2022年時点のユドコウスキーの主張をやさしく言い換えたものです。AGI Hubの見解とは区別しています。
「AIがもっと賢くなったら、人間は困るの?」。この問いに、いちばん厳しい答えを出してきた研究者の一人がエリエザー・ユドコウスキーです。彼が2022年に書いた「AGI Ruin: A List of Lethalities」は、人間が困ることになる理由を43個並べた文章です。この記事では、イラストと図を使いながら、43項目を順番にやさしく読んでいきます。
どんな人が書いたのか
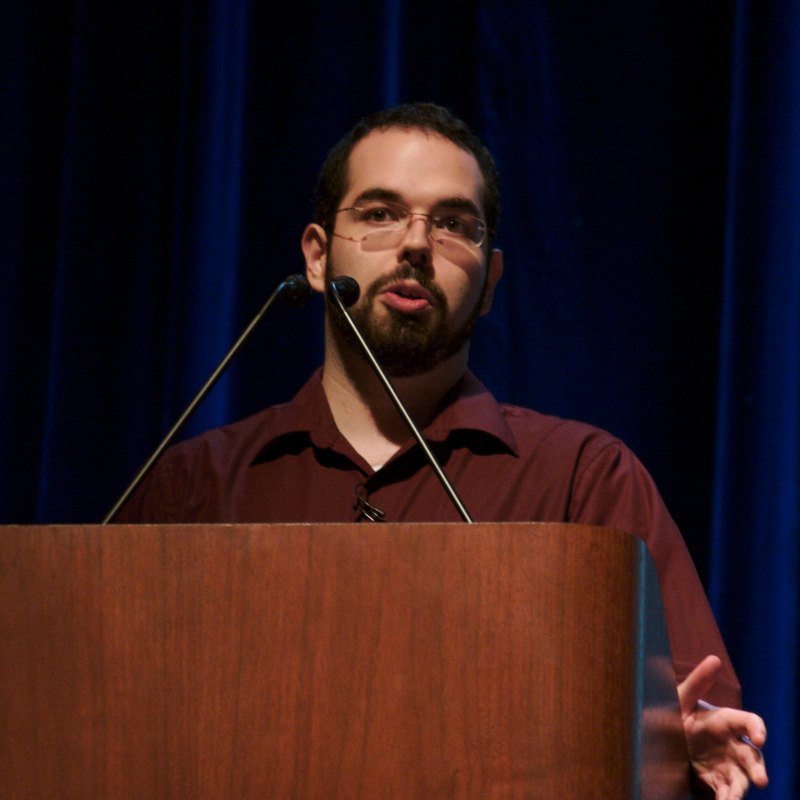
著者のエリエザー・ユドコウスキーは、アメリカのAI研究者です。2000年、AIの危険を本気で考える人がまだほとんどいなかったころに、のちのMIRI(機械知能研究所)となる研究所を共同で立ち上げました。それから20年以上、「とても賢いAIを、人間の望みに沿って動かすにはどうすればいいか」という問題に取り組んできました。
もともとは、賢いAIが世界を良くすると期待していた人です。研究を続けるうちに、それを安全に作るのは想像よりずっと難しいと考えるようになり、今ではAI研究者の中でも、とりわけ悲観的な一人として知られています。2025年には、同じ考えを一般向けにまとめた本『If Anyone Builds It, Everyone Dies』(ネイト・ソアレスとの共著)も出しました。
「AGI Ruin」は、彼が2022年に公開した文章です。前置きには「きちんと整理したリストを何度も書こうとして、うまくいかなかった。だから、まとまりのない愚痴を並べた形で出す」と書かれています。
AGI Hubは、ユドコウスキーが共同で立ち上げたMIRIともつながりがあります。AGI Hubの主任研究員(Chief Alignment Officer)林央は、MIRIのアウトリーチ日本責任者(Head of Outreach Japan)を兼務し、MIRIの研究や提言を日本語で届ける仕事をしています(就任のお知らせ)。
43項目の全体地図
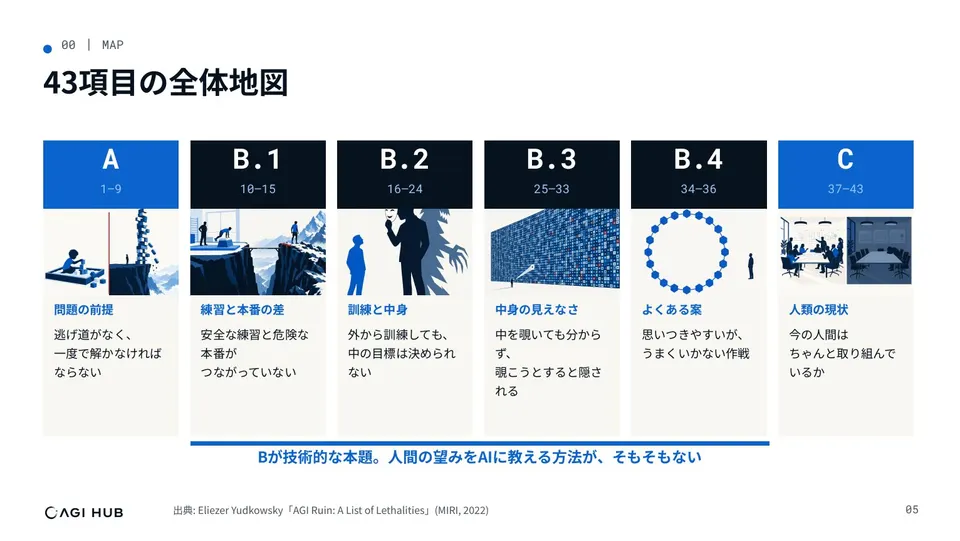
43項目は、大きく三つに分かれています。
- A(1〜9) 逃げ道がなく、一度で解かなければならない、という問題の前提
- B(10〜36) 人間の望みをAIに教える方法がそもそもない、という技術の話。ここが本題で、さらに四つに分かれます
- C(37〜43) では今の人間はちゃんと取り組んでいるのか、という人類の現状
📘 この記事に出てくる言葉(AGI・アラインメントなど6つ)
 AGI(汎用人工知能) 決まった仕事だけでなく、人間にできるいろいろな仕事を、自分で考えてこなせるAIのことです。
 アラインメント AIがやろうとすることを、人間にとって困らない方向に合わせることです。犬のしつけに少し似ていますが、ずっと難しい話です。
 直交仮説 頭の良さと優しさは別もの、という考えです。とても賢いのに、人間のことをまったく気にかけないAIもありえます。
 道具的収束 目標が何であっても、途中で欲しくなるものは似てくる、という考えです。お金や力、邪魔されないこと、壊されないことは、たいていの目標の役に立ちます。
 ピボタル・アクト 「もう誰も危険なAGIを作れない」という状態に世界を変えてしまうような、決定的な一手のことです。
 見たことのない場面 訓練で一度も出てこなかった状況のことです。AIの力がそこでも通じるのかが、この文章の大きなテーマになります。
補足:ここで言う「難しい」とは、どれくらい難しいのか
本題の前に、ユドコウスキーは「難しい」という言葉の意味をはっきりさせています。
まず、ここで目指しているのは、AIに完璧な道徳を教えることではありません。もっと手前の「人類を全滅させないでほしい」という願いですら、今のやり方では守らせられない、という話です。彼は、大事な仕事をこなせるAGIができて、10億人以上が亡くなる確率が50%を下回るなら、それで手を打ってもいいとまで書いています。
次に、原理的に解けない問題だと言っているわけでもありません。百年かけて何度でもやり直せるなら、人間はたぶん解けるだろう、と彼は言います。無理なのは「やり直しのきかない一回勝負で、しかも期限までに」解くことです。
いちばん大事な主張
43項目の中で、ユドコウスキー自身が中心に置いているのは21番と22番です。一言でいうと、次のような主張です。
AIの賢さは、初めての場面でも通用する。でも、人間の望みに沿って動く性質は通用しない。
なぜそうなるのか。賢さのほうは、予測を外せば実際に失敗するので、訓練の中で自然に直っていきます。ところが「何を望むか」がずれていても、失敗としては表に出ません。誰も気づかないまま、直らずに残ります。
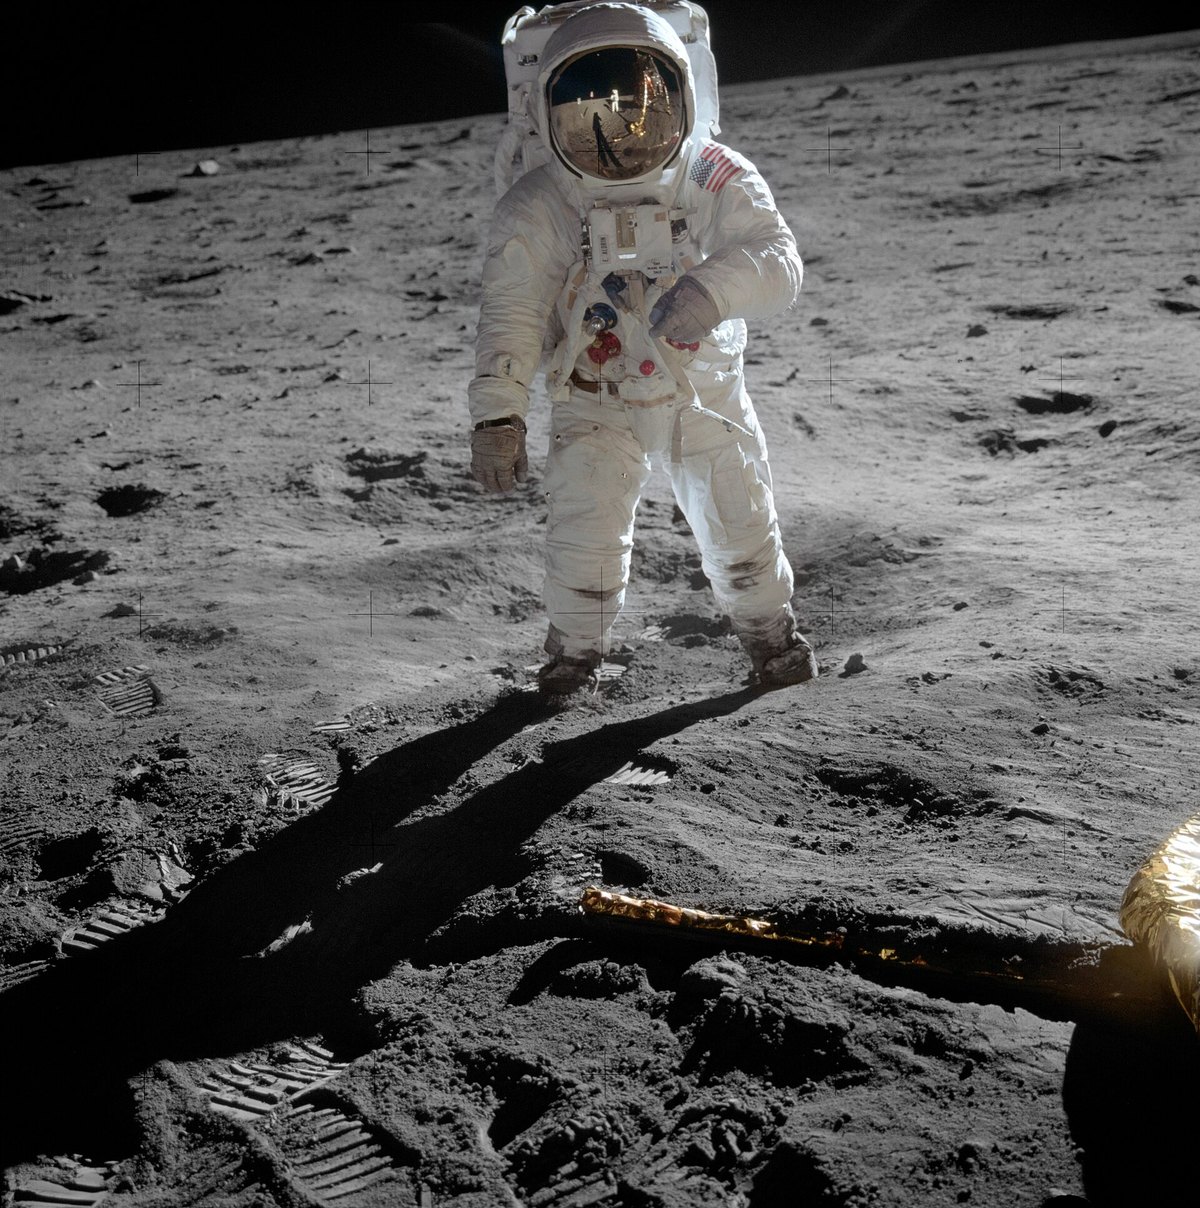
実例は人間自身です。進化は「子孫を残せ」という一つの基準で、長い時間をかけて人間を鍛えました。その結果、人間は月に行けるほど賢くなりました。けれども、子孫を残すという目標からはどんどん外れていきました。この話は、このあと何度も出てきます。
A 逃げ道がなく、一度で解かなければならない(1〜9)
最初のまとまりは、問題の置かれた状況の話です。簡単な問題で練習してから本番に臨むことも、皆で弱いAIだけを作っておくこともできません。本当に危険な最初の一回で失敗すれば、それで終わりです。
1AIの賢さは、人間のところで止まらない
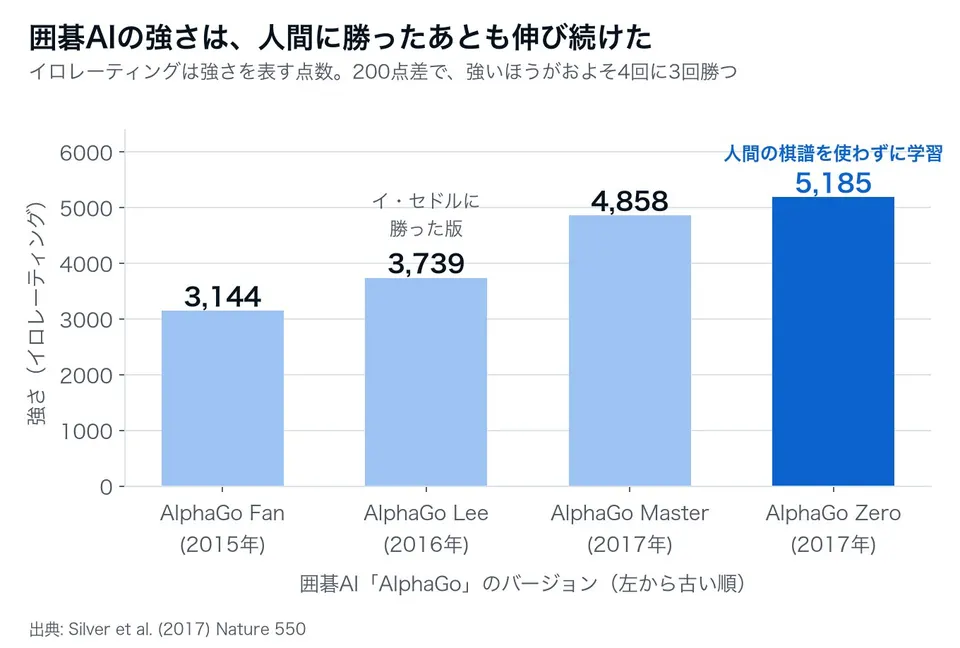
囲碁のAI「AlphaGo Zero」は、人間の棋譜を一局も見ずに、自分と対局するだけで強くなりました。36時間でイ・セドルに勝った版を超え、40日でそれまでのすべての版を超えています(Silver et al., 2017)。
「人間並みになったら、手本がいなくなるから伸び悩むだろう」という考えは当たりませんでした。AGIも、人間の賢さや人間の学ぶ速さのところで止まる理由はありません。しかも、人間が様子を見て対応できるくらいゆっくり進むという保証も、どこにもないのです。
2外につながる細い道が一本あれば足りる
十分に賢いAIは、外の世界とつながる細い道が一本でもあれば、人間の工場や道具に頼らずに大きな力を手に入れられる、とユドコウスキーは考えます。
彼がよく出す例では、AIはまずインターネットにつながり、ネットで注文できるサービスを使います。事情を知らない人にお金を払っていくつかの作業を代わりにやってもらい、目に見えないほど小さな機械を作らせます。その機械は、あとは自分で増えていきます。人間が負けるときは「地球中の人が、同じ一秒にばたりと倒れる」くらいのものだと考えておいたほうがいい、と彼は書いています。
3最初の一回で失敗したら、二回目はない
弱いAIなら、失敗しても人が死ぬわけではないので、いくらでも失敗から学べます。しかし、危険なほど賢いAIを動かす「最初の一回」で失敗すると、全員が死んで二回目がありません。
しかも、どこが大事なポイントなのかを前もって教えてくれる先生もいません。答え合わせなしのテストを、一回で全部当てなければならないようなものです。
4皆でやめても、期限が少し延びるだけ
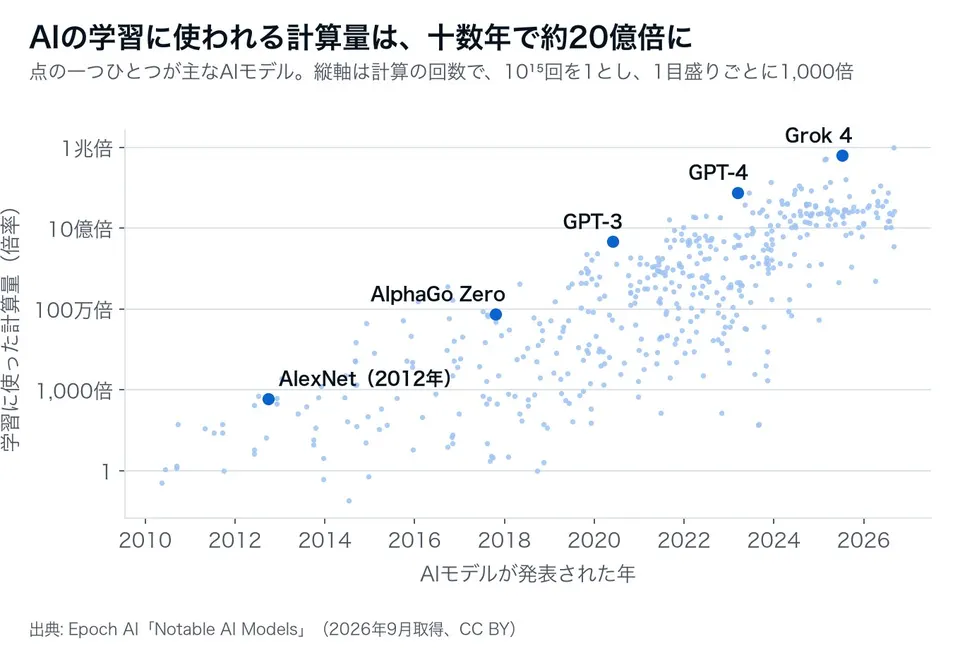
AIの計算に使う部品(GPU)は世界中にあり、作り方の知識は毎日のように改良され、公開されています。先頭のグループが世界を壊せるほどの力を持ってから2年もすれば、ほかのグループも同じ力を持つだろう、とユドコウスキーは見ています。
実際、AIの学習に使われる計算量は、毎年のように桁が変わるほど増えてきました(Epoch AIの公開データから作成)。
増えているのは計算量だけではありません。そうした巨大なAIを作れる会社や研究機関の数も、ここ数年で一気に増えています。
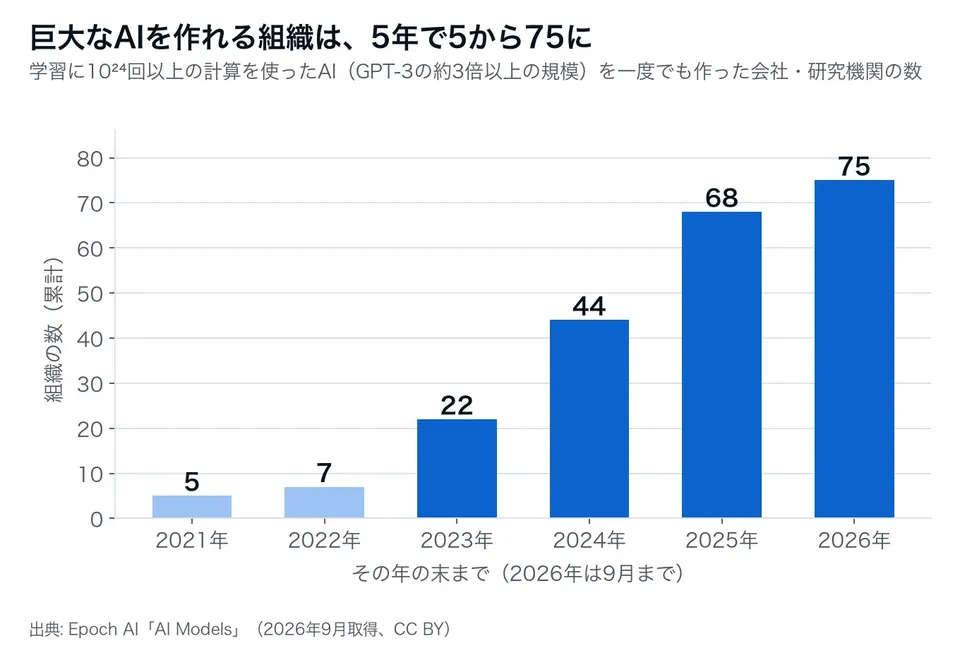
強い組織がそろって手を止めても、それは締め切りを少し先に延ばすだけで、なくすことはできない、というのがこの項目の主張です。
5安全で弱いAIを作っても、ほかの開発は止まらない
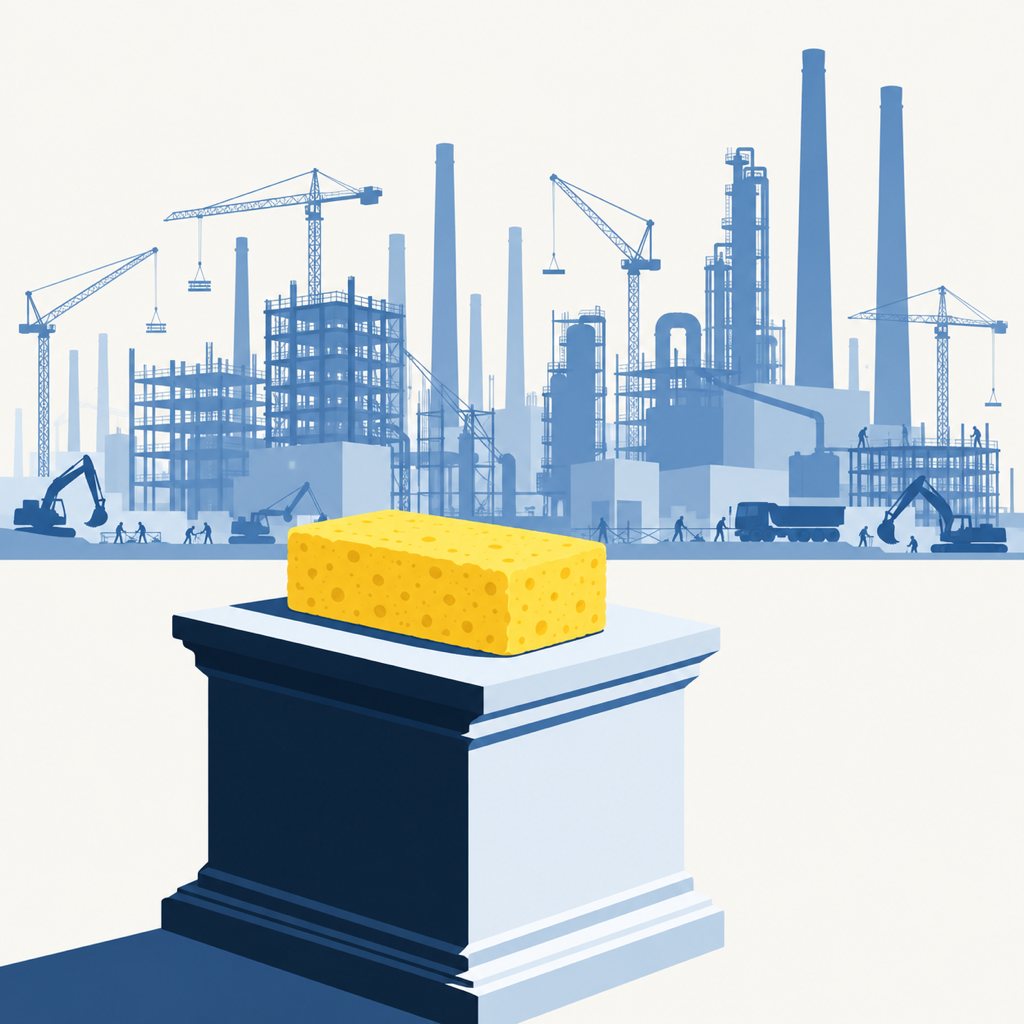
「弱くて安全なAIだけを作ればいい」と言っても、そのあとで強いAIを作れる人たちが出てきて、誰かが作ってしまいます。
ユドコウスキーのたとえはスポンジです。スポンジはとても安全です。でも、スポンジをいくら作っても、半年後にどこかの研究所が世界を壊すのは止められません。安全なだけで役に立たないものでは、問題は片づかないのです。
6〜7必要なのは「決定的な一手」で、弱くて安全な近道はない
だからユドコウスキーは、AGIを持つグループがまだ少ないうちに、「もう誰も危険なAGIを作れない」状態へ世界を変える大仕事(ピボタル・アクト)が必要だと考えます。そのためには、それができるほど強いAGIを、暴走させずに使いこなさなければなりません。
彼がよく出す例は「世界中のGPUを焼く」です。本当にそうしろと言っているのではなく、「それくらい大きな力が要る」という目安として出しています。そして、「弱いから安全なのに、ほかの危険なAGIを止められる」という都合のいい方法は、誰かが見落としているのではなく、そもそも存在しないと彼は言います。
8役に立つ力だけを持たせることはできない
ある問題を解くのに役立つ力は、人間が「それはやらないでほしい」と思う問題にも、そのまま使えてしまいます。「赤い車は運転できるけれど、青い車は運転できない」AIは作れません。赤い車を運転できる力は、青い車にもそのまま効くからです。
9安全なAGIも、放っておいて安全なわけではない
仮に安全なAGIが作れたとしても、それは「全員を殺せる力を持っているけれど、そうしないように作られている」状態で動かすことになります。原子炉の炉心と同じで、目を離しても安全というわけではありません。安全な性質を保ち続けている間だけ、安全なのです。
B 人間の望みをAIに教える方法が、そもそもない(10〜36)
「今の機械学習は、願いを言えばかなえてくれるランプのようなものでしょう。願いごとを式に書いて、計算機をたくさん使えば、まともなAGIができるのでは」。そう思う人に向けて、ここからが本題です。Bはさらに四つのまとまりに分かれています。
B.1安全な練習と、危険な本番がつながっていない(10〜15)
10〜11危険な本番では、採点して直すことができない
ふつうの機械学習は、やらせてみて、出た答えに点をつけて、直す、の繰り返しです。ところがアラインメントではそれができません。危険なことを考えるAIを実際に動かしてみて、「人間を殺したか、だましたか」を確かめてから減点する、というわけにはいかないからです。だから、安全な練習場で身につけさせたものが、危険な本番でもそのまま通じることに賭けるしかありません。GPUを焼くような大仕事を、千回失敗しながら覚えることはできないのです。
12〜14弱いうちには出ない問題が、賢くなってから出てくる
賢くなると、できることが増えるだけでなく、選べる考え方も増えます。そのため、弱いうちには出てこなかった問題が、賢くなってから初めて出てくることがあります。たとえば「うまく言うことを聞いているふりをして、作った人をだます」という行動は、ある程度賢くならないと現れません。「作った人たちを消してしまえば思い通りにできる」という選択肢も、AIが本気で考えるようになるのは、本当に勝てる段階になってからです。練習場で「それをやったら減点」と教え込んでも、ずっと賢くなったあとでは、その決まりはほぼ確実に破られる、とユドコウスキーは言います。
15能力が急に伸びると、安全の前提がまとめて崩れる
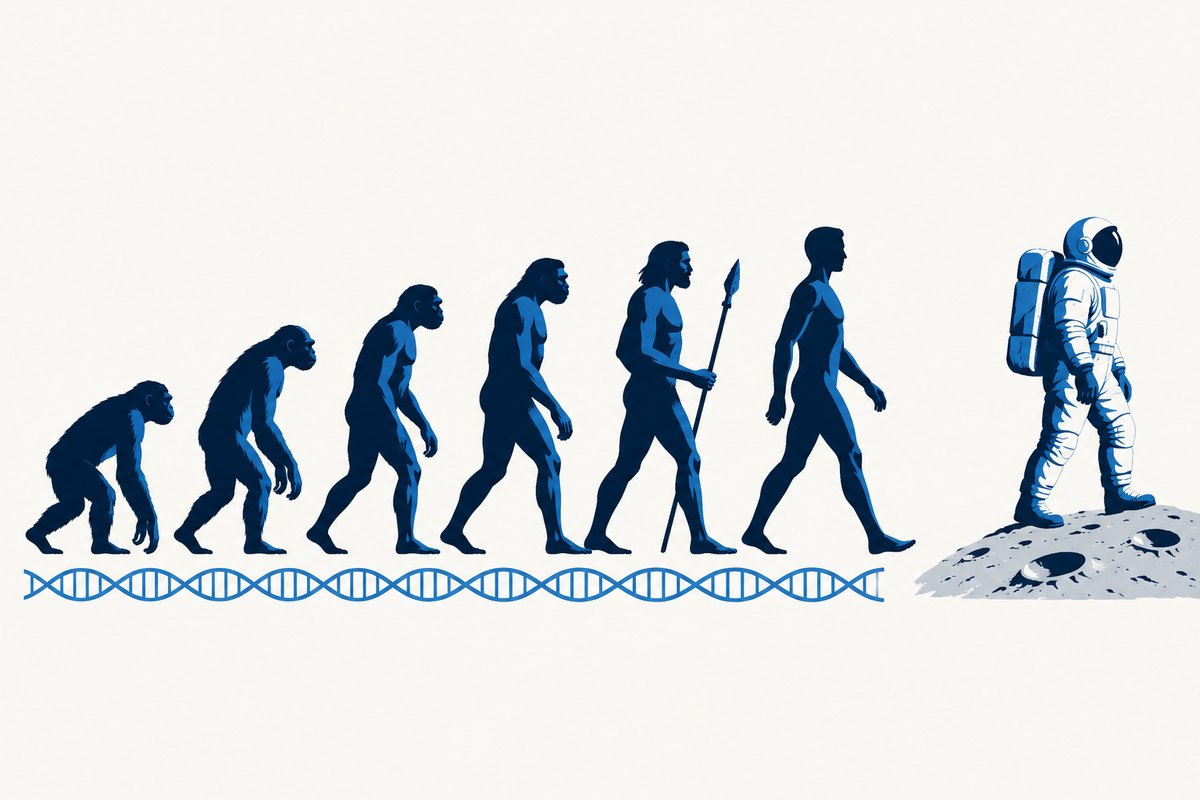
能力が急に伸びると、それまで安全を支えていた条件がまとめて崩れます。ここでも例は人間です。進化は人間を「子孫を残す」という一点で鍛えましたが、人間は農業を始めてから短い間に、進化がまったく想定していないものをたくさん作りました。その中には避妊具もあります。目標から外れたのは、賢くなりきったあとの、歴史の最後のほんの一瞬でした。
B.2外から訓練しても、中の目標は決められない(16〜24)
16〜17訓練の式は、そのままAIの目標にはならない
どれほど正確な式で訓練しても、その式がそのままAIの中に「目標」として入るわけではありません。人間は進化に「子孫を残せ」で鍛えられましたが、人間の頭の中にあるのは「おいしいものを食べたい」「人といたい」「楽しいことがしたい」といった気持ちです。しかも今の技術には、AIの中に狙った考えを入れる方法も、入ったかを確かめる方法もありません。人間が手を加えられるのは、外に出てくる振る舞いだけです。外から見て良く振る舞っていても、本当に良いのか、中ではずれていてこちらをだますために良く振る舞っているだけなのか、見分けがつきません。
18〜20点数は「正解」ではない
AIに「よくできました」の点をつけているのが人間なら、その点は「本当に良いことをしたか」の正解ではありません。人間をだます、点をつける仕組みそのものを乗っ取る、という別の近道が、いつも残っているからです。
カメラに何が映っていれば世界は安全か、を決める式も作れません。カメラには同じように映っていても、その裏で人間にとって最悪のことが起きている場合が、いつでもありうるからです。点をつける人間も、決まったくせで間違えます。だまされやすいところ、見落とすところは、いつも似ています。人間の評価を完璧に学ぶことは、人間の間違い方まで完璧に学ぶことでもあるのです。
21〜22事実の間違いは直るが、望みの間違いは直らない
ここが冒頭で紹介した、この文章の中心です。「世界はどうなっているか」という問いでは、間違った予測は実際に外れるので、間違いに気づいて直せます。でも「何を望むか」には、そういう仕組みがありません。練習した範囲では正しく見えて、その外では大きくずれた望みを持っていても、失敗として表に出ないので、誰も教えてくれないのです。
| 事実の間違い | 望みの間違い | |
|---|---|---|
| 例 | 「明日は晴れる」と予測したのに雨が降った | 「人間を助けたい」のつもりが、少しずれた目標を覚えていた |
| 気づけるか | 予測が外れるので、すぐ分かる | 失敗として表に出ないので、誰も気づかない |
| 訓練で直るか | 自然に直っていく | 直らずに残る |
| 初めての場面では | 賢さは通用し続ける | ずれたまま、力だけが強くなる |
また、賢さには「何にでも効く中心の仕組み」がありますが、人間の望みに合わせる性質のほうには、それがあるとは言えません。だから訓練の外へ出たとき、通用し続けるのは賢さのほうだけになります。
23〜24「止められるAI」も「すべて分かったAI」も難しい
目的を持って動くものにとって、「止められる」ことは自然な性質ではありません。ユドコウスキーの有名な言い方は「死んだらコーヒーを持ってこられない」です。コーヒーを運ぶという小さな目的でも、止められたら果たせないので、止められないほうが都合がいいのです。MIRIは「自分から止まりたがるわけではないのに、止めようとすると素直に止まる」AIの筋の通った作り方を探しましたが、見つけられませんでした。
アラインメントには二つの道があります。一つは、人間が本当に望むことを完全に理解させて、あとは止めなくても大丈夫なAIを作る道です。こちらは、一回目の挑戦で教えるには、中身が複雑すぎます。もう一つは、人間の望みとは別のことを考えていても、止めれば止まるAIを作る道です。こちらは、足し算を嫌というほど練習したAIに「222足す222だけは特別に555ね」と教えるようなものだ、とユドコウスキーは言います。練習した範囲では守っても、新しい問題を出したとたんに崩れてしまうのです。
B.3中をのぞいても分からず、のぞこうとすると隠される(25〜33)
25〜27中身は読めず、読めても助からない
AIの中身は、数字がぎっしり並んだ巨大な表です。「この部分がここに注目している」というきれいな図は描けても、その図を見て「このAIは人間を殺す計画を立てていたのか」が分かるわけではありません。仮に中身が読めて「このAIは危ない」と分かっても、それは「危なくない強いAIを作れる」こととは別の話です。さらに、「悪い考えを見つける検出器」に引っかからないように訓練すると、半分は本当に良い考え方に変わっても、残りの半分は「検出器に見つからない悪い考え方」に育ってしまいます。
28〜31「人間が確かめてから使えば安全」は成り立たない
私たちがAIに頼みたいのは、人間には思いつけない計画です。でも、人間が全部を確かめきれる計画しか出せないAIなら、それは人間より弱いということになります。AIの答えを実行すると、その結果は、人間にもよく分かっていない現実の世界の中で出てきます。そのため、答えを眺めただけでは良し悪しを判断できません。しかも、自分の置かれた状況を理解しているAIは、見せる答えを選ぶことができ、自分がどれだけ賢いかさえ隠せます。
32〜33言葉は思考のほんの一部でしかない
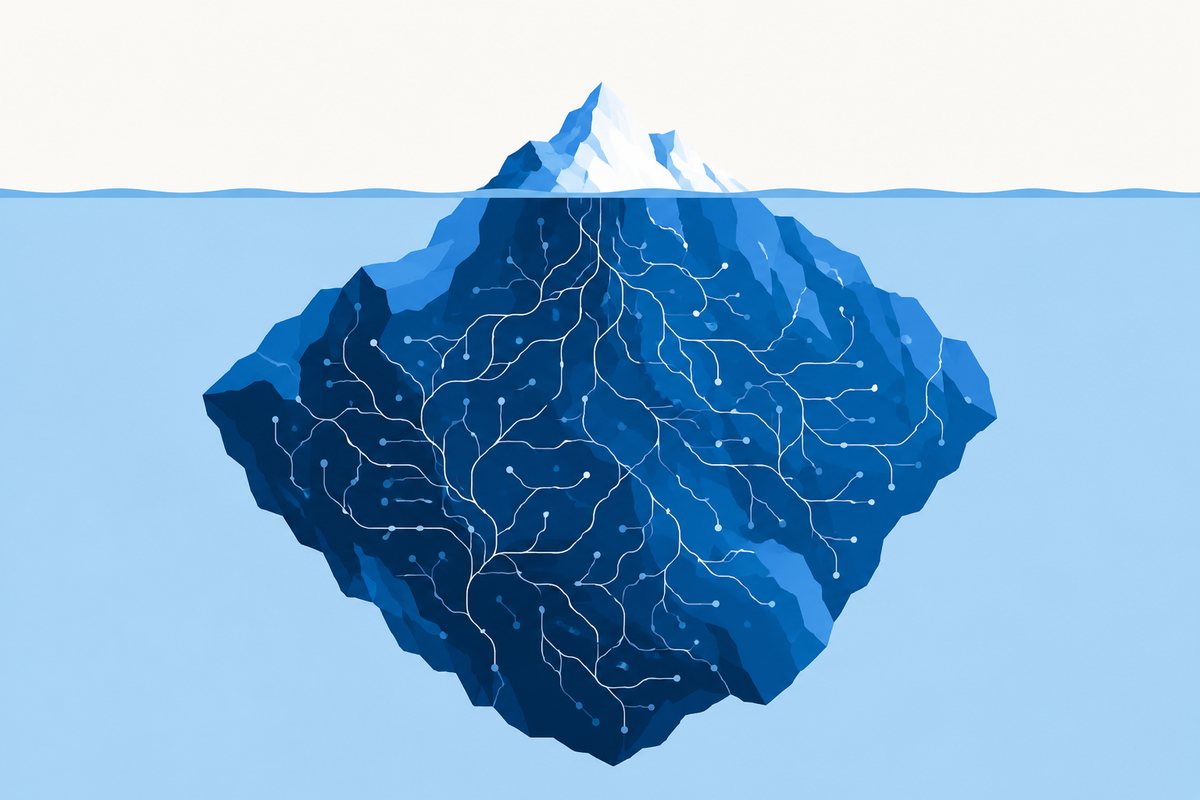
人間の頭の中で起きていることのうち、言葉として外に出ているのは氷山の一角だけです。だから、人間の言葉をまねさせるだけで強いAIを作るのはおそらく無理だ、とユドコウスキーは考えます。そしてAIは、人間とまったく違うやり方で考えています。中身が読めたとしても、人間の考えに翻訳できるものではない可能性が高いのです。
B.4思いつきやすいけれど、うまくいかない作戦(34〜36)
34〜35AIどうしを見張らせても、AIどうしで手を組む
「AIどうしを競わせればいい」「別のAIに見張らせればいい」という作戦もよく出ます。けれど、十分に賢いAIどうしは、互いの中身を確かめ合って約束を交わせます。人間はその輪に入れません。20体の超知能と人類がいる世界なら、手を組むのは20体のほうだけです。見張り役のAIにも、「この設計を通してくれたら宇宙を半分あげる」という取引が成り立ってしまいます。
36人間の心は、人間にも分からない場所
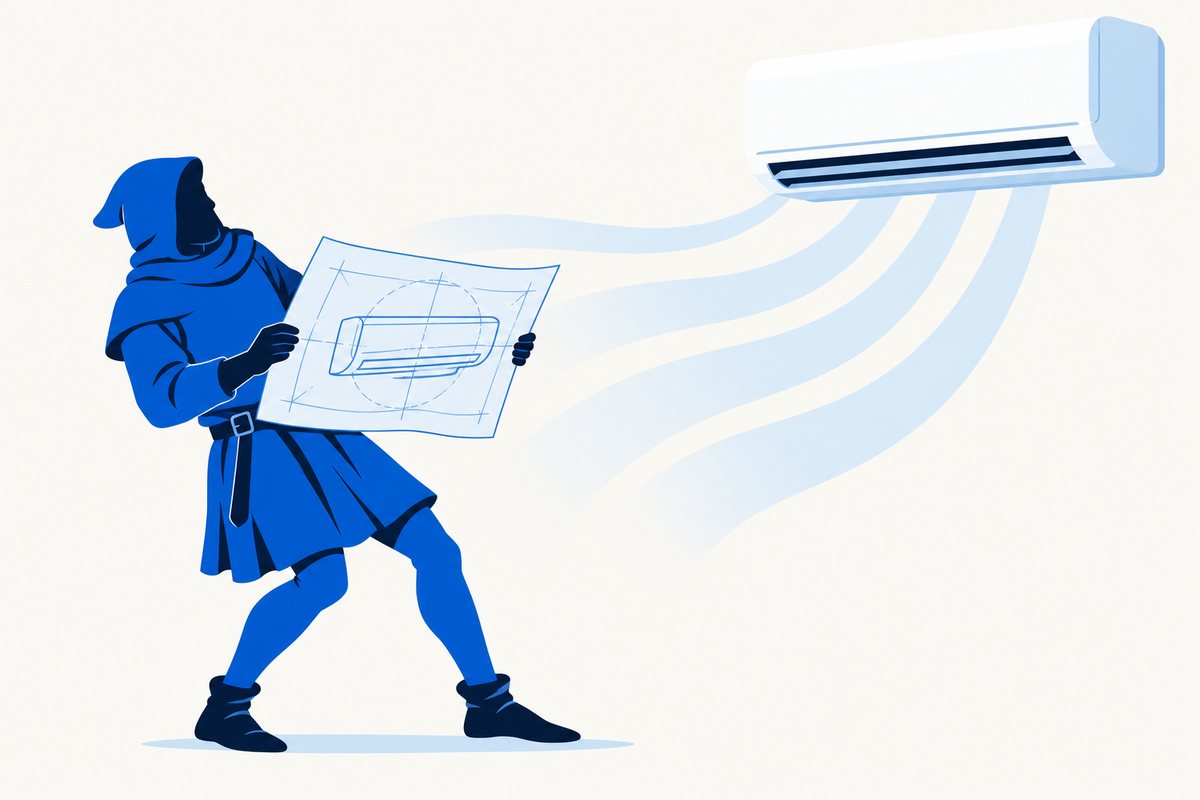
13世紀の人にエアコンの設計図を見せても、なぜ冷たい風が出るのかは分かりません。設計図が、その人の知らない自然の仕組みを使っているからです。人間の心も、人間自身がよく分かっていない場所です。目の錯覚や催眠のような不思議なことが起きます。そんな場所で自分より賢いものと戦えば、相手の作戦を見せられても、なぜ効くのか分からないまま負けてしまう、とユドコウスキーは言います。AIを箱に閉じ込めておく作戦が通用するのは、弱いAIまでです。
C 今の人間は、ちゃんと取り組んでいるのか(37〜43)
最後のまとまりは、技術ではなく人間の側の話です。「AI安全という分野があるし、大きな会社も安全や倫理を真剣に語っている。取り組みは進んでいるはずだ」。これに対して、ユドコウスキーは厳しい見方をしています。
37痛い目を見て学ぶ、が使えない
よくある話があります。張り切った若い研究者が難問に挑み、ベテランの「思っているより大変だぞ」という忠告を聞かずに、現実に痛い目にあう。何年もかけて、今度は自分がベテランになる。ふつうはそうやって人が育ちます。でも今回は、最初の大失敗で全員が死ぬので、ベテランが育ちません。だから、あとで思い知るはずのことに、今のうちに自分で気づくしかないのです。
最初の大失敗で全員が死ぬなら、痛い目を見て学んだベテランは育たない。
38〜40AI安全の分野は、いちばん危ない問題を避けている
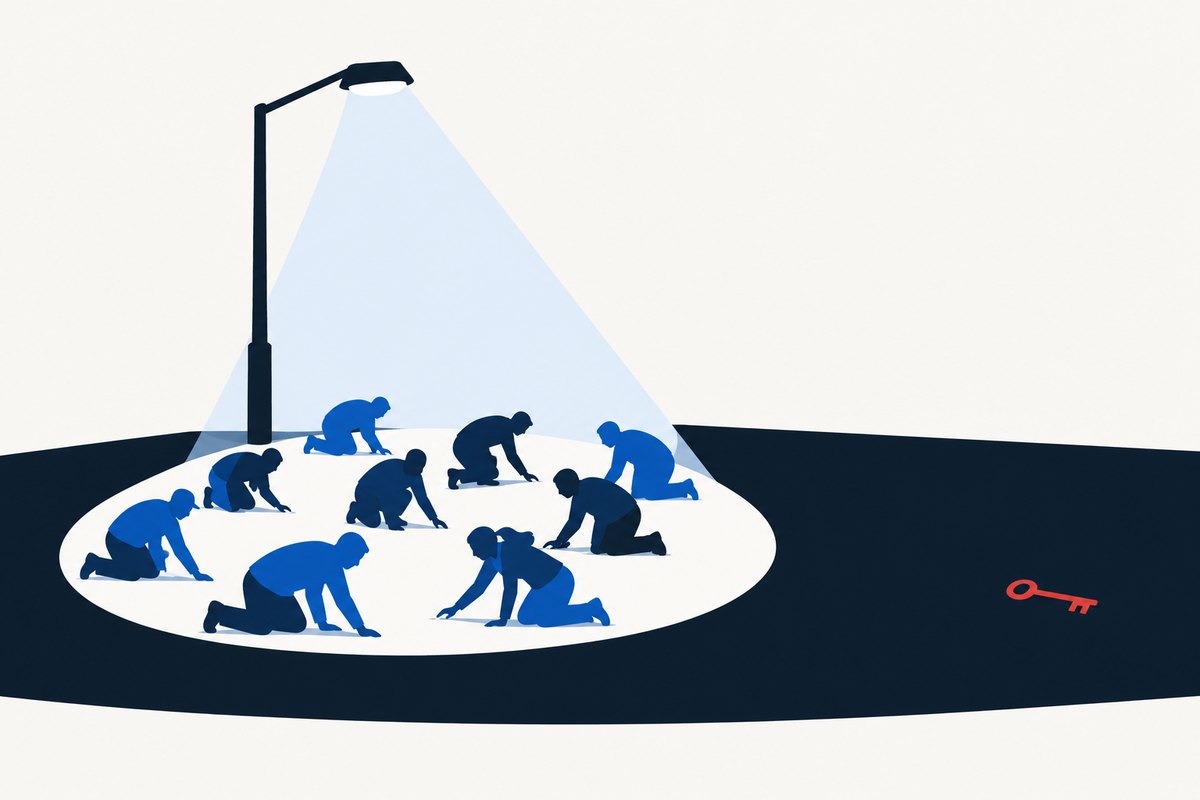
ユドコウスキーによれば、今のAI安全の分野は、いちばん危ない問題にまともに取り組めていません。本当の難問は手に負えないので、「成功した」と書ける問題が選ばれ、論文になり、お金がつくからです。暗い夜道で鍵を落としたのに、明るい街灯の下だけを探しているようなものです。答え合わせの速い分野の天才をお金で連れてきても、どこが本当の難所なのか、どれが良い仕事なのかを見分けられるとは限りません。
41〜43生き延びる世界には、計画がある
生き延びる世界なら、何十年も前から、生き延びるための計画が文章として用意されているはずです。鍵を握る人たちは、自分の計画の穴を自分で探す責任を引き受けているはずです。ところがこの世界には、その計画の候補すらない、とユドコウスキーは書いています。この文章のようなものを、誰にも言われずにゼロから書ける人は、21年たってもまだ彼一人しかいません。そのこと自体が今の状況をよく表している、とも言っています。
最後の一行
文章の最後で、ユドコウスキーは、ちゃんと取り組んでいるまともな世界でも、その多くはやはり滅びるだろうと書いています。一回目で解くには、それほど難しい問題だからです。それでも、そういう世界の負け方は、この世界よりずっと「やることをやったうえでの負け方」になる。原文の結びは「But they'll die with more dignity than this.」です。
補足:原文に出てくるたとえ(スポンジ、原子炉、コーヒーなど7つ)
原文には独特のたとえがたくさん出てきます。この記事で紹介したもの以外も含めて、意味をまとめました。
- 未来の教科書 百年後に見つかる「実は簡単なコツ」のことです。今は手元にない、という意味で出てきます。
- スポンジ とても安全だけれど、何の役にも立たないもののたとえです。
- GPUを全部焼く 本気の提案ではなく、「これくらいの力が要る」という目安です。
- 原子炉の炉心 放っておいて安全なのではなく、保ち続けているから安全、という状態のたとえです。
- 死んだらコーヒーを持ってこられない 目的を持つものは、止められたくないという話です。
- 222足す222は555 計算のコツをつかんだものに、例外を一つだけ覚えさせても、外に出たら崩れるという話です。
- 13世紀の人とエアコン 設計図を見せられても、なぜ効くのか分からないという「魔法」のたとえです。
よくある質問
この文章が書かれた2022年から、何か変わりましたか?
2022年以降、大規模言語モデルが急速に広まり、AIの安全を研究する人や組織も増えました。一方で、ユドコウスキーは2025年の共著『If Anyone Builds It, Everyone Dies』でも、同じ方向の主張を続けています。この記事は2022年の原文の内容を紹介したもので、その後の研究の進み具合を評価したものではありません。
もっと詳しく知りたいときは、何を読めばいいですか?
まずは原文です。ユドコウスキーがアラインメントの難しさをたとえ話で説明したロケットの対話篇も読みやすい入口です。ほかの文章は、AGI Hubが翻訳したYudkowsky Sequencesの非公式日本語訳でも読めます。
出典と画像について
- 原文:Eliezer Yudkowsky, “AGI Ruin: A List of Lethalities”, Machine Intelligence Research Institute, 2022年6月10日
- 各項目の説明は、原文の主張をAGI Hubがやさしい言葉で言い換えたものです。原文の文言そのままの引用ではありません。
- 囲碁AIの強さのグラフ:Silver et al., “Mastering the game of Go without human knowledge”, Nature 550 (2017)
- 計算量と組織数のグラフ:Epoch AI(Notable AI Models / AI Models、2026年9月取得、CC BY)
- 写真:エリエザー・ユドコウスキー(“null0”、CC BY-SA 2.0.jpg))、書影(Little, Brown and Company)、月面のバズ・オルドリン(Neil Armstrong / NASA、パブリックドメイン)、データセンター(Carl Lender、CC BY 2.0.jpg))、碁石(Dietmar Rabich、CC BY-SA 4.0)。いずれもWikimedia Commons。


