Dwarkesh Patel氏のエッセイ「The avalanche that hit math is coming for AI development」(2026年11月13日)の主張を、AGI Hubが日本語で要約・解説したものです。逐語訳ではなく、AGI Hubの見解とは区別しています。
米国のポッドキャスト司会者Dwarkesh Patel氏が、2026年11月13日(米国時間)にエッセイ「The avalanche that hit math is coming for AI development」を公開しました。Patel氏は、最高の人間に並ぶAI研究者が2年ほどで、早ければ数か月で現れると見ています。 その後まもなく、2030年までに(早ければ来年にも)、あらゆる分野で最高の専門家と少なくとも同等のAIが現れるという予想です。今年の前半までは「超知能まで少なくとも10年近くかかる」と考えていた人が、この3か月で考えを大きく改めました。きっかけの一つは、数学で起きたことがAI研究でも起きると見たことです。
📘 この記事に出てくる言葉(再帰的自己改善・サンプル効率など4つ)
 再帰的自己改善(RSI) AIが次のAIの研究開発を担い、できたAIがさらに次のAIの開発を速める循環。エッセイのURLにも使われている言葉。
 答えを確かめられる課題 答えが合っているかを機械で確かめられる課題。数学の証明や、書いたプログラムがテストで正しく動くかなど。AIに何千回も練習させやすい。
 サンプル効率 同じことを覚えるのに必要なデータの少なさ。今のAIは人間よりはるかに多くのデータを必要とする。
 継続学習(オンライン学習) 仕事をしながら経験から学び続けること。今のAIは、会話を始めるたびに「出社初日」に戻ってしまう。
どんな人が書いたのか
Dwarkesh Patel2026
ポッドキャスト「Dwarkesh Podcast」の司会者
2028年
- 条件
- AI企業が意図して開発を遅らせなければ
- 見積もり
- 最高の人間に並ぶAI研究者の登場は中央値で2028年、2027年もありうる。2032年より後になる確率は25%
Patel氏は、AI企業の経営者や研究者への長いインタビューで知られる司会者です。このエッセイでは、番組の内外で人と議論し、答えを確かめられる分野でのAIの伸びを見てきた結果、予想を大きく早めたと書いています。
出典:The avalanche that hit math is coming for AI development写真:TechCrunch(Wikimedia Commons、CC BY 4.0)
Patel氏はこの1年半、今のAIに欠けている一番の能力は「仕事をしながら学ぶこと」だと論じ、AI研究の自動化はすぐには来ないと見ていました。その本人が、継続学習は今の作りの延長で解けそうで、仮に解けなくてもAI研究は自動化されうると考えを改めました。 AGI Hubがこのエッセイを取り上げるのは、この変化が大きいと考えるからです。
AIはすでにAI開発を速めている
Patel氏はまず、AIが最先端のAI開発をすでに大きく速めている証拠を挙げます。
三つの証拠
1METRの評価
外部の評価機関METRがAnthropicに3か月入って調べ、範囲の決まった作業での進歩の速さが1年前の2倍になったと結論づけた。その大半はAIを研究開発に使った効果と見ている。
2OpenAIの利用額
AIを最も使う上位10%の研究者は、社内のコーディングエージェント(自分で作業を進めるAI)に使う額が、夏の初めの1日約1,000ドルから、8月末には1日7,000ドル超に増えた。
3Anthropicの仕事の分担
Claudeが「主導する」研究開発の割合は、2月の1%未満から8月には26%超になった。人間は監督に回り、Claudeが大まかな指示から作業の大半を進める。
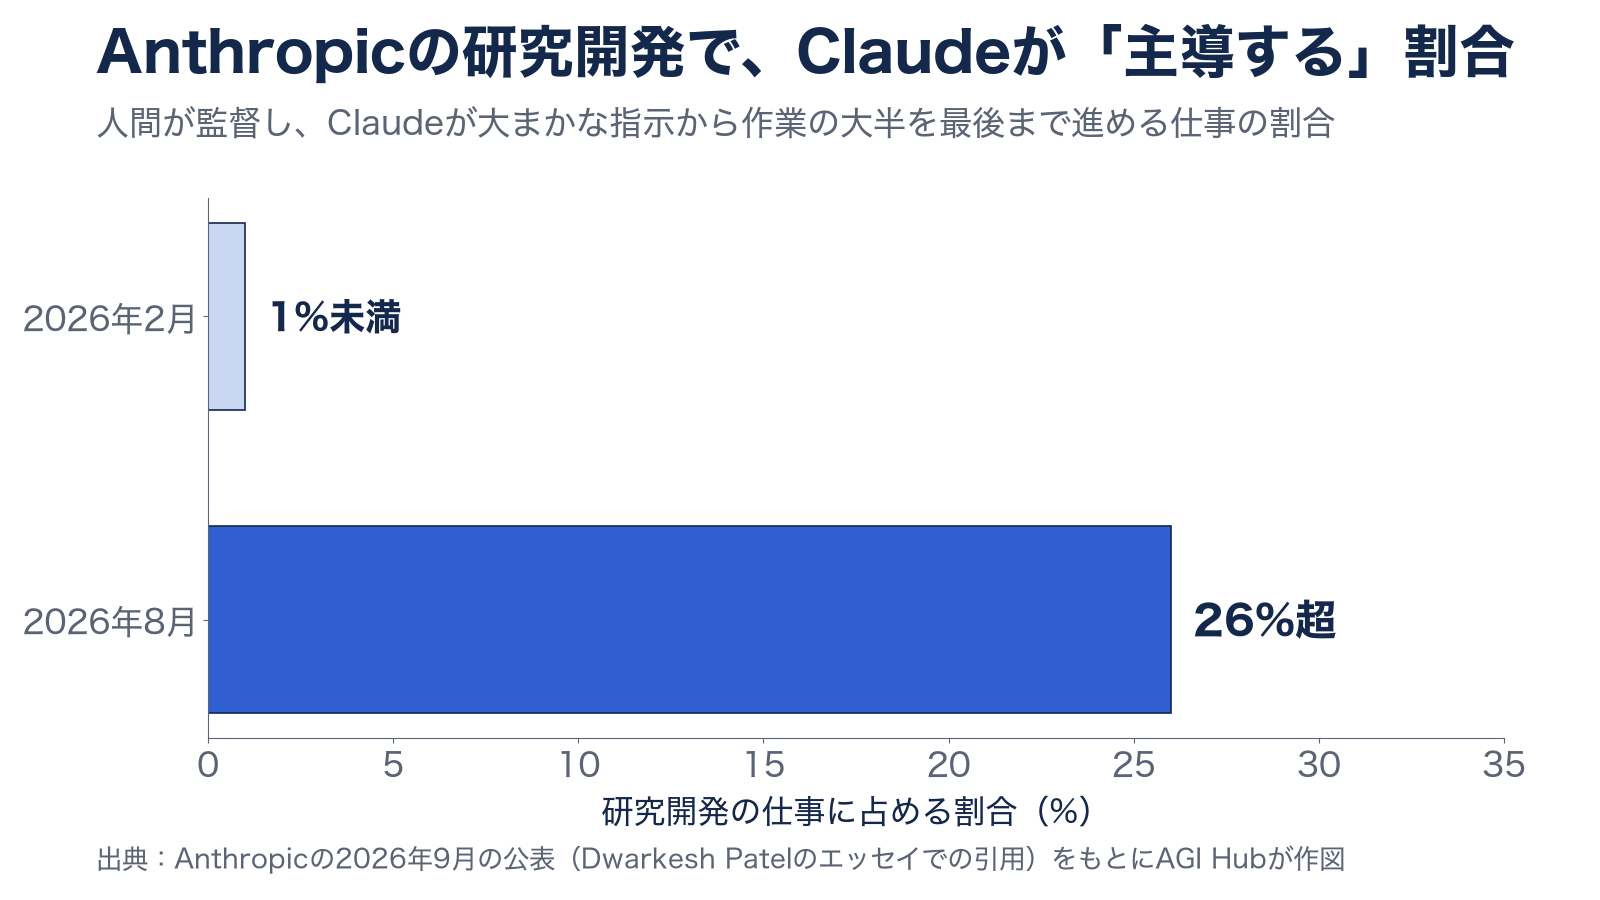
完全に人間抜きで進む仕事は、まだ0%です。 ただしPatel氏は、Claudeが主導する割合も2月にはほぼ0%だったと注意を促しています。Claudeが人間の細かい指示のもとで大きな作業を担う段階に届かない仕事は、すでに1割を切りました。METRの報告そのものは、METRの報告を扱った記事と安全性の専門家の反応をまとめた記事に詳しく書きました。
数学で起きたことがAI研究でも起きる
Patel氏が考えを改めた大きなきっかけの一つは、数学でのAIの伸びです。
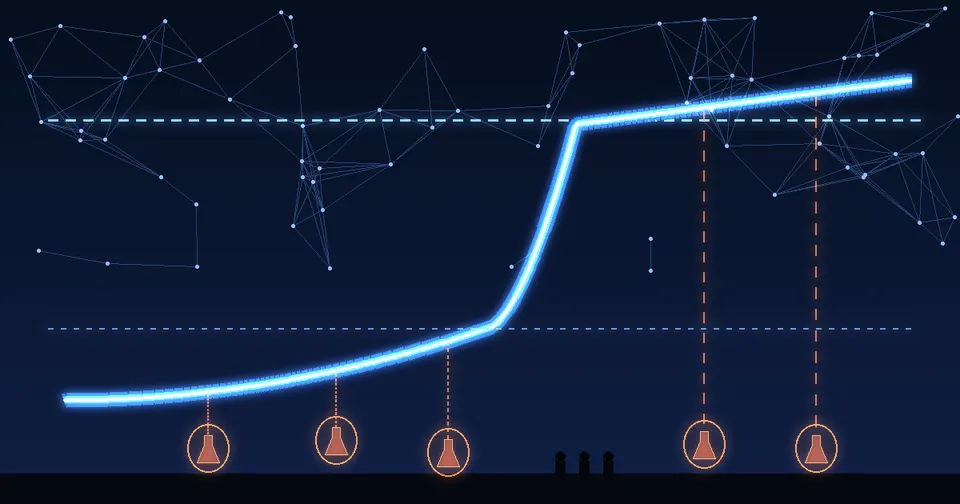
数学でのAIの歩み(エッセイの記述から)
2023年数学
4桁の足し算も確実にはできなかった
2024年数学
高校生の数学コンテストの問題がほとんど解けなかった
2025年数学
国際数学オリンピックで金メダルの水準に届いた
2026年前半数学
未解決のエルデシュ問題を解き始めた(誰も挑んでいなかった問題で、似た解法も文献にあった、と言われた)
2026年10月ごろ数学
OpenAIのモデルがミレニアム懸賞問題を88時間で解いた
神々の没落について確かなことが一つある。少しずつ落ちるのではない。崩れ落ち、粉々になるのだ。(スタインベック『エデンの東』、Patel氏が引用)
Patel氏も、進歩が反例探しのような確かめやすい部分に偏っていることは認めています。哲学者のToby Ord氏は、AIは証明の自動化を始めたものの、強い問いを立てたり新しい分野を開いたりできる証拠はほとんどない、と書きました。Patel氏はこれを、新しい問いを立てる力がないままミレニアム懸賞問題を解いた、と言い直します。
そのうえでPatel氏は、範囲の決まった問題を解く力は、数学よりAI研究でこそ大きな意味を持つと論じます。 数学の目的は、予想を一つずつ片づけることだけでなく、位相幾何や群論のような新しい考え方で理解を広げることにあります。AI研究では優先順位が逆です。AI企業が気にするのは、新しい手法で学習が効率よくなるか、より賢いモデルができるかで、ここ15年の深層学習の進歩も新しい理論をあまり必要としなかった、とPatel氏は書いています。
例に挙がるのがTransformer(今の大規模言語モデルの基になった仕組み)です。2017年の論文が出る前から、注意機構(attention)も残差接続も知られていました。Patel氏の説明では、Transformerは何年も前から論文にあった部品を組み合わせ、小さな実験を大量に重ねてようやく従来より良くなったものです。 粘り強く何十通りもの組み合わせを試す作業は、AIが数学で見せた得意分野そのものです。Patel氏は、TransformerでさえClaude 7が発明しうる種類のものだと書いています。
ただしPatel氏は、AI研究には数学ほど答えを確かめられない部分もあると認めています。ミレニアム懸賞問題を解くモデルを持つOpenAIが、研究者を解雇していないのはそのためです。それでもPatel氏は、AI研究は最高の人間に並べるほどには確かめられると考えています。 答えを確かめながら何千回も練習できる分野で、AIは数年のうちに「たいていの人間より下手」から「最高の人間より上」になってきました。研究の方向を何年も先に見抜くような確かめられない力も、確かめられる課題で鍛えたモデルが、鍛えていない部分まで伸びると見ています。ミレニアム懸賞問題を解いたモデルも、ほかのミレニアム懸賞問題で練習したわけではありません。
中央値を2028年に置きつつ2027年もありうるとする理由も、Patel氏は書いています。 予測の実績がある研究者たちの中には、来年と見る人がいます。METRの「1年で2倍」をそのままAIの離陸の計算に入れると、2027年になります。Patel氏は、この単純な計算がどこまで正しいかに自信がないので中央値を2028年にした、と説明しています。それでも、来年そうなっても驚くべきではなく、備えておくべきだと書いています。
研究が自動化されると、どれだけ速くなるか
最高の人間に並ぶAI研究者ができれば、アルゴリズムの進歩は大きく速まるとPatel氏は予想しています。 理由に挙げるのは、速さ、賢さ、数の三つです。
自動化されたAI研究者の三つの強み
速い
今のAIでも人間の約10倍の速さで働き、夜も週末も休まない。1週間にこなす仕事は人間の約50倍になる。
賢い
Patel氏の感覚では、ある研究所の進歩の約8割は上位50人ほどが生んでいる。自動化されれば全員がその水準になる。
多い
AI研究は、独立して進めて結果を確かめられる作業が多く、大勢で並列に進めやすい。
速さが50倍でも、実験に使う計算資源は速くならないので、進歩は50倍にはなりません。それでもPatel氏は、速さだけでも今の何倍も速く進むはずだと見ています。人数も同じで、10万人いても100倍にもならないだろうが、桁違いの数がいれば少なくとも2〜3倍にはなるはずだ、と書いています。
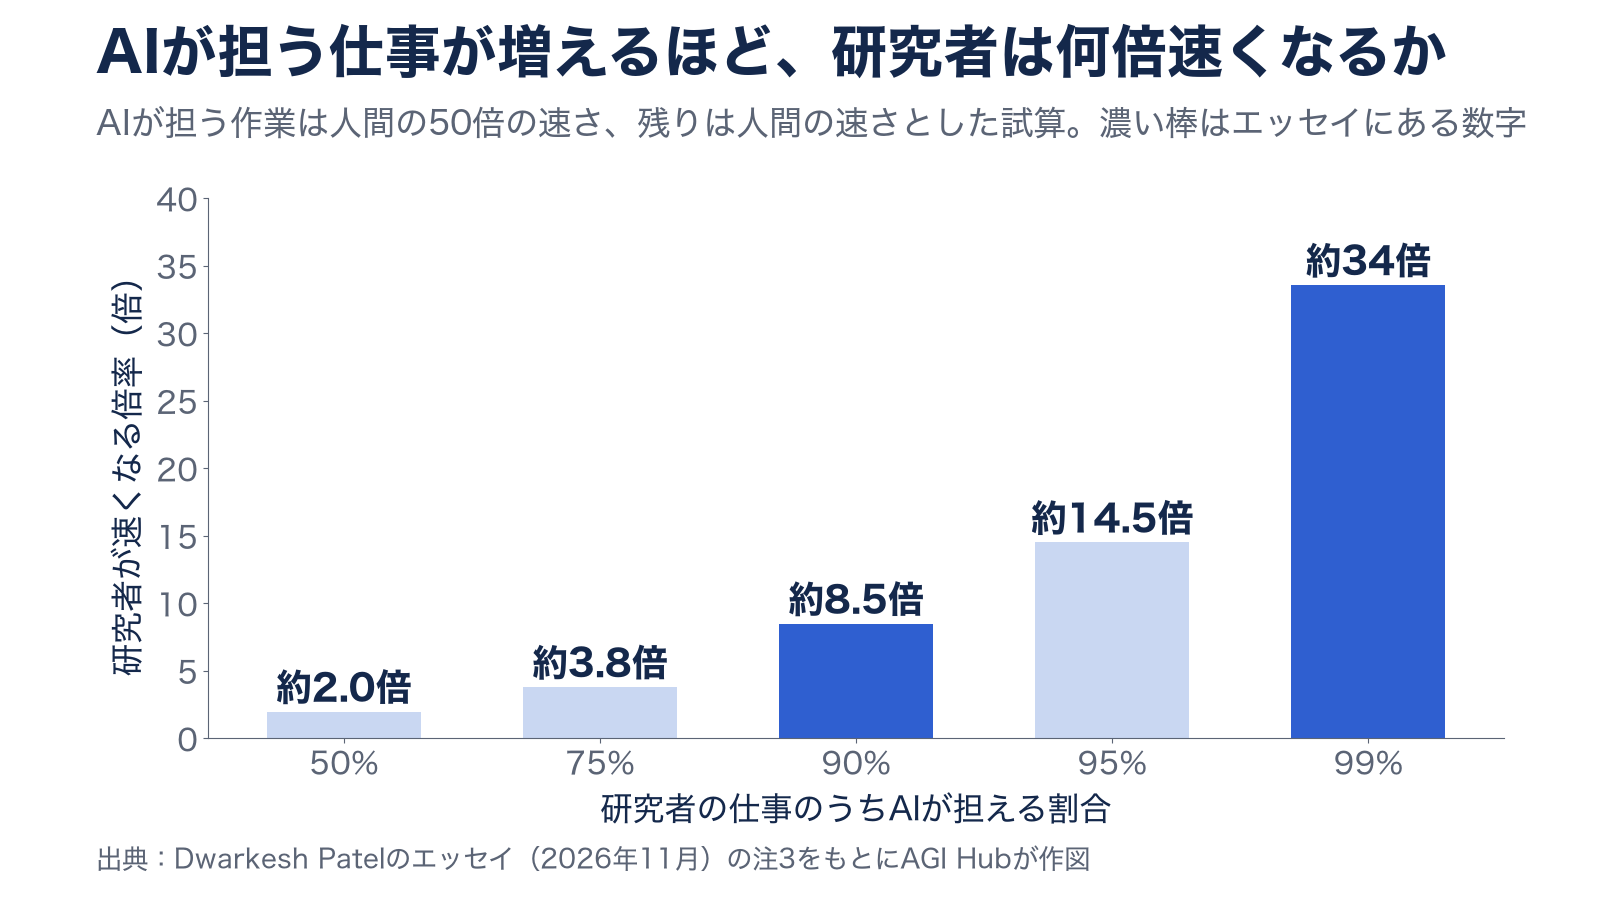
自動化の完成が2032年より後にずれ込む場合でも、その前から開発は大きく速まる、とPatel氏は注で試算しています。AIが担える作業を人間の50倍の速さでこなし、残りは人間の速さのままとすると、AIが半分を担っても研究者は約2倍にしか速くなりません。9割なら約8.5倍、99%なら30倍を超えます。 速くできない残りの作業が全体の速さを決めるためで、アムダールの法則と呼ばれる考え方です。
その先は「シンギュラリティ」か「スパーク」か
Patel氏は、初めの速さより、その速さが続くかどうかのほうが大事だと書いています。 AIは自己改善で速く賢く多くなる一方、簡単なアイデアから先に掘り尽くされ、研究はだんだん難しくなります。今でもAI企業は、同じ速さで進むためだけに、研究用の計算資源を毎年4倍、人員を2倍にしています。AIが賢くなる速さが勝てば、計算資源を増やさなくても進歩が加速し続けます。Patel氏はこれを「ソフトウェアだけのシンギュラリティ」と呼び、アイデアが見つけにくくなる速さが勝つ場合を「スパーク」と呼んでいます。
どちらが勝つかで分かれる二つの未来
スパーク
シンギュラリティ
何が勝つか
スパークアイデアが見つけにくくなる速さ
シンギュラリティAIが賢くなる速さ
最初の1年
スパーク3〜6年分の進歩が1年で起きる
シンギュラリティ計算資源を増やさなくても、AIが次々に賢い自分を作る
その後
スパーク計算資源の増設を待って落ち着く
シンギュラリティ数か月で、今のチップの物理的な限界に近い超知能に届く
確率
スパーク50%
シンギュラリティ50%
Patel氏は、落ち着くほうの「スパーク」でも途方もない変化になると書いています。 自動化の最初の1年で約4年分進むと、GPT-3.5からGPT-6 Astraまでの飛躍が12か月に詰まります。GPT-3.5はまずまずの戯れ歌を書き、簡単なプログラムを補える程度で、ほとんど役に立たないおもちゃでした。Astraはゲームを一から作り、フィールズ賞級の数学の成果を次々に出しています。2027〜2028年からもう一度同じ大きさの飛躍が起きれば、少しでも確かめられる分野では人間をはるかに超える頭脳になるだろう、とPatel氏は予想します。次世代のAIチップの設計でNvidiaを上回り、材料の実験室を遠隔で使えれば、常温超伝導体を探す力で人類全体を上回るだろう、という例を挙げています。
データセンターの外の仕事もこなせるのか
会社の経営、裁判、選挙のように、現実の世界で何年も経験を積んで身につける仕事はどうでしょうか。Patel氏は、あらゆる問題の答えをAIの中身に焼き込めるとは考えていません。代わりに、強化学習(課題に挑ませ、うまくいったやり方を強める学習)を大きくすれば、AIは新しい場面にすぐ慣れる力を身につけると予想しています。
Patel氏の描く知能爆発では、自動化された技術者が今の何万倍もの学習環境を作ります。何百万ものAIが暮らす仮想の経済で会社を立ち上げる、1700年までの資料だけから一般相対性理論を導く、1962年までの新聞記事からキューバ危機の展開を予測する、といった課題です。Patel氏は、そうした課題で、情報を探す、計画を立てる、失敗しても進める、学んだことを覚えておく、といった汎用の力が鍛えられると考えています。
根拠は二つあります。一つは、今の何万分の一の規模の学習でも、すでに応用が利いていることです。Claude CodeやCodexは、初めて見るプロジェクトでも自分で全体の仕組みをつかみ、大きな課題に取り組めます。もう一つは人間の進化です。進化は「遺伝子を残せたか」という粗い基準しか持たない最適化でしたが、サバンナで生き延びるための選別から、伝記を書き、半導体を作り、国を率いる汎用の学習者が生まれました。目的を持って汎用性を鍛えるAIの学習は、進化よりずっと先まで行けるはずだとPatel氏は考えています。
とはいえ、データセンターの中だけですべては学べず、現実の経験も要るとPatel氏は認めています。ただし、必要な経験は何十年分ではなく数年分だと見ています。ナポレオンは27歳までに大国の軍を次々に破り、ロックフェラーは石油業に入って2年で世界有数の製油所を動かしました。AIは並列のコピーで社員全員に聞き取りをし、何年分もの経験を数週間で積めます。そのため、使い始めて数か月で、ほぼすべての分野で人間のトップ水準に届くとPatel氏は予想しています。 中央値のシナリオでは2028〜2029年です。
AI研究は「確かめられる」のか
エッセイの付録は、この予想の前提になっている「AI研究は確かめられる」という主張を説明しています。
Patel氏がまず取り上げるのは、AIが人間に比べてもっとも劣っている点、つまりサンプル効率の悪さです。 ある能力を身につけさせるには、人間が同じことを学ぶよりはるかに多くのデータが要ります。しかしPatel氏は、サンプル効率はどの種類も測れると指摘します。
Patel氏は、サンプル効率と継続学習を、現実のデータから速く効率よく学ぶという同じ問題の表と裏と見ています。 何十年も機械学習でもっとも深い未解決問題とされてきたもので、Patel氏は「AIにとってのミレニアム懸賞問題」と呼びます。そして、数学が示したとおり、難しい問題でも答えを確かめられるならAIが解いていく、と主張します。
AI研究全体についても、Patel氏は三つの分野それぞれに確かめられる指標があると書いています。
AI研究の三つの分野と、確かめられる指標
1事前学習
小さなモデルを決まった損失まで学習させるのに要る計算量を、どれだけ減らせるか。公開の競技「nanoGPT speedrun」がすでにある。小さな規模の改善が大きな規模でも通用するかを当てる「研究のセンス」も、課題にして鍛えられる。
2事後学習
事前学習のあと課題をこなして鍛える段階。新しい環境で学ばせるのに要る計算やデータ、時間と、見たことのないゲームにどれだけ速く慣れるかを測れる。Anthropicは、研究者がその年に解いた約500の実際の問題を集めた社内ベンチマークを持っている。
3推論の効率
作ったモデルを動かす段階。GPUの使用率、処理の速さ、1回の計算量など、すぐに測れる数字が並ぶ。
四つの反論とPatel氏の答え
Patel氏は、ボトルネックは深刻で、もっとも急な展開の確率を下げると認めています。 そのうえで、瓶の首は思ったより広いと書き、四つの反論に答えています。
よくある反論への答え
1継続学習がないから無理では?
今の作りのまま、会話の中で学べる期間を何か月分にも伸ばせば足りるかもしれない。継続学習の研究自体も確かめられる問題なので、記憶を持たないままでも、今より1〜2年分賢くなったモデルなら解けるかもしれない。ただし、ここが壁になる可能性は本当にあり、「2032年より後になる確率25%」の理由になっている。
2何を指標にするかは決められないのでは?
Transformerも推論モデルも、既存の翻訳や数学、コードのベンチマークで効果が見えた。ミレニアム懸賞問題をいくつ解けるか、のようにやり方に左右されない指標も作れる。Patel氏は、これが理由で自己改善が大した結果にならないとしたら「とても驚く」と書いている。
3データが足りなくなるのでは?
良い学習データを作ることも機械学習の研究課題で、AI自身が担える。Patel氏らの調べでは、この6年の事前学習の進歩のうち、データの改善による分はモデルの改善による分の3倍を超えていた。DeepSeekも、事後学習の伸びはほぼすべて合成データと学習環境の改善から来たと書いている。
4実験用の計算資源が足りなくなるのでは?
最先端の研究所の計算資源は毎年4倍以上に増えている。この増加が続けば、2027年末のOpenAIは数千のエージェントに毎日1回ずつGPT-3規模の学習をさせられる。2017年のTransformer論文の最終モデルは、今なら約50ドルで学習できる規模だった。
実験の反論について、Patel氏は、今の研究所の計算資源の使い方は研究者の時間が足りないことを前提にしたものだ、と指摘します。 トップ研究者には年に何億ドルもの報酬が払われ、その時間を節約するために、実験では計算資源を惜しまず使っています。研究者の時間が余り、計算資源のほうが足りなくなれば、丁寧な小さな実験を増やすなど、使い方そのものが変わるとPatel氏は見ています。
有路翔太のQ&Aで続きを読む(4問)
実験の壁については、AGI Hubの共同代表の有路翔太と神楽坂やちま、主任研究員の林央も社内の議論で論じています。
この予想の前提
Patel氏の予想は、AI企業が意図して開発を遅らせないことを前提にしています。 自動化されたAI研究者の登場を2028年とする中央値にも、この条件が添えられています。研究の自動化がそのまま進めば、スパークでも数年、シンギュラリティなら数か月で、Patel氏が「チンパンジーに対する私たちのような存在」とたとえる超知能に届きます。Patel氏は次のエッセイで、こうした頭脳がどんなものになり、世界をどう変えるかを書くと予告しています。
ここからはAGI Hubの見方です。この条件を人間が選べるうちに、開発の速さをどう決めるかが問われていると私たちは考えます。 開発を止める仕組みについては、『Hardwired Pause』報告書の解説にまとめました。