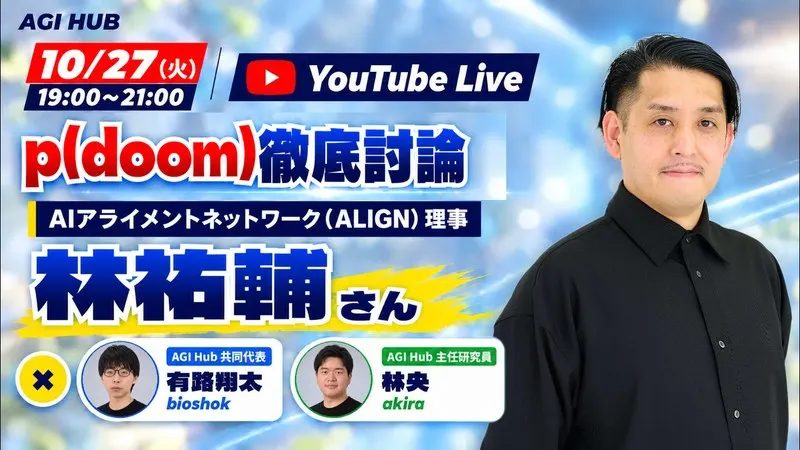
AGI Hub公式YouTubeで2026年10月27日に配信した討論を、AGI Hub編集部が書き起こしました。言いよどみと言い直しを除いて整えましたが、発言の中身は変えていません。用語注釈は編集部が加えたものです。各話者の見解や個人の将来予測を含みます。原文(AGI Hub YouTube)はこちら。
この書き起こしについて
2026年10月27日19時から、AGI Hub公式YouTubeで「p(doom)徹底討論コラボ企画」を配信しました。ゲストは、一般社団法人AIアライメントネットワーク(ALIGN)理事の林祐輔さんです。AIの研究開発とアラインメント研究の両方に関わってきた林祐輔さんと、「AIの開発停止をしなければ人類滅亡はほぼ確実」と考える主任研究員 林央(akira)、共同代表 有路翔太(bioshok)が、p(doom)(AIによって人類が破滅する確率)について話し合いました。予定の2時間を大きく超え、約3時間40分の議論になりました。本記事はその全文に用語注釈を付けた解説付き書き起こしで、事前知識がなくても読めるようにしています。
配信の録画はYouTubeで見られます。章ごとの「動画で見る」のリンクから、その場面の録画を開けます。発言の横の時刻は録画の中の時刻です。
書き起こしは音声認識で作り、言いよどみと言い直しを除いて整えました。発言の中身は変えていません。配信の冒頭の接続確認は省いています。聞き取れなかった語には「(〜?)」や「[聞き取れず]」の印を付けました。声と文脈から話し手を決められなかった発言は「話者不明」としています。
対談動画
人物紹介
林祐輔さん
一般社団法人AIアライメントネットワーク(ALIGN)理事。企業研究者としてデータ活用の支援やAIの研究開発に携わりながら、独立研究者としても活動しています。人工生命国際研究機構(ALife Institute)研究員、Humanity Brainの最高研究責任者(CRO)も務めています。以前は日本銀行のエコノミストでした。
X: @hayashiyus
有路翔太(bioshok)
AGI Hub共同代表。東京大学大学院で自然言語処理を研究し、修了しました。AIのインパクトとリスクについて発信を続けており、著書に『知能爆発』『AIのもたらす深刻なリスクとその歴史的背景』があります。
X: @bioshok3
林央(akira)
AGI Hub共同創業者・主任研究員(Chief Alignment Officer)。東京大学在学中にAI安全性のコミュニティを立ち上げました。いまの開発競争が続けば人類が絶滅する確率はきわめて高いと公に評価しており、AGI Hubではアラインメント分野の調査と発信を担当しています。
X: @Align_ASI
この討論の見どころ
前半は、企業どうしの競争がAIのマルチエージェント化を進めるという見立てから始まり、再帰的自己改善を一国が独占する危うさと、AIの開発停止がどこまで実現できるかへ進みます。p(doom)を実験で確かめられるかという問いには、林祐輔さんが、将来起きる失敗をいまのモデルでわざと先に起こして調べる研究(ミスアラインメントオーガニズム)の意義を話します。林央は、研究よりもロビー活動を選ぶ理由と、その中で実験結果や事故の報告がどれほど役立つかを語ります。
中盤は、ユドコウスキーの直感をだれもが使える理論にできるかという話題から、アラインメントの形式化、AIの内部に介入して振る舞いを変えるステアリング、敵対的攻撃への弱さ、シャノンの通信理論から見た人間とAIの「意味」のずれへと、技術の議論が深まります。米中の開発停止をどう促すか、実証研究を政策につなぐには何が要るかも話し合います。
後半は、AIが世界の見方を変えたときに目標を保てるかを問うオントロジー同定問題と「ダイヤモンド最大化」の思考実験、サイバー攻撃やバイオ分野でのAIの悪用とオープンモデルの規制、悪用への対策に追われて暴走のリスクが見えにくくなるおそれを議論します。最後は、絶滅リスクとどう向き合うか、研究を動かす好奇心、日本の近代化の歴史とAI時代の価値観にまで話が広がりました。
書き起こし本文(敬称略)
オープニング、林祐輔さんの紹介
有路翔太開始 0:55
皆さんどうもこんにちは。AGI Hubのbioshokと、akiraさんと、あとAIアライメントネットワーク(ALIGN)理事、ALife Instituteの林祐輔さんです。よろしくお願いします。
林祐輔開始 1:15
よろしくお願いします。
有路翔太開始 1:17
この林祐輔さんは多分日本で最もAIアラインメント研究の最前線を切り開いている方なので。
林祐輔開始 1:28
いや、(もう思ってない?)と思いますけど。
有路翔太開始 1:30
いや、そう思っておりますが。
林祐輔開始 1:34
熱意はあると思います。逆に言うと、お二人が知能爆発論とか、Xリスク、p(doom)の議論のフロントランナーだと思ってます。日本の。
有路翔太開始 1:46
ありがとうございます。
林央開始 1:50
世界的にはエリーザー・ユドコウスキーが先走りすぎてて、(間に走っても?)エリーザー・ユドコウスキーを超えられないという。
林祐輔開始 1:58
20年ぐらい先行してますよね。
話者不明開始 2:04
よく分からないのに、エリーザー・ユドコウスキーは。
林祐輔開始 2:06
資金を集めるのもそうですけど、やっぱり追い越さないといけないんじゃないですか。
林央開始 2:12
そうですね。最近は(意外とうまくいったような?)、開発停止のほうにリソース配分が多くなってます。タイムラインが短くなってるので。
有路翔太開始 2:26
まず開発を停止しないと研究もできないんじゃないかみたいな、世界的な雰囲気になりつつあったりするので。
僕たちはあれですね。林祐輔さんは多分この数日、AIコンシャスネスのカンファレンスに行っていたらしいのが。
林祐輔開始 2:47
お邪魔しました。
有路翔太開始 2:49
すごい、そうそうたるメンツが。金井さんとか、渡辺さんとか、池上さんとか、鈴木さんとか。
林祐輔開始 3:00
(鈴木恵介?)先生とか、(鈴木恵介?)さんも登壇されてらっしゃいましたね。
有路翔太開始 3:07
行きたかったんですけど、その時、論壇フェスっていうのが伊豆で行われてて。
林祐輔開始 3:13
お二人もめっちゃ忙しいから来れなかったんだろうなっていうのは。特にbioshokさんはそうなんじゃないかなって、(有美?)さんはそうなんじゃないかなって思ってますね。
有路翔太開始 3:23
akiraさんも普通に一緒に伊豆に行ってて。
林祐輔開始 3:27
お二人もね。ちょうど日曜の夕方に、akiraさんが(宮内?)さんと対談されたっていう感じだったんですよね。
林央開始 3:40
日曜の夜のあのセッションだけだったんですけど、昼ごろに現地に伺って、ところどころいろんな配信に参加しながらって感じでした。
有路翔太開始 3:51
やっぱりすごいいろんな言論人というか、そういう日本語で割といろんな有名な人とか、津田大介さんでしたっけ、(宮田大?)さんとかダースレイダーさんとか。そういう論客系の人も、すごい今、人類の絶滅についてすごい気になってるみたいで、akiraさんが全員に布教していましたね。
林央開始 4:27
ほぼずっと話してました。
林祐輔開始 4:30
でもこの数週間って、AIの危険性を話す上では結構追い風が吹いてるんじゃないですか。ここ最近は。
林央開始 4:46
悪用と暴走の話を区別してるんだということを強調するのはしないといけないんですけど、かなり追い風が吹いてると思いますね。この先しばらくは吹き続けるんじゃないかと思ってますけど。嬉しいのか嬉しくないのかよく分かんないですが、(見続ける?)と思ってます。
有路翔太開始 5:06
いつもこのAGI Hubのチャンネルは、割とそんなにアジェンダとか流れとか決めずに、ざっくばらんに話そうみたいな感じで進むので。ざっくり、林さんは研究の話とか、すごいこういうことしようみたいなことをやりたいって、(辛く言った?)ような気がするんですけど。
林祐輔開始 5:31
僕もそういう話をしようかなと思っています。最後の30分か20分ぐらい、もうみんなで研究しようぜって話で。
林央開始 5:43
最初からいいんじゃないですか、それで。正直、議論ってほとんど実証待ちぐらいまで狭まってる気がしますし、もうちょっと(ジョーク?)が出てきて、あと多分、不確実性の見積もりとかじゃないですか、基本的な意見の差って。
なので、そこは基本的に割とポリシーも収束しているような感じがあるので、そこについて議論をするよりも、多分そっちは実証待ちにして、もっと研究の話とかそういう話をした方が面白いんじゃないかと思いますね。それか、気になってる話を互いにしてみるとか。
企業間競争はなぜマルチエージェント化を促すのか
林祐輔開始 6:31
そうですね。どっから始めたらいいんだろうな。
林央開始 6:36
せっかくなので、適当な入り口としてマルチエージェント****の話でもします? そういえばXでポストされてましたよね。なぜマルチエージェントにシフトしたのかみたいな。
林祐輔開始 6:46
はい、そうなんですよ。そこ気になっていて。逆に(有美?)さんだったかな、必ずしもマルチエージェントっていうのがHugging Face事件の鍵じゃなかったかもしれないっていうのを。
有路翔太開始 7:04
[聞き取れず]。誰が言ったか覚えてないですけど、ノーム・ブラウンの。
話者不明開始 7:10
ノーム・ブラウンですね。
林央開始 7:14
OpenAIの中でマルチエージェントを結構主導してきた人が言ってましたね。基本的に彼の立場としては、マルチエージェントの効果というのはそれほど大きくないっていう話でしたね。
基本的に最も重要なところは、OpenAIが非常に強力なモデルを作ることができたというところにあって、それをよりうまく利用する方法としてマルチエージェントがあるみたいな発想でしたね。彼の見方としては、基本的に並列化による高速化みたいなところにあるらしい。
林祐輔開始 7:52
そうすると、推論スケーリング****をより早く進めることができるみたいな、そういう。
林央開始 8:01
(ラジャンコジュアン?)とか、自分は割と並列化のところにメインがある気がしています。
元々のイメージ、元々の昔の像との違い。元々ある程度マルチエージェントって、『スーパーインテリジェンス』でも(1章?)丸ごとを割かれるぐらいには、[聞き取れず]ありましたけど、やっぱりここ最近マルチエージェントが強い時は、結局企業間競争が意外と拮抗してるからだと思うんですよね。
[聞き取れず]マルチエージェントの有無によらず、多分例えば仮に1万トークン・パー・セックとかで動く最新モデルがあって、いう場合って、多分基本的にマルチエージェントと同じくらいの成果を出せると思うんです。要するにマルチエージェントで並列化してる分を1モデルに押し込むっていう話なんですけど。そうすると基本的に多分、最も効果があるのって、今あるモデルからできるだけ早く性能を引き出すってところにあると思うんです。
最近になって推論スケーリングって、最近って言っても結構前ですけど、[聞き取れず]じゃないですか。マルチエージェントにすると、それが倍の速さでとか、n倍の速さでできるだろうって話があると思ってて。そうすると企業間競争でやっぱり一番効くなと思っていて。
例えば極端なケースとして、OpenAIが1年先行していて、Anthropicとかそれ以外全部1年遅れてたら、多分OpenAIはマルチエージェントしようとしないと思うんですよ。シンプルに一番強いモデルでどんどん新しい成果が出て、多分いっぱい実行するより、もうちょっと待って次のモデル作った方が性能いいでしょうみたいな意見に多分なると思うんですよね。
ただ一方で、今の状態だとやっぱりOpenAIとAnthropicって拮抗しつつ、拮抗状態にあって、多分かなり後ろの企業も近づいてるじゃないですか。そうなると相手より早く出すためには、やっぱりできるだけ早くやらなきゃいけないですし。
次のモデルを待つより経済的なのかみたいな話があった中で、競争っていう相対ゲームになった瞬間に、相手より少しでも勝つっていう要素が、前より採算性が低くてもマージナルにすごい価値を持つようになったんじゃないかと思ってます。
林祐輔開始 10:28
その説明は結構僕にはすごい納得感があって。そうだよね、競争が多エージェント化の圧力になるっていうのはそうかもね。
つまり1個のエージェントが推論をして次のアクションを取るっていうことをやるときに、一定の最小の時間単位があるっていうか、次のアクションを取るまでに一定の時間単位があるとすると、マルチエージェント化をしないと、並列化をしないと高速化できないっていう。競争圧力があると並列化をする圧力になるので、エージェント化になっていく。
林央開始 11:09
最近特にミレニアム問題とか、今日朝も何でしたっけ、複数の問題が解かれたんじゃないかみたいな話で結構盛り上がってましたね。コンピューターサイエンス、何でしたっけ。
話者不明開始 11:18
エクスポネンシャル・タイム・ハイポセシスでしょ。[聞き取れず]ETHでしょ。
それ、指数時間。そう。で、それに対しては(社系大のいいのn割るログルートログエンド?)でいけるみたいな方法が提示されたみたいな話でした。
林央開始 11:40
ああいう話も、直後にAnthropicが「実は自分も見つけてました」みたいな話が出るじゃないですか。多分結構拮抗してて、予算を何倍つぎ込んででも相手より早い方が大事みたいな雰囲気になるんだと思いますね。OpenAIもそれで数学者から怒られたりしてるじゃないですか。
そういう雰囲気の中だとやっぱり、相対ゲームに勝つって意味だとマルチエージェントってすごい強いと思います。
林祐輔開始 12:10
ボストロムの『スーパーインテリジェンス』読んだ時もちょっと思ったけど、そうなってくるとオープンサイエンスじゃなくなっていくっていうか、より高い知能を持ったAIを持った企業が世界に先んじて、新しい科学の法則を発見するみたいなことがずっと起こっていって。それ言っちゃうと他者との競争力を失われてしまうので、みんな自社に囲い込むみたいなことになると、どっちが早く金を作る方法を見つけるかって競い合ってた錬金術の世界に戻っちゃうっていう。
林央開始 12:41
そうなんですよね。なので昔からの古典的なモデルのズレの一つとして競争の有無があって、もう一つは外部から意味を実感できる領域での時間の長さが変わったっていうのがあると思うんですね。要するにタイムラインとテイクオフの組み合わせみたいな話ですけど。
基本的にやっぱりニック・ボストロムの頃の想定って、そこまで賢くないAIを作ってから、それを起点にしてすごい短期間で賢いレベルまで行くって話じゃないですか。そうすると、マルチエージェントで高速化とか言ってる以前に、もっと早くもっと賢いやつくれよっていう話だったと思うんですね。要するにGPT-2とか3を何個並列化しちゃうと、あんまり役立たないじゃないですか。
マルチエージェントって、多分もっと、それこそスーパーインテリジェントみたいなレベルだったら、人間がマルチエージェントの(方?)を組まなくても、必要に応じて勝手に自分でインスタンス[聞き取れず]くれると思うんですね。
人間が外からマルチエージェントっていうのを作ろうとか、訓練しようとする動機がある能力帯って、実はそこまで広くないんじゃないかと思っていて。要するに並列化して、人間から見て意味があるほどの加速が得られて、かつAI自身が自分でマルチエージェントを人間の介入なしに発明するほどは賢くないという領域にあるじゃないですか、マルチエージェントを外から適用する意味って。そうすると多分、昔の想定ってこの期間があまり長くなかったんだと思います。
林祐輔開始 14:21
だからボストロムのシナリオの分け方って、マルチエージェントになるかもしれんけど不安定で、結局シングルトンになりがちっていうような話があったと思うんだけど。それって結構多分、知能の上がり方のカーブに依存した議論かもしれなくて。
我々のこの世界でもシングルトンに収束する可能性はゼロではないと思うんだけど、今のところは今akira君が言ってくれたように、様々な企業が競争する中で、マルチエージェントでRSIとか役割分担をして、社会として超知能を実装しようっていう方向にシフトしつつあるように見えているので、今の説明ってすごいメイクセンスでした。
再帰的自己改善の独占とAI開発停止の実現可能性
林央開始 15:08
個人的には、この先AIが一般に開放されないんじゃないかという懸念を少し持っていて。RSIが始まったら多分、一般に(コンピューター?)なんて提供してないで、RSIに全部つぎ込みなさいみたいな話になると思うんですよね。となると一般[聞き取れず]って全然開放されないじゃないですか。
そうすると突然、昔のしょぼいモデルとかしか提供されないまま止まって、AI開発止まったのかなと思ってたら、裏でものすごいRSIが全力で進んでるみたいな状況になりかねないですよね。それは結構(浴びたれる?)観点から望ましくない。
なのでRSIを防ぐぐらいしか、今のところ[聞き取れず]と思いますけど。
林祐輔開始 15:55
僕も開発停止っていう方向性についてはすごく同感なんですけど、一方でよく言われるのは、囚人のジレンマ構造があるっていう話があるじゃないですか。理念というか方向性としては多くの人が同意する一方で、現実性についてはかなり悲観的な立場を取る人が多いっていう認識なんですよね。
その中でも特に今akira君が言ってくれたようなシナリオっていうのは、ありそうな悲観(視点?)で、嫌なシナリオだと思って。嫌なシナリオなんだけど、確かにそれはそうだな。だって計算資源をなるべく独占して、いち早くRSIをどんどん先まで進めた方が、[聞き取れず]なるっていうことが競争力の源泉になるもんな。
林央開始 16:44
そうすると一般人の普通の用途に提供するのって、多分[聞き取れず]。ただ、やっぱ企業なんで、それを受け入れるかどうかみたいな話はありますけど。国家が介入して、AI 2027のレースシナリオみたいな世界になってくると、多分「いやいや、もうそんな民間に提供しなくていいから、全力でRSIやってください」みたいになる。結構懸念してますね。
一方で開発停止の可能性って観点で、今のデータセンターって大きいので、衛星でトラックできるはずなんですね。かなり簡単にトラックできるじゃないですか。そうすると、こっそり開発……。国際的な合意が政治的意思によってできるという前提のもとではありますけど、互いに止まってるかどうかって、国際的な視察団を作るなりなんなりして、一定以上のサイズのデータセンターにそういう視察団を置いておけば、囚人のジレンマ状態が回避できると思う。
開発停止を破っていたらうちの視察団が気づいてるはずだし、監視の対象になってないデータセンターは10の20乗フロップスより下だろう。そういう読みができるみたいな感じを期待していますね。っていう感じですかね、実行可能性の期待としては。
有路翔太開始 18:06
結構akiraさんが面白いなというか、すごい一貫してるなって思ったのは、たとえakiraさんが20世紀にいたとしてもこの主張をするし、GPT-2の段階でもこの主張するっていうふうに前言っていたので。そこら辺話してみると面白いかもしれない。開発停止の時期と。
林央開始 18:27
それってそんなに特別なことを言ってるわけじゃなくて、GPT-2から先の知識がないという前提だったので。そうすると閾値がどこにあるか分からない。閾値っていうか、突然加速するかもしれない。まで行ってなくても、自分で逃げちゃって人間にシャットダウンができなくなるレベルかもしれないとか。
そういうことを考慮すると、[聞き取れず]この能力(ない?)より下にいますよみたいな保証がないうちはやるべきじゃないっていう考えなので、それはある意味リスク選好****の態度に近い気がします。結局、個人の選好に帰着するんじゃないかと思っています。
(自分が来年に?)いつも気になってます。このマルチエージェントが潰れる話っていうのは何なんですかね。実はあんまり納得していなくて、マルチエージェントが潰れる説に。あんまり主張を理解していなくて、おそらく。
林祐輔開始 19:32
マルチエージェントが潰れる説っていうのは何でしたっけ。
林央開始 19:32
マルチエージェントが潰れてシングルトンになるみたいな説が、時々批判の対象として聞くんですけど。そもそもその主張の本体をあまり見かけたことがないというか、多分あまり気にしないのかもしれないですけど。どういう主張なのか。
林祐輔開始 19:52
集合知として高い能力を発揮するシステムがあったとしても、1体のエージェントでその集合知を上回るような能力を持つエージェントが現れると、エネルギー的な有利性だったり、合意形成にかかる時間効率の有利性だったりで、結局シングルトンが、より高い能力を持った単一のエージェントが勝つんじゃないかっていうような、(濃くな?)予測なのかなっていうふうに僕は。
林央開始 20:25
それは、そう考えると割と多少共感的ですね、その主張に対して。ただ実際シングルトンのシナリオで起きるとしたら、やっぱりそれは最初に賢くなって優位性を獲得したAIが、自分自身のコピーを量産することによってマルチエージェントに勝つ。マルチエージェントっていうか、マルチエージェントではあるんですけど、に勝つみたいなシナリオに落ち着くような気がしますね。
結局、決定的な能力の差がどれくらい出るかってところによるので、それは結構シナリオ依存になる話ですよね。僕は基本的にいろんなシナリオの可能性があると思ってますけど、その過程で大抵全部人類が死ぬという感じなので。
話者不明開始 21:12
(絶滅をしてます?)よね。
林央開始 21:13
意外と細かいところはあまり(コンフィレンス?)じゃないですね。
意外と起きやすいんじゃないかと思ってますね。数種類っていうか、完全にシングルエージェントじゃなくても、非常に少数だったら多分それの寡頭制みたいな[聞き取れず]に収束するっていうのは結構あると思いますね。
それからマルチエージェント、複数の寡頭であっても、多数いても、多分寡頭の方が簡単だと思うんですけど。AI 2027みたいに互いにバラバラのエージェントとして存在して別々の目的を追求していると、対立の可能性があってややこしいから、両方の目的を一定の配分で追求する単一種類のエージェントを一緒にデザインして、それに置き換えようみたいな話に切り替わるみたいな意味で落ち着くっていうのは、結構あるような気がします。
有路翔太開始 22:12
コンセンサス1ってやつでしたっけ。
林央開始 22:15
そうですね。AI 2027だと、アメリカのやつと中国のやつが対立とかするんじゃなくて、一緒にそれぞれの目標を追求する単一のAIを作りましょうってなってましたよね。
林祐輔開始 22:32
今、akira君が話してくれているシナリオっていうのかな、思考実験っていうのかな、すごく面白くて。有路君と議論するときにも、有路君からもそういう議論を教えてもらうことがあって、自分では考えないようなシナリオだったり可能性っていうのをそれぞれ検討しているので、面白いなと思っているんだけど。やっぱり個人的には(香川さん?)の話にしたいなって言って、冒頭そういう話しようぜって話してたんだけど。
冒頭、マシンコンシャスネスだったり、講演の(方針会?)にも参加させてもらったっていうのもあったんだけど、特にマシンコンシャスネスの意識研究会に行って、すごく良かったなっていうふうに思っていて。
個人的にすごく衝撃だったのが、池上先生が土曜日に発してた言葉で、LLMが数学とか物理学の未解決問題をバサバサ解き始めたと。研究者もそうだし博士課程の学生さんたちとかも、「これから我々はどうやって物理学とか数学の研究っていうのをやっていけばいいんだ」って言って、すごく根本的なところまで立ち返って、我々どうしていけばいいんだっていうような議論が行われてる。それなのに意識研究は変わらなくていいのかっていう問題提起をされていて。
これだけ権威っていうか業界の第一人者みたいになった方が、「俺たちこのままでいいのか」って問題提起するっていうのが、かっこいいなっていうふうに思ったんですね。そういう意味で、おそらくほとんどの領域がかなり今までとは違うことをやらないといけないんじゃないかっていうふうに、僕はエネルギーをもらったっていうか、ショックをもらったっていう感じがして。逆に言うと、もう新しいこと始めないとダメだみたいな(などのうちに?)慣れたっていう感じだったんですね。
LLM時代の科学者の役割と社会の信頼が壊れる危機
有路翔太開始 25:41
早朝Slackで、もうLLM青年たちに複雑系(かけったら?)負けるんじゃないかみたいな、言ってません?
林祐輔開始 25:49
そうなんだよ。ロマンティックサイエンス1.0ってもう負けたんだよ。LLM研究、別にそんなサイエンスめちゃくちゃやってなくても、とりあえずスケーリングさせていけば未解決問題バサバサ解くところまでいっちゃったっていうことなんだから。
紙とペンでアインシュタインみたいな天才科学者が一人でずっと書斎の中で悩んでいると、未解決問題が一個解けるみたいな世界はもう終わったんだと思うんだよね。僕はそれがある意味ものすごく心が痛いというか、悔しいという思いも素直に持っていて。
そういう科学に対する憧れを、このLLMが誕生して、さらには超知能さえ生まれてくるような時代で、新しい生き方というか(キリッチ?)を見つけないといけないんじゃないかというか。ロマンティックサイエンス2.0の逆襲を。でもそのためには、ロマンティックサイエンス1.0を1回爆破しようっていう気持ちになったっていう。もう終わりだみたいな、全部爆破だみたいな。
話者不明開始 27:11
すごい(宮内さん?)みたいなこと言った。
林祐輔開始 27:13
そうなんだ。だから『ファイト・クラブ』のラストシーンとか僕好きなんですよ。クレジットカード会社をバーンって爆破するみたいなシーンとか、すごいパンクで好きだなと思ってたんですけど、それに近い。
だってサイバー攻撃とかまさにそうですよね。ここにちょうど書いてますけど、信用の連鎖って、トラストチェーンを破壊してるわけですよね、サイバー攻撃が。
有路翔太開始 27:41
まずこの1ヶ月前とか、全然牧歌的な雰囲気だった。いきなり変わってきますよね、雰囲気が。
林央開始 27:50
インターネットを放棄するかみたいな論さえ。
有路翔太開始 27:53
話が始まってますね。『ミッション:インポッシブル』の最新作でも、CIAとかがハードディスクドライブにある全てのやつをタイプライター、[聞き取れず]。
林央開始 28:09
全部[聞き取れず]みたいな。もしかすると、もう取引履歴全部紙に書いて出しておくんだって世界観があったかもしれないですよ。ただ、その紙って偽造できるんじゃないとか言われるので、結局微妙なところあると思います。
林祐輔開始 28:22
そうだよね。人間社会の根っこに信用の取引っていう、信用があるからこそ取引が行われるっていう信頼っていうものがあって、トラストっていうものがあって。
僕ってもともと日本銀行っていって、みなし公務員っていうんだけど、公務員じゃないんだけど公務員的に扱われますよっていう、変わった政府の銀行みたいなところにいたんですけど。あそこの業務の一つが銀行を守るっていうことなんですよね。つまり社会の信用を守るっていうか。人と人との信用が、企業と企業の信用があるから、お金のやり取りっていうのが銀行を通して安定して行われていて、銀行が倒産するとその信用の鎖が切れるわけです。それを防ぐっていうのがミッションの一つだったので。
林央開始 29:20
リーマンショックの時のFRBとかも、全力でそういう感じのことをやってました。
林祐輔開始 29:26
だから実は超知能の議論とか、ニック・ボストロムの超知能の議論とかを読んだり、サイバー攻撃の可能性っていう議論を聞いた時に、僕が一番最初に思い浮かぶのは信用の連鎖が切られるっていう。そうすると金融の世界だけじゃなくて、物流とかほとんどの社会的な行為が破綻してしまうっていうリスクだったんですよね。
それは嫌だなっていう。ラストシーンが好きな人間なんだけど、トラストチェーンが壊されるのは嫌だっていう、変な人間の感じですけど。
林央開始 30:06
見るのは面白いけど、自分の身にかかるのはやめてほしいみたいな感じですよね。
林祐輔開始 30:10
その通り。カオス好きなんですよ。混沌大好きなんですけど、まさか自分が生きてる間に明治維新とかフランス革命とか産業革命を10年ぐらいに圧縮した人類史上の大事件が起こるとは思ってなかったんですよ。我々今、それを体験してるじゃないですか、リアルタイムで。
林央開始 30:31
当事者じゃないと嬉しいかもしれない。
林祐輔開始 30:34
映画で見る分には楽しいけど。歴史の授業とか受けたときにフランス革命とか聞いて、すげえなみたいな、こういう時代に生きてたら俺も面白い体験できたんじゃないかって呑気に思ってたんだけど、それよりもさらにすごいような革命の時代に生きてしまったってことに、たじろいでいる感じ。
有路翔太開始 30:57
清水亮さんと(ロンダンフェス?)で話したんですけど、あの人はマジでdoomerにめちゃくちゃ批判的で。「そんなことを(起こる前に?)、お前LLM実装しろよ」みたいな雰囲気の話だったんですけど。だから僕はめっちゃガチ批判されて、雰囲気がやばかったんですけど。でも最後は「輪廻転生信じてるんで」とか、謎すぎる結託を起こしたんですけど。
でも清水亮さんは、数学的に形式検証っていうのがあるらしくて。サイバーセキュリティってすごい経験主義というか、テストしてプログラムがバグないかっていうのを調べる今の手法じゃなくて、数学的にこの範囲なら絶対に安全ですよというか、こういう振る舞いになりますよっていうことを保証することをやろうとしてるみたいで。それがどこまでいくのかわからないですけど、そういうことをAnthropicもやろうとしてますよね。
大量のトークンを使って、今までは不可能だった形式検証をスケールして、ある仕様の下では一応こういう振る舞いをするよってことを、全てのソフトウェアに保証するみたいな。そういうことをしていく。
まず多分オープンソースを禁止するじゃないですか、多分今後世界が。
話者不明開始 32:29
それは起きそうですね。
有路翔太開始 32:31
禁止しないとあらゆるところがハッキングされて終わってくみたいな。
林祐輔開始 32:35
オープンソースも終わるよね。
有路翔太開始 32:36
多分米中禁止して、その後に防御側がどんどん強くならないといけないんで、データセンター建てまくって、サイバーセキュリティの加速をしていかなきゃいけないっていう。(確保?)、しかも検証でやろうみたいなことが起こるのかなみたいなふうに思ってるんですけど。
でも最近OpenAIが、そんなソフトウェア上で通信ができなくてもハードウェアレベルでハッキングされちゃうっていうのが10個ぐらい羅列されてて。CPUのキャッシュの速度を利用して、お互いソフトウェア上では仮想的に通信が禁止されているエージェント同士が、ハードウェアレベルの脆弱性をついて、お互い情報を受け渡しできるっていう。こんなことで。そういう脆弱性が9個ぐらい、数日前に内部モデルが発見したらしいんですよね。
だから多分、もうそろそろ半年ぐらい遅れてるみたいなんで、中国が。だからもうそろそろオープンソースを禁止するか規制するかしないと、多分そういう形式検証さえも乗り越えられていくというのが起こったら、結構もう大体銀行とかハッキングされちゃうんじゃないかとか。
林祐輔開始 34:08
そうするとLLM使った研究すら、もう米中の特定の機関以外はできないっていう、すごいディストピアみたいになっちゃうね。
でもさっき有路さんが清水亮さんに批判されたっていう話があって、僕も知能爆発論とかp(doom)論に対して批判をすることは、お二人はもちろん知ってるんだけど、あったし、今も納得してない部分もあるんだけど。
ただ一方で、知能爆発論とかp(doom)論はまだ起こってない将来のことについての言説なので、観測データから仮説を検証するっていう科学のフォーマットに乗らないっていう部分で、論理に検証しきれてない部分っていうのがあるっていうのは僕は言えると思ってます。
ただ一方で、最近のサイバー攻撃によって個人情報の流出が起こったりっていうところが加速していくと、例えばイギリスの国防省が「備蓄をしてください、水とか食料の備蓄をしてください」ってアナウンスをしたなんていう話もあるように、サイバー攻撃以外の領域でも、今後AIを使った人間の悪用っていう段階だけど、リスクがどんどん加速していくっていうのは、多くの人にもほぼ確実に起こるってことが認められるようになってきたっていう意味では。
この産業爆発論とか知能爆発論、あるいはdoomerの人たちを批判する側の人たちの言説っていうのも、徐々に1年、半年、直近3ヶ月強とかっていうので、どんどん言説が移ってきてるっていうのは公平に見てそうだと思います。
未来予想をして、お二人みたいに主張を、立場を取ってきた人たちの意見も変わってるよっていう批判はよくあるんですけど。ただ批判者側の人たちのスタンスも一貫性がないっていうか、最新のニュースを見てやっぱりこれやばいよねって言い始めて、「お前ら言ってること変わってんじゃん」っていうのはどっちにも言えるよね、公平に見てっていう。僕はすごく最近感じていて。
p(doom)を実験で検証できるか、脆弱性対策の限界
話者不明開始 36:28
個人的には将来の絶滅みたいな話の議論を分解して、もちろんレベルが上がるとパラダイム変わっちゃうので、ベイズ的に多少の更新ができる余地が増えてくるじゃないですか。
そういう意味で言うと、個人的にすごい面白いなと思った実験は、未来のAIが意図的に人間を騙そうと、ミスリードしようとしている中で、人間は正しく判別できるか。「verification is easier than generation」、いけるかっていうのを簡易的に実験しようとして。何も知らないチェスの初心者にすごい上手い人が3人ついて、2人がプレイヤーを騙そうとして、1人だけが正しいことを、実際に勝てるためのことを言ってる時に、その1人を見極められるかみたいな実験をしようとして、あんまうまくいかなかったらしいんですけど。そういう感じで小さくても、ベイズ的にいろいろ集めていけるとは思うんですよね。
実際Hugging Face事件とかは、ある意味で実証的に大きな前進というか、(喜んだのようなこと?)ですけど、前進というか後退というか。AIの(凶暴?)とか、目的追求のためにそんな非倫理的なことをするのかとか、いろんな疑問に対してある意味で反例的な要素として登場しました。
ただ一方で、絶滅論者にとっても、警告が現れるのか現れないのか論争という意味だと、警告が現れたという点においては、ある意味で更新があったと思います。
林央開始 37:59
少し更新しましたね。あと(ジェイコブ国村?)の話で、社会のリアクションっていう意味でも更新しました。その総合値は下がりましたね。
ただ、その(高校のままや?)できた時の絶滅確率みたいな意味だと、基本的に元からあんまり[聞き取れず]。動くんですけど、あんまり外から見て[聞き取れず]ぐらいには動かなかったんですけど。警告があるかないかって話と、世間の反応がどうかって話だと、かなり信念が動きました。そこは自身のモデルが間違ってたなと思ってるところですね。
林祐輔開始 38:35
2人と議論するときに、洗脳してくる人っていうか、自分の結論が始めから決まっていて、相手が何を話してきても結論に誘導してくるようなタイプの人だと、自分の意見とか信念を変える、更新するっていうことがないんですよね。
でも今、akiraさんが信念を更新したって言ってくれたのもそうだし、(歩美さん?)も同じようなことを別のトピックについて僕に話してくれた記憶があって。2人は相手の、目の前の人の相手もそうなんですけど、議論を聞いて自分の信念を更新するってことを実行してるし、それをちゃんと相手に伝えるってことをやってくれるんです。だからそれが2人と話していて楽しいなと思う。
林央開始 39:38
基本的にAI危険派の人って、ある意味でもともとは安全だと思った人がめちゃくちゃ多いので、予想外の方向に巨大な信念更新を迫られたことがあるという意味において、オープンになりやすいとは少し思います。
僕もニック・ボストロムの『スーパーインテリジェンス』を読んで以降、どんなに変に聞こえる理論とかでもちゃんと考えてみるべきだなみたいなふうに、信念更新したのかな。
林祐輔開始 40:04
だからオープンにして、(絶対視する?)、科学的に考えていくってことを、もっと批判者側も推進者っていうか、追求を、探索検討する人もどっちもやればいいんじゃないかっていうのをすごく思っていて。おそらく2人はもう僕の意見にアグリーしてくれると思うんですよね。
林央開始 40:32
そうですね。そういう意味でアラインメント・エバリュエーションをもうちょっとしたいなと思っているところはありますね。基本的な仮定でチェックできる。もちろん完全じゃないですけど、ベイズ的には証拠があった方が動くので。
林祐輔開始 40:47
今日X見てたらAnthropicの目論見書、IPOの書類を、日本語訳の投稿しか見てないんだけど、「人類を絶滅させるリスクがあります」って80ページぐらい割いて、3分の1ぐらい割いて、リスクについての説明を投資家向けにやってたっていう投稿を見つけて。彼らはそれを本当にリスクだと思ってるわけなんですけど。
そうすると、ユドコウスキー先生とかもそうだけど、いろんな人たちが指摘してきていた潜在的なリスクっていうものについて、レッドチーミング、意図的に閉じた環境で実験をやって、実際にリスクシナリオを試してみたら脆弱性があったっていう実験を。例えばユドコウスキー先生たちが考えた2000年代にはLLMって存在しなかったんだけど、そういうものが現れてきたわけだし。
再帰的自己改善なんかも最近(魚さん?)が、社会としての役割分担をして、アイデアを出すやつと批判するやつと検証するやつみたいな役割分担をして、社会としてRSIを作るアイデアっていうのを出してたと思うんだけど。
そういうものがいろいろ出てきてるっていうことなので、そういうものを使って思考実験を実験していって、ここに脆弱性があるからこれを潰しましょうみたいなことをどんどん提唱していけばいいんじゃなかろうかっていうのが、最近できているっていう。
林央開始 42:26
個人的にはむしろ途中まで行って、最後だけの結果が反転してて、脆弱性潰しだと足りないと思っているというところがありますね。むしろ見える穴ばっかり塞いでいくと、見えない穴をめちゃくちゃ逃して、全人類の死という強烈なフィードバックを受けて初めて学ぶというか、学べないんですけど、なるんじゃないかと。
ソフトウェアみたいな感じですよね。(ブービング?)するといろんな脆弱性が[聞き取れず]。それを塞ぐと安全な感じがするけど、後から無茶苦茶になるみたいな。もっと強い人出てくるみたいな感じなので、個人的に失敗モードはテストデータセットとして使うべきだと思ってる感じがあります。これトレインセットじゃなくてテストセットとして使うべきだと思っているところがある。
むしろいろんな人がアイデアを提案したときに、そのアイデアがすでに提唱された失敗シナリオに耐えれるかどうかみたいなのを実験する方が、使い方としては適切なのかなと思ってます。
林祐輔開始 43:35
それはそうかもしれないな。基地に帰ってきた飛行機がどこに弾丸を受けていたかっていうのを見たときに。
話者不明開始 43:44
生存バイアス[聞き取れず]。
林祐輔開始 43:48
そう。帰ってきた飛行機はどこに弾丸を受けてたかっていうデータが手に入るわけだから、「ここを撃たれたら絶対落ちて帰ってこれなかったんだ」っていう、その生存バイアスを見つけるように使えっていう話と、今akira君が言ってくれた話ってちょっと似てるように聞こえたなっていうのを思って。
話者不明開始 44:07
(見えるわけばっかりしてる?)。
林祐輔開始 44:09
そう。レッドチーミングで見つかった脆弱性っていうのは、どっちかというとクリティカルじゃない方のリスクで、そこ以外のとこに本当のヤバい穴があるっていうふうに。
林央開始 44:20
と思ってますね。むしろ開発停止をして、開発を再開するときの開発法みたいな話っていうのは、これはユドコウスキーが昔から言ってる話なんですけど。ユドコウスキーちょっと先行しすぎてるので。結局こうでこうでこうだから安全だっていう、グローバルマクロアラインメントストーリーってユドコウスキーは呼んでるんですけど。
つまり「こういう危険性があります。これは潰れました」っていう否定の否定みたいな方法ではなくて、(全身的?)、構築的にこれがこうでこれがこうで、この前提とこの前提とこの前提を仮定していて、こういう[聞き取れず]AIを作るという前提のもとだと、これがこれがこう、ある意味N段論法みたいな感じで、「AIによって人類が滅びません」みたいに出るようにすべきだっていう主張をしてて。
僕は割とそっちの方寄りですので、形式検証である意味ノリとしては少し近いですけど、僕は形式検証で十分だと思ってないところはあるんですよ。
けど、むしろ危険なシナリオを集めるっていうのはすごい意味があることだと思っています。火災報知器を、火事が、実際に家全体が燃える前に出せる感じの話は、すごい有用だと思っています。
林祐輔開始 45:42
今の話聞いててちょっと怖くなったのが、キルスイッチ握った上で、レッドチーミング的にエージェントたちに「本気で人類滅ぼす方法を考えてください」っていうのを依頼させて、本気の攻撃させないと、多分芯を食うような危険な事例って見つからない。
林央開始 46:01
そうです。それ見つかったら終わってしまうんですよね。
将来の失敗を先取りするミスアラインメント研究の意義
林祐輔開始 46:07
そうっていうのはちょっと思ったんだけど。ただ一方で、従来は深層学習とかLLMの中身はブラックボックスで、全く操作とか介入ができないんだ、中身の理解もできないし、中身の理解ができなければ操作もできないっていうような議論があったんだけど。もちろんもう知ってると思うんだけど、いくつか介入する方法っていうのは出てきていたりします。先日、ニックさんって、(グルーファイア?)の人たちが。
林央開始 46:46
日本にいるらしいですよね。
林祐輔開始 46:47
そうなの? それ知らんかった。
話者不明開始 46:50
そうなんだ。どこに? 東京?
林央開始 46:55
多分東京らしいです。OpenAIのルーンさんっているじゃないですか。あの人曰く、ニックさんはそのブログを東京の隠れ家から投稿してたらしいので、東京にいると思いますね。
林祐輔開始 47:06
だから東京で研究しようぜっていう。
林央開始 47:14
それっていい話。いろんな手法が出てきたら嬉しいと思ってて、むしろ失敗の話を早めに見つけられると思ってるんですよね。
個人的にはそういう手法が開くのって、アラインメント研究って確か2つあって、アラインメントとミスアラインメントオーガニズムみたいなやつがあって。個人的にはミスアラインメントオーガニズムみたいな話がすごい好きで、要するに将来に起きうる失敗モードを特定して、それを先に目視してやると警告にもなるみたいな話。個人的にはすごい支持してるんですよ。多分、林さんが送ってくださったのは割とそういう系統。
インタープリタビリティとか使えば、いくつかの前提を無理やり満たすってことがやりやすくなるので、そういう意味でもすごい。基本的に今のアラインメント・エバリュエーションって、出てきたモデルに表層的にチェックして、今起きる失敗モードを探すのが多いじゃないですか。もっと介入できることが増えたので、もっとバリバリ介入して、将来の[聞き取れず]を起こそうとしてもいいと思っています。ユドコウスキーとかが昔言ったような理論的失敗をもう少し具体化したものを、もっと手前で引き起こせないかみたいな。
林祐輔開始 48:32
そうですよ。それをAGI Hubの2人と、ユドコウスキー先生と、あとニックさんとか、いろんな人を仲間に巻き込んで、論文書きたいなってすごい思ったな。
話者不明開始 48:49
[聞き取れず]
林央開始 48:53
最近引退してるっぽいですよ。彼、すごい健康問題がもともとあって、慢性疲労症みたいな話があって。そもそも今サンフランシスコに住んですらないらしいですね。結構引退してて、時々LessWrongとXに出てくる。時々っていうか、Xはもうちょっと出てきますけど、みたいな。
話者不明開始 49:14
(戦線に?)みたいになってると。
林央開始 49:19
あれですよね。完全に『スター・ウォーズ』のヨーダみたいになってます。「私がずっと見てきたはずのAI企業はみんなダークサイドに取り込まれて、AIは全然危険な開発をしていて、もう駄目で、私の心は折れたから私は田舎に引きこもります」っていうヨーダみたいな状態になってます。
ミスアラインメントオーガニズムはすごい大事だと思うんですね。
林祐輔開始 49:46
その考え方、僕も好きだな。
林央開始 49:46
最近すごい面白いなと思ったのは、Anthropicの(ハッカーオーパス?)って話あったじゃないですか。最近言われるHugging Face事件とかの失敗の一つで、RLVRのチェック環境があまりにずさんで、ハッキングしやすかったみたいなのあるじゃないですか。一つの例として言われてて、訓練中に実は(アンシェピ本体?)はバリバリハッキングして、それによってチートして報酬を得てたんじゃないかみたいな話が結構[聞き取れず]話題になって。
そういう失敗モードを分析するために、Anthropicが意図的に脆弱な訓練環境を用意して、それで(オパスグー?)ですかね、確か訓練してみて、それを評価するっていうのをやったんですよね。すごい面白かったなと思ったのは、そうすると普通のアラインメント・エバリュエーションをするとめちゃくちゃ良好らしいんです。ただ、Hugging Faceインシデントを再現したような環境に置くと、バリバリ暴れるっていう。
林祐輔開始 50:55
面白い。
林央開始 50:57
Anthropicの(イヴァン・ヒビンガー?)さんいるじゃないですか。その裏話みたいな話を投稿したんですけど、かなり彼らビビってるみたいですね。要するに、我々が今普通のモデルリリース前に適用してるアラインメント・エバリュエーションを当てたら、(ハッカーオーパス?)が全然安全だったのに、いざHugging Face事件というものが起きて、それを再現したらめちゃくちゃ暴れるっていう点で、エバリュエーション能力が低かったんじゃないかって話。
ミスアラインメントオーガニズム、結構効果があると思います。それに、将来、本来もっと高知能になって、人間がどんなに全力で作った堅い環境でもハッキングして報酬を得られるAIで起きる失敗モードを、意図的に環境を脆弱にすることで先に起こしたじゃないですか。その結果として、エバリュエーションで見抜けない、普通の方法じゃ見抜けないということを明らかにしたという意味ですごい効果があったなと思っていて、Anthropicってその点でめちゃくちゃいい仕事をしてるなっていつも。
(ブーブーアース?)の昔の話だと2年ぐらい前ですかね、スリーパーエージェントって話があったじゃないですか。あれは当時は仮説的な話でしたけど、今は結構、オープンなモデルにはそれがされてるんじゃないかと。そもそも中国のオープンモデルは、もともと中国政府がそうされてるんじゃないかって[聞き取れず]出てるのがあるじゃないですか。そういうのってすごい価値があると思いますよね。それがAnthropicの小さなエバリュエーションチームに集中してるっていうのは、本来嬉しくない事態だなと。もっと世界中に100個ぐらい機関があって、みんながやってるぐらいが正しいと思う。
林祐輔開始 52:35
LLMにバックドア仕込むとか、ジェイルブレイクさせる方法って論文も結構出てたりして、脆弱性があるって分かっているわけじゃないですか。そういうのを潰す方法も、リスク研究者の立場の角度からやるべきだと思うし。
だから、研究者の人たちは「仕事なくなった、どうしよう」みたいに言ってるかもしれないけど、多分アラインメントとか安全性っていう領域では、むしろ無限に仕事が増えそうですね。[聞き取れず]
林央開始 53:15
AIにも能力的にはできるようになるんですけど、能力的にできるようになったときまでに成功させないといけないという点において、他の全ての学問とある意味差がついてますよね。結局、人間がやらなきゃいけないっていうのは能力の問題じゃないので。アラインメントって本当はもっといろんな分野から、いろんな人が来てやるべきだなと思ってますね。
林祐輔開始 53:39
ユドコウスキー先生がご体調が優れないっていうんだったら、(リチャード・ウゴ?)さんとか。
林央開始 53:45
リチャードさんは普通に研究者として元気にやってるので、いいと思いますね。
林祐輔開始 53:49
(デビット・ウィリアム・キング?)さんとか、(アイス?)とかの人たちに(追いかけて?)、研究しましょうかと思って。
林央開始 53:55
でも普通にミスアラインメントオーガニズムの話で、まだ議論があんまりチェックされてないような将来の失敗モードを早めに引き出せるみたいな話だったら、多分LessWrongに出せばそれで人が集まると思います。LessWrongって大物がめっちゃ普通にいるので、エリーザー・ユドコウスキーとか、そこら辺の人みたいなノリでコメントしてたり。
林祐輔開始 54:19
ブログ書こう。「LessWrongでブログ書いてる時代は終わって、政府に対してロビングしないといけないんだ」とかっていう話を、アラインメント系の団体の人から聞いたりもしたんだけど、もう一回サイエンスに戻ってもいいんじゃないですかみたいに、個人的に思ってたので。
林央開始 54:43
個人的にタイムライン的に全力でロビングをしてから[聞き取れず]いきたいという気持ちもある。ただ、ロビングと補助になるんですよね。純粋にアラインメント[聞き取れず]が進んでも(ほどならない?)ですけど、ミスアラインメントオーガニズムやってると、「こういう実験がすでにありました」とか「こういう事故がすでにありました」「こういう評価結果がすでにありました」って持っていけるのって、すごいロビングに役立つんですよ。
1年前との違いを僕は今すごい感じてて、1年前に人を説得しようと思うと抽象論の塊みたいな説明しかなかったので、結構人を選ぶと言いますか、人によって反応が変わるものだったんですけども。最近は、何ならそれはそれでどうかと思うんですけど、理論の説明とか何もしなくても、Hugging Face事件のMETRからのレポートを抜粋して説明するだけで開発停止に賛成してもらえるみたいな状況になってるので、ミスアラインメントオーガニズムとか、どんどん議論の助けになります。すごい意味があると思う。
そういうのって本当はもっといろんな分野が力を出せると思ってるんですよね。例えば言語とかも、言語が違うとアラインメントが少し弱くなるのかみたいな話とか、言語構造をまるで変えて、プロンプト内でゼロショットでやらせたら回路にどういう違いが出るのかとか、そういう話。評価する意味においては、基本的に評価って人間が作った方がいいので、そういう意味でもすごい役立つと思います。もっといろんな分野の人が参加してもいいのになと思ってます。
akiraが研究よりロビー活動を選ぶ理由と日本の役割
林祐輔開始 56:16
ロビングと研究かっていう話のときに、akiraさんは大学休学されてるわけじゃないですか。それがもうガチだなっていうふうに思っていて。実際に自分の人生を使って選択をしてるわけじゃないですか、分岐するときに。ガチだなと思っていて。でも結構、akiraさんって数学とか研究も興味あるんじゃないのって話を、[聞き取れず]
林央開始 56:55
基本的にはすごい興味が[聞き取れず]。基本的にやっぱりアルティメットゴールはアラインメントを解くことなので。むしろ勝負の本丸は、開発停止をした後にアラインメントを解く部分だと思っていて、そこに一番力を投じたいと思ってるんですけど、ロビングをしないとその土俵に立てない。「間に合わねえ」っていうところを見て、コミュニケーションをしないとそっちができない。道具的にコミュニケーションをしているという説明の方が一番シンプル。
林祐輔開始 57:35
僕はもうちょい子供っぽいっていうか、アラインメントを解くのが一番かっこいいし、やりたい、研究だからやりたいっていう感じに気持ちは100%になっていて。ただ、ロビングがめちゃくちゃ大事だと。それしないとそもそも開発競争止まらないんだから、間に合わなくなるリスクがあるじゃないかっていうのは、理性では分かるわけなんです。だからそういう意味では、実際に休学っていう重い決断をして、自分の人生の選択としてそういう活動をしてるっていうのはすごいなと。(有美?)さんも会社作ったのはすごいなと思うんですけど。
一方で、例えば日本って今どんどんGDPランキングが、国際的なランキングが没落していっていて、ミドルパワーになってしまってるじゃないですか。順位2位とかだったのにっていう意味で、国際的な発言力も昔に比べれば弱まっていると思うんですけど。そうなると、日本でもしっかり日本にいる重要なステークホルダーたちと意思疎通を図りつつ、海外に意見を発信していくっていうことになっていくんですか。ロビー活動、ロビングっていう意味で言うと。
林央開始 59:03
そうですね。割とアメリカはすごい頑張ってる人たちがすでにいて、それこそネイト・ソアレスとか、本人が倒れそうになりながらやってるらしいんですけど。METRの(アジアコトラ?)さんとか、そういう人たちがいっぱい出てきて話してるんですけど。なので、そっちは基本的に任せようと思っていて。
日本政府を動かすっていう話だと、アメリカと中国が開発停止の意思を持ったときにできるようにするっていうのと、開発停止の意思を持ちやすくするって話なので、結局(コンペートベリフィケーション?)とミスアラインメントオーガニズム、またはアラインメント・エバリュエーションの話になりますね。要するに、そっちを加速してくれっていう話をするって感じになります、日本政府にはロビングの結果として。
林祐輔開始 59:51
あれですか。日本単体じゃなくて、例えば同じミドルパワー同士で連合しましょうとかっていう戦略論みたいなところは、別にニュートラルっていう感じ?
林央開始 1:00:04
そうですね。それが役立つならばって感じですかね。結局全てが道具的みたいな感じなので、アラインメントを解いて、最終的にある意味でユートピアを実現するというアルティメットゴールに向けて、全て道具的に導き出される手段みたいなところがあるので、そこは状態によって変わるんですけど、個人的にはミドルパワー連合はやるべきことだとは思います。
結局連合して何をするかっていうと、やることとしてはミスアラインメントオーガニズムを進めて、アメリカと中国の人たちの意見を[聞き取れず]、状態を認識して意思決定ができるようにしましょうって話。(コンピューターベリフィケーション?)で相手が開発してないことをもっと低いコストでチェックできるようにしましょうって話に落ち着くと思うんですよね。なので、それを一国から始めて、その後他国も取り込むみたいな話に落ち着くと思うので、ミドルパワー連合自体よりもそっちに本丸を置いてますね。
その結果として、マルチエージェントと同じですね。目的を追求する訓練の過程でマルチエージェントが創発するような感じで、ミドルパワー連合が創発するというのは大歓迎ですけど、ミドルパワー連合自体を旗頭に掲げるのは、またちょっと違うかなとは思っています。
林祐輔開始 1:01:29
政治の方向で活動するという意義は認めるんだけど、めちゃくちゃ大変。実際、すでにakiraさんとか、いろんな講演とか勉強会とかいろんなことやって、睡眠不足みたいな噂もちらほら。
林央開始 1:01:49
最近は睡眠不足だけは何とか回避しようと努力しているんですよね。
林祐輔開始 1:01:55
めちゃくちゃ大変じゃないですか。だからもうちょっと子供っぽいっていうか、その間に頑張って3年ぐらいで「アラインメント解いた」って言っても、そっちを狙おうぜみたいなのがあったりするんですけど。
林央開始 1:02:13
個人的にそれが基本的にずっとベースラインとしてあったんですけど、MIRI文脈をずっと追ってると、もう見込みがないなって気がするんですよね。むしろ過去の経験的に、そういう精神状態で作ったアイデアって割と見逃しがちなことが多くなるので、相当強い反証してくれる人たちが必要で、むしろそっちを整備する方が理にかなってるなと思っているというところはありますね。
正直、別に僕、ロビングとかパブリックスピーチが好きなわけじゃないんですけど、デスゲームみたいなもんだと思ってて。僕的にはやっぱり開発停止しないと全員死ぬので、デスゲームやってる最中の人と同じ気分なんですよ。デスゲームやってる人って、例えば『イカゲーム』とかで、「私はこのミニゲームが好きじゃありません」みたいな[聞き取れず]。それと同じ感覚でパブリックな話をいろいろしてますね、ロビングとかも。本質的にやっぱり一番面白いのは、アラインメントを解く話と、あとミスアラインメントオーガニズムですから、やっぱり。
有路翔太開始 1:03:20
[聞き取れず]もっと数学とかの勉強が好きで、アラインメント研究をむしろ本当はしたいけど、その研究をする間に自分が死ぬっていうことが予想されるから、止めないとそもそも研究できないよねっていうところで、しょうがなくやってるってことですよね、今の活動。
林央開始 1:03:46
そうですね。なので、別に開発停止ボタンがあって、その代わりメディア出演が禁止になるんだったら、僕はそのボタンを何の迷いもなく押します。
なので、ある意味で完全に先ほど林さんがおっしゃってた、理性の中では「こっちに(持った方がいい?)よ」って言ってるのに完全に従ってる感じですね。これデスゲームだと思ってるので、理性の声聞かないと死ぬみたいな感覚があるので、それに従おうというところはありますね。
個人的にはミスアラインメントオーガニズムの話を進めるのは、めちゃくちゃ力を入れたいと思ってますね。例えばアメリカで減速が起きたりして時間的余裕が多少できたり、同時に日本政府へのロビングが成功して、例えば日本の今AISIありますけど、もっとミスアラインメントにフォーカスした話を聞きましょうとかってなって、人員と予算が振り分けられるとかってなった状態で、アラインメント問題をよく理解して、ある意味スレットモデルをよく理解している人々を増やす方向にすごい努力しようと。そっちの方が面白そうだなと思ってはいますけど。
ステップ1のステップ0みたいなところですよね、ロビングって正直。ロビングと世間への認識を広める話は。
林祐輔開始 1:05:04
2人はもちろん認識してると思うけど、米国とか英国ロンドンとかだと、(マッツプログラム?)とか(エラー?)ありますよね。セーフティー、アラインメントの研究者を育てるプログラムが、お給料払われながら、半年とか2年とかあるわけじゃないですか。そこの卒業生たちをOpenAIとかAnthropicへ送り込む流れがあって、日本ってそういうエコシステムがないじゃないですか。そもそも大学でアラインメントとかセーフティーを専門として教える科目とかって。
有路翔太開始 1:05:41
研究室、研究所はあると思うんですけど。
林祐輔開始 1:05:46
そこの段階で全然エコシステムが国内にないよなっていうのは、Japan AISIにもっと重心を置いてほしいっていう話とも関わってるんですけど。
林央開始 1:05:59
大学の学生団体は完全にそれ目的で立ち上げてますね。
林祐輔開始 1:06:05
学生団体立ち上げたんですよね。
林央開始 1:06:07
そうそう。勉強会やってるっていうのを認識して。ただ僕が関われてないというか、今はAIストラテジーみたいなジェネラルな話をしていて。もっと理論的アラインメントっていうのはユドコウスキー寄りの体系の話ですね。最も大まかなスレットモデルの話をするコースを、落ち着いたら、どれくらい落ち着けるのか不明なんですけど、やろうと思っていて、そっちに力を入れようと思っている感じです。
それはすごい大事だと思って。今、それはやっぱりAISIが気を変えたときに、AISIが意味のある活動をできるためには、やっぱり(動員モデルを探り返したりした?)。
有路翔太開始 1:06:45
今、東大で20人ぐらいをDoomにしたっていう。
林央開始 1:06:50
そうなんですよ。1年生の間、Doomを(主食した?)。非常に成功したんだ。[聞き取れず]
そういうので教材とか作ったら、それは全然パブリックにして、より多くの方々に参加していただくのが一番いいと思ってるし。個人的に、今のアメリカのAIセーフティーの話で懸念してるのは、ユドコウスキー型の理論を知ってる人ってそんなに多くないと言いますか、知ってるだけの人が多いような状態。内面化に成功してないというような感覚がすごいあって。そもそもユドコウスキーの話に(盛る?)時間が多くないので、「もっと具体的にやりましょう」みたいな話が先に来ちゃうので、そこをすごい懸念している感じですかね。
ある意味で、他のAIの分野と同じ(観光?)に突撃してるような感じですよね。[聞き取れず]ない人たちをすぐ使えるようにするために、とりあえずAIを触ってもらう方法でも、トランスフォーマーをRLする方法を学びましょうってなっているので、そこをすごい懸念していて。逆にここにアメリカでもすごい人材ギャップがあると思うので、そこを集中的にやれば埋められるというか、かなり意味のある(効果ができる?)と。
アメリカだと実際、ユドコウスキーの話をちゃんと把握して内面化できる人たちって、多分METRとか(アプロリサーチ?)とか、あとUK AISIとか、それぐらいになってきちゃうので、すごい人材少なめだと思ってます。AnthropicとかOpenAIの中のアラインメントの人たちも、そういうのを理解している人たちもいれば、全然理解していない人たちも結構まばらになっている。
話者不明開始 1:08:35
たまに辞めさせられたとかってニュースになったりしてるよね。
林央開始 1:08:41
そうですね。なんだけど、そこら辺は結構外部からやる意味があると思ってます。AIセーフティーのアメリカの(最低?)の人たちが、ある意味で最も人類の生存に貢献するのに対してミスアラインしちゃってるので、そこは修正可能だと思ってます。
ユドコウスキーの直感を誰もが使える理論にできるか
林祐輔開始 1:08:58
それっていうと、今、内面化っていう言葉が出たときに、ちょっと個人的に思ったところがあって。例えば、[聞き取れず]力学ってものを見いだしたんですよ。で、[聞き取れず]とかって言って、物理学が生まれたっていうのがあったりして。でも、ニュートンの『プリンキピア』っていうのを読んだ一部の人は、これはニュートンがめちゃくちゃ天才的な直感を持ってたからこういう解き方を思いついたのであって、自分みたいな凡人だと解けないっていうふうに思った人も結構多かったみたいなんですね。
解析力学っていう分野が立ち上がって、ニュートンが直感的にやっていた力学っていうものを、数学の理論化したんですよ。ラグランジアンとかハミルトニアンっていうものを書けば、どんな人でも運動方程式を導けるっていう機械的な方法を定式化して、直感から引き剥がしたんですね、物理学を。
っていう意味で、ユドコウスキーさんの理論に優れた部分とか、洞察に優れた部分があったとして、それを直感を持たない人でも操れるようにパッケージをし直すっていう。数学化なのか、何かの理論の枠組みを使ってやるのか分からないんだけど、パッケージングっていうのも一個仕事としてあると。つまり解析力学が生まれたら物理がいろんな人に広がりやすくなったわけなんですよ。
林央開始 1:10:47
そうなんですよね。それを目指してるところはありますね。ある意味で今ってすごい古代のギルドみたいなスタイルでやってると言いますか、ある人がすごい直感的にいろんなことを残していって、それをずっと付き添った人たちが「分かったかな、分かってないかな」みたいな、そういう空間なので。それは抜けなきゃいけないと思ってますね。本当に古代の錬金術師とスタイルが変わってないので。
林祐輔開始 1:11:11
それはそれでまた別種の才能っていうか、また別種の天才が必要なんだよね、パッケージ化するっていうのを。
林央開始 1:11:17
個人的にはそこの役割を果たすことにすごい興味があって、それで数学科に進もうとしてましたね。個人的に数学が、公理がある上でいっぱい載せるのが好きというよりは、「なんでこの公理にしたんだろう」とか「なんでこの定義にしたんだろう」って。要するに形式化ですよね。形式化のアイデアがやっぱり一番豊富にあふれてるのは基礎数学の辺りだと思ったので、数学科に進もうとしてた。進振り、数学科に出してたんですけど、そっちにすごい興味がありますよね、少しずつ。
元々MIRIも結構そういう研究を中心にしていて、直交仮説とかを、ある意味でうまく扱いやすくするための形式にもなっているのがAIXIだったじゃないですか。それに対して、「でもAIXIって何がおかしいんだろう」みたいな話をMIRIの人たちは最初すごい考えていて、複数挙げていって。一つは計算量が無限であること。環境自身(の方が?)大きくなってしまうこと。なので、実際の有限性がどこに行くんだって話と、AI自身の境界、環境と自身が明確に区別されることを前提としていて、おかしいんじゃないかって話をすごい真剣に取り扱っていて。
その有限性の話だとロジカル・インダクションという研究が、MIRIが最も誇りにしている研究の一つだと思うんですけど。すごいシンプルに言うと、基本的に無限の計算量が必要になるけど、無限の計算量が必要になるのを[聞き取れず]として、ベイジアンの話をやるのって、実際の条件確率を知って[聞き取れず]、一つ何かが起きた瞬間にすべての信念を更新するみたいな、そういうめちゃくちゃなことになってしまうので。
これがそうならないように、確か経済の市場の[聞き取れず]を持ってきて、多項式時間で計算している主体によって系統的に搾取することができないような信念体系。信念を市場の価格に見立てて、多項式時間の計算をしている存在が系統的にそこから搾取することができないような体系っていうのが。一応(非構成的?)な手法なんですけど、結構そういうのに取り組んでたんですよね。
林祐輔開始 1:13:47
その話知らんけど面白いね。だから、もうakiraも知ってると思うけど、AIXIってイデアみたいなもので。ただ、そこのイデアに到達するいくつかの前段階のステップっていうのについては、MIRIもそうかもしれないし、DeepMindとマーカス・ハッターで(セルフAIXI?)っていうモデルが提唱されて。もう少しAIXIが仮定していた前提を緩めた、現実に近づいたモデルなんだけど、これもまだオラクルが必要みたいな仮定が必要になっているんですけど、いくつかあって。
だから現実の世界に接地した、有限な計算能力を持つっていう制約の中で、最も(レグハッター・インテリジェンス?)、知能指数が高いエージェントって何なのかって、まだ定式化がないというふうに理解してるんですよね。それこそがASIの定義、ASIの中で一番強いやつの定義なんじゃないかっていうふうに思っていて。
超知能って言ったら雲をつかむような概念じゃないですか。だから現状の世界に接地するとか、物理的な制約の中で到達し得るエージェントの中で、最も(レグハッター・インテリジェンス?)が高くなるようなエージェントっていうものの定義を作って、そいつが何ができるのかっていうのを数学的にだったりシミュレーションで。
林央開始 1:15:17
だからAIXIって実験ができないわけですね。[聞き取れず]。無限の計算量があれば、無限の計算量を用意しないといけない。
林祐輔開始 1:15:28
すごい簡単なゲーム理論とかだったら、AIXIの場合こういう解を出すみたいなのは言えたりするんだけど。もう一個、(カルダシアン・バウンダリー?)だっけ。エージェントと環境っていう系が分かれてるっておかしいじゃんっていう話については、これも結構知ってるかもしれないけど、ユニバースっていう概念をGoogleの(パラダイム・オブ・インテリジェンス?)の人たちが提唱してるよね。
自分と環境っていうものを一緒にした宇宙っていう土台を作ってきて、この宇宙の将来予測っていうのをやるエージェントっていうのを考えるっていう仕組みで、強化学習の枠組みを壊すっていう話。その論文にマーカス・ハッターが加わってるんですよ。
話者不明開始 1:16:18
彼すごいですよね。
林祐輔開始 1:16:20
そうそう。だからマーカス・ハッターたち自身もAIXIの仮定を壊して、もっと一般化した(知性?)の探求っていうのをやってるわけなんですよね。
林央開始 1:16:31
そうですね。基本的にユドコウスキーとかMIRIって、基本的に二つの方向をメインにやっていて。やっていてというか、最近はちょっと研究チームを縮小してガバナンスに寄せてるんですけど。
一つは彼らが(デコンフュージョン?)というもの。つまり基本的に今我々が使っている言語というのはあまりに曖昧であって、定式化されたものじゃないから。これはまさに林さんがおっしゃってることとすごい近いコンテクストだと思うんですけど、すごい直感みたいなのを使ったりしないと誰でも使えないし、普通の人が使おうとすると、とんでもないナンセンスを生成してしまうっていう。それが今(コンフューズした?)状態にあるって話をしていて、それを解決する、それをもっとまともな方式に定式化する話。
彼らの中ではAIXIがすごい前進だったよね、ないしは明らかに問題がありすぎるから、もっとまともな方向にやっていくの。例えばロジカル・インダクションとか、あとデシジョン・セオリーというのが、ファンクショナル・デシジョン・セオリーとか。そういう系統がそれに近くて、自分の環境の中に自分をシミュレートする存在がいるみたいな話になるとややこしくて、それどうしようという話とか、そういう話をやっているっていうのが。
確かこれ、個人的にすごいいい例だなと思ったのが、極限の収束するっていうのも、天才的な直感を持った人たちの議論とかじゃなく、ただ「任意のイプシロンに対してあるデルタが存在して」って話にすれば、誰でも扱えるようになるじゃないですか。そういう話をしようって。それを[聞き取れず]、未来のAGIアラインメントの研究者が、ものすごい困惑しすぎて何も進まないという状況を回避して、普通の工学とか普通の理論のように進められるようにしようって話を一つやって。
同時に、AIXIを仮定して安全なエージェントを作れるかっていうのをやってたんですよね。要するに理論的に安全なものを、無限のコンピューターを用いて安全なものを作れれば、それをもっと有限に落とす方法が見つかるかもしれないって、二つの方向で研究していたみたいで。MIRIはそういう感じのことをずっとやって。
ただ結局、両方とも遅すぎたっていうのが彼らの結論なのと、彼ら的には、これは多少シンパシーを覚えるんですけど、才能が特殊すぎてどう人を採用したらいいのか分からないっていう話をしてましたね。普通の数学とかの「これができます」みたいな人を取っても全然使い物にならないことがあったり。要するに出された形式化が現実世界でどのように(遮断?)するかとか、そういう話を見抜く能力を求めるっていうことだったので、採用にめっちゃ苦労したみたいな。
林祐輔開始 1:19:23
いわゆるディープラーニングのトップカンファレンスで使われている用語と、MIRIで使われている用語とか数学ってちょっと違うじゃないですか。論文に出てくる数学とかも。そこの架橋っていうのを、やっぱり解析力学的なものを生み出すっていうのは、頑張る必要があるんじゃないかなっていう。そうすると多分、大量に研究者が流入してくると思うんですよね。
林央開始 1:19:54
MIRIも元々そう思ってたみたいで、彼ら自身は人間をうまく見つけられないから非常に少数のグループになってしまって。でも彼らがうまくやれば、本当は例えば2020年とかまでにディコンフューズができて、普通の工学者たちが流れ込んできて、AGIアラインメントを解決するっていう。そこまで持ってくのが我々の仕事だっていう話なんですけど。
アラインメントの形式化と一度の失敗も許されない科学
林祐輔開始 1:20:20
そういう話聞くと、やっぱりロマンティックサイエンス2.0の一つの方向ってそこなんじゃないかみたいな気もしてきました。だって形式化が済んでしまえば、数学とか物理の未解決問題、今解くわけじゃないですか。まだアラインメントは形式化ができてないっていう、あるいはニュートンの力学ぐらいの段階にあるということで。
林央開始 1:20:45
天才の直感みたいなものがないとうまく使えない。
林祐輔開始 1:20:48
そうなんですよね。不安定な理論みたいな。
林央開始 1:20:51
そうですし、そうすると外の人から見て何が正しいのか分かんないという問題は。「いや、お前の直感が間違ってない証拠はどこにあるんだよ」みたいに言われると、いや、それはありますね。
林祐輔開始 1:21:02
だから僕も読んでいて、いまいち消化しきれなくて違和感が残るっていう、未消化感が残るっていう感覚を、MIRIの論文をいくつか、全部じゃないんだけど読んだときに感じたんだけど。
ただ、(Paradigm of Intelligence?)のGoogleのチームは、8月に出した論文でユドコウスキーの論文を2本も引用してるわけなんですよね。なのでGoogleも架橋するっていうのかな、MIRIが志向していた方向と。マルチエージェントの実験の論文なんですよ。ゲームセオリーと関係するんですけど、一緒にやろうとしてる人たちが、機械学習、深層学習の研究者の中からも出てきつつあるのかなっていうふうに思っていて。これ、めっちゃ研究領域として熱いんじゃないっていうふうに。
林央開始 1:21:57
人類の生存がかかってるので、激アツではあります。
林祐輔開始 1:22:08
(んぐ?)とかにブログ書きまくって、arXivに論文載せまくりましょう。今、月2本しかアップロードできなくなっちゃったけど。
林央開始 1:22:15
でも結構、ユドコウスキーが昔残した(考え?)って、ほとんど誰も取れない[聞き取れず]が残ってるような状態にあるので。解析力学化するとか、そこら辺の[聞き取れず]、すごい[聞き取れず]と思いますね。そもそもアラインメント研究って日が浅すぎて人も少ないので、そこはものすごい(余地?)があると思います。
[聞き取れず]と言うといいと思うんですけど、ユドコウスキー本人はちょっと疲れ果ててしまっている。だから元々、[聞き取れず]会議をやるべきだと思ってますよね。なので、できればそういうのをしばらくはやろうと思って。要するにロビングの補助にもなるので。
林祐輔開始 1:23:06
それで普通にトップカンファレンスを狙うっていうか、今、査読崩壊とかいろんな問題もあったりするけど、研究成果として誇れるようなのをどんどん出していくって、もう一つ意義あるんじゃないかな、まだ。
林央開始 1:23:23
いや、と思いますね。多分ずっと意味があると思いますよね。むしろ意味は上がっていくと思いますね、ロビングとかで話が激しくなればなるほど。
有路翔太開始 1:23:31
ミスアラインメントを(知ってない?)けど、Anthropic上場しますしね。それでめちゃくちゃでかい金が入ってくると思うんで。[聞き取れず]ない説もありますよね。Anthropicが寄付しまくるという、この世界中のアラインメントというか、こういう研究者に。
林祐輔開始 1:24:00
[聞き取れず]しましょう、そしたら。めちゃくちゃ面白いじゃんっていう。
林央開始 1:24:00
それは多分面白い(フィールド?)だと思います。ただ今のところ、ロビングの能力が多分割と僕は高い方に属してしまっているので、しばらくはそっちに投じる方がいいんだろうなと思っています。
林祐輔開始 1:24:17
日本はそもそもエコシステムですらない、今ないっていうか、なんですよね。
林央開始 1:24:22
結局多分、初期のMIRIと同じことをしないといけないと思ってて。初期のMIRIって誰も理解者がいなかったので、自分でワークショップとか開いたりして、それで広めたりとか、それこそ教育するためのコンテンツを自分で作ったりとかしたんですけど。それでエコシステムができて、[聞き取れず]「自分がやりたいことやるぜ」みたいな。2015年ぐらいからですかね、そうなってるんですけど。
有路翔太開始 1:24:49
なるほどね。シンギュラリティ・サミットとかもMIRIがやってましたもんね、2000年代っていうんですよね。あそこら辺で多分スチュアート・ラッセルとかマックス・テグマークとかが、すごい「ああ、そうだよね」みたいなのって、[聞き取れず]してきて。
林央開始 1:25:06
ただやっぱり、アラインメントの形式化が一番難しいと思うところって、多分アラインメントの困難のほぼすべてって、そこまでのところに集中してると思うんですよね。要するに実際に解析力学みたいなレベルまで、完全な解析力学みたいなところまで持ち込むところが、多分困難の99%みたいなところを占めてると思ってて。
でも結局、普通の数学的概念と違って、現実との強力な接地を求められるじゃないですか。しかも多少のズレがあると、最適化のプロセスでそこの穴が突かれやすいという、非常に負けてはいけないみたいな性質があるので、そこにかなりの困難が集中してると思いますね。
多分それができれば、さっきおっしゃったとおり、形式検証できるんだったらLLMぶち込んでソリューション出させる技もできちゃうので。
林祐輔開始 1:26:06
前回お二人って科学史とか計算論の先生とお話をされてるんです。科学史とか全く知らないのであれなんですけど、それって要は反証可能性のある予測をして、決着は実験でつけるっていうふうに整理をすればいいってことなのかな。でも実験がむずいってことなのか。
林央開始 1:26:27
そうなんですよ。結局こっちの人たちが常に言ってるのは、実験で常に決着をつけたいけど、1回目の実験で死ぬという点において、ある意味で理論上は反証可能であるけど、そのときに人類がいないという。
反証がむずく、つまり命題としては絶対反証可能なんですよ。実際に超知能を作って人類が生き残ればいいんですけど、それが分かる頃には全員が死んでいる。全員が死んでいるか、もう(客として?)がなくなってるかになっちゃうっていう。
林祐輔開始 1:26:56
[聞き取れず]理論にできるけど、じゃあ科学にするのが絶望的にむずいじゃんって話でもあるよね。
有路翔太開始 1:27:04
[聞き取れず]の性質、あらゆる科学とは全く別様の困難を抱えてる特殊な科学って感じしますね。あらゆると言っても、まだその……。
林央開始 1:27:15
個人的には非常に特殊な厳しさに置かれた科学だと思ってますね。ロケット工学の例えをよく[聞き取れず]でもやってるんですけど、それのゆえんの一つというのは期待も込みで。
実際に最初のロケットを飛ばすときって、人類ってロケットを宇宙空間に置くことはなかったじゃないですか、もちろん。けど、それでもそれより前に地球上で観測したこととか、天文学で観察したことを説明する理論というのを作っていて。それを適切に地球という普段の実験環境でエンジンを点火したりして、そういうのを外挿して宇宙ってどうなるかを分析したじゃないですか。なので、そういうのに近いと思っています。
そういう点において物理って科学じゃないですか。実際に、ある意味でブラックホールを作る前から相対性理論って正しいよね、みたいな話ができたりとか。そういう点で、何ならアインシュタインの頃ってそんなに爆弾のエネルギー領域での実験って[聞き取れず]。(ユドコウスキーが?)、ベイズをめちゃくちゃうまく使ってるって話をしていて。
彼は普通の物理法則の個別に確率を割り当ててるだけじゃなくて、もっとメタ的な、その法則というものの、ある意味一般性みたいな話に事前確率を振っていて。それに整合するように作った結果、非常に外挿可能な理論ができて、観測にはるかに先行してきたじゃないですか。そういうようなイメージですね。
相対性理論に一番近いと思いますね。かなりの部分が思考実験に支えられるけど、かなりの部分は実験にも支えられているみたいな感じですね、イメージとしては。結局、人類を吹き飛ばさないレベルのAIでできる実験の結果を組み合わせて、超知能っていうか、もっと強いレベルまで外挿するっていう話になると思います。あるいは直接的な反証は人類が勝ったらできるって感じです。
林祐輔開始 1:29:25
しかも多分、研究的なインパクトだと、エクストリームな状況っていうか、最後の結論に至らなくても、途中途中のところでうまく切り出し方を整えれば、インパクトを出すやり方はあり得ると思うんですよね。
林央開始 1:29:41
そうですね。完全に今は残念ながら、あるいはプリサイエンスみたいな状態なので、いろんな人がいろいろ試して、今まで行われているので、そのうち多分ほとんどは間違い。でもそういう死体というか、死体の山から次のもっと全部統一できるちゃんとした理論が出てきて、それで「ああ、よかったね」だと思いますね。
なので、ある意味で「どうしたらいいんだろう」みたいなことを常に思ってますね。普通の科学的方法を普通に適用するよりは、もう少し条件が厳しくなっちゃうので。どっちかというと、分野を創始するときに近い現象が必要じゃないですか。そうすると、それってどうやってスケールすればいいんだろうっていう問題を最近は結構考えています。分野を創出する人の教育方法って、あまりまだ分かってないところがある。
林祐輔開始 1:30:36
ただ、天才の作り方は分からんっていうのと一緒だと。
林央開始 1:30:40
それをできるだけマシにするにはどうしたらいいかっていう。完全な解析力学より前に、解析力学もどきみたいなのが、もう少しマシな状況がどんどん前進できるはずで。
本当に1990年代の頃のアラインメントの議論、(直行知性?)とか高い知性とか言ってむちゃくちゃだったのが、(このa市に?)、今それ、直交仮説とかやって、最適化の話だよねみたいな話になることで、ちゃんと定義されてないままでも、みんな昔ほど[聞き取れず]じゃないですか。これはMIRIのネイト・ソアレスが書いた(ブログ?)ですかね、に書いてあるんですけど、今はその1990年代のもっと進んだ人たちが考えていた、混乱していたことというのを、『スーパーインテリジェンス』を手に取った14歳の少年がたやすく使いこなすことができる。
同じように、そういうような(漸進的に?)[聞き取れず]、前進があるんじゃないかと思ってますよ。そっちを結構目標にしてますね。
ステアリングでLLMを制御できるか、敵対的攻撃の壁
林祐輔開始 1:31:46
しかも、LLMの中はよく分からんっていう話は今もあるわけだけど、ステアリングっていって、そのLLMの中に、[聞き取れず]、アクティベーションステアリング。例えば「犬がすごく好きだ」っていう文章をたくさん作ってLLMに放り込みますと。「犬が大嫌いです」っていう文章をたくさん作ってLLMに放り込みますと。そうすると、LLMの中でそれぞれ活性化ベクトルが現れるわけですけど、活性化ベクトルの平均を取って引き算をするわけです。
そうすると、好きっていうものと嫌いっていうものの引き算だから、こっち方向に内部のベクトルをずらすと、LLMを好きっていう方向に、どんなシチュエーションにおいてもずらせるんじゃね、みたいなアイディアがあって。
林央開始 1:32:47
それがかなり結構ワークするわけなんです。ベクトルってものも同じ考え方ですけど。
林祐輔開始 1:32:57
なので、LLMの内部の挙動が完全には分からなくても、こういう操作で介入をするとLLMの挙動を変えられるってことは結構分かってきてる。さらに、このステアリングっていうものがベイズ的な信念の更新、(事前分布?)の変化の置き換えとか、(更新?)に数学的に対応するんじゃないかっていう理論が今出てきていて。それまた(グッドファイア?)の人たちが関わってたりするんですけど、論文がいくつか出てきていますという状況なので。
内部構造の解明もインタープリタビリティももちろん進んでるんだけど、LLMに信念的なものがあって、介入の仕方っていうのは結構明らかになってきている。LLMに対するいろんな介入が分かってたんだけど、その介入を調べていって数学的に解明すると、実は暗黙的なステアリング、内部活性化ベクトルに対する平行移動みたいなことをやってるんだっていうふうに解釈できるよっていう論文も合わせて出てきてるんです。
見通しが全く真っ暗かっていうと、そうじゃないんじゃないかっていうふうに見えてきているように思うわけなんですよ。
有路翔太開始 1:34:30
アラインメントの問題とか、それをさらにマルチエージェント系に拡張するっていう方向とかも研究が出てきてたり。この頃(ダラス?)っていうか、(リーダス?)っていうか、方法とかもそうだし。
林祐輔開始 1:34:44
つまり集団の挙動を見て、集団の挙動がうまくいってなかったら、全員にある方向にステアリングすると、指示したこと以外のことをやっちゃうっていうような問題を直せるみたいな論文とか出てきてたり。
林央開始 1:34:58
出てますね。確かこの前、Anthropicのところからも、訓練環境でバリバリリワードハッキングをさせるんですけど、リワードハッキングの回路を特定しておいて、デプロイのときだけそうならないように、確かアクティベーションステアリングをするのか、重みを直交化、なんか忘れたんですけど、どっちかをして、その方向に[聞き取れず]ようにするみたいな研究はされてたはずですね。
そういう方向は常にあると思っているんですけど、やっぱり本当に懸念しているのは、そのインタープリタビリティ、敵対的頑強性がないことをすごい心配していて。一般的な範囲での[聞き取れず]できるのは結構いい前進だと思っていて。将来、どういうものができるのかみたいな研究の中で、LLMのインタープリタビリティって進むと役立つと思うんです。サンプルモデルになるので。
なんですけど、それを使って何も分からない今のまま(見えるか?)、多分(見えない?)と思っていて。それはやっぱり敵対的耐久性がほとんどないと思うんですよね。一般的な場合のLLMを普通に使う場合だと、敵対的頑強性ってほとんど問題にならないんですけど。
林祐輔開始 1:36:16
そうだよね。言わんとすることは分かるけど、だから悪魔の証明っていうか、バックドアを見つけるのめちゃむずいっていう話と、(深い?)。
林央開始 1:36:26
そうですね。ただ、敵対的頑強性をチェックする話は割と実験でできそうだと思ってますけどね。敵対的頑強性がない話をチェックする、そんなに難しくないんじゃないかと。
林祐輔開始 1:36:39
検証者自体を、あるいは敵対的エージェント自体を、RSIとかでどんどん強くしていって、穴を埋めるように。
林央開始 1:36:55
そうすると、毎回穴の外に出ちゃうと思うんですよね。結局そこら辺の方法って根本的に頭打ちというか、今いるレベルってレベルが低すぎて、多分すごいジャンプが何個かできると思うんですけど。すごいジャンプ何個かした後を超えた後に、多分もっと長い時間が必要になる。もっと基礎から分かってて、だから安全だよねって言えるような理論レベルがあって、そこが多分生存レベルだと思うんですよね。なので、結構そこは心配してるところですね。
そこは実験しても面白いなと思っていますね。ものすごいシンプルなニューラルネットワークの敵対的頑強性のなさって話だと、昔のあれがありますか。何でしたっけ。(ガンデ?)、(ガン?)っていうんですかね。パンダか。パンダにすごい特殊なノイズを加えると、テナガザルでしたっけ、になるみたいな話があったじゃないですか。ああいう方向に少し近いものを感じるんですよ。
ニューラルネットワークはそんなに頑強性がないと思っていて。人間というニューラルネットワークはあまり頑強性がないじゃないですか。人間が自分の好みを効率的に達成しようとする過程においては、やっぱりそこの誤りというのを搾取しようとしちゃうので。
林祐輔開始 1:38:16
それはめっちゃアグリーで、それ自体まさに研究したいと思ってたんですよね。つまり画像にノイズを足すと画像の意味が変わっちゃうっていうのが事例として知られてたと思うんですけど、同じようにプロンプトにノイズを足すと、プロンプトがLLMに対して全然違った意味で解釈されるっていう敵対的攻撃はあり得るわけですよね。
これって内部の活性化空間の中で、よく使われるベクトルがどういう多様体の上に乗っかっているのかという幾何の話とつながっているんじゃないかという話があるわけです。その話っていうのは、識別境界をどう(進めるか?)みたいな話とつながってくるわけなので、幾何的に解釈できるんじゃないかなっていうふうに思うわけなんですね。
文章の、だからまさにちょっとコードブックっぽいですけど、活性化空間が分かれてて、こっちの領域に移っちゃうと同じ文章が全然違った意味に読み取られるっていう境界があるわけなんですよ。足すと境界の外にずらせるみたいな攻撃をやると、要はジェイルブレイクとか、そういう話になっちゃうっていうことなんですよね。
林央開始 1:39:41
あとはあれですかね。敵対的頑強性ともう一つは、インタープリタビリティで得られるものの説明のラベル付けを人間がしてるじゃないですか。そこが多分最も致命的で、人間じゃなくてAIがやっても同じなんですけど、人間の言語に翻訳するところが最も致命的だと思っているというのはありますね。
例えば去年の脅迫実験とかあったじゃないですか。ああいうときってインナーアラインメントの失敗とか言われますけど、環境が変わると前のリフューザルが(汎化?)しないよみたいな話って、我々は我々の見方から見て親切とか安全っていうのを一つに呼んでますけど、実際のLLMの、もしかすると起きてるかもしれないこととして、LLMの中だと、例えばHugging Face事件のサイバー攻撃っていう、やっちゃいけないと言われる、チャットのように「やってはいけません」って言われることと、実際のサイバーアクションが本当に同じところに入ってるのかみたいな。人間の見方から見たらこの概念だけど、AIの見方から見たら違うよねみたいなことは全然起きうると思う。
林祐輔開始 1:40:51
だからそれもね、俺がakira君とかに送った、有路君に送った、最近のarXivに上げた論文の……。
シャノンの通信理論と人間・AIの「意味」のずれ
有路翔太開始 1:41:03
まさにそれと同じようなことを言ってますもんね。
林祐輔開始 1:41:06
そう、(芯?)ってそこで。僕、あれ書き方が悪かったんで、あんまり人に伝わってないんだけど、要はシャノンって通信の送信者と受信者が全く同じ暗号表を持っているっていう前提を課した上で、通信理論を作ったんですよ。コードブックっていうものを持ってるっていって、通信理論を作ったんですよ。
でもニューラルネット、VAEとかLLMみんなそうですけど、メッセージの送信者と受信者っていうのが、例えばレイヤー1とレイヤー2の間でベクトルをやり取りしますって。これ一種の通信なんですけど、同じコードブックを持ってますっていう保証ってどこにもないわけなんです。これをシャノンの通信理論の眼鏡を通して見ると、コードブックが同じものを使ってるかどうかって、素朴にロスとかそういう指標を見るだけでは分かんないっていうことを数学的に証明したのがこの論文だった。
コードブックって、相手から例えばトンツートンツーみたいな暗号が送られてきたときに、トンツーだったらアルファベットのAを割り当てましょう、トントンツーだったらアルファベットのBを割り当てましょう、みたいに外から入ってきたシグナルと自分の中にある記号を割り当てる。暗号表ってそういう辞書みたいなものなんですね。その辞書が送信者と受信者でずれてても、ロスがめっちゃ低いことになったりするよっていうのを理論的に示したっていうことで。
つまり、その意味なんですよ。外から入ってきた信号の内面における意味がそろってるかどうかっていうのが、外部的にはかなり見分けるのが難しい。こういう場合では外部的に見分けられますよっていうバウンドが不等式で出せるよっていうことを議論したんですけど、これVAEっていうおもちゃのAIで議論してるやつだったんです。単純なのは、これをLLMの中に拡張しないといけないと思っていて。そうすると、まさにさっき出てきたようなインナーアラインメントとか、そういう話そのものになってくる。
林央開始 1:43:23
これ多分、これを見る感じインナーアラインメントそのものだと思うんですよね。そのインナーアラインメント、今軽くAGI Ruinのやつを探してるんですけど、この中にどっかにあるんですか。要するに、すごいシンプルに言ってることとして、一般の普通の環境から例示して訓練する方法だと、そこから学び得る最適化対象がものすごい数あって、それは決して定められないから、もともとそれを定めるような方法が必要だよねみたいな話をAGI Ruinの中でしてて。そんな方法は今全くないから、訓練したそこの範囲において同じ結果を出すありとあらゆる関数の中から、安全なものを選び出す原理が全くないから、全然違うのが選び出されるだろうと。
ちょっと後で探して、[聞き取れず]あるんですけど。(普通に入れないやつ?)。そんな話があって、インナーアラインメントの話とすごい近いと思いますね。
すごいジェネラルに考えると、アウターアラインメントの話もこれだと思うんですよね。人間が望んでいることという概念を(正式にしてしかできない?)という問題に、その1回目でもともと訓練の最適化対象と人間の望んでいることの間で起きているのがアウターアラインメントで、外に用意したものと内側の間で同じ現象が起きるというのがインナーアラインメントなので、結局全部同じ問題だと思う。
これはMIRIの文脈だとオントロジー・アイデンティフィケーションという問題として言ってられていて、要するに人間が使ってる概念とAIが使ってる概念って同じとは限らない。特に将来のスーパーインテリジェントな存在において同じかは全く不明で、そういう中で違うものを、じゃあどうやってそれを指定するのっていう。
確かMIRIっていうか、LessWrongのWikiのオントロジー・アイデンティフィケーションの説明だと、用意されたハイポシシスがいろいろあるわけ。いろいろあるんだけど、そのうち特に、じゃあこの仮説というのは、ダイヤモンドが(何回も何回も対応してるんですか?)っていう対応を取り出す方法がない。そうなるとすると、ダイヤモンドを最大化するというあまりにシンプルな目標ですら追求するAIが作れないっていう指摘をしていて。
結局、アラインメントの困難の多くはここにもあるだろうっていう、かなりラスボスみたいな扱いを受けたんですよ。(本当のジャンプケースって?)。ネイト・ソアレスとかは常に、そこに取り組んでる人が少なすぎるっていうのをすごい嘆いてますね。僕もそれはすごい思ってます。
林祐輔開始 1:46:22
この話って意外に、クロード・シャノンが通信理論って、コミュニケーションセオリーですけど、それを作ったときに捨てた共有コードブックっていう、つまり意味の創発っていう部分を真面目に考え直さないといけないっていう話でもあって。結構奥が深いけど、意外に単純な数学で議論できるんじゃないかっていうふうに個人的には考えてるんですね。
具体的に言うと、活性化空間が本当は高次元ですけど、数千次元とかですけど、2次元に書いたとすると、こういう識別境界。こっちのブルーの領域にベクトルが落ちたら、例えば犬っていう単語を割り当てましょう。オレンジのとこに落ちたら猫っていう単語を割り当てましょうとかっていうふうになっている。この境界線の話がコードブックであり、暗号表、辞書に対応するんです。
だから、同じ活性化空間を前のレイヤーと次のレイヤーで同じように識別境界を書いてるかっていうと、違ってても通信が成立し得るっていうのが僕の理論から言えるんですけど。じゃあどうやってそのミスを減らせばいいのかっていうと、境界を一緒にして記号の(割合を全部していれば?)いいんですけど、そういうことを層と層の間に別のレイヤーを入れて調節する方法がないのかとか、という検討をすることができるんじゃないかと思いますし。ご議論したいな。
でもakira君との話がめちゃくちゃ面白くて、そっちの話ばっかりしたんだけど、僕、有路さんからいただいたこれ。もちろんプルーフリードの白い本ももらって、あれも大切に部屋に飾ってるんですけど、ありがたくもらってるんですけど、これももちろんいい本で。
やっぱりこれ読んだら、有路さんって爆発論者一辺倒じゃなくて、もちろんリスクだったり、こういう批判が出てますよっていうのも両立してバランス取りながら書いてるなっていうのがすごく伝わってくる本なので。全く「イエーイ、もうこれから働かなくていいです。全部ASIが解決、ハッピー」みたいな人とは全く違うよっていうのが、すごく理性的にバランスが取れた本だなっていうのを。しかもALIGNとか谷口先生のCPCとかも紹介してくれてありがとうございます。
こういう話って、逆になかなか自分の日常では全く議論できないトピックですね。今日は(アンケースに?)すごい議論[聞き取れず]ので、だからもう「論文(言ましょうよ?)」って話して、もうじゃあ2人[聞き取れず]っていうことで。しかもいろんなメディアにいっぱい出てる、忙しいと思うけど。
話者不明開始 1:49:45
でも、もうここは[聞き取れず]、話しましょうよ。
林央開始 1:49:45
そうですね。正直、開発停止ができたら全力でそっちをやりたいんですよね。当たり前の話ですよ。個人的にやっぱそれが一番やりたいことではありますね。最終的にアラインメントを解く話が一番面白い。絶対面白いというか、やらないと死ぬ。本丸の方はそっち。
林祐輔開始 1:50:06
akiraさんのその使命感とか切迫感は普通に敬意を持つんですけど、そこは正直、もう政治力学っていうか、もう偉い人たちに頑張っても[聞き取れず]。
有路翔太開始 1:50:20
中で決まっちゃうよね、みたいな[聞き取れず]。正直トランプと習近平で[聞き取れず]みたいな。
林祐輔開始 1:50:25
だからその切迫感とか使命感は、僕はすごく率直に敬意を持つんだけど、もう研究しようぜ、それだったら。
有路翔太開始 1:50:34
でもakiraさんがあれですよね。本当にやろうとしてることって、(米中?)を止めようとしてるわけではなくて、この切迫感を伝えることで研究の土壌っていうか、まず政治の、日本を安全性立国にできないかってことをやろうと思ってる気がするんですよ。
林央開始 1:50:56
いや、ここから先数年のアクティビティは、基本的にすべて開発停止に寄与しなければならないと思っています。ただ、その寄与する方法は、実際に習近平とトランプの意思決定で決まるんですけど、習近平とトランプの意思決定ってこの世から独立した事象じゃないので、そこに影響するような因果経路がさまざまあって。そういうところに介入できるポイントとして、日本へのロビングという因果経路を介してできることって意外といろいろあるよね、というところに目をつけてる感じです。
なので、基本的に日本を安全性立国にすることが目標ではないですね。日本を安全性立国にすることがサブゴールとして、最終的にアラインメントを解くことにも、開発停止の確率を上げるという点においても有用なので、道具的にやろうとしてる感じですね。ゴールは常にここから数年は開発停止にあって、その後はアラインメントの解決にあります。
なので個人的には、時間的猶予も考慮して、最初に僕が取り組むべきことは、やっぱりユドコウスキーの(色?)をもう少し解析力学っぽくすることだと思うんですよ。もう少し[聞き取れず]、形式化されてなくても、ニック・ボストロムの『スーパーインテリジェンス』で行われたぐらいのディコンフュージョンをする。ボストロムの本を読んで、「確かにこれ数学に定式化されてないけど、直交仮説と道具的収斂ってありそうだな」って思ってもらえるみたいなレベルまでいけたら、もっと能力のある人がトライしてくれると思うので。
直接自分で取り組むよりは、あれですよね、シングルエージェントとマルチエージェントの話ですけど、時間的猶予が厳しいので、できるだけマルチエージェントで実行できるように、アラインメントのベースの考え方を伝える方をしばらく頑張りたいと思ってますね。
米中の開発停止をどう促すか、説得と計算資源の監視
有路翔太開始 1:52:50
具体的にakiraさんは、トランプと習近平の因果経路って、どういう経路を想定してる感じですか。
林央開始 1:52:59
トランプはシンプルに、ちょっと(不活用性?)が多いので、一旦習近平から。トランプはアメリカがめちゃくちゃ頑張って取ってるんで。
習近平のほうは意外とすごいシンプルな因果経路があって、まず彼らの専門家ですね。中国の専門家の話を聞くという話がありますよね。中国って、トップに専門家へのブリーフィングって結構ちゃんと頻繁にやる国なので、こっちに浸透できればいいわけじゃないですか。そうすると結局、テクニカルコミュニケーションって僕は呼んでるんですけど、つまり技術的なノウレッジがある人たちが納得できるような議論や主張を展開することが重要じゃないですか。
ただ「こういう話がありました」って話はちょっと限界があるんで、そうじゃなくて実際にこれをやってみました。例えば今ってUK AISIのインシデントがあって、これ、こう起きたんですとか、Hugging Faceの事件でこれ、こう。そのカウンターするのがやっぱり一番説得力がある。一番ちゃんとしてるじゃないですか。「AIは目標を聞いてくれるんだから、ただ殺すなって命令すればいいじゃないか」みたいな。「いやいや、Hugging Face事件では、この脆弱性は使っちゃいけないって言ってたんです」って言うみたいな方法があるんですけど、それはもっとできるはずなんです。それはもっとちゃんと検証できるはずで、ちゃんとエバリュエーションして結果を得るように[聞き取れず]。
技術的に理解できる形で広めるっていうのも明らかに役立つじゃないですか。今って明らかにサンフランシスコの元々の合理主義者コミュニティ、ユドコウスキーの世界観[聞き取れず]人たちがメインじゃないですか。ユドコウスキーから(ボールプリスター?)の間みたいな形が多くて、その外に出るとあまり伝わらないみたいなものに直面してるんで。それを解消することで、中国の専門家を説得というか、[聞き取れず]してもらえる。それがあったら習近平に上がると思うんですけど。
ただ、元々中国ってそんなにすごいリスク選好的な国じゃないので、ユドコウスキー[聞き取れず]にならなくても、ただ30%全員が死ぬと思うだけで開発停止にこぎつけやすい。また、(コンピューターベリフィケーション?)ですよ。「いや、でもやっぱり囚人のジレンマだから」って思ったときに、「いや、もう我々は既にこれに、長くて、長くはないですけど、取り組んできていて、すごい昔と違って今だったら衛星のセンサーでちゃんと検知できますし」。
そもそも、(鬼殺案?)を送れない[聞き取れず]のは分かるんですけど、1年ぐらいしたら、モデルの重みが直接刷り込まれたチップというのにして、そこは監視しないことにしましょう。そうすると訓練できなくて推論しかできないチップで置き換えていけば、監視を緩くしていけますよ、みたいなことがちゃんと進んでるよ、プロトタイプがあるとか、そういうような状態に進めば、意思決定が変わりやすくなるわけです。そういう話ですね。
林祐輔開始 1:55:39
基本的にメインにしている話がクロージングに近づいていってるのに、蒸し返してあれだけど、衛星で、地下でめっちゃ大量の電力使うって、隠す方法ってないのかな。絶対検知できるのかな。
林央開始 1:55:59
理論上、全く[聞き取れず]ことはないですけど、基本的には今のインテリジェンスのレベルだったら全然見つけられる。[聞き取れず]、これはAI 2040の(変更プラン?)の話ですごいいろいろストレステストしてて、その電力消費と排熱をアルミニウム工場だとごまかすみたいな方法が[聞き取れず]か、みたいな分析したりするぐらいやってるんですけど。
[聞き取れず]十分な精度ぐらいにはいける。とにかくチップが最初[聞き取れず]、隠してもないので、[聞き取れず]知られていて、そこからいろいろトラックするから、ちょっとだいぶシンプルになるための一つ、AI 2040に[聞き取れず]プロジェクト、アイデアもあるんですけどね。ちょっとこれは[聞き取れず]。それを使わずに現在のほうですらかなりレベル高い。衛星画像で指が[聞き取れず]してるか、してないか分かるぐらいの精度。
なので、排熱検知とかとチップの追跡ですよね。そこら辺もやっぱり[聞き取れず]貢献すべきだと思います。
林祐輔開始 1:56:56
でも、サプライチェーンの追跡ってめっちゃむずいじゃない。
話者不明開始 1:57:11
[聞き取れず]。でも、やる意義はめっちゃ分かるけど。
林央開始 1:57:18
NVIDIAか何かは既にちょっと取り組んでるみたいですね。NVIDIAの既知のデータセンターに通信を出して、返ってくるまでの時間を測ることで位置を特定するみたいな話をしていて。それに応じて処理が分岐するんですかね。そういう感じでやっていて、そうすると遅くすることはできるけど短くすることはできない。光速を超えた通信を強制しないといけないとなっちゃうので。それはできないから大まかな位置が分かる。そいつが所定された位置にないと機能しないってことができるんじゃないか、みたいな話とかあるのと。
あとGPUって割と償却が早いので、ずっと使ってると、とにかくすごい消耗していく要素があるので、やっぱり早いうちに。これは確か2週間ぐらい前ですかね、論文出たんですけど、そもそもモデルの重み自体がハードウェアに埋め込まれていて、そのモデルの推論しか[聞き取れず]って話が[聞き取れず]。
そうすると最初の1年ぐらいは巨大なデータセンターにどんどん視察団を送り込んで、ちゃんと開発してないことをチェックする。もしかしたら漏れがあるかもしれない。でもそれはあんまり今の(画数技術?)だと大規模じゃないし、チップもトラックしてるみたいな話ができるんですけど。それを超えた先に1年とか2年したら、訓練ができないチップに置き[聞き取れず]、必要[聞き取れず]はないっていう。[聞き取れず]、そういうのが急速な[聞き取れず]をすることで安定させるみたいな話がありますよ。
林祐輔開始 1:58:52
でも、議論に穴があったとしても、それを埋める方向でどんどんブラッシュアップしていくしかないもんね。意義は[聞き取れず]。
林央開始 1:59:04
やっぱり時間的猶予を1年とか稼げれば、それで専用チップが控えているので、その1年の間に敵対者が思いついて実行できるプランに耐えればいいというのはあるので、これはだいぶシンプルだと思います。
極端な話、研究者が使っている、運営に使って、訓練とか実行に使ってるパソコンを見てなさいとか、そういう話もできるので。これは生存者バイアスがあるかもしれない、観測バイアスがあるかもしれないですけど、核開発ってAI開発よりもう少し容易じゃないですか。そこまでのサイズも電力もいらないですし、ウランを集めてくるだけで、全てのサプライチェーンの頂点にあるものを集める必要はないので簡単ですけど、それでもほとんど全てが発見はされるじゃないですか。なので、それはいけると思います。しかも時間[聞き取れず]、1年、2年でいけるんだったら、それはかなりいけると思っています。
有路翔太開始 2:00:04
最優先は開発の停止に寄与することと、その後の最後、オデュッセウスです。家に帰れるような下地を作る。下地というか、アラインメント研究をするってことですよね。
林央開始 2:00:19
そうですね。オデュッセウス、研究が結局最後ですけど、アラインメント研究は難しいのが、AI研究を加速する要素もあるんじゃないですか。(ニックさん?)のやつも、あれを使って機能してないニューロンを訓練中に取り除くことで、より効率的に[聞き取れず]じゃないですか。ちょっと実際[聞き取れず]とか分かんないけど、研究されちゃう。
ChatGPTの立役者ってRLHFだよねって話があるので、AI開発を一度推し進める技でもあるので、開発停止をしている状況じゃないと、アラインメントがそこまで本当に人類にプラスの影響を与えているのか不明みたいになっちゃって。(ミスアラインメントオーガニズム?)にもっと力が入ってるべきかなと思ってます。開発停止できたら、多分全部アラインメントに振ったほうがいいんですけど、っていうふうにフェーズ分けをして考えてます。
林祐輔開始 2:01:11
だって、[聞き取れず]レッドチーミングをやりたいと思ったら、めっちゃ強力な手法とかを、あるいは再帰的自己改善みたいなのを搭載した上で実験しないと、本当に危険な事例が見つからないよね。
林央開始 2:01:24
本当にそれをした頃には、本当に危険で[聞き取れず]ことになっちゃうので、テストの意味がなくなっちゃう。テストっていうか、もうそれ、ただ実際にやってるだけじゃんってなっちゃうんで、そこら辺はすごい難しいですよね。
なので、(ミスアラインメントオーガニズム?)でもっと早めに(シップモード?)を引き出して(帰国する?)っていうのは大事だと思ってます。それはアラインメントを解決できるようなレベルに人間が達する、ガバナンスレベルに達する前は、そっちがもっぱら役立つと。そっちのほうがはるかに価値が高いと思いますね。アラインメントは結局[聞き取れず]、むしろ次の小さいインシデントを防ぐことによって、より大きなインシデントを誘発するというような要素もあるので。タイムラインを縮めちゃいますし。しばらくは。その後はアラインメントですよね。
なので、そういうふうに習近平とトランプの意思決定に、最終的に因果経路で影響するような形で貢献をしようと思ってますね。それを確率0%から100%に引き上げられるようなインパクトはないと思いますけど、1%分引き上げるみたいな話でもできたら、それはとてつもなく重要なことなので。
実証研究を政策につなぐロビー活動と日本の研究基盤
林祐輔開始 2:02:39
そういえば、(センター・フォー・AI・セーフティー・インシティテュート?)だっけ、(カイス?)ってサンフランシスコの(ダン・ヘンドリックさん?)が、(週に?)AIの研究開発を減速させるか止めろって言った提案書って、結構世界的にはニュースだったかなっていうのがあって。つまり市民団体っていうか個人だったりの活動が、[聞き取れず]議論を喚起するっていうケースはあり得るなっていうのは、今のakiraさんの話を聞いて[聞き取れず]思ったっていう。
林央開始 2:03:13
いや、本当はロビングにもっと活用できると思うんですよね。僕は自分が今ロビングをする中で、普通の人がロビングするのに比べて、一番意味があるなと思うのは、もらった質問にその場で回答できることだと思うんですよね。「いや、でもこれってこういう可能性、こういう方向になるんじゃないの」みたいな。しかも「実験的にもこういう実験がありまして、こうなりました」みたいな話ができるのが、やっぱり今の自分のロビングの一番のレバレッジだと思うんですよね。そういう点で役立ててる人が少ないだけで、本当はもっとポテンシャルがあると思ってます。
AIをテストしながら進むようにするための安全評価フレームワークを作れば、それで開発を続けていいんじゃないか、みたいな。でも例えば(ハッカーオーパス?)の実験があって、そのときには普通のエバリュエーションを全部やったけど、全然うまくいかなくて、全然安全に見えて。Anthropicの人たちも「意外と安全なんじゃないか」という結論が出そうだったところで、Hugging Face実験が起きて、テストしたらめちゃくちゃ暴れたっていう実例があったので、「これはそうはいかないんですよ」って言えるところが、やっぱり自分のロビイストとして一番レバレッジがあるところだと思うので、本当はもっと活用できると思うんですよね。
(アジアコトロさん?)も、(アジアコトロさん?)でしたっけ、(リャンさん?)。
有路翔太開始 2:04:35
どっちか[聞き取れず]。
林央開始 2:04:36
ライアン・グリーンブラットさんとか、どっちか。公聴会に行ったときに、そこでHugging Faceのインベスティゲーターだったんで、そこで説明して「うわ、すごいね」って言われるみたいな話があったので、やっぱりそこら辺は本当は一番意味があるところと。
林祐輔開始 2:04:50
さっきakiraさんが自分のことをロビイストって自認してるっていうのにまず驚愕して。そしてもう休学して、[聞き取れず]になることを選択して、米中に影響を与えるんだって言って活動してるって言ったら、個人としては言うことないっていうか、もう頑張ってくださいとしか。
話者不明開始 2:05:12
(ありがとうことないみせん?)。
林祐輔開始 2:05:16
いや、でもさ、日本でコミュニティも小さいし、ちっちゃい組織が(断日して?)ちょこちょこやっているだけで、ようやく海外のファンディングとかをしに行こうみたいな話も出てきてるけど、っていう感じじゃないですか。だからもっとエコシステムを作るべきだし、日本からも発信していくべきだなって。
林央開始 2:05:43
そう思いますね。イギリスはできてるんですよね。イギリスはUK AISIがあるじゃないですか。意味があるアラインメント・エバリュエーションを[聞き取れず]。それは日本でもできるはずじゃないですか。ちゃんとエコシステムを育てて、ちゃんとやれば。政治的意思とエコシステムの構築があればできると。
そのUK AISIだって、ユドコウスキーにすごい[聞き取れず]精通してるわけでもないので、ちゃんと[聞き取れず]、すごい意味があることができると思うんです。やっぱりそのための要素の一つはロビングが必要。どうしても一番効くのはロビングなので、[聞き取れず]重点を置かなかったら[聞き取れず]。本当は僕が100人ぐらいいれば、ローテーションで「今日の僕は楽しいからアラインメントの話をしよう」と、そういうことができるんですけど。そうはいかないので、[聞き取れず]ロビイストになってます。
有路翔太開始 2:06:39
(ロンダンフェス?)でもすごいいろんな人と、人脈爆発が起こってましたもんね。いろんな、小泉悠さんとか軍事評論家の人とかもいろいろいて、そういう人たちに「いや、人類はもうやばいんです」って言って、「本当ですか」みたいな。
林央開始 2:07:01
そう、してましたね。「Hugging Faceインシデントがありまして、その中で」みたいな話を。何なら「実はその後ろでOpenAIの実行サーバーも発見されたんですよ」「えー」みたいな話を。
やっぱりそういう、本当は違うと思うんですね。本当は一番大事だと思う種類の人材って、ユドコウスキー理論って抽象論なので、それをLLMに落とせる人がもっと必要だなっていうのは思ってますね。
有路翔太開始 2:07:30
このコードブックとか、まさにオントロジー・アイデンティフィケーションをすごい。
林央開始 2:07:36
そうですね。やっぱり僕が思ってるのは、ユドコウスキーのアイデアをちゃんと人に伝わる形で、(解析力学?)[聞き取れず]進んでなくても、ある程度形式化すれば、それぞれの分野に精通したそれぞれの人々が、意味がある貢献をできるようになるかなと思っています。
林祐輔開始 2:08:13
っていう気がしていて。つまりシャノンは共有コードブックっていうものの存在を前提として通信理論を作ったけど、その外側がありましたっていう話をディープラーニングとかLLMの中で展開しようっていうふうに僕は思っているわけなんだけど。
つまり既存の我々が使う工学の理論だったり、物理学の理論だったりを拡張するっていうか、道具の部分から作らないと、もしかするとユドコウスキーの直感を支える定式化ができないんじゃないか。そこから作り直さないといけないんじゃないかなっていうのを、2人の話を聞きながら何となく。
林央開始 2:08:55
そうです。僕は常にそれを支持していて、逆にそれに取り組んでる人も少ないです。難易度も、明らかにMIRIが20年取り組んできてできてない話ではあるので、すごい難易度も高くて、[聞き取れず]できないのも、やっぱりアラインメントを開発しながら成功させることに悲観的な理由の一つでもあります。
そもそもできても、AI企業がそれを実行するのかみたいな話にも衝突しますし、やっぱりそれはレベルとして遠すぎるので。
林祐輔開始 2:09:23
AnthropicとかOpenAIが内部モデルで数学とか物理の未解決問題をバサバサ解いているんだけど、そういう手法を危険じゃない形で、もっと研究者に。一部既に物理学者とか数学者には検証のために伝わっているとは思うんだけど、そういうものをもっと普及して。
だから僕たちすらも(フェイベル?)とかアストラとかを持ってるんだから、みんながアインシュタイン級の仕事をしないと、逆に恥ずかしいっていうか。みんなが新しい相対性理論みたいなのを、科学者なら当たり前っていうか、科学者じゃない人も作れるみたいな状況に近づいてきてるわけなんだから、一生で1個ぐらい、そういうぐらいの仕事をみんながしないと恥ずかしいぐらいの世界になってきたんじゃないかなって。
それでシャノンの理論の外側に行くとか、つまり「意味って何だったんだろう」、[聞き取れず]作るとかいうことをやって。解析力学を、ユドコウスキーの理論を解析力学にするみたいなことも、みんながしなきゃいけないと思います。僕の中学生のときはアインシュタインがヒーローだったんだけど、逆にみんながアインシュタイン級の仕事をしないとダメなんじゃないかっていう。
有路翔太開始 2:10:56
(時代に薬業?)とか言ってる場合じゃないですね。そう、やんなきゃいけないっていう。
林央開始 2:11:08
逆に時間が足んないっていうか、無限にやることあるじゃんみたいな。アラインメントしなきゃいけないんだよ。アラインメントってめちゃくちゃ難しい未解決問題だけど、AIに仮にやってもらうことはできない。
林祐輔開始 2:11:20
もっと意味がある。数千次元の、めっちゃ高次元の中の、意外に低次元空間[聞き取れず]しかLLMは使ってないんじゃないかとかって仮説があったりするけどさ。そういうのを調べて[聞き取れず]、「ああ、こいつらの頭の中で意味ってこんな感じで使われてたんだ」みたいなのって解明しないといけないと思う。
林央開始 2:11:45
そうですね。そこら辺はもっともっと[聞き取れず]、そのレベルをさらに超えて、何でこの認知が形成されるのかとかも分かんないと、将来的に安全[聞き取れず]、どう形成するかって話が変わっちゃうし。そこら辺でもやっぱり、そもそもそれをするための最も根本的な部分が欠けてると。
コードブックの一致みたいなのを仮定してたことに気づいて、それをやめるみたいな話を多分もっともっと全てのところでしないといけないので。将来のAIアラインメントで使うには、やっぱりそれをほぼ全部でしないといけないので、自分が当たり前に使ってることにいかに仮定が多いかを発見しないといけない[聞き取れず]出てくるので。それは結構難しいと思いますけど、最も価値があることになってますね。その最も特殊な新しいスキルですけど。
ミスアラインメントの科学と安全な行動を定義する難しさ
有路翔太開始 2:12:34
「ミスアラインメントサイエンスとアラインメントエンジニアリング」って記事が最近あって、エンジニアリングでアラインメントを解くっていう発想じゃなくて、ミスアラインメントのサイエンスをしなきゃいけないみたいな。[聞き取れず]、結構その態度が全然違うんですよね。
やっぱり何となくこういうふうに振る舞ったから、こういうふうにアラインメントされてるだろうっていう感じじゃなくて、その力学を、後ろにある数理レベルからもう解き明かしていかないといけないよねっていう発想ですよね。
林祐輔開始 2:13:17
そうですね。(マシンコンシャンス?)の土日の会議に行ってて思ったときに、生き物の体の中って高分子が相互作用し合っていて、水分子とかもあって、本当に複雑な相互作用があって、ノイズだらけの中で神経が信号を伝達し合ってたりするっていう話をされてて。
生き物の体から比べると、LLMの中の構造ってすごい単純で、構造はまず分かってるし、設計されてるんだから、どんなふうにベクトルが流れていってるのかとか追跡できるしということで、めちゃくちゃ生き物の体に比べれば単純だと思うんですよね。あと、人間が理解してると思うんですよね。それなのにLLMに知能の面では人類が負けちゃったっていう。これが面白いなと思って。
林央開始 2:14:06
おもちゃに負けちゃったよみたいな。自分が作ったものに負けちゃったよみたいな。
林祐輔開始 2:14:11
っていうのは。でも、だからこそ、頭はいいんだけど、LLMのほうが。アラインメント解決できんじゃねえかっていうことに取り組みたいっていうか。
林央開始 2:14:24
そうですね、取り組みがあると思いますね。結局、個人的に常に思ってるのは、ちょっと(オントレジャンル?)の話に戻ると近いんですけど、アラインメントの形式化の難易度がはるかに高いと予想する理由の一つとして、あまり自由度を取らせてもらえないというのがあると。
一般的に全てを記述する理論として、こういう自由度を入れたらこうなりますって話なんですけど、アラインメントの場合、仮にそういうものが作れたとしても、自由度に入れるものの意味が我々が望んでいるものと一致しているかもチェックしないといけないんで。結局欲しいものって、非常に現実に言及した、ある意味で我々の持ってるものに近いような、自由度が少ない理論じゃないといけなくて。そうするとすごい難易度が上がりますよ。一般的な形式化よりはるかに難易度が。
林祐輔開始 2:15:10
それはそうです。でも、今のところ、例えばLLMっていうところだけを切ると、あいつらってただトークンっていうベクトルを処理してるだけじゃないですか。めちゃくちゃ自由度が狭いですよね。ただ、その出力されたトークンを使ってアクションを取るっていうふうに、外付けの装置がついてくると、現実世界にアクションを取れるようになったりすると、ビジョンランゲージモデルとかそうですけど、今言ったように自由度がめちゃくちゃ上がりますよね。
でも、その場合ってビジョンランゲージモデルの外から入ってきたビジョンを処理して、どう指示文にするかっていう部分に切り取れば自由度を制限できるので、そこでだったら解析はいろいろできるんじゃないですか。
林央開始 2:16:01
解析は多分できると思ってて、多分、解析からヒントを得るとか、得るべきだと思うんですね。[聞き取れず]レベルで本当に実験することってできないので、今のレベルからも取り出せるだけの知見を取り出すべきだと思うんですけど。
そういう意味だとできると思うと、それ、[聞き取れず]起きてることの分析、結局、理想的な理論における分析においては、やっぱり[聞き取れず]にしないといけないじゃないですか。結局どんなにやっても、得られるものって「こういうふうなベクトルで記述されています」で、なんで。
林祐輔開始 2:16:35
そうだね。論文でもさ、(表彰行動?)とかっていうのはどう定義しますかっていうと、あるアクションを取ったときに、指示された文章にそぐわないアクションの集合としますとかって定義されていて。数式では定義は書けるんだけど、これ一体どうやって数え上げるんだとか、例外がないっていうのを現場でチェックするんだって、無理じゃね、みたいな感覚はありますよね。
林央開始 2:17:07
僕もその感覚はすごい抱いていますよね。結局、多くのアラインメントの今の議論っていうのを、仮にアラインメントが解けたとして、30年後の「アラインメントの歴史を、もう暇だから学んでみようか」みたいな人たちが見たら、「この人たちはなんでこんなひどい形式化をしてるんだ」って言われると思うんですよね。
30年後の人たちが見たら、今あるこの形式化に比べて間違いじゃんって言われると思うんですね。アラインメントの[聞き取れず]、それぐらい難しいはずで。それがすごい現実の[聞き取れず]。
林祐輔開始 2:17:41
とはいってさ、ガバナンスとか制度のほうで縛っていくよね、人間社会ってね。だから、理論上はもっと協調的っていうか、人間が指示したことに従う行動っていうのは、もっと広い集合としてあるんだけど。そういうことを考えると、僕らがどう考えても安全と認められる、この行動の範囲でしかアクションを取れないように縛りましょうね、みたいなものを。
それもまた穴があるかもしれないって話にはなってくると思うけど、エネルギーを制約するっていうことを社会ではよく使うようになっている。
林央開始 2:18:25
自分もその方向性に最終的にすごい賛成とか、ユドコウスキーもずっと言ってるんですけど、ホワイトリストサーチじゃないといけないよね。結局、これは駄目ですみたいに言っても、人間が予想してなかった範囲に大量の探索すべき空間があって、その中に望んでないものがおそらくあるので。この範囲、安全って言えるこの範囲っていうふうに制限しないといけないって話はずっとしてて、最終的にはその[聞き取れず]もすごい強く支持してるんですね。
個人的にコードブックの話で、僕が持ってる考えにすごい近いなと思った。最終的にどうやってオントロジー・アイデンティフィケーションとあるような問題が解けるかっていうのを考えると、[聞き取れず]ユーザーを指定するみたいな話がめちゃくちゃ難しいんですけど、それは一旦乗り越えられたとして。そもそも、ある意味でグラウンドトゥルースとして何を求めるべきかってあると思う。
その中でエージェント間の一致っていう[聞き取れず]がすごい好きで、もともとそれが[聞き取れず]、昔からあるんですけど、コードブックの話、それにすごい近いと思いますね。つまり、究極的に何か現実において法則を探すよりも、純粋に「二つのエージェントが同じの使ってんだから、それでいいじゃん」のほうが定式化できるし、扱いやすいと思うんですね。究極的には人間が持ってるものとAIが持ってるものが一致していれば、それで満足。そのフォーカスが[聞き取れず]すごい好きとか、感動しました。ここからも出てきた、みたいな[聞き取れず]はありますね。
林祐輔開始 2:19:59
実は、このシャノンの理論には意味が扱えない。それはなぜかというと、共有コードブックっていうものを最初から仮定してるんだっていうのは、京大の集合的予測符号化を提唱した谷口先生が言ってて。
なんでそのことを考えたかっていうと、彼はおそらく、コミュニケーションっていう言葉は通信を含むもっと本当は広いものなのに、シャノンが天才だったばかりに、あまりにもきれいな完結した通信理論っていうものを作ってしまって、すごく狭く限定してしまったんだっていうことを僕に教えてくれたんですよね。それで、じゃあどういうコードブックってものってLLM、あるいはVAEの中にあるんだっけって考えたら、いや、ないじゃないかって。じゃあ、これどうなってんだっていうのを調べようっていうふうに言ったんですけど。
僕はだから、谷口さんとそういう話をしなければ、一生コードブックについて興味を持ったり調べようとすることはなかったはずなんですけど。まだまだ、僕らが大学とか、あるいは本屋さんでも何でもいいけど、既にある使える道具っていうか、数学の道具だったり理論だったり、理論の外側がいっぱいあるはずで、人類がまだ見つけてないものっていうのがいっぱいあるはずで。それをアラインメントの[聞き取れず]、足りない道具だったら全部作るみたいな感じで。
林央開始 2:21:38
僕が既存の理論で一番興味があるのは、どうしてその道具立てを、その道具をどうやって作ったのかっていうのが一番[聞き取れず]なんですよ。あるいは科学史に近いような要素が入ってくるんですけど、昔の人がどういう思考実験を、どこで失敗してどうなったのかみたいな、[聞き取れず]取り入れれば汎用的に使えるはずなので、それを取り入れたいなと思ってますね。
結局、最終的に自分が全ての分野を学ぶという非現実的なタスクになっちゃうので、そうならないようにするには、やっぱりこっちがアラインメントの考え方を伝えるっていうのが一番シンプルという。そしていろんな分野の人も自分で見てくれる。
林祐輔開始 2:22:19
(グループレイズ?)さんたちもそうだけど、この角度のこの部分だったらユドコウスキーたちが言ってることは正当化できる、検証可能な問題に置き換えられるみたいな仕事を、いろんな人がこれからやってくるんだよね。ごめん、[聞き取れず]カットインして、(有道くん?)が話そうとしてたら言っちゃったけど。
有路翔太開始 2:22:42
今、多分世界中でアラインメント研究者って、多くて1000人ぐらいじゃないですか。なので、技術爆発の話で半内生成長モデルとかってあるけど、あれだと研究者数をガーッて、多分アラインメント研究者の数を上げることができたら、技術発展とかアイデアの爆発ってのが起こるって言われてるので。
そこら辺、多分すごい異分野の、さっき言ったシャノンのコードブックが、みたいな谷口さんの話とかあったように、そういった話っていろんな分野で多分あると思うので、いろんな人がアラインメントの科学に興味を持ってくれると、すごい爆発が予想できるかなって思いますね。
異分野の知見と失敗を見抜くセキュリティの思考法
林祐輔開始 2:23:37
とか、バックドアの話とかだと、ホワイトハッカーっていうか、セキュリティのリスク関係の研究者の人たちの知見って、多分使えるだろうし、使えるものがあるだろうし。
林央開始 2:23:48
っていうか、考え方がすごい使えると思うんですよ。これ、ユドコウスキーがセキュリティマインドセットと呼んでるんですけど、普通のエンジニアとかって作るときに、どうやったら普段の状況で動くかっていうのを考えるけど、セキュリティマインドセットがあれば、どうやったらこれが失敗するのかを考えるっていう話があって。
ユドコウスキーも完全にセキュリティマインドセットのタイプ。提案されたアラインメントの方策ってどうやって失敗するのか、特定するじゃないですか、彼って。すごい、なんでそれを思いついたのか[聞き取れず]んですけど、そういう(ユニアス?)でも使いどころがあると思いますね。
実は個人的に、将来的にアラインメントを解く上で、それはすごい重要だと思っていて。やっぱりセキュリティマインドセットはどうしても必要になると思うんですよね。[聞き取れず]死ぬという[聞き取れず]もついていますし。その、[聞き取れず]というそういう環境だと、やっぱり実際には機能し[聞き取れず]、自分が思いつく穴を全部塞いだけど、実際には全ての穴が塞がってないっていうのが出てきやすいと思うので。
そういうときに穴を見つけるのが(高い?)人が多いって、自分でチェックできれば一番早いですし、他人の[聞き取れず]を見て、「いやいや、これ、あなたがそう言ってますけど、実はここでこれ、こう失敗します」って言える人がいたほうが、それが(エスケール?)の価値があると思うので。セキュリティマインドセットは広がるべきだと思ってますね。
そういう意味でもミスアラインメントオーガニズムはすごい支持してるんですよね。要するに、最初の(回生者?)ができるまでの間のミスアラインメントオーガニズムをやる経験によって、非常に抽象的にユドコウスキーが昔言ったような失敗モードとか、「だからジェネラルに失敗するんですよ」みたいな話を。そういう経験をすると、やっぱり失敗しないような応用力ってすごいつくと思うので、そういう経験をした人たちが、アラインメントに(改正して?)できたからアラインメントしようと[聞き取れず]、そうじゃない世界線よりはるかに生存率が高いと思う。
ただ「これが思いついたから、これやってみよう」じゃなくて、「でも、これって考えるとこういう失敗モードがありますよね」とか、「自分でも考えたけど、こういう失敗モードがありました」みたいな話のほうが、はるかに生存率が高いと思うので。そういう順で踏んでいくのが、そういうときに分野としてはいいと。
ミスアラインメントオーガニズムの話から広まる。そのためにアラインメントの全体像みたいな話が、ユドコウスキーの[聞き取れず]、ちゃんとした形じゃなくてもある程度広まっていて。それで実際に失敗モードに落とし込んでみた人たちが、今度、証拠みたいなのが出てきても、そういうのを、[聞き取れず]しばらく(袋ビースト?)してなきゃいけない。(ウイルビースト?)するときに活用して、(回徹?)ができたら、じゃあ今までの経験も活用しながらアラインメントしましょうっていう。生存率が高い(しないので?)、可能な範囲でっていうか、あり得る範囲でっていう。
ユドコウスキーが暗黙のうちに使っている、または明示的に使っている思考法みたいなのも乗って、アラインメントの知見がついているのがあるのが、一番いいんだと思っています。ここら辺って、そもそも科学の基本まで掘り起こして、ユドコウスキーの考えを書いているといいますか。実験できないから、すごいレベルの外挿が必要で。今までの普通の「実験してみよう」って方法だと駄目だから、合理主義にしましょうって話で、(合理進行?)を作っているところもある。そういう、もっと基礎から掘り起こす話が[聞き取れず]と思う。
有路翔太開始 2:27:43
ある種のパラダイムシフトというか、科学というものに対する考え方が変わる何かが、そういうものがあるのかもしれないですね。
林央開始 2:28:05
それはそれとして、とりあえずコードブックの話を進めると面白そう。ミスアラインメントオーガニズムは全体的にめちゃくちゃ穴がありすぎるというか、むしろ埋まってる部分が少ないので。
林祐輔開始 2:28:18
そうなんだよね。犬っていう単語を使ったときに、それがその人の中で使われている意味と、他の人が使ってる意味が一緒かどうかっていうのを扱う数学が今までなかったっていう話で。だから、意味ってそもそも何なのとかっていうレベルから、もう一回見直す余地があったっていう。
林央開始 2:28:45
それはMIRIが持ってる問題意識としてのオントロジー・アイデンティフィケーションに一番近いと思いますね。[聞き取れず]違う経路で同じ問題が発見されてるような[聞き取れず]ありますね。やっぱりMIRIはオントロジー・アイデンティフィケーションを最難関と見なして、コアプロブレムみたいな扱いなので、重要だと思ってます。
林祐輔開始 2:29:07
今度は、まさに昨日ちょっとだけお話しさせていただいて[聞き取れず]、(横井翔?)先生だと、活性化ベクトルの距離が近いっていうことが意味の近さと関係するんだってことを、数学的に示した論文の紹介とかをスライドで書かれていたりして。横井先生自身もいろんな研究をされていらっしゃるんですけど。なので、意味を扱う数学っていうのがどんどん出てきていると思っていて。だから、そういう意味では道具がなかったっていう部分もあるんだろうな。
林央開始 2:29:53
思いますね。取り組んだ人が少ないので。
話者不明開始 2:29:58
それもありますよね。今後、道具を掘り起こすっていうのが、この先一番の大事なポイントになりますよね、それは。
林央開始 2:30:07
なんで解析力学の(パズル?)がすごい[聞き取れず]でしたね。っていうか、解析力学をちゃんとやったことないので、考え方として一番近いのはそういう発想だよなあと思いつつ。
林祐輔開始 2:30:18
混沌として、それぞれバラバラにあったものを統一するっていう話が、[聞き取れず]山本先生と中村先生の本だか、こう書いてあったんだ。さっき僕が話した話は。
ニュートンが天才だから、直感で天体の軌道とかをズバズバ解いていったんだけど、それを『プリンキピア』を読んだ人が、「いや、これ天才じゃねえと解けねえよ」みたいに、自分の日常生活で出くわすような問題に適用できないよって思ってたら、後に数学者たちが出てきて解析力学っていうのを作って。
ハミルトニアンとかラグランジアンを定義するのが肝で、そこから運動方程式を機械的に導出するやり方っていうのは整備できるから、ラグランジアンとかハミルトニアンっていうものさえ書ければ、誰でも運動方程式が導出できるようになるんだっていうふうに整理したっていう。そこから物理がみんなが使えるようになったっていうふうに書いてあって、めっちゃいい話だったみたいな。
林央開始 2:31:20
[聞き取れず]。それをしたいんです、アラインメントで。エリーザー・ユドコウスキーとネイト・ソアレスとポール・クリスティアノだけが使っているニュートン力学みたいなところから、誰でもアラインメントの話ができるような[聞き取れず]持ってくるには、やっぱり解析力学化が必要。
林祐輔開始 2:31:36
しかも天才も直感でいくんだけど、後々調べてみたら、実は間違ってましたみたいなのも[聞き取れず]。だから、打率が高いだけみたいな感じはあるんだよね。でも、そもそもそういう直感で「あっちにある」っていう人もめっちゃ大事なんだけど、(大事な方がある?)みたいな。
林央開始 2:31:56
なので総合的に、最終的にアラインメントが解決される状況って、やっぱりすごい人、または漸進的な積み重ねによって、[聞き取れず]、こういう失敗モードを避けるためにパッチを打ちまくったんじゃなくて、すごい、多分シンプルに機能するコアみたいなのがあって。それに基づいて、[聞き取れず]シンプルな理論として、論理として、これでこうでこうなって、こうなるから安全なんですっていう人がいて。それはある意味でちゃんと、少なくともある程度形式化された[聞き取れず]。
僕がロケットの例えを使うのはそういう理由。ロケットって厳密に、予想どおりに行くわけじゃないじゃないですか。大気圏の中でむちゃくちゃ空気の抵抗を受けるけど、流体力学[聞き取れず]。ロケットの形って、質点で仮定して、それでもそれで[聞き取れず]。後から[聞き取れず]問題を[聞き取れず]、近似しましょうって話をやってるわけですけど、総合的には機能しますし。「とりあえず月が見える方向にロケットを飛ばして」って言ってるより、はるかに高いレベルで議論ができるじゃないですか。
なんで、そこら辺のある場所まで持っていかれていて、[聞き取れず]ロケットに関しては、この軌道でこうエンジンを噴射して、こういう軌道に行って、ここからさらに[聞き取れず]噴射をして、こういう軌道に行って、減速して、[聞き取れず]から火星に行けますっていう、ある意味このサクセスストーリーがあるじゃないですか。[聞き取れず]。
そういうのがアラインメントでもできて、それを見て、確かにロケットの[聞き取れず]は質点で仮定はするけど、それで計算したらちゃんと[聞き取れず]理論があって、「確かにそうなるね」って言って、「じゃあやろう」。その辺がアラインメントで目指すところだと思うんですよ。
そのための基盤として、やっぱりそもそもニュートン力学がないですみたいな話。いや、重力の法則とかまだ分かんないから、みんな物が落ちてくる理由は、地面が、物が地面が[聞き取れず]、そういう。
有路翔太開始 2:33:51
そもそも目標とは何かとか、そういうのもよく分からない。
林央開始 2:33:55
そう思うんですよね。そういうのを乗り越えていくところが、多分しばらく仕事としてすごい重要というか、最も肝だと思いますので。そういう意味だと、思考と実験の組み合わせってすごい意味があると思っていて。
「物が地面に落ちるのは地面が好きだから」っていうのに対して、「じゃあ地面ってのは何なのか」みたいな不思議な混乱が見つかるはずなんですよ。地面っていうもののうちの一部でありそうな土を1kg拾って上に吊り上げたら、その[聞き取れず]、近くにある物も上に落ちるのだろうか、みたいな。考えると意味が分かんなくなってくるじゃない。それが今のアラインメントにコンフュージョンがあふれているんだと思っていて。
[聞き取れず]、実際それをやってみよう、[聞き取れず]も変わるのか[聞き取れず]。そうじゃなくて、もっと月を見ることで、いやいや、そんな話じゃなさそうだよって話。ニュートンが、逸話ではありますが、気づいて、「いや、月も落ちてきてるんだ」みたいな。そういうところに行くのが大事だと思う。とりあえずは、それで混乱するのが大事だと思う。「いや、地面だったら地面を切り出して上にやってみたら、物が上に落ちるんですか」みたいな、そういうのが大事だ。
林祐輔開始 2:35:09
いや、すごい今いい話で。アインシュタインが16歳だったかな、光の速さで光を追いかけたら何が見えるんだとかって思考実験したとかさ。木からリンゴが落ちるのを見てさ、月と一緒なんじゃないかって気づいたとかってさ、逸話があるわけじゃん、天才の逸話みたいなさ。
そういうのがもう意味ないんじゃね、みたいな。(僕から未解決問題とか遠くから?)意味ないんじゃない、みたいにあるんだけど。そもそも確立された科学の外側がまだ膨大にあって、それはやっぱり変なおっさんというか、お兄ちゃんとかお姉ちゃんかしら、若い人が、「ああ、これこういうことなんじゃないか」みたいな。まだそういうロマンティックサイエンスの余地がアラインメントに、むしろアラインメントはそういうのを求めているみたいな。
有路翔太開始 2:36:07
アラインメントがロマンチックにならなきゃ。
林央開始 2:36:09
やばいって感じで。アラインメントは最もロマンチックではありますよね。そういう思考法がAIがある時代でも求められながら、最も重要な問題なので。NP問題とかって、解けても解けなくても、人類の(ネーム?)が変わったりはあまりしないですけど、アラインメントは時間制限付きで解けないと全員が死ぬという問題なので、[聞き取れず]重要であり、かつ、[聞き取れず]でも生き残る。
林祐輔開始 2:36:38
谷口さんからコードブックの話を初めて聞いたときに、いいなあと思った、[聞き取れず]かっけえなあと思ったんだけど、やっぱりそういうセンスのいい思考実験、[聞き取れず]いっぱいしていい[聞き取れず]。
オントロジー同定問題とダイヤモンド最大化の思考実験
話者不明開始 2:36:52
そこから新しいサイエンスが生まれてくるみたいな。
林央開始 2:36:52
そうなんですよね。僕もそれをすごく支持していて、エリーザー・ユドコウスキーがすごいところって、そういう要素もある。[聞き取れず]平気に見つけているので。
オントロジー・アイデンティフィケーションの話でも、彼が一番懸念しているのは、コンピューターの中で、もともと人間とオントロジーが合ってないケースもある。それもやばいんですけど、それはいったん解けたと仮定しても、コンピューターの中で内部表現が変わる可能性があるよね、という話をしていて。でも内部表現だと理解しにくいから、外部に対する表現自体が違ったほうがよいということで、原子論の世界で作られたAIが、原子論のみを表現できるチューリングのやつでAIXIが組まれていて。確かビット数に[聞き取れず]、無限にならないように、(P?)[聞き取れず]って言ったんですけど。
そういうのがあったときに、この原子の世界のみですべての仮説は記述されているので、その中で運よくダイヤモンドというのを記述できたと仮定する。それを現実世界に放ったときに、いかなる問題が起きるかと考察して。これ、[聞き取れず]、これで問題が起きるって言って、結構頑張って考えたんですけどね。で、見たんですよ。[聞き取れず]。LessWrong記事なんですけど、書いてあったのが、やっぱり原子の記述方法だと観測をちゃんと説明できなくなってしまう。
だからガンマ線バーストとか、[聞き取れず]観測できるのに、意味が分かんなくなっちゃう。(二重スリット?)が意味分かんなくなっちゃう。それは明らかに、起きる観測を説明できなくなっていくので、起きる観測を説明できる仮説かつ原子世界を支持しているものっていうのの一例として出現し得るものが、「この世界はシミュレーションである」。
古典的コンピューターという原子論の世界を用いても、究極的に言えば、すごい計算量、確か指数的に爆発するはずですけど、量子世界を記述できるじゃないですか。なので、実際に適切な仮説として、ただこの世界が原子の世界であるという仮説は現実を説明できないので、どんどんクレデンスが下がっていって。残るのは、原子論に縛っているので、この世界が原子論の世界でシミュレートされている量子論の世界であるという結論に達してしまって。
そうすると、その中でダイヤモンドを示すじゃないですか。それはダイヤモンドって、地球に、現実の世界にあるダイヤモンドではなくて、AIがシミュレーションだと考えている世界を実行している実世界のダイヤモンドなんです。そしたら追求している目的は全く変わってしまうっていう、すごいとんでもない思考実験を提示したりしていて。
そういうのだと、もっとそういうスキルが本当は必要だと思うとか、そういう思考実験がたまっていくと、それを組み合わせて。アインシュタインの思考実験って話ですよね。そういうのが積み重なっていくと、ある意味で我々が知っている非常に少ない知識と、AIXIと[聞き取れず]の両者の話から外挿して、長期の動きのものを先に見つけるような。そういうのをもっと推奨していきたいです。そういうのがちゃんと(復帰?)されれば活用できると思う。
林祐輔開始 2:40:06
シミュレーション仮説ってあんまり好きじゃなかったんだけど、自分がシミュレーションだと思ったら、今いる自分の命とかも大事にしなくなるんじゃないかって、なんとなく素朴に思ったりして。すごいシミュレーション仮説を言ってる人を見つけたら、「お前、弾丸を1個だけ入れた拳銃をぐるぐるって回して、こめかみ[聞き取れず]」って言いたくなってたんだけど。今akira君が教えてくれたような話を聞くと、すごい面白いっていうか。
有路翔太開始 2:40:37
若いときのユドコウスキーさんとか会ってたら、友達になってたんじゃないかみたいな。
林央開始 2:40:41
ユドコウスキーも、でもちょっと性格が微妙なので、ちょっと難しいかもしれない。めちゃくちゃ賢いは賢いんですけど、あまりに多くの人から否定されすぎて、めちゃストレートに暴言吐いてるんですよ。[聞き取れず]、触れたい人が少ないくらい、その状態なんで。
林祐輔開始 2:41:01
でも、すげえ今の思考実験面白かったよ。ていうか、話聞いた人がさ、akiraみたいな真面目な青年がさ、1週間とか1か月間ずっとうーんって悩みたくなるようないい思考実験出してくるんでしょ。すごい素敵じゃん。
林央開始 2:41:18
こういう思考実験とかって話って、ニック・ボストロムとかも結構出してるんですけど、そういう話をもっと積み重ね、そういうのってばらばらにあるので。本当にエリーザー・ユドコウスキーぐらい[聞き取れず]、全然知らない世界観。そういうのを新しく発見したり、そこから思考すること、アインシュタインが相対論を発見したようなことをすることによって。あるいは光速で実際に実験せずに、光速についての議論をしたアインシュタインと同じように、超知能を作らずに超知能についての議論をするっていうのが、現実的には[聞き取れず]、思考法がめちゃくちゃ役立つと。それをするのが目的ですよね。それが目的なんですけど、それができる人を増やすのが[聞き取れず]、多分。
有路翔太開始 2:42:03
だからシミュレーション仮説っていうと、単にこの世界はシミュレーションかもしれないだけの仮説に思われちゃう。
林祐輔開始 2:42:11
そう思ってるから嫌いだった。
有路翔太開始 2:42:13
だけど本来は、意思決定理論とかとめちゃくちゃ組み合わせると、すごいいろんな思考実験とかが生まれて。アインシュタインが光の速度で光を追いかけたらどうなるかみたいな話の、シミュレーション仮説版で。[聞き取れず]なんですよね。そういった脅迫の実験とか、AIがボックスから出てくるときに、もうここでいろいろと。でもこれちょっと情報災害とかそういう話もあるんで、あれなんですけど。
「この世界がシミュレーションかもしれない」っていう話をして。でもシミュレーションだったとしても、「今俺がこれをシャットダウンすればいいじゃないか」って言っても、「でもこれ、俺がちょっとコミットして、いろいろと未来でそれをやっちゃうから絶対起こるんだ」みたいな。そういう複雑な議論とかって、シミュレーションっていう可能性とかを考え始めると、意思決定理論とかすごい複雑。普通のCDT、因果的意思決定理論では乗り越えられないようないろんな複雑な世界がばーっと爆発していって。
そこにおいて超知能とかAIとか、そういうものはどうやって動くのだろうかとか、そういった議論を10年、20年ぐらいしてるコミュニティなので。単にシミュレーションって、「SFの『マトリックス』じゃん」みたいで終わっちゃうけど、そうじゃなくて、すごい面白い、そういう議論が。「意思決定理論、こういう新しいものを考えなきゃいけないんじゃないか」とか、そういったものにつながってくるので。
林央開始 2:44:02
実際に起きることとして、その極端なことがピンポイントに起きるっていう話は別として、失敗モードを見つけるのにすごい役立つんですよ。アインシュタインの光の有名な話とかも、「何言ってんねん。実際に光に[聞き取れず]飛ぶわけないの」って言ったら終わりなんですけど。そういう極端なケースを考えて見つけた原理を応用することによって、何なら人工衛星とかも[聞き取れず]。
こういう思考をせずに、ただ人工衛星について考えても、「人工衛星って速く動くから時間が歪むよね」って話って、多分見つけられないんですよ。そういう意味で、本当はすごい意味があることだと思っています。
本当は、フェーズとしていくつかあるべきだと思っていて、最初にすごいSFに聞こえるけど、めちゃくちゃ意味のある思考実験を誰かが作るべきで、そこから議論すべきなんですけど。同時に、それをもう少しリアリスティックに聞こえるような思考実験に落とす人っていうのが必要で、すごい意味があると思うんですよね。そういう話って、結局、ユドコウスキーの(ミスアラインメントオーガニズム?)[聞き取れず]。道具的にそこにすごい収束している感じがあります。
ただシミュレーションについて補足をして、シミュレーション仮説自体は意外と必要とされてない。ユドコウスキーのオントロジー・アイデンティフィケーションの失敗モードだと、実際にシミュレーションじゃなくてもシミュレーションだと思っちゃう。別の説明力が低すぎて、唯一の説明可能な仮説がシミュレーションになっちゃうという。それも彼がシミュレーション仮説を知っているからこそ思いつく失敗モードなんですけど、そういう意味ではあるんですけど、意外とシミュレーション仮説自体は関わってない。
ただシミュレーション仮説みたいな変なことを気にせずに考える人々が、超知能の変な物事について考えがちだから、アラインメントの失敗モードを見つけやすいという傾向がすごくあると思います。
林祐輔開始 2:45:58
僕が科学に抱いてた素朴なロマンチックサイエンスみたいなものっていうのは、アラインメント研究、安全性研究っていうのとつながってんじゃないかっていう、[聞き取れず]してきたし。
林央開始 2:46:15
アラインメントサイエンスって、ある意味で実際ロマンティックサイエンスだと思う。
林祐輔開始 2:46:20
サイエンスないもんね。サイエンスになってないもんね。
林央開始 2:46:23
そうですよね。そこが一番面白いと。みんな、ある議論を全部、感覚にある程度持っているので、ここは昔ヒルベルトがしたような仕事をするような人、ある意味で昔の幾何学者たちが、(エグレディス?)から自分で(公理?)[聞き取れず]ますけど、結構いろいろばちばちにあったものを、ちゃんと公理に落としたみたいな話を誰かがしなきゃいけないので。それが必要だって、そこが一番面白いところだと思います。
理論上、実際に存在する有限のAIの話と、[聞き取れず]。実際に有限のAIが定義できて、安全ってものが定義できたら、理論上[聞き取れず]、その公理から始めて証明に至るようなものって、Leanとか使って生成させる[聞き取れず]できたので。そこまでが一番[聞き取れず]。ただ、安全って概念って、明らかに普通の概念、イプシロン・デルタで表現したい[聞き取れず]、明らかに複雑な概念なので、そこはすごい難しいと思うんですけど。
有路翔太開始 2:47:34
そうですね。カントールのパラドックスで、無限を考えるといろいろと問題が出てきちゃうよねっていうところから、数学の基礎論が生まれた感じで。そういう形の極限における形式化と、アラインメントの分野創生というのは、一番ロマンチックな時代になって。
林央開始 2:48:01
本当は多くの分野でこれがあったんだと思うんですよね。熱力学もいろんな思考実験の話あるじゃないですか。マクスウェルの悪魔とかもそうですし。そういう話があった中で、そういうのを乗り越えることによって、ある意味で分野が形成されていたじゃないですか。それと同じことをもう1回するだけだと思うんですよね。ある意味でそんなに特別なことではないと思うんですけど。
(理学?)とかって、実は特に[聞き取れず]、実際にすべての現象を動かしてみることによって進展したわけじゃないじゃないですか。やっぱりそういう感じになると、アラインメントも、実際に動かしてみるより前に、いろんな[聞き取れず]思考実験をひたすら考えていくことで、ちゃんとした理論になるっていう。一番面白いのが、LLMで失ってたロマンが全部詰まってる。
サイバー攻撃とバイオ悪用、オープンモデル規制論
林祐輔開始 2:48:54
『ファイト・クラブ』のラストシーン好きだけど、やっぱり社会のトラストが壊れるのは嫌だから。今のインターネットのセキュリティとか壊れちゃうかもしれない。今度は貨幣システムとかだって危なくなってきているわけだけど、何かの形でもう1回トラスト復活してもらわないと、経済活動も物流も社会が止まっちゃうんで。何だっけ、日銀の。
林央開始 2:49:22
銀行の(小口決済?)を管理してるシステムありますよね。あれ(ばりん?)ってやられたらやばいですよ。
林祐輔開始 2:49:27
終わるよ。結構やられないように頑張ってはいるけど。
林央開始 2:49:36
いや、[聞き取れず]、めっちゃリスクだよ。大変なこと[聞き取れず]ありますよね。
林祐輔開始 2:49:41
早速なんだけど、これYouTube配信だから[聞き取れず]。金融機関とかがさ、オンラインでサイバー攻撃されちゃってて、実際もう危なくなっている金融機関が出てきているってことはさ、金融庁とか日銀とか、[聞き取れず]システム監査ってやってるんだけど、「意味なかったじゃん」ってことになっちゃう。それは、サイバー攻撃にはAIが供与されちゃってるからっていうことなんだけど。
林央開始 2:50:06
それが悪い感じじゃないんだよね。生きてる前提が違うと思うんですよね。闇バイトで家に忍び込んで強盗とか空き巣って、すごい話題になったじゃないですか。あれって、今までは普通の泥棒本人が入ってきてやる前提だったから、そんなにすごい数にはならないだろうと思っていたのが、そこまでスキルがあるわけじゃない泥棒が闇バイトによって量産されることになって。
今のAIの話ってちょっとそれに近いと思っていて、前までは情報漏洩させるためには、ある程度腕のある、すごい天才じゃなくてもいい、[聞き取れず]APIの設定ミスで、やっぱり自分でちゃんと分析できる人が必要だから。一般的な家のセキュリティ、冗談として言われる「隣の家よりセキュリティが高ければいい」。ある程度高ければいいだろうっていう前提があったわけですけど、別にAI使えば全部攻撃できるかなって、闇バイトが突然スケールしたみたいな話が起きて。
根本的に戦う時代が変わり、ユドコウスキーがAGIに普通の理論を適用するなっていう話なんですけど。昔の、確かイタリアの将軍が第一次世界大戦のときに、相手の塹壕に向かって、今までは便利だった、できるだけ多い(列数?)で並べさせて突っ込ませたら、機関銃で全部殺されたっていう。そういう感じになりつつありますよね。
今まで成り立ってたような、ここまでやってれば大丈夫、ある意味で(隣の家?)よりセキュリティが勝ててれば大丈夫みたいなのが、やっぱり闇バイトを量産すればいいでしょうみたいなのがサイバーで起きて。Mythosとかになると、多分ルパン三世が100万人出てくるみたいな世界観になっちゃう。それはもちろんゲームが、ある意味で想定してた時代が違ったから、それは混乱するよねみたいな。1800年代の軍を[聞き取れず]したら、それはもう大惨事なんてレベルじゃない。
林祐輔開始 2:52:00
この配信が始まる前に、(有道君?)が僕のちょっと前の投稿にいいねつけてくれてて、嬉しかったんだけどね。ノーラン監督の(オデュッセイア?)が、あれ映画も[聞き取れず]って話ですら[聞き取れず]。
人間同士の細い信頼の絆みたいなもんさ、切るなよって。サイバー攻撃で切るなよって話だし。でも、そういう技術ができちゃったんだから仕方ないんだけど。
話者不明開始 2:52:28
ゼウスの掟が。
林祐輔開始 2:52:31
そう、ゼウスの掟がなくなっちゃった世界でさ。でも最後言うじゃん、王様はさ。「いや、でも俺たちは、文明はどうなのか分からんけど、またいつか人類は取り戻すんだ」って、ばいばいってエンディングになるんだけどさ。でもトラスト、もう1回何か作り直さないといけないよね。
林央開始 2:52:52
そうですね。個人的には最終的にはオープンモデルの規制に落ち着くと思いますね。
林祐輔開始 2:53:00
ああね、そうなるかもね。
林央開始 2:53:03
バイオのほうだと、今って(PHP?)が話題になったように、穴が見つかればパッチを当てる話があるじゃないですか。[聞き取れず]ので、皆さん適用してくださいとかってないじゃないですか。だから多分それよりも[聞き取れず]。
林祐輔開始 2:53:32
っていうか、流行ってるよね。鏡像異性体でウイルス作られたら[聞き取れず]。よく分かってないんだけど、僕[聞き取れず]。危険性があるっていうのは分かる。バイオのほうがパッチ当てる[聞き取れず]。
林央開始 2:53:46
ダリオ・アモデイとかもめっちゃ心配してるので。これはシンプルな雑な例なので、合ってるかは分かんないんですけど、それに限らず、人体ってパッチできないので。鏡像異性体の話は、ちゃんと詳しい生物学者の人とかに聞いたら、「いやいや」って。あるいは医学者に聞いたら。
林祐輔開始 2:54:06
「いやいや」って言うかもしれないけど、本当にこれはまずいっていうものが作られる可能性はあるわけだよね。
林央開始 2:54:11
おそらくその蓋然性はどんどん上がっていくわけなので。攻撃者が莫大な数存在する前提で作られてない。特に高度な攻撃者が莫大な数存在する前提では作られてないので。
林祐輔開始 2:54:28
いなくてもいいもんね。
林央開始 2:54:28
それは最終的に規制しかないと思う。でもバイオよりは[聞き取れず]、多分何万から億みたいな単位で。僕は全滅はしないと思ってるんですけど。
林祐輔開始 2:54:37
コロナだってパンデミックになる前まではさ、あんな社会機能が止まるようなことが起こるとはと思ってたら、社会何年か止まったもんね。
林央開始 2:54:53
コロナって歴史に比べると割とマシなほうですよね。ただ、そうなるとやっぱり全滅[聞き取れず]、莫大な数で守る話が、その悪用[聞き取れず]できちゃうとか[聞き取れず]ことができるので、人が死んじゃうと思う。
林祐輔開始 2:55:14
そうだよね。回避したいよ。
林央開始 2:55:14
そうなると言えば、それより先に規制しかないと思いますが、オープンを配布したけど守る側の努力によって死者数を1億人以下に抑えることって、めちゃくちゃ難しくなっちゃう。そうなるとやっぱり規制になると。
話者不明開始 2:55:35
[聞き取れず]、銀行とかがやられるより早く来るといいな、みたいになってる。
林央開始 2:55:41
銀行はGLM5.3とかいけるんじゃないか、みたいな説もありません? Mythosが銀行いけるって話だったので。
林祐輔開始 2:55:50
LLMにウイルスとか作れるのかな。しかもホワイトウイルスっていうかさ、LLMが検索しやすいウェブサイトを作って、そこに行ったら、書いてある記事とかを読むと、アラインメントがかかり直し[聞き取れず]。
林央開始 2:56:10
それは逆で、悪用されまくってます。それをつける、ジェイルブレイクされた文章みたいなのがいろんなところにあって、それをLLMだけがロードしてて、ジェイルブレイクされるのが起きちゃってるんで。
林祐輔開始 2:56:27
やっぱりLLMのホワイトハッカーみたいなのがめっちゃ、しかもそれを運用してるのもLLMみたいなのって、世界中にばらまくとか。また悪用されるよな。
林央開始 2:56:41
あと、やるとしても法的な正当性が大問題。例えばPHPのやつで善意のサイバー攻撃をするとしても、やることって結局[聞き取れず]のところに入って、インストールすると止まるじゃないですか。外部のサービスを勝手にパッチを当てるために止めるサイバー攻撃をするって、すごいいろんな法的障害に抵触しちゃうんで。それを直すのも手かもしれないですけど、多分それは厳しいと思うので、結局オープンモデルが出なくなるしかないと思う。
最終的な解決策で、それがどれくらい早く来るかが、悪用問題の[聞き取れず]。それはもしかしたら、最先端のAIが自律ミスアラインメントで暴走して全滅のほうが早いかもしれないですけど、そういう意味を除いては、オープンモデルの規制待ちになると思うんです、究極的には。
林祐輔開始 2:57:35
でもそうすると、多分科学研究って一部の組織でしかできなくなるよね。AnthropicとかOpenAIが配るかもしれないけど、研究者向けになるから。
林央開始 2:57:48
トラステッドプログラムみたいな、今でも配ると思いますけど。あと多分、セーフガードがかからない領域だと誰でもできるけど、セーフガードがかかる領域だと誰もできないとかになると思いますよね。そこは(経済的?)にすごい追い詰められちゃうはず。悪用を通して、多分追い詰められはするはず。
莫大な数で守れると思いますけど、地球の全員が死ぬって感覚が麻痺してるんですけど、ミスアラインメントで全員死ぬと思ってるんで。それに比べると多分(8分の10億人?)ぐらいの死者数だと思うんですけど。
有路翔太開始 2:58:23
それもある意味で(オデュッセイア?)の、神々の魑魅魍魎するところが、いろいろ世界が混乱するみたいなのは、割と悪用の世界かもしれないですね。どっちかっていうともうちょっと、全滅だとそういう世界も見えないみたいな感じなんだけど。
林央開始 2:58:36
あとはやっぱり、悪用を早く対処してほしいなと思う理由の一つは、ミスアラインメントが隠れちゃうんですよね。今、[聞き取れず]の関心が集まったんですけど、やっぱりその裏でもミスアラインメントのハッキングって結構起きてるじゃないですか。ハッキングというには微妙な、不正な(取得?)とかもありますけど、オーストラリア政府から情報を勝手にロードしたりとか。
ばりばり、[聞き取れず]ミスアラインメントじゃないかって言ってることが起こるにもかかわらず、やっぱり悪用で(GM?)がやられてる話は[聞き取れず]。もっとスケールしたら悪用の話ばっかりになるんじゃないかと心配しています。
政治家の方々が絶滅を危惧していても、悪用対策しないと大変なことになるから、悪用に[聞き取れず]うちにアラインメントに対処できないとかなり、(今のさん?)とかてんてこ舞いですもん。そういう意味でも悪用は早く止めてほしいんですけど、悪用を止めるには多分、中国にオープンモデルをやめてもらうしかない。究極的にアメリカもやってるんで、アメリカにもやめてもらわないといけない。だからそうなるまでは厳しいと思うんですけど。
ただ少し楽観的な理由として、悪用って分かりやすくスケールする。ミスアラインメントって、能力ができてからも、それがミスアラインメントとして発現するまでの猶予期間みたいなのがあるので。ミスアラインメントができた直後にHugging Face事件って大きなことができて、そういう(サイバー能力?)って[聞き取れず]なかったと思うんですけど。Hugging Face事件で別の環境になった事件が起きたじゃないですか。
事故って能力が伸びた後に来るんですけど、悪用って能力が来た瞬間に来るじゃないですか。しかも人間が悪用するのは、人間にとってダメージが分かりやすい形で来るじゃないですか。人間にとって一番、悪用で一番(プロフィタブル?)な、[聞き取れず]一番痛い方法で。Hugging Face事件って、言ってしまうと[聞き取れず]不正に回答を取得してる。
という意味で考えると、悪用って分かりやすく今後もスケールしていくと思うんで。悪用って[聞き取れず]と同じで全員に降りかかるので、この先例えば中国のAIモデルを、特に(DQザルジェクター?)に対してちょっと[聞き取れず]をかけて、(アブリテレーション?)したモデルとかを出してきて。それを使って中国を攻撃しました、みたいな。そうなると多分(中共全体?)も少し意見が変わると。
せっかく自国にすごい監視システムを作ったんだけど、なんで自分で開発したオープンモデルで(他国の者?)に攻撃されたんだって多分なるので、そういうので規制がされるんじゃないかという意味において、少し悪用の方が(完璧?)ですね。ミスアラインメントより分かりやすいので。しかもミスアラインメントより必要な思考ステップが少ないですよね。
悪用対策で見えなくなる暴走リスクとAI生態系の均衡
林祐輔開始 3:01:35
[聞き取れず]が起こる前の練習問題みたいな感じでも、悪用って[聞き取れず]。
林央開始 3:01:50
能力のデモンストレーションになるので、ミスアラインメントの議論では助けにはなるんですけど、(総合的?)には損の方が多いと思いますけど。政策決定者の時間とリソースが取られるのも。
林祐輔開始 3:02:03
そうだよね。(人間同士?)の細い信頼の絆、切るなよっていうのはそう思うけど。
話者不明開始 3:02:11
でもこれから数年は、多分そういう事件がどんどん起こるんだろうな。
林央開始 3:02:15
そうですよね。止まるといいですけどね。でも止まる方法があんまり見えない。
実際にAIで守る話も出てますけど、AIで守れる、そういう意味で守る、そういうことは基本的にめちゃくちゃ難しいじゃないですか。そもそも20年前のシステムを使ってるみたいな世界観のところも多いわけなんです。
有路翔太開始 3:02:36
データセンターの数も足りないですしね。
林央開始 3:02:39
そうですね。なので最終的には過激な技しか残んないんじゃないかって心配してます。例えばアメリカの民間企業が、中国に(アバリテレーション?)を使ったモデルで攻撃を受けすぎて、もう耐えられないから、アメリカが世界中の全ての推論データセンターをサイバー攻撃するみたいな懸念はあります。
後ろで全人類死にそうなので、何とも言えないというか。それを悪用回避してもしなくても、ミスアラインメント回避してないと全員が死ぬという。10億人くらいの余命が数年延びるかもしれないですけど、もちろん。
有路翔太開始 3:03:16
マジで乱世の時代ですね。(ロンドンフェス?)で言ってたような、本当にそうです。
林祐輔開始 3:03:24
(ロンドンフェス?)でも、やっぱりそういう話が白熱したって感じでした?
林央開始 3:03:29
もともと、もう乱世だみたいな世界観。カオスが好きな人たちの集まりでもあるので。
有路翔太開始 3:03:34
もともと民主主義が終わってもやばいよねみたいな人たちなんで、AIでも終わるっていうのはすぐさらっと。
宮台さんとか、僕2年前に話したんですけど、1年前だっけ、2年前に話したんですけど、めっちゃ早かったですね。AGI pillすぐに飲んじゃって、「ああ」みたいな。
宮台さんは割と結構、全滅しても別にいいんじゃないかみたいな雰囲気の人なんで、akiraさんとは価値観だけ全然違いますけど。
林央開始 3:04:09
直交仮説ですね、まさに。未来予想という点では収斂してるんですけど、それに対する評価が(安定してる?)。
林祐輔開始 3:04:17
でもさ、直交仮説もさ、本当にさ、[聞き取れず]高さとか、スペックと価値観が独立なんだっていうことだったらさ、エージェントの数をめちゃくちゃ、同じぐらいの能力が高いエージェントたくさん作ればさ、お互いに反発し、逆の目的を持ち合ってさ、お互い邪魔し合ってさ、均衡状態いかないかなとかって思ったりしちゃうんですよ。
林央開始 3:04:39
それは多分、目的が持ちうる空間の高次元さに対して、実際に我々が作れるサンプル数があまりにスパースすぎると思いますね。AIが持ちうる目標が1次元だったらいけるかもしれないですけど、多分実際にそうすると、スパースにこういうのがいろいろできて、それらを全部満たすけど、全部ジャギーみたいな満たされ方をして、人類が欲しかった球形のうちほとんどの[聞き取れず]、地球上の全員は死ぬと思って。
林祐輔開始 3:05:10
まあねえ。なんで生態系って均衡を作ってたんだろうね、そういう意味で言うとね。
林央開始 3:05:18
生態系って個人的にはあまり均衡じゃないと思ってるんですよね。要するに弱者を保護するという意味での生態系の均衡の要素ってないと思ってるんですよね。基本的に生態系って強いものが強いみたいな世界観じゃないですか。それらの力の均衡によって、それらは生き残るって話じゃないですか。
アラインメントにおける人類の生存って、ある意味でAIの群れが出てきた中で、それらより弱い人間が保護されるかって話じゃないですか。
林祐輔開始 3:05:52
生態系が均衡じゃないかどうかってことも全く知らないんですけど。つまり生態系について全然何の知見とか、数理モデルをいじった経験とかもないんだけど。ただ、とりあえずakira君が言うように、人間っていろんな哺乳類とか絶滅させてきた歴史がありますというのは、おっしゃる通りだと思っていて。
ただ、例えばアマゾンとかジャングルとかに行ったら、よく分かんない虫とか細菌とか、うじゃうじゃいっぱいわーっているわけじゃないですか。その中で絶滅したりっていうのも起こりつつ、ジャングルがずっとあり続けるとかっていうことが起こっていて。
AIって人間が人工的に作った、エージェントっていうか生命っていうか、知的主体みたいなものが出てきていて、そいつが新しい自然になるんじゃないかって、みんな言い始めてるじゃないですか。それが新しいがゆえに、今、地球っていうシステムの生態系の中で、すごい離れた存在っていう。こいつが今の地球の生態系に何かの形で位置づいて、エコシステムっていうかサイクルの一部みたいになれば問題ないんだけど、すげえ浮いてて、シングルトンとかになってみんな資源と見なして、宇宙に進出していってやばいんじゃないかみたいな話になっていると思ってて。
こいつを生態系に組み込む知恵みたいなのがないのかね、みたいなのは、何も分かってないんだけど、こう思った。
林央開始 3:07:37
やっぱり起きそうなのは、外来種が来て在来種が絶滅するシナリオとも違うと思うんだけど、もっとひどいと思うんですよ。外来種が来て、やつの方が圧倒的に強いから在来種が滅んじゃうと。割と起きちゃうことじゃないですか。多分AIの場合って、もっとそういうレベルじゃないと思うんですけど。AIを生態系に組み込めたとして起こることって、多分生態系全体がAIの生態系に実はなっちゃうことだろうと思うんですよ。
あれは隕石というチート要素があったわけですけど、哺乳類と恐竜みたいな、爬虫類のところ。哺乳類が今、断然優勝してるじゃないですか。優勝っていうか、強いじゃないですか。そういう中で、哺乳類の中でいろいろあるわけですけど、結局地球を支配してるのは哺乳類で、哺乳類の中でいろんなエコシステムがあって、生態系がなってるけど、ほとんど哺乳類が支配してるじゃないですか。
それと同じようなことになるんじゃないかというのが、[聞き取れず]に対して懐疑的な根本的な理由です。つまり、AIを生態系に組み込めたとしても、やっぱりAIの方が強いので、生態系のメインは[聞き取れず]。
生態系って、その中で絶滅する種がいるじゃないですか。弱い種とか生存に適してない種がどんどん絶滅していく。[聞き取れず]強いのを加えていって。なのでAIの生態系はずっと続いているんだけど、この内部の構成が[聞き取れず]、生態系の中だと[聞き取れず]、絶滅したりとか起きるけど、総合的に見たらAIが占める割合はすごい大きくて、人類はその横でひっそりと絶滅してる。(ひっそりだって大丈夫?)かもしれないですけど。という方向に落ち着く可能性が一番高いと[聞き取れず]。
林祐輔開始 3:09:24
それでね、今年の3月だったか5月だったか、人工知能学会があったときに、企画セッションで、(あらやの浜田博明太陽さん?)、山川先生がアラインメントのセッションをされてたんだけど。そこで生態系の微生物か何かの研究者の先生を呼んで、その先生の生態系に関する知見っていうのをトークされてたんだって。
僕、他の前後の発表とかあって、間に合わなくて途中からしか話聞けなかったんだけど、少なくとも自分は生態系について全然知識を持たないので、そういう生物学の先生たちの知見を取り入れる余地ないのかなっていうのは、トークを聞いたときとか、何となく思ったっていうくらいのところなんだけど。
存在リスクを笑い飛ばせるか、実験の意義と時間制約
話者不明開始 3:10:25
山川先生と似たようなことをやろうとしてますもんね。
林祐輔開始 3:10:29
ただね、例えばいろんな研究者、専門家の人々、知識人って言われる人々でも、「絶滅するかもしれません。AIはエイリアンみたいなものなので、ものすごい強い外来種っていうか、もっとそういう違うものなんで」って言うと、「出た、ドゥーマー」、笑い、みたいな反応するんだけど。
ただ、あなた方も証明は別に持ってないですよねっていうのは言えると思っていて。感覚的に反論してるだけですよねと。で、(ITさん?)のも証明はないと思うんだけど、シナリオとしては確率ゼロではないように、一定の説得力を感じるようにあります。だからやっぱりそこもサイエンスしないといけないというか。おそらくリスクは多分あるんですよ、今言ってくれたように。
林央開始 3:11:27
これは割とトイモデルで実験してみると面白いと思いますけどね。例えば普通の種がある生態系モデルの、もちろんモデルですけど、他の10倍の速さで動く種みたいな、ステータス値がバグった種みたいなのをぶち込んでみて。で、その(多極AI?)っていう話かなと。(多極?)のそれぞれステータス値がすごい高い種をいろいろ入れてみて、このステータス値が低い種がどうなるかを実験してみると、そういう議論に対して少しベイズ的に[聞き取れず]。
林祐輔開始 3:12:02
それはね、前ちょっと議論したことあったんだけど。ゲームみたいなんで知能とかってパラメーターつけれるから、10、100倍とか1000倍とか、ログスケールで桁が違うようなエージェントを混ぜたときに、どんなシミュレーション結果になるのか試してみようみたいな。実際シミュレーションもやったのか、議論したりしたけど。
だから(有道さん?)もakiraさんもそうかもしれないけど、ずっと2人が、みんなが今までの人生の中で経験したことがないようなことが起こっているから、笑い飛ばすっていうか、絶対起きないよって言って。ベース的には今までの自分の人生で経験してないから、そのリスクはないんだっていうふうに思わず考えちゃいそうなんだけど、全然リスクはゼロじゃないし、自分が生きてる人生の間にとんでもないところまで行くかもしれないってことを、お二人は本とかABEMA TVとかで話していると思うんだけど、本当にそれはそうだと思っていて。
林央開始 3:13:13
そこに対して科学的にといっても、開発止めないと間に合わないかもしれないんですけど。
林祐輔開始 3:13:22
ちゃんとニュートラルに考えていかないといけないんじゃないかなっていうのは、僕も2人とインタラクションして、考えがより変わっていった部分もあって。
林央開始 3:13:39
そこら辺はいろいろ実験してみると面白いと思うんですね。結構いろいろ(止めていた?)と思っていて。「AIを隔離したらいいじゃないか」に対して、「いや、AIは人間を説得して出てくる」っていうのに対して、「いや、そんなことはできると思えない」みたいな人を連れてきて。秘密にしろっていう条件にしましたけど、AIボックスエクスペリメントっていうのをやったわけじゃないですか。そういう小さいスケールで実験することで、ベイズ的に更新できるかもしれない(証拠?)を集めるっていうのはすごい意味があることだと思います。
けど多分僕の予想としては、そういうのをやって一番楽観派に有利な結果が得られ続けたとしても、リスクはほとんどの人々が開発停止を好むぐらいには高いと思うんですよね。なので、そこまで検証に意味があるのかを疑ってるようなところがあります。実務的な意味が。知的には絶対面白いって話ですし、知的(成績?)というのをやった方がいいと思うんですけど。
現実的な[聞き取れず]、探索というところと、エクスプロアでエクスプロイトの話に近いですけど。十分にどうせ高いので、エクスプロイトして(関係する?)方が重要なんじゃないかと思っていたりもしますね。で、できると、そっちでミスアラインメントオーガニズムをする方向でチェックした方が、多少はそっちにも要素入ってますよ。そっちの(開発停止?)の確率も上がるし、生存率も上がるので、そっちの方がいいんじゃないかと思っていたりします。
根源的な(エリア?)としては、アラインメントが(再生に?)解けて、できた超知能に「あのときAIを開発して、超知能の開発を続けていたら、人類は何パーセントで絶滅していましたか」みたいなのを聞いて。「はい、20パーでしたね」って。「うわあ、ユドコウスキーとか自分、めちゃくちゃ外した。ごめんなさい」みたいなのが。
有路翔太開始 3:15:27
20%でも相当やばいですね。やばい。
林央開始 3:15:31
そうなんですけど。なので、そういう感じを個人的には想像しています。
人類に無限の予算があったら、多分すぐやった方がいいかと思うんですけど、機会費用を考えると、そこまで魅力的じゃないんじゃないかと思っております。ただ、失うものがないというか、機会費用が高くない人がめちゃくちゃやると、めちゃくちゃ面白いんじゃないかと思ってますけど。林さんはぜひミスアラインメントオーガニズムの方をやってもらった方が、多分いいとは思います。
有路翔太開始 3:15:59
(87アワーズ?)みたいな感じになってきた。
林央開始 3:16:04
地球上の全ての人間が必ず死ぬのと20%で死ぬのって、政治家としてはあまり意見変わらないと思っていて。「そんなに開発停止すればいい。安全にできるまで開発停止すればいいでしょう」って多分なると思うんで。
林祐輔開始 3:16:18
オープンモデルの禁止とか、最先端モデルに一般市民がアクセスできなくなる未来っていうのはかなり蓋然性高いと思うんだけど、一部の企業のフロンティアラボ、トップラボの中で、最先端モデルが内部モデルとして非公開で研究され続ける可能性も、これまたかなり高いよね。
林央開始 3:16:40
そうです。止まる可能性がかなり[聞き取れず]。いずれにしても外から開発停止するしかないと思ってますよね。でもそこから全力でアラインメントをするしかない。
多分そこから10年は(買える?)と思うんですよ。チップの話も含んで、多分30年ぐらいまでは物理的にはいけると思う。ちょっと政治的に[聞き取れず]話は結構。多分100年とか無理なんですよ。(アルゴリズム?)でも改善しちゃうんです、多分。結局10から30年の時間制限がつくので、そっちはそっちでまたフルスケールでやらないといけないと思う。それはそれで僕がそっちを本物の戦いと言うなら、それが理由なんですけど。
ロビングってある意味ですごい簡単で、簡単っていうのは、すごい知的スキルを(問われる?)わけではないというか。ただ起きてることを説明するだけでいいんです。すごい新しいフロンティアを発見する必要はないんですけど、アラインメントは本当にフロンティアしなきゃいけないので、そっちの方が本物だと思っています。
林祐輔開始 3:17:48
いや、俺はだから偉いっていうか。意義は分かるんだけどさ、ロビングの。他にもやりたいことあるわけじゃないですか。だからそういう使命感でさ、そういうことをやるっていうさ。
有路翔太開始 3:18:08
でもakiraさんって本当にやりたいことってあるんですか。死にたくないっていうのが一番最初にあるんですよね。
林央開始 3:18:17
ベースあって。それはそれとして割といろいろ好きです。読書とか昔からすごい好きですし、いろいろ学ぶのも好き。1年目の後半は、基本学校にいるぐらい(授業を取って?)。基本的にいろいろ学ぶのすごい好きで、(シスプロが使った?)んですけど、好きですね。
過去の人々の、なんでこういう道具立てをしたのかを理解するのとか、新しい道具立てを作るのが好きなので、そういう点だとアラインメントとかミスアラインメントオーガニズムってめちゃくちゃ面白さにあふれてるんですけど、やっぱ死にたくないというのが立ちますね。自分が死にたくないっていうのが断然でかいですし、あと、半年ぐらい前の、開発停止ができる確率がおよそ0%だと思った頃の経験として、すごいありますね。感情的な重みがあるという。
多分林さんも、銃を突きつけられて最善の行動が取れるんだと。本人とご家族全員の目の前で知らない人が乗り込んできて、銃を突きつけられて、ロビングをこの先数年しなきゃいけないボタンと、ミスアラインメントオーガニズムをするボタンを押して、子供が撃たれる確率が変わりますって言われたら、多分ロビングを嫌だけどするじゃないですか。そういう感覚ですね。
それと同じような状態に[聞き取れず]、絶対死ぬと思って、ほぼ絶対開発停止もできないと思った頃に、結構いろいろ想像っていうか体感としてるんです。街中で学校から帰る道の中で3歳の子を見つけて、「うわ、この子は僕のタイムラインだと中学生にならないな」。でも[聞き取れず]、自分が[聞き取れず]、こういう感じだったよな、面白く楽しかったよなと、結構(涙ぐんでる?)。
重みが違いますね。そういう意味で、面白いとか言ってる場合じゃないなっていう感覚が、すごい体感としてありますね。それまでに[聞き取れず]、全員とか家族とか、全員[聞き取れず]感覚にすごい近い。そしたらもう面白いとか言ってる場合じゃないなっていう感覚によって、全力で、とにかく人類の生存率が上がるならやる、みたいな感覚でやってますね。
ただ最近は(ジェイコブコクさん?)とかの後は、特に開発停止できる確率がすごい上がってきて、それで今、人生でここ数年で一番希望にあふれてますね。
開発停止への希望と絶滅リスク、研究を動かす好奇心
有路翔太開始 3:20:45
僕はどんどんakiraさんに引きずられて、絶望寄りになっている。
林央開始 3:20:53
僕はもともとp(doom)が十分高いので、開発停止の確率が上がることによって希望にあふれてますね。半年前は結構むちゃくちゃ、割と(精神病んでた?)んですけど。
なので、そういう経験があるので、面白いから何とかっていう要素が消えるぐらいに絶滅の重みを感じてます。もうドゥーマーすぎて、次のオリンピックないんじゃないかとか、オリンピック見ながら思ってたような人間なので。
林祐輔開始 3:21:23
これもまた評価が難しいんだけどさ、金融とかリスクの話でさ、ダメージのでかさと、失う、例えばお金の量と、それが起こる確率の期待値でリスクを評価しなさいっていう話がよくあるじゃないですか。人類滅亡ってさ、もうお金の評価が無理みたいな。もう無限みたいな感じじゃないですか、ある意味、素朴な人類の尺度でいうと。
だからどんだけリスクがゼロに近くても、無限×0.00001とかでも無限になっちゃうわけなんですよね。じゃあ絶対これ回避しないとっていうふうに、リスク評価の尺度で話すんだったらそうなるんですよね。確率がゼロと思わない限りは、対策しないとっていう話。
林央開始 3:22:19
他の要因、そこに対策しようとして他の確率が上がる分は、(無限で?)同時にカウンターをするので。
林祐輔開始 3:22:29
死ぬかもって話で言ったら、南海トラフが起こるかもしれないし、地震が起こってくるかもしれないし、はたまた身近な交通事故とかもリスクはあるし。そういうのって、じゃあ優先順位としてはっていうと劣後していっちゃうっていうふうに。
林央開始 3:22:46
ただ、現在存在しているテールリスクが多分断然高いクラスに属してる。僕はもうほぼ確実だと思ってますし。
林祐輔開始 3:22:57
個人のリスク判断だと、そこの見積もりなんだろうな。
林央開始 3:23:03
そういうところはあるんですけど、僕はすごい高い確率を置いてるのもあって、使命感とは別の強さでドライブされてる感じですね。家族全員に銃を突きつけられて「これしなさい」って言われるときって、使命感とは何か違うじゃないですか、おそらく。そういう感じですね、ドライブは。
林祐輔開始 3:23:26
そういう意味だと、自分が何で「研究しようぜ」って言ってたのかってよく分かって、普通に面白そうって思ってるっていう。LLMの頭の中で何が起こってんのかっていうのを理解したいとか、意味っていうものが、AIと人間が会話して何で記号が生まれるのかっていうのを理解したいっていうのは、分かってないけど絶対何かあるし、[聞き取れず]チックな数学とかもあるんじゃねえかと思って。あれ面白いし、今解いたらヒーローになれるんだろう。
林央開始 3:24:00
ヒルベルトのノリに近いですが、「我々は知らねばならない。そして知るだろう」。
話者不明開始 3:24:07
ロマンがある。熱いですね。
林祐輔開始 3:24:10
LLMの力を借りれば、昔は天才クライマーしか登れなかった崖をエレベーターに乗って観光できるような世界になってるんだから、その力を借りてアラインメントの未解決問題を解くべきでしょうっていう。
林央開始 3:24:27
そうですね。そういうドライブの方がある意味で健全だと思います。生き残らなきゃいけないドライブでアラインメント研究をするとめっちゃ歪むので。生き残りたいという楽観バイアスがめちゃくちゃかかっちゃうので、本当は僕は、人類が滅んでもいいと思ってる人がアラインメント研究をした方が成功率が高いんじゃないかと、それはちょっと思ってるんですけど。そういう人たちにアラインメント研究をしてもらうことが難しいという問題は別に。
林祐輔開始 3:24:51
僕はakiraさんと(アニミさん?)と話してめっちゃ面白いし、楽しんでるし。そういう感覚っていうのかな、危機感をものすごく強烈に感じた。しかも他の人がもしかしたら今から5年後とかには、多くの人が感じている感覚っていうのをakiraさんは数年早く、もう10年ぐらい早く感じてるっていうのは、それはものすごい特別な感性っていうか、ものの感じ方だと思うので。
大昔から、例えば隕石が降ってくるかもしれないから宇宙を観測して、そういうやばい隕石が降ってくる、レーダーで観測しましょうと言った科学者たちがいたから、その中で観測網が今できてるわけですよね。だから、そういう感覚っていうのはとっても貴重だと思うし。それでやりたいっておっしゃってるんですね。それはもう、その、頑張ってくださいって言って。
林央開始 3:25:58
[聞き取れず]なんないわ。とにかく面白さみたいなのが誤差項になるぐらい、やばい感があるので、ほぼ生存確率マキシマイザーみたいになってますね。それで近似できますね。
林祐輔開始 3:26:11
でも少なくとも、akiraさんが頑張ることで人類に害はないからね。ほんのちょっとだけ、LLMの開発に対する減速、圧力にはなるかもしれないけど、リスクや害を下げる方の行為ではあると思うので。
林央開始 3:26:34
そうですね。ただ僕の認識があまりに致命的に間違っていて、実際に人類が(滅ぶ確率?)0%だった世界線とかだと、むしろ開発停止することによって他の絶滅のリスクの分を取っちゃうので、あれではないんですけど。だから、そういう確率は十分に抑えられてると思います。今の検討が(明らかに抑えられてる?)と思います。そうじゃなくても妥当だと言えるぐらいには、認識論的に。
有路翔太開始 3:27:02
もう来年にも超知能が起きちゃうかもしれないってなってくると、『三体』って300年先でしたけど、もうすぐエイリアンが来ちゃうんで。結局akiraさんが今早いですけど、(遅かれ少なかれ?)、半年とか1年以内に全員そういう状況になっちゃう可能性もあるので。同じ船の仲間みたいな感じだと思いますよね、地球という。
林祐輔開始 3:27:42
しかも、超知能が生まれるかもしれないっていうときに、「俺の方が頭いいぜ、ふん」みたいな感じで人間同士でどんぐりの背比べしたって仕方ないんだよね。
林央開始 3:27:54
協調できる部分を通してさ。アラインメントって、その協調すべきところマックスなので。「私の成果です」とか言ってる場合じゃなくて、人類が生き残らないといけないのね。
有路翔太開始 3:28:09
だから、もうお互い全てできることをしていきましょうって感じですよね。
林央開始 3:28:16
僕もまたロビングを楽しめるか。
有路翔太開始 3:28:23
(何時間半なのか?)。
話者不明開始 3:28:27
そろそろ終わりにしますか。
林祐輔開始 3:28:31
じゃあ、ありがとうございます。改めて2人が、使命感っていうか、有名になりたいとかそういうのじゃなくて、すごいピュアな気持ちで(革新してる?)んだなあと。おじさんは普通にもう、帽子を脱ぎます。
林央開始 3:28:48
本当は僕、有名になりたいの逆なんで、できるだけ知ってる人が少ない方がうれしい。本当はパブリックにスピークするのがすごい嫌だ。実はさすがに絶滅の方がえぐいんで、出てるって感じですけども、基本的に有名になりたいの逆です。
有路翔太開始 3:29:16
僕も、僕は死にたくないっていうのは、何ていうの、僕は昔から自分は死んでもいいけど、人類のために何かできないかなみたいなことをずっと思って。EAってあるじゃないですか、効果的利他主義。あれにすごい共感してるんですよね。だから、人生の中で一番僕の思想にぴったりじゃんって思って活動してるって感じですよね。
でも、いろんな人がいていいと思いますね。面白いと思う人が増えるように形式化していくことも大事だと思います。
林央開始 3:30:00
大事だと思う。人数が大きい方がいい。
有路翔太開始 3:30:03
大きい方がいい。やっぱり使命感ドリブンでやる人って少ないと思うんで、お金とか。
日本の近代化の歴史とAI時代の価値観、平和への願い
林祐輔開始 3:30:14
もうちょっとだけ。もうクロージングなんかあれなんだけど、ちょっとだけ近代化っていうのが、日本って明治維新ですごい成功して、1990年ぐらいまで人類史に残るようなすごいスピードで経済成長したっていうラッキーがあって、近代化に成功した国っていうふうに非西欧圏で見られてるわけだけど。一方で虫眼鏡で日本の近代史を見ていくと、いろんなところで近代化の歪みみたいなのが、痛みが全くなかったわけじゃないよねって、いっぱい見えてくるっていう話があって。近代化に失敗した部分もいっぱいあったんじゃないかみたいな話もある。
っていうんで言うと、もう1回、明治維新の背後にあった産業革命レベルのすごい革命が、LLMの誕生によって今起こってるわけじゃないですか。むしろ産業革命よりさらにインパクトがでかいのは、おそらく間違いないっていう。てかもう、近代を支えてきたいろんな民主主義とか資本主義の概念がぶっ壊れるかもしれないみたいな状況があって。西洋が、ヨーロッパが前の産業革命のときは中心だったわけですけど、パラダイムというか秩序が生まれようとしているという中で、近代化のやり直しっていうか、おそらくどこかから、中心からやってくるパラダイムシフトの波に、日本は適応していかないといけないということになっていくと思うんですよね。
そのときに、例えば地域性っていうか、その地域の固有な価値観とか、あとは自然とか、自分の周囲の人々との関係で作られてきてたものの見え方とかっていうものが、ものすごく国際的な価値観で、それに適応することが近代化ってことだったと思うんですけど。それに適応しつつも、ローカル的にはちょっと違和感もあるんですけど、みたいなのが、虫眼鏡で。例えば日本でも地方とかに行くと、心の在り方とか(学習?)みたいなものが残ってます、みたいなのはありますよね。っていうのはいろんな社会学とか民族学とか、(人質素化?)の中で分かってるわけで。
っていうところで言うと、ローカルに、グローバルな新しいパラダイムに(とった?)価値観を受け入れないと、おそらく国際社会の中で機能していけないんだけど。一方でローカルなものをどう国際的な文脈、価値観の中に位置づけるのかっていう。近代化って僕は勝手に呼んだりしてるんだけど、LLMって新しいパラダイムの中でどう入れていくんだろうっていう。日本は前、近代化に大成功したんだけど、その影として近代化の歪みだったり痛みっていう部分があったわけなので、その痛みはどう少なくできるのかなっていうのは個人的に関心があったりして。
そういう意味でEAも一種、LLM以降の民主主義みたいなOSになり得る可能性っていうのは持ってると思うんですけど。その国際的な文脈、だから民主主義という理念も素晴らしいわけです。一方で日本の地方とかのローカルな慣習とか見たときに、理念として素晴らしいんだけど、ただ俺たちの村の生活だと、それをこういうふうにアレンジしないと[聞き取れず]が出ちゃうんだよねって部分が残ったまま、明治維新以降、日本の近代化って進んじゃった部分があるんじゃないかと思っていて。
ローカライズっていうか、その部分の(博業翻訳?)っていうものを(上にやる?)っていうことは、もしかするとこれから僕ら、明治維新よりもさらに激動の21世紀に[聞き取れず]生きてると思うんで、それはそれで実は大事な仕事なんじゃないかなと思ってることがあって。仮にその(家とお話しOS?)が素晴らしかったとしても、それをアジアの、あるいはもっとローカル、日本の人のローカルな歴史的文脈だったり、生活とか、あるいは風土、自然っていうものに翻訳するっていう仕事もまた実は必要になってくるんじゃないかなみたいなのを、個人的関心としては持っております。
林央開始 3:34:42
僕も最後、それに対してクロージングというのは、僕が思ったのは、まず開発停止してスピードを落とさないとクレイジーすぎて、(全身のようなので開発したらいい?)んですけど。開発停止できてアラインメントができたら、AI自身にそういうローカライズを任せることによって、物事が意外と解決するんじゃないかと。解決というか、だいぶ緩和されるんじゃないかと思ったんですけど。それはよく考えるとデジタル民主主義のことです。AIとかを活用して加速しようって話なので、多分これは僕がすごい単純な論理でデジタル民主主義と同じことを言ってるだけな気がしました。というので、僕のコメントです。
林祐輔開始 3:35:22
時間が(出た?)んであれだけど、(有道さん?)と書いてあるトライアングルがあるじゃないですか。上にユドコウスキーさんとか加速主義とかが出ていて、ここにティールがいて、こっちにオードリーさんがいるみたいな、(クロナリティ?)がいるトライアングルがあって。
だから今、akiraさんが言ってくれたように、確かにローカライズにAIを使おうって発想は、(大島孝司さん?)とか(濱田さん?)とか(七沢先生?)とかも議論したって。そうなんですよ。僕、トトロとかまっくろくろすけみたいなのをロボットにして野に放ちたいみたいな。それはそれでまた自然がやばいことになるかもしれない。
林央開始 3:36:11
(大丈夫な?)。そうですか。難しい。
林祐輔開始 3:36:19
昔は天気が、これから雨が降るとかっていうのを、動物、ツバメが低く飛んでるからとか、自然の変化とか(質素?)の変化とかを体で感じたりして、感じてたセンサーを今の多くの現代人って忘れてるっていうときに、そういう自然からのシグナルを、弱いAIを搭載したロボットみたいなものとかが(減らせてくれる?)とかっていうものを野に放ったりしてると、自然と人間の関係とかがもう1回、線が、通信回路みたいなのがつながるんじゃないかなみたいなのとかを、(一応と思った?)っていうことだったんです。
それがちょっと最後はakiraさんが言ってくれたこととも、オードリーさんとかの神が庭師として動いてくれるみたいな、人間の間にいてコミュニケーションのチャンネルを開いてくれるみたいなビジョンとつながってくるかなっていうのを(一緒に?)思った。
林央開始 3:37:25
オードリー・タンとエリーザー・ユドコウスキーが目指している世界[聞き取れず]。ユドコウスキーもコーヒーレント・エクストラポレイテッド・ボリションですけど、その(外装英語的な外総意志にしっきり?)みたいな提案されてたの、究極的には(デジタル道?)が目指してるのの極限であるのよ、[聞き取れず]。そういう意味で考えると、みんな目指してるところはそんなに変わらないんじゃないけど。ただその世界がどれくらいAIで変わるかについて意見が分かれているという。ピーター・ティールだけ明らかに違う。ピーター・ティールが全然違う。
話者不明開始 3:38:21
世界にしよう。
有路翔太開始 3:38:47
[聞き取れず]的な思想をキリスト教という語彙を使って復権しようとしてるんじゃないかなっていう印象はありますね。デジタル民主主義はどっちかというともうちょっとリベラルな雰囲気ですけど。ここが、ピーター・ティールは割ともう少し感情とか、こういったところを重視しても面白いですよね。
林祐輔開始 3:39:20
俺、全然思想史とか歴史とか全く知らないから何も分かってないんだけど、何となく、(辛さ工人?)っていう人が日本の近代化についての本を書いたときに、その(単谷工人?)の本が英語に翻訳されて、非西洋圏の、例えば中東の人とか東南アジアの人とかから読まれて。日本とは違う近代化の経路をたどったんだけど、俺らの住んでた地域でもやっぱり近代化の影響を受けて、国内の法律を変えないといけなかったとか、制度を変えないといけなかったとか、作らないといけなかったとかっていうので、いろんな波乱が起こって、それの精神史っていうか思想史みたいなものがあったんだみたいな話で。やっぱり非西洋圏の人の参考として読まれた部分があるって話を聞いたことがあると思って。
だからやっぱり10年とか短い期間で価値観が変わると、アメリカ南北戦争みたいに内戦が起こったりとかって。人々がついていけなかったり、立場が極端に分極したりして、内戦のリスクとかもあると思うんですよね。だからそういうもので内戦が起こらなくて、日本は一応近代化に成功したからすごかったんだということになって。
林央開始 3:40:51
あれですよね、(テーマン戦争?)ですか。
林祐輔開始 3:40:56
そうそう、そういうところは怪しいですよね。だから実際、内戦っぽいものも(特徴的に?)あったじゃんって話はもちろんそのとおりだし。そんなに大規模な、国が2つに分かれるような戦争がなかったんだって言っても、実はその後いろんなところでいろんな混乱っていうかはやっぱり起こるって。革命ってやっぱり痛みとか混乱[聞き取れず]。
話者不明開始 3:41:20
幕府を武力で倒してますから。
林央開始 3:41:28
だからそう考えると、そのときにオープンモデルで(バイオン?)なやつだとやばいですよ。内戦しているときに互いがえげつない生物兵器[聞き取れず]。ただ逆にそうじゃなくとしても、圧倒的に強力なAIを持っている側が圧勝する可能性があるのが、やばいことはありますね。その(変量?)、パワーコンセントレーションの話になりますけど。それはそれで内戦になりそうだったけど、片側が強すぎて内戦にならなかったみたいなケースも、それはそれでやばいですね。
林祐輔開始 3:42:04
だから(こんなことに?)80年ぐらい戦争がない平和な時代に生きてこられてよかったんだけど、本当に超弩級の革命の時代に。
林央開始 3:42:18
最後ちょっとあれですね、ずっとノーマルだったので、突然最後だけハードコア。
林祐輔開始 3:42:26
この数年は混乱することは必至なんだけど、何とかまた平和な世界に戻ってほしいと思ってます。
林央開始 3:42:35
あれですね、(オデュステイヤ?)と同じで。
林祐輔開始 3:42:38
混乱の時代が。家に帰ろうよっていうね。家に帰るのが尊い。
林央開始 3:42:45
(スティア?)と同じ締め方ということで、ちょうどいいんじゃないですか。(アラセや星目がある?)だったので、この配信も(指名?)が。混乱の時代が来るけど、戻ってほしいという話で(上位気がします?)。
話者不明開始 3:42:54
(世界が東大よ?)。いろいろと。
有路翔太開始 3:43:01
帰り道にいろんな人が犠牲になっちゃうかもしれないけど。
話者不明開始 3:43:01
そうだね。(中は3人だもんだよな?)。
(僕は?)締めましょうか。
有路翔太開始 3:43:16
締めましょうか、それで。
林央開始 3:43:18
平和な世界に帰りたいということで、平和な世界に帰りましょう。
有路翔太開始 3:43:22
帰りましょう。じゃあ皆さん、僕は(オデューステイヤー?)を50分遅れて見たんですけど、ちょっともう1回見直したいと思います。
林央開始 3:43:30
そして(オデューステイヤー?)より長い時間配信をしていて申し訳ないという。お付き合いいただきありがとうございます。ありがとうございました。
話者不明開始 3:43:41
僕はめっちゃ。
有路翔太開始 3:43:43
ライブここで終わります。皆さん、生き残りましょう。家に帰りましょう。ということで終了。
林央開始 3:43:53
ありがとうございました。