
プランAにおける計算資源
Romeo Dean
この補足資料では、計算資源に関する数値の推計と予測を説明する。大きく二部に分かれ、第1部は2029年以前、第2部は2029年以降を扱う(第2部はプランAを前提とした予測になる)。2029年以前の部分の主な目的は、世界の計算資源の総量を年ごとに予測し、それを意味のある区分に分けることだ。区分には、AI関連とそれ以外、単体デバイスとクラスタ、地域別の保有、(AI関連クラスタについては)データセンターの規模がある。2029年以降の部分では、ハードウェアの研究開発と生産がAIによって加速した場合にどれだけの計算資源を生産できると考えるか、その根拠を示す。あわせて、企業への計算資源の集中、フロンティアAIの計算資源の用途別配分についての予測と、プランAのシナリオでAIのコピー数と速度がどうなりそうかという見立ても示す。
図で見る要約
| AI関連 | 非AI関連 | |
|---|---|---|
| クラスタ | AIクラスタAIサーバーとポッド。 | 非AIクラスタCPUサーバー。 |
| 単体デバイス | 特殊用途の消費者向けハイエンドワークステーションとゲーミング用カード。 | 消費者向け計算資源スマートフォン、PC、ゲーミングGPU。 |
2つの基準で区分する。チップが AI関連 になるのはAI計算性能の下限を超える場合、 クラスタ になるのは他のチップ1つ以上と5 GB/s以上で接続されている場合だ。
計算資源の定義
計算資源の測り方:生のH100eと実効H100e
この補足資料で使う主な指標は H100換算(H100e) だ。Nvidia H100 GPU 1基を単位とした倍数で、総処理性能(TPP) で測る。
とはいえ、ハードウェアの性能を表す指標は計算性能だけではない。AIのワークロードで計算資源がどれだけ役に立つかは、ほかの多くの要素にも左右される。たとえばメモリ帯域幅、メモリ容量(計算ユニットにデータを蓄え、送り込む)、インターコネクト(チップ間でデータをやり取りする)だ。私たちが中心に据える指標は計算資源(H100e)だが、AIにとっての総合的な有用性も考慮したい。そこで、ほかに四つのハードウェア資源も見て、それらをまとめた 実効H100e という指標を作る。
| 資源 | 役割 | H100(1 H100eあたり) |
|---|---|---|
| 計算(TPP) | 演算のスループットそのもの(単位を定義する) | 15,800 TPP |
| メモリ帯域幅 | 計算ユニットにデータを送り込む(HBM) | 3,350 GB/s |
| メモリ容量 | 計算ユニットの近くにデータを蓄える(HBM) | 80 GB |
| スケールアップ | サーバー内のチップをつなぐ(NVLink) | 900 GB/s |
| スケールアウト | クラスタ内のサーバー同士をつなぐ(Ethernet) | 50 GB/s |
実効H100e は、生のH100e(計算性能だけを数えたもの)を一つの有用性係数 で補正した値だ。
は上の表にある残り四つの資源から組み立てる。その時代の代表的なAIワークロードで、チップがメモリから実際にデータを供給され、ほかのチップと通信できる度合いを反映する補正で、2024年時点の10万基規模のH100 SXMクラスタをちょうど とした相対値である。
FLOP/sに比べてメモリが豊富でネットワークも充実したハードウェアは1を上回ることがある(非AIのCPUサーバーは、比較的小さな計算性能のまわりに大量のメモリとネットワークを備えているため約1.4になる)。逆に、ネットワーク能力に乏しい計算資源(ゲーミングGPUやスマートフォンなど)は1を下回る。
有用性係数の詳しい説明は付録にある。
計算資源の4区分
この補足資料では世界のすべての計算資源をモデル化し、それを互いに独立な二つの軸で分けて4つの区分を得る。
分類1:AI関連か非AI関連か。 A100 GPUのすぐ下に設定したAI関連の閾値の四つの下限をすべて満たすチップをAI関連とみなす。
| 指標 | 閾値 | A100 | H100 | RTX 4090 |
|---|---|---|---|---|
| 計算性能 | 4,000 TPP | 4,992 | 15,800 | 5,285 |
| メモリ帯域幅 | 1.0 TB/s | 2.0 | 3.35 | 1.01 |
| メモリ容量 | 32 GB | 80 | 80 | 24 |
| ネットワーク(NIC) | 100 Gb/s | 200 | 400 | 64 |
分類2:クラスタか単体デバイスか。
クラスタ = 少なくとも2台のデバイスが双方向5 GB/s以上の速度で接続され、複数デバイスの構成で実際に使われているもの。
単体デバイス = 単独のデバイスとして使われているもの(スマートフォン、PC、ゲーミング用カードなど)、またはクラスタの定義を満たさないもの。
これらの定義から、計算資源の4区分が得られる。
| AI関連 | 非AI関連 | |
|---|---|---|
| クラスタ | AIクラスタAIサーバーとポッド。 | 非AIクラスタCPUサーバー。 |
| 単体デバイス | 特殊用途の消費者向けハイエンドワークステーションとゲーミング用カード。 | 消費者向け計算資源スマートフォン、PC、ゲーミングGPU。 |
2つの基準で区分する。チップが AI関連 になるのはAI計算性能の下限を超える場合、 クラスタ になるのは他のチップ1つ以上と5 GB/s以上で接続されている場合だ。
第1部 協定前の計算資源(2029年以前)
1.1 AI関連の計算資源
この節では、AI関連の計算資源の生産量を需要側の方法で予測する。
設備投資額(ドル) コスト効率(H100e/ドル) = 追加される計算資源(H100e)
AIの設備投資額のトレンドは、2023年第3四半期から2025年第4四半期にかけて年約1.72倍で推移してきた。一方、コスト効率(1ドルあたりのH100e)は年約1.4倍のペースで改善している。
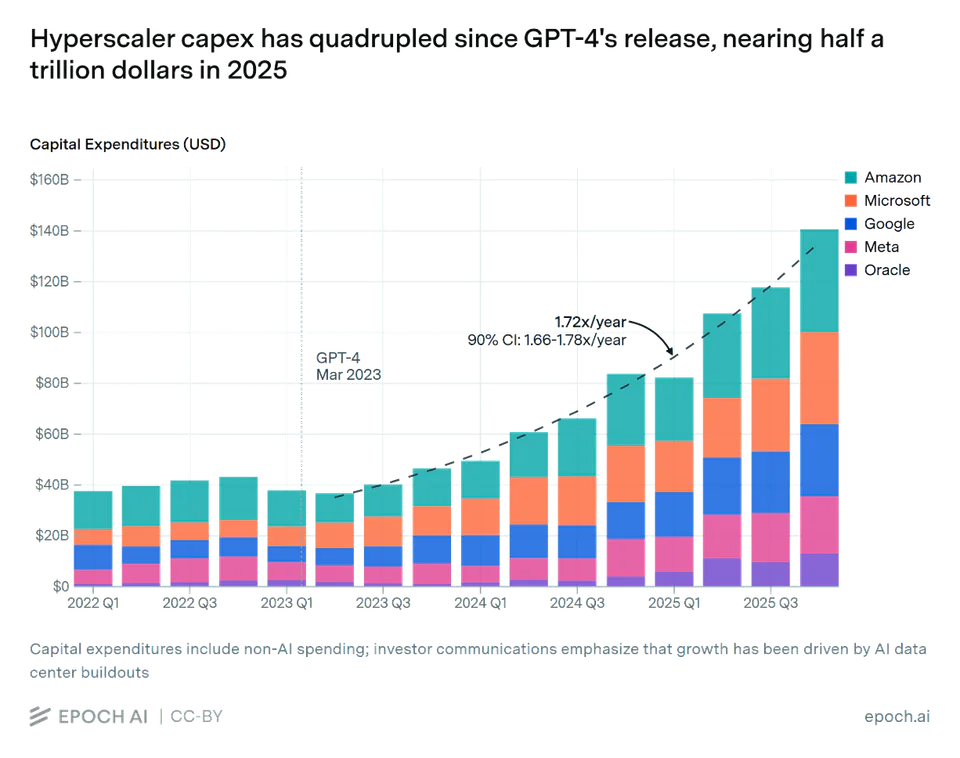
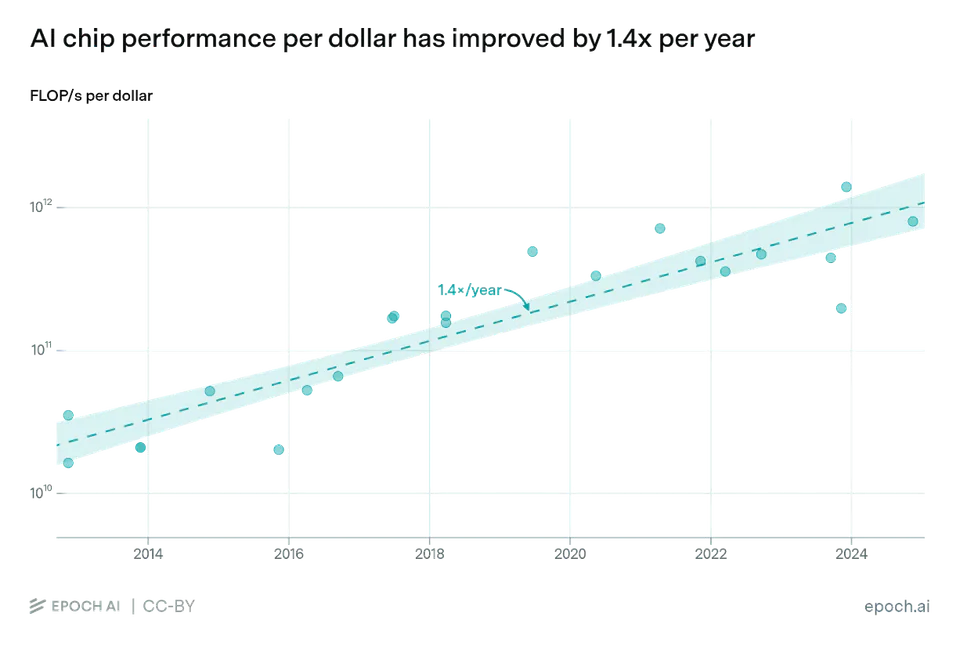
これらのトレンドを単純に外挿すると、計算資源の予測は次のようになる。
この節の残りでは、この単純なベースラインから予測を改良していく。
設備投資予測の改良
2025年までは、計算資源の増強費用のほぼ全額が大手テック企業の営業キャッシュフローで賄われてきた。しかしこのトレンドが続けば、2026年第3四半期ごろにはハイパースケーラーの設備投資額が営業キャッシュフローを上回る見込みだ。
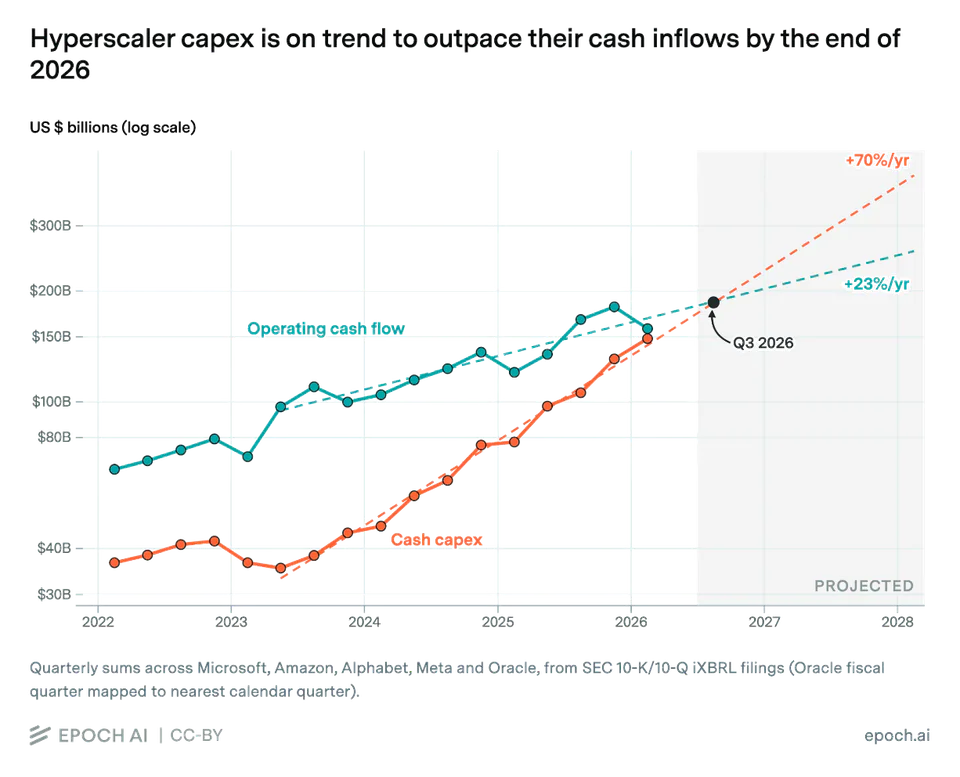
この点を織り込んだ予測にするため、設備投資の見通しを三つの資金源に分けた。既存トレンドに沿ったハイパースケーラーのキャッシュフロー、AIキャッシュフロー(AI企業の収益から追加で支出される計算資源投資。フロンティアAI企業の収益予測の80%で近似する)、そして負債・株式による資金調達(2025〜2026年にはすでに増え始めている)の三つである。
見通しは次のとおりだ。
-
既存トレンドに沿ったハイパースケーラーのキャッシュフローは年約20%で成長を続け(Epochの推計で約4,780億ドル→6,030億ドル。フロンティアAI企業の収益は除く)、そのより大きな割合が増強に回る。設備投資がキャッシュフローに占める割合が高まるにつれ、投資に回る割合は約75%から85%へ上がる。
-
AIキャッシュフローは、フロンティアAI企業全体のARR(年換算収益)が 300億ドル(2026年初め)→1,800億ドル→5,000億ドル→1兆ドル(2029年初め) と推移する経路に従う。計上収益の80% を計算資源への追加支出として数える。
-
負債・株式による資金調達は、AI収益に対する低下していく倍率として手作業で(大まかに)予測する。3倍(2025年)、2.8倍(2026年)、1.8倍(2027年)、1.6倍(2028年) だ。この値は非常に不確かである。AI収益の伸びはレバレッジを後押しする一方、借入総額が膨らめば金利はおそらく上がる。また、この水準のレバレッジは、シナリオどおりAIの急速な進歩が続くこと(貸し手が収益の伸びを信じ続けること)を暗に前提にしている点にも注意してほしい。収益の経路そのものと同じく、これは無条件の予測ではなく、このシナリオと整合する入力値である。
2024〜2025年をEpochの広義の設備投資額(2,600億ドル/4,480億ドル)に合わせると、AIの設備投資総額は2028年に約2.4兆ドルに達し、負債は約9,000億ドル(2028年の増強額の38%)になる(AIの設備投資総額の代理指標としては、ハイパースケーラーの広義の設備投資額を使う。ハイパースケーラーは世界のAI支出の約60〜90%を占め、その設備投資の約60〜90%がAI向けなので、二つのずれはおおむね相殺すると仮定する)。これは、単純なベースライン(年約1.72倍のトレンドの外挿)による2028年の設備投資額2.28兆ドルより7%も高い。強気のAI収益予測(と、その急成長が促すと考える借入)によって、トレンドがむしろわずかに押し上げられるためだ。
AI収益と負債の予測
AI収益の予測は、フロンティアAI企業全体のARR(年換算収益ランレート)が 300億ドル→1,800億ドル→5,000億ドル→1兆ドル(年の境目で2026.0〜2029.0)と推移する経路に従う。ただしAI収益は1年間に計上されるフローであって、ARRのランレートではない。そのため年間の計上収益に換算すると、2025年:150億ドル/2026年:840億ドル/2027年:3,130億ドル/2028年:7,210億ドルになる。このうち80%を計算資源への追加支出(上の「AIキャッシュフロー」)として数えると、120億/670億/2,510億/5,770億ドルとなる。フロンティアAI企業全体のARRの見通しは手作業で立てたもので、不確実性が非常に大きい。大まかに言えば、Anthropicの最近の年約10倍というARRのトレンドは、同社が収益でトップのAI企業になるにつれて減速し、AI企業全体の収益トレンドは年約3倍に戻ると見ている。さらに後半の年には、推論計算資源が年約2倍で増えるなかで各社が推論計算資源あたりの収益(ドル/FLOP)をほぼ横ばいに保つため、伸びはそれよりやや低くなると考える。計算資源の数値とはいくぶん循環的な関係にあるが、これが現時点での(非常に不確かな)見立てだ。
この収益トレンドを前提にすると、どの程度の借入ペースが妥当か? まず、5大ハイパースケーラーは2025年に約1,210億ドルの社債を発行した(2020〜2024年の標準は年約280億ドル)。BofAとJPMorganは2026年に約1,750億〜3,000億ドルと予測している。CoreWeaveのように負債で資金を賄うネオクラウドは、収益の約4倍の負債を抱えている(収益約50億ドルに対し負債210億ドル)。モルガン・スタンレーのポッドキャストは、2025〜2028年の約2.9兆ドルの増強のうち約1.15兆ドルが負債で賄われると見ている。米国の投資適格債の発行総額は年約1.5兆ドルだ。SpaceXのIPOも大規模な株式調達の可能性を示しており、OpenAIやAnthropicが同規模かそれ以上の調達で続くかもしれない。これらを目安に、負債をAI収益総額に対する倍率として場当たり的に手で設定した。3倍(2025年)→2.8倍(2026年)→1.8倍(2027年)→1.6倍(2028年)で、2025〜2028年の負債によるAI設備投資は約360億/1,880億/4,520億/9,230億ドルになる。合計すると、2025〜2028年の増強総額約5.1兆ドルのうち約1.6兆ドルが負債による支出(負債比率約31%) となり、モルガン・スタンレーの負債約1.15兆ドルを約39%、総額約2.9兆ドルを約75%、それぞれ上回る。ただし、モルガン・スタンレーの数字は株式による調達を考慮していない点に注意したい。
コスト効率予測の改良(供給側)
設備投資の予測は需要側からの予測だが、コスト効率については供給側を見るのが理にかなう。とくにこの節では、生産できるH100eの量を制約する主なボトルネックとして予想される、リソグラフィ(主にEUV)の生産能力に注目する。
EUVは最先端のロジックに欠かせず、最先端のHBM向けDRAMノードでもいまは使われている(DRAMはつい最近までEUVをまったく使わずに製造されていた。たとえばMicronがEUVを導入したのは2025年になってからだ。したがってDRAMでのEUV使用は厳密な必須要件ではなく、コスト上最適な選択である。EUVを避けても、同じ需要が共有のDUV設備に移るだけだ)。EUV装置は非常に複雑で、サプライチェーンへの依存も広範に及ぶため、短期間で増産するのが極めて難しい。そのためEUVが最も重要で、最も示唆に富むボトルネックになると考えている。時間に対する非弾力性(価格シグナルに応じて生産をすばやく増やすことの難しさ)があるので、EUV装置の保有台数は比較的予測しやすくもある。
| 年 | EUV保有台数(年初) | EUV年間追加台数 | 年間パス数(全装置) | AIの年間ロジックウェハ数 | AIの年間HBMウェハ数 | AIの年間EUVパス数 | 保有台数に占めるAIの割合 |
|---|---|---|---|---|---|---|---|
| 2024 | 220 | +44 | 87M | 0.2M | 1.1M | 7M | 7% |
| 2025 | 264 | +48 | 104M | 0.4M | 2.5M | 15M | 15% |
| 2026 | 312 | +65 | 124M | 0.7M | 4.6M | 34M | 27% |
| 2027 | 377 | +80 | 150M | 1.0M | 8.0M | 68M | 45% |
| 2028 | 457 | +100 | 183M | 1.6M | 13M | 118M | 65% |
| 2029年(プランAなし) | 557 | +125 | 223M | 2.1M | 17M | 172M | 77% |
EUV装置の保有台数の推移と、そのうちAIが使う割合。保有台数は2024年時点の稼働中の装置220台から始まり(2021年末時点でASMLのEUV装置は約127台が稼働中で、ASMLは2022年と2023年にそれぞれ54台と42台を出荷したと推計した。ASMLの年次報告書による。出典を含む積み上げの全体は下の詳細ボックスにある)、加速していく出荷によって増えていく。「EUV追加台数」の列は、その年のASMLの出荷台数である(ASMLは2026年に「60台超」、2027年に約80台という見通しを示している)。年間パス数は、その年の平均保有台数×装置1台あたり約36万パスで求めた。AIの使用量は、AI向けのロジックウェハ(ロジックウェハ1枚あたりEUV約12〜24層、N4→N2)とHBM用DRAMウェハ(HBMウェハ1枚あたりEUV約4〜7層、積層とパッケージングの歩留まりを考慮)の合計である。AIの割合は約15%(2025年)から約77%(2029年、プランAなし)へ高まる。
EUV露光装置がH100eを生み出すまで
AIがEUV装置を使う需要はロジックとメモリの両方から生じるので、二つを一つの単位にまとめて足し合わせる。EUVパス=ウェハ1枚に対するEUV露光1回である(装置1台は、何を焼き付けるかにかかわらず年に約36万パスを処理する)。以下は2025年の積み上げである。
1. 保有台数→パス数。 露光装置1台の公称処理能力は1時間あたり約160枚だが、実際には1時間あたり約40〜50枚相当しか処理できない。実際のパターンには仕様の想定より長い露光が必要になり(光源の出力に制約されて露光量が増える)、装置の稼働率は約75〜82%にとどまり、露光フィールド間の移動にも時間を取られる(レチクルのオーバーヘッド)ためだ。これらを差し引くと、装置1台あたり年約36万の実効パスになる(160枚/時×8,760時間≈110万〜140万という単純計算は3〜4倍多すぎる)。二つの逆算がこれと一致する。フレデリック・チェン(Frederick Chen)(実効50枚/時未満)とSemiAnalysis(月約1,500枚×約20回の露光)だ。2024年初めの稼働中の装置約220台(2021年末時点でASMLのEUV装置は約127台が稼働中で、2022〜2023年に約54台と約42台が出荷された。TSMCだけで生産能力の約56%を運用している)から出発すると、2025年の保有装置全体のパス数は年約1億で、ASMLのEUV出荷の加速(2025年の約48台から2029年には年約120台へ)に伴い、2029年には約2億2,000万に増える。
2. AIのロジック需要。 2025年、AIアクセラレータは最先端ウェハ約40万枚を使う。これはTSMCの5nm以下のウェハ約300万枚の約12% にあたる(Epochの直接推計。BlackwellはN4で、NvidiaはようやくN3への移行を進めているところだ)。N4のEUV層数約14で計算すると約500万パスになる(約800mm²のダイは、歩留まり約70%でウェハ1枚あたり良品約42個が取れる。Cerebrasによる。ウェハ1枚あたりのH100eは現在約28〜36で、FP4、N4→N3→N2の微細化、Rubinのチップあたり高いH100eが重なって2029年には約120になる。そうするとロジックだけの上限は年約2億→約12億H100eとなる。ただし微細化はEUVの面ではただではない。より多くの層がEUVに移るため、モデルではロジックウェハ1枚あたりのパス数が2024年の約12から2029年の約24へ増えていくとしている)。
3. AIのメモリ需要(大きいほうの半分)。 HBMは事実上すべてAIに回り、しかもGBあたりのウェハ使用量が多い。報告されている2025年のHBMのTSV/後工程の生産能力は月約40万枚(SK Hynix約17万+Samsung約16万5,000+Micron約6万。TrendForce)だが、これは生産能力の上限であって、実際の投入枚数ではない。歩留まりを差し引くと、AIの実際の需要は年約250万枚のHBMコアウェハになる。24GbダイのDRAMウェハ1枚は総容量で約1,400GBを持つが、コアと積層(KGSD/TSV)の歩留まり約57%、CoWoS組み立ての歩留まり約88%を経ると、投入ウェハ1枚あたり出荷されるのは正味約700GBにとどまる。一方、2025年分のアクセラレータに必要なHBMは約18億GBだ(ボトムアップで約1,170万基のアクセラレータ×約150GB。業界全体の約350億ドル/約20億GBとも整合する)。最先端のHBMノードは実際にEUVを使っている(SK Hynixの1bで約4層、1cで約6層)ので、約4層で計算すると約1,000万パスとなり、AIのEUV需要のおよそ3分の2を占める(GBあたりで見ると、HBMはDDR5ウェハの約3倍を消費する)。
4. 保有装置に占めるAIの割合。 ロジック(約500万)+HBM(約1,000万)= 約1,500万パス/保有装置全体の約1億400万≈15%(2025年)。HBMの生産量とEUV層数の増加に加え、AIがEUVを多用するN3/N2のロジックへ移行することで、この割合は2028年に約64%、2029年に約77% に達し、2029〜2030年ごろにはAIがEUV装置をほぼ使い切る状態に近づく。この需要はコストの割増にはね返る(EUVの使用が増えるほど割増が大きくなり、1ドルあたりのH100eが減る)ので、自己整合的に解いている。増強の後半が抑えられるのはこのためだ(2028年の追加量は、単純計算の約1億9,000万に対し約1億5,500万)。
5. ウェハ枚数ではなくパス数を使う理由。 AIのウェハは種類が混在している。HBMウェハはEUVパスが約4回で済むのに対し、最先端のロジックウェハは約14〜22回かかる。そのためウェハの枚数で数えると、装置に対する大きく異なる需要を同じものとして扱ってしまう。AIのウェハ構成はHBMに偏っているので、枚数で数えると初期の割合を過大に見積もる(2025年の割合は、パス数で数えた約15%を大きく上回ることになる)。2029年までに二つの指標が収束する理由は単純だ。そのころにはAIがロジックとHBMのどちらのウェハでも過半を使う利用者になっているので、構成の違いが問題にならなくなり、どちらの数え方でも約80%前後に落ち着く。
EUV装置に占めるAIの割合は、2024年の約7%から2028年には約64% へ上がる(2029年には約77%で、ほぼ飽和に近い)。これは、装置のほかの用途(スマートフォン、PCなど)に競り勝つ必要があるため、価格の上昇につながると考えている。これをモデル化するため、装置の使用率に応じて変わるコスト割増の曲線を手作業で設定した(不確実性の大きい場当たり的な選択である)。
この割増を単純な価格性能比のトレンドに適用すると、計算資源のコスト効率は、過去の年約1.4倍ではなく、2025〜2028年の平均で年約1.25倍に改善するトレンドになる(割増が効いてくる2028年には年約1.1倍まで鈍る)。
ウェハの数字の出どころ
コストの数字は ドル/H100e =(ウェハ1枚あたりの総費用)/(ウェハ1枚あたりのH100e) という恒等式で決まる。三つの量のうち二つにはそれなりに良い推計があるので、10億ドルあたりのウェハ枚数(ウェハ1枚あたりの総費用の逆数)を残差として逆算し、そこから導かれるウェハコストが妥当かどうかを確かめる。
ドル/H100e(既知)。 2024年と2025年は観測値である(年間設備投資額/追加されたH100e:約5万1,000ドル、約3万3,000ドル)。2026〜2028年は、年約1.4倍の価格性能比のトレンドにEUVの割増を課して、約2万3,000ドル/約1万8,000ドル/約1万6,000ドルとした。
ウェハ1枚あたりのH100e(既知、約28→約98)。 レチクルの限界に近い約800mm²のダイは、300mmウェハ1枚から総数で約64〜72個取れ、歩留まり約70%で良品は約42個になる。後工程での損失(パッケージングの歩留まり)を差し引くと、2024年は販売可能なH100eがウェハ1枚あたり約28になる。これはFP4/精度(EUV不要)、N4→N3→N2の微細化(EUV層の追加という代償を払う)、Rubinのチップあたり高いH100eによって年約1.4倍で伸び、2028年には約98(2029年には約120) に達する。いずれもダイサイズ、ノード、精度の推計にかなりしっかり裏付けられている(2025年の検算:AI向け最先端ウェハ約38万枚で約1,360万H100e≈ウェハ1枚あたり約36H100e)。
10億ドルあたりのウェハ枚数(残差)。 二つを掛け合わせると、ウェハ1枚あたりの総費用が逆算できる。約143万ドル(2024年)→約118万ドル(2025年)→約120万ドル→約136万ドル→約156万ドル(2028年)で、10億ドルあたりのウェハ枚数にすると約700→約845→約640枚だ。2025年の落ち込みは観測データそのものから来ている。2024年は立ち上がりの時期で供給制約があり、2025年にBlackwellが量産に入ったため、最先端ウェハ1枚あたりの総費用が下がった。2026年からは導かれるウェハ単価が上がっていくが、これは予想どおりだ。TSMCの平均販売価格は年5〜10%上がり(N2は約3万ドルで、N3より10〜20%高い)、CoWoSは年15〜20%上がり、データセンターのMWあたりの費用も上がり、そこにEUVの割増が加わる。この水準は、ウェハ1枚あたりのボトムアップの積み上げとも整合する。ファウンドリ費用が約2万5,000〜3万ドル、ウェハから取れる約28個のダイに使うHBMが約5万〜7万ドル、CoWoSが約1万〜1万5,000ドルで、チップ設計企業の約4〜5倍のマークアップを乗せると、ウェハ1枚あたりのアクセラレータの価値は約40万〜50万ドル(アクセラレータ1基あたりおよそ1万5,000ドル)になる。残るウェハ1枚あたり約70万〜110万ドル(アクセラレータ1基あたり約2万5,000〜4万ドル)は、チップ以外の増強費用、つまりデータセンター、電力、土地、ネットワークだ。したがって残差は妥当に見える。2025年以降、ウェハコストは緩やかな逆風になり、ドル/H100eが約5万1,000ドルから約1万6,000ドルへ下がる分はすべて、計算密度の向上によるものだ。
このコスト効率のベースライン(希少性による割増を含む)に設備投資の総額を掛けると、年間の追加H100e(2028年に約1億5,500万)と、2028年末時点で約2億8,000万の稼働中の総量が得られる。チップの残存率に合わせて、ごくわずかに下方修正もしている。中国が国内で製造する計算資源(§1.3)はこのEUVのサプライチェーンを使わないので、別に予測してこの合計に上乗せする。これで世界のAI計算資源の総量は約2億8,700万になる。
資源の集約度:生のH100eから実効計算資源へ
稼働中のAIハードウェアについても、実効H100eと生のH100eはずれていく。メモリの壁は実効性を1より下に引き下げ(FP4で押し上げられたTPPが、HBMの帯域幅と容量の伸びを上回る)、拡大していくコヒーレントなNVLinkの世界(HGX-8→NVL72→NVL144→NVL576)はそれを押し戻す。二つはおおむね相殺する。2024年には小さな上乗せがあるが(約1.16。ハードウェアのメモリが豊富な時期)、メモリの壁と大規模化する学習実行が効いてくるにつれ、2029年には約1へ薄れていく。これは§1.2.3と同じ有用性モデルだ(導出の全体は付録にある)。これを動かす、導入量で加重したAIハードウェア全体の入力値は次のとおり(H100e換算のスケールアップ世界=コヒーレントに接続されたチップ数×チップあたりのH100e)。
| AIハードウェア全体(導入量で加重) | 2024 | 2026 | 2028 |
|---|---|---|---|
| H100eあたりのHBM帯域幅(GB/s) | 4,080 | 3,330 | 3,610 |
| H100eあたりのHBM容量(GB) | 110 | 91 | 85 |
| スケールアップ世界(H100e) | 184 | 436 | 929 |
| チップあたりのH100e | 1.15 | 2.58 | 5.34 |
| 生のH100eあたりの実効H100e | 1.16 | 1.06 | 1.04 |
1.2 すべての計算資源
§1.1ではAI関連の計算資源を予測した。ここからは対象を世界のすべての計算資源に広げる。すべての計算資源を、デバイスの種類で6つの区分に分ける。
| 区分 | 例 | AI関連 |
|---|---|---|
| AI | データセンター向けAIアクセラレータ(H100、B200、MI300) | はい |
| 非AIサーバー | データセンター向けCPUと非AIアクセラレータ | いいえ |
| PC | ノートPCとデスクトップPC | いいえ |
| スマートフォン | スマートフォン | いいえ |
| ゲーミング | ゲーミングGPU | いいえ |
| その他 | マイコン、車載、エッジ | いいえ |
この方法では二つの量を見る。デバイス側は、出荷台数と、各デバイスが平均して載せている計算性能を数えて得られる計算資源だ。リソグラフィ側は、ファブ(半導体工場)が生産できるウェハの枚数と、ウェハ1枚が生み出す計算資源を数えて得られる、世界が製造できる計算資源である。
デバイス側 H100e = 台数 1台あたりのH100e
リソグラフィ側 H100e = ウェハ枚数 ウェハ1枚あたりのH100e
ウェハ1枚あたりの計算資源は最も確信の持てない量なので、過去のデータ(ほかの値がすべてよく推計できる期間)からこれを絞り込むことを試みる。
1.2.1 較正(2015〜2024年)
2015〜2024年について、デバイスの需要(出荷台数と1台あたりの計算性能)とリソグラフィの供給(出荷されたウェハ枚数)を見て、ウェハ1枚あたりの計算資源の推計値を逆算する。これを使えば、ウェハの配分と供給の予測から、将来の計算資源を区分ごとに予測できる(供給側は比較的予測しやすいリソグラフィの上限で予測できるので、デバイスの需要を予測するより容易だ)。
デバイス側
| 出荷台数(M台/年) | 2015 | 2018 | 2020 | 2022 | 2024 |
|---|---|---|---|---|---|
| スマートフォン | 1K | 1K | 1K | 1K | 1K |
| PC | 276 | 259 | 304 | 292 | 263 |
| ゲーミング | 44 | 50 | 40 | 38 | 36 |
| AI | 0.1 | 0.3 | 0.6 | 2.0 | 7.5 |
| 非AIサーバー | 8.0 | 11 | 13 | 14 | 13 |
| その他 | 12K | 20K | 24K | 28K | 30K |
出荷台数の出典
- スマートフォン:1.43B(2015年)→1.24B(2024年)。ピークは1.47B(2016年)、パンデミック期の底は1.21B(2022年)。出典: IDC Worldwide Quarterly Mobile Phone Tracker / Omdia / Counterpoint。
- PC:276M(2015年)→263M(2024年)。COVID期のピークは約349M(2021年)、底は約260M(2023年)。IDCはChromebookを数えるため、2020〜2021年にはGartnerより約30M多い。ここではIDCの基準を使う。出典: Gartner / IDC PCD Tracker.
- ゲーミング:デスクトップ用の単体アドインボードGPUのみ(iGPUとデータセンター向けは除く)。44M(2015年)→約35M(2024年)。出典: Jon Peddie Research AIB Report.
- AI:AIデータセンター全体。台数=アクセラレータ数。TechInsightsは2023年のNVIDIAのデータセンター向けGPUを3.76M基と集計した(シェア98%)。2024年は全ベンダーで約7.5M(NVIDIA約4M + Google TPU約2.5M + AWS Trainium約1.2M + AMD MI300約0.4M)。出典: TechInsights(DCD経由)、 Epoch AI、Omdia/Morgan Stanley。
- その他:先端ノードのデジタルチップ(ネットワークASIC、ベースバンド、車載・IoTロジック)のみ。MCUとアナログ全体ははるかに大きい(MCUだけで年約25〜35B個)が、大半はこのモデルが追跡する300mmリソグラフィの枠外にある、旧世代ノード/200mmの生産能力だ。
| 1台あたりのTPP | 2015 | 2018 | 2020 | 2022 | 2024 |
|---|---|---|---|---|---|
| スマートフォン | 0.5 | 5.0 | 25 | 60 | 100 |
| PC | 8.0 | 20 | 38 | 62 | 100 |
| ゲーミング | 15 | 250 | 550 | 1K | 2K |
| AI | 350 | 1K | 2K | 5K | 10K |
| 非AIサーバー | 30 | 75 | 150 | 320 | 500 |
| その他 | 0.1 | 0.3 | 0.5 | 0.7 | 0.9 |
1台あたりTPPの出典
TPP =(ある精度での密行列演算のピークTOPS)×(その精度のビット長)を、すべての精度で最大化した値。米国BISの輸出規制指標(ECCN 3A090)である。尺度を固定する基準値:V100 ≈ 2,000、A100 = 4,992、H100 ≈ 15,800、RTX 4090 = 5,285(規制ラインの4,800をわずかに上回る)、B200 ≈ 36,000。フラッグシップは台数のごく一部なので、数値はすべて販売加重平均。出典: Federal Register 88 FR 73458, CSETの解説, Princeton ISCA 2025.
- スマートフォン:NPUのINT8 TOPS × 8。Apple A11 = 0.6 TOPS(2017年)→A17 Pro = 35 TOPS(2023年)、Snapdragon 8 Gen 3 = 45 TOPS(2024年)。2017年以前はほぼゼロ。2024年の販売加重平均は≈100 TPP。出典: Apple Neural EngineのTOPS一覧.
- PC:ほとんどのPCはNPUを持たない(2024年の出荷のうち「AI PC」は約17%のみ)。2024年の販売加重平均は≈100 TPP。出典: CanalysのAI PCシェア.
- ゲーミング:密行列INT8 TOPS × 8。RTX 3060 = 815、RTX 4060 = 968(4060 Ti = 1,412)、RTX 4090 = 5,285。販売構成はほとんどxx60クラスなので(Steamの調査)、2024年の販売加重平均は4090の5,285ではなく約1,500 TPP。出典: Steam Hardware Survey.
- AI:全ベンダーの販売加重(H100/H200 = 15,800、A100 ≈ 5,000、TPU/Trainiumはそれ以下)。2024年 ≈ 9,500 TPPで、NVIDIAのフラッグシップを下回る。約7.5M台なので2024年は約4.5M H100eとなり、この積み上げ値が2025年の継ぎ目でプランAの予測とつながる。出典:NVIDIA/Google/AWSのデータシート、 TrendForceの構成比.
- その他:年約30B個。大半はAI処理性能がほぼゼロのMCU/アナログで、AI処理性能をもつのは車載・ADASとエッジNPUのわずかな裾野だけ。そのため台数加重平均は2024年時点でもわずか約1.5 TPP。
リソグラフィ側
| ウェハ(M枚/年) | 2015 | 2018 | 2020 | 2022 | 2024 |
|---|---|---|---|---|---|
| スマートフォン | 1.8 | 1.9 | 1.9 | 1.9 | 2.1 |
| PC | 0.7 | 0.7 | 0.9 | 0.9 | 0.9 |
| ゲーミング | 0.2 | 0.3 | 0.2 | 0.3 | 0.3 |
| AI | 0.0 | 0.0 | 0.0 | 0.0 | 0.3 |
| 非AIサーバー | 0.1 | 0.2 | 0.3 | 0.3 | 0.3 |
| その他 | 5.5 | 9.7 | 12 | 15 | 17 |
| デバイス需要(合計) | 8.3 | 13 | 15 | 18 | 20 |
ウェハ出荷の出典
- 各区分のウェハ= ロジックウェハ (台数 × デバイスあたりのダイ数 ÷ ウェハあたりの良品ダイ数)に、一緒に出荷される メモリウェハ (HBM、DRAM、NAND)を足したもの。台数は上の出荷表による。メモリウェハは、各デバイスのメモリ搭載量と、DRAM/NAND/HBMの各ノードの現在のウェハ1枚あたりGBから求める。
- 300mmウェハ1枚あたりの良品ダイ数(歩留まり考慮後):スマートフォン約600(約100〜120mm²)、PC約300(約200mm²)、ゲーミング約130(約400mm²)、AI約42(約800mm²のレチクル上限のダイ、歩留まり約70%)、「その他」約1,800(約30mm²)。出典: AnySilicon、レチクル/ダイサイズの公開情報(TSMC、NVIDIA、WikiChip)。
- 完成デバイスあたりのダイ数:非AIは≈1(デバイスごとにSoC/CPU/GPUが1つ)。AIは1(H100)→約1.5(2024年、デュアルダイのB200)→2030年までに約8〜11(Rubin世代のチップレット)と増える。出典:NVIDIAのロードマップ、 SemiAnalysis.
- ダイ面積はすでに歩留まりを考慮した値なので、別途の歩留まり係数は適用しない。
区分ごとのリソグラフィの使用状況を下に示す。どの区分も、ロジックと付随するメモリ(HBM、DRAM、NAND)をひとまとめにしたパッケージとして扱う。
ウェハ1枚あたりの計算資源を独立の推計で検算する
ウェハ1枚あたりの計算資源は、単に(ウェハ1枚あたりの良品ダイ数)×(ダイ1個あたりのTPP)/15,800 で求まる。どちらも、ファブの稼働状況とは無関係にデバイスの仕様から推計できる。
-
300mmウェハ1枚あたりの良品ダイ数(歩留まり考慮後、ダイ面積から算出。出典は上のウェハのボックスにある):AIは約42(レチクル限界に近い約800mm²のダイ、歩留まり約70%)、ゲーミングは約130(約400mm²)、PCは約300(約200mm²)、スマートフォンは約600(約100〜120mm²)、汎用品の「その他」は約1,800(約30mm²)。
-
ダイ1個あたりのTPP = 各区分の1台あたりのTPP(上のデバイス側)/1台あたりのダイ数。2024年では、AIが約9,500/約1.5≈6,300 TPP/ダイ、ゲーミングが約1,500、スマートフォンとPCが約100、「その他」が約1.5だ。
つまりAIは大きくTPPの高いダイのおかげでウェハあたりの密度が最も高く、汎用品の「その他」(小さくTPPがほぼゼロのダイ)が最も低い。これは、各区分の計算資源をそのウェハ枚数で割った結果とぴったり一致する。
| 逆算したH100e / ウェハ | 2015 | 2018 | 2020 | 2022 | 2024 |
|---|---|---|---|---|---|
| スマートフォン | 0.03 | 0.23 | 1.1 | 2.4 | 3.8 |
| PC | 0.20 | 0.46 | 0.83 | 1.3 | 1.9 |
| ゲーミング | 0.19 | 2.8 | 5.6 | 9.2 | 12.3 |
| AI | 1.4 | 5.0 | 7.2 | 14.2 | 16.8 |
| 非AIサーバー | 0.11 | 0.25 | 0.46 | 0.90 | 1.3 |
| その他 | 0.01 | 0.04 | 0.06 | 0.09 | 0.10 |
さらに検算として、これらの値から導かれるウェハ需要を、推計したリソグラフィの総供給(世界のロジックウェハの広義の生産量。2024年に約3,000万枚で、SEMIの300mm生産能力と整合する規模)と比べると、この10年を通じて総供給の約62〜69%になる。総供給を超えることのない、もっともらしく安定した割合だ。ただし総供給の水準自体がこの範囲に収まるよう較正されているので、これはダイサイズ、計算性能、生産能力の推計が互いに整合していることを示すだけで、どれか一つを独立に裏付けるものではない。
こうして得られた、区分別の毎年の追加H100eを、生のH100eと実効H100eの両方で下に示す。
1.2.2 予測(2025〜2028年)
§1.1のAIの計算資源予測を出発点に、残りのリソグラフィ生産能力をほかの区分に割り振る。まずAIが自らのリソグラフィ使用量を確保し、その残りのウェハを、非AIの各区分が2024年時点で固定した割合で分け合う。そうして得られる予測は次のとおりだ。
| フロー(H100e/年) | 2025 | 2026 | 2027 | 2028 |
|---|---|---|---|---|
| スマートフォン | 12.0M (33%) | 16.6M (25%) | 21.5M (18%) | 31.0M (14%) |
| PC | 2.8M (7.7%) | 4.1M (6.2%) | 5.5M (4.5%) | 8.8M (4.0%) |
| ゲーミング | 5.2M (14%) | 7.2M (11%) | 9.4M (7.8%) | 14.2M (6.5%) |
| AI | 14.2M (39%) | 35.7M (54%) | 80.6M (67%) | 159.7M (73%) |
| 非AIサーバー | 558K (1.5%) | 725K (1.1%) | 901K (0.7%) | 1.2M (0.5%) |
| その他 | 2.0M (5.4%) | 2.3M (3.4%) | 2.6M (2.2%) | 3.2M (1.5%) |
| 合計 | 36.7M | 66.6M | 120.5M | 218.1M |
AIは§1.1による。非AIは、残りのロジックウェハ × 上昇するウェハ1枚あたりのTPPで求める。ロジックとHBMを合わせると、AIは2028年までにEUV保有装置の処理能力の約15%→65%を使う(装置全体の使用率はほぼ100%)が、ロジックウェハ全体に占める割合は約40%にとどまる。
AIのウェハ使用量、残りの供給、部材構成
| ウェハ枚数/年 | 2025 | 2026 | 2027 | 2028 |
|---|---|---|---|---|
| AIのロジックウェハ | 378K | 664K | 1.0M | 1.6M |
| +AIのHBMウェハ(先端DRAM) | 2.5M | 4.6M | 8.0M | 12.8M |
| =AIの最先端ウェハ(ロジック+HBM) | 2.9M | 5.2M | 9.1M | 14.4M |
| EUV装置能力に占める割合(ロジック+HBM) | 15% | 27% | 45% | 65% |
| 広義のリソグラフィ供給に占める割合(全ノード) | 9.3% | 16% | 27% | 40% |
| 割り当て可能なロジック供給(×使用率) | 20.9M | 22.0M | 23.2M | 24.4M |
| 非AIに回る残り | 20.6M | 21.4M | 22.1M | 22.8M |
出典:AIの予測とアクセラレータ1基あたりの部材構成
- AIのH100eの推移。§1.1のEUV制約下の解(設備投資総額 ÷ コスト効率 ÷ EUV割増)による。稼働中のH100eストック(1月1日時点)は8.6M · 22.4M · 57.1M · 135.2M → 2029年までに289.0M、年間生産量は14.2M · 35.7M · 80.6M · 159.7M。§1.2は§1.1のこのAI増強をそのまま受け取り、非AIの残り分だけをモデル化するので、両節は構成上必ず一致する。出典:§1.1(プランAの設備投資総額に基づく)。
- アクセラレータ1基あたりのHBM。H100=80GB、H200=141、MI300X=192、B200=192。販売数で加重すると2024年に約130GB→2030年に約600。×約750万基≈2024年のHBM約1EBで、TrendForceの業界推計と一致する。出典:NVIDIA/AMDのデータシート、 TrendForce.
- アクセラレータ1基あたりのシステムDRAMとストレージ。8GPUのノードは、約1〜2TBのホストDRAM(GPU1基あたり約150〜250GB)に加え、数TBのローカル+ネットワーク接続のNVMeを備える。2024年はアクセラレータ1基あたりDRAM約300GB、NAND約2TBとし(2030年までに約1TB/約6TBに増加)、汎用メモリではなくHBMがAIの最大のウェハ需要であり続ける規模に設定した。出典: NVIDIA DGX/HGX H100の仕様、ハイパースケーラーのリファレンス設計。
- 総量と生産量の扱い。AIの保有分は累積として扱う(5年未満のこの期間では退役を見込まない)。そのため各年1月1日の総量は生産量の累計になる。非AIの区分で使う積み上げ式の退役計算は行わず、総量をそのまま使う。各年のウェハ使用量を決めるのは生産量のほうだ。
この節の残りでは、この表の供給側の根拠、つまり各区分がリソグラフィの上限のどれだけを使うかを説明する。
この単純なモデルでは、EUVの使用率は2024年のわずか52%から2028年には約100%に達する。そのころにはEUVが実際の制約になると予想しているからだ。この数値は、稼働率と実現スループットをすでに別途考慮しており、どちらも2024年の比率で固定している。使用率が文字どおり100%に達するとは考えていないが、この近似で差し支えないと判断している。稼働率と実現スループット(理論上の最大スループットに対する割合)は2028年までにいくらか改善するはずで、その分がおおむね差を埋めるからだ。
| EUVパスの供給(M/年) | 2024 | 2028 |
|---|---|---|
| パス需要 | 45.3M | 182.5M |
| パス処理能力 | 87.1M | 182.5M |
| EUVの使用率 | 52% | 100% |
| 液浸(DUV)の使用率 | 20% | 25% |
使用率=パス需要÷パス処理能力。EUVも液浸も実効ベース(稼働率と処理能力で補正)なので、二つの使用率はそのまま比較できる。
ノードの構造:ウェハ1枚あたりのパス数とノード構成
| ノード | EUV/枚 | 193i/枚 | ウェハ枚数 2024年 | ウェハ枚数 2028年 |
|---|---|---|---|---|
| ロジックの層 | ||||
| 最先端 | 12→22 | 30 | 2.0M | 3.2M |
| DUV先端 | 2 | 33 | 2.0M | 5.2M |
| 成熟 | — | 6 | 16.4M | 16.0M |
| メモリの層 | ||||
| 先端DRAM | 4 | 12 | 4.2M | 20.7M |
| 成熟DRAM | — | 8 | 5.8M | 7.6M |
| NAND | — | 4 | 40.2M | 45.0M |
三つの層(最先端=N3以下/N5/N2、EUV使用。DUV先端=N7/N16。成熟=28nm/旧世代)。構成がN5→N3→N2へ移るにつれ、最先端のウェハ1枚あたりEUVパス数は12→22に増える。赤=EUVを使う層。この表は使用率の確認用で、計算資源や総量の計算には使わない。
ノード構成(2024年、区分別のウェハ面積の割合)
| 区分 | 最先端 | DUV先端 | 成熟 |
|---|---|---|---|
| スマートフォン | 53% | 27% | 20% |
| PC | 42% | 40% | 18% |
| ゲーミング | 55% | 45% | — |
| AI | 95% | 5.0% | — |
| 非AIサーバー | 50% | 42% | 8.0% |
| その他 | — | 5.0% | 95% |
AIはほぼすべて最先端プロセス。スマートフォン・PC・ゲーミングは最先端から成熟プロセスまでにまたがり、「その他」(MCU)はほぼすべて成熟プロセス。幅広いロジックの供給枠(2024年に29.5M枚)が非AIへの割り当ての元になる。
デバイス1台あたりのメモリとウェハ使用量
メモリのウェハ枚数=デバイス数×デバイス1台あたりのGB÷ウェハ1枚あたりのGB。HBMは使えるGBあたり約3倍のウェハ面積を要し(8〜12段のスタック、TSV、ベースのロジックダイ)、ほぼすべてがAIに回る。そのためAIアクセラレータのウェハ使用量は、ロジックよりメモリのほうが大きい。
| デバイス1台あたり(2024→2028年) | HBM | DRAM | NAND |
|---|---|---|---|
| スマートフォン | — | 8 → 13 GB | 200 → 333 GB |
| PC | — | 16 → 27 GB | 700 → 1033 GB |
| ゲーミング | — | 14 → 21 GB | — |
| AI | 130 → 400 GB | 300 → 767 GB | 2000 → 4667 GB |
| 非AIサーバー | — | 512 → 683 GB | 26000 → 36667 GB |
| その他 | — | 0.05 → 0.05 GB | 2 → 3 GB |
- ウェハ1枚あたりのGB(2024年):DRAM約2,800、NAND約21,000、HBM約900。いずれも2030年までに約1.7倍になる。2024年のDRAMウェハに占めるHBMの割合は約11%(TrendForceでは約14%)。出典: SEMI、TechInsights、TrendForce。
- 非AIサーバーの行にはデータセンターのストレージ層(SSDアレイ、ネットワーク接続のNVMe)を含めているので、NANDが大きい(サーバー換算で約26TB)。厳密にデバイス単位で数えると漏れる大容量ストレージもこれで取り込まれ、2024年の世界のNANDは約845EB(ウェハ約4,400万枚)となり、Trendfocusの推計と整合する。出典:TrendForce、Trendfocus、IDC/Omdia。
リソグラフィ供給の出典:ノードごとのEUV層数、保有台数、スループット、ノード構成
- ノードごとのEUV層数:N5/N4≈13〜14、N3E≈19、N3B≈25(ダブルパターニング)、N2≈23〜25。ダブルパターニングの層は露光が2回必要なので、パス数≥層数となる。最先端層は12→24(2024→2029年)と増えるものとしてモデル化した。出典: SemiAnalysis、WikiChip、TSMC。
- メモリのEUV:先端DRAM(1α/1β/1γ)はEUV層を約1〜6層使い、増えつつある。3D NANDは使わない。先端DRAMはウェハ1枚あたり約4 EUVパス、成熟DRAMとNANDは0としてモデル化した。出典:SK Hynix/Samsung/Micronの開示資料、TechInsights。
- EUV保有台数:ASMLの見通しに基づき、2024年までに約220台、2028年までに約457台。スループット:装置1台・1年あたり約36万の実効露光(仕様の約160枚/時を下回る)。出典: ASML.
- 液浸装置の保有台数:約1,330台(2024年)→約1,800台(2028年)。豊富にあるので、193iが制約になることはない。スループット:装置1台・1年あたり約95万の実効パス(公称の年約180万の約半分。EUVと同じ稼働率・処理能力の基準で割り引いた値)。ノード構成はウェハ面積の割合:Counterpointによれば2024年のスマートフォン向けSoCの出荷数の約43%が5nm以下で、ウェハ面積では約53%にあたる。出典:ASML/SEMI、Counterpoint、 TSMC.
1.2.3 結果
退役分を差し引いた生産量を累積すると、区分別の稼働中の総量が得られる。生のH100eを実効H100eに換算し直す(生のH100e×。 は付録で導く、資源を考慮したAIワークロードでの有用性モデル)。
実効H100eは、各区分の生の計算資源を有用性係数 Uで補正したもの(導出は 付録).
| 有用性 U | 2024 | 2026 | 2028 | 2029 |
|---|---|---|---|---|
| スマートフォン | 0.21 | 0.11 | 0.07 | 0.05 |
| PC | 0.35 | 0.08 | 0.04 | 0.03 |
| ゲーミング | 0.04 | 0.05 | 0.06 | 0.04 |
| AI | 1.16 | 1.06 | 1.04 | 1.02 |
| 非AIサーバー | 1.38 | 1.40 | 1.41 | 1.40 |
| その他 | 0.53 | 0.43 | 0.34 | 0.30 |
チップあたりの入力値と、上限をかける前のモデル出力
Uを決めるチップあたりの資源の入力値(区分別、2024年)。本格的な計算性能とHBM級の帯域幅、大きなNVLinkのコヒーレント領域を併せ持つのはAIアクセラレータだけだ。ほかの区分は実質的に単独のチップである(スケールアップ世界=1)。非AIサーバーはメモリが潤沢だが計算性能は小さく、消費者向けのチップは帯域幅が乏しくクラスタを組まない。「その他」(MCU/エッジ)はどの指標でもごく小さい。
| チップあたり(2024年) | H100e/チップ | メモリ帯域幅(TB/s) | メモリ(GB) | スケールアップ世界 |
|---|---|---|---|---|
| スマートフォン | 4.0e-3 | 0.032 | 7 | 1 |
| PC | 6.6e-3 | 0.085 | 12 | 1 |
| ゲーミング | 0.097 | 0.41 | 11 | 1 |
| AI | 1.15 | 4.7 | 126 | 160チップ |
| 非AIサーバー | 0.030 | 0.70 | 512 | 1 |
| その他 | 5.7e-5 | 0.006 | 0.1 | 1 |
予測期間を通じて、チップあたりのH100eは約1.5年ごとにおよそ2倍になる。一方、H100eあたりのメモリ帯域幅と容量は下がり(メモリの壁)、AIのNVLinkの世界は拡大する(NVL72→NVL576)。AIの保有ハードウェアの推移の全体は、§1.1の資源集約度のボックスにある。
非AIに1以下の上限をかける前のU
| 区分(補正前のU) | 2024 | 2026 | 2028 | 2029 |
|---|---|---|---|---|
| スマートフォン | 0.21 | 0.11 | 0.07 | 0.05 |
| PC | 0.35 | 0.08 | 0.04 | 0.03 |
| ゲーミング | 0.04 | 0.05 | 0.06 | 0.04 |
| AI | 1.16 | 1.06 | 1.04 | 1.02 |
| 非AIサーバー | 1.38 | 1.40 | 1.41 | 1.40 |
| その他 | 0.53 | 0.43 | 0.34 | 0.30 |
サーバーと「その他」(MCU/エッジ)が1を超えるのは、計算性能がごく小さいチップでは、FLOPあたりの比率がどれも潤沢に見えるからだ。ネットワークのペナルティはほぼ消え、値は計算性能の上限まで浮き上がる。非AIサーバーではこれはもっともらしく(実際にメモリの潤沢なマシンだ)、生のH100eに占める割合もごく小さい(約1〜2%)ので、補正前のUをそのまま使う。MCU/エッジの「その他」ではモデルの副産物にすぎないので、1以下に抑える。ただし「その他」は生の値では大きな割合を占める(約8〜23%)ので、1に抑えてもAIへの有用性をおそらく過大に見積もっている。
クラスタと単体デバイスの内訳。 計算資源はクラスタと単体デバイスにも分類する。非AIサーバーは非AI関連のクラスタ、スマートフォン、PC、ゲーミングGPU、組み込みチップは非AIの単体デバイスとして扱う。AI関連の計算資源は、ほぼすべてがデータセンターで動くアクセラレータ(AI関連クラスタ)だ。ただし、AI関連の単体デバイスのチップもわずかながら増えている。いまは無視できる量だが、データセンター級のGPUがデスクトップの形態に収まるようになるにつれて(NVIDIAのDGX Stationなど)後年に増えていく。
| 実効H100eの総量(1月1日時点) | 2020 | 2024 | 2026 | 2028 | 2029 |
|---|---|---|---|---|---|
| AI関連・クラスタ(AIデータセンター) | 101K (4.1%) | 3.6M (26%) | 23.7M (67%) | 140.8M (90%) | 295.2M (94%) |
| AI関連・単体デバイス(特化型の消費者向け) | 0 | 0 | 0 | 218K (0.1%) | 938K (0.3%) |
| 非AI・クラスタ(非AIサーバー) | 294K (12%) | 1.4M (10%) | 2.6M (7.5%) | 4.7M (3.0%) | 6.1M (1.9%) |
| 非AI・単体デバイス(消費者向け) | 2.1M (84%) | 8.7M (63%) | 9.1M (26%) | 11.5M (7.3%) | 12.6M (4.0%) |
AI関連の単体デバイス(特化型の消費者向け)の計算資源の予測方法
これは単独で使うAIワークステーションだ。高性能なGPU(帯域幅1TB/s以上、32GB以上、4,000 TPP以上)に100Gb/sのNICを組み合わせ、AI関連の四つの下限をすべて満たす。RTX PRO 6000級のGPUを載せたワークステーションから、NVIDIAのDGX Station(GB300を1基、約2.5 H100e)まで幅がある。DGX Spark(約0.5 H100e)のような安価な小型機は帯域幅の下限に届かず、一般的なゲーミングPCは100Gb/sのNICを備えていない。1台約1万〜10万ドルなので、販売台数はそれほど多くない。年間の販売台数と1台あたりのH100eを推計し、それを積み上げる。
| 出荷年 | 出荷台数 | H100e/台 | H100e追加量 | 稼働中(1月1日時点) |
|---|---|---|---|---|
| 2026 | 15K | 2.5 | 38K | 0 |
| 2027 | 60K | 3 | 180K | 38K |
| 2028 | 180K | 4 | 720K | 218K |
| 2029 | 450K | 5 | 2.3M | 938K |
「 稼働中(1月1日時点) 列は各年初めの累積ストックで、上の表の特化型消費者向けの行とちょうど一致する(2029.0時点で約938K H100e、AI全体の約0.3%、約255K台)。新しい区分なので、台数は大まかな推計にすぎない。
1.3 地域別の保有
この節では、§1.1のAI関連の計算資源について、世界の計算資源の地域別保有を予測する。保有は米国、中国、その他の世界の三つに分ける。中国の計算資源を別に予測することに重点を置くのが最も有益だと考える。中国は輸出規制によって世界の主要なサプライチェーンから切り離されているため、支出の割合からの大まかな推計では最も見積もりにくい地域だからだ。
そこで以下では、中国に流入する計算資源の供給源ごとに分けて、中国の計算資源を独立に予測する。そのうえで、世界全体のうち米国とその他の世界の内訳を大まかに推計する。中国の国内製造は、同じ(EUVを使う)サプライチェーンから来るものではないので、§1.1の世界の計算資源の総量予測とは別に扱い、§1.1の合計に後から加える。
1.3.1 中国の計算資源の予測
中国のAI計算資源は四つの供給源に分ける。三つは世界のサプライチェーンから来るもの(§1.1の世界全体にすでに含まれる)で、合法な輸入(輸出規制に適合するチップ。過去のH20や、現行の許可制度のもとでのH200など)、密輸されたチップ、抜け穴(パッケージング前に密輸されるチップのダイや、中国企業が国外に所有する、または国外から借りるデータセンター)だ。四つ目は国内で製造されるチップ(SMICの7nmロジック/CXMTのHBM/Ascend)である。中国の計算資源は2026〜2029年に約9倍に増えるが、世界全体の増強がそれを上回るため、世界に占める割合はなお約9%へ下がっていく。
観測データに合わせた2024〜2025年の基準値:
| 経路 | 2024 | 2025 | 根拠 |
|---|---|---|---|
| 国内 | 0.25M | 0.6M | SMICの7nm以下で製造するAscendとCambricon。一度きりの国外製HBMの備蓄(約1,300万スタック。大半はSamsung製の約1,140万で、910C約160万基分)と、TSMC製ダイ約290万個の「ダイバンク」を使う(SemiAnalysis)。910C 1基あたり約0.8生H100e |
| 合法 | 0.2M | 0.15M | 2024年は性能を抑えたH20が約100万基(1基あたり約0.2 H100e)。2025年は正味約0.15Mにとどまる。4月の禁輸前の第1四半期の出荷、7月からの一部再許可、中国政府による購入抑制のため |
| 抜け穴 | 0.25M | 0.45M | 中国企業が国外に所有する、または国外で借りるデータセンター。ここでの2024+2025年の累計(2025年末までに約0.7M)は、確認されている賃借の下限約67万以上(ByteDanceが約52万)をわずかに上回る |
| 密輸 | 0.16M | 0.48M | 禁輸対象部品の闇市場。Epochに準拠 |
2026〜2028年の予測
世界のサプライチェーンから来る三つの経路は、§1.1の世界全体の生産量に対する割合として予測する。
| 世界経由の経路 | 規則(§1.1の世界全体に対する割合) | 2026 | 2027 | 2028 |
|---|---|---|---|---|
| 密輸 | 約3.5%→2%(取り締まりの強化による) | 1.26M | 2.12M | 2.99M |
| 抜け穴 | 約2%(確認されている賃借の下限約1.5%+その他の経路) | 0.7M | 1.6M | 3.15M |
| 合法 | 約1% | 0.35M | 0.8M | 1.6M |
合法の経路は、この約1%という規則より2〜3倍多くてもおかしくない。現行の許可制度はすでにそれを上回る量をカバーしているが、中国側の輸入制限によって実際の出荷は押し下げられている。
国内生産はHBMに制約される。最近のSemiAnalysisのCXMTに関する記事を参照してほしい。
| 国内生産の積み上げ | 2026 | 2027 | 2028 |
|---|---|---|---|
| CXMTのHBM生産能力(kwspm=月間投入千枚) | 30 | 55 | 100 |
| 8段スタックの歩留まり(向上していく) | 25% | 31% | 37% |
| ウェハ1枚あたりの8段スタック良品数(総数約88×歩留まり) | 22 | 27 | 33 |
| → 年間の910C相当の良品数(kwspm×12k×スタック数/8) | 1.0M | 2.2M | 4.9M |
| 910C相当1基あたりの生H100e(ロジックとHBM3Eの改善) | 0.80 | 0.82 | 0.85 |
| → CXMT製メモリを使う生H100e | 0.8M | 1.8M | 4.2M |
| 上乗せ:密輸HBM+他社 | +30% | +25% | +20% |
| = 国内 | 1.1M | 2.3M | 5.0M |
これは楽観的な見積もりだ。CXMTのHBMの増産計画を額面どおりに受け取っている(SemiAnalysisのCXMTに関する記事は、2028年までに世界のHBMウェハ供給の約12%に達すると予測している)が、この増産は後半に偏っており(2026年の列はほぼゼロでもおかしくない)、同じファブで利益率の高い汎用DRAMとも競合する。
DUVの生産能力は豊富にある。 AscendのロジックもCXMTのメモリも、中国のArF液浸(DUV)装置で焼き付けられるが、ここでのAIチップの予測はその能力のごく一部しか使わない。
| DUV液浸装置 | 2026 | 2028 | 根拠 |
|---|---|---|---|
| 保有台数(台) | ~290 | ~400 | 基礎の約200台+2024年に購入したArFi約90台(大半はNXT:1980Fi級で275〜330枚/時。ASMLの129台の70%、50億〜70億ドル)。その後の輸入はオランダの規制で減速(AEI) |
| 実現生産能力(年間パス数) | ~520M | ~720M | 保有台数×装置1台あたり年約180万の実現パス(量産での1日約5,000〜6,000枚。公称約240万パスに対して。§1.1のEUVの約36万と比較) |
| Ascendのロジック | ~5M (~1%) | ~17M (~2%) | SMICの7nm以下の投入が月産約8千→2万8千枚×ウェハ1枚あたり約40〜60パス(SAQPの4重パターニング) |
| CXMTのHBM | ~4M (~1%) | ~12M (~2%) | CXMTのHBM投入が月産約3万→10万枚×ウェハ1枚あたり約10パス |
AIの使用量は2026年に装置能力の約2%、2028年に約4%で、実際の制約はHBMだ。中国がDUV装置をAIチップで埋め尽くすことはないと考える理由もここにある。それに見合うHBMがなければ、Ascendのロジックを増やしても使えるAI計算資源は増えない。SMICの7nm以下の投入量は、露光装置の空きではなく、マルチパターニングの歩留まりとコストで頭打ちになる。そして装置の大半は、中国が同じく支配を目指している成熟ノードの経済(自動車、産業機器、家電)に使ったほうが利益になる。
四つの経路の合計(生のH100e、単位M=100万):
| H100e(注記がなければ年間) | 2024 | 2025 | 2026 | 2027 | 2028 |
|---|---|---|---|---|---|
| 国内 | 0.25M | 0.6M | 1.1M | 2.3M | 5.0M |
| 西側からの合法輸入 | 0.2M | 0.15M | 0.35M | 0.8M | 1.6M |
| 抜け穴(国外データセンター/賃借) | 0.25M | 0.45M | 0.7M | 1.6M | 3.15M |
| 密輸 | 0.16M | 0.48M | 1.26M | 2.12M | 2.99M |
| 年間追加量の合計 | 0.9M | 1.7M | 3.4M | 6.8M | 12.7M |
| → 中国の総量(年末) | 1.3M | 2.9M | 6.3M | 13.2M | 25.9M |
| → 世界に占める中国の割合 | 14.7% | 13.1% | 11.1% | 9.7% | 9.0% |
1.3.2 結果
世界全体(§1.1)、中国の予測(§1.3.1)、残りを米国85%/その他の世界15%で分けた内訳を組み合わせると、地域別の保有が得られる。全期間を通じて米国が大半を保有し、中国は約15%から約9%へ下がる。
1.4 データセンターの規模
この節では、§1.1のAI計算資源が、ギガワット級の学習用キャンパスから小規模な地方拠点の長い裾野まで、データセンターの規模ごとにどう分布するかを予測する。手法は比較的単純(で不確か)だ。AI計算資源の総量予測(§1.1)を、データセンターの総数に割り振る。三つの集中度の基準値でデータセンター規模の曲線を当てはめ、その結果を米国、中国、その他の世界の保有(§1.3)に分ける。
データセンター規模のモデル
設定。 AI計算資源の総量 C(§1.1)と、データセンター数 N(2025年に約1,000拠点。既定では年30%で増え、2029年に約2,850拠点に達する)を用いる。そのうえで、規模の分布に基づいて各データセンターの規模を割り当てる。
基準値。 規模の分布の形を、三つの集中度の基準値で固定する。上位1、10、100のクラスタが全計算資源に占める割合 で、それぞれおよそ4%、20%、70%と予測する(手で設定した値で、Epochのデータセンターのデータセットから上方修正した)。これらは時間を通じて一定とする。
当てはめ。 次に、規模の対数を順位の対数の3次式としてモデル化する。係数は の四つだ。
この四つの係数は、三つの基準値と総量という四つの式によって厳密に決まる(順位の対数の3次式は自由度が4で、四つの制約と一致するので、自由パラメータを残さずに曲線が完全に決まる)。
一つ目はすぐに解ける。 なので となる。残りの三つは数値的に解く。これで、N、C、三つの基準値だけから、すべてのデータセンターの規模 が求まる。
地域。 曲線を米国、中国、その他の世界に分けるため、各地域が全計算資源に占める保有割合 を予測し(目標値は )、その割合に比例して各データセンターを地域に割り当てる。オプションの傾き を使えば、地域の総量を保ったまま、その地域を小規模な拠点寄り、あるいは大規模な拠点寄りに傾けられる(最大級のクラスタの規模が異なることが分かっている地域、たとえば中国に合わせるため)。ただし既定では無効()で、各地域は世界の曲線を同じ形のまま切り分けたものになる。
既定のパラメータ。
| パラメータ | 既定値 | 制御する対象 |
|---|---|---|
| (2025年の拠点数) | 1,000 | 2025年のデータセンター数 |
| 成長率 | 30% / 年 | データセンター数の伸び(→2029年に約2,850拠点) |
| 4% | 最大のクラスタ1つが占める計算資源の割合 | |
| 20% | 上位10が占める割合 | |
| 70% | 上位100が占める割合 | |
| 傾き | 0(無効) | 地域ごとの規模の傾き(任意)。0=比例 |
これらの集中度の割合は手で選んだ不確かな値で、Epochの現在の観測データセットから上方修正している。このデータセットはフロンティアのクラスタを網羅していないと想定したためだ(2025年末時点で、追跡している最大級の拠点は世界のAI計算資源の約15%しかカバーしていない)。
第2部 協定後の計算資源(2029年以降)
この部では、プランAが実行された後に何が起きるかを予測する。あわせて、プランAがなかった場合の既定の反実仮想を1年分示す。
2.1 協定がなかった場合の反実仮想
既定の(協定のない)経路をもう1年予測するため、§1.1の手法(中国の国内追加分については§1.3の手法)を2029年末の稼働中の総量まで延長する。プランAのもとでは、研究開発の一時停止と、協定の実施に伴う全般的な不確実性によって、設備投資が一時的に落ち込むと予想する。これを近似するため、プランAのもとでは増強のうち負債で賄う部分がゼロに落ち込み、現金による設備投資はトレンドどおりに続くものとする。推論のみの検証が迅速に実施され、推論計算資源の配分が増えることから、AI収益の予測は既定の反実仮想と同じ水準にとどまると見ている。
全体として、協定がうまく実施されれば、研究開発の再開が認められるという確信を企業に与えられると考える。実現済みの能力の水準と、研究開発再開後も続く改善(減速はするが、なお速いペースになる)を考えれば、AIへの投資は依然として経済的に極めて魅力的だと予想する。透明性が高まってもこの見立ては変わらない。アルゴリズム上の参入障壁(モート)がなければ、経済的価値は計算資源の所有者に集まる(所有者はそれゆえ、最良のモデルを最初に学習させ、最も広い利用者層に提供する立場にとどまりうる)からだ。
2.2 協定後のAI関連計算資源
プランAがさらに進むと、計算資源の伸びについての不確実性は増す。とくにAIとロボットがハードウェアの研究開発と生産を自動化できるようになり、これまで人間に制約されていた労働力を劇的に増やすようになると、不確実性は大きくなる。この不確実性を踏まえ、比較的単純なモデル(ジョーンズ型の研究開発とライトの法則による学習)を使うのが妥当だと考える。このモデルは§1.1の計算資源の経路を出発点とし、2040年まで延長する。ハードウェアの研究開発と生産にAIとロボットを制約なく投入すれば、既定ではハードウェアの爆発的増加が起きると予想する。そうなれば情勢が不安定になる(とりわけ、協定からの離反が容易になり、協定内での検証の負担も増す)。そのためプランAでは、キャップ・アンド・トレード制度によってハードウェアの爆発的増加を減速させ、制御可能な(それでも劇的に増えた)ハードウェアの水準に抑える。
ハードウェアが急速に伸びると予想する理由。 計算資源1単位あたりのコストを下げる力は、二つに分けて考えられる。
-
設計の改良(ジョーンズのモデルで扱う)。 チップのレイアウト、メモリ設計、トランジスタ密度、パッケージングなどの改良によって、AIチップの生産量を一定としたまま、得られる計算資源を増やせる。これは研究開発なので、投入される労働量でモデル化できる。ただし、易しいアイデアが使い尽くされるにつれて収穫は逓減し(Jones 1995、Bloom et al. 2020で較正)、同じ時点で並列に投入する労働を増やしても収穫は逓減する。過去の「ウェハ1枚あたりの計算資源」の向上がこれにあたると考えてほしい(プロセスの微細化もこれに含める。微細化は生産規模ではなく、チップと製造装置の研究から生まれるので、設計の研究開発に分類する)。現在、半導体業界で働く人はおよそ200万人いる。私たちの予測では、2030年代初めまでに、チップと製造装置の研究開発に投入される人間、AI、ロボットの労力の合計は、その約100倍になる。それでも、このモデルのパラメータのもとでは、「ムーアの法則」の進歩は約1.1倍しか加速しない。
-
生産規模の拡大(ライト)。 計算資源の単位をひたすら大量に製造することで、「習熟による」効率改善が生じうる。歩留まり、スループット、稼働率の向上や規模の経済などだ。過去の「1ドルあたりのウェハ枚数」の改善がこれにあたると考えてほしい。累積生産量が2倍になるごとに単位コストが約15%下がるとモデル化する(半導体や太陽光発電の長期的な学習率と同程度)。ファブの建設と運営をAIとロボットが自動化すればこのトレンドが加速するのかは分からないが、少なくとも、こうした規模の利益が設計の改良とは別に続くというのは妥当なベースラインだと考えている。
計算資源1単位あたりのコスト(ドル/H100e)は、(生産単位あたりの計算資源)と(1ドルあたりの生産単位数)という二つの要素の積として扱う。生産単位はこれまで「ウェハ」だったが、将来のパラダイムでは変わるかもしれない。どちらの要素も2025年を1に正規化し、それ以降は下がっていく。§1.1の終点を出発点として、この二つのモデルを2040年まで先へ進める。
ジョーンズ型とライトの法則によるコストモデル
AI計算資源1単位あたりのコストは、2025年の基準値に、どちらも1から始まって時間とともに下がる二つの指数を掛けたものだ。製造の指数 と設計の指数 である。
ライトの法則(製造)。 コストは累積生産量とともに下がる。古典的な学習曲線である。
したがって累積生産量が2倍になるごとに、製造コストは だけ下がる。、つまり倍増ごとに約16%とする。半導体の長期的な学習率と同程度だ(太陽光発電のスワンソンの法則にも近い)。
ジョーンズ型の設計研究開発。 設計コストの年間低下率は、研究開発に投入される労働が増えるほど大きくなるが、収穫は逓減する。
ここで は人間とAIを合わせた知的労働量(配備された計算資源とともに増える)で、私たちの経済モデルの「実効労働」の量から取る。実効労働は、AI/ロボットの労働量と、その能力(自動化できるタスクの割合)を組み合わせたものだ。 は基本のペース、 は「足の踏み合い」効果の補正である(Bloom et al. 2020)。研究者を100倍に増やしても、進歩は100倍よりはるかに小さくしか速まらない。
| パラメータ | AIチップ |
|---|---|
| ライトの学習率 | 0.25(倍増ごとに約16%) |
| ジョーンズの基本率 | 年25% |
| ジョーンズの足の踏み合い | 0.05 |
| 2025年の製造コスト | 5,000ドル / H100e |
| 2025年の累積生産量 | 2,000万 H100e |
基本率(年25%)は、年約1.35倍という計算資源の効率向上のトレンドに合わせたものだ。 は足の踏み合い効果を強く効かせる設定で、AIの研究者を100倍に増やしても設計の進歩率は約1.3倍にしかならない。そのため、AIの労働力が膨れ上がっても、チップ設計はそれほど加速しない。上の基準値はチップを製造するコスト(限界生産費用。2025年に約5,000ドル)で、コストの図が追っているのはこの値だ。マークアップとデータセンター、電力を加えると総費用は約3万3,000ドルになり、投資額の図が数えているのはこちらの値である。どちらも同じ の曲線に沿って下がる。以下では、プランAの二つの制約、すなわち計算資源の上限と研究開発の管理があるときとないときで、このループを回してみる。
プランAでは、ハードウェアの爆発的増加に二つの歯止めがかかる。 歯止めがなければ、協定の安定性(離反の容易さと検証の負担)にとって進歩が大きすぎる。計算資源が増えるとハードウェアの研究開発と生産が進み、それがさらに計算資源を増やし、ハードウェアを安くするというフィードバックループがある。プランAの二つの制約は、このループの異なる部分に作用する。生産量の上限(2032年以降のキャップ・アンド・トレード政策)と、研究開発への投入の制限(量に上限を設けても、計算資源の製造があまりに容易で安くなるのを防ぐため)だ。
各シナリオの前提
三つのシナリオはいずれも、上限が効き始める(約2034年)まではプランAの計算資源の経路に従い、その後は二つのレバーで分かれる。
-
計算資源の上限(キャップ・アンド・トレード、2032年以降)。有効:稼働中の計算資源はプランAの政策経路に固定され、2040年までに約1兆H100eになる。無効:制約のない再投資ループが量を決め、歯止めなく増えていく。
-
ハードウェアの研究開発。 管理下:チップ設計の進歩を年約10%に抑える。これは2010年以降のトランジスタあたりコストの改善ペースにほぼ等しい(年約25%というAI計算資源の効率向上トレンドを大きく下回る)。制約なし:ハードウェア研究開発の実効労働は経済モデルの実効AI労働(能力×量)そのものになり、設計コストの低下もそれに伴って加速する(基本率は年25%、足の踏み合いは 、上限は年60%)。
| シナリオ | 計算資源の上限 | ハードウェア研究開発 | 何が起きるか |
|---|---|---|---|
| プランA | 有効、2040年までに約1兆 | 管理下 | 本資料のほかの部分で使う、抑制された経路 |
| 上限なし、ハードウェア研究開発は管理下 | 無効 | 管理下 | 量が爆発的に増え、上限の数千倍に達する |
| 上限なし+ハードウェア研究開発も制約なし | 無効 | 制約なし | 量もコストも歯止めがきかず、グラフの外に出る |
実効労働はどのシナリオでも同じ系列である(経済モデルのA_effで、能力×量を、そのシナリオの計算資源で調整したもの)。研究開発の管理が作用するのは、そのうちどれだけが設計の進歩に変わるかであって、労働の総量ではない。
| ハードウェア研究開発 | 2040年の実効AI労働(HE=人間換算) | 設計コストの低下 |
|---|---|---|
| 管理下(プランA) | 約4,000億HE | 年約10%。2010年以降のトランジスタあたりコストのペースに抑える |
| 管理下(上限なし) | 約2x10^15 HE | 年約10%。労働力が桁違いに大きくても、なお抑えられる |
| 制約なし(両方) | 約2x10^21 HE | 年25%から、上限の年60%まで上がる |
制約なしの率は、経済モデルのジョーンズの式そのものだ(年25%×(A_effの伸び)^0.05、)。管理下の上限は、プランAの研究開発管理政策を上に重ねたもので、基本の経済モデル自体はこの制約を課していない。
実効労働のうちどれだけが研究開発に回るか? 実効労働の一定の割合とする。効くのはその伸びだけなので割合は相殺され、特定の割合を決める必要はない。この実効労働は経済モデルの実効AI労働(A_eff、能力×量)を、各シナリオのプランAに対する計算資源の比で調整したものなので、研究開発の進歩は能力の向上と量の増加の両方に反応する。ロボットは、プランAのキャップ・アンド・トレードの固定経路に置いたままで、これらのシナリオ間で変えていない。
供給側への含意と妥当性の確認
プランAで既定のままなら可能になる計算資源の生産量は、比較的単純にモデル化している。キャップ・アンド・トレードの軌道は、ほかの制約(検証と協定の安定性)のため、それよりかなり低く設定されている。このボックスでは、キャップ・アンド・トレードの軌道が実現可能であることを、供給側にとっての含意を示して裏付ける。具体的には、それに必要なリソグラフィを過去の伸びと比べる。
方法。 プランAの年間生産量(年間の新規H100e。2040年までに年約5,700億H100eに増える)をシリコンウェハに換算し(このパラダイムが続くと仮定)、ウェハを必要なリソグラフィの露光パス数に換算する。それをリソグラフィ装置1台のスループット(装置1台・1年あたりの実現パス数)で割って、必要な装置年数を求める。
既定のリソグラフィ装置。 2029年(§1.1から、H100eあたりEUV約0.7パス)を基準とし、過去の経路どおりに推移するリソグラフィ装置の保有台数(2029年に稼働中の装置約620台で、年約20%増加。ASMLは現在年約125台を出荷している)と比較する。装置のスループットも、過去の1時間あたりウェハ処理枚数の伸び(2019〜2024年におよそ125枚から220枚)に合わせ、年約10%上がるとした。
既定の計算密度。 ウェハ1枚あたりのH100eは、これまで年約35%で増えてきた。以下では、それが既定のトレンドと比べてどれだけのリソグラフィの増強を必要とするかについて、三つの可能性を見る。
| ウェハ1枚あたりの計算資源の伸び | 年0%(2029年の技術で固定) | 年35%(技術トレンドが継続) | 年50%(技術トレンドが加速) |
|---|---|---|---|
| 2040年までに必要なリソグラフィ装置 | 約110万台 | 約1万4,000台 | 約4,400台 |
| 装置の過去のトレンド(2040年に約4,300台)との比較 | 約255倍 | 約3倍 | 約1倍 |
| 必要な年間生産台数と現在(年約125台)との比較 | 約4,400倍 | 約29倍 | 約6倍 |
プランAで実際に起きるのは、中央の列に近いものだと予想している。
プランAの増強を金額で表して、それが必要とする投資額を確かめることもできる。各年の投資額は、その年に追加される計算資源に、H100eあたりの総費用を掛けたものだ。総費用は、上のモデルの生産コストに、AI設備投資の1ドルで買うそれ以外のすべて(チップメーカーの利益、データセンター、電力、ネットワーク)を含めるマークアップを掛けて求める。マークアップは、2025〜2028年が第1部の設備投資予測(2028年に約2.4兆ドル)を、2029年が§2.1の協定の年をちょうど再現するように較正した。その結果、約7〜8倍になる。最善の推測としては、マークアップはその後2040年までに約1.2倍へ下がる。ロボットが建設するファブやデータセンターはハードウェアを生産コストに近い価格で売るはずであり、H100eあたりの電力とデータセンターの費用の割合も、下で述べる効率の向上によって縮むからだ。
上限のない経路については非常に不確かだが、制約のない既定の経路は、上限を課した経路より何桁も大きくなる可能性が高いと考えている。AIとロボットがハードウェアの研究開発とチップ生産をこなせるようになれば、そこに投入できる実効労働は桁外れに増える。ジョーンズ型とライトの法則による学習曲線を重ねた動態は、それがどうなりうるかを単純に近似したものとして妥当だと考えている。
歴史的に、チップ設計の改良は電力効率の改善と密接に結びついてきた。そこで計算資源の電力効率も、上のコストモデルと同じジョーンズ型の設計トレンドでモデル化する。パラメータも同じ(基本率は年25%、足の踏み合いは )で、プランAの制約された研究開発ペースを用いる。すると次の軌道になる(なお、Epochが推計するCMOSトランジスタの理論限界は超えない)。
2.3 企業への集中
この節では、計算資源が企業間でどう分布していくかの予測を示す。追跡するのはAI企業のエンドユーザー(計算資源を実際に使う企業)であり、所有者(自ら使うか、他社に貸し出す企業)ではない。初期には、計算資源の大半が集中的にハイパースケーラーに所有されている(Googleが計算資源の約25%を所有する)。しかしAI企業のエンドユーザーはそれほど集中しておらず、2026年に最大の企業が使うのは世界の計算資源の約10%だ(GDMとOpenAIが同程度)。
AI企業が使う割合は時間とともに増えてきた。プランAが実施されるまでは、このトレンドをそのまま先へ延ばす。2030年以降は、プランAの透明性の制度によって参入障壁が下がる。AIへの投資は増えながらより均等に広がり、計算資源はより多くの企業に分散していく。2040年には、最大の企業でも世界の計算資源の約5%しか持たず、フロンティア企業(最大の企業の4分の1以上の規模を持つ企業と定義する)は約20社になる。
企業ごとの計算資源の集中度を求める方法
手法は比較的単純だ。分布の形について、世界全体に一つの順位・規模法則を置き、予測に合うよう手で設定する。そのうえで、§1.3の内訳に合うよう企業を保有地域に割り当てる。世界全体で 社のエンドユーザーがいるとき、順位 の企業の割合は
で、割合の合計が1になるよう正規化する( は順位 の標準正規分位点)。形のパラメータは二つある。 は全体の広がり(集中度で、上位3社を左右する)を決め、 は で減衰する先頭の傾きで、裾野への影響を抑えつつ、首位の1社を2位・3位に対して動かす。
世界のエンドユーザーの上位1社と上位3社の割合を毎年直接選び、分布がその両方を再現するよう を解く。首位は初期には少数派で(フロンティアAI企業はまだAI計算資源の大半を使っていない)、2029年の協定に向けて世界の計算資源の約5分の1まで上昇し、上位3社で半分近くを占める。その後はプランAが計算資源を分散させるため、どちらも下がる(上位1社は2035年までに約10%、2040年までに5%。上位3社は約25%、その後13%)。この予測をよりしっかり正当化するのは今後の課題だ。AI計算資源に対する「AI市場での力」/「支払意思」のモデルを作りたかった。アルゴリズムの知的財産(協定後は均等に行き渡る)、アルゴリズム以外の知的財産や資本(データセット、ユーザー、ブランドへの忠誠、人材の定着など)、そしてより広い意味での資本を組み合わせた量として定義し、それを追跡して計算資源の配分の推移をモデル化するというものだ。しかし複雑で、時間が足りなかった。
次に、各企業を上限付きの貪欲法による割り当てで保有地域(米国、中国、その他の世界)に振り分ける。その結果、地域ごとの合計は、2029年までは毎年§1.3の保有の内訳と厳密に一致し、その後は、キャップ・アンド・トレード協定の割当へ収束していくプランAの保有の内訳と一致する。地域ごとの規模の偏りは、その地域がどの企業を持つかだけを変え、総量は決して変えない。米国は中立で、最大の開発企業を抱える。中国は2030年までは平坦で分散しているが、2031年に国家が後押しする中核が統合され(首位の開発企業が中国の計算資源の約半分まで跳ね上がり、フロンティアの開発企業が一つ生まれる)、その後2040年までに再び徐々に平坦になる。その他の世界はより平坦で、終盤にかけてさらに平坦になる。そのため、その他の世界の保有割合が米国を上回った後も、世界最大の開発企業は米国にとどまる。
2030年まで(協定の時代)は、世界のエンドユーザーの上位3社をフロンティアの集合とする(米国の主要な開発企業の名前を、年ごとに手で設定した順序で挙げる)。2031年以降は企業名を出さず、世界最大のエンドユーザーの4分の1以上の規模を持つエンドユーザーをフロンティアとみなす。
| パラメータ | 値 | 役割 |
|---|---|---|
| 世界のエンドユーザーの母数() | 200 | 順位・規模法則の企業数 |
| 上位1社のエンドユーザーの割合(2026 / 2029 / 2035 / 2040) | 8% / 20% / 10% / 5% | 手で設定。 を解いて一致させる |
| 上位3社のエンドユーザーの割合(2026 / 2029 / 2035 / 2040) | 23% / 45% / 25% / 13% | 上位1社とは独立に手で設定 |
| 2040年の§1.3の保有の内訳(米国 / 中国 / その他の世界) | 35% / 20% / 45% | 地域ごとの合計を毎年厳密に一致させる |
| 中国の規模の偏り | 平坦、2031年に+5、2039年までに+2へ緩和 | 初期は分散、2031年に統合、2040年までに平坦化 |
| その他の世界の規模の偏り | −0.6、2039年までに−2.5 | 終盤にかけて平坦化し、最大の開発企業は米国にとどまる |
| フロンティアの規則 | 上位3社(2030年以前)/4分の1以上(2031年以降) | 協定の時代は上位3社の名前を挙げ、その後は最大の企業の4分の1以上 |
2.4 計算資源の配分
この節では、プランAにおけるフロンティアAIの計算資源の配分を予測する。2025年、OpenAIは計算資源の約半分を推論に使い、2024年には3分の1程度を推論に使った。残りは学習と実験で、そのうちフロンティアモデルの最終的な学習実行に使われたのは約10%にすぎない。2029年の協定までは現在の配分を単純に先へ延ばし、その後はプランAを前提として各割合を予測する。
2.5 AIのコピー数と速度
この節では、フロンティアモデルのコピーを同時にいくつ動かせるか、そして1秒あたり何トークンの速度で動かせるかを予測する。どちらも不完全な指標だ。将来、さまざまなスキャフォールドやアーキテクチャのもとで「コピー」をどう数えるべきかは分かりにくいかもしれない。ここでは、提供されているモデルの重みの並列インスタンスをそれぞれ1コピーとみなす。つまりコピー数=レプリカ数×バッチサイズである。速度も不完全だ。本当に気にすべきはおそらくタスクを完了する速さだが、ここではデコードの1秒あたりトークン数だけに注目する。将来のパラダイムの変化、たとえば思考の連鎖に代わるニューラリーズ(neuralese)の登場によって、トークン単位での速度比較が成り立たなくなるおそれはあるが、それでもこの指標を使う。
最初に断っておくと、これらの予測は具体的な最善の推測であり、正直に言って不確実性は何桁にも及ぶと考えている。AIのパラダイム(アーキテクチャ、スパース性、エージェントのスキャフォールド、「コピー」という捉え方がそもそも適切か)も、ハードウェアのパラダイム(チップのメモリと帯域幅のトレードオフ、シリコンのどれだけが推論に特化されるか)も、2040年までに何度も変わりうる。手法自体は単純で、率直に述べておきたい。フロンティアモデルの規模を推測し、世界の計算資源のうち推論に使われる割合を推測する。そのうえで、推論用ハードウェア全体のメモリを、コピー1つが占めるバイト数で割ってコピー数を求める。速度は、各トークンに必要なバイトをメモリ帯域幅がどれだけ速く読み出せるかから求める。この節の残りでは、それぞれの推測をどう立てたかを説明する。
モデルの規模。 前の節までの世界の計算資源の伸びに、首位企業の集中度(§2.3)と学習への配分(§2.4)を組み合わせて、フロンティアの学習計算量の推移を求める(2029年には現在の約32倍、2040年には16万倍)。次に、これらの計算量とスパース性の予測を、単純なモデルでモデルの規模(総パラメータ数)に換算する。
ここで は総パラメータ数(T が現在の水準)、 はフロンティアの学習計算量、 はスパース性である。計算量の指数 は、計算量の拡大に対してモデルの規模がどれだけ拡大するかの感応度だ。単純なChinchilla最適性からは約0.5になるが、不確実性は大きい。これが大きくなる理由としては、たとえばデータの入手可能性(ネソフ(Nesov)自身の計算量とスパース性の数値にこの式を当てはめると になる)や、重みを盗みにくくするためなどの意図的な学習不足が考えられる。逆に小さくなる理由もある。提供コストを下げるための過剰学習の増加(Sardana and Frankle)、強化学習、パラダイムの変化にまつわるその他の未知の要因などだ。ここでは単純に とし、もっともらしいと考える範囲として を図に帯で示す。スパース性の指数 は、暫定的ながらより確かに定まっている(ただし、スパースなMoEのパラダイムは変わるかもしれない)。
スパース性の前提はコピー数と速度に大きく影響しうるので、含めておく価値があると考えている。
合計=10T×(計算資源の伸び)α ×(スパース性の伸び)β(α = 0.5、β = 0.74)。
| 年 | 10T×計算資源α | ×スパース性β | =本推計(合計) | α ∈ [0.2, 0.8] | Nesov |
|---|---|---|---|---|---|
| 2026 | 10T | x1.0 (8x) | 10T | 10T〜10T | 10T |
| 2027 | 20T | x1.7 (16x) | 33T | 22T〜49T | 30T |
| 2028 | 35T | x2.8 (32x) | 97T | 46T〜205T | 240T |
| 2029 | 57T | x2.8 (32x) | 158T | 56T〜449T | 650T |
| 2030 | 83T | x3.1 (37x) | 255T | 72T〜904T | — |
| 2032 | 229T | x3.8 (48x) | 862T | 132T〜5,638T | — |
| 2035 | 1,411T | x4.7 (64x) | 6,576T | 337T〜128,155T | — |
| 2040 | 3,992T | x7.8 (128x) | 31,063T | 854T〜1,129,715T | — |
ネソフの数値との違い
ネソフが650Tを得る方法: ネソフの予測も私たちの予測も学習計算量から出発する。主な違いは、ネソフの2029年のフロンティアの学習実行が2倍大きく、30倍のスパース性を仮定した8e28 FLOPである点だ。30倍のスパース性では、計算最適な比率はアクティブパラメータ1つあたり240トークンになる(スパースMoEのスケーリング論文による)ので、8e28 FLOPなら約1,800Tトークンで7.4Tのアクティブパラメータが望ましい。しかしネソフは、固有のデータは約200Tトークンしか存在しないと仮定しており、8.5倍の不足が生じる。これをデータ制約下のスケーリングの結果で配分し、おおよそ 2.9倍のアクティブパラメータ(7.4T→22T)と2.9エポックの反復を得ている。私たちはネソフと同じ低データ領域の調整はしない。強化学習の増加、学習パラダイムの変化、合成データの生成など、逆方向に働きうる要因が複数あると考えるからだ。どちらの方向にも働きうるこれらの要因の不確実性を踏まえ、より単純な素朴なベースラインを使うほうを選んだ。
出典: 「Model size scaling in 2023–2031」.
| 年 | 事前学習の計算量(FLOP) | スパース性 | アクティブパラメータ数 | 総パラメータ数 | データ不足 | エポック数 |
|---|---|---|---|---|---|---|
| 2026 | 1.3e27 | 8x | 1.3T | 10T | — | 1 |
| 2027 | 6e27 | 8x | 2.9T | 30T | 1.75x | 1.3 |
| 2028 | 2e28 | 30x | 7.9T | 240T | 4.5x | 2.1 |
| 2029 | 8e28 | 30x | 22T | 650T | 8.5x | 2.9 |
| 2030 | 1e29 | 30x | 26T | 790T | 10x | 3.1 |
| 2031 | 2.2e29 | 30x | 48T | 1,400T | 15x | 3.9 |
推論用の計算資源。 §2.4の、世界の計算資源に占める推論の割合(一般向け+社内)を取り、H100eあたりのメモリと帯域幅の比率(§1.1)を2029年以降は横ばいとする。この計算資源を、通常の汎用チップと推論特化チップに分ける。この配分は手で設定したシナリオで、下で説明する。
コピー数。 推論用ハードウェア全体のメモリを、コピー1つが占めるバイト数で割ってコピー数を求める。各コピーには、モデルの重みの分担分(重み一式は現在4ビットで約5TB、2040年には私たちの中央推計のモデル規模で約15PBになる。同じバッチで提供されるコピー間で共有される)と、各コピー固有のコンテキストが必要になる。本文ではバッチサイズとKVキャッシュをモデル化する代わりに、両者を合わせた効果だけを述べる。汎用の推論メモリのうちコンテキストが占める割合は、現在はおよそ半分で、2040年には約5%に下がると仮定する。重みの伸びが、各コピーのコンテキストの伸びよりはるかに速いためだ(詳細は方法のボックスにある。バッチの仮定はコンテキスト長の仮定とトレードオフになるだけで、任意に決めたものだ)。これで、現在のコピー数は約3,000万になる。コピー数は最初わずかに落ち込む。スパース性が一気に上がってモデルが推論用ハードウェアより速く大きくなるためだ。その後、2040年にはごく大まかに言って約2億に達する。大半のコピーは汎用ハードウェア上で動き、残りは下で説明する推論特化チップ上の、はるかに速いコピーだ。
| 年 | 平均コンテキスト長 | KV/コピー | コンテキスト/レプリカ | 重み/レプリカ | コンテキストの割合 |
|---|---|---|---|---|---|
| 2026 | 200k | 20 GB | 5.1 TB | 5.0 TB | 51% |
| 2029 | 341k | 68 GB | 17.4 TB | 79.2 TB | 18% |
| 2032 | 580k | 220 GB | 56.3 TB | 430.9 TB | 12% |
| 2035 | 988k | 896 GB | 229.3 TB | 3.3 PB | 7% |
| 2040 | 2.4M | 3.3 TB | 856.1 TB | 15.5 PB | 5% |
節目の年のモデル規模、コピー数、速度(プランA)。
| 年 | モデル(総数/アクティブ) | コピー数(汎用/推論特化) | 全コピー | 速度(汎用/推論特化) | 平均速度 | 総tok/s(汎用/推論特化) |
|---|---|---|---|---|---|---|
| 2026 | 10T / 1.3T | 30.3M / 8k | 30.3M | ~57 / ~1.0k | ~57 | 1.7B / 7.9M |
| 2028 | 97T / 3.0T | 23.4M / 60k | 23.5M | ~65 / ~1.3k | ~68 | 1.5B / 78.6M |
| 2029 | 158T / 4.9T | 28.9M / 123k | 29.0M | ~67 / ~1.5k | ~73 | 1.9B / 185M |
| 2032 | 862T / 18T | 63.1M / 1.6M | 64.6M | ~89 / ~3.0k | ~161 | 5.6B / 4.7B |
| 2035 | 6,576T / 103T | 154M / 21.7M | 176M | ~119 / ~6.0k | ~844 | 18B / 130B |
| 2040 | 31,063T / 243T | 150M / 36.2M | 186M | ~192 / ~25.0k | ~5.0k | 29B / 904B |
速度。 速度についてはメモリ帯域幅を見る。汎用ハードウェアでは、デコードの各ステップで、重みに加えてバッチ内の全コピーのコンテキストを読み出さなければならない。したがって各コピーが1秒あたりに得るトークン数は、ハードウェアが自分のメモリを1秒間に何回読み通せるかに等しい。推論用ハードウェアのメモリ帯域幅はメモリ容量の約31倍なので、1秒あたり約31回の全読み出しになる。投機的デコードによる約2倍の上乗せと約90%の使用率を考慮すると、コピー1つあたり約57トークン/秒だ。都合のよいことに、この推測はバッチ、コンテキスト、モデルの規模、スパース性に左右されない。メモリのフットプリントが大きくなれば、それに比例してメモリ帯域幅も増えるからだ。すると速度は、H100eあたりの帯域幅がH100eあたりのメモリ容量を上回るペースでしか伸びない。このペースは2029年以降年約10%と仮定し、2040年には約190トークン/秒に達する。
推論特化チップ。 最大の不確定要素は、特定のモデルの提供に特化したチップだ。重みをオンチップのSRAMに保持するもの(CerebrasやGroqの方式)、Transformerアーキテクチャそのものをシリコンに焼き込むもの(Etchedの方式)、重みを直接ダイに作り込むもの(Taalasの方式)がある。ここではすべての段階が推測だ。新たに生産される計算資源のうちこれらのチップが占める割合を手で設定した(2026年に0.2%、協定時に1%、2040年までに14%で、そのころには合計で推論用ハードウェアの計算資源のおよそ半分になる)。各コピーを提供する速度も手で設定した(現在は約1,000トークン/秒。CerebrasがLlama-405Bで実測した969トークン/秒を基準とする。2035年の一時停止でフロンティアモデルが固定され、遅延の下限近くまで詰めたチップを設計する価値が生まれると、2040年までに約2万5,000トークン/秒に上がる)。各コピーを速く動かせば、その分だけ直接コピー数が減る(コピー数=トークンの総スループット/各コピーの速度)。そのためこれらのチップが増やすコピー数は比較的少ない。しかしこの仮定のもとでは、2040年までにトークンのほぼすべてを生み出すようになり、平均速度を現在の約100トークン/秒からごく大まかに5,000トークン/秒まで引き上げる。上の図の速度の伸びの大半はこれによるものだ。これらのチップが普及しなければ、平均速度は汎用の約190トークン/秒の経路付近にとどまる。下の表は、推論用ハードウェアの各部分が、その計算性能と帯域幅を実際にどれだけ使っているかを示す。
各チップ種別の帯域幅と計算性能のうち、デコードが使う割合。制約になる(上限の低い)資源がスループットを決める。
| 年 | 汎用:帯域幅 | 汎用:計算性能 | 推論特化:帯域幅 | 推論特化:計算性能 |
|---|---|---|---|---|
| 2026 | 90%(制約) | 9.4% | 90%(制約) | 18% |
| 2029 | 90%(制約) | 3.3% | 90%(制約) | 21% |
| 2032 | 90%(制約) | 3.2% | 90%(制約) | 40% |
| 2035 | 90%(制約) | 3.3% | 73% | 90%(制約) |
| 2040 | 90%(制約) | 2.7% | 23% | 90%(制約) |
AIのコピー数と速度を求める方法
フロンティアモデルは、スパース性 のもとで総パラメータ 、アクティブパラメータ を持ち、4ビット( バイト/パラメータ)で提供される。したがって1レプリカは バイトの重みを保持し、1トークンあたり FLOPを要する( バイトを読み出す)。
モデルの規模。 。ここで T、、、 は首位企業の学習計算量(上位1社の割合(§2.3)×世界の総量×学習への配分(§2.4))である。中央推計では2029年に約158T、2040年に約3万1,000T。
コピー数。 推論用ハードウェアは、世界の総量のうち§2.4の推論の割合 を占める(H100eあたりのメモリと帯域幅は§1.1から取り、2029年以降は横ばい)。そのうち推論特化の割合 は、新規計算資源の手で設定した流入から積み上げる(特化チップは提供しかしないので、その総量すべてが提供に回る)。汎用部分は、そのメモリからコピーを提供する。1レプリカは重み に加え、 個の同時実行コピーそれぞれのKVキャッシュ を占める。特化チップのほうは、選んだ速度 で、トークンのスループットが支えられるだけのコピーを提供する。スループットは、使用率 に、計算性能の限界()と重みの読み出し帯域幅の限界()の小さいほうを掛けたものだ。特化チップのメモリはそれに見合う大きさにするので、制約にはならない。したがって、
速度。 推論用ハードウェアの帯域幅と容量の比(メモリを1秒間に何回全部読み出せるか)を とすると、
汎用ハードウェアでは、バッチ処理のデコードの1ステップで読み出すのはフットプリント()そのもので、そのレプリカが持つ帯域幅もこれに比例する()。そのためバッチとコンテキストは相殺され、デコードの上乗せ と使用率 の積だけが残る。これは、提供が大バッチでスループット最適な動作点にとどまることを前提としている。スパース性は実際の速度を動かさない(トークンあたりのバイト数とFLOPは減らすが、層の数は減らさない)。スパース性が効いてくるのは、モデルの規模と、特化チップのトークンあたりの計算量を通じてである。見出しの平均速度はコピー数で加重している。
すべての入力を、属する推測の順(モデルの規模、推論用ハードウェア、コピー数、速度)に並べる。
| パラメータ | 値 | 注記 |
|---|---|---|
| 2026年の基準値 | 総パラメータ10T、スパース性8倍 | 現在のフロンティア |
| 計算量の指数() | 0.5、範囲 [0.2, 0.8] | データの壁は押し上げる(ネソフの数値は に合う)。過剰学習、強化学習、蒸留は押し下げる |
| スパース性の指数() | 0.74 | アクティブパラメータあたりの最適トークン数は約 で増える |
| スパース性() | 8倍→32倍@2028→128倍@2040 | 手で設定 |
| 推論の割合() | 協定前は約50%、77%@2030、25%@2040 | §2.4から(一般向け+社内) |
| 新規計算資源に占める特化チップの割合() | 0.2%(2026年)→1%(2029年)→14%(2040年) | 手で設定。2040年までに推論用ハードウェアの計算資源の約半分 |
| H100eあたりの帯域幅 | 2029年以降は年+10%、容量は横ばい | 読み出し率 が決まる:約31/秒(2026年)→約107/秒(2040年) |
| 特化チップの帯域幅() | HBMの60倍(2026年)→約500倍(2040年) | Groq/Cerebrasの実測は約60〜80倍。約2034年までは帯域幅が、その後は計算性能が制約になる |
| 提供時の精度とFLOP/s | 4ビット(0.5 B/パラメータ)、H100eあたり4e15 FLOP/s | 2026年の重みはレプリカあたり約5TB |
| バッチ() | レプリカあたり256の同時実行コピー | 一定。コンテキストの仮定とトレードオフになる |
| コピーあたりのKV() | 約20GB(2026年)→約3.3TB(2040年) | コンテキストは約20万→約240万トークン。2040年までにコンテキストがメモリに占める割合は約5%になる |
| デコードの上乗せ() | 約2 | 投機的デコード/マルチトークンデコード |
| 使用率() | 0.9 | 各チップ区分の制約となる限界に対する値 |
| 特化チップの速度() | 2026/29/32/35/38/40年に1,000 / 1,500 / 3,000 / 6,000 / 15,000 / 25,000トークン/秒 | 手で設定。オンチップ配線の遅延の下限に向かう |
付録:実効H100eモデル
A.1 目的
あるクラスタがAIワークロードにとってどれだけ有用かを、典型的なH100 GPUクラスタとの相対値で推計する方法がほしい。
生のH100換算は代理指標として不十分だ。ピーク時の計算性能しか測っておらず、実際のAIワークロードでは、ほかのハードウェア要因によってクラスタの有用性が大きく上下しうるからだ。とくに効くのは、メモリ帯域幅、メモリ容量、スケールアップのネットワーク、スケールアウトのネットワーク、そして典型的なワークロードがまたがる必要のある物理チップの数である。出力は
で、有用性補正は、クラスタが生のH100eあたりで基準とするH100クラスタより有用なら1を上回り、劣るなら1を下回る。有用性補正の主な設計目標は次のとおりだ。
-
基準とするH100クラスタでは、実効H100eが生のH100eと等しくなること。
-
ほかの条件がすべて同じなら、メモリ帯域幅、メモリ容量、スケールアップのネットワーク、スケールアウトのネットワーク、スケールアップの世界の規模のいずれかが増えれば、有用性が上がること。つまり、どれか一つの指標がN倍に改善すれば(ほかは同じとして)、有用性補正は 1倍になること。
-
ハードウェア性能の総量が同じでも、より小さなデバイスに分散したクラスタは劣りうること。ワークロードの規模が一定なら、より多くのチップに分散させる必要があり、通信のオーバーヘッドが増えるからだ。つまり、チップあたりの全指標をN分の1にし、数量をN倍にした場合(クラスタの総量は同じ)、有用性補正は 1倍になること。
-
ボトルネックは硬くなく柔らかいこと。資源どうしはトレードオフできるべきだ。AIワークロードでは、並列化などのソフトウェア上の選択を調整して、異なる資源を融通し合えることが多いからだ。
A.2 入力
入力はチップとクラスタの特性で、次のように表記する。
-
:チップあたりの計算性能(H100e)。
-
:チップあたりのメモリ帯域幅。
-
:チップあたりのメモリ容量。
-
:ある世界の規模の内部での、チップあたりのスケールアップ帯域幅(ラック内のNVLinkなど)。
-
:スケールアップの世界の外、ただしクラスタ全体の内部での、チップあたりのスケールアウト帯域幅。
-
:スケールアップの世界の規模。単位はチップ(スケールアップ領域のGPU数。たとえばNVL72 )。
-
:クラスタ内のチップ数。
このモデルはワークロードに依存する。つまり、ワークロードの規模(計算量での大きさ)を考慮に入れる。単一の平均的なワークロードを考える代わりに、ジョブの規模に幅を持たせる。各ジョブはフロンティアの規模 の割合 で表す。 はフロンティア企業の計算資源の総量を表すことを意図している。ジョブ数の重み ()とともに、フロンティアの規模に対する割合 として次のように表す。
| ジョブ | に対する割合 | 重み |
|---|---|---|
| 小(推論、実験) | 0.50 | |
| 中(大規模な実験、試験的な学習実行) | 0.30 | |
| 大(フロンティアに近い学習) | 0.20 |
重要なのは、 が物理的なチップ数ではなく、生のH100eの計算量に対する割合だという点だ。
A.3 基準のシナリオ
生のH100eと実効H100eが等しくなる基準として、2024年型のH100-SXMクラスタを使う。
| 基準(生=実効となる点) | 値 |
|---|---|
| チップあたりの生H100e | 1 |
| メモリ帯域幅 | 3.35 TB/s |
| メモリ容量 | 80 GB |
| スケールアップ帯域幅 | 0.9 TB/s |
| スケールアウト帯域幅 | 0.05 TB/s |
| スケールアップの世界 | 8チップ(HGX-8) |
| クラスタの規模 | 10万チップ |
これとは別に、考慮するフロンティアの規模 は時間に依存する。 は世界の計算資源の総量に占める割合が増えていくものとしてモデル化する(フロンティアAI企業が世界の計算資源に占める割合が上がっていることを反映する)。その割合は約6%(2025.0)から9/13/16/18%(2026.0〜2029.0)へ上がる。そのためワークロードの絶対的な規模は毎年大きくなり、スケールアップの世界の規模のロードマップと並行して、スケールアウトへの圧力も高まる。構成上、基準では実効H100e 、つまり有用性補正 が出力されなければならない(§A.9で確認する)。
A.4 ワークロードのフットプリント
各区分 について、ワークロードの生の規模(必要な計算量)は
である。そのワークロードが必要とする物理チップ数は、ハードウェアが許す限り薄く分散させると仮定して求める。ジョブの計算量をチップあたりの計算性能 で割ると、メモリの制約がない場合に必要な数が得られる。そこに を掛けて水増しし、メモリの少ないチップはジョブの重みと活性化のうち小さな部分しか保持できないことを反映させる。ただし、メモリを硬い壁としては扱わない。指数 は、容量をある程度取り戻せる(活性化の再計算、オフロード、より細かいシャーディング)ことを反映している。チップのメモリを半分にすれば、ワークロードはいくらか多くのチップに分散するが、必ずしも2倍のチップが必要になるわけではない。
ここで は上で説明したメモリフットプリントの弾力性である(:容量はチップ数を変えない。:フットプリントが容量に反比例する。既定では とする)。
これを通信のフットプリント と呼ぶ。以下のペナルティでチップ間の通信量を決めるのがこの値だからだ。ジョブが多くのチップに広がるほど、チップ間でやり取りしなければならない量が増える(§A.5)。ワークロードが1チップに収まる極端な場合は、下限を1とする。どちらの弱点も、フットプリントを膨らませる方向に重なる。計算性能の低いチップはジョブを動かすのに自らをより多く並べる必要があり、メモリの少ないチップは状態を保持するのにより多くの数が必要になる。つまり、どちらの軸で弱いチップも、同じワークロードをより多くのチップに分散させ、より多くの通信コストを払う。
これらはすべて、同じジョブを動かす基準クラスタと比べて測る。基準のフットプリントは で、基準では なのでメモリの項はない。
A.5 スケールアップとスケールアウトの通信量
次に、ワークロードの通信のうち、高速なスケールアップの世界の内部にとどまれる割合()を推計する。ワークロードのチップフットプリント (§A.4)を世界の規模 と比べ、
とする。フットプリントがスケールアップの世界に収まる()なら だ。それより大きければ、全対全型の通信のうち世界の内部で済むのは一部だけになる。スケールアップの世界を持たないチップ()では、1チップより大きいワークロードはすべてスケールアウトになる。これはAIワークロードの通信量の大まかな近似である。
A.6 資源のペナルティ
このモデルは資源のペナルティを計算する。いずれも基準が1になるよう正規化する。
6.1 メモリ帯域幅のペナルティ。
チップあたりの計算性能がチップあたりのメモリ帯域幅を上回って伸びると(どちらも基準との比)、チップは帯域幅のボトルネックをより強く受ける()。帯域幅のほうが計算性能より速く伸びれば、ボトルネックは弱まる()。
6.2 ネットワークのペナルティ。 これは、同じジョブで基準と比べて、クラスタがどれだけ通信に縛られているかを測る。通信のボトルネックは、チップの計算性能が高いほど(1秒あたりにこなす仕事が多いほど、処理を止めないためにやり取りするデータが増える)、またジョブがまたがるチップが多いほど大きくなる。これらを、ネットワークの速さと比べて重み付けする。
まず、各クラスタの実効的な逆帯域幅 (移動するデータ1単位あたりの通信時間。高いほど悪い)から始める。§A.5から、 はスケールアップの世界の内部での通信量の割合で、 はスケールアウトでの割合なので、 は通信量の行き先に応じて二つのファブリックを混ぜ合わせたものになる。基準については、
評価対象のクラスタについても、それ自身のフットプリント、世界、帯域幅で同様に、
となる。通信のペナルティは、基準と比べて測る三つの量の積としてモデル化する。ジョブがまたがる必要のあるチップ数()、各チップが仕事を終える速さ()、クラスタでの通信のコスト()だ。これらを掛け合わせるのは、通信時間が、移動するデータ量と移動のコストの積だからだ。そのため複数の軸で同時に劣ると、影響が重なる。チップ数には弾力性 を用いて、
計算速度()と通信コスト()は線形に効く。仕事を2倍速く終えるチップは、やり取りするデータも2倍速く生み出し、1バイトあたり2倍コストのかかるリンクは2倍の時間がかかる。そのため、どちらも通信時間に線形の圧力をかけるとモデル化する。チップ数が線形より弱く()効くのは、チップを2倍にしても、個々のチップが動かすデータは2倍にならないからだ。たとえばリング型のall-reduceでは、各チップが動かすデータ量は、ジョブが100チップで動こうと10万チップで動こうと一定(モデルサイズの約2倍)である。ステップ数が増えるのと同じ速さで、チップあたりの分割データが小さくなるからだ。ただし、調整のステップ数(同期の回数、ツリーのホップ数など)はチップ数とともに増えるが、その増え方は弱い。そこで全体として、これを指数 でモデル化することにした。
A.7 ボトルネックの統合
上の二つのペナルティを計算性能のボトルネックと組み合わせ、重要度の割合 で重み付けする。計算性能にはペナルティがない(ペナルティは計算性能と資源の比であり、計算性能そのものについてはその比が なので、定義上1になる)。したがって は、計算性能に縛られるとモデル化した仕事の割合にすぎず、 と はメモリ帯域幅とネットワークのペナルティで決まる割合である。資源どうしがある程度トレードオフできるよう、硬いボトルネックではなくべき平均を使い、既定では とする。
ここで はH100の基準と比べた速度低下である( は単純なアムダール型の加重平均で、既定の は大きなボトルネックをより強く効かせる。CESの言葉で言えば、 は資源間の代替の弾力性 に対応する)。有用性補正は、ワークロード全体にわたるペナルティの加重平均だ。
A.8 式の全体
ここで有用性補正 は次のとおり。
A.9 この式が望ましい性質を満たす理由
性質1:基準では生と実効が等しい。 基準では かつ なので、、 となる。したがって で、実効H100e がちょうど成り立つ。
性質2:資源が増えれば有用性が上がる。 を増やすと が下がる。 を増やすとフットプリント が減り、したがって も下がる。 や を増やすと が下がる。 を増やすと が上がり、通信量が遅いスケールアウトから速いスケールアップへ移る( のとき有利に働く)。この効果は 、つまりワークロードがすでにスケールアップの世界に収まった時点で頭打ちになる。いずれも実効H100eを押し上げる。
性質3:総計算性能が同じで、チップが小さい場合。 基準のクラスタを、チップあたりのすべての指標が 分の1で、数が 倍のチップで組み直す。クラスタの総量は変わらない。 で、チップ数は 、ワークロード は同じとする。
生のH100eの総量は同じなのに、有用性は1を下回る。各ジョブがより多くのチップにまたがる必要があるからだ。フットプリントは線形より速く増える。チップあたりの二つの削減が重なるためだ。計算性能が弱いので各チップはジョブの しか受け持てず、 倍のチップが必要になる。さらにメモリが小さいので(メモリの弾力性 に従って)それが 倍に膨らむ。したがってチップ数は 倍になり、 なので 倍を上回る。
帯域幅のバランスは変わらない。また では、チップあたりの計算性能とネットワークの逆数が相殺する(チップあたりの計算性能が小さくなった分は、それに見合ってネットワークが遅くなることで打ち消される)ので、フットプリントの項だけが残る。
\tau'_B = \frac{C'/C_0}{B'/B_0} = \frac{1/k}{1/k} = 1, \qquad \tau'_{N,j} = \left(\frac{n_'j}{n_{0,j}}\right)^{\gamma}\frac{C'}{C_0}\frac{R'_j}{R_{0,j}} \;\gtrsim\; \big(k^{1+\delta}\big)^{\gamma}\cdot\underbrace{\frac{1}{k}\cdot k}_{=\,1} \;=\; k^{(1+\delta)\gamma} > 1.したがって
既定のパラメータでは、有用性補正は次のようになる。
これを次の の値について計算すると、以下のとおりだ。
| 有用性補正 | ||
|---|---|---|
| 0.1 | 1.10x | 0.91x |
| 0.5 | 1.04x | 0.96x |
| 2 | 0.96x | 1.04x |
| 10 | 0.84x | 1.19x |
| 100 | 0.64x | 1.55x |
| 1000 | 0.45x | 2.23x |
弱いチップ()ではペナルティは確かに生じるが、程度は中くらいだ。、、、 が大きいほど、また大きなジョブがスケールアップからスケールアウトにあふれるほど、ペナルティは強まる。(数は少ないが強いチップ。たとえば の行)では逆になり、 となる。
A.10 既定のパラメータと結果
既定のパラメータ(不確かで、手で選んだもの):
| パラメータ | 値 | 役割 |
|---|---|---|
| 0.55 | 削減できない、計算性能に縛られる割合 | |
| 0.20 | メモリ帯域幅に左右される割合 | |
| 0.25 | ネットワークに左右される割合 | |
| 1.5 | ボトルネックの鋭さ(1=アムダール、→∞=最大値) | |
| 0.5 | 容量の不足がフットプリントをどれだけ膨らませるか | |
| 0.15 | フットプリントの大きさが通信の圧力をどれだけ高めるか |
フロンティアのワークロード規模の予測と、§1.2の各計算資源区分の平均的な資源特性に基づくと、生の計算資源に対する有用性補正は次のようになる。
| 生のH100eあたりの実効H100e() | 2024 | 2026 | 2028 | 2029 |
|---|---|---|---|---|
| AI | 1.16 | 1.06 | 1.04 | 1.02 |
| 非AIサーバー | 1.38 | 1.40 | 1.41 | 1.40 |
| PC | 0.35 | 0.08 | 0.04 | 0.03 |
| スマートフォン | 0.21 | 0.11 | 0.07 | 0.05 |
| ゲーミングGPU | 0.04 | 0.05 | 0.06 | 0.04 |
| その他 | 0.53 | 0.43 | 0.34 | 0.30 |
は生の計算資源1単位あたりで測っている点に注意してほしい。非AIサーバーの値が最も高いのはそのためだ。CPUサーバーはチップあたりの計算性能はごく小さいが、それを潤沢なメモリ、帯域幅、データセンターのネットワークで包んでいるので、その(わずかな)H100eの一つひとつが異例なほど十分にデータを供給される。AIのハードウェアは1をわずかに上回るところから始まり(基準に比べてメモリの豊富なH100のため)、メモリの壁が効いてくるにつれて1へ近づいていく。一方、単体デバイスの値が1を大きく下回るのは、計算性能ではなくネットワークで不合格になるからだ。
このモデルは自分で動かすこともできる。下に任意のチップ/クラスタの仕様を入力すれば(あるいはプリセットから始めれば)、その有用性補正と実効H100eを読み取れる。
AI関連の定義は、複数のハードウェア性能指標に基づく閾値で、A100のすぐ下に設定している。詳しくは計算資源の定義を参照。
計算資源を所有する企業の国籍によって、米国、中国、その他の世界に分ける。
ピーク時の密(スパース性なし)の1秒あたりテラ演算数 最も速く動く精度のビット幅(例:FP16=16、FP8=8、FP4=4)。H100は 約15,800 TPP(1,979 FP8 TFLOP/s 8ビット)で、Blackwell B200はその約2.3倍(密のFP4で9,000 TFLOP/s×4ビット=36,000 TPP)だ。低いビット精度がそのビット幅に比例して小さく扱われる以上、指標としてはこの時点ですでに欠陥がある。ビット精度を2分の1にするとTPPは2分の1になるが、ビット幅が半分になれば実際に有用性も半分になるのかは明らかではない。それでも、理論上は精度が2分の1になれば純粋な情報量も2分の1になるので、妥当な近似ではある。
H100とA100はすべての下限を満たす。一方、ゲーミングGPUのRTX 4090は、生のFLOP/sは高いものの、メモリ容量とネットワークで基準を満たさない。ネットワークの下限はスケールアウト(NIC)の帯域幅である。チップのNVLink級のスケールアップ帯域幅は有用性モデルに入力されるが、それ自体はAI関連かどうかの閾値ではない。
データセンターのスケールアウト速度のおよそ100分の1(ほぼUSB4/Thunderboltの速度)。広い定義だが、実際にはほぼデータセンターで使われるチップだけが該当する。
これらの定義で捉えようとしているのは、チップの実際の使われ方だ。誰かが複数のノートPCを十分な速度のケーブルでつなげば、それは非AI関連のクラスタになる(つなぐ前の同じノートPCは、非AI関連の単体デバイスだった)。
ハイパースケーラー(Microsoft、Google、Amazon、Meta)の設備投資額の合計に、ネオクラウドと政府系ファンドを加えた額は、2023〜2025年に年約1.7倍で伸びた。絶対額が大きくなるにつれて伸び率を年約1.5倍へ減速させ、2028年までの平均を年約1.6倍とする。
1ドルあたりのH100eは、ダイの微細化(N5→N3→N2)、より大きなHBMスタック、チップレットによるパッケージングによって改善し、過去には年約1.4倍だった。加速を仮定せず、この率を2028年まで変えずに維持する。
二重計上を避けるため、フロンティアAIの収益はハイパースケーラーのキャッシュフローの項から除外する(AI企業の現金支出はハイパースケーラーのキャッシュフローの中に現れる)。つまり直近の年のキャッシュフローから差し引き、独立した資金源として加え直す。これまでのところ、フロンティアAIの収益がハイパースケーラーのキャッシュフローに占める割合は無視できるほど小さいので、これは小さな調整である。
増強の資金は、ますます負債と株式で賄われるようになっている。Alphabetは2026年2月に約200億ドルの社債の条件を決定し(珍しい100年債を含む約315億ドルの世界的な資金調達の一部)、2026年の約1,850億ドルの設備投資に充てた。これは2025年11月の約250億ドルの社債に上乗せされるものだ(同社の長期負債は2025年に4倍の約465億ドルになった)(CNBC)。Metaは、Hyperionキャンパスのために300億ドルの社債に加えて約270億ドルのプライベート・クレジットのSPVを組成し、Oracleは約180億ドルを発行した(いまや金融を除く投資適格債の最大の発行体である)。全体として、5大ハイパースケーラーは2025年に約1,210億ドルの社債を発行した。標準は年約280億ドルである(Fortune)。株式の面では、SpaceXの過去最大となる約750億ドルのIPO(2026年6月)の一部がAI計算資源に充てられる予定で、GoogleやAnthropicとの大規模な計算資源供給契約がその裏付けになっている(CNBC、TechCrunch)。
これらの倍率は単純化したものだ。負債は最終的には収益ではなく利益から返済される。また大手の発行体は歴史的に投資適格(A格以上)の信用格付けを守ろうとしてきたので、受け入れるレバレッジには上限がある。額面どおりに受け取ると、私たちの経路が示すレバレッジは、貸し手が予測どおりの収益の伸びを信用し続ける場合にしか投資適格を保てない(2025〜2028年の累積負債は約1.6兆ドルで、2029年初めのフロンティア企業のARR約1兆ドルに対する額である)。理想的には、明示的な信用格付けの制約のもとで、予測されるキャッシュフローから負債の規模を決めるべきだ。当面は単純な収益倍率を使う。
換算はランレートの時間平均で行う。A_start から A_end へ指数関数的に伸びる場合、これは対数平均になり、およそ年末のARRの0.4倍だ。したがって2026年にARRが300億ドル→1,800億ドルと推移すると、2026年の計上収益は約840億ドルになる。
最先端のロジックもHBMもEUVリソグラフィに依存しており、EUVはサプライチェーンのなかで短期間の増産が最も難しい部分だ。ASMLが唯一の供給者で、露光装置1台の価格は2億ドルを超え、納期は数年に及ぶ。稼働中の装置の台数は年約10〜15%しか増えず、AI計算資源の需要よりはるかに遅い。考えうるボトルネック(ファブの空間、先端パッケージング、電力、EUV)のうち、EUV装置の稼働時間を実際の制約(かつ最も予測しやすいもの)として扱う。
稼働中の計算資源は、単純な累積生産量ではない。チップの残存率の緩やかな減衰(再利用や中古市場を含め、AIアクセラレータの半減期を約15年とする)を差し引いており、これで2029年の総量は約3%減る。同じ区分別の退役を、§1.2のすべての計算資源に適用している。
ここでは使用率(さまざまな歩留まりや稼働率の要因によって、理論上のウェハ生産能力のうち実際に最終的な計算資源に変わる割合)を、最終的なウェハ1枚あたりのH100eの数値にまとめて織り込んでいる。使用率を切り分けて、「良品ウェハ」1枚あたりのH100e×使用率として考えることはしていない。
この節を通じて、ほかのDUVリソグラフィ(KrF、ArFドライ、i線)は、制約にならない成熟した層として無視する。ここで「DUV」はArF液浸(193i)を指す。
具体的には、装置1台・1年あたり約36万の実効露光パスとしてモデル化している。公称仕様の約160枚/時に対して約50枚/時で、約75〜82%の稼働率に加え、露光量、光源の出力、レチクルのオーバーヘッドによる損失を反映している。したがってここでの「使用率100%」は、TSMCのようなファブがすでに装置を動かしている現実的な持続スループットで保有装置が埋まっている状態を意味し、稼働率100%という文字どおりの上限ではない。
各区分の年末時点の稼働中の総量は、前年の総量のうち残存した分に、その年の生産量を加えたものだ。残存は区分ごとの半減期による幾何級数的な減衰としてモデル化した。半減期は、スマートフォンが約12年、PCとゲーミングが16年、非AIサーバーが14年、AIアクセラレータが15年、「その他」の層(マイコンなど)が30年で、毎年保有台数のおよそ2〜6%が退役する。
計算量が一定なら、アクティブパラメータあたりの最適トークン数は、スパース性の平方根にほぼ比例して増える(スパースMoEの比率で、密なモデルの約40から、30倍スパースで約240へ)。そのため総パラメータ数は そのものではなく で増え、現在の最もスパースなフロンティアモデルのアクティブパラメータ数の小ささと合致する。スパース性は手で設定したスケジュールで、現在の8倍から協定時に32倍、2040年までに128倍とする。大半は非常に不確かな、トレンドの単純な外挿である。
各コピーのKVキャッシュは、アテンションの圧縮後でトークンあたり約100KBの、約20万トークンのライブなコンテキストである。これを、モデルの幅(約 active^0.5)と、コンテキスト長の正味約12倍の伸び(エージェントのコンテキストがKV圧縮のさらなる進歩を上回って伸び、コピーあたり約20万→約240万トークン)の積で増やす。その結果、2040年にはコンテキストが汎用メモリに占める割合は約5%になる。
スパース性はこれを変えない。大バッチではすべてのエキスパートが各ステップで使われるので、いずれにせよモデル全体が読み出される。バッチサイズ1での提供ならアクティブな部分のバイトだけを読み出して数倍速く動けるが、そのトークンあたりのコストを大規模に払う者はいない。この予測では、そうした需要は推論特化チップが担う(バッチサイズ1の上限 は、元データのシートに診断値として残している)。この相殺を2040年まで持ち越すことは、提供が、帯域幅と容量の比が§2.2の経路に従うチップ上で、現在の大バッチでスループット最適な動作点にとどまることも前提としている。遅延への圧力によって汎用の提供のあり方が変わる(バッチを小さくする、遅延重視の部品を使う)なら、ここでの速度は上に、コピー数は下にずれていく。
解釈について二つの注意がある。推論モデルは完了したタスク1件あたりに多くのトークンを費やすので、1秒あたりの有用な仕事量は生のトークン数に遅れをとる。また、ここで数えているのはフロンティアモデルのコピーだけだ。シナリオの労働者数(2036年までに人間の速度換算で1,000億)には、より小さな蒸留モデルも含まれており、ここでのフロンティアモデルのコピーは、トークン換算でその総数の約20%を担う。
形式的には 。つまり1チップに収まるほど小さなジョブでも、チップ1個をまるごと占有する。この下限が効くのはその極端な場合だけで、複数のチップにまたがるほど大きなワークロードでは働かず、 となる。
この指数については本当に確信がない。うまくスケールする集団通信もある。よく実装されたツリー型のall-reduceは、参加数 に対して遅延が になる(NCCLのダブル・バイナリーツリーは、数万基のGPUまで遅延をほぼ一定に保ち、Summitの24,576基のGPUでは最大180倍の改善を示した)(NVIDIA, Massively Scale Your Deep Learning Training with NCCL 2.4)。これは 〜 チップの範囲では に近い。一方で、より悪いものもある。リング型のアルゴリズムの遅延は線形に増え、処理の遅いノード(ストラグラー)、競合、計算と通信の重ね合わせの不完全さがオーバーヘッドをさらに押し上げる。したがって は、線形より弱い緩やかな増加についての大まかな推測である。
フットプリントは で、 は§A.5のとおり。