
秘密AIプロジェクト
Brendan Halstead, Thomas Larsen
プランAのシナリオで私たちが提案するのは、AIを安全に開発するための国際協調だ。リスクを許容できる水準に抑えるには、AI開発のペースを大幅に落とす必要がある。この種の協調を阻む大きな要因は、いずれかの当事者が秘密裏にAIを開発して優位に立つおそれである。
幸い、破局をもたらすような形で秘密のAIデータセンターを建設・運用するのは非常に難しいと思われる。この補足資料の残りでは、中国がプランAから秘密裏に離反するのがどれほど難しいか、そして離反を防ぐためにどのような対策を講じられるかを分析する。
離反を成功させるために必要なこと
要するに、私たちが推奨するプランAの政策が有能に実施された場合、それを最も巧妙にくぐり抜けるには、中国は次のことをすべて成し遂げなければならない。
-
チップの透明性に関する合意が結ばれる前に、チップの転用を始めると決断する(プランAのシナリオでは、2028年中に決める必要がある)。
-
発見されずに150万H100e程度(協定がなかった場合の2028年末時点における中国の保有量の約7%)を手に入れる。この計算資源を確保する最も有望な手段は、(i) 2028年を通じて密輸チップを転用する、(ii) 廃棄してリサイクルしたと偽って旧世代のチップを転用する、(iii) 半導体サプライチェーン全体で生産記録を示し合わせて改ざんし、協定前の生産の一部を隠す、の三つである。
-
発見されずに違法なデータセンターを建設する。私たちが知るかぎり最も有望な方法は、衛星による発見を避けるためにデータセンターを地下に置くことだ。
-
地下データセンターに電力を供給し、冷却する。一つの方法は、小型原子炉で現地発電し、赤外線で見える温排水の広がり(熱プルーム)を生じさせないようにしながら、大河川や深層水の水源に水を循環させて排熱することだ。
-
地政学的な勢力均衡を大きく動かすほど極端なAI能力を築くのに十分な期間、発見されずに施設を運用する。そのためには、政府内のスパイ、サイバー作戦、秘密プロジェクトの発見を手伝うより賢いAI、衛星による監視、そして米中政府間で合意された透明性措置(たとえば、プライバシーを守りつつ機密情報を読むAI)のすべてをかわさなければならない。米国が疑いを抱いた場合(上記のいずれかから証拠が出た場合など)、中国は秘密プロジェクトの露見につながる譲歩(たとえば、秘密プロジェクトの候補地への米国の査察官の立ち入り)を避けつつ、協定が崩壊する事態も避けなければならない。
-
嘘発見器(あるいは検証を飛躍的に改善するその他のAI技術)の開発や利用を阻む。
中国はもっと小規模な秘密プロジェクトを進めることもできる。その場合、痕跡も発見される確率も規模に比例して小さくなるが、戦略的に意味のあるAI能力への進歩も遅くなる。
十分に小規模な中国の秘密プロジェクトについては、米国が「存在しない」と確信をもって断定することは、実際には不可能だろう。したがって、主な関心事は次の二つになる。
-
発見を逃れられる秘密プロジェクトの最大規模はどれくらいか。
-
現在の軌道のままなら、秘密プロジェクトはいつ頃から協定の健全性と世界の安全保障を脅かすようになるのか。
答えはシナリオ全体の展開に大きく左右される。とはいえ、どのシナリオでも、コンソーシアムの参加国は戦略を調整して秘密プロジェクトに対するリードを広げられる。主な手段は、ソフトウェア面の進歩のペースを落とすこと(その代わり、アラインメントが十分に進む前に協定が弱体化するリスクが増す)か、先に進む前にもっと堅牢な発見技術の導入を求めることである。
第1節:秘密プロジェクト対策の戦略の概要
この補足資料では、プランAからの破局的な離反を防ぐための私たちの計画を概説する。
この図は、秘密プロジェクトに対処する私たちの戦略の全体像を示している。図のとおり、戦略の各要素は四つの補足資料にまたがって扱っている。この節では戦略全体を概観する。
この図は、秘密プロジェクトに対処する私たちの戦略の全体像を示している。図のとおり、戦略の各要素は四つの補足資料にまたがって扱われている。この節では戦略全体を概観する。
プランAからの離反は、合法なデータセンターでも秘密のデータセンターでも起こりうる。合法なデータセンターは、AIの開発や利用が承認されている代わりに、ルールを守っているかどうかの検証を受ける。合法なサーバーの検証は、主に検証計画で扱っている。
この補足資料が焦点を当てるのは、秘密プロジェクト、つまり主に秘密のデータセンターを使うプロジェクトのリスクである。
秘密プロジェクトを抑え込む主な方法は、使える計算資源の量を制限することだ。気づかれずに済むためには、秘密プロジェクトのデータセンターはごく小さくなければならない。秘密プロジェクトの計算資源は、秘密プロジェクトによる計算資源の取得を防ぐことと、建設された秘密データセンターを発見することを組み合わせて制限できる。
秘密データセンターの計算資源の出どころは、「ストック」(2029年より前に生産された計算資源)か「フロー」(2029年中またはそれ以降に生産された計算資源)のどちらかになる。新しいチップのフローについては、非常に強力に管理できると楽観している。プランAのもとでは、厳重に管理されたファブ(半導体工場)で計算資源の生産がきわめて入念に監視されるからだ(具体的には、転用をほぼゼロに抑え、転用の総量が10万H100e未満であることを非常に高い確度で保証できるはずだ)。産業爆発の時期には、新しいチップのフローの検証がいくらか難しくなる。ロボットが大量に存在すれば、秘密のチップサプライチェーンを構築するのがはるかに現実的になりうるからだ。コンソーシアムは、ロボットの労働力に検証手法を適用することでこれを防げる。
一方、計算資源のストックはすでに各地に散らばっているので、見つけるのははるかに難しい。そのため私たちは、秘密プロジェクトが計算資源を確保するとすれば既存のストックからだろうと予測している。だからこそ、協定前のストックを推計し、その大部分の所在を把握することがプランAの重要な優先事項になる。
中国が有能に秘密プロジェクトを実行した場合に転用できる計算資源の量について、私たちの推計の中央値はおよそ150万H100e(2028年末時点の世界の計算資源の0.5%、費用は約150億ドル)である。
ソフトウェアはハードウェアよりはるかに制限しにくい。そして十分な量のソフトウェアが流出すれば、ごく小さな秘密プロジェクトでもきわめて高性能なAIを開発できてしまう。秘密プロジェクトのソフトウェア面の進歩は、合法なプロジェクトから得る進歩と、秘密プロジェクト自身の研究による進歩の二つに分けられる。
合法なプロジェクトから得る進歩。 ほとんどのAIアルゴリズムについて、セキュリティを確保するのはほぼ不可能だろう。そのため、ここでの主な防衛線は、合法なプロジェクトによるアルゴリズムの進歩を制限することになる。それでも、プランAの大半の期間を通じて、秘密プロジェクトがAIアルゴリズムを手に入れる主な経路はこれになるだろう。
秘密プロジェクト自身によるソフトウェアの進歩。 秘密プロジェクトはきわめて限られた計算資源で動くので、この進歩は放っておいても遅い。さらにプランAは、秘密プロジェクトがAI研究開発に利用可能な最高性能のAIシステムを使えないようにすることを目指している。ただし、秘密プロジェクトがいくつかの経路で高性能なAIにアクセスし、ソフトウェア面の進歩を劇的に加速させる可能性はある。
-
合法なAIからの蒸留。 中間の計算過程を隠すといった標準的な手法で蒸留を抑えることについては楽観しているが、それでも秘密プロジェクトは蒸留によって、多少は高性能なAIシステムを使えるようになると予想している。
-
合法な推論用AIを使ったAI研究。 既定でこうした要求を拒否させることで抑えられる。
-
合法なAIを盗み、拒否する性質を追加学習で取り除く。 モデルの重みのセキュリティで抑えられる。モデルの重みはサイズが大きいので、アルゴリズムよりもはるかに守りやすいと楽観している。
第2節:秘密裏の計算資源調達を防ぐ
プランAで私たちが推奨する政策を米国が有能に実行した場合でも、中国が協定の1年前から有能に転用を進めれば、米国に違反の明白な証拠をつかまれることなく、協定開始時点の世界のAI関連計算資源の**0.1%から1.4%(80%信頼区間)**を手に入れられると推計する。以下の表では、これをさまざまな単位で示す。
推計の中央値 | 80%信頼区間 | |
世界全体に占める割合 | 0.51% | [0.11%, 1.4%] |
H100e | 150万H100e | [31万, 413万] |
IT機器の費用 (中国が支払うH100eあたりの価格の推計中央値を使用) | 150億ドル | [36億ドル, 650億ドル] |
2029年1月時点の最先端AI企業の研究開発用計算資源の推計中央値との比較 (3,600万H100e) | 24分の1 | [115分の1, 9分の1] |
第2節の残りでは、これらの数値の根拠を説明する。
第2.1節では、私たちの検証の手法を説明する。その中心は、世界に存在する計算資源の量を正確に把握したうえで、販売記録を最終使用者までたどり、協定前の計算資源のできるだけ多くについて物理的な所在を確かめることにある。
第2.2節では、秘密プロジェクトがこの検証の手法をかいくぐるために使いうる戦略を述べる。どの経路も協定の実施前に行動を起こす必要がある。ここでは、中国が協定の1年前に転用を始めると想定する。
出どころ | チップの由来 | 実現可能な確率 | 中央値 [80%信頼区間] | |
密輸された西側のチップ | 2028年のフロー | 米国設計 | 100% | 0.23% [0.02%, 1.17%] |
偽装廃棄 | 2028年より前のストック | 米国設計 | 60% | 0.31% [0.21%, 0.42%] |
国内生産の隠蔽 | ストック+フロー | 中国設計 | 25% | 0.14% [0.05%, 0.30%] |
検証を免除された軍事用計算資源 | 検証 免除 | どちらも | 推計せず | 推計せず |
最後に第2.3節では、各経路からどれだけの計算資源を得られるかを予測し、秘密プロジェクトが手に入れられる計算資源の総量を推計する。
第2.1節:秘密プロジェクトによる計算資源の取得を制限する政策
プランAの実施後に生産されるAI関連の計算資源は、入念に追跡・監視される。したがって、プランAのもとで秘密プロジェクトが計算資源を手に入れる最も現実的な経路は、協定の実施日より前に生産された計算資源になる。
既存の計算資源は、最終的に以下のいずれかの状態に行き着く。
要するに、私たちは次のことを推奨する。
これらはそれぞれ、フローチャートの左端のノード、フローチャート内の青い木構造、フローチャートの「記録されていない販売」の部分に対応している。
提言1:半導体サプライチェーンを監査し、協定前の計算資源の生産をすべて正確に記録する
協定前の計算資源をもれなく把握するには、まず協定前の生産について正確な申告を得る必要がある。言い換えれば、AIアクセラレータのベンダー(NvidiaやHuaweiなど)に、協定前の販売をすべて申告させなければならない。生産の過少申告をできるだけ難しくするため、米国はAIアクセラレータの生産に関わる上流の各サプライヤーにも記録の提出を求めるべきだ。
具体的には、まず汎用GPUについてはNvidiaとAMD、カスタムAIアクセラレータについてはBroadcomとMarvell、中国ではHuaweiとCambriconから販売の申告を受ける。次に、これらの企業が在庫、サプライヤー、購入履歴を申告する。たとえば次のようなものだ。
-
TSMC、Samsung Foundry、Intel Foundry、SMICによるロジック半導体の製造
-
SK Hynix、Samsung、Micronの高帯域幅メモリ
-
ASE/SPIL、Amkor、JCETによる先端パッケージング
さらに、これらの上流サプライヤーが自社のサプライヤー、購入、在庫、累積生産量を申告する。各階層で流れを突き合わせられるので、矛盾を生じさせずに生産を過少申告するには、次のいずれかを組み合わせる必要がある。
-
上流の投入物の購入を過少申告する。その場合、上流のサプライヤーも生産を過少申告しなければならない。
-
上流の投入物の在庫を過大申告する。申告された在庫の実地検査で発覚する。
-
生産工程でのロスを過大申告する。その場合、後工程のすべてのノードが、つじつまを合わせるために投入量を過少申告しなければならない。
注目すべきことに、中国製チップの生産に関わるサプライヤーの多くは、本社が中国国外にある。それでも中国がこうした改ざんを示し合わせる可能性は考えられる。中国に生産の過少申告を思いとどまらせるため、米国はさらに次のことができる。
-
協定に至るまでの数年間、国家の諜報能力(サイバー作戦や人的情報源など)を使って、中国のサプライチェーンに改ざんの証拠がないかを探る。
こうした条件のもとでは、中国企業が正確な開示を行う可能性は高いが、確実ではないと私たちは考えている。中核的な提言には含めず、推計でもあてにしていないが、サプライチェーンの側でも協定前に行動を起こし、検証を容易にすることはできるし、そうすべきだ(例)。
提言2:申告された計算資源の販売を、物理的な最終使用場所まで追跡する
私たちは、コンソーシアムが協定前のすべての計算資源の所在を二層で検証することを推奨する。一層目では、ベンダーの販売記録を下流へたどり、一定の規模を超える計算資源の保有者をすべて監査する。二層目では、残りの小規模な保有者の裾野から無作為に標本を抽出し、抽出した計算資源の単位ごとに現在の物理的な所在までたどる。その結果得られるのは、選んだ信頼水準のもとで、秘密プロジェクトに転用されえた計算資源の量の上限を示す証明である。
監査の提案の詳細
-
提言1で検証されたベンダーから直接顧客への販売記録を出発点に、しきい値Tを超える直接顧客をすべて監査する。次に、監査した企業の顧客のうちTを超えるものをすべて監査し、これを再帰的に繰り返して、未監査の受け取り手がすべてT未満になるまで続ける。
-
たとえば、しきい値は協定前の世界の計算資源の0.01%(3万H100e、当時の価格で約2億ドル)に設定することが考えられる。Tは、条約が目標とする秘密プロジェクトの規模の上限と同じかそれ以下にすべきだ。そうすれば、単独で秘密プロジェクトを構成できるほど大きな企業は、確実に監査される。
-
ここでいう「監査」とは、「購入、転売・譲渡、在庫として保有している計算資源のすべての記録を入手する」こと、そして「その企業が現在保有する計算資源をすべて実地検査する」ことを指す。
-
-
記録上の流出のなかには、その先を追跡できないものがある。これらは全量を追跡不能プールLに加え、転用された可能性があるものとして数える。主なケースは二つある。
-
監査できない取引相手への販売。ある企業の記録に、監査のために出頭させることのできない買い手(ペーパーカンパニーや、その先の記録を残していない密輸業者など)への販売があれば、その販売の全量をLに加える。Tは目標上限以下に設定されているので、Tを超えるこうした販売が一件あるだけで証明は成り立たなくなる。そのためコンソーシアムは、売り手の残りの記録も調べ、この件を提言3の手段にも回すべきだ。
-
検証できない廃棄の主張。ある企業が計算資源を廃棄またはリサイクルしたと主張する場合、コンソーシアムはその主張を、リサイクル業者側の記録(リサイクル業者自体も監査可能な取引相手である)、入手できる場合はシリアル番号、保険数理的な機器の損耗率と照合する。照合を通った分は受け入れ、残りはLに加える。先ほどと同じく、Tを超える検証不能な主張は証明を妨げ、調査の対象になる。
-
-
これが完了すると、協定前の計算資源はどの単位も、物理的に検証されたか、Lに加えられたか、しきい値未満の受け取り手に納入されたと記録されたかのいずれかになる。こうした小口の納入の検証済みの記録(企業1がa_1 H100eを受け取った、企業2がa_2を受け取った、など)が、二層目で標本を抽出する対象のリストになる。
-
その納入記録からH100e単位で無作為に標本を抽出し、抽出した単位ごとに、実地検査されたチップにたどり着くか、たどり着けずに終わるまで、転売の連鎖を追跡する。
-
裾野に納入されたと記録されたすべての計算資源から、一様無作為に1単位を選ぶ。こうすると、受け取った量に比例する確率で受け取り手の企業が選ばれる。その企業を監査する。検証可能な形で受け取った計算資源は、現在の保有量、記録されたその先への販売、文書化された損耗の合計と一致しなければならず、保有分は実地検査を受ける。
-
販売記録では個々のチップを区別できないので、抽出された単位はその企業の帳簿のなかで比例配分して扱う。たとえば、受け取った500単位のうち200単位を保有している企業なら、200/500の確率で追跡はそこで終わり、検査のためにチップを提示しなければならない。そうでなければ、記録されたその先への販売をたどって買い手に移り、そこで再び監査を行う。
-
各追跡は、合格(実地検査されたチップにたどり着いた)か不合格(検査で数が足りない、帳簿が合わない、買い手を出頭させられない、廃棄の主張を検証できない)のいずれかで終わる。敵対者が大規模な転用を、T未満の多数のペーパーカンパニーの買い手に分散させても、何も得られない。そうした販売は納入記録に現れるので、抽出された追跡はその規模に比例してそこに行き着き、そのような追跡はすべて不合格になる。こうして二層目は、失われた計算資源を統計的に発見し、その量を測る。
-
抽出による監査は、事前通告を最小限にして行い、検査官は毎回の検査でチップのシリアル番号を記録する。同じシリアル番号が、つじつまの合わない時期に二つの検査で現れれば、それ自体が違反となる。この二つの措置がなければ、秘密プロジェクトは一時的に借りたチップで監査を通過できてしまう。
-
協定以降、コンソーシアムはLが増えないようにする。協定後の一定規模を超える譲渡は、登録された監査可能な取引相手に対してのみ認め、協定後の廃棄には立ち会いのもとでの破壊か、シリアル番号を検証したうえでのリサイクルを求める。
こうして得られる証明は、「確率1 - deltaで、D + Lを超える秘密プロジェクトは存在しない」というものになる。Dは問題のない追跡の数が増えるほど小さくなる(おおまかに言えば、n回の追跡で証明できるDは約(裾野の規模 / n) * ln(1/delta))。Lは直接測定される量であり、監査を重ねても減らせない。Lを減らすには、提言3の外部証拠の手段が必要になる。
提言3:所在不明の残りの計算資源を、インセンティブと航空・衛星画像で突き止める
AIデータセンターの直接観測。 情報機関は、Epoch、SemiAnalysis、その他の民間の取り組みと同様の手法を使えば、協定前に中国にある(特に隠蔽されていない)すべてのAIデータセンターを特定し、所在を突き止められると、比較的強く確信している。いずれそれらのデータセンターが査察を受けるとき、査察官が追跡不能な計算資源の一部を見つけるかもしれない(ただしこの方法は、協定の時点ですでに生産されているがデータセンターに配備されていない計算資源には役立たない。その量は約5,000万H100eに上る可能性がある)。
買い戻し制度と密輸の免責。 追跡不能な計算資源を保有する者や、それについて情報を持っている可能性のある者が、名乗り出てコンソーシアムに所在を明かすよう促したい。所在不明の計算資源を明かさない最もわかりやすい理由は、それを秘密のAGIプロジェクトに使っていることだ。それ以外に、民間の主体が名乗り出るのをためらう理由として、次の二つが考えられる。
-
そもそも計算資源を違法に入手した(密輸、あるいは密輸目的の詐欺や窃盗など)ため、名乗り出れば処罰されると恐れている。
-
ほかの主体(秘密のAGIプロジェクトを試みる国家など)に売ったほうが、より多くの見返りを得られると考えている。
前の段階の措置を講じた後も所在不明の計算資源の量が許容できないほど多い場合には、この両方のインセンティブに対抗することを推奨する。1)に対しては、所在不明の計算資源を査察官に引き渡せる者には、国家が完全な免責を与えるべきだ。2)に対しては、所在不明の計算資源を市場価格を上回る値段で買い取ると、国家が申し出るべきだ。ただし、こうした約束は密輸を後押しする逆効果のインセンティブを生むので、追加の所在不明分を把握するために必要な場合にかぎって行うべきである。
第2.2節:秘密プロジェクトが計算資源を取得する戦略
出どころ1:密輸のフローからの転用
対象:2028年のフローのうち西側製のもの
プランAのもとでも、協定の実施前に相当量の計算資源がなお中国に密輸されると予測している。密輸業者はすでにチェーンのどこかで記録を途切れさせたり偽ったりしており、正規のサプライヤーほど詳細な記録を残していない可能性もある。そのため、偽りの身元で計算資源を購入しておけば、サプライチェーンの追跡が最終的にあるサプライヤーにたどり着いても、大きな疑いを招かずに済むかもしれない。
推測の域を出ないが、中国の情報機関が、米国と敵対する別の国(ロシアなど)の企業を装ったダミー会社を設立し、その名義でチップを購入することも考えられる。そうした国にもチップを隠す動機がありうるので、最終的な販売の追跡では、チップが(たとえば)ロシアにあるのか、別の場所にあるのかを結論づけられないかもしれない。
出どころ2:協定前の国内生産の一部を隠す
対象:中国設計のチップのうち、2028年より前のストックと2028年より前のフロー
転売の追跡と実地検査の過程から計算資源を隠すため、中国の情報機関が国内のアクセラレータのベンダーに、協定前の販売を過少申告させることが考えられる。計算資源の生産の追跡は、物理的に生産されたすべてのアクセラレータを把握することで、これを防ぐことを目指している。中国の情報機関は、Huaweiなどのアクセラレータのベンダーには各サプライヤーへの発注量を、サプライヤーには生産量を、それぞれ少なく申告させる必要がある。そのサプライヤーにもさらにサプライヤーがおり、そこでも申告を合わせなければならない(たとえばSMICは、Huaweiのチップ用のロジックダイを製造するのに、別の企業のシリコンウェハーに頼っている)。
サプライチェーンの一部は外国にあり、中国の情報機関には操作しにくい。一方で、高帯域幅メモリのような重要なボトルネック部品は密輸されている可能性が高く、それがサプライチェーンの追跡を複雑にしうる。
何十もの上流サプライヤーの記録を改ざんせずに済ませるため、生産の不足分を歩留まりの変動で説明することも考えられる(たとえばリソグラフィでは、各ウェハー上のダイの一部に欠陥が生じ、そのダイは使えなくなる。ファウンドリはこの歩留まりの最適化を目指すが、それには継続的な研究開発が必要で、歩留まりは時期によって変動しうる。TSMCに追いつこうと急ぐ中国のファウンドリでは特にそうだ)。しかし、歩留まりを低く申告して存在を否定した中間投入物も、秘密裏に最終製品に仕上げなければならないことに変わりはない(先の例で言えば、歩留まりを低く申告して記録にないロジックダイを手に入れても、完成したアクセラレータのパッケージにするには、記録にないHBM(別のサプライヤー製)と記録にないパッケージング(これも別の場所で行う)が必要になる)。つまり、歩留まりの改ざんは、協力が必要な企業の数を減らすにすぎない。
理想的なのは、最終組み立ての段階で歩留まりを操作することだろう。私たちの知るかぎり、この段階の歩留まりは前の段階よりはるかに高く予測しやすいので、大幅に改ざんするのは現実的ではなさそうだ。
全体として、この戦略はかなり危険に見える。関与する企業が一社増えるごとに、ミスや情報漏洩の機会が増えるからだ。ただし、内部告発者制度や聞き取り、人的情報収集(HUMINT)の取り組みが予想より効果を上げないこともありうるし、監視下でこうした複数企業にまたがる改ざんを行うのが、中国の情報機関にとって予想以上に手慣れた仕事である可能性もある。
出どころ3:偽装廃棄によるストックからの転用
対象:2028年より前のストックのうち西側製のもの
放っておいても、購入から協定開始までのあいだに一部の計算資源は廃棄される。これが販売の追跡にとって問題になるのは、(現在行われているような)廃棄では、チップが破壊されたことを事後に検証できないからだ。
何もしなくても、どれだけの計算資源が廃棄されるのか
通常のチップの寿命を考えれば、その量はわずかだ(たとえば一般的な減価償却期間は5年なので、協定前の5年間に計算資源が年2〜4倍で増えていたとすれば、協定前に5年目を迎える計算資源は2^-5〜4^-5未満、つまり協定開始時点の世界の計算資源の3.1%から0.1%にとどまる)。
米国のハイパースケーラーは、廃棄の全過程について詳細な記録を持っていると理解している。たとえばMicrosoftが廃棄するAIサーバーはMicrosoft Circular Centerに送られ、そこで価値の高い部品(AIアクセラレータは当然これにあたる)が取り外され、社内での再利用、転売、(教育目的の)寄付、リサイクルのいずれに回すかが評価される。米国のハイパースケーラー(現在、世界の計算資源の71%を保有している)が廃棄したチップを正確に数えられると仮定すれば、廃棄される割合は、協定開始時点の世界の累積計算資源生産量の0.9%から0.03%に下がる。
小規模な計算資源の運用者や、中国の計算資源の運用者の状況については、それほど確かなことはわからない。
転用の戦略としては、中国の情報機関が大手の中国クラウド事業者に、協定に先立って米国設計の計算資源を廃棄させることが考えられる(名目はたとえば、中国の半導体の自給自足を示す政治的なアピールや、過去の密輸の証拠隠し)。そのうえで偽のリサイクル業者を用意し、ハードウェアを受け入れさせて、リサイクルせずに備蓄させる。協定前に計算資源の大部分を廃棄すれば、それを秘密プロジェクトに使われた可能性のあるものとして扱うべきかどうか、判断がつかなくなる。中国が誠実に行動していたとしても、チップが本当にリサイクルされたことを証明する手段がないかもしれないからだ。
可能なかぎり、米国の情報機関が中国のIT機器リサイクル業界を監視し、この戦略に備えることを推奨する。
廃棄をあまり怪しく見せないための推測的な戦略として、中国の情報機関がサイバー攻撃を使い、設置済みの機器にハードウェア故障のように見える不具合を起こすことも考えられる。そうすれば、事情を知らないデータセンターの運用者は、設置したハードウェアの一部を返品修理(RMA)のためにサーバーやGPUのメーカー(Huaweiなど)に返送したり、リサイクルに回したりする。中国の情報機関は、その出荷品を横取りし、リサイクル済みとして記録させればよい。
出どころ4:申告された軍事用計算資源を秘密のAGIプロジェクトに役立てる
米国と中国が交渉で検証のない軍事用計算資源をなくせなければ、それがAI開発に使われるおそれがある。秘密プロジェクトに転用されうる軍事用計算資源の量は、完全に交渉の進み方しだいである。 検証のない軍事用計算資源の量を最小限にするため、米国が取りうる交渉のやり方はいくつかある。軍事AI開発に使われうる計算資源の量の最大値を最小にするには、米国はすべての軍事用計算資源を推論専用の検証のもとに置くよう求めるべきだ。この方法には、以前なら割に合わないと判断されたかもしれない秘密プロジェクトに動機を与えてしまうという欠点があるが、最悪のシナリオ(秘密プロジェクトと申告された軍事用計算資源が連携する事態)は改善される。
あるいは米国は、検証のない軍事用計算資源をもっと多く受け入れることもできる。その量を協定前の所在不明の計算資源の量と連動させれば、秘密の備蓄を表に出す動機を与えられるかもしれない。一定の前提のもとでは、こうした戦略によって軍事研究開発に使われる計算資源の総量の期待値は減るかもしれない。その代わり、攻撃的な敵対者が使える総量は増える。
全体として、米国はすべての軍事用計算資源を推論専用の検証のもとに置くよう求めるべきだと推奨する。
第2.3節:定量的な推計
有能な秘密プロジェクトが手に入れられる計算資源の量を推計するため、二つの手法を検討する。私たちは一つ目の手法のほうを信頼しており、二つ目の手法は主に妥当性の確認として扱う。現時点では、どちらの推計にも、申告された軍事用計算資源を秘密のAGIプロジェクトに役立てるケースは含めていない。
推計 | 世界全体に占める割合 | H100e(2029.0時点で2億8,900万と仮定) | 説明 |
1 | 中央値 0.51% 80%信頼区間 [0.11%, 1.4%] | 中央値 150万 [31万, 413万] | 上で論じた現実的な転用戦略を組み合わせた積み上げ式の推計。 |
2 | 中央値 0.23% | 中央値 66万 [6万3,000, 680万] | 2028年に中国がAIサーバーの秘密購入に費やせる金額のおおまかな推計と、2028年のH100eあたりの価格の予測にもとづく |
手法1:積み上げ式
この手法では、中国が上で特定した取得戦略のすべてを同時に進めると仮定する。戦略ごとに、取得できる計算資源の量の分布と、その戦略が実現可能な確率を与え、それらを集計して、転用される計算資源の総量の分布を得る。
転用の経路 | 実現可能な確率 | 中央値 | 80%信頼区間 |
2028年より前のストックの廃棄 | 60% | 0.31% | [0.21%, 0.42%] |
2028年の国内生産の過少申告 | 25% | 0.14% | [0.05%, 0.30%] |
2028年に密輸された西側のチップの購入 | 100% | 0.23% | [0.02%, 1.17%] |
出どころ1:偽装廃棄
サプライチェーンの追跡とデータセンターの監視が効果を上げていれば、設置済みの計算資源を理由の説明なしにデータセンターから持ち出すことはできない。したがって、何らかの説明を用意するか、サプライチェーンの追跡とデータセンターの監視をかいくぐるかのどちらかが必要になる。後者はおそらく実現不可能で、仮に可能でも得られる計算資源は比較的少ないと考えられるので、単純化のために除外した。そのため、2028年より前のストックを転用する唯一の方法は、まだ動くチップを廃棄したと偽ることになる。
パラメータの推計値とその根拠
パラメータ | 推計値 | 根拠 |
そもそも言い逃れのできる形で廃棄を偽装できる確率 | 60% | 直感的な推測。 |
中国にある2028年より前のストックのうち米国設計のものの割合 | 45% | 国内生産が世界の3.7%で、(プランAのサイドパネルのデータにあるとおり)2028.0時点の世界のストックの6.7%が中国国内にあるなら、米国設計の割合は45%でなければならない(世界のストックの3%にあたる。2028.0時点)。 |
中国にある2028年より前の米国設計の計算資源のうち、2029.0までに偽装廃棄できる割合(言い逃れのできる形での偽装がそもそも可能だという条件のもとで) | 22% 80%信頼区間:[15%, 30%] ベータ分布 | 直感的な推測。上位数社のクラウド事業者(Alibaba、Tencent、ByteDanceなど)が中国にある米国設計の計算資源の60%を保有し、この計画の一環として、保有する米国設計の計算資源のうち古い順に下位25〜50パーセンタイル分を廃棄するなら、米国設計のストックの15〜30%になる(上のパラメータの45%を使えば、2028.0時点の中国のストック全体の6.75%〜13.5%)。 |
偽装廃棄が実現可能だという条件のもとで、この経路から得られるのは、2028.0時点の中国のストック全体の6.7%〜13.4%、2028.0時点の世界のストックの0.45%〜0.9%であり、**偽装廃棄の計画がそもそも実現可能だという条件(確率60%)のもとで、協定前の世界の計算資源の0.21%〜0.42%**と推計する。
出どころ2:協定前のフローの転用
これは、協定前の国内生産の一部を隠し、秘密プロジェクト用の保管場所に直接送り込むことを意味する。
パラメータの推計値とその根拠
パラメータ | 推計値 | 根拠 |
国内生産の隠蔽が実現可能である確率 | 25% | 直感的な推測。難しさについてはこちらの議論を参照。中国の半導体エコシステムや、私たちの提案と同様の内部告発者制度の過去の有効性について詳しく知れば、見直すかもしれない。 私の当初の推測は15%で、ロメオ(Romeo Dean)は35%と考えているので、その平均をとって25%とした。 |
実現可能であるという上の条件のもとで、2028年の国内生産のうち隠蔽できる割合 | 7% p90 = 15%のベータ分布。 | 直感的な推測。p90は、「中国のハイパースケーラー1社分」(たとえば10〜20%)を消すのはおそらく目立ちすぎる、という考えにもとづく。ただし、これは中国にある計算資源の総量からハイパースケーラー1社分を消すこととは違う点に注意。その総量の一部は、合法に輸入された、あるいは密輸された米国設計のチップだからだ。 |
中国が生産する計算資源の世界に占める割合がおおむね一定だと仮定し、2028年のフローを考慮すると、この経路から得られるのは、**そもそも実現可能だという条件(確率25%)のもとで、中央値0.13%(80%信頼区間:[0.05%, 0.31%])**と推計する。
出どころ3:密輸チップの転用
パラメータの推計値とその根拠
パラメータ | 推計値 | 根拠 |
2028年の計算資源の販売のうち中国に密輸される割合 | 2% [0.66%, 6.0%] 対数正規分布 | 現在、Epochの推計 の中央値では、2025年第4四半期までに販売された計算資源の3.2%が中国に密輸された。今後、中国でフロンティアAIが大きなビジネスになるにつれて計算資源の需要が高まれば(あるいは、AI計算資源が国家安全保障にとって重要であることが中国共産党の目にいっそう明らかになれば)、この割合は上がるかもしれない。米国の取り締まりが強化されれば、下がるかもしれない。 中央値は、計算資源予測と同じく2%に引き下げている。取り締まりの強化を根拠にこれを点推定値として示したロメオの判断に従った。プランAを前提とするなら、これは妥当だと思う。 |
密輸された計算資源のうち、最終顧客を特定できないもの | 25% [2.5%, 70%] ベータ分布 | 直感的な推測。おそらく半分未満だと思う。もっと調べれば不確実性は減らせると思うが、それほど簡単ではない。
関与するすべての主体が販売先について何らかの記録を持っていれば、たとえそれが監査人に見せるような記録でなくても、密輸チップにも正確に記録された管理の連鎖がありうると思う。ただし、どこかの時点で偽りの身元を使う主体に販売されたり、「現金のみ」で販売されたりして、転売業者がチップの行き先を把握していない場合は、これに含めない。一方、チップの最終的な行き先をCIAが把握しており、情報源や手法などを危険にさらさずにその情報をサプライチェーンの追跡に使えるなら、これに含める。 |
2029.0時点までの累積計算資源販売量に占める2028年のフローの割合 | 53% | プランAのサイドパネルのデータ では、2028年に追加されるのが1億5,400万H100e、2029.0時点の総量が2億8,900万H100eである。154M / 289M = 53%。 |
これらのパラメータが独立だと仮定してシミュレーションすると、2028年のフローの0.44%([0.04%, 2.19%])、つまり**2029.0時点の世界の計算資源の0.23%(80%信頼区間 [0.02%, 1.2%])**となる。
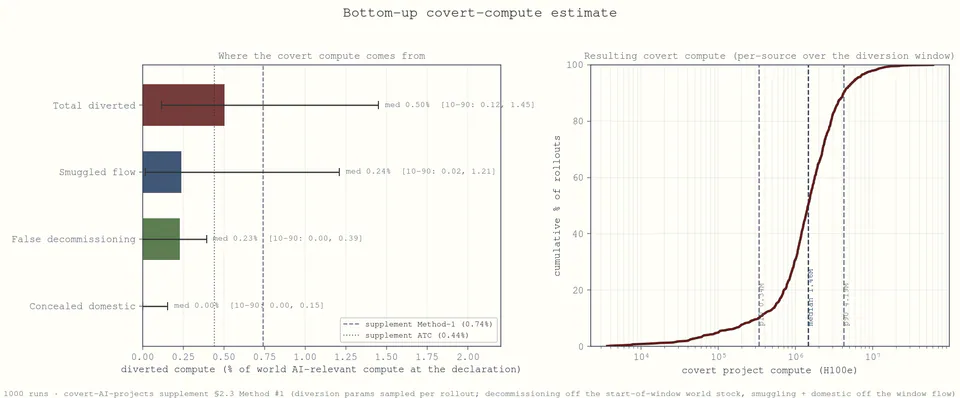
上で論じたすべての手法を集計した、転用される計算資源の総量の分布。
手法2:軍事支出にもとづく推計
以下の数値は、主に妥当性の確認に使うものなので、手法1の数値ほど厳密には推計していない。
パラメータの推計値とその根拠
パラメータ | 推計値 | 根拠 |
2028年の中国の軍事支出 | 4,000億ドル 80%:[3,500億, 4,570億] 対数正規分布 | 中国の2023年の公式の軍事予算は2,964.4億ドルだった。それ以前の10年間はほぼ直線的に伸びており、年平均132億ドルずつ増えている。これを2029年まで外挿すると、公式の軍事支出は3,624億ドルに達すると予測される。 私たちは、SIPRIによる軍事支出の推計(公式予算より範囲が広い)を外挿したものに近い値を使う。 |
中国が年間予算のうちAIサーバーの秘密購入に費やせる割合 | 2% | 何の根拠にも依拠しない直感的な推測。Claudeに尋ねたところ、15%〜20%程度の数値を示した。 |
2028年の最新の米国製AIサーバーのH100eあたりの価格 | 8,000ドル | プランAのサイドパネルのデータの2028.0と2029.0の値の幾何平均。 |
密輸による上乗せ率 | +100% [+50%, +200%] | |
廃棄サーバーの値引き率 | -50% | 米国市場のH100eあたりの価格より安いのは確かだ。そうでなければ、米国で計算資源を買ってリサイクル業者に直接売る裁定取引ができてしまう。ただし中国の情報機関は、市場を押さえる必要があるので、リサイクル業者に通常より少し高く(たとえば1.2倍)支払う必要があるかもしれない。あるいは、クラウド事業者の幹部に特定のリサイクル業者を使うよう指示するだけかもしれないし、本物のリサイクル業者を廃業に追い込むこともありうる。 |
廃棄分と密輸分の比 | 3:5.5 | 手法1の数値にもとづく。 |
2029.0時点の世界のH100e | 2億8,900万H100e | 計算資源の補足資料による。 |
上の表の分布をシミュレーションすると、**中央値は世界の計算資源の0.23%、80%信頼区間は[0.022%, 2.34%]**となる。
第3節:秘密のAIインフラを発見する
この節は前節よりも推測的な内容を多く含む。私たちは関連するどの分野の専門家でもなく、重要な考慮事項を見落としているかもしれない。
この節では次のことを取り上げる。
-
秘密プロジェクトを発見する手法(第3.1節)
-
秘密プロジェクトがこうした発見の手法を逃れるために取りうる戦略(第3.2節)
-
発見がどの程度うまくいくか、どれくらいの期間で成果が出るか、それが秘密プロジェクトの規模にどう左右されるかについての定量的な推計(第3.3節)
第3.1節:プランAにおける発見の戦略
手法1:排熱の追跡
エネルギー保存則により、データセンターに入る電力1メガワットごとに、何らかの形(大半は熱)で1メガワットが出ていかなければならない。データセンターから排熱する標準的な方法は、宇宙から見える特徴的な痕跡を残す。こうした痕跡を隠したり偽装したりすることが、秘密データセンターを隠すうえでの最大の制約になると思われる。
最新のAIサーバーは液冷を前提に設計されており、冷却材をIT機器に循環させて熱を吸収する。冷却材は熱を水に渡し、その水は通常、データホールの外に送り出されて屋外のチラー(冷却装置)で冷やされる。チラーには空冷式と水冷式がある。
空冷式のチラーは、フィン付きの凝縮コイルに冷たい空気を通し、空気を約10〜15℃温める。チラーを直接見えないように隠すことはできるが、温まった空気は最終的に大気中へ逃がさなければならない。そして空気が抜ける開口部は、周囲の表面より高い温度に落ち着く。こうして温まった表面は赤外線を放射し、それは宇宙から見える。高温の排気口の赤外線シグネチャを最小限に抑える技術は存在する(たとえば、F-117のような低被探知性の航空機に使われている)。持続的な衛星監視に対してこれがうまく機能するかについてはやや懐疑的だが、可能性はある。もちろん、排気口を見えなくすることが厳密に必要なわけではない。正規の産業施設の一部に偽装してもよい。
水冷式のチラーは、データセンターの冷却ループの熱を別の水の流れに移し、その水を冷却塔で蒸発させる。気象条件によっては、水蒸気が凝結して目に見える雲になる。これを常に隠し通すのがどれほど難しいかはわからない。
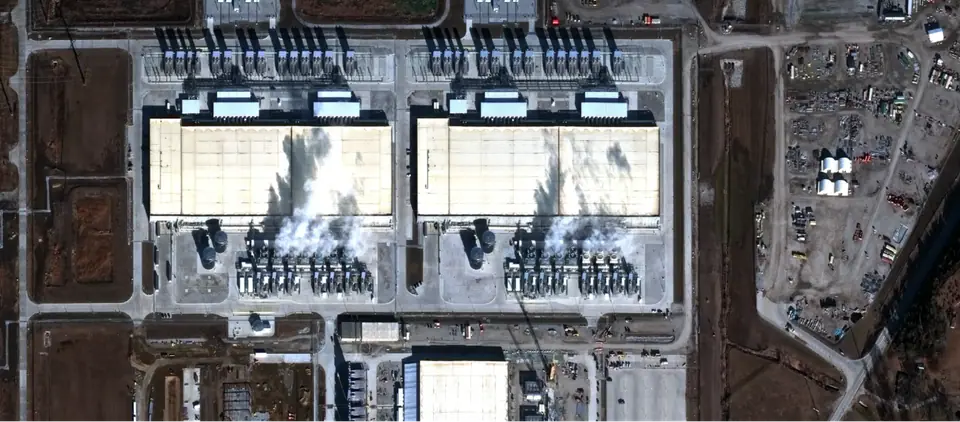
Google Council Bluffs(East)データセンターの冷却塔の上に見える凝結。このデータセンターは約190MWの熱を排出している。
もう一つの排熱方法は、温水をそのまま川や海に流すことで、原子力発電所の冷却によく使われている。赤外線で見える熱プルームを生じさせずにこれを行うのは難しい。とりわけ、数年にわたる運転期間で時間平均をとれば、ごくわずかな温度差まで分解できるからだ。既存の熱源に紛れさせて熱の痕跡を隠したり、深い位置に多孔式の拡散放流管を設けて、発見されない程度に広い範囲へプルームを拡散させたりすることは可能かもしれない。
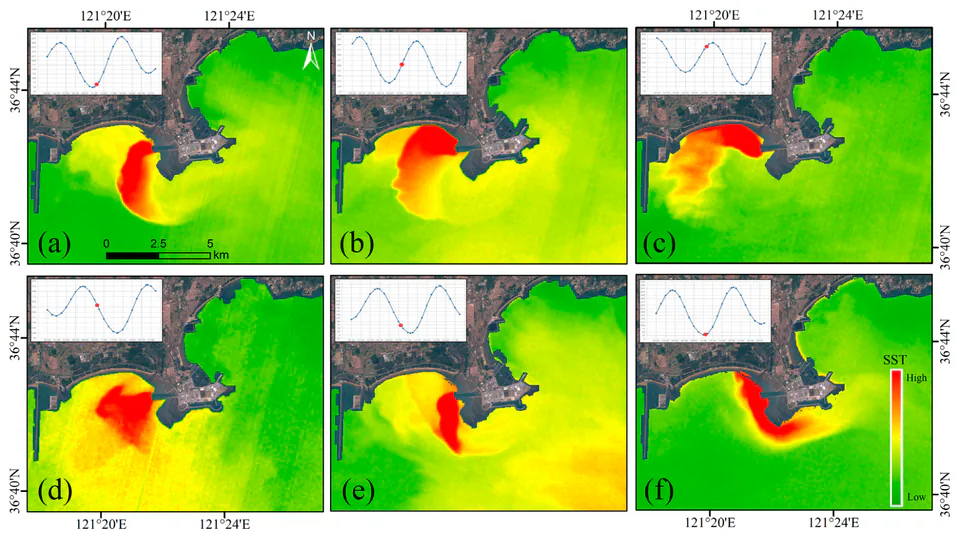
海陽原子力発電所の熱プルームを捉えたLandsatの画像。中国東部沿岸にあるこの発電所では、1.1GWeの原子炉2基が冷却されている。
手法2:その他の画像情報(IMINT)・計測情報(MASINT)
干渉合成開口レーダー(InSAR)は、秘密データセンター計画の建設段階を発見するのに役立つ可能性がある。ローレンス・リバモア国立研究所(LLNL)の技術報告書は、トンネル掘削によって生じる地殻のごくわずかな変位を時間を追って測定することで、既知の場所での地下建設の特徴を把握するためにInSARを使う方法を調べている。ただし、未知の施設に気づくことにはあまり向いていないようだ。それでも、疑わしい場所が実際に秘密データセンターであることの追加の証拠を得るのには役立つかもしれない(たとえば、掘削された空間の形状を観測するなど)。
地下を掘削すれば、土や岩(「掘削残土」と呼ばれる)を地上に運び出さなければならない。これを隠すのは難しいかもしれない。選択肢としては、掘削を別の産業プロジェクトに紛れ込ませる、トンネルの入口を建物の中に設けて残土をトラックで運び出す、残土を川に捨てる、などがある。
最後に、米宇宙軍と国家偵察局(NRO)が現在開発中の宇宙配備型の地上移動目標指示(GMTI)システムを使えば、計画の進み具合によっては、秘密データセンターの建設や運用に関わる個々の物流車両を追跡できるかもしれない。これが発見にどれほど役立つかはわからないが、「中国国内で遮るもののないすべての車両を映し出す動画の地図」とみなせる程度に機能するなら、プランAがもたらす膨大なAIの労働力と組み合わせて、きわめて有用になりそうだ。車両を追跡するためにシステムを狭い範囲に向ける必要があるなら、人里離れた場所の発見にはあまり役立たなくなるが、すでに疑わしいとされた地域について証拠を集めるには、依然として役に立つ。
手法3:信号情報(SIGINT)
秘密データセンターの建設には、専門の請負業者が必要になる。たとえば、後述の見えないデータセンターを建設する戦略に従うなら、次のものが必要になる。
-
掘削
-
隠された冷却用の取水施設と放水口を設計・建設するための水理工学
-
原子力工学
-
通常のデータセンター計画に関わるすべての請負業者と専門分野
-
場合によってはTEMPEST(電磁波漏洩対策)またはそれに相当するもの
米国は、秘密プロジェクトにほぼ確実にいずれかが関与するような、比較的少数の請負業者を特定できる可能性がある。それらすべての企業にサイバー作戦を仕掛ければ、秘密プロジェクトの存在を否定するのに十分かもしれない。これを実行できるかどうか、どのような結果を招きうるかについては、確かなことはわからない。関連する公開情報としては、2010年のNSAによるHuaweiへの侵入がある。報道によれば、NSAはこのとき「[Huawei製のネットワーク製品]の仕組みに関する情報を入手し、同社の最高幹部の通信を監視した」という。
手法4:人的情報(HUMINT)
秘密AIプロジェクトについて、罪に問われうる全容を知る人物は、防諜部門がおそらく入念に身元を審査するだろう。それでも、外国の情報機関の協力者がこの計画について知らされる可能性はありそうだ。当然ながら、その可能性を見積もるための公開情報はほとんどない。私たちの漠然とした印象では、中国は西側の人的情報収集にとって最も難しい国の一つとみなされている。
協定の一部として、米国は内部告発者制度を交渉で勝ち取るべきだと推奨する。この制度のもとでは、計算資源の転用、秘密AIデータセンターの建設、その他の協定を損なう活動の証拠を持つ者は誰でも聞き取りを受けられ、報復からの保護が保証される。このような制度はAIと無関係な通常の対中人的情報収集にも役立ってしまうことを考えると、外交上どこまで認めてもらえるのが現実的かはわからない。中国での内部告発者制度は、米国が運営するより、中立的な第三者が運営するほうが受け入れられやすいかもしれない。
手法5:AIによる決め手
注:この節の内容はすべて、極端なAI能力を前提としているため、この文書のほかの部分よりはるかに推測的である。
プランAのもとで、私たちはきわめて高性能なAIまでスケールし、あらゆることで人間のトップ専門家並みのAIに到達する。その結果、経済と科学の進歩が加速し、発見の能力も大きく向上する可能性がある。
-
信頼できる嘘発見器。 AIは信頼できる嘘発見器の開発を加速させうる。既存の嘘発見器(ポリグラフなど)は比較的簡単にだませる。信頼できる嘘発見器は、通常の人類の技術発展の中でも近いうちに開発されるかもしれないが、極端な水準のAI能力があれば、その時期を早められる。嘘発見器の開発が政治的にどこまで受け入れられるかもはっきりしない。秘密プロジェクトを抱える政権が、原則論を盾に嘘発見器の使用を拒否できるなら、嘘発見器は役に立たない。一方で米国は、中国や他の当事国が高官を嘘発見にかけることに同意しないかぎり、協定から離脱すると迫ることもできる。
-
プライバシーを守るAI検証技術。 AIを使えば、立ち入った検証をプライバシーを守る形で、つまり許容できない情報を漏らさずに行えるようになるかもしれない。たとえば次のように実施できる。まず、膨大な数のセンサー(カメラや温度計など)と移動ロボットを中国全土に配置する。米国がそのすべてを観測できれば、中国に秘密プロジェクトがないと確信できるだけの規模にする。次に、その情報をすべて、中国国内の安全なサーバー上で米国が学習させたAIに渡し、懸念すべき兆候がないか分析させる。最後に、AIには調査結果のごく大まかな要約(たとえば「中国は秘密プロジェクトを運営しているか?」への答え)だけを伝えさせ、残りの情報は削除する。原理的には、この方法によって、機微な国家機密を明かすことなく、秘密プロジェクトの存在を実質的に否定できるほど立ち入った検証が可能になりうる。
-
極端な産業的検証。 プランAのもとでは、2035年までに米国の実質GDPが現在の25倍に成長する。これによって、並外れた産業能力が発揮できるようになる。極端な場合には、関連するすべての製造・産業プロセス(たとえば秘密プロジェクトの排熱を隠すのに使われうるアルミニウム工場)を解体し、検証済みの場所(つまりロボット経済特区)で置き換えたり組み立て直したりすることもできる。この場合も、そのコストを払う政治的な意思がないかもしれない。それでも、強い圧力がある場合(たとえば、双方が協調的なプランAの体制を続けることを強く望んでいるが、秘密プロジェクトの証拠がいくらかあるため、一方がより高い保証を求める場合)には、十分に起こりうる。プライバシーを守るAI検証と組み合わせれば、なおさらだ。
プランAの期間を通じて、AIは膨大な科学的進歩を遂げるだろう(おそらく2030年代を通じて、人間の進歩に換算して数百年分に相当する進歩)。歴史上の技術進歩は、秘密プロジェクトの発見に役立つさまざまな技術を生み出してきたが、その多くはずっと前に予測するのが非常に難しいものだった(衛星による監視など)。こうした進歩はすべて、予測しにくい形で発見の手法の改善につながると考えるべきだ。同様に、技術の進歩は秘密プロジェクトの隠蔽にも役立つと考えるべきだが、全体としては、技術の進歩は隠蔽よりも検証に有利に働くだろうというのが私たちの見立てである。
第3.2節:秘密プロジェクトが発見を逃れる戦略
この節では、秘密プロジェクトが発見を逃れるために取りうる戦略(「見えない」ものと「偽装した」ものに分類する)を取り上げる。
秘密データセンターはどの程度分散させるのか
多数の小さなデータセンターではなく、一つの大きなデータセンターにするのはなぜか。秘密プロジェクトは、計算資源1単位あたりの発見ハザードを最小にしようとするはずだ。十分に小さな規模(たとえば8×H100のサーバー1台)では、1拠点あたりの発見ハザードは拠点の規模に対して線形より緩やかにしか増えないと思われる(8×H100のサーバー4台を4つの異なる都市に置けば、4台すべてを一つのラックにまとめた場合より発見リスクが高くなる)。したがって、計算資源1単位あたりの発見ハザードを最小にするには、1拠点あたりの発見ハザードが拠点の規模に対して線形より急速に増え始める点まで、あるいは何らかの別の制約でそれ以上規模を広げられなくなるまで、拠点の規模を大きくすべきである。
手法1:偽装データセンター
「見えないデータセンター」と比べると、「偽装データセンター」には、特定の目に見える施設が集中的な監視や、場合によってはチャレンジ査察の対象になりうるという欠点がある。たとえば米国は、中国で電力負荷の大きい産業施設のランキング表を作り、衛星を割り当てて頻繁に再訪させ、表向きそれらを運営している企業について信号情報を収集し、そこで働く人や近くに住む人を情報源として獲得しようと試みることもできる。目に見える物質を生産する工場なら、施設からの出荷を直接追跡し、排熱量と比べることもできそうだ(たとえば、アルミニウム製錬所に偽装したデータセンターは、同程度の電力を消費する製錬所に比べて、生産するアルミニウムがはるかに少なくなる)。データセンターを総電力消費のごく一部(たとえば1%〜10%)にとどめれば、これを回避できるかもしれないが、そうするとデータセンターの規模は10MW〜100MW程度に制限される(10GW以上の電力負荷を持つ産業施設は、私たちの知るかぎり存在しない)。
一方、「見えないデータセンター」はより複雑な工学を必要とし、実現できない可能性もある。とりわけ、プランAの期間中にAIが生み出すかもしれない新しいリモートセンシング能力に対しては難しい。
隠れみのとして役立ちそうな産業施設の種類には、具体的に次のようなものがある。
-
アルミニウム製錬所。中国は年に4,300万トンのアルミニウムを生産しており、アルミニウム製錬所は年産100万トンあたり約1.6ギガワットを必要とする。単純に計算すると、中国には約70GWのアルミニウム製錬能力があることになる。
-
原子力発電所。
-
火力発電所
例:アルミニウム製錬所の下にデータセンターを隠す
この例では、IT機器を地下に置き、掘削はすべて屋内で行って、目に見える残土の山や掘削機械を避ける。電力は、敷地内の石炭火力発電所や系統連系から(表向きは製錬所を支えるという名目で)振り向ける。そうなると、施設が生産するアルミニウムは、その電力消費や熱の痕跡から見込まれる量より少なくなる。しかし私たちの調べたかぎりでは、国家技術手段を使ってアルミニウム製錬所から実際に出荷されるアルミニウムの量を正確に測ることはできないようだ。データセンターとアルミニウム製錬所では熱の痕跡が異なるが、アルミニウム製錬所の放熱に似た形でIT機器の熱を逃がす冷却システムを設計することが、熱力学的に不可能だとは言い切れない。
手法2:見えないデータセンター
データセンターを何もないように見せるのは、別の何かに見せかけるよりも複雑に思われる。私たちが特定した最大の難題は、IT機器(と敷地内の発電設備)が出す熱を隠すことだ。理論上は、すべての設備を地下に建設して衛星の目から遮れるが、熱はどこかで施設の外に出さなければならない。リモートセンシング、IMINT、MASINTの節を参照。運用中に出続ける痕跡に加えて、初期の建設期間にも活動の兆候が現れるが、発見を逃れた前例もいくらかある。
例:貫流冷却+原子力
考えられる戦略の一つは、地下施設を新たに建設するか既存のものを拡張し、IT機器に電力を供給するのに十分な数の小型原子炉をそこに設置し、沿岸の深い水中に取水施設を建設したうえで、放水口には深層の多孔式拡散放流管のような設計を使い、温まった冷却水が水面に届く前に赤外線のノイズフロア以下の温度まで薄まるようにすることだ。拡散放流管をその要求を満たすように設計できるかはわからないが、ありえそうに思える。もし可能なら、この種の施設は、稼働後にリモートセンシングで発見するのはかなり難しそうだ。原子炉は燃料補給がまれか、まったく不要なので、中国の電力網や天然ガスの供給網などを完全に把握していても、施設の所在を突き止めるには不十分だろう。隠された原子炉を発見する既存の技術がこのケースで効果を発揮するとは考えていないが、繰り返しになるが、私たちは専門家ではないので間違っている可能性もある。
混合戦略
中国は、施設の一部の側面は「見えなく」し、ほかの側面は偽装することもできる。たとえば、IT機器と発電設備を物流倉庫の中に置く(トラックでディーゼル燃料の搬入を受けるなど)ことも可能かもしれない。物流倉庫は数が多いので、先に述べた集中的な監視という懸念が当てはまらないかもしれない点が利点だ。しかし物流倉庫は通常あまり熱を出さないので、冷却については、上で論じた手法のいずれかで「見えなく」する必要がある。
第3.3節:定量的な推計
転用された計算資源には、どれだけのデータセンター容量が必要か
パラメータの推計値とその根拠
パラメータ | 推計値 | 根拠 |
2026.0時点の米国におけるH100eあたりのIT電力(最大稼働時) | 833 W/H100e | DGX GB200 SuperPODのリファレンスアーキテクチャの6ページ。NVL72サーバー8台からなる1スケーラブルユニットのTDPは1.2MWなので、InfiniBandとEthernetのネットワーク、管理ノード、ストレージを含めてサーバー1台あたり150kWになる。 これをサーバー1台あたり2.5 * 72 H100eで割ると、833 W/H100eになる。 |
2026.0〜2028.0の米国の電力効率の年平均の向上率 | 1.37倍/年 | プランAのサイドパネルのデータの関連する3つのセルを平均し、(1.3*1.4*1.4)^(1/3) = 1.37。 |
密輸チップの代表年 | 2028.6 | おおよそ密輸が起こる時期。指数関数の中間点での値はその平均を過小評価するので、それを補正するためにわずかに後ろにずらした。 |
転用期間中の中国国産チップの電力効率の差 | 3.7倍 | プランAのサイドパネルのデータの関連する2つのセルの間の値をとった。 |
廃棄チップの代表年 | 2026.5 | おおむね妥当に思える。廃棄チップは一般にこれより古いが、量が年2〜4倍程度で増えているため、計算資源としては新しいチップの占める部分が大きくなる。 |
秘密データセンターのピーク時PUE | 1.4 | 最大稼働時の施設全体の電力使用量を、最大稼働時のIT電力使用量で割った値。こちらの値を使う。秘密データセンターなので上方修正すべきかもしれないが、はっきりしない。必要に応じて柔軟に運用できるプロジェクトについて、理論上の最大電力を追うべきなのかどうかもはっきりしない。当面は1.4のままにしておく。 |
上のパラメータ値を使うと、施設全体の電力が1GWの秘密データセンターで、2028年頃に密輸された米国製チップなら190万H100e、廃棄された米国製チップなら約100万H100e、2028年頃に国内生産されたチップなら52万5,000H100eを動かせる。
建設にはどれくらいの時間がかかるか
現在の状況について、Epochはギガワット級のデータセンターはおそらく2年以内で建設できるとしている。
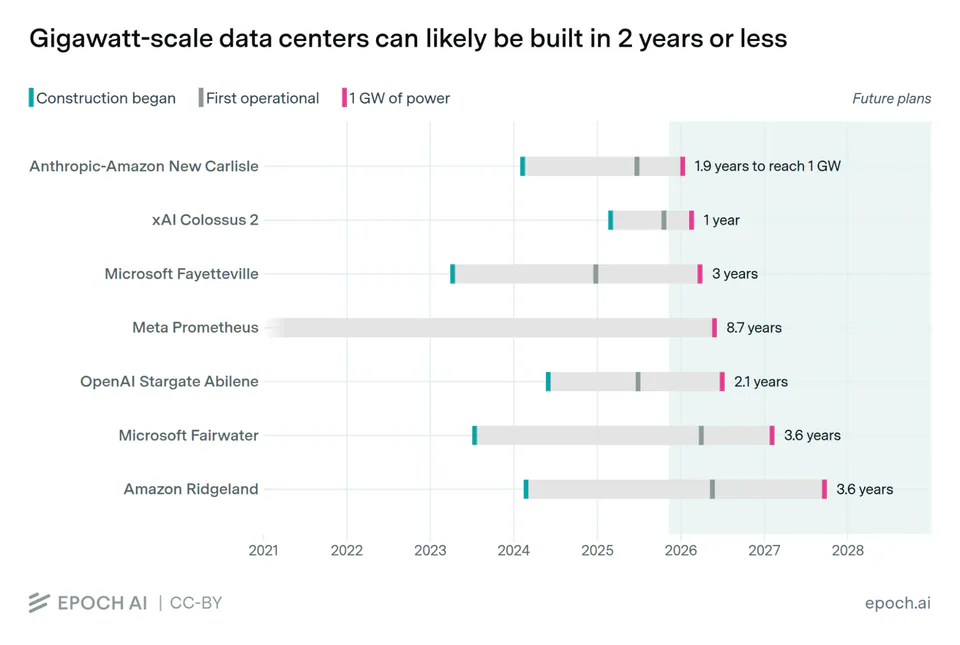
建設がこれより速くなることを示す考慮事項:
-
2029年までには、この規模のデータセンターの建設はもっとありふれたものになり、おそらく現在より速くなる。
-
さらに、中国政府の最優先の国家課題になれば、通常より速いスケジュールが可能になるかもしれない。
-
プランAでは、建設労働の大部分がロボットによって自動化されると予測している。その時期は不確かで、協定の初期には大きな要因にならないかもしれない。
建設がこれより遅くなることを示す考慮事項:
-
秘密の地下施設には、通常のデータセンターには必要ない特注の設計・施工が必要になる。
-
建設のスピードは、労働力や支出以外の要因に制約されるかもしれない(たとえば、人里離れた場所で大きな地下空洞を掘削する場合、衛星から見える残土の山を作らないように広い範囲に分散させるため、掘削残土(土や岩)を運び出せる速度には上限があるかもしれない)。
-
人間の労働力が大量に必要なら、スパイを避ける必要から、作業員を集めるのが難しくなるかもしれない。これとは別に、プロジェクトの各部分を区画化すれば、並行して作業できる度合いが制約されうる(たとえば、IT機器がそこに設置されることを知る人の数を減らすため、IT機器を設置する前に掘削を終えたいと考えるかもしれない)。
点推定値としては2年を使う。
さまざまな規模の秘密プロジェクトは、どれだけの発見リスクを負うか
発見確率の推計には、次の方法を用いる。
-
発見ハザードが拠点の規模に応じてどう増えるかはわからない。発見ハザードが拠点の規模に対して線形より急速に増えると考える理由がないので、最適な戦略は「実現可能性の制約の範囲で拠点をできるだけ大きくする」ものに近いと考えている。上の戦略を踏まえ、最適な拠点規模(ここでの「最適」は、基本的に「実現可能な最大の拠点規模」を操作的に定義したもの)について分布を推計する。
-
「最適な拠点規模」がいくつかの値をとる場合のそれぞれについて、そのような拠点が1か所の場合と10か所の場合に、プランAの10年間で発見される確率を推計する。
-
こうした直感的な推計を、共有フレイルティモデルで補間する。こうすれば、任意の量の計算資源を運用する拠点について、10年間の発見確率を算出できる(特定の最適な拠点規模を条件とするが、それについて周辺化することもできる)。
-
3年間の発見確率も推計し、ワイブル型のハザード率(ハザード率が時間のべき乗で変化する)で時間を補間する。そうすると、任意の量の計算資源を運用する秘密プロジェクトについて、時間を追った生存曲線を描ける。
現時点での「発見」の操作的定義は、物理的なインフラに焦点を当てている。次の条件を求める。
-
米国が疑わしいと評価した場所のうち、秘密データセンターである可能性が最も高いと評価した候補地が、実際に秘密データセンターである。
-
米国の情報機関が、この候補地は秘密データセンターであると50%を超える確信度で評価している(このしきい値はもっと高くすべきかもしれない)。
この操作的定義のねらいは、米国がその場所の査察を要求し、さらなる圧力をかけるために必要なら国際社会に公表しても、外交上問題ないと感じられる時点に合わせることにある。
残念ながら、時間の制約のため、上の手順で使った数値は、私たちが検討した発見の手法と隠蔽の戦略についての直感と定性的な推論だけにもとづいている。歴史的な参照クラスによる手法を適用することも可能に思えるし、秘密プロジェクトの歴史上のさまざまな事例も非公式に調べた。しかし、今回のケースと見つかった歴史上の事例との間には多くの非対称性があり、非公式な調査からも明確な結論が得られなかったため、参照クラスにもとづく定量的な推計に時間を割く価値はないと判断した。
したがって、時間を追った発見確率の推計は、きわめて推測的なものとして扱うべきだ。それでも、国家が秘密プロジェクトを発見できるかどうかは私たちの見解を左右する重要な入力なので、推論の透明性のためにあえて掲載する。
最適な拠点規模の分布
パラメータ | 推計値 | 根拠 |
1MW超が実現不可能または最適でない確率 | 0% | モデル化のための近似。 |
10MW超が実現不可能または最適でない確率 | 10% | 直感的な推測。系統から10MWを受電し、10MWの熱を放散する産業施設には多くの種類がある。中国にはそれぞれの種類の施設が数百から数千あるだろう。そのうち少なくとも一つが秘密データセンターの偽装として機能する可能性はきわめて高そうだ。 |
100MW超が実現不可能または最適でない確率 | 35% | 直感的な推測。中国で100MW級の産業施設は少なくなるが、それでもおそらく1,000以上ある。ただしこの規模になると、別の何かに偽装するのではなく、施設を完全に隠すことに頼らざるをえないかもしれない。 |
1GW超が実現不可能または最適でない確率 | 80% | 私たちの評価では、1GW以上の貫流冷却で熱プルームを避けるには、(川ではなく)海での深層拡散放流管が必要になる。この規模で他の冷却方法(空冷式や水蒸気による冷却式のチラー)を見えなくするのは、ありえそうにない。 この規模の産業施設もいくつかあるが、あまり多くはないようで、チャレンジ査察の格好の標的として非常に目立つだろう。 このData Insightによれば、「米国の主要市場全体のMW加重平均」で、IT電力1GWあたりの施設の設備投資額は110億ドルである。 |
10GW超が実現不可能または最適でない確率 | 100% | モデル化のための近似。 |
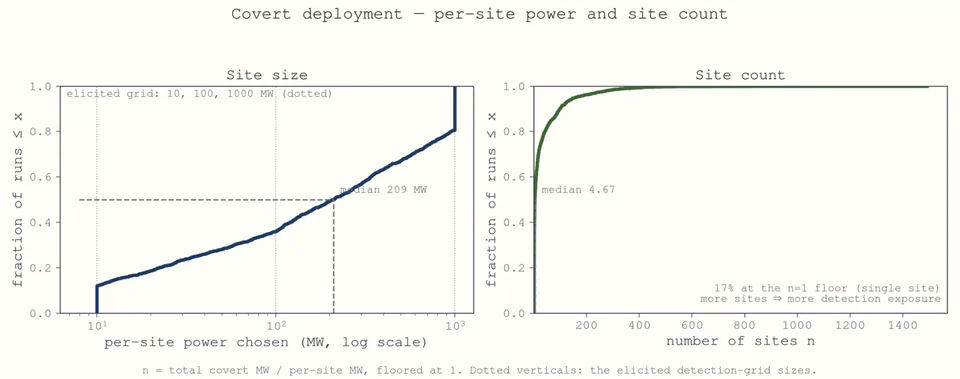
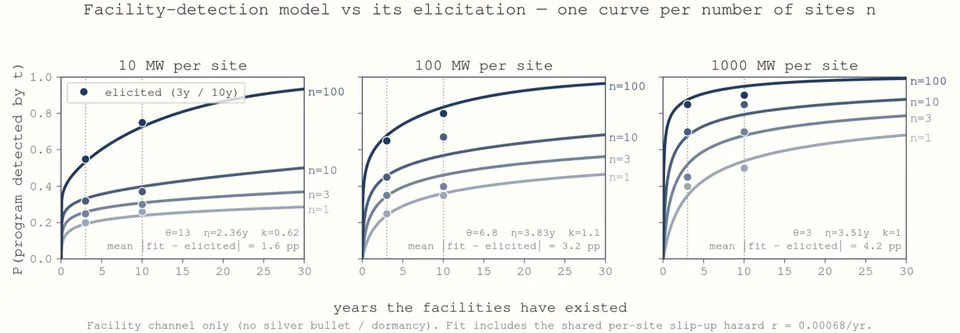
直感にもとづく発見確率(拠点の規模と数別)
これらの推計は、上で論じた単独で行う発見の手法だけを想定し、「AIによる決め手」が見つからないことを条件としている(最終的なモデルでは、それらを上乗せする)。「3年」とは「協定開始から3年」を意味する。
1拠点あたりの施設電力(MW) | 拠点数n | 3年までに発見される確率 | 10年までに発見される確率 |
10 | 1 | 0.20 | 0.26 |
10 | 3 | 0.25 | 0.30 |
10 | 10 | 0.32 | 0.37 |
10 | 100 | 0.55 | 0.75 |
100 | 1 | 0.25 | 0.35 |
100 | 3 | 0.35 | 0.40 |
100 | 10 | 0.45 | 0.67 |
100 | 100 | 0.65 | 0.80 |
1000 | 1 | 0.40 | 0.50 |
1000 | 3 | 0.45 | 0.70 |
1000 | 10 | 0.70 | 0.85 |
1000 | 100 | 0.85 | 0.90 |
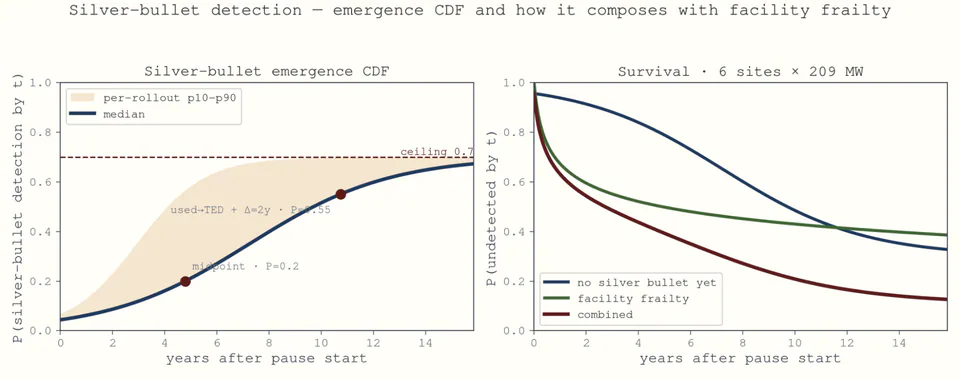
「AIによる決め手」が見つかる年の予測
このカテゴリーに入る何らかの手段によって、以下の各年までに秘密プロジェクトを発見できるようになる可能性について、トーマス(Thomas Larsen)の全体的な見解は次のとおりである(プランAの展開を前提とする)。
意志が強い場合 | 意志が弱い場合 | 理由 | |
2033 | 65% | 20% | 能力向上の軌道を前提とすれば、2033年までに嘘発見器が開発される可能性は五分五分だと思う。意志が強い場合、嘘発見器があれば、米国は中国が嘘発見を受け入れないかぎり協定から離脱すると迫れ、そうなれば秘密プロジェクトは露見する。さらに、ほかの経路が大きく役立つ可能性もいくらかある。特に、未知の未知がそうだ。 |
2037 | 95% | 55% | 2037年までには、優れた嘘発見器が開発されている可能性が高い(80%程度か)。意志が強い体制なら嘘発見器で十分だと思われるし、ほかの検証手法が成果を上げる可能性も非常に高い。必要な監視装置を何でも設置できるだけの産業能力があるだろうからなおさらだ。意志が弱い体制では、どうなるかについてそれほど確信が持てない。 |
これらの数値はすべて、ほかの発見の手法をすべて脇に置いたもの、つまり、ほかに発見する能力がまったくないと仮定したものである。
第4節:コンソーシアムの進歩が秘密プロジェクトを後押しするのを抑える
プランAでは、2030年代を通じて世界中の合法なプロジェクトが高性能なAIとロボット技術を開発する。この進歩の一部は秘密プロジェクトにも波及し、AI開発の世界的なモラトリアム(プランSのような)のもとに比べて、秘密裏にAGIを構築しやすくなる。それでも私たちの最善の推測では、協定の枠組みのもとでより高性能なAIを構築することには、アラインメント、権力集中の抑止、戦争の回避という利点があるので、このリスクの増加は引き受ける価値がある。その理由について詳しくは「考えうるプランの比較」の補足資料の議論を参照してほしい。
この節では、コンソーシアムのAIの進歩が秘密プロジェクトの研究開発にどの程度役立つかを左右する、プランAのさまざまな政策をまとめる。また、次のことも推計する。
第4.1節:関連するプランAの政策
提言1:研究の完全な透明性
プランAでは、すべてのフロンティアAIプロジェクトについて、AIのアルゴリズム、コード、ドキュメントを含むほぼすべてのAI研究が一般に完全に公開される。AIモデルの重み、学習データのかなりの部分、その他の少量の機微な情報は、データセンターの外に出ないようにする。
提言2:秘密プロジェクトへの後押しを防ぐための推論の監視
推論の監視と制限についてはこちらを参照。
秘密プロジェクトに拡散してほしくない能力を持つモデルについては、ゼロデータ保持(ZDR)の推論を提供する予定はない。ZDRの方針についてはこちらを参照。
提言3:モデルの重みのセキュリティ
モデルの重みのセキュリティを高い確度で確保することは、プランAにとってきわめて重要だと考えている。世界で最も能力の高い主体でもモデルの重みを盗めないと約95%の確信が持てるまで、コンソーシアムはおそらく協定前の能力水準から大きく先へ進むべきではない。これが実現する可能性の予測は、この補足資料の範囲外である。
第4.2節:秘密プロジェクトの戦略
経路1:コンソーシアムのモデルからの蒸留
現在、MinimaxやZhipuといった中国のAI企業は、OpenAIのような米国のフロンティアAI企業に比べて、研究開発用の計算資源に20〜30分の1程度しか支出していない。私たちの予測からすると、秘密AIプロジェクトは協定開始時点で、最先端のAI企業の約20〜30分の1の計算資源から出発することになりそうだ。そのため、秘密を守らなければならないことが重荷になるのは間違いないが、中国の秘密プロジェクトを運営する研究者は、当初は合法に活動していたときと比べて、計算資源の制約をそれほど強く感じないかもしれない。計算資源で優位に立っているにもかかわらず、米国のAI企業はモデルの能力でのリードを目に見えて広げられてはいない。
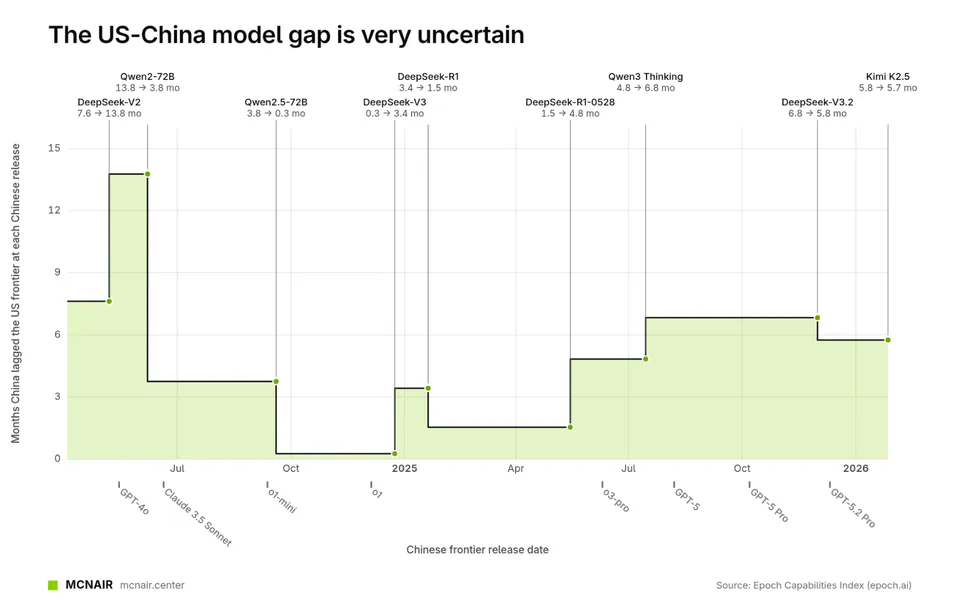
その主な原因は「蒸留」だと考えている。ここでの蒸留は広い意味で使っており、最先端のクローズドソースのモデルを使って合成データを生成したり、強化学習の軌跡を採点したりすることを指す。こうした手法を使えば、計算資源の面できわめて効率的に学習でき、場合によっては計算資源換算で1桁(1 OOM)を超える効果が得られる。
では、秘密プロジェクトは今日の中国のAI企業のように、フロンティアから3〜9か月の遅れにとどまれるのだろうか。一方で、秘密プロジェクトは協定開始時点で、今日の後発のAI企業にはない追加の後押しを得る。今日とは違い、すべての学習レシピが透明化されるからだ。各社が別々に持っていた知見が最初に共有されることで、協定開始時点ではコンソーシアムと秘密プロジェクトの双方のフロンティアがそろって前進する。他方でプランAは、たとえばAPIでモデルの中間出力を明かすことを企業に禁じるなどして、蒸留を抑えようとする。
こうした対策が、決意の固い敵対者にどこまで有効かはわからない。AI企業、アプリケーション、配備の数が多ければ、そのぶん攻撃対象領域も大きくなる。また政府が、自国のAIプロジェクトの一つに圧力をかけ、蒸留のための抜け穴を意図的に残させることもありうる。
蒸留によって不安定化をもたらす軍民両用の研究開発能力が拡散することは、何としても避けなければならない。こうした能力は、協定のかなり早い段階(たとえば、SARと人間のトップ専門家を凌駕するAI(TED-AI)の節目の間)で現れるかもしれない。そのため私たちは、コンソーシアムが継続的なレッドチーム実験を行い、研究者のグループに、秘密プロジェクトが直面するのと同様の状況で現行のフロンティアモデルの蒸留を試みさせることを推奨する。その結果によっては、より確かな保証が得られるまで、より高性能なモデルの外部への提供を停止する必要があるかもしれない。
経路2:コンソーシアムのモデルから研究開発の労働力を引き出す
推論用データセンターで動くコンソーシアムのモデルには、AI研究開発らしきあらゆる試みを検知する分類器が備わる(プランAでは、協定前の最高水準を超えてAI研究開発を後押しするモデルは、ZDRのもとでは提供されない)。こうした仕組みに対して試行錯誤を繰り返すのは危険に思われるので、有望な戦略とは考えていない。
全体として、コンソーシアムが有能であれば、この経路が少しでも機能する可能性はかなり低そうだ。仮に機能すれば、秘密プロジェクトは、AI研究開発、生物学の研究開発、その他の軍民両用分野で超人的な実験選択のスキル(つまり「研究センス」)を持つモデルを利用でき、進歩を大きく加速させられる可能性がある。
第4.3節:定量的な推計
パラメータ | 推計値 | 根拠 |
コンソーシアムのソフトウェア面の進歩のうち秘密プロジェクトに流出する割合 | 中央値:67% 80%信頼区間:[36%, 90%] ベータ分布 | 中央値についてはこちらの推計を参照。80%信頼区間は直感的な推測である(具体的には、p90を90%に設定してベータ分布を仮定したので、p10は必然的に36%になる)。 |
第5節:秘密プロジェクトはどのような場合に破局をもたらすか
破局をもたらすには、秘密プロジェクトは次の三つのうちいずれかを達成しなければならない。
-
覆せない能力面のリード。 秘密プロジェクトがコンソーシアムに対して十分なリードを得て、コンソーシアムが急速な開発競争に戻ったとしても、秘密プロジェクト(あるいはその後ろ盾の国家)が、以下のどの結果も阻止できるだけのAI能力に到達するのを止められなくなる場合。
-
勢力均衡を歪める能力。 秘密プロジェクトが、たとえば経済、軍事、政治の面で大きなリードをもたらすことで、地政学的な勢力均衡を大きく変える場合。その極端な形は決定的な戦略的優位、つまり秘密プロジェクトを持つ国に、競争相手に対する完全な戦略的優越をもたらすことである。
-
BATNAを歪める能力。 秘密プロジェクトのAIがホスト国の力を大きく高めるため、相手国が(不正を知りながらも)協定から離脱して単独で進もうとするより、協定にとどまるほうを選ぶ場合。BATNAとは、交渉が決裂した場合の最善の代替案のことだ。
どれも当てはまらなければ、(i) 秘密プロジェクトは覆せない能力面のリードを持たない(合法なプロジェクトは望めば追いつける)、(ii) すべての当事者が協定内での勢力均衡をおおむね保つ、(iii) すべての当事者が、離反が判明した国に秘密プロジェクトを停止させるため、協定からの離脱を信頼性のある形で脅しとして使える。これらが成り立っているかぎり、協定からの離反は破局にはならない。
これらの条件のいずれかを満たすために秘密プロジェクトが到達しなければならない能力水準を、協定を損なうAIと定義する。協定を損なうAIは固定された能力のしきい値ではない。そのしきい値は、他国が利用できる能力の水準に応じて時とともに変わる。
以下では、秘密プロジェクトが協定を損なうAIを構築するのがどれほど難しいかを論じる。
第5.1節:秘密プロジェクトが破局に至る経路
覆せない能力面のリード
秘密プロジェクトは計算資源で大きく劣っているので、覆せない能力面のリードを得るのはきわめて難しい。
合法なプロジェクトがTED-AIで能力開発を一時停止するまでは、秘密プロジェクトの能力の進歩の大部分は、合法なプロジェクトが開発した新しい学習レシピを取り入れることから生まれる(蒸留が起きていないと仮定した場合)。したがって、「実効学習システム性能」の差はハードウェアの差に等しくなる。シナリオのプランA開始時点では、秘密プロジェクトと最大の合法プロジェクトの差は約24倍(80%信頼区間:[115倍, 9倍])である(秘密プロジェクトが約150万H100eを保有し、最大の合法プロジェクトが研究開発に約3,600万H100eを使うと仮定)。
秘密プロジェクトには二つの利点がある。
第一に、安全のために減速しなくてよいかもしれない。プランAのある時点では、安全上の懸念から、能力の進歩が劇的に減速するか一時停止する。そうした状況でも秘密プロジェクトは独自にソフトウェア面の進歩を遂げるが、そのペースは非常に遅い。
第二に、透明性とアルゴリズムのセキュリティ確保の難しさのため、アルゴリズムは合法なプロジェクトから秘密プロジェクトへ流れるが、逆方向には流れない。
秘密プロジェクトが能力面のリードを得たとしても、コンソーシアムは計算資源をすべてAIの進歩に振り向ける方針に戻るだけでよい。協定開始時点で計算資源の差は約20倍(1.3桁)あり、2035年までには4.3桁に広がる。新たに生み出されたアルゴリズムがすべてすぐに秘密プロジェクトに渡るなら、これはまったく役に立たない。しかし実際には次のような事情がある。
-
アルゴリズムの中には規模に依存するものがあり、秘密プロジェクトより合法なプロジェクトにとって役立つ。
-
一部のアルゴリズムは秘密を守れるかもしれない(たとえば、私たちの推計では、プランAの期間中に流出するアルゴリズムは約67%にすぎない)。
-
徹底的な透明化の対象外のアルゴリズムについては、盗まれるまでに多少のタイムラグ(たとえば数か月)があるかもしれない。
勢力均衡を歪める能力
地政学的な勢力均衡を変えるために秘密プロジェクトが追求しうる能力として、私たちが知るかぎり最も有望なのは次のものだ。
-
説得/政治面での後押しのためのAI。 秘密プロジェクトが、たとえば『AI 2027』の開発競争エンディングに登場する2028年初頭のAIと同程度の能力を持つAIを手に入れられれば、ホスト国は政治的にほかのどの国よりもはるかに効果的に動けるようになり、はるかに大きな権力を得られる。説得AIの主な制約は、それがおそらく高い能力のしきい値にあることだ。
-
秘密裏のロボット増産。 秘密プロジェクトは、たとえば地下トンネルで大規模な産業拡大を可能にし、世界のほかの地域をはるかに上回る産業能力をもたらしうる。プランAのシナリオではロボットの生産にキャップ・アンド・トレードの体制が敷かれるので、これは特に重要になる。
-
軍事研究開発。 秘密プロジェクトが合法なAIより大幅に高性能なAIを持つ場合、あるいは合法なAIがすべて積極的な拒否の対象になっている場合、秘密プロジェクトは、より安く優れた兵器(ドローン、ミサイル、艦船、航空機、爆弾など)の設計を手助けできる。
-
未知の新技術。 ナノテクノロジー、精神のアップロード、ある種の生物工学、そして未知の未知がこれに含まれる。どれもきわめて大きな不安定化をもたらす。主な不確実性はその難しさ、つまり実現するのにどの水準のAIがどれくらいの期間必要かである。
軍事研究開発とロボットの増産については、他国に発見されない形で十分な成果を上げられるかどうかが主な制約になる。他国が気づけば、検証の強化を求めたり、さらなる軍備管理協定を求めたり、自国の生産を増強して軍事力の相対的な均衡を取り戻したりして対抗できる。
BATNAを歪める能力
秘密プロジェクトが中国のBATNAを大きく改善する主な経路は次のとおりだ。
-
計算資源に対する完璧な第一撃。 中国は協定から離脱して米国のデータセンターを破壊し、さらに (i) 米国の防護された重みやチップの備蓄を破壊するか、(ii) 協定が崩壊した場合に破壊されるはずだった計算資源の一部を守ることで、米国に対して非対称な優位を得られる。合法なプロジェクトに対する推論用計算資源の劣勢を覆すほどのサイバー面のリードがあれば、秘密プロジェクトは米国のモデルの重みの保管庫に侵入し、複製を破壊できるかもしれない。計算資源を守るには、おそらく相当な物理的能力、つまり秘密裏のロボット増産が必要になる。
-
協定の崩壊後にロボット生産の立ち上げを加速する。 たとえば、秘密裏にロボット研究で世界のほかの地域をリードしておけば、協定が崩壊したときに、より優れたロボットの設計から始められる。あるいは防護されたロボットの備蓄を築いておけば、そこから増産を立ち上げる際のロボットの初期台数を多くできる。
これについても、上の各項目と同様に、未知の未知(まだ知られていない新たな軍事技術など)がある。未知の未知は、私たちが特定したどの具体的な経路よりもおそらく恐ろしい。
第5.2節:「協定を損なうAI」の操作的定義
この補足資料の定量分析では、協定を損なうAIを時間とともに変わらない特定の能力のしきい値と仮定して、モデル化を単純化した。
具体的にどのしきい値を選ぶのか。現時点では、これを「人間のトップ専門家を凌駕するAI(TED-AI)」、つまりあらゆる分野でトップの専門家より優れたAIとして操作的に定義している。現在のAIの能力の分布はかなりでこぼこなので、TED-AIは得意なスキルでは大幅に超人的でありながら、苦手なスキルではトップ専門家並みにとどまるだろう。
-
なぜもっと高いしきい値にしないのか。 AIが人間の範囲を超えてしまうと、私たちが防御方法を知らない未知の新技術の可能性を抑えるのが難しくなる。さらに、TED-AIを超えた先の知能爆発はおそらくかなり速いので、しきい値を上げても大きな違いはないだろう。
-
なぜもっと低いしきい値にしないのか。 人間の範囲内のAIは、地政学的な不安定化をもたらしうる類の新技術を開発する可能性がはるかに低いと思われる。非常に大きな進歩(たとえば、迎撃ミサイルの大幅な低コスト化)でさえ、相互確証破壊(MAD)を損なうにはほど遠いように見える。
今後の分析でこの基準が改善されることを期待している。たとえば、「協定を損なうAI」のもう一つの妥当な操作的定義は、「合法なプロジェクトより高性能なAIすべて」だ。その理由は次のとおりである。
-
そもそもリードがなければ、秘密プロジェクトが覆せない能力面のリードを持つことはありえない。
-
防御側がより高い能力のAIを配備してレッドチームを行っているなら、同程度の能力水準のAIが地政学的な勢力均衡を変えることはおそらくできない。コンソーシアムの防御側は(たとえば脆弱性の発見と修正に使える)計算資源をはるかに多く持っているので、なおさらだ。これは合法なプロジェクトが取る戦略しだいであり、合法なプロジェクトがAIを軍事研究開発に応用することが認められているという前提に立つ。プランAでは現在、新たな超兵器の開発へのAIの利用について、一定の軍備管理上の制限を推奨している。この方針の主な欠点は、秘密プロジェクトが大きな軍事的優位を得るために使われる可能性が高まることだ。
ただし、この戦略では、おそらく必要以上に積極的な能力のスケーリングが求められる。
-
比較的低い能力水準(たとえば自動コーディングAI)で秘密プロジェクトがリードを得るのは、おそらく問題ない。その段階では、わずかな能力の差が軍事・経済面の勢力均衡を大きく変えるほどの力はないからだ。シナリオでは、2029年のごく短い期間(自動コーディングAIの前)に、検証体制を整えるあいだ合法な学習が一時停止される。そのため、シナリオ上は秘密プロジェクトが原理的にはこの間にリードを得られるかもしれない。ただし、ハードウェアの差があるので、実際にはその可能性は低い(さらに、既存の免除された軍事用データセンターを使うのでないかぎり、秘密プロジェクトがインフラを整えるにはおそらくもっと長い時間が必要になる)。
-
人間の範囲の上限に近づくと(たとえばトップ専門家レベルのAIかそれ以上になると)、わずかなAI能力の差が雪だるま式に膨らみ、あっという間に巨大な能力の差や政治権力につながる事態が容易に想像できる。超人的な政治戦略や説得のようなものの重要性が増し、それらに対してはほとんど防御のしようがない。
第6節:全体のリスク推計
この節の推計は、テイクオフの補足資料で説明したとおりに秘密プロジェクトの能力の進歩をシミュレーションした結果にもとづいている。
この節では、コンソーシアムのスケーリング戦略が、秘密プロジェクトが協定を損なうAIを開発するリスクにどう影響するかを定量化する。ここで評価するのは、「協定開始から一定の年数でTED-AIに到達することを目指し、その後は権限移譲を遅らせるリスクが利点を上回るまで、そこで一時停止してアラインメント研究を行う」という形の固定された戦略だけだ。これはやや非現実的である。実際には、プランAを実施する意思決定者は、得られた証拠にもとづいて柔軟に対応し、戦略を変えられるからだ。
たとえば、6年以内にTED-AIに到達するには膨大なソフトウェア面の進歩が必要になるという証拠を米国が得れば、コンソーシアムのほかの参加国に、ハードウェアの増強により多く頼る緩やかなスケーリングの軌道をとるよう働きかけ、秘密プロジェクトに流出するソフトウェアを減らせる。そうすれば秘密プロジェクトによるリスクは減るが、TED-AIに安全に到達する前に協定が崩壊するリスクは高まる。また、研究の完全な透明性の代わりにフィルタリング型透明性を採用することもできる。そうすれば秘密プロジェクトに流出するソフトウェア面の進歩の割合が小さくなり、秘密プロジェクトのリスクを同じ水準に保ったまま、より速くスケールできる。その代わり、安全性が損なわれ、協定の機能低下のリスクも生じる。
実際に負う秘密プロジェクトのリスクは、意思決定者がこうした要因をどう比較衡量してスケーリング戦略を選ぶかにかかっている。以下では、スケーリングの期間と権限移譲までの待機期間を変えると、負うリスクがどう変わるかを示す。
置いている前提のすべて
私たちは次のことを前提としている。
-
米国と離反しないコンソーシアムの参加国が、私たちの政策提言をすべて有能に実施する
-
中国が協定実施の1年前(つまり2028年)に、有能な転用計画を実行した
-
協定を損なうAIに到達する前に発見された秘密プロジェクトは、ただちに進歩を止める
-
協定を損なうAIをTED-AIとして操作的に定義する
-
協定期間中に重みの窃取は起きない
-
対象期間中に協定は崩壊しない。
2年でTED-AIを目指す | 5年でTED-AIを目指す | 8年でTED-AIを目指す | |
TED-AI到達時点の秘密プロジェクトのリスク | 7% | 8% | 8% |
TED-AI到達後5年待つ場合の秘密プロジェクトのリスク | 18% | 13% | 11% |
TED-AI到達後10年待つ場合の秘密プロジェクトのリスク | 20% | 16% | 15% |
具体的には、今日得られる証拠にもとづき、次のような進め方をした場合のリスクを推計している。
-
自動コーディングAIの節目のおよそ1年前にAI研究開発を停止してプランAを始動し(私たちのシナリオでは、2029年初頭の実施を意味する)、
-
その後6年間で、人間のトップ専門家を凌駕するAIまで安全にスケールするのに必要なソフトウェア面の進歩を遂げ(私たちのシナリオでは2035年初頭まで)、
-
さらに5年間、高い確度のアラインメントの解決策に向けて取り組む(私たちのシナリオでは2040年まで)
中国が有能に秘密プロジェクトを進め、それを隠し通すことに固執した場合、この進め方では、発見されるか権限移譲に至る前に秘密プロジェクトが協定を損なうAIを開発する確率が13%になる。
上の確率は、AI研究開発の根底にあるダイナミクスについての私たちの不確実性の全範囲に加えて、秘密プロジェクトのさまざまな戦略と対策の実現可能性についての不確実性からサンプリングして得たものだ。定量モデルの詳細はテイクオフの補足資料で説明している。繰り返しになるが、プランAを実施する意思決定者は私たちより多くの情報を手にするだろう。その情報によって、上の各戦略が負うリスクの差が、私たちの推計よりはるかに大きいことが明らかになるかもしれない。
これを具体的に示すため、AI研究開発とテイクオフのダイナミクスが私たちのシナリオのとおりに働くと確信できる一方、秘密プロジェクトが取りうる手段については依然として不確実な場合を考える。その場合、上の表は次のようになる。
『AI 2040』のテイクオフのパラメータを仮定した場合に、いくつかの戦略が負う秘密プロジェクトのリスク:
2年でTED-AIを目指す | 5年でTED-AIを目指す | 8年でTED-AIを目指す | |
TED-AI到達時点の秘密プロジェクトのリスク | 2.0% | 1.6% | 1.8% |
TED-AI到達後5年待つ場合の秘密プロジェクトのリスク | 18.8% | 8.8% | 5.2% |
TED-AI到達後10年待つ場合の秘密プロジェクトのリスク | 22.8% | 12.4% | 10.8% |
第7節:秘密プロジェクトへの対応計画
秘密プロジェクトに対する政策対応の主な目標は次のとおりだ。
-
秘密プロジェクトが協定を損なうAIを構築するのを防ぐ。 基本的に、合法なAIプロジェクトが秘密プロジェクトより強力なAIを持っている状態を保ちたい。これは知能爆発の初期にはそれほど重要ではないが、後になるときわめて重要になる。より優れたAI能力を持てば、すぐに覆せない地政学的なリードにつながりうるからだ。具体的には、協定を損なうAIとは、(i) 秘密プロジェクトに決定的な戦略的優位を直接もたらすAI、または (ii) 合法なAIプロジェクトが最速でAI能力を進める方針に切り替えたとしても、それを継続的に上回るペースで進歩できるAIを指す。
-
秘密プロジェクトの創設を抑止する。 プランAの開始時点で、米国と中国の双方が、自分が秘密プロジェクトを行えば、意味を持つ前に発見されるか、AIの進歩で追い越されるかのどちらかになり、しかもその結果は秘密プロジェクトを持たないより悪い、と確信している状態にしたい。
-
国際協力を維持する。 特に、秘密プロジェクトが存在しないのに、信頼の欠如からプランAが崩壊する事態、つまり一方が相手の秘密プロジェクトを疑って合意からの離脱を望む事態は避けたい。
-
人間レベルだが超知能ではないAIの期間を長く保つ。 人間レベルのAIがある期間は非常に価値が高い。アラインメントが最も進むのはこの期間だからだ。
目標1・2と目標3・4は緊張関係にある。秘密プロジェクトを防ぎ抑止するための中心的な手段が、プランAの枠内で能力の進歩を加速することだからだ。
この節の残りは次のように構成する。
-
まず、秘密プロジェクトへの対応として考えられる選択肢を論じる。
-
次に、全体的な戦略の大枠の例を論じる。
-
最後に、具体的なシナリオを検討し、それぞれにどう対応すべきかを示す。
第7.1節:秘密プロジェクトへの対応の選択肢
この節では、秘密プロジェクトのリスクが許容できないほど高く見える状況での政策の選択肢を取り上げる。これらの選択肢は並行して進められる。多くの選択肢(特に選択肢1〜4)は、中国との交渉を必要とする点に注意してほしい。
選択肢1:プランSに切り替える
多国間
米国と中国は、進行中のAI開発を全面的に停止するモラトリアムに合意できる。秘密プロジェクトが主にコンソーシアム主導のアルゴリズムの進歩から恩恵を受けている状況なら、これで秘密プロジェクトの進歩は遅くなる。秘密プロジェクトは独自に進歩を続けられるが、計算資源と労働力のボトルネックがあるので、そのペースははるかに遅い。全体として、発見を別にすれば、一定規模の秘密プロジェクトに追い越されるまでに合意のもとで確保できる時間を最大化できる。
もちろん、この選択肢にはプランSへの切り替えに伴う通常の欠点がある。秘密プロジェクトに関して言えば、上で論じた、秘密プロジェクトの抑止に役立つ「AIによる決め手」の登場も遅れるかもしれない。
プランSから抜け出す道は、(1) 改善された検証技術の開発に成功した、(2) 双方が相手に検証のためのより広いアクセスを認めることにした、(3) アラインメントが十分に進み、秘密プロジェクトを上回るペースで急速にスケーリングを続けられるようになった、(4) 秘密プロジェクトが差し迫った大きなリスクとなり、ミスアラインメントのリスクが秘密プロジェクトのリスクより小さくなった(それでも相当な大きさだが、そうでなければ(3)に当てはまる)、のいずれかである。
このうち最も望ましいのは(1)だ。その場合の計画は、秘密プロジェクトが制約要因にならないと確信できるほどの検証体制が整うまでAI研究開発を全面的に停止し、その後プランAに戻る、というものになる。
選択肢2:能力の進歩に占めるソフトウェアの割合を最小にするスケーリング戦略を採る
多国間
プランAでは現在、2035年にかけて、ソフトウェアのスケーリングを年約0.5桁、ハードウェアのスケーリングを年約0.5桁認めている。アルゴリズムの進歩を推奨する大きな理由は、協定の失効・崩壊のリスクにある。秘密プロジェクトが制約要因になるなら、アルゴリズムの進歩を最小限に抑え、拡散しないハードウェアだけでスケールすることもできる。アルゴリズムの進歩をゼロにするのはおそらく不可能だが(たとえば、安全性研究には能力向上の外部性が避けられない)、年約0.1〜0.2桁まで減らせるかもしれない。
選択肢3:アルゴリズムの進歩のセキュリティ向上を試みる
多国間
もう一つの方法は、アルゴリズムの進歩が拡散するのを防ぐ(あるいは拡散までの時間を長くする)ことだ。この場合も、秘密プロジェクトが主にコンソーシアムのアルゴリズムの進歩に頼っているかぎり、その進歩は大幅に遅くなる。主な難点は、開放性・透明性を求める姿勢と、アルゴリズムの秘密を守りたいという要請との間に大きな緊張関係があることだ。プランAの重要な要素である研究の完全な透明性は、ほとんどのアルゴリズムを意図的にインターネット上に公開する。アルゴリズムのセキュリティを高める選択肢については、透明性の補足資料で論じている。
アルゴリズムのセキュリティがどこまで成功するかによっては、より速い能力のスケーリングに切り替えられるかもしれない。これは当然ミスアラインメントのリスクを高めるし、この状況では秘密プロジェクトがすぐ後ろに迫っているので減速が難しい。したがって、望ましい立場とは言えない。
選択肢4:より強力な検証を受け入れるよう中国と交渉する
二国間
たとえば、中国は次のことに同意できる。
-
継続的で立ち入った物理的監視(たとえば、大きな水源への温度計の設置、関連する場所へのカメラの設置、電力網の監視)
-
秘密プロジェクトが存在しないことを示す機密資料へのアクセスの提供
-
秘密プロジェクトの候補地(たとえば、相当な排熱を出す産業施設や、大きな水源の近くのトンネルなど)の実地査察
-
機密データへのアクセス(たとえば、AIが秘密予算を閲覧し、AIに関係しそうなものがあれば報告する)
-
検証を免除される軍事用計算資源の上限の引き下げ
AIがこうした情報源にアクセスしてごく大まかな情報だけを報告できるような、実用的なプライバシーを守る検証があれば、この選択肢ははるかに現実的になる。あるいは米国が、より強力な検証の手段を提供しないかぎり協定から離脱すると、中国に信頼性のある形で警告することもできる。中国にとって協定の崩壊は非常に悪い結果なので、中国にはこうした譲歩に応じる動機がある。協定の崩壊は現状への回帰に近いもの(たとえば、米国がはるかに多くのAI計算資源を持つ開発競争への逆戻り)に等しいからだ。
選択肢5:検証の改善に向けて全力で取り組む
二国間
十分な時間があれば、改善された検証技術、たとえば上の選択肢を可能にするプライバシーを守る検証の開発に向けて、膨大な資源を投じて短期集中で取り組む価値があるかもしれない。この選択肢には、より高度なAIを利用できることが役立つ。より強力な検証を実施できる手段を持つことは一般に有用なので、ほぼどのシナリオでもこれを進めることを推奨するが、秘密プロジェクトが相当なリスクになっているシナリオでは特に有望である。
選択肢6:テイクオフの速度のモデル化を改善する
単独
秘密プロジェクトへの懸念は、テールリスク、つまりテイクオフがごくわずかな計算資源で私たちの考えより速く進むリスクに大きく左右されているかもしれない。少ない計算資源で知能爆発がどれほど速く進むかについて、より良い情報を得るために相当な資源を投じる価値があるかもしれない。わかりやすい基本線は、一般的なテイクオフの速度のモデル化(AI Futures Modelのようなもの)にもっと投資することだ。
より踏み込んだ選択肢は、「秘密プロジェクト凌駕ミニプロジェクト(CDMP)」を作ることだ。これは秘密プロジェクトの進歩を模擬する公認のプロジェクトで、発見を逃れられると私たちが考える量よりいくらか多い計算資源を与えられ、できるだけ速く知能爆発を起こそうとし、理論上はどの秘密プロジェクトも上回るペースで進む。この提案の主な欠点は、アルゴリズムの進歩が速くなることだ(それが秘密プロジェクト自体にも拡散し、さらに加速させるかもしれない)。それでも、テイクオフの速度について非常に不確実な状況では、CDMPから得られる経験的な観測によって、計算資源が大きく制約された状況でのテイクオフの速度をはるかに正確に推計できるので、差し引きで改善になるかもしれない。
選択肢7:協定から離脱してプランBに切り替える
単独
この場合は協定から抜けることになる。ただちに双方が互いの計算資源の大部分を破壊し、その後双方が開発競争に戻る。ただちに経済的な大惨事となり、ミスアラインメントのリスク、第三次世界大戦のリスク、権力集中を大きく高めるので、双方にとってきわめて悪い結果である。
この選択肢の主な利点は、交渉でのBATNAとして役立つことだ。協定から離脱するという脅しの信頼性を保っておけば、そもそも秘密プロジェクトが作られるのを抑止する助けになる。発見される可能性がかなりあると知りながら中国が秘密プロジェクトを作り、米国が発見すれば協定から離脱すると約束しているなら、中国がそもそも秘密プロジェクトを作るのはおそらく合理的ではない。
協定からの離脱の主な欠点は、実際には中国が誠実だったのに、何らかの理由で米国が中国の秘密プロジェクトについて過度にタカ派的な見積もりをしていた場合に離脱してしまうことだ(たとえば、計算資源の推計が外れていた、あるいは密輸業者の追跡が予想より難しかった、など)。そうした世界では、プランAを続けて、あらゆる面ではるかに低いリスクで済ませる選択肢があった。
選択肢8:その他の地政学的な譲歩
二国間
一般に、中国が離反しているのではないかと米国が疑う場合、米国は標準的な地政学上の手段を使って、離反を思いとどまらせられる。プランAのシナリオで特に注目すべき手段としては、両国に課されるロボットと計算資源の上限がある。
第7.2節:秘密プロジェクトの曖昧な証拠を得た場合の対応計画
米国が秘密プロジェクトの弱い証拠を得る具体的な例:
-
チップのサプライチェーンの追跡で、100万H100eが所在不明だと判明する。これらのチップが製造された記録は(たとえばNvidia、TSMC、Huaweiに)あるが、見つけられない。密輸業者の仕業かもしれないし、国家が後ろ盾となった秘密プロジェクトかもしれない。
-
中国が追加の検証を拒否する。たとえば、米国が秘密プロジェクトがあるかもしれない特定の一連の場所を疑っているのに、中国が米国の立ち入りを認めようとしない。正当な施設であれば中国が米国の立ち入りを認める可能性ははるかに高いので、これは秘密プロジェクトの存在を示唆する方向の材料になる。
-
米国が画像情報(IMINT)、公開情報(OSINT)、信号情報(SIGINT)から曖昧な情報を得るかもしれない。たとえば、衛星画像が大規模な地下建設を示唆していても、それがAI関連の秘密プロジェクトなのかを米国が確かめられないかもしれない。
-
中国から来ている可能性があるが帰属がはっきりしない、モデルの重みの持ち出しの試みに米国が気づく(これは必ずしも中国が秘密の計算資源を運用していることを意味しないが、証拠にはなる)。
基本的な対応:
-
秘密プロジェクトにより配慮したスケーリング戦略を採る。たとえば、アルゴリズムの進歩を最小限に抑える(選択肢2)。
-
検証を改善する。技術を改善する(選択肢5)とともに、その導入の拡大を交渉する(選択肢4)。
-
中国が検証の改善を拒否するなら、協定からの離脱を検討する(選択肢7)。対応のなかで米国が単独でできるのはこれだけだが、これが双方にとって悪いBATNAであるという事実が、中国に上の措置に同意するよう圧力をかける。
要するにこの提案は、秘密プロジェクトが重大な懸念であるという直接の証拠があるので、秘密プロジェクトのリスクに対してより慎重になるようプランAの各部分を少しずつ調整しつつ、プランAの中核的な性質は維持するというものだ。研究の完全な透明性、AIの幅広い配備、継続的で後戻り可能なスケーリングなどはそのまま続く。
第7.3節:米国が中国の秘密プロジェクトの明白な証拠を得た場合
米国が秘密プロジェクトの明白な証拠を得る具体的な例:
-
サイバー諜報(たとえばGPUのバックドア、機密文書の発見など)
-
衛星映像(たとえば建設現場やプロジェクトの熱の痕跡の発見など)
-
プロジェクト内部にいる文字どおりのスパイ
-
交渉中の中国による露骨な拒否(たとえば、非常に確かなプライバシーを守る検証技術があるのに、中国がその使用を拒否し、納得のいく理由を説明しない)
基本的な対応:
-
中国に、地政学面と検証面で大きな譲歩をするよう求める(選択肢8と選択肢4)。
-
中国がそうした譲歩に応じないなら、合意から離脱する(選択肢7)。
-
中国が十分な譲歩に応じるなら、検証の状況がどれほど良好かを評価し、継続する秘密プロジェクトのリスクの全体的な水準に見合った能力のスケーリング戦略を選ぶ。
この戦略が妥当なのは、(i) 中国を罰して戦略的に不利な立場に置き、そもそも秘密プロジェクトを行うことを抑止する、(ii) 双方が合理的に望むとおりプランAの協定を存続させる、(iii) 秘密プロジェクトが協定を損なうAIを開発するのを防ぐ、からである。
付録
有効でないと考える秘密プロジェクトの戦略
計算資源の取得
国内生産を遡って過少申告し、2028年より前のストックを転用する
このカテゴリーは、中国のチップベンダーによる2028年より前の販売を指す。これらの販売を少なく申告することも考えられなくはないが、新規生産を少なく申告する(それ自体がすでにかなり難しそうな)作業よりさらに難しいと思われる。
パラメータ | 推計値 | 根拠 |
国内生産を遡って隠蔽することが実現可能である確率 | 7% | 遡らずに行う場合の実現可能性は約15%だと考えており、その数字を2で割っている。おおむね妥当だと思うが、中国の半導体エコシステムや、私たちの提案と同様の内部告発者制度の過去の有効性について詳しく知れば、見直すかもしれない。 |
上の実現可能性を条件として、2028年より前の国内累積生産量のうち、隠蔽してデータセンターから取り除ける割合 | 5% p90 = 7%のベータ分布。 | 直感的な推測。p90は、「中国のハイパースケーラー1社分」(たとえば10〜20%)を消すのはあまりにも目立つ、という考えにもとづく。ただし、これは中国にある計算資源の総量からハイパースケーラー1社分を消すこととは違う点に注意。その総量の一部は、合法に輸入された、あるいは密輸された米国設計のチップだからだ。 |
中国が生産する計算資源の世界に占める割合がおおむね一定だと仮定し、2028年のフローを考慮すると、[0, 1.6%]を台とするベータ分布が得られ、**この経路から得られるのは、そもそも実現可能だという条件のもとで、協定前の計算資源の中央値0.08%**となる。
中国以外の秘密プロジェクト
この補足資料は、中国が秘密プロジェクトを行う可能性に焦点を当てている。しかし、中国以外の国が秘密プロジェクトを試みる可能性もある。この可能性は詳しく調べていないので、ここでの結論に確信はないが、暫定的には、秘密プロジェクトを行うのが最も現実的なのは中国だと考えている。理由は次のとおりだ。
-
中国より多くの計算資源を持つ国は世界で米国だけであり、計算資源の取得は秘密プロジェクトにとって中心的なボトルネックである(第2節を参照)。
-
米国のBATNAは中国のBATNAより有利なので、米国がプランAに合意しながら同時に計算資源の転用を選ぶ可能性は低いと思われる。
-
米国は中国に比べて、秘密プロジェクトを行う能力が低い。主な理由は次のとおり。
-
米国ではチップの取得がはるかに難しい。米国内では大規模なチップの密輸がなく、企業に大量のチップを廃棄させるもっともらしい口実もなさそうなので、秘密裏に計算資源を調達する主な道が断たれている。
-
米国は行政権に対する抑制と均衡がより強いので、秘密プロジェクトを立ち上げるのはおそらく政治的により難しい。また、チップ設計より下流の段階で米国に本社を置く企業はごくわずかなので、米国が関連企業に秘密プロジェクトへの協力(たとえば半導体企業に販売記録を改ざんさせること)を強いるのも難しそうだ。
-
特に中国に焦点を当てるのは、離反するのに最も有利な立場にある当事者は中国だと考えているからだ。これについては付録でさらに論じる。
私たちのモデル化によれば、配備する計算資源の量を意図的に抑えても、秘密プロジェクトの成功の確率は上がらない。
私たちのモデル化によれば、秘密プロジェクトの能力の進歩の速さは、大部分がコンソーシアムの進歩の速さで決まる。具体的には、私たちの透明性に関する提言のもとでは、進歩を速める主な手段(ソフトウェア面の進歩)が秘密プロジェクトも加速させる。そのため、「秘密プロジェクトを上回るために速く進む」ことは、たいてい逆効果になる。むしろ、リードを最大にする戦略は、ハードウェアの増強に制約された学習用計算資源のスケーリングのペースを保ちながら、ソフトウェア面の進歩をできるだけ少なくすることである。
そのうえ、研究の完全な透明性のもとでは、事実上すべてのAIアルゴリズムを私たちは意図的に公開している。
中国の先見性が低く、1年前ではなく3か月前にしかチップの転用を始めなかった場合、転用できる量は約3分の1になるかもしれない。米国の有能さが低く、協定までの1年間に密輸の割合を現在より減らせなかった場合、転用できる量は約1.5倍になるかもしれない。
この仕組みについては、検証の補足資料のこちらでさらに論じている。
先に述べたとおり、これを実行できるかどうか、どのような結果を招きうるかについては非常に不確かである。関連する公開情報としては、2010年のNSAによるHuaweiへの侵入がある。これは、正確な会計記録を得るのに必要な水準のアクセスと同等かそれ以上だったと思われる(たとえばNSAは、「[Huawei製のネットワーク製品]の仕組みに関する情報を入手し、同社の最高幹部の通信を監視した」)。
ここでいう「監査」とは、企業が購入、転売・譲渡、在庫として保有している計算資源の完全な記録を入手し、その企業が現在保有する計算資源をすべて実地検査することを指す。
同様のやり方で中国国内の生産者から直接チップを購入することもできるかもしれない。ただし、それをより難しくしたり異例なものにしたりする輸出規制が中国にあるかどうかはわからない。実際には、AI計算資源の戦略的な重要性を考えれば、2028年の生産のかなりの部分を輸出すること自体がかなり異例に見えるだろう。
投入物(ロジックダイやHBMなど)を備蓄しておき、協定期間中に秘密の施設で組み立てを完了させることもできる。私たちが検討したケース(秘密のパッケージングライン)では、これは割に合わないように思われた。主な理由は、処理能力が比較的低く、稼働させるには投入物を継続的に流入させる必要があることだ。
あるいは中国設計の計算資源を廃棄させることも考えられる。ただし、米国製の計算資源でこれを行うほうにはいくつかの利点がある。たとえば、(1) 電力効率が高く、必要な秘密データセンターの規模を最小にできる、(2) 生産記録の改ざんなど、中国設計の計算資源により適したほかの転用戦略と補完し合える、(3) もっともらしい言い逃れの余地が広がる(ただし、これは推測である)。
これは中国の利益に反するが、もっともらしい名目にはなりうる。
私たちの分析を参照:「国内生産を遡って過少申告し、2028年より前のストックを転用する」。
一方で、ジェットエンジンの排気はチラーの排気よりはるかに高温だが、他方で、こうした航空機が身を隠す必要があるのは赤外線誘導ミサイルのようなものからであって、衛星による繰り返しの観測と分析からではない。
毎秒1立方メートルの水流は、1℃の温度上昇あたり4.2MWを運ぶ。世界最大の下水処理場は約30 m^3/sを処理している(シカゴの約半分をカバー)。中国最大の地下導水事業は約100 m^3/sを運ぶ。最大級の原子力発電所は毎秒数百m^3を放水する(この流量で約10GWを放出するため、水温を1℃以上上げている)。最大級の淡水化プラントは1,000 m^3/s以上の海水を取水する。世界最大級の河川の平均流量は30,000〜300,000 m^3/sの範囲にある。
私たちが見つけたなかで最も適した熱赤外線衛星は、解像度57mで総雑音等価温度差が約0.2Kとされている。これは、この論文で原子力発電所の熱プルームの撮影に使われたLandsat 8・9の解像度100mより優れている。したがって、水面での温度上昇はおそらく0.1℃未満にする必要がある。そのためには、4.2MWごとに10 m^3/sの水を取水する(そうなると、100MWの施設の流量は世界最大級の原子力発電所と同程度になる)か、1 m^3/sの水あたりにより多くのメガワットを投入する代わりに、より深い場所(あるいは何らかの地下水路)で放水し、最終的に水面に届くまでにプルームをもっと薄めるかすればよい。この分析が時間平均やその他の信号処理の手法を適切に考慮できているかどうかは、現時点ではわからない。
この技術では、ほぼ同一の軌道配置から異なる時期に撮影した複数の画像を重ね合わせる必要があるようで、広い範囲での発見にはあまり向いていないと思われる。十分な数の衛星があれば、力ずくで解決できるかもしれない。
宇宙軍の報道官はBreaking Defenseに対し、この目的のための専用衛星は2028年に打ち上げられる見込みだと述べた。これとは別に、このプログラムの2026会計年度の研究・開発・試験・評価(RDT&E)予算のスケジュールでは、GMTIの「GMTIの開発と配備」の活動が2030会計年度第4四半期まで続くとされている。これは配備期間が2030会計年度末まで続く計画であることを示しているが、この文書には初期運用能力(IOC)や完全運用能力(FOC)の達成時期は記されていない。
2010年から2012年にかけて、中国にいた多数のCIAの情報源(ほぼ全員とも思われる)が殺害され、投獄された。ニューヨーク・タイムズ紙は2017年に、「CIAは中国でスパイ網の再建を試みてきたが……費用も時間もかかる取り組みだ」と書いている。[進展についての2023年のバーンズ(Burns)の発言に言及する]
この提案の最も極端な形は、たとえば次のようなものだ。(1) 宇宙船ですべての人間を他の惑星に移住させる、(2) 秘密のGPUが他の惑星に運ばれていないことを検証する、(3) 他の惑星で新たに製造された計算資源から転用が起きていないことを確かめる、(4) 地球を解体する。これは明らかに説明のための極端な例であり、実際には、これだけの能力があれば、はるかに効率的で低コストな方法がとられるだろうと考えている。
当初の合意にチャレンジ査察の規定が含まれていなくても、秘密プロジェクトへの懸念がコンソーシアムのスケーリングの決定を縛る要因になれば、中国はのちにそれを認めるよう国際的な圧力を受けるかもしれない。
ホール・エルー法から出るパーフルオロカーボンの排出を測定すれば、実際のアルミニウム生産にどれだけのエネルギーが使われているかを見分けられるかもしれない。ただし、施設ごとの水準でこれを宇宙から測定する方法は知られていない。
2024年に、OpenAIは研究開発用の計算資源に50億ドルを支出した。Zhipu AIの研究開発費の総額は3億800万ドルで(10ページ)、そこには技術スタッフ657人が含まれる(1人あたり年10万ドルと仮定すると、計算資源への支出は2億4,230万ドルになる)。Minimaxの支出は総額1億8,900万ドルだった(11ページ)。
計算資源の優位は、ある意味では時間とともに広がる。私たちのシナリオでは、コンソーシアムは計算資源を年約3倍に増やす。ただし、これがそのまま能力に結びつくのは学習用計算資源のスケーリングを通じてだけである(一方、研究用計算資源のスケーリングは、ソフトウェア面の進歩を限られた量にとどめるよう制限される)。
これは測り方しだいである。米国のAI標準・イノベーションセンターは米国のリードが拡大しているらしいことを見いだしたが、ここではEpoch Capabilities Indexを使っている。「The US-China AI gap is very uncertain」(米中のAI格差はきわめて不確実)を参照。
(やや古い)例を挙げると、Phi-4はGPT-4を使って特化した合成データを生成し、学習用計算資源が約20分の1で済んだにもかかわらず、ECIでGPT-4を上回った。
ここでは、秘密プロジェクトが手に入れられるのは追跡されていない協定前の計算資源だけ、つまり協定後の計算資源を密輸したり、秘密のチップサプライチェーンを構築したりすることはできないと仮定している。極端な能力に達した後であれば、秘密プロジェクトが秘密の計算資源のサプライチェーンを構築することも可能になるが、これが制約要因になるとは考えていない。つまり、それが起きるのは、私たちが破局的とみなすほかの能力が実現した後になる。
さらなる分析はこちらを参照。
この極端な形は核による相互確証破壊(MAD)を損ないうるが、それはきわめて難しい。秘密裏に行わなければ、他国は核兵器の備蓄を増やすか、増強に介入して対抗するだろう。
重要な点として、これらの推計には、協定期間中の重みの窃取によるリスクは含めていない。
理由の一つは、秘密プロジェクトが実行不可能だと判明したとしても、中国が相当量の計算資源を転用した世界では、コンソーシアムがより不利なスケーリング戦略を採らざるをえなくなるかもしれないことだ。所在不明の量の計算資源があれば、仮想の秘密プロジェクトがどれだけ速く協定を損なうAIに到達できるか、コンソーシアムにはわからないからだ。もう一つの理由は、秘密プロジェクト自体が無害なほど小さくても、それを発見して停止させることに伴う緊張が、協定の弱体化のリスクを新たに生むことだ。
これは不可能かもしれない。「BATNAを歪める能力」を参照。