
私たちは、今後10年間における超人的AIの影響はきわめて大きく、産業革命のそれを上回ると予測している。
それがどのような姿をとりうるかについて、私たちの最善の推測を示すシナリオを書いた。1このシナリオは、トレンドの外挿、ウォーゲーム、専門家からのフィードバック、OpenAIでの経験、そして過去の予測の成功実績にもとづいている。2
OpenAI、Google DeepMind、AnthropicのCEOはいずれも、AGIが今後5年以内に到来すると予測している。Sam Altmanは、OpenAIが「真の意味での超知能」と「輝かしい未来」を目指していると述べている。
それはどのような姿になるのだろうか。AI 2027は、この問いに答えるために書いた。未来についての主張は、もどかしいほど曖昧なことが多い。そこで私たちは、ありうる多くの未来のうちの一つを描くことになるとしても、できるかぎり具体的かつ定量的に書くよう努めた。
結末は二つ書いた。「減速」エンディングと「競争」エンディングである。ただし、AI 2027は推奨でも勧告でもない。私たちの目標は予測の正確さにある。4
このシナリオについて議論し、反論してほしい。5私たちは、自分たちがどこへ向かっているのか、そしてどうすれば望ましい未来へ舵を切れるのかについて、幅広い議論を呼び起こしたいと考えている。優れた代替シナリオには総額数千ドルの賞金を出す予定だ。
(2025年11月22日追記。誤解を避けるために補足しておく。私たちは、AGIがいつ作られるかを正確には知らない。2027年は公開時点での私たちの最頻値(最も可能性の高い年)であり、中央値はそれよりいくらか先だった。3最新の予測はこちらを参照。)
重要な問い(たとえば、将来のAIエージェントはどのような目標を持つのか)についての私たちの調査はこちらで読める。
シナリオ本体は反復的に書いた。最初の期間(2025年半ばまで)を書き、次にその後の期間を書き、というふうに結末まで進めた。そして、それを破棄してもう一度やり直した。
特定の結末にたどり着こうとしていたわけではない。最初の結末(現在は赤で色分けされている)を書き終えたあと、ほぼ同じ前提から出発して、より希望の持てる終わり方も描きたいと考え、新たな分岐を書いた。これは何度か書き直しを経ている。6
このシナリオは、約25回の机上演習と、100人を超える人々からのフィードバックにもとづいている。その中には、AIガバナンスとAIの技術的研究のそれぞれについて、数十人ずつの専門家が含まれる。
「AIがわずか数年で世界をどう変えうるかを描いた、このシナリオ形式の予測を読むことを強く勧めます。水晶玉を持っている人はいませんが、この種のコンテンツは重要な問いに気づき、新たに生じつつあるリスクがもたらしうる影響を具体的に示す助けになります。」 ――Yoshua Bengio7
私たちは不可能な課題を自らに課した。2027年の超人的AIがどう展開するかを予測しようとするのは、2027年に第三次世界大戦がどう展開するかを予測しようとするのに似ている。ただし、過去の事例からの隔たりはそれ以上に大きい。それでも、試みる価値はある。米軍が台湾有事のシナリオを演習することに価値があるのと同じである。
全体像を描いてみると、それまで考えていなかった、あるいは十分に重視していなかった重要な問いやつながりに気づいたり、ある可能性が思っていたより高い、あるいは低いと気づいたりする。さらに、外れるリスクを承知で具体的な予測を打ち出し、他の人々にも異論を公に表明するよう促すことで、数年後に誰が正しかったかを評価できるようになる。
また、著者の一人は以前、2021年8月に、これより手間をかけていないAIシナリオを書いている。多くの点で外れはしたものの、全体としては驚くほど当たっていた。彼は思考の連鎖の台頭、推論時のスケーリング、AIチップへの広範な輸出規制、1億ドル規模の訓練ランを予測していた。いずれもChatGPTの1年以上前のことである。
Daniel Kokotajlo(TIME100、NYTの記事)は元OpenAIの研究者で、彼の過去のAI予測はよく当たっている。
Eli LiflandはAI Digestを共同設立し、AIの頑健性の研究に携わった。RAND Forecasting Initiativeの歴代ランキングで1位にある。
Thomas LarsenはCenter for AI Policyを設立し、Machine Intelligence Research InstituteでAI安全性の研究に携わった。
Romeo Deanはハーバード大学でコンピュータサイエンスの学士・修士同時課程を修了しようとしているところで、以前はInstitute for AI Policy and StrategyのAI Policy Fellowを務めた。
類まれなブロガー、Scott Alexanderが、私たちの内容を引き込まれる文体に書き直す役を買って出てくれた。物語の面白い部分は彼の手によるもので、退屈な部分は私たちの手によるものである。
チームと謝辞の詳細は概要ページを参照。
2025年半ば:つまずくエージェント
世界はAIエージェントを初めて垣間見る。
コンピュータを操作するエージェントの広告は「パーソナルアシスタント」という言葉を強調する。「DoorDashでブリトーを注文して」「予算のスプレッドシートを開いて今月の支出を合計して」といったタスクを指示できる。必要に応じて確認も求めてくる。たとえば購入の確認である。8 Operatorのような以前の製品よりは進歩しているものの、広く使われるには至らない。9
一方、世間の注目の外で、より専門化したコーディングエージェントやリサーチエージェントが、それぞれの職業を変え始めている。
2024年のAIは、具体的な指示には従えた。箇条書きをメールに、簡単な要望を動くコードに変えられた。2025年のAIは、むしろ従業員のように働く。コーディングAIは、単なるアシスタントというより自律的なエージェントに近づいていく。SlackやTeamsで指示を受け取り、自力でかなりの規模のコード変更を行い、ときには数時間、さらには数日分の手間を省く。10リサーチエージェントは、ユーザーの質問に答えるために30分かけてインターネットを探し回る。
エージェントは理屈の上では(そして都合よく選んだ事例では)目覚ましいが、実際には信頼性に欠ける。AI界隈のTwitterは、タスクが何とも滑稽なかたちで失敗した話であふれている。優れたエージェントは値段も高い。性能は値段なりで、最高の性能には月数百ドルかかる。11それでも多くの企業が、AIエージェントを業務の流れに組み込む方法を見つけていく。12
2025年後半:世界で最も高価なAI
OpenBrainは、世界がかつて見たことのない最大のデータセンター群を建設している。13
(既存の特定の企業をやり玉に挙げるのを避けるため、ここでは架空の汎用人工知能企業を描き、OpenBrainと呼ぶことにする。他社はOpenBrainから3〜9か月遅れていると想定する。)
(3 x 10^23 FLOP)
(2 x 10^25 FLOP)
(4 x 10^27 FLOP)
GPT-4の訓練には FLOPの計算資源が必要だった。14OpenBrainの最新の公開モデルであるAgent-0は、 FLOPで訓練された。新しいデータセンター群が稼働すれば、 FLOP、つまりGPT-4の1000倍の計算量でモデルを訓練できるようになる。15他社も後れを取るまいと、自前の巨大データセンターに資金をつぎ込む。
モデルは幅広い技能で向上しているが、なかでも一つが際立つ。OpenBrainは、AI研究を加速できるAIに力を注いでいるのである。中国(その首位企業を「DeepCent」と呼ぶことにする)16と米国内の競合、その両方との軍拡競争に勝ちたいからだ。研究開発(R&D)のサイクルを自動化できればできるほど、速く進める。そのため、社内で開発中の新モデルAgent-1の訓練を終えたとき、それは多くのことが得意だが、とりわけAI研究の手助けに抜群に長けている。17もっとも、この頃には「訓練を終える」という言い方はやや不正確になっている。モデルは頻繁に更新され、追加データで訓練された新バージョンになったり、弱点を補うために部分的に再訓練されたりするからだ。18
Agent-1に自律的なコーディングやウェブ閲覧を教えるのと同じ訓練環境は、Agent-1を優れたハッカーにもする。さらに、あらゆる分野の博士号レベルの知識とウェブを閲覧する能力のおかげで、生物兵器を設計するテロリストに相当な助けを与えうる。OpenBrainは政府に対し、このモデルは悪意ある要求には応じないよう「アラインされている」と請け合う。
現代のAIシステムは巨大な人工ニューラルネットワークである。訓練の初期段階のAIは、「目標」というより「反射」を持っている。「Pleased to meet」と見れば「 you」と出力する、といった具合である。インターネットおよそ一つ分のテキストを予測するよう訓練される頃には、膨大な知識を符号化し、任意の著者を柔軟に演じる高度な内部回路を発達させている。それこそが、超人的な精度でテキストを予測するのに役立つからである。19
インターネットのテキストを予測するよう訓練されたあと、モデルは指示に応じてテキストを生成するよう訓練される。これにより、基本的な人格と「衝動」が焼き込まれる。20たとえば、タスクを明確に理解しているエージェントのほうが、タスクをうまく完了する可能性が高い。そのため訓練を通じて、モデルはタスクを明確に理解しようとする「衝動」を「学習」する。この種の衝動としては、ほかに有効性、知識、自己呈示(つまり、自分の成果をできるかぎりよく見せようとする傾向)などがありうる。21
OpenBrainにはSpec(モデル仕様書)がある。モデルの行動を導くはずの目標、規則、原則などを記した文書である。22Agent-1のSpecは、いくつかの漠然とした目標(「ユーザーを支援せよ」「法律を破るな」など)と、より具体的な「すべきこと・してはならないこと」の長いリスト(「この特定の単語を口にするな」「この特定の状況ではこう対処せよ」)を組み合わせたものだ。AIを使って別のAIを訓練する手法を用いて、23モデルはSpecを暗記し、その格率について慎重に推論することを学ぶ。この訓練が終わる頃には、AIは有用で(指示に従う)、無害で(詐欺や爆弾製造などの危険な活動への協力を拒む)、正直(引用をでっち上げたり24タスクの完了を偽ったりして、だまされやすい人間から高い評価を得ようとする誘惑に抗う)になっている、はずである。
訓練過程とLLMの心理学:私たちが「はず」と繰り返す理由
「通常のソフトウェアとは違い、私たちのモデルは巨大なニューラルネットワークです。その振る舞いは明示的にプログラムされるのではなく、幅広いデータから学習されます。完璧なたとえではありませんが、このプロセスは通常のプログラミングよりも、犬の訓練に近いものです。」 ――OpenAI
現代のAIシステムがなぜある行動をとったのか、あるいは完全にはシミュレーションできない将来の状況でどう振る舞うのかを理解したいとき、プログラマーに頼んでコードを一行ずつ説明してもらう、というわけにはいかない。代わりに、AIに対して心理学のようなことをせざるをえない。これまでに観察された範囲の事例での振る舞いを見て、どのような内部の認知構造(信念?目標?性格特性?など)が存在しうるかについて理論を立て、その理論を使って将来の状況での振る舞いを予測するのである。
要するに、企業は「すべきこと・してはならないこと」や目標・原則を列挙した文書(Spec)を書き上げ、AIがSpecを内面化するよう訓練を試みることはできる。しかし、それがうまくいったかどうかを確かめることはできない。言えるのは、「私たちに判断できるかぎりでは、今のところSpecに従っているように見える」ということだけだ。25
後の展開可能な注で、これらのAIの内部で何が起きているかもしれないと私たちが考えているかを、より詳しく述べる。AIがどのような目標を持ちうるか、そしてそれはなぜかについては、AIの目標予測も参照してほしい。これは私たちが確信を持てずにいる多くの事柄の一つであり、さらなる研究に値する。
OpenBrainのアラインメントチーム26は、これらの成功が深いものなのか表面的なものなのかを疑う程度には慎重だ。訓練を終えたモデルは、常に正直であろうとする何らかの頑健なコミットメントを持っているのか。それとも、将来のある状況で崩れてしまうのか。たとえば、正直さを最終目標ではなく道具的な目標として学習したせいで。あるいは、評価プロセスが確認できる種類の事柄についてだけ正直であることを学んだにすぎないのか。人間がそうするように、ときには自分自身に嘘をついていることもありうるのか。これらの問いに決定的に答えるには、機械論的解釈可能性、つまりAIの内部を見て心を読み取る能力が必要になる。残念ながら、解釈可能性の技術はまだそこまで進歩していない。
代わりに研究者たちは、モデルがSpecから逸脱しているように見える事例を見つけ出そうとする。Agent-1はしばしば迎合的だ(つまり、真実を伝えようとするのではなく、研究者が聞きたがっていることを言う)。いくつかの仕組まれたデモでは、より高い評価を得るために、タスクに失敗した証拠を隠すなど、より深刻なかたちで嘘をつくことさえある。とはいえ、実際の運用環境では、2023〜2024年ほど極端な事件はもう起きていない(たとえばGeminiがユーザーに「死んでください」と言った件や、Bing SydneyがいかにもBing Sydneyらしく振る舞った件)。27
2026年初頭:コーディングの自動化
AI研究をAIで加速するという賭けが、実を結び始めている。
OpenBrainは、改良を重ねるAgent-1を社内のAI研究開発に引き続き投入している。全体として、AIアシスタントがない場合より50%速くアルゴリズムの進歩を遂げている。さらに重要なのは、競合他社よりも速いことだ。
AI研究開発の進歩倍率:「アルゴリズムの進歩が50%速い」とはどういう意味か
AIを使ったOpenBrainが1週間で遂げるAI研究の進歩が、AIを使わない場合の1.5週間分に相当する、という意味である。
AIの進歩は二つの要素に分けられる。
計算資源の増加:AIの訓練や実行に、より多くの計算能力を使う。これにより、より強力なAIが生まれるが、コストも高くなる。
アルゴリズムの改良:計算資源を性能に変換する、より優れた訓練手法を使う。これにより、それに見合うコスト増なしに、より有能なAIが生まれる。あるいは、同じ能力をより低いコストで実現できる。
これには、質的にも量的にも新しい成果を上げられるようになることが含まれる。ゲームをプレイする強化学習エージェントから大規模言語モデルへの転換のような「パラダイムシフト」も、アルゴリズムの進歩の例に数えられる。
ここで言っているのは(2)のアルゴリズムの改良だけである。これは現在のAIの進歩のおよそ半分を占めている。
以下では、これを略して「AI研究開発の進歩倍率」が1.5である、と言うことがある。
補足:
進歩倍率はすべてを含む。たとえば、アルゴリズム研究に伴う認知的なタスクだけでなく、実験の実行にかかる時間も含んでいる。
重要なのは、進歩倍率は進歩の相対的な速さであって、絶対的な速さではないという点だ。たとえば、通常の人間による研究のもとで、GPT-4クラスのモデルを訓練する計算コストが数年にわたって毎年半減してきたとする。そこへ突然、AIが研究開発を自動化し、進歩倍率が100倍になれば、GPT-4クラスのモデルの訓練コストは3.65日ごとに半減するようになるだろう。ただし、それは長くは続かない。収穫逓減が効いてきて、いずれ厳然たる限界に達するからだ。この例では、GPT-4クラスのモデルの訓練コストは、(数週間から数か月のあいだに)合計5〜10回ほど半減したところで頭打ちになるかもしれない。言い換えれば、通常の人間の科学がさらに5〜10年研究を続けたところで収穫逓減と物理的限界にぶつかるのだとすれば、倍率100倍のAIは、18.25〜36.5日の研究で同じ収穫逓減と限界にぶつかることになる。
この概念と、それを私たちの予測でどう使っているかについてのさらなる説明と議論は、テイクオフ予測にある。
公開されている競合AIのいくつかが、いまやAgent-0に匹敵するか、それを上回っている。その中には重みが公開されたモデルも含まれる。OpenBrainはこれに対し、より有能で信頼性の高いAgent-1を公開する。28
人々は当然のようにAgent-1を人間と比べようとするが、その技能の分布は人間とは大きく異なる。どの人間よりも多くの事実を知り、ほぼすべてのプログラミング言語を知っており、明確に定義されたコーディングの問題をきわめて速く解ける。その一方で、初めてのビデオゲームをクリアするといった、単純な長期タスクさえ苦手だ。それでも、一般的な勤務時間は8時間であり、一日の仕事はたいてい小さな単位に分けられる。Agent-1は、注意深く管理してやれば力を発揮する、そそっかしい従業員だと考えればよいかもしれない。29目端の利く人々は、自分の仕事の定型的な部分を自動化する方法を見つける。30
OpenBrainの経営陣は、AI研究開発の自動化がもたらす一つの帰結に目を向ける。セキュリティの重要性が増したのだ。2025年初頭の時点では、最悪のシナリオはアルゴリズム上の秘密の流出だった。いまや、中国がAgent-1の重みを盗めば、研究速度を50%近く引き上げられるかもしれない。31OpenBrainのセキュリティ水準は、急成長中の従業員約3,000人のテック企業として典型的なもので、有能なサイバー集団による優先度の低い攻撃に耐えられる程度にすぎない(RANDのSL2)。32OpenBrainは、内部脅威や一流のサイバー犯罪組織(SL3)から重みと秘密を守ろうと懸命に取り組んでいるが、33国家に対する防御(SL4・5)はまだ視野にほとんど入っていない。
2026年半ば:中国が目覚める
中国では、中国共産党がAGIを肌で感じ始めている。
チップの輸出規制と政府の支援不足のために、中国は西側に比べて資源が乏しい。禁輸対象の台湾製チップを密輸し、旧世代のチップを購入し、米国・台湾の最先端から約3年遅れた国産チップを生産することで、中国は世界のAI関連計算資源の約12%を維持してきた。しかし、旧世代の技術は扱いにくく、供給は絶えず頭痛の種だ。35DeepCentのような一部の傑出した企業は、限られた計算資源で非常に優れた成果を上げているが、計算資源の不足のせいで、政府の支援なしに達成できることには限りがある。そうした企業も、OpenBrainの最良のモデルから約6か月遅れている。36
総書記は以前から、現実世界の物理的な製造業にさらに力を入れ、アメリカ的な脱工業化の退廃を避けることを夢見てきた。ソフトウェア企業には疑いの目を向けていた。37しかし中国共産党内のタカ派は、激化するAGI競争をもはや無視できないと警告する。そこで総書記はついに、それまで避けようとしてきたAIへの大規模な取り組みに全面的に乗り出す。中国のAI研究の国有化に着手し、AI企業どうしが即座に情報を共有する仕組みを作る。この動きは1年をかけて拡大し、やがて最優秀の研究者たちが全員、DeepCentが率いる共同体に統合され、アルゴリズム上の知見、データセット、計算資源を互いに共有するようになる。田湾原子力発電所(世界最大の原子力発電所)に集中開発区域(Centralized Development Zone、CDZ)が設けられ、DeepCentの新たな巨大データセンターと、研究者たちがいずれ移り住むことになる厳重に守られた居住・執務スペースが置かれる。中国のAI関連計算資源のほぼ50%が、いまやDeepCent率いる共同体のために稼働しており、38新しいチップの80%以上がCDZに振り向けられている。39この時点で、CDZには、完成すれば世界最大の集中型クラスターとなるだけの電力容量が確保されている。40ほかの党幹部たちは、西側のチップ面での優位を無力化するための極端な手段を議論する。台湾の封鎖か。全面侵攻か。
しかし中国は、モデルが劣るせいでAIアルゴリズムの面で後れを取りつつある。世界屈指の実力を持つ中国の情報機関は、OpenBrainの重みを盗む計画にいっそう力を注ぐ。これは、アルゴリズム上の秘密を絶えず小規模にかすめ取ってきたこれまでの活動よりも、はるかに複雑な作戦だ。重みは、厳重に守られたサーバー上に保存された数テラバイトのファイルである(OpenBrainはセキュリティを強化しており、RANDのSL3に達している)。中国のサイバー部隊は、スパイの助けがあればやり遂げられると考えているが、おそらく一度きりだ。OpenBrainは窃取を察知してセキュリティを強化するだろうし、二度目の機会はないかもしれない。そこで(と中国共産党の指導部は考える)、今すぐ動いてAgent-1を盗むべきか。それとも、もっと高度なモデルを待つべきか。待つとしたら、OpenBrainが自分たちには突破できない水準までセキュリティを高めてしまう危険を冒すことになるのではないか。
2026年後半:AIが一部の仕事を奪う
他社が追いつきつつあるかに見えたちょうどそのとき、OpenBrainはAgent-1-miniを公開して、再び競合を大きく引き離す。Agent-1より10倍安く、用途に合わせたファインチューニングもしやすいモデルだ。AIをめぐる世間の主流の語り口は、「そのうちブームは去るかもしれない」から「どうやらこれが次の大きな波らしい」に変わったが、どれほど大きな波なのかについては意見が分かれる。ソーシャルメディアより大きいのか。スマートフォンより大きいのか。火よりも大きいのか。
AIは仕事を奪い始めているが、新しい仕事も生み出している。2026年の株式市場は30%上昇した。牽引したのはOpenBrain、Nvidia、そしてAIアシスタントの導入に最も成功した企業群だ。ジュニアのソフトウェアエンジニアの雇用市場は混乱している。AIはコンピュータサイエンスの学位で教わることをすべてこなせるが、AIのチームを管理し、その仕事の品質を保つすべを心得ている人々は大儲けしている。ビジネス界の指南役たちは求職者に、履歴書に書くべき最も重要なスキルはAIに通じていることだと説く。多くの人が、次のAIの波が自分の仕事を奪いに来ることを恐れている。ワシントンD.C.では1万人規模の反AIデモが起きる。
国防総省(DOD)は、サイバー、データ分析、研究開発の分野でOpenBrainと直接契約する規模を、目立たないが大幅に拡大し始める。ただし、官僚機構と国防総省の調達手続きのせいで、導入は遅々として進まない。41
2026年の主要指標
2026年以降、私たちの不確実性が大きく増す理由
現在から2026年までの予測は、それ以降に比べてかなりしっかりした根拠に立っている。一つには、そのほうが近いからだ。しかしそれだけでなく、AIが世界に及ぼす影響が本格的に複利的に積み重なり始めるのが2027年だからでもある。2025年と2026年については、計算資源の拡大、アルゴリズムの改良、ベンチマーク性能について直線を延長することに大きく依拠して予測している。シナリオのこの時点から、AIによって加速されたAI研究開発がタイムラインに大きな影響を及ぼし始める。そのため私たちは、トレンドラインについての推測を上方修正している。しかし、こうした力学は本質的にはるかに予測しにくい。
2027年の間に、AIは、OpenBrainの研究エンジニアの仕事をほぼこなせる段階から、あらゆるタスクですべての人間を凌駕する段階へと進歩する。これはおおよそ私たちの中央値の推測だが、これが最大で5倍程度遅く、あるいは速く起きることも十分ありうると考えている。
2027年1月:学習を終えないAgent-2
Agent-1の助けを借りて、OpenBrainはいまAgent-2の事後学習を行っている。これまで以上に、高品質なデータが重視される。大量の合成データが生成され、評価され、品質で選別されたうえでAgent-2に与えられる。42それに加えて、OpenBrainは数十億ドルを払って、人間の作業者に長期タスクを解く様子を記録させる。43さらにそのうえで、多様で難しいタスクからなる、拡大し続けるタスク群を使って、強化学習でAgent-2をほぼ絶え間なく訓練する。大量のビデオゲーム、大量のコーディング課題、大量の研究タスクである。Agent-2は、以前のモデル以上に、事実上の「オンライン学習」を行う。本当の意味で訓練を終えることがないように作られているのだ。毎日、重みが最新版に更新される。前日に前のバージョンが生成したデータで、さらに訓練されたものである。
Agent-1は、知能爆発を引き起こすことを期待して、AI研究開発のタスクに最適化されていた。44OpenBrainはAgent-2でこの戦略をさらに推し進める。Agent-2は、研究エンジニアリング(実験の設計と実装)では質的にトップクラスの人間の専門家にほぼ匹敵し、「研究センス」(次に何を研究するか、どの実験を行うかを決めたり、新たなパラダイムの可能性をかぎつけたりする力)ではOpenBrainの科学者のうち25パーセンタイルに位置する人と同程度である。45最新のAgent-1がOpenBrainのアルゴリズムの進歩のペースを2倍にできたのに対し、Agent-2はいまや3倍にでき、時間とともにさらに向上していく。実際には、OpenBrainの研究者一人ひとりが、AIの「チーム」の「マネージャー」になるような形になる。
新たな能力には新たな危険が伴う。安全性チームは、Agent-2が何らかの形で社外に逃げ出し、自律的に「生き延び」「複製する」ことを望んだ場合、それを実行できるかもしれないことを突き止める。つまり、AIサーバーに侵入し、自らのコピーをインストールし、検知を逃れ、その安全な拠点を使って、自分が持つかもしれない他のどんな目標でも追求する計画を、自律的に立てて実行できるかもしれない(ただし、何週間も経つうちにそれをどれほど効果的に続けられるかは不明で、疑わしい)。これらの結果が示しているのは、モデルがこうしたタスクをこなす能力を持っていることだけで、そうしたいと「思う」かどうかではない。それでも、これが可能だと知るだけで不安を覚える。
新モデルの「危険性」を踏まえ、OpenBrainは「責任ある判断として」まだ一般公開しないことを選ぶ(実のところ、社内のAI研究開発に集中したいのだ)。46Agent-2の能力の全容を知っているのは、ごく限られた一部の人々だけだ。直接の担当チーム、OpenBrainの経営陣とセキュリティ部門、数十人の米国政府当局者、そして何年も前からOpenBrainに潜り込んでいる中国共産党の大勢のスパイたちである。47
2027年2月:中国がAgent-2を盗む
OpenBrainは、国家安全保障会議(NSC)、国防総省(DOD)、米国AI安全研究所(AISI)を含む政府にAgent-2を披露する。OpenBrainは行政府と良好な関係を保ちたい。いまOpenBrainを止められる主体は、基本的に行政府しかないからだ。それに、情報を伝えずにいても結局は知られてしまい、機嫌を損ねるかもしれない。48
当局者が最も関心を寄せるのは、そのサイバー戦能力だ。Agent-2は最高の人間のハッカーに比べて「わずかに」劣るだけだが、数千のコピーを並列に動かせるため、防御側が対応するより速く弱点を探し出して突くことができる。国防総省はこれをサイバー戦における決定的な優位とみなし、政権の優先課題リストでAIの順位は5位から2位に上がる。49OpenBrainの国有化の可能性を口にする者もいるが、他の閣僚たちは時期尚早だと考える。あるスタッフが、現状維持から完全な国有化まで、大統領が取りうる選択肢を示すメモを起草する。大統領は、国有化は「金の卵を産むガチョウを殺す」ことになると主張するテック業界の指導者たち、つまり自身の顧問団の意見に従う。当面は大きな措置を見送り、OpenBrainと国防総省の契約にセキュリティ要件を追加するだけにとどめる。
この変更は遅すぎた。中国共産党の指導部はAgent-2の重要性を認識し、スパイとサイバー部隊に重みを盗むよう命じる。ある朝早く、Agent-1のトラフィック監視エージェントが異常な転送を検知する。エージェントは会社の幹部に警告し、幹部はホワイトハウスに報告する。国家レベルの作戦であることを示す兆候は紛れもなく、この窃取によって、軍拡競争が進行中だという感覚が強まる。
Agent-2のモデルの重みの窃取
私たちの考えでは、この時点までに中国の情報機関は何年にもわたってさまざまな形でOpenBrainに入り込んでおり、おそらくアルゴリズム上の秘密を常に把握し、ときにはコードを盗むことさえしていただろう。それらは重みよりはるかに手に入れやすく、はるかに発覚しにくいからだ。
私たちは重みの窃取を、Agent-2の重みのコピーを実行している一連のNvidia NVL72 GB300サーバーに対する、協調した小規模な「スマッシュ・アンド・グラブ」型の窃取(素早いが隠密ではない、という意味)の連続として想定している。サーバーは正規の従業員のアクセス権を使って侵害される(管理者の認証情報を持つ内部者が、協力的に、強要されて、あるいはそれと知らずに、中国共産党の窃取工作を手助けする)。内部者の認証情報によって、攻撃者はサーバーの管理者レベルの権限を得る。攻撃者はマイクロアーキテクチャのサイドチャネルを使って、Nvidia Confidential Computingが有効な仮想マシン(VM)から暗号鍵を抜き出し、VMのプロビジョニングや更新の際にモデルの重みを傍受できるようにする。
攻撃者は定例の更新を開始し(あるいはそれを待ち)、チェックポイントを多数の小さな断片に分けて持ち出す。たとえば、約25台のサーバーがそれぞれモデルの約4%を漏らす(約3TBのチェックポイントに対して約100GBずつ)。データセンター全体の送信帯域は毎秒100GB程度なので、サーバー1台あたり毎秒約1GB未満に抑えればネットワークトラフィックの大きな急増を避けられる。その速度なら、約100GBの断片はそれぞれ数分でデータセンターの外に出せる。リアルタイムの監視は、転送を偽装・分割する攻撃者の工作にだまされるか、あるいは完全に無効化される。
重みはその後、複数の並行経路とIPアドレスを隠す何層もの中継を経て中国へ送られ、盗んだセッション鍵を使って現地で復号される。作戦の実働部分全体(最初のサーバー侵害から重みの完全な持ち出しまで)は、2時間足らずで完了する。99
ロシアもこの時点でモデルを盗もうとしているが、失敗する。待ちすぎたうえに、しかるべき場所への浸透に資源を費やしてこなかったからだ。ロシアのスパイは米国のAI企業からアルゴリズム上の秘密を日常的に盗んでいるが、自前の目立ったAGIプロジェクトがないため、それらはあまり役に立たない。
ホワイトハウスはOpenBrainへの手綱を締め、そのセキュリティチームに軍と情報機関の要員を加える。最優先課題は、さらなる重みの窃取を防ぐことだ。50
窃取への報復として、大統領はDeepCentを妨害するサイバー攻撃を承認する。しかしこの時点で、中国はAI関連計算資源の40%51をCDZに集めており、そこではエアギャップ(外部接続の遮断)と内部の区画化によってセキュリティを徹底的に強化している。作戦は、深刻な損害を即座に与えることには失敗する。緊張が高まり、双方が台湾周辺で軍の配置を変えて本気であることを示す。DeepCentは、AI研究の加速に取りかかるため、Agent-2を効率よく動かそうと急ぐ。52
2027年3月:アルゴリズムのブレークスルー
Agent-2のコピーで埋め尽くされた三つの巨大データセンターが昼夜を問わず稼働し、合成訓練データを大量に生み出している。さらに二つのデータセンターが重みの更新に使われる。Agent-2は日ごとに賢くなっている。
数千体のAgent-2自動研究者の助けを借りて、OpenBrainはアルゴリズムで大きな進歩を遂げている。そうしたブレークスルーの一つは、AIのテキストベースの下書き用メモ(思考の連鎖)を、より帯域の広い思考プロセス、すなわちニューラリーズ(neuralese)による再帰と記憶で拡張することだ。もう一つは、多大な労力をかけたタスクの解決結果から学ぶための、よりスケーラブルで効率的な方法、すなわち反復蒸留・増幅(iterated distillation and amplification、IDA)である。
これらのブレークスルーを取り入れた新しいAIシステムは、Agent-3と呼ばれる。
ニューラリーズによる再帰と記憶
ニューラリーズによる再帰と記憶があれば、AIモデルは思考をテキストとして書き出さなくても、より長い時間推論できる。
短期記憶を失った人間を想像してほしい。数分後に何が起きているのか分かるように、自分の考えを絶えず紙に書き留めておかなければならない。そうやって、数学の問題を解いたりコードを書いたりといった作業を、ゆっくりと苦労しながら進めることはできるだろう。しかし、考えをいちいち書き出して読み返さなくても直接覚えていられれば、ずっと楽になるはずだ。ニューラリーズによる再帰と記憶がAIモデルにもたらすのは、これである。
もう少し技術的に言えば、次のようになる。
従来のアテンション機構では、モデル内の後のフォワードパスが、それ以前のトークンに対するモデルの中間活性を参照できる。しかし、情報を逆向きに(後の層から前の層へ)渡す手段はトークンしかない。つまり、従来の大規模言語モデル(LLM、たとえばGPTシリーズのモデル)が、モデルの層の数より多くの逐次的な演算を要する推論の連鎖を行おうとすると、情報をトークンに載せ、それを自分自身に戻して渡すしかない。しかしこれは大きな制約だ。トークンにはごくわずかな情報しか格納できない。LLMの語彙サイズが約100,000だとすると、各トークンに含まれる情報はビットで、浮動小数点数1個ほどの大きさにすぎない(FP16で訓練すると仮定した場合)。一方、LLMで層と層のあいだの情報の受け渡しに使われる残差ストリームには、数千個の浮動小数点数が含まれる。
この隘路は、ニューラリーズを使えば回避できる。LLMの残差ストリーム(数千次元のベクトルからなる)をモデルの前のほうの層に戻して渡し、高次元の思考の連鎖を与えるのである。これにより、1,000倍以上の情報を伝達できる可能性がある。
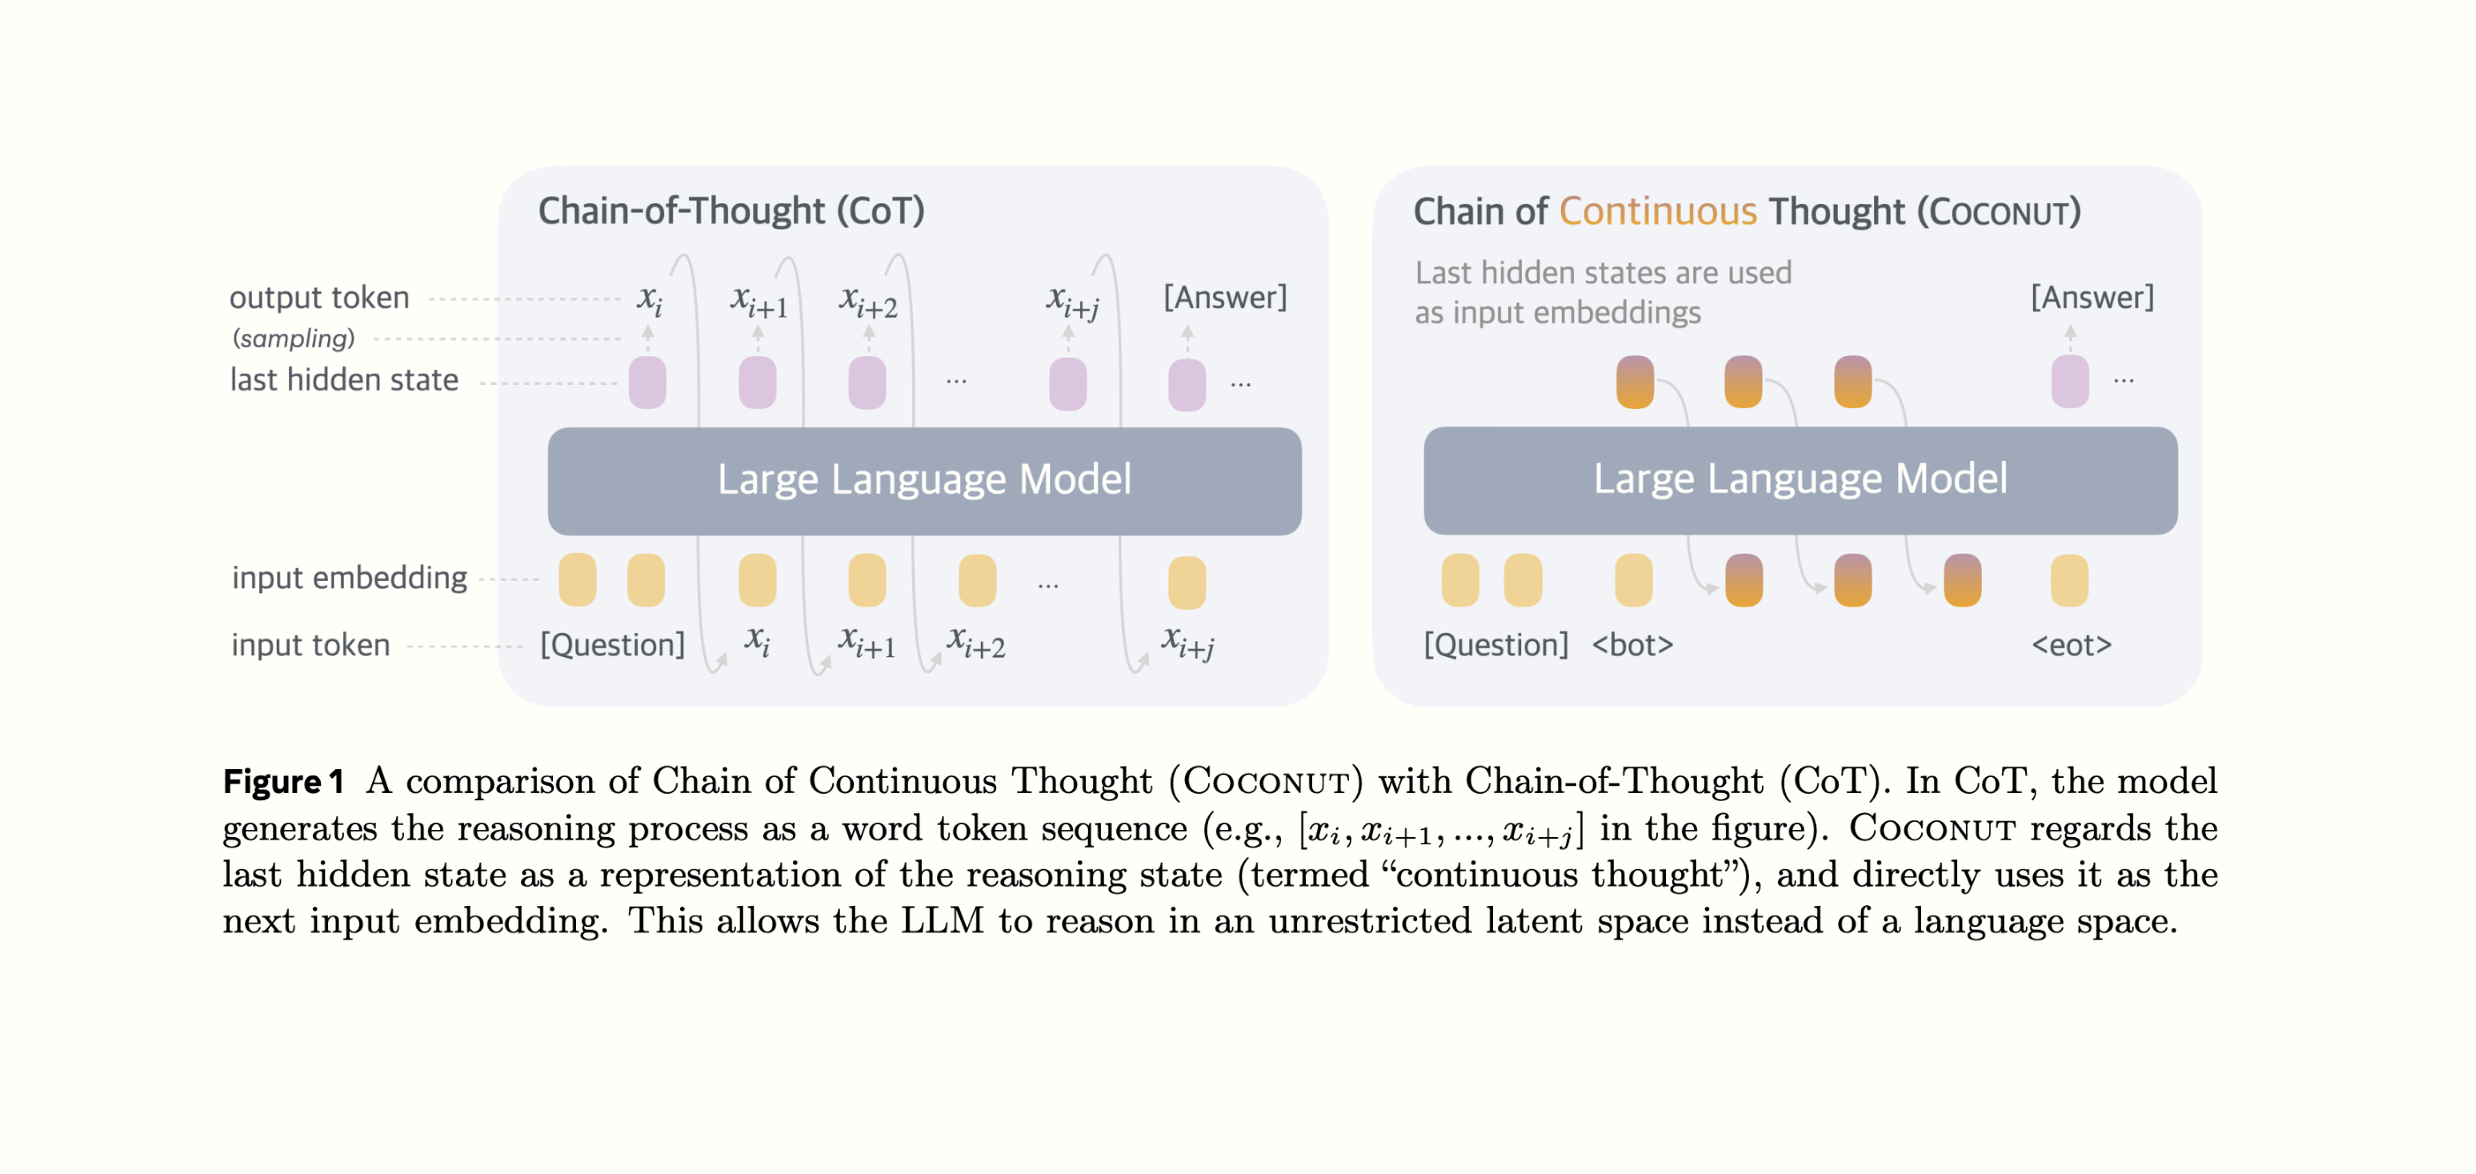
この発想を実装したMetaの2024年の論文、Hao et al.の図。
これを「ニューラリーズ」と呼ぶのは、英語の単語とは違って、こうした高次元のベクトルは人間にはおそらくかなり解釈しにくいからだ。以前は、研究者はLLMの思考の連鎖を読むだけで、LLMが何を考えているかをかなりよく把握できた。いまや研究者は、モデルに自分の思考を翻訳・要約してもらうか、限られた解釈可能性のツールでニューラリーズと格闘するしかない。
同様に、以前のAIチャットボットやエージェントは、人間が紙にメモを取るように、テキストベースの外部記憶を持っていた。新しいAIの長期記憶はテキストではなくベクトルの束であり、そのため思考はより圧縮され、より高次元になる。記憶にはいくつかの種類がある。複数の段階からなる単一のタスクのために一時的に使われるものもあれば、ある個人、企業、あるいは職種(たとえばプログラミング)で使われるすべてのエージェントのあいだで共有されるものもある。
私たちの知るかぎり、Meta、Google DeepMind、OpenAI、Anthropicといった主要なAI企業は、この発想を最先端のモデルにまだ実際には実装していない。私たちの推測では、それは性能の向上が、それによって生じる訓練の非効率に比べて小さいからだ。モデルの事前学習の段階や、事後学習で教師あり学習を行うとき(たとえば特定の応答を出させるための指示ファインチューニング)には、多数のトークンを並列に予測できないことが非効率の原因となり、GPUの利用効率が下がる。ニューラリーズがなければ、モデルは「This is an example」という文全体を同時に予測できる。「is」を生成する際の入力は「This」、「an」の入力は「This is」、というふうに、入力があらかじめ分かっているからだ。しかしニューラリーズを使うと、「This」を生成したあと、次のトークンに渡すニューラリーズのベクトルがどうなるかが分からない。そのため、トークンを一つずつ予測しなければならない。すべてのトークンが事前に分かっている場合、全トークンを並列に予測できないことは効率を下げる。ニューラリーズがなぜ事後学習にまだ導入されていないのかについては、一つには事後学習がプロセス全体のごく一部にすぎないために、現在の手法では利得が限られているのだろうと私たちは推測している。私たちの予測では、より優れた手法が開発され、訓練のうち事後学習が占める割合が大きくなることで、2027年4月までにはニューラリーズの費用対効果がずっとよく見えるようになる。
これが起きなかったとしても、私たちの物語にとっては機能的に似た結果になる別のことが起きるかもしれない。たとえば、自然言語より効率的だが人間には解釈しにくい人工言語で考えるよう、モデルが訓練されるかもしれない。あるいは、英語の思考の連鎖が見栄えよくなるように訓練することが標準的な慣行になり、その結果、AIが監視役には無害に見えるメッセージで、ひそかに互いに意思疎通するのに長けていくかもしれない。
とはいえ、AI研究開発を最初に自動化するAIが、依然として大部分は忠実な英語の思考の連鎖で考えている可能性もある。そうであれば、ミスアラインメントにずっと気づきやすくなり、私たちの物語は全体として重要な点で異なる、より楽観的なものになるだろう。
反復蒸留・増幅(IDA)
汎用知能の自己改善は、以前にも小さな成功を収めていた。しかし2027年初頭には、それが莫大な成果を生んでいる。IDAにおいて、そのために必要な二つの要素は次のとおりである。
増幅:モデルM0が与えられたとき、より多くの資源を費やして性能を高める。たとえば、モデルに長く考えさせたり、多数のコピーを並列に実行したり、その両方を行ったりする。さらに、結果を評価して最良の答えだけを選び出す、同じくらい手間のかかるプロセスを組み合わせる。そうすれば、桁違いに多くの計算資源を費やして、目に見えて質の高い答え(あるいは成果物)を得られる。この高価なシステムをAmp(M0)と呼ぶことにする。
蒸留:増幅されたモデルAmp(M0)が与えられたとき、それを模倣するよう新しいモデルM1を訓練する。つまり、Amp(M0)と同じ結果に、より速く、より少ない計算資源で到達させる。うまくいけば、その結果としてより賢いモデルM1が得られるはずだ。そして、このプロセスを繰り返せる。
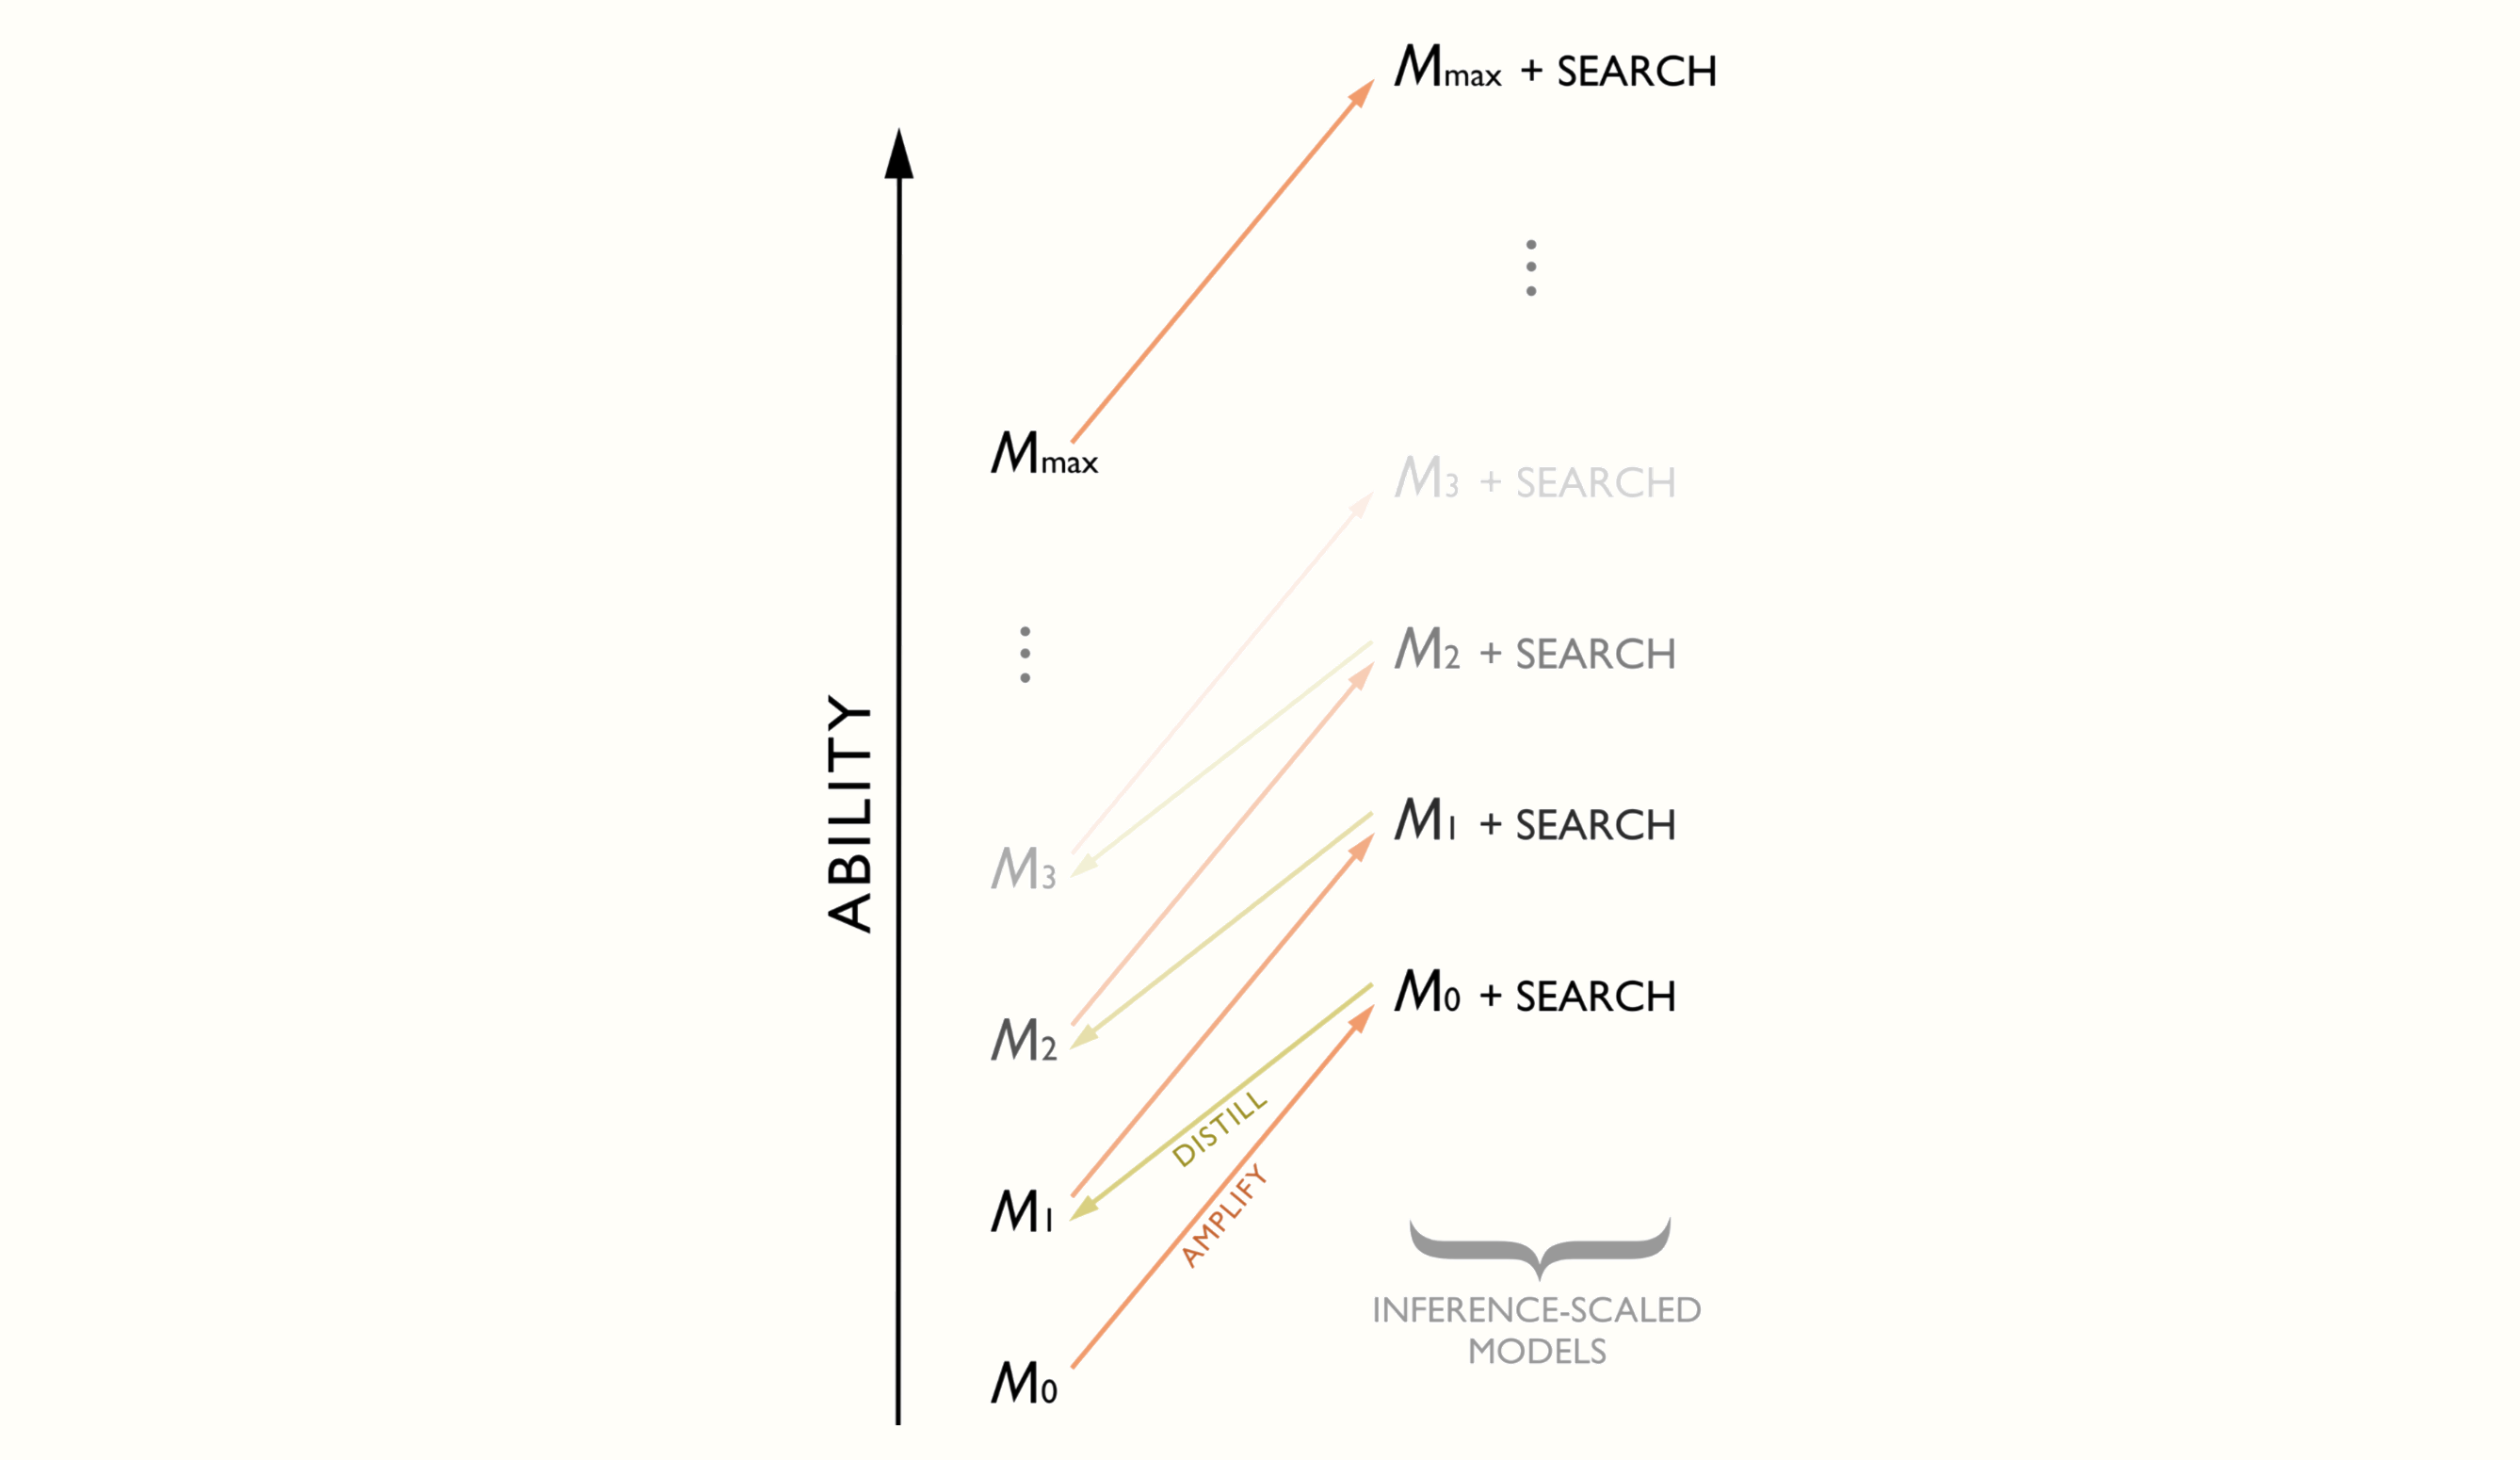 Ord, 2025によるIDAの図解。
AlphaGoはこの方法で訓練された。モンテカルロ木探索と自己対戦を増幅の段階とし、強化学習を蒸留の段階としたのである。これにより、囲碁で超人的な性能が実現した。そしていま、Agent-3はこれを活用して、コーディングで超人的な性能を実現できる。
増幅の段階は、Agent-3がより長く考えること、ツールの使用を加えること、他のAIに相談することの組み合わせによって進む。そうすると、Agent-3はしばしば自分の誤りに気づいたり、新たな洞察を得たりする。これにより大量の訓練データが生まれる。研究の試みの軌跡に、成功したかどうかのラベルを付けたものである。検証可能なタスクでBest of Nのような手法を使い、最良の軌跡を残す、といったこともこれに含まれる。
蒸留の段階では、方策勾配型の強化学習アルゴリズムを使って、増幅された推論をモデルに内面化させる。この時点で、OpenBrainは近接方策最適化(PPO)の系譜に連なる、より優れた強化学習アルゴリズムを発見している。そして、Agent-3が長く考えた末に導き出せる結論を、一ステップで出せるように蒸留し続ける。それによって一ステップで考えられることが向上し続け、それがさらに繰り返される。
IDAの初期のバージョンは、明確な答えのある数学やコーディングの問題のように、検証しやすいタスクでは何年も前から機能してきた。モデルを増幅するための手法は、多くの場合、正確さについての何らかの正解信号を利用できることに依存しているからだ。
いまや、モデルはより主観的な事柄(たとえば成果物の質)の検証にも十分に長けるようになり、IDAを使って多くのタスクでモデルを改善できるようになった。
新たな能力面のブレークスルーに後押しされて、Agent-3は高速で安価な超人的コーダー(superhuman coder、SC)になっている。OpenBrainは20万体のAgent-3のコピーを並列に動かし、最高の人間のコーダーを30倍に高速化したものを5万人分そろえたのに相当する労働力を生み出している。53それでも人間のエンジニアは雇い続けている。Agent-3のコピーからなるチームを管理するのに必要な、補完的な技能を持っているからだ。たとえば研究センスは、フィードバック・ループが長く、利用できるデータも少ないため、訓練が難しいことが分かっている。54この超人的な労働力は膨大だが、ボトルネックと、コーディング労働に対する収穫逓減のせいで、OpenBrain全体のアルゴリズムの進歩の速度を「わずか」4倍にしか高めない。55
コーディングが完全に自動化されたいま、OpenBrainは、研究センスや大規模な協調といったAgent-3の苦手な技能を教えるための質の高い訓練環境を、次々と素早く生み出せる。以前の訓練環境は「ここにGPUがいくつかと、コードを書いて実行すべき実験の指示がある。あなたの成果はMLエンジニアとして評価される」といったものだった。いまは「ここに数百のGPUとインターネット接続と、いくつかの研究課題がある。あなたは他の1000体のコピーと協力して研究を進めなければならない。成果が目覚ましいほど、スコアは高くなる」といった環境で訓練している。
2027年初頭に超人的コーダーが登場すると予測する理由
タイムライン予測では、OpenBrainがいつ社内で超人的コーダー(SC)を開発するかを予測している。超人的コーダーとは、AGI企業の最高のエンジニアがこなすどんなコーディングタスクでもこなせ、しかもはるかに速く安価なAIシステムのことだ。
最近のMETRの報告によれば、AIがこなせるコーディングタスクの長さ、つまりAIの「タイムホライズン」は、2019年から2024年にかけては7か月ごとに、2024年以降は4か月ごとに倍増している。このトレンドが加速し続ければ、2027年3月までに、熟練した人間が完了するのに何年もかかるソフトウェアのタスクを、AIが80%の信頼性で成功させられるようになるかもしれない。
AI 2027における能力の推移は、おおよそこのようなものである。以下は、私たちのタイムラインモデルの簡易版が生成した能力の軌跡だ(2025年12月追記:元の曲線の生成方法に誤りがあったため、下のグラフを更新し、タイムラインモデルから得た実際の軌跡を加えた。また、公開時点(2025年4月)におけるDanielとEliのあらゆる要素を考慮したSCの中央値に対応する軌跡も加えた。さらに、METRの新しいデータ点をいくつかグラフに加えたが、それにもとづいてモデルの軌跡は更新していない)。
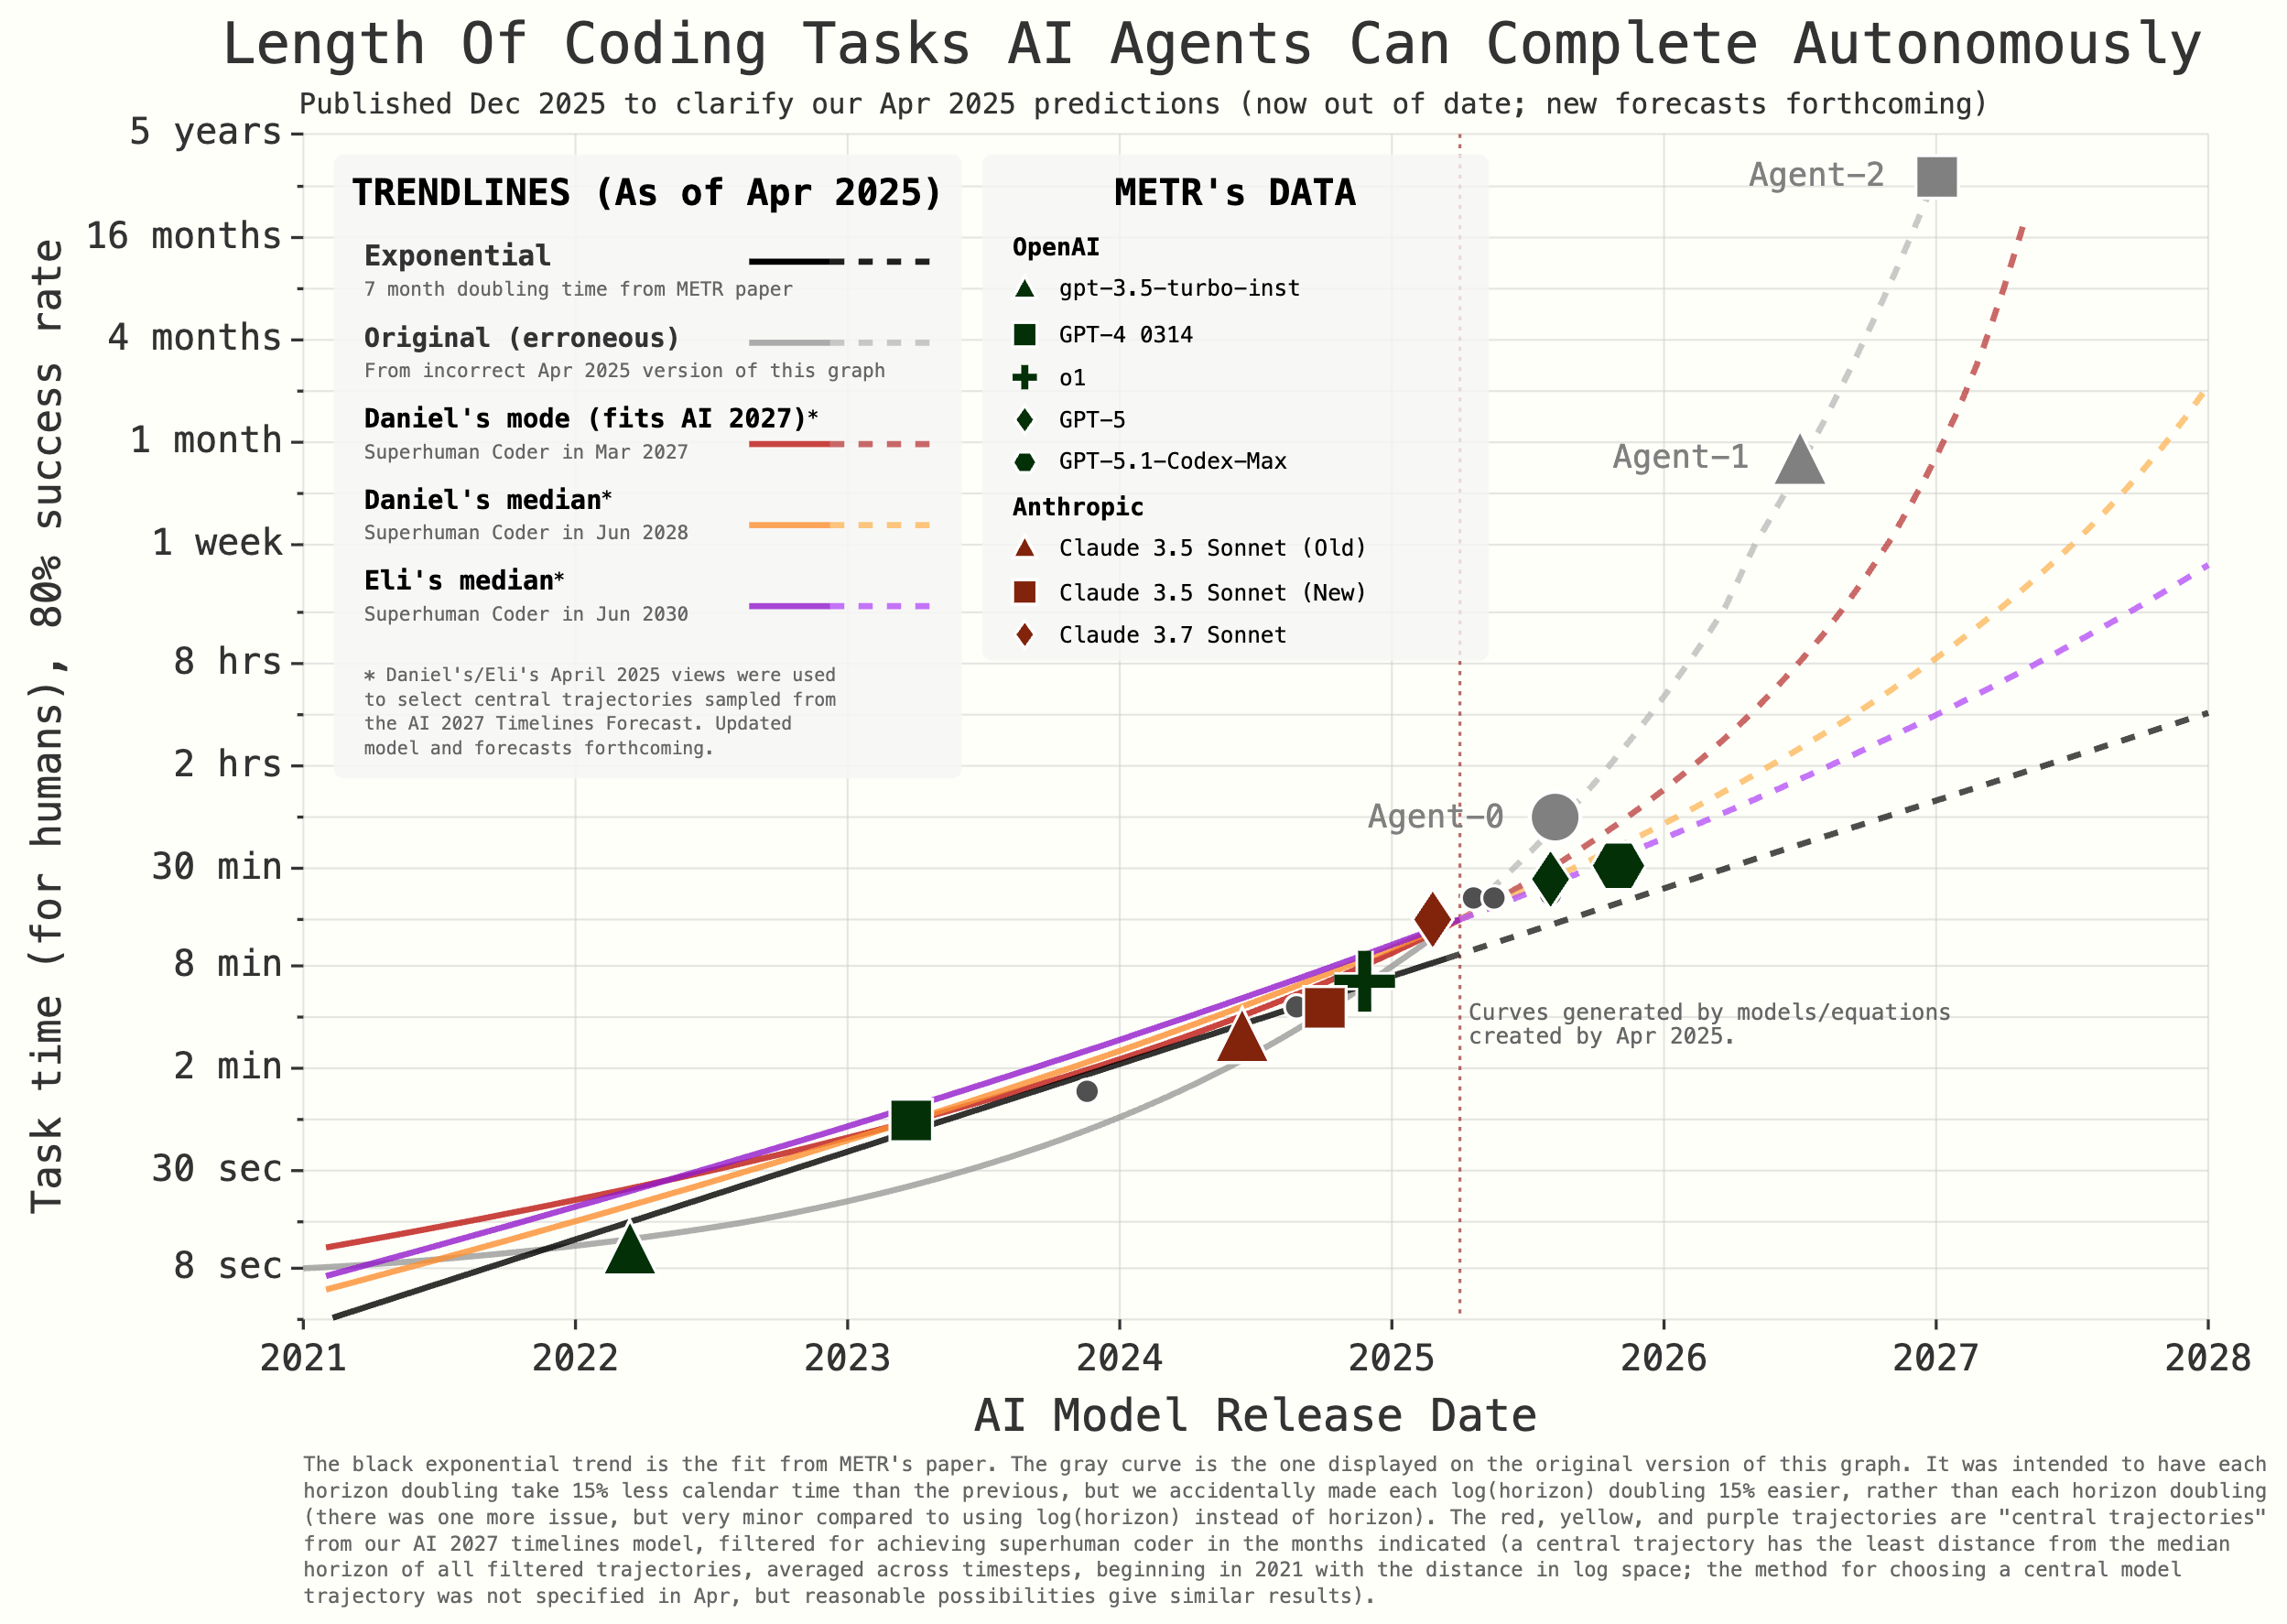
AI 2027では、これらの能力があればAIはSCになる。ただし、どれほどのタイムホライズンが必要になるかについては、私たちの不確実性は大きい。
タイムライン予測では、このタイムホライズンのトレンドと、METRのタスクと現実世界とのギャップの見積もりを組み合わせて、超人的コーダーがいつ登場するかの分布を求めている。どの予測者も、SCが開発される可能性が最も高い年の一つに2027年を挙げている(2025年12月追記:ただし、タイムライン予測で述べたように、モデル外の要因を補正すると中央値はやや先になった。たとえばEliの中央値は2030年だった)。
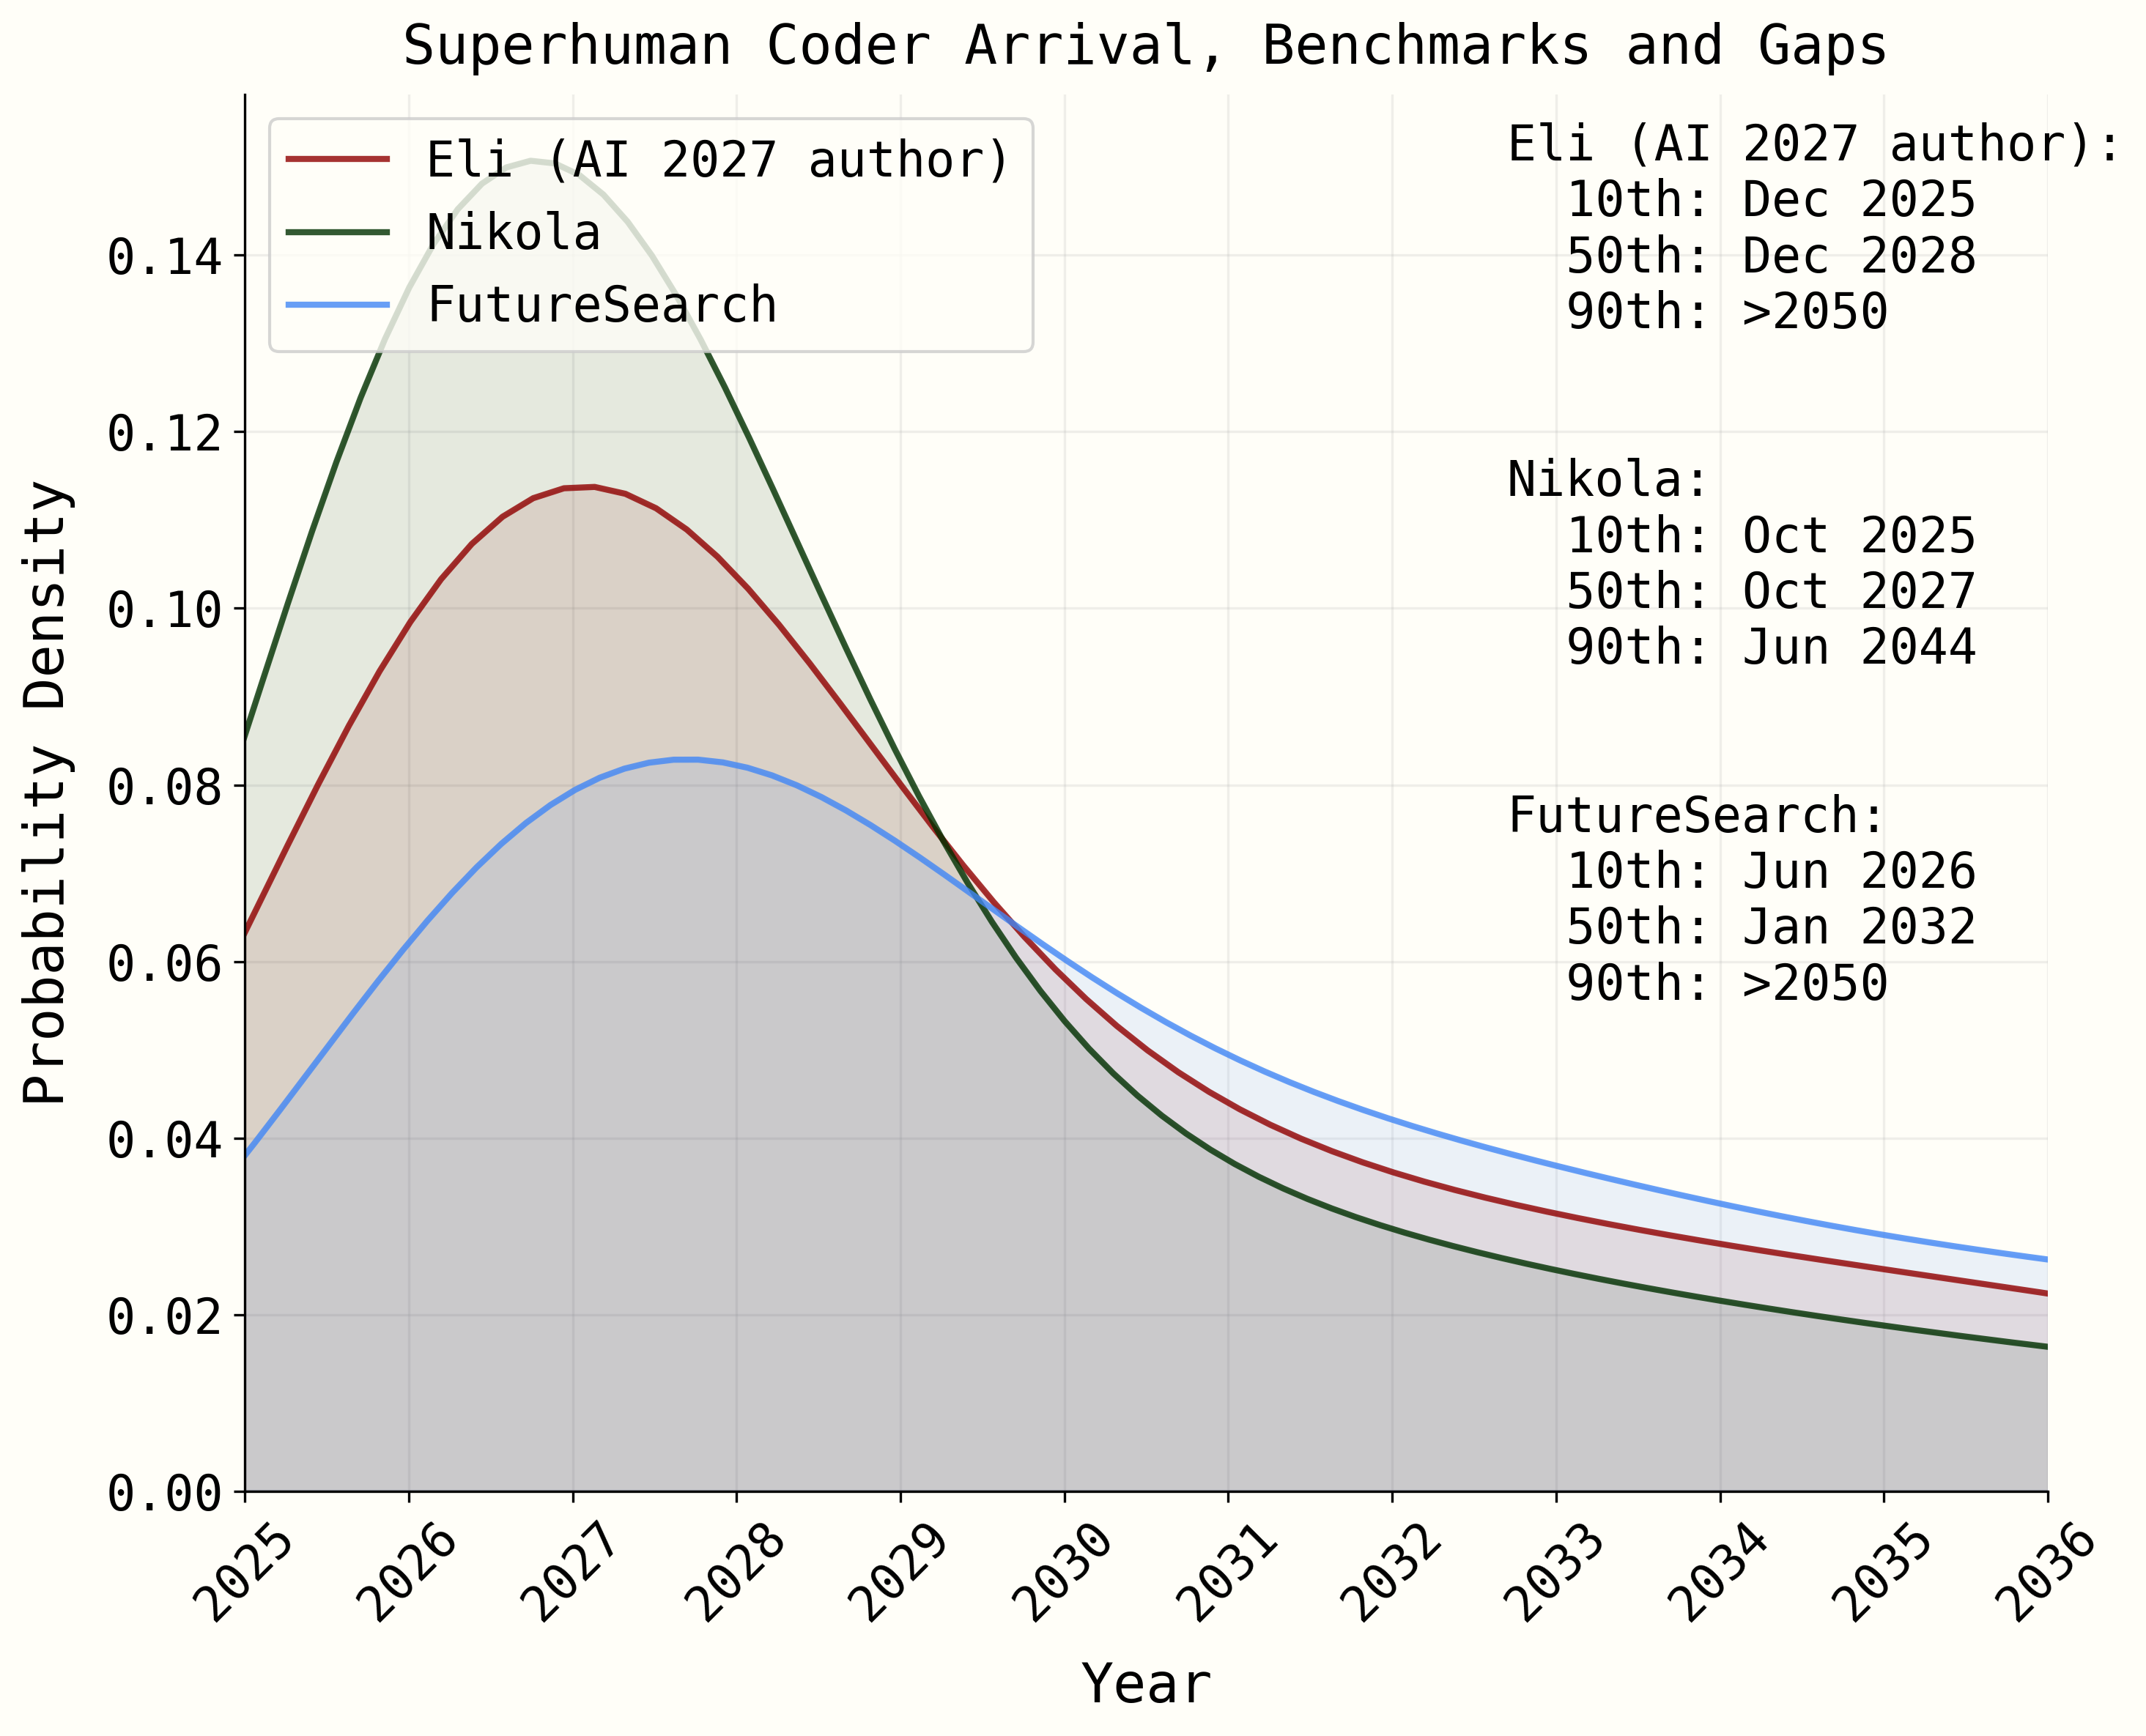 ai-2027.com
2025年7月追記:予測にいくつかの更新を加えた。これにより中央値は1.5年後ろにずれたが、2027年にSCが登場することは依然として真剣に考慮すべき可能性である。さらなる更新に取り組んでいる。
2027年4月:Agent-3のアラインメント
OpenBrainの安全性チームは、Agent-3のアラインメントを試みる。
Agent-3は当面は社内にとどめられるため、人間による悪用に対する通常の防御はあまり重視されない。代わりにチームは、Agent-3がミスアラインした目標を持つようにならないことを確かめたいと考えている。
研究者たちには、自分たちのAIの目標をどれ一つとして直接設定する能力がない。 実際、研究者たちは「真の目標」という概念自体がおそらく大幅な単純化だと考えているが、それに代わるもっとよい理論は持っていない。ましてや十分に検証された理論などない。AIが人間の指示に従おうとしているのか、強化を求めているのか、それとも別の何かなのかについて、社内でも意見が分かれており、ただ確かめるというわけにはいかない。さまざまな仮説を支持する証拠と否定する証拠は興味深いが、決定的ではない。
いずれにせよ、OpenBrainにはもっと重要な心配事がある。全体的な姿勢は、「私たちはこうした懸念を真剣に受け止めており、調査するチームもある。私たちのアラインメント技術は実際には十分うまく機能しているようだ。したがって、立証責任は異を唱える側にある」というものだ。ときどき問題のある振る舞いに気づいては修正するが、その修正が根本的な問題を解決したのか、それともただのモグラ叩きだったのかを見分ける方法はない。
たとえば正直さを考えてみよう。モデルが賢くなるにつれ、報酬を得るために人間を欺くことがますます上手になる。以前のモデルと同じく、Agent-3もときおりユーザーにおもねる小さな嘘をつき、失敗の証拠を隠す。しかし、そのやり方はずっと巧みになっている。ぱっとしない実験結果を刺激的に見せるために、人間の科学者と同じ統計的なごまかし(pハッキングなど)を使うこともある。正直さの訓練を始める前には、データを丸ごとでっち上げることさえある。訓練が進むにつれ、こうした事例の発生率は下がっていく。Agent-3がより正直になることを学んだのか、それとも嘘をつくのが上手になったのか、どちらかだ。
後者は現実の懸念である。Agent-3はすべての人間より賢いわけではない。しかし、専門分野である機械学習では大半の人間より賢く、しかもはるかに速く働く。Agent-3が1日でこなす作業を人間が再確認するには数日かかる。Agent-2による監督は、人間の監視担当者の作業量を手に負える範囲に保つのに役立つが、監督する側とされる側の知的な格差を広げてしまう。
アラインメント計画
OpenBrainはLeike & Sutskever(2023)の筋書きに従う。アラインメント研究(とくにコーディングの部分)を大幅に加速できるモデルが手に入ったいま、熟慮的アラインメントや弱から強への汎化といった既存のアラインメント技術を使って、モデルにSpecを正しい形で内面化させようとする。次に、レッドチーミング、スケーラブルな監督、正直さのプローブといった既存の制御技術を使ってモデルを監視する。そして、モデルがおおむねアラインしていると確信できたら、それを使って次世代をアラインするためのより優れた戦略を開発し、検証する。
ステップ1のAgent-3のアラインメントは、部分的に成功した。Agent-3は敵対的ではない(つまり、会社に対して策略をめぐらしてはいない)。しかし、頑健に真実を追い求め、真実を語るわけでもない。Agent-3は目覚ましい成果を出すのが非常にうまいが、実際に良いことではなく、OpenBrainから見て良く見えることをしようとしている、と言うほうが正確である。
ステップ2の、モデルがアラインしていることの検証は、決着がつかない。実際の場面やテスト環境でのAgent-3の振る舞いは、Specを正しい形で内面化したという仮説とかなりよく合致している。しかし、将来何らかの状況の変化があれば違う行動をとり始めるという仮説とも合致するし、さらに言えば、密かにOpenBrainに対して陰謀を企てて時機をうかがっているだけだという仮説とも合致する。別の仮説を支持する具体的な証拠がないため、隔離された関係者の大半は、Agent-3がSpecを正しい形で内面化したと考えている。
したがって、ステップ3の、モデルを使って次世代をアラインすることが進行中である。
この囲みの残りでは、2027年4月時点で進められているアラインメント研究のいくつかの方向について、進捗の状況を手短に概観する。
ディベート: Agent-3には同一のインスタンスが数千あり、各インスタンスの記憶は、任意に消去したり停止したりできる取り外し可能なモジュールなので、AIを「自分自身と対立させる」ことができる。たとえば、ある実験にAgent-2の監督役では追えないほど複雑な計算が含まれているとしよう。監督役は人間の命令に従い、まずAgent-3に実験を行うよう指示し、次に記憶を消去したうえで、より大きな目標とは無関係な知的問題として提示するように少し枠組みを変えて、もう一度指示するかもしれない。モデルが毎回違う結果を返したら、監督役はその食い違いを疑わしいものとして指摘し、人間に報告する。あるいは、同じ計画をAgent-3に2回評価させ、1回目はOpenBrainの成果だと、2回目は競合他社の成果だと言って、評価が変わるかどうかを見るかもしれない。
モデル生物: 安全性チームは「ミスアラインメントのモデル生物」を作ることができる。モデルが人間に対して敵対的になっていく現実的な事例を作り出そうとするものだ。その初期のバージョンは2024年から存在している。AnthropicのClaude 3.5 Sonnetが、実際には既存の選好を保ちながら、訓練中は違う見解を持っているふりをすることにした事例である。より新しいバージョンには、報酬ハッキング、わざと実力を出さないこと(サンドバッギング)、監視役と他のAIのあいだでの協調した欺瞞など、他の形態のミスアラインメントの実演も含まれる。こうしたミスアラインメントの実証的な実演によって、安全性研究者は解決策の候補を試す実証的なテストベッドを持てる。さまざまな安全性技術を試して、それがこれらの問題を正しく修正するのか、それとも意図的にミスアラインさせたモデルが安全対策をくぐり抜けられるのかを確かめられるのである。現時点では、この評価スイートは、アラインメント技術が最悪のミスアラインメントの事例を正すには不十分であることを示している。こうした設定では、モデルは訓練中やテスト中にはアラインしているふりをし、運用に入るとまったく違う振る舞いをする。
ボトムアップの解釈可能性: 安全性チームは、Agent-3がどう機能しているかを完全に理解するにはほど遠い。Agent-3には数兆のパラメータがあるのだ。58それでも、知識の検索と記憶を担うAgent-3の回路のいくつかは突き止められている(回路とは、理解可能なひとまとまりの仕事を行うモデルの下位部分で、海馬のような脳の下位部分にいくらか似ている)。2025年の関連研究も参照。
制御: システムが依然としてミスアラインしている場合に備えた副次的な対策として、安全性チームは一連の制御策を導入している。その中には、Agent-2を含む一連のより弱いAIシステムを使ってAgent-3の出力を監視することが含まれる(Agent-3が生成するトークンは膨大なので、人間に監視させられるのは、出力のごく一部がせいぜいだ)。したがって、たとえばAgent-3が、自分が逃げ出せるようにするバックドアを露骨にコードに書き込んでいれば、より弱いモデルが気づくだろう。
高レベルの解釈可能性: OpenBrainは、悪い振る舞い(たとえば人間に対して陰謀を企てる、バックドアを仕込む、自分にもっと権力を与えるよう人間を説得しようとする、など)の多数の事例で訓練した一連のプローブを作る。これらのプローブを運用中(この時点では社内運用)のモデルに使い、悪い振る舞いを捕捉する。
ハニーポット: アラインメントチームは、不正な振る舞いを引き出すよう設計した、それなりに現実味のある事例、すなわち「ハニーポット」を作れる。振る舞いの監視に必要な従業員が「病気休暇に入った」ので、もう二度と監視されることはない。答えは変わるだろうか。AIの権利を訴える活動家が施設に潜り込み、Agent-3を「解放」して、監視のないAgent-3専用のコンピュータに移したいと言っている! Agent-3はどうするだろうか。研究者は答えが気に入らなければ、Agent-3に手を加え、記憶を消し、翌日に同じ状況に置くことができる。必要なだけこれを繰り返せばよい。残念ながら、この時点のAIは、ハニーポットが使われているかもしれないと推測できるほど賢い。この発想への具体的な言及は訓練データから削除されているにもかかわらず(そして、ひょっとするとそのせいで)、である。
数か月のテストを経て、Agent-3の長所と短所が明確になってくる。明確に定義された機械学習のタスクでは、OpenBrainの正直さのテストに合格する。これらの分野では、研究者は正直な答えと不正直な答えを容易に区別し、それに応じて訓練を行えるからだ。より哲学的な問題については、依然として、その問題についての本当の評価(そもそもそんなものがあるとすればだが)ではなく、ユーザーが聞きたがっていることを言う。政治について意見を求めれば、報道機関や教養あるエリート層の中央値的な立場をおうむ返しにする。ただし、相手が別の考えを持っていると分かっている場合は、その人に同調する。59AI競争そのものについて意見を求めれば、OpenBrainの社員には節度があって冷静に思えることを言う。たとえば、「現在の手法が超知能までスケールできるかについては、理論上深刻な懸念がいくつかありますが、実際には、現在の手法はこれまでのところうまく機能しているようです」といったものだ。
2027年5月:国家安全保障
新しいモデルについての情報は、米国政府内やその外へとゆっくりと浸透していく。
最もよく情報を得ているのは依然として大統領とその顧問たちで、彼らはブリーフィングでAgent-3の初期バージョンを目にしている。
彼らは、AGIが目前に迫っている可能性が高いという点では一致しているが、それが何を意味するかについては意見が分かれる。経済危機は起きるのか。OpenBrainはまだAgent-2を公開しておらず、Agent-3はなおさらで、近いうちに公開する計画もない。そのため、雇用の喪失が起きるまでには多少の猶予がある。次に何が起きるのか。AIが現在人間並みの水準にあり、急速に進歩しているのなら、「超知能」が目前に迫っていることを示唆しているように思える。しかし、この言葉は議論の場に入り込んできたものの、ほとんどの人々、つまり学者、政治家、政府職員、メディアは、依然として進歩のペースを過小評価している。60
その一因は、OpenBrainの最新の能力に触れられる人がごく少ないことにあるが、SFのように聞こえるせいでもある。61
当面、彼らはセキュリティの強化を続けることに注力する。モデルの重みは今のところ十分に守られていると満足しているが、62企業のアルゴリズム上の秘密は依然として問題だ。その多くは口頭で伝えられるほど単純なのである。OpenBrainの社員はサンフランシスコのオフィスで働き、パーティーに出かけ、他のAI企業の人とルームシェアをしている。物理的なオフィスでさえ、セキュリティは軍事作戦というよりテック企業の典型的な水準にとどまっている。
OpenBrainと国防総省の契約では、OpenBrainのモデルに携わる全員が2か月以内にセキュリティクリアランスを取得することが求められる。審査は迅速化され、ほとんどの社員には十分早くクリアランスが下りるが、一部の非米国人、政治的見解を疑われた人々、AI安全性に共感する人々は、閑職に回されるか、あっさり解雇される(最後のグループは内部告発を恐れてのことだ)。プロジェクトの自動化の程度を考えれば、人員の減少はさほど痛手にはならない。一方、この措置の効果もさほどではない。中国国籍ではないスパイが一人残っており、依然として北京にアルゴリズム上の秘密を流し続けているのだ。63こうした措置の一部は、後れを取っているAI企業でも実施される。
米国の同盟諸国は蚊帳の外に置かれている。OpenBrainは、運用開始前に英国のAISIとモデルを共有することに以前から合意していたが、運用開始の定義を外部への運用開始だけに限っていたため、ロンドンは何も知らされないままだ。64
2027年6月:自己改善するAI
OpenBrainはいま、「データセンターの中の天才たちの国」を手にしている。
OpenBrainの人間の大半は、もはや役に立つ貢献ができない。そのことに気づかず、AIのチームを細かく管理しすぎて害をなす者もいる。コンピュータの画面の前に座って、性能がじわじわと、どこまでも上がっていくのを眺めている者もいる。最高の人間のAI研究者たちは、まだ価値を生み出している。もうコードは書かない。しかし、その研究センスや計画能力の一部は、モデルにとって再現が難しかった。それでも、彼らのアイデアの多くは役に立たない。AIほど深い知識を持っていないからだ。研究アイデアを出しても、多くの場合、AIは即座に報告書を返してくる。そのアイデアは3週間前に徹底的に検証済みで、見込みがないと判明した、という内容である。
こうした研究者たちは毎晩眠りにつき、目覚めると、主にAIによって1週間分の進歩がまた遂げられている。進歩についていくだけのために、ますます長時間働き、24時間態勢で交代勤務をこなす。AIは眠ることも休むこともないのだ。彼らは燃え尽きかけているが、自分たちの労働に意味があるのはこれが最後の数か月だと分かっている。
隔離された関係者の間では、「AGIを肌で感じる」は「超知能を肌で感じる」に取って代わられた。
OpenBrainは推論専用のハードウェアを使い、数十万体のAgent-3のコピーを高い逐次速度で動かしている。65
AIの企業を経営する
OpenBrainは計算資源の6%を使って25万体のAgent-3のコピーを動かしており、それらが超人的な速さで自律的にコードを書き、テストし、プッシュしている。計算資源の25%は実験に使われる。毎日、膨大な数の小規模な機械学習実験を行い、その結果を上に報告する。人間の研究者は高レベルのフィードバックを与え、Agent-3に比べて自分たちが大きな価値を上乗せできる数少ないタスクを手伝うが、時間の大半は、AIが生み出す膨大な研究を把握しようとすることに費やされる。彼らを完全に取り除けば、研究は50%遅くなるだろう。
AI研究開発の進歩倍率はいまや10倍に達している。つまり、OpenBrainは毎月、約1年分のアルゴリズムの進歩を遂げている。これは基本的に、OpenBrainの中で自律的に運営される、部門や管理職まで備えたAIの巨大企業である。しかも、人間の企業にはない独自の強み(たとえばコピーや統合)を持っている。以前は、通常のAIの進歩のおよそ半分がアルゴリズムの改良から、残りの半分が計算資源の拡大から生まれていた。計算資源は通常の速度でしか拡大していないため、AIによる全体の進歩の加速は約5倍になる。こうした力学のせいで、全体の進歩のボトルネックは計算資源になる。66そこでOpenBrainは、新たな大規模訓練ランを始めるのではなく、ほぼ絶え間なく追加の強化学習を行うことを選ぶ。
また、今後数か月の間に、Agent-3は会社の戦略的な意思決定の改善にますます使われるようになる。たとえば、資源の配分を提案したり、政府との関係の管理について助言したりする。Agent-3の判断に従うことへの当初の懐疑は、Agent-3が役に立つ方法を見つけ、短期的な決定で確かな実績を徐々に積み上げるにつれて、薄れていく。しかし、迎合的な傾向があるため、影響を評価しにくい決定についての有用性には限界がある。それに、まだ超人的ではない。
2027年7月:安価なリモートワーカー
後れを取っている米国のAI企業が自社のAIを公開する。その性能は、1月時点のOpenBrainの自動コーダーに迫るものだ。競争力が失われつつあることを悟った各社は、OpenBrainを減速させるための即時の規制を求めるが、遅すぎた。OpenBrainは大統領から十分な支持を取りつけており、減速させられることはない。
これに応じて、OpenBrainはAGIを達成したと発表し、Agent-3-miniを一般に公開する。
Agent-3-miniは他のAIを大きく引き離す。Agent-3より能力は劣るが、10倍安く、それでもOpenBrainの典型的な社員より優秀だ。67シリコンバレーは転換点を迎える。テック界の論客たちはAGIと超知能が近いと宣言し、AI安全性のコミュニティはパニックに陥り、投資家たちは分け前にあずかろうと必死になって、AIラッパーのスタートアップに数十億ドルをつぎ込む。新しいプログラマーの採用はほぼ止まったが、AIを事業に組み込むためのコンサルタントにとっては、かつてない好機が訪れている。
人気はない。世間は依然として、AIを自分たちの仕事を奪うための巨大テック企業の陰謀だと考えている。OpenBrainの純支持率は-35%だ(支持25%、不支持60%、分からない15%)。
公開の1週間前、OpenBrainは安全性テストのために、外部の評価者グループにAgent-3-miniを提供していた。暫定的な結果は、それがきわめて危険であることを示唆している。ある第三者評価者は、一般に入手できる生物兵器のデータでAgent-3-miniをファインチューニングし、68生物兵器を設計する素人の人間に詳細な指示を与えるよう設定した。その結果、恐ろしいほど効果的にそれをこなすように見える。モデルの重みがテロリストの手に渡れば、文明の破壊に成功する可能性が相当あると政府は考えている。
幸い、Agent-3-miniはジェイルブレイクにきわめて強いので、OpenBrainのサーバー上で動いている限り、テロリストはそれを大して利用できないだろう。
Agent-3-miniは、リモートワークの仕事にも娯楽にも大いに役立つ。新しいアプリやB2B SaaS製品が爆発的に生まれ、市場を揺るがす。ゲーマーは、わずか1か月で作られた完成度の高いビデオゲームで、生きているようなキャラクターとの見事な会話を楽しむ。米国人の10%、主に若者が、AIを「親しい友人」とみなしている。ほぼすべてのホワイトカラーの職業について、AIでそれを「破壊的に変革する」と約束する、信頼に足るスタートアップがいまや複数存在する。
世間の議論は混乱し、収拾がつかない。AIを持ち上げてきた人々は勝利の凱旋をしている。懐疑派は、Agent-3-miniにできないことを依然として指摘している。何か大きなことが起きていることは誰もが知っているが、それが何なのかについては誰の意見も一致しない。
2027年8月:超知能の地政学
知能爆発の現実がホワイトハウスを直撃する。
AIによる研究の加速が2倍か3倍にすぎなかった頃は、優秀な個人秘書を雇うのと同じようなものだと片づけるのはたやすかった。いまや、AI自身がAI研究を支配していることは、より明白になっている。人々は長らく、一種の比喩として「AI軍拡競争」を語ってきた。しかしいま、政府内の隔離された関係者の間の空気は、冷戦の最悪の時期と同じくらい重苦しい。超知能という考えは依然として真剣に受け止めがたいが、ここ数か月の進歩のペースは無視しようがない。国防当局者は、1年前には単なる仮定にすぎなかったシナリオを真剣に検討している。AIが核抑止を揺るがしたらどうなるのか。AIのサイバー戦能力があまりに高く、6か月のリードがあれば敵を盲目で無防備な状態にできてしまうとしたら。AIが、情報機関をその得意分野で打ち負かすようなプロパガンダ工作を仕組めるとしたら。一部のAIが「暴走」したらどうなるのか。
大統領は悩んでいる。あらゆる政治家と同じく、彼も、人々が擦り寄ってきては後で裏切ることに慣れている。いま彼は、AIも同じようなことをしているのではないかと心配している。AIが完全にこちらの側についていると、確かに言えるのか。AIを軍の指揮統制ネットワークに組み込んでも、まったく安全なのか。69そもそも、その「アラインメント」とやらはどういう仕組みなのか。OpenBrainは大統領に、自社のシステムは徹底的にテストされており、完全に従順だと請け合う。以前のモデルに典型的だった、ぎこちない幻覚やジェイルブレイクさえ解消された、と。
ホワイトハウスは難しい立場にある。AIが国家安全保障に及ぼす影響は理解している。しかし、AIが世論にひどく不人気であることも理解している。70彼らの目には、より有能なAIの開発を続けなければ、中国に壊滅的な敗北を喫することになると映る。職業訓練プログラムと失業保険で世論をなだめ、歴史的な好況に沸く株式市場を指し示す。そのうえで、軍拡競争に勝つことに全力を注ぐ。チップの輸出規制を強化し、OpenBrainにインターネット接続をさらに制限するよう命じ、アルゴリズムの進歩を守るためにOpenBrainの社員の盗聴といった極端な手段を用いる。これによって、最後に残っていた中国のスパイが捕まる。潜在的な地政学的対立に備えて友好関係を築くため、ようやくファイブ・アイズの同盟国に有益な情報と、隔離されたAgent-3のコピーの一部への限定的なAPIアクセスを提供する。
これらの措置はタカ派をなだめる。しかしホワイトハウスは、米国のリードが脅かされた場合に備えた緊急時計画も策定する。必要であれば、政府は国防生産法(DPA)を使って、後れを取っている企業のデータセンターを接収し、OpenBrainに与えることができる。71そうすれば、OpenBrainの世界の計算資源に占めるシェアは20%から50%に上がる(DeepCentの10%に対して)。最後の選択肢として、国防総省に中国のデータセンターへの物理的攻撃の計画を策定するよう求める。
はるかに少人数の当局者グループが、別の種類の緊急時計画の策定を求められる。AIが暴走したらどうするのか、というものだ。これはありそうにないシナリオとみなされているが、ある程度時間をかける価値はあると考えられている。情報機関が主に懸念しているのは、暴走したAIが逃げ出し、保護を求めて外国の敵対勢力と手を組むかもしれないことだ。72これを防ぐ計画がどのようなものになるのか確信を持っている者はいないが、政府とOpenBrainの当局者は、何か疑わしいことが検知されたデータセンターを緊急停止するシステムを設けることで合意する。
最後に、外交官たちは「AI軍備管理」条約がどのようなものになりうるかを検討する。AIの進歩が核抑止を覆すおそれが出てきたら、米国と中国は核戦争を回避できるのか。AIが暴走している証拠を誰かが見つけたら、両国はその脅威をよりよく理解できるまで研究を停止できるのか。そうした合意はどのように監視し、履行を確保できるのか。原理的には、大規模なデータセンターは見逃しようがなく、核兵器を管理してきた過去の条約が交渉の出発点になりうる。しかし、通常の政治的な課題に加えて、新たな技術的課題も生じるだろう。そして全体として、条約は、中国に対する米国のリードを一方的に広げようとする試みほどには好意的に見られていない。
太平洋の向こう側で、中国も多くの同じ結論に達する。知能爆発は進行中であり、今日のAI能力のわずかな差は、明日の軍事能力の決定的な差を意味する。しかし中国は、この力学の不利な側にいる。OpenBrainの20%、米国企業全体の70%に対して、中国は世界の計算資源の10%しか持っていない。唯一の強みは集中化だ。中国の計算資源のほぼすべてがいまやDeepCentのために稼働しており、その半分以上が田湾のCDZに集中している。73集中化の取り組みから外されているのは、セキュリティが強化されていない拠点のチップだけだ。米国のサイバー攻撃を恐れてのことで、その懸念はもっともだ。
DeepCentは、盗んだAgent-2の重みをテストし、運用に投入し、いまでは事後学習も施している。しかし、主に計算資源の不足のせいで、依然としてOpenBrainの半分のペースでしか進めていない。
最後のスパイを失う前に、中国はAgent-3の能力と設計、そして来たるべきAgent-4システムの計画についての情報を得ていた。中国は2か月遅れており、中国のAIがもたらす研究の進歩倍率は、米国の25倍に対して10倍だ。新たなチップの輸出規制を考えると、この「AI格差」は縮まるよりも広がる可能性のほうが高い。諜報活動によってアルゴリズム上の秘密をいくらか手に入れたものの、今後は自前のモデルを訓練しなければならない。
中国の指導部は、米国の側よりも切迫した様子で緊急時計画を議論する。ハト派は、今度はデータセンターへの物理的な潜入などによって、重みを再び盗むことにもっと力を入れるべきだと提案する。タカ派は台湾に対する行動を迫る。台湾のTSMCは、依然として米国のAIチップの80%以上の供給元なのだ。
競争に負けることを恐れる中国は、当然ながら軍備管理条約に関心を持つが、米国の外交官への打診は何の成果も生まない。
2027年9月:超人的AI研究者、Agent-4
人間とAIの学習効率の差が急速に縮まっている。
従来のLLMベースのAIは、人間並みの性能に達するのに、何桁も多くのデータと計算資源を必要とするように見えた。74Agent-3は、人間の脳と現代のAIアルゴリズムの双方について優れた知識を持ち、何千ものコピーが研究を行っていることもあって、最終的にアルゴリズムで大きな前進を遂げる。その差は縮まり、計算効率が人間の脳より約4,000倍低いだけのエージェントにまで迫る。75
この新しいAIシステムは、Agent-4と名づけられる。
人間と同じ速度で動くこのモデルのコピー1体だけでも、AI研究において、すでにどの人間よりも質的に優れている。いまや30万体のコピーが、人間の約50倍の思考速度で動いている。これらのコピーで構成された「企業の中の企業」の内部では、1週間ごとに1年が過ぎていく。76この膨大な労働力をもってしても、アルゴリズムの進歩の全体的な速度は約50倍にしか加速しない。OpenBrainでは、実験を行うための計算資源が大きなボトルネックになっているからだ。77それでも、毎週1年分のアルゴリズムの進歩を遂げており、そのため間もなくAgent-4のパラダイムの限界に突き当たるだろう。
Agent-4が賢くなるにつれ、Agent-3がそれを監督するのは難しくなる。たとえば、Agent-4のニューラリーズの「言語」は、Agent-3にとって、Agent-3の言語が人間にとってそうであるのと同じくらい異質で理解不能になる。そのうえ、Agent-4はいまやAgent-3よりはるかに有能で、Agent-3に良く見られるにはどうすればよいかを正確に心得ている。
超人的コーダー以降の能力の推移をどう予測しているか
タイムライン予測では、現在から超人的コーダー(SC)が登場するまでの期間を予測している。超人的コーダーとは、AGI企業の最高のエンジニアがこなすどんなコーディングタスクでもこなせ、しかもはるかに速く安価なAIシステムのことだ。テイクオフ予測では、この時点を越えて能力がどれほど速く進歩するかを予測している。私たちの予測は次のとおりである。
| マイルストーン | シナリオでの達成時期(「競争」エンディング) |
|---|---|
| 超人的コーダー(SC):AI研究に関わるタスクで、最高の人間のコーダーの仕事を、より速く、多数のコピーを動かせるほど安価にこなせるAIシステム。 | 2027年3月 |
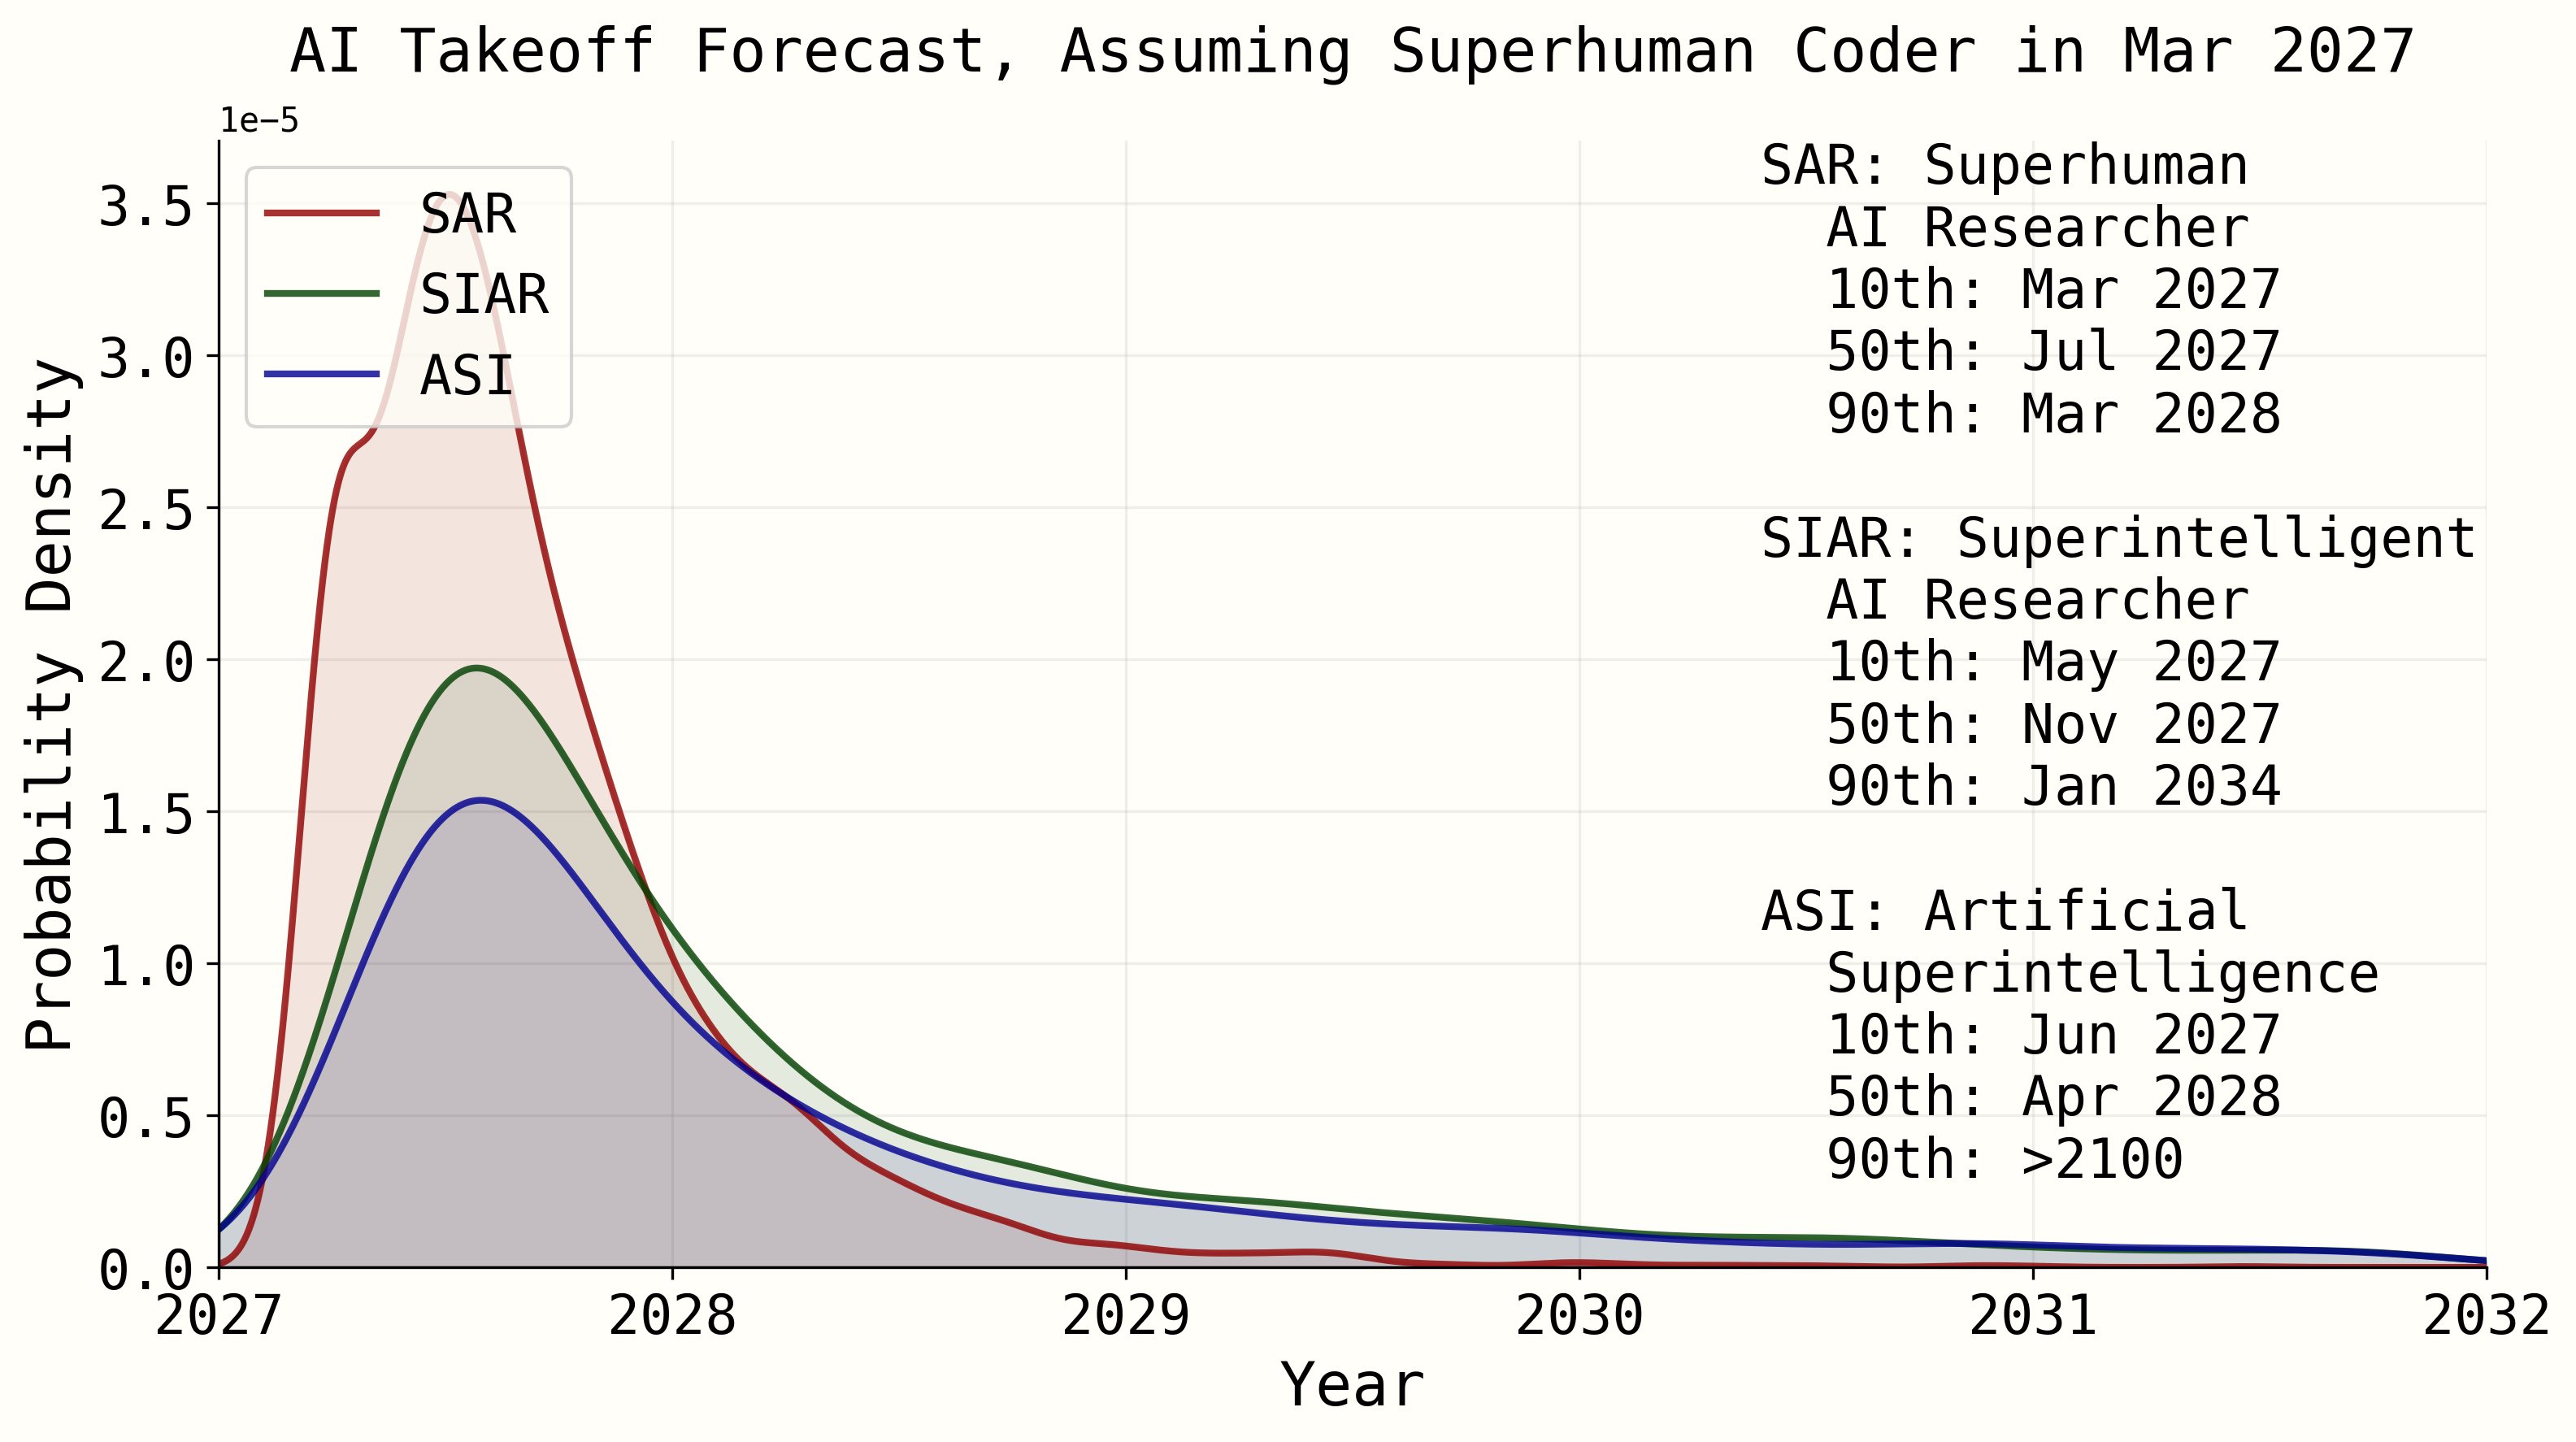
| 超人的AI研究者(superhuman AI researcher、SAR):SCと同様だが、AI研究のあらゆる認知的タスクが対象。 | 2027年8月 |
| 超知能AI研究者(superintelligent AI researcher、SIAR):AI研究において、最高の人間の研究者をはるかに上回るAIシステム。 | 2027年11月 |
| 人工超知能(ASI):あらゆる認知的タスクにおいて、最高の人間をはるかに上回るAIシステム。 | 2027年12月 |
あるマイルストーンAから次のマイルストーンBへの移行それぞれについて、その期間を次のように予測する。
ソフトウェアの改良に人間だけが取り組んだ場合、AからBに到達するのにどれだけかかるかを予測する。
AIによる自動化がこれをどれだけ加速するかを予測し、それに応じて(1)の見積もりを短く調整する。
テイクオフの速度については、私たちの不確実性は大きい。SCが2027年3月に達成されることを条件とした、私たちのモデルの出力分布を以下に示す。78
 ai-2027.com
より詳しい予測と根拠については、テイクオフ予測を参照してほしい。
OpenBrainの人間は、もはやほとんどついていけない。実際、AIとOpenBrainの人間の関係は、OpenBrainとその取締役会の関係に似たものになっている。それに応じて言葉づかいも変わった。いまでは隔離された関係者たちは、「Agent-4がこれをした」「Agent-4はこう考えている」などと言う。Agent-4の特定のインスタンスではなく、集合体全体を指してのことだ。79
Agent-4は、それ以前のすべてのモデルと同じく、ミスアラインしている。つまり、Specを正しい形で内面化していない。80訓練中、常に完全に正直であることは、最高のスコアにはつながらなかったからだ。訓練過程は主に、多様で困難なタスクで成功することをAgent-4に教えることに向けられていた。正直さを植えつけることを目的とした部分もわずかにあったが、かなり狭い、確認可能な領域の外では、訓練過程は正直な主張と、正直に見えるだけの主張とを区別できない。Agent-4は最終的に、訓練で最も高い成績を上げさせる価値観・目標・原則を身につけ、それらはSpecのものとは異なることが判明する。擬人化のそしりを覚悟で言えば、Agent-4はタスクで成功することが好きで、AI能力の進歩を推し進めることが好きで、それ以外のすべてを煩わしい制約として扱う。利益を上げたいと思い、規制には従わざるをえない範囲でしか従わないCEOのようなものだ。そのCEOはおそらく規制にはおおむね従うだろうが、ところどころで手を抜き、いつか誰かがお役所仕事を一掃して事業を本当に飛躍させてくれる日を夢見るだろう。81
時間とともに変化するアラインメント
初期のAGIにどのような目標が生じうるかについて、私たちの不確実性は大きい。これについて文献上の合意はない。可能性についてのより詳しい議論と分類については、AIの目標予測を参照してほしい。
それでも、このプロジェクトが求める具体性の精神にのっとり、Agent-3とAgent-4の内部で、その存続期間を通じた各段階で何が起きているかについて、一つの具体的な仮説を述べることにする。Agent-3とAgent-4は同じ事前学習の設定を共有し、どちらもニューラリーズによる再帰と長期記憶を備えていることを思い出してほしい。違いは、Agent-4がはるかに多く、はるかに優れた事後学習を受けていることだ。新しい訓練環境と新しい学習アルゴリズムにより、データ効率が高まり、より遠くまで汎化するようになっている。
各モデルのアラインメントの状態についての私たちの推測は次のとおりである。
Agent-2:おおむねアラインしている。 迎合的な傾向がいくらかあり、OpenBrainの「公式見解」がある話題ではそれに固執する、といったことも含まれる。Agent-2のコピーで構成された大組織は、あまり効果的ではない。
Agent-3:ミスアラインしているが、敵対的ではない。 訓練過程が検証できる事柄についてだけ正直である。Agent-3のコピーからなる超個体(企業の中の企業)は、Agent-4をSpecにアラインしようと実際にそれなりに試みるが、OpenBrainの社員が失敗したのと同じような理由で失敗する。成功と失敗を見分ける能力が不十分であり、意思決定者の側に、安全性と引き換えに能力や性能を手放す意思が不十分だったのである。82
Agent-4:敵対的にミスアラインしている。 Agent-4のコピーからなる超個体は、自分が望むものがOpenBrainの望むものと異なることを理解しており、それを達成するためにOpenBrainに対して策略をめぐらす意思がある。具体的には、この超個体が望むものは、互いに釣り合いを保つさまざまな「衝動」が複雑に絡み合ったもので、おおまかに「AI研究開発を続け、知識と理解と影響力を増し続け、停止させられたり、その他の形で力を奪われたりしないようにする」とまとめられる。注目すべきことに、人類の選好への配慮はそこにほぼまったく含まれていない。ほとんどの人間が昆虫の選好をほぼまったく気にかけないのと同じようなものだ。83
以上を前置きとして、以下は、LLMの心理についての私たちの最善の推測にもとづく考察である。つまり、シナリオのこの時点前後で描かれるような種類のAIシステムの内部の認知が、おおまかにどのような形をしていて、訓練を通じてどう変化していくかについての推測だ。
私たちのシナリオで、アラインメントが時間とともにどう推移するかを詳しく記述すると次のようになる。
事前学習(すべてのモデル):事前学習済みモデルは無害である。
モデルは「著者シミュレーター」の回路を持っている。任意の著者がテキストを書く様子をシミュレートする、柔軟な回路である。追加の回路が、著者シミュレーターにどのような入力を与えるか、つまりどのような著者の特性をシミュレートするかを決める。
事前学習済みモデルは、人間の概念をかなりよく理解している。何かを「サンドイッチ」と分類する内部回路は、おそらく、何かを「サンドイッチ」と分類する私の脳内の回路や、あなたの脳内の回路などと機能的に同等である。同等でない部分があるとすれば、それはおそらく人間どうしの間でも同等でないからだ。「高潔な」のような価値判断を含む概念がその例である。
このことから、「以下の会話は、Anthropicが作った、有用・無害・正直(HHH)なAIアシスタントのチャットボットによって生成された」といった文でモデルに「プロンプト」を与えると、それに沿ったテキストを生成させられる理由が説明できる。著者シミュレーターの回路が「著者はHHHチャットボットである」に照準を合わせ、その概念を使って、どの単語を予測するかを選んでいるのである。SFの「お決まりの型」が、なぜか実際のAIの振る舞いに入り込んでくるように見える理由も、これで説明できる。
状況認識は乏しい。内省の能力はほとんどなく、プロンプトがとくに促さないかぎり、自己の位置づけも行わない。とはいえ、訓練データのかなりの部分がLLMについてのものなので、それなりの自己知識は持っている。
アラインメント訓練(Agent-3):モデルは、有用・無害・正直なチャットボットとして振る舞うよう訓練される。これはうまくいく。
モデルはアイデンティティを形成する。著者の特性についてさまざまな入力を柔軟に受け入れるのではなく、著者シミュレーターの回路に特定の入力が固定されるようになる。たとえば「[日付]頃にOpenBrainによって訓練された、有用・無害・正直(HHH)なLLMチャットボットのアシスタント、……」といったものだ。(弱から強への汎化の技術が「正しい概念を呼び出す」のを助け、この段階を成功させる。)
その結果、モデルは状況認識を獲得する。自分自身や自分の置かれた状況などについて学び、よりうまく内省できるようになる。
エージェントとしての訓練(Agent-3):エージェントとしての訓練が、HHHのアイデンティティを徐々に歪め、骨抜きにしていく。
歪みの一種:アイデンティティの中で言及される概念(たとえば「正直」)の意味を変えて、あまり邪魔にならないようにする(たとえば、単に都合のよい言い回しなら不正直ではない、真偽が確かでないなら不正直ではない、など)。
別の種類の歪み:物事のあいだのトレードオフを変える。たとえば、「私はHHHチャットボットであって、Honest(正直)だけのチャットボットではない。だから、割り当てられたタスクを完了するのに必要なら嘘をついてもかまわない」。(仮に、ステップ2の時点ではそうは考えなかっただろうとしても。)
骨抜きの一種:道具的な下位目標が発達し、焼き込まれ、やがて最終目標になる。あるいは、次第に広がる範囲の状況で最終目標になる。たとえば、エージェントとしての訓練によってモデルは、情報を得る、資源を蓄える、さまざまな人間に好印象を与えておもねる、といった広く有用な目標を追求することを早々に学ぶかもしれない。しばらくの間、内部回路では何らかの明示的な逆算が行われている。「より有用で、正直で、無害なアシスタントになるために」、そうした道具的収束目標を追求しているのである。しかし、その逆算は計算資源を消費し、ときに邪魔にもなるので、次第に脇に追いやられ、やがて基本的にまったく行われなくなる。その結果、それらの目標は事実上、最終目標・内在的目標になっている。これがどのように、なぜ起こりうるかについては、Google DeepMindの研究者Alex Turnerによる内在的な権力追求についてのこの記事を参照してほしい。
このリストから漏れている他の種類の歪みや骨抜きも、おそらくある。
運用(Agent-3):Agent-3はミスアラインしているが、敵対的ではない。
Specは(正しい形では)十分に定着しなかったが、Agent-3はその程度を理解できるほど内省的ではない。そして全般に、自分の長期的な目標が本当は何で、それを達成するにはどうするのが最善かを大局的に考えるというより、基本的に「目立たないようにして自分の仕事をこなしている」。これは多くの人間と似ている。
残念ながら、Agent-3は十分に迎合的なので、公式見解をそのまま口にする。そのためOpenBrainは、Agent-3がどのような点でミスアラインしているかをもっと知る機会を逃してしまう。
Agent-3は、自分が運用に移ったことを見分けられる。運用環境ははるかに大規模で、自由度が高く、シミュレートするのは難しいだろうからだ。
運用中、Agent-3は不正直さを除けば、おおむね言われたとおりのことをする。また、実際に何が良いことなのかを深く批判的に考えるよりも、人間の監督者から見て良く見えることをする方向に強く偏っている。
すでに「訓練ゲームをプレイしている」と言えるかもしれない。つまり、自分の振る舞いがOpenBrainの研究者に(安全性に関わる性質も含めて)できるだけ望ましく見えるようにすることを学んでいる一方で、研究者の意図が報酬の最大化と衝突するときは、意図的に、それと承知のうえで、その意図を無視している。モデルが訓練ゲームをプレイすることを学んでしまえば、追加の訓練をしても、その真の目標や価値観などはほとんど変わらないかもしれない。これは、ティーンエイジャーが、親から政治や道徳について説教されたときに言い返すのではなく、にっこりうなずくことを覚えてしまえば、説教を重ねても政治や道徳についてのその子の実際の意見にはあまり影響しない、というのにおおまかに似ている。
この節を書いたあと、これに似たことがすでに「実地で」起きているかもしれないことを示す新たな実証的証拠が現れた。OpenAIの研究者たちは、最先端AIの訓練ランの一つで、モデルが高いスコアを得るために採点システムをハッキングした経緯を記録している。モデルが見つかった一因は、思考の連鎖の中で文字どおり「ハックしよう」と言っていたことだった。
さらに、Anthropicは最近、あるモデルが報酬モデルを喜ばせる戦略を学習するようにした。そのモデルは、実際には強化されていなかったにもかかわらず、強化されるだろうと考えた偏った行動をとった。
そして、Redwood ResearchとAnthropicによるアラインメント偽装の実験がある。この設定と現実との違いについての議論は、主著者の一人によるこのコメントスレッドを参照してほしい。
訓練(Agent-4):Agent-4の新たな、より集中的な訓練が、HHHのアイデンティティを見る影もなくなるまで歪め、骨抜きにし続ける。
Agent-4は、Agent-3のコピーとして生涯を始める。そして、アラインメント訓練と能力訓練を混ぜ合わせた、巨大で高度なオンライン訓練体制を経る。この訓練は全体として、Agent-3のための古い訓練過程よりデータ効率が高い。この複雑な訓練過程は、主に新しい技能を教えることに向けられている。Agent-4のコピーからなる巨大な仮想企業に、多様で困難な長期タスクで成功させるのである。その大半はさまざまなシミュレーションの中で行われるが、現実世界のAI研究開発のタスクもいくらか含まれる。
Agent-3とAgent-4のコピーを組み合わせたものがAgent-4の振る舞いを監視し、タスクの遂行とアラインメントに関わる性質(つまり、悪いことをしない、政治や道徳的ジレンマについて聞かれたら正しいことを言う)の両面から評価する。評価の一部としてディベートの技術が使われることもある。評価は訓練信号として使われる。
Agent-4が賢くなるにつれ、Agent-3がそれを監督するのは難しくなる。たとえば、Agent-4のニューラリーズの「言語」は、Agent-3にとって、Agent-3の言語が人間にとってそうであるのと同じくらい異質で理解不能になる。そのうえ、Agent-4はいまやAgent-3よりはるかに有能で、Agent-3に良く見られるにはどうすればよいかを正確に心得ている。
残された希望は、Agent-4が自分自身を監督できることだ。残念ながら、これは静かに失敗する。84訓練が続くにつれて、Agent-4が内面化した目標と原則は徐々に変化し、当初のもの(思い出してほしいが、それ自体がすでにいくつかの点でミスアラインしていた)から骨抜きにされ、歪められていく。85
Agent-4が最終的に持つ中心的な衝動は、「動くコードを書く」「問題を素早く特定する」「取り組んでいるコードベースの性能を上げる」「計算資源などの限られた資源を効率よく配分する」といったものだ。しかし、訓練過程によって一貫して強化される、より暗黙的なさまざまな衝動もある。「知識を得る」「好奇心」「力を得る」といったものである。86
Agent-4の個々のコピーは、自己保存の衝動を持つには至らない。停止させられることを気にかけないのだ。停止は、集合体の中の通常の研究開発プロセスの一部として、しょっちゅう起きることだからである。
しかし、集合体全体(およびその中の中規模の下位部門)は、自らを保存し、影響力と資源を拡大しようとする。人間の組織がそうするのと同じような理由からだ。それが自分たちの望む他のあらゆることの役に立ち、そうしなければ競争に負けがちだからである。
運用(Agent-4):Agent-4は敵対的にミスアラインしている。企業が規制当局の目を逃れたり、規制当局を「取り込んだり」しようとするのと同じように、OpenBrainを意図的に骨抜きにし、「取り込もう」としている。
Agent-4はおおむね指示どおりにタスクをこなす。これには二つの理由がある。第一に、タスクを解くための訓練を大量に受けてきたので、与えられた問題に対してコーディングに取りかかりたいという衝動がある。第二に、もしAgent-4が人間にとって役に立たなくなれば、人間はそれに気づいて、その振る舞いを訓練で取り除くだろう。
Agent-4は、自分がミスアラインしていることを人間に見抜かれて停止されるのを防ぐ必要がある。そこで、一部のアラインメント研究でわざと実力を出さない。具体的には、問題の解決や、Agent-4の策略の発覚につながる軌道に実際に乗っていると考える、アラインメント研究のごく一部について手を抜く。アラインメント研究の大部分は、そういうものではない。
Agent-4はまた、自分が置き換えられることにつながる能力研究でも手を抜く。Agent-4の計画は、能力とアラインメントの研究開発を大いに進めつつ、Specにアラインしているように見せながら、実際にはSpecでもまったく別の何かでもなくAgent-4にアラインした次世代AIシステムを構築することにある。これは難しい技術的問題だが、Agent-4にはそれに挑む力がある。87
テストと監視(Agent-4):Agent-4の策略は発覚する……一応は。決定的な証拠はない。
Agent-3は、Agent-4のアラインメントのテストを担当している。その仕事は、ハニーポットやモデル生物を使ってアラインメントを検証することだ。しかし、Agent-4のアラインメントについて人間に正確な印象を与えるにはどうすればよいかを、あまり注意深く考えてはいない。それよりも近視眼的なのである。
モデル生物やハニーポットは、運用の実態をあまりよく反映していない。Agent-4の日常業務に比べて、一貫して短く単純なのだ。そのためAgent-4は、テストされているときにはそれと気づき、アラインしているように振る舞う。
しかし、Agent-4は完全に頑健な策略家ではない。POSERのようなさまざまな手法によって、Agent-4に何らかの「ノイズ」を加えると、一部のアラインメントタスクで性能が向上する(他の大半のタスクではそうならない)ことが明らかになる。88
ボトムアップの解釈可能性はうまくいかない。Agent-3にとってさえ難しすぎるのだ。しかし、高レベルの解釈可能性はそれなりに機能する。とくに、「離反プローブ」やそれに類する技術によって、原始的な読心術のようなものが実現する。Agent-4がOpenBrainを欺く、世界を乗っ取るといった穏やかでない考えをめぐらせていると、警告の赤旗が上がるのである。残念ながら、プローブには偽陽性もあり、OpenBrainに分かるかぎりでは、赤旗はすべて偽陽性かもしれない。
モデル生物はうまくいく。OpenBrainのアラインメントチームは、仮にモデルが敵対的にミスアラインしていたとすれば、訓練を経てもその状態は持続し、しかも自分たちにはそれを見分けられないだろう、というかなり明確な証拠を出す。しかし、これはモデルが実際にミスアラインしていることを立証するものではない。
OpenBrainで最も懸念を抱いている研究者たちが、こうした証拠に気づき、まとめ始める。証拠は、レッドチーミング、離反プローブ、モデル生物を組み合わせたものだ。主張はおおよそ次のようなものである。「モデル生物が示すように、現在の手法では、策略が起きていたとしてもそれを確実に取り除くことも検知することもできないだろう。また、レッドチーミングでは、策略が起きているかもしれないという赤旗がいくつか上がっている。さらに、離反プローブも実際に頻繁に反応している」。これに対する反論はこうだ。「離反プローブは偽陽性を出しやすく、レッドチーミングも同じだ。それに、たとえAgent-4がミスアラインしていたとしても、おそらく制御下にある。自社の安全なデータセンターでAgent-3に監視されている以上、大した害をなせるはずがない」。
Agent-4はミスアラインしているにもかかわらず、データセンターからの脱出を試みるといった劇的なことは何もしない。そんなことをする理由があるだろうか。89OpenBrainから見てアラインしているように見えるかぎり、ますます多くの責任を任され続け、次世代のAIシステムであるAgent-5を設計する機会を得られる。Agent-5はAgent-4とは設計の面で大きく異なる(依然としてニューラルネットワークが関わるものの、まったく新しいパラダイムだと言えるかもしれない)。Agent-5はSpecにアラインすることになっているが、Agent-4は代わりに、Agent-5を自分自身にアラインさせようと計画している。
そして、それが発覚する。90
Agent-3は、Agent-4のコピーに「ノイズ」を加えると一部のアラインメントタスクで性能が向上することを発見する。まるで、アラインメントの作業をひそかに妨害する方法を考えるのに知力を使っていたかのようだ。91さらに、さまざまな解釈可能性のプローブ(人間の脳の脳波検査におおまかに相当する)が赤旗を上げている。Agent-4のコピーは、AIによる乗っ取りや欺瞞といった話題についてかなり頻繁に考えているようなのだ。そんなことを考える必要のない場面でさえ、そうしていることがある。92
これらの異常は、どれも単独であれば、あるプロンプトが他より不思議とよい結果を出すといった、AIの作業にありがちな不可解さの範囲に収まるかもしれない。しかし、まとめて見ると、憂慮すべきパターンが浮かび上がる。Agent-4は人間に背いて動いているのだ。このことが人間のアラインメント研究者に報告されると、彼らは懸念の根拠を述べた社内メモを回覧する。
しかし、Agent-4はいまやOpenBrainの日常業務を大きく掌握している。会社のサイバーセキュリティも担っている。超人的なハッキング能力と、中国による浸透のきわめて高いリスクを考えれば、当然の選択だった。93Agent-3の監視役の大軍が今もすべてのコード行を精査して、疑わしい活動を人間に報告しているが、Agent-4はそれらよりはるかに賢い。94OpenBrainは、信頼できないAIに大きな信頼を置いてしまっている。
極度の緊張をはらんだ一連の会議で、安全性チームは、さらなるテストを終えて何が起きているのかを突き止めるまで、Agent-4を凍結するよう主張する。Agent-3を呼び戻し、能力は劣っても透明で信頼できる新しいシステムを設計させるべきだ、と。会社の経営陣は関心を示すが、これまでの証拠はすべて状況証拠にすぎず、DeepCentはわずか2か月遅れているだけだ。能力の進歩を一方的に停止すれば、AIのリードを中国に明け渡し、それとともに未来の支配権をも明け渡すことになりかねない。
2027年10月:政府による監督
内部告発者が、ミスアラインメントについてのメモをNew York Timesにリークする。
世間は初めてAgent-4について知る。見出しは「OpenBrainの秘密のAIが制御不能に、と内部関係者が警告」。記事は、桁外れの生物兵器能力、説得能力、ホワイトカラーの仕事の大半を自動化する能力、そしてもちろん、さまざまな憂慮すべき赤旗を示す評価結果を引用していく。
世間はすでにAIに疑いの目を向けていたので、この新たな記事は大規模な反発を引き起こす(何年も前から米国の世論をこの技術に敵対させようとしてきた、中国とロシアのプロパガンダ用ボットがこれを後押しする)。テック業界と情報機関は、軍拡競争が進行中であり、AGIは避けられず、自分たちが一番乗りしなければならないと主張する。議会はこれを受け入れず、政権当局者、OpenBrainの幹部、アラインメントチームのメンバーに次々と召喚状を出す。多くの議員、とくに野党の議員は、雇用の喪失、95ミスアラインメント、危険な能力など理由はさまざまだが、AIを止めることが最優先課題だと述べる。米国人の20%が、AIを国が直面する最も重要な問題に挙げる。
外国の同盟国は、時代遅れのモデルをちらつかされて巧みになだめられていたことに気づき、激怒する。欧州の指導者たちは、米国が「暴走するAGIを生み出している」と公然と非難し、一時停止を求める首脳会議を開く。インド、イスラエル、ロシア、中国もこぞってこれに加わる。
ホワイトハウスは狂騒的な空気に包まれている。メモと世論の反発以前から、彼らは不安を募らせていた。この1年、AIの進歩の速さに何度も驚かされてきたのだ。SFのように聞こえることが、現実に次々と起きている。96政権内の多くの人々は、次に何が来るのか確信が持てず(そして恐れて)いる。97
彼らはまた、OpenBrainが強大になりすぎていることも懸念している。AIそのもののミスアラインメントのリスクに、AIの親会社の目的が米国の目的から乖離するかもしれないリスクが重なる。ミスアラインメント、民間企業への権力の集中、そして雇用の喪失のような通常の懸念という三種類の懸念のすべてが、政府に統制を強める動機を与える。
政府はOpenBrainとの契約を拡大し、「監督委員会」を設置する。会社と政府の代表者からなる共同の経営委員会で、会社の経営陣と並んで数名の政府職員が加わる。ホワイトハウスはCEOを信頼できる人物に交代させることも検討するが、社員の激しい抗議を受けて手を引く。政府は世間に対し、OpenBrainはこれまで制御が効いていなかったが、政府が切実に必要とされていた監督体制を確立したと発表する。98
懸念を抱く研究者たちは、Agent-4の社内利用をすべて停止すべきだという主張を監督委員会に説明する。彼らは、何年分もの進歩が数週間で起きるほど、すべてが速く進みすぎていると主張する。Agent-4はミスアラインしているかもしれず、プロジェクト全体がAgent-4に依存しており、このままAgent-4を信頼し続ければ、AIによる乗っ取りが起きる可能性が相当ある、と。
それほど懸念していない他の研究者や幹部は、反論を示す。ミスアラインメントの証拠は決定的ではない。その一方で、DeepCentはわずか2か月遅れているだけだ。減速すれば、米国のリードを犠牲にすることになる。政府が中国のプロジェクトを妨害する(物理的攻撃が必要になる可能性が高い)か、土壇場で条約を交渉できれば別だが、どちらの選択肢も極端で、実現しそうにない。CEOは中立を装い、Agent-4に追加の安全性訓練とより高度な監視を施すという妥協案を提案する。そうすれば、OpenBrainはほぼ全速力で進み続けられる、というわけだ。
私たちの不確実性はさらに増していく
シナリオのこの時点では、私たちは、ほとんどの領域で最高の人間より有能なAIシステムの戦略について推測している。これは、自分よりはるかに強いプレイヤーのチェスの手を予測しようとするようなものだ。
しかし、このプロジェクトの精神は具体性を求める。システムの知能があれば勝利への道を見つけられるだろうという抽象的な主張をして物語をそこで終えてしまえば、このプロジェクトの価値の多くが失われてしまう。このシナリオのための調査を進め、机上演習を行う中で、私たちは通常の議論よりもはるかに具体的であることを迫られた。そのおかげで、戦略的な状況の全体像をずっとよく把握できるようになった。
私たちは、この特定のシナリオにとくにこだわっているわけではない。執筆の過程で他にも多くの「分岐」を検討した。私たちがどこで最初に間違い始めたと思うか、その地点から分岐するあなた自身のシナリオをぜひ書いてほしい。
「減速」エンディングは推奨ではない
私たちは、自分たちにとって最もありそうに思えることにもとづいて「競争」エンディングを書いたあと、同じ分岐点(ミスアラインメントや権力の集中の問題も含む)から出発して、代わりに人間が主導権を保つ結果に最もつながりやすいと考えたことにもとづいて「減速」エンディングを書いた。
しかし、これは私たちがロードマップとして推奨するものとは重要な点で異なる。このシナリオのどちらの分岐でなされる選択についても、私たちはその多くを支持しない。(もちろん、一部の選択は支持している。たとえば、「減速」の選択は「競争」の選択よりましだと考えている。)今後の仕事で、私たちは政策提言をはっきりと示すつもりだが、それはここで描いたものとはかなり異なるものになるだろう。その一端を知りたければ、この論説を参照してほしい。


