
テイクオフ予測
Daniel Kokotajlo、Eli Lifland | 2025年4月
 ai-2027.com
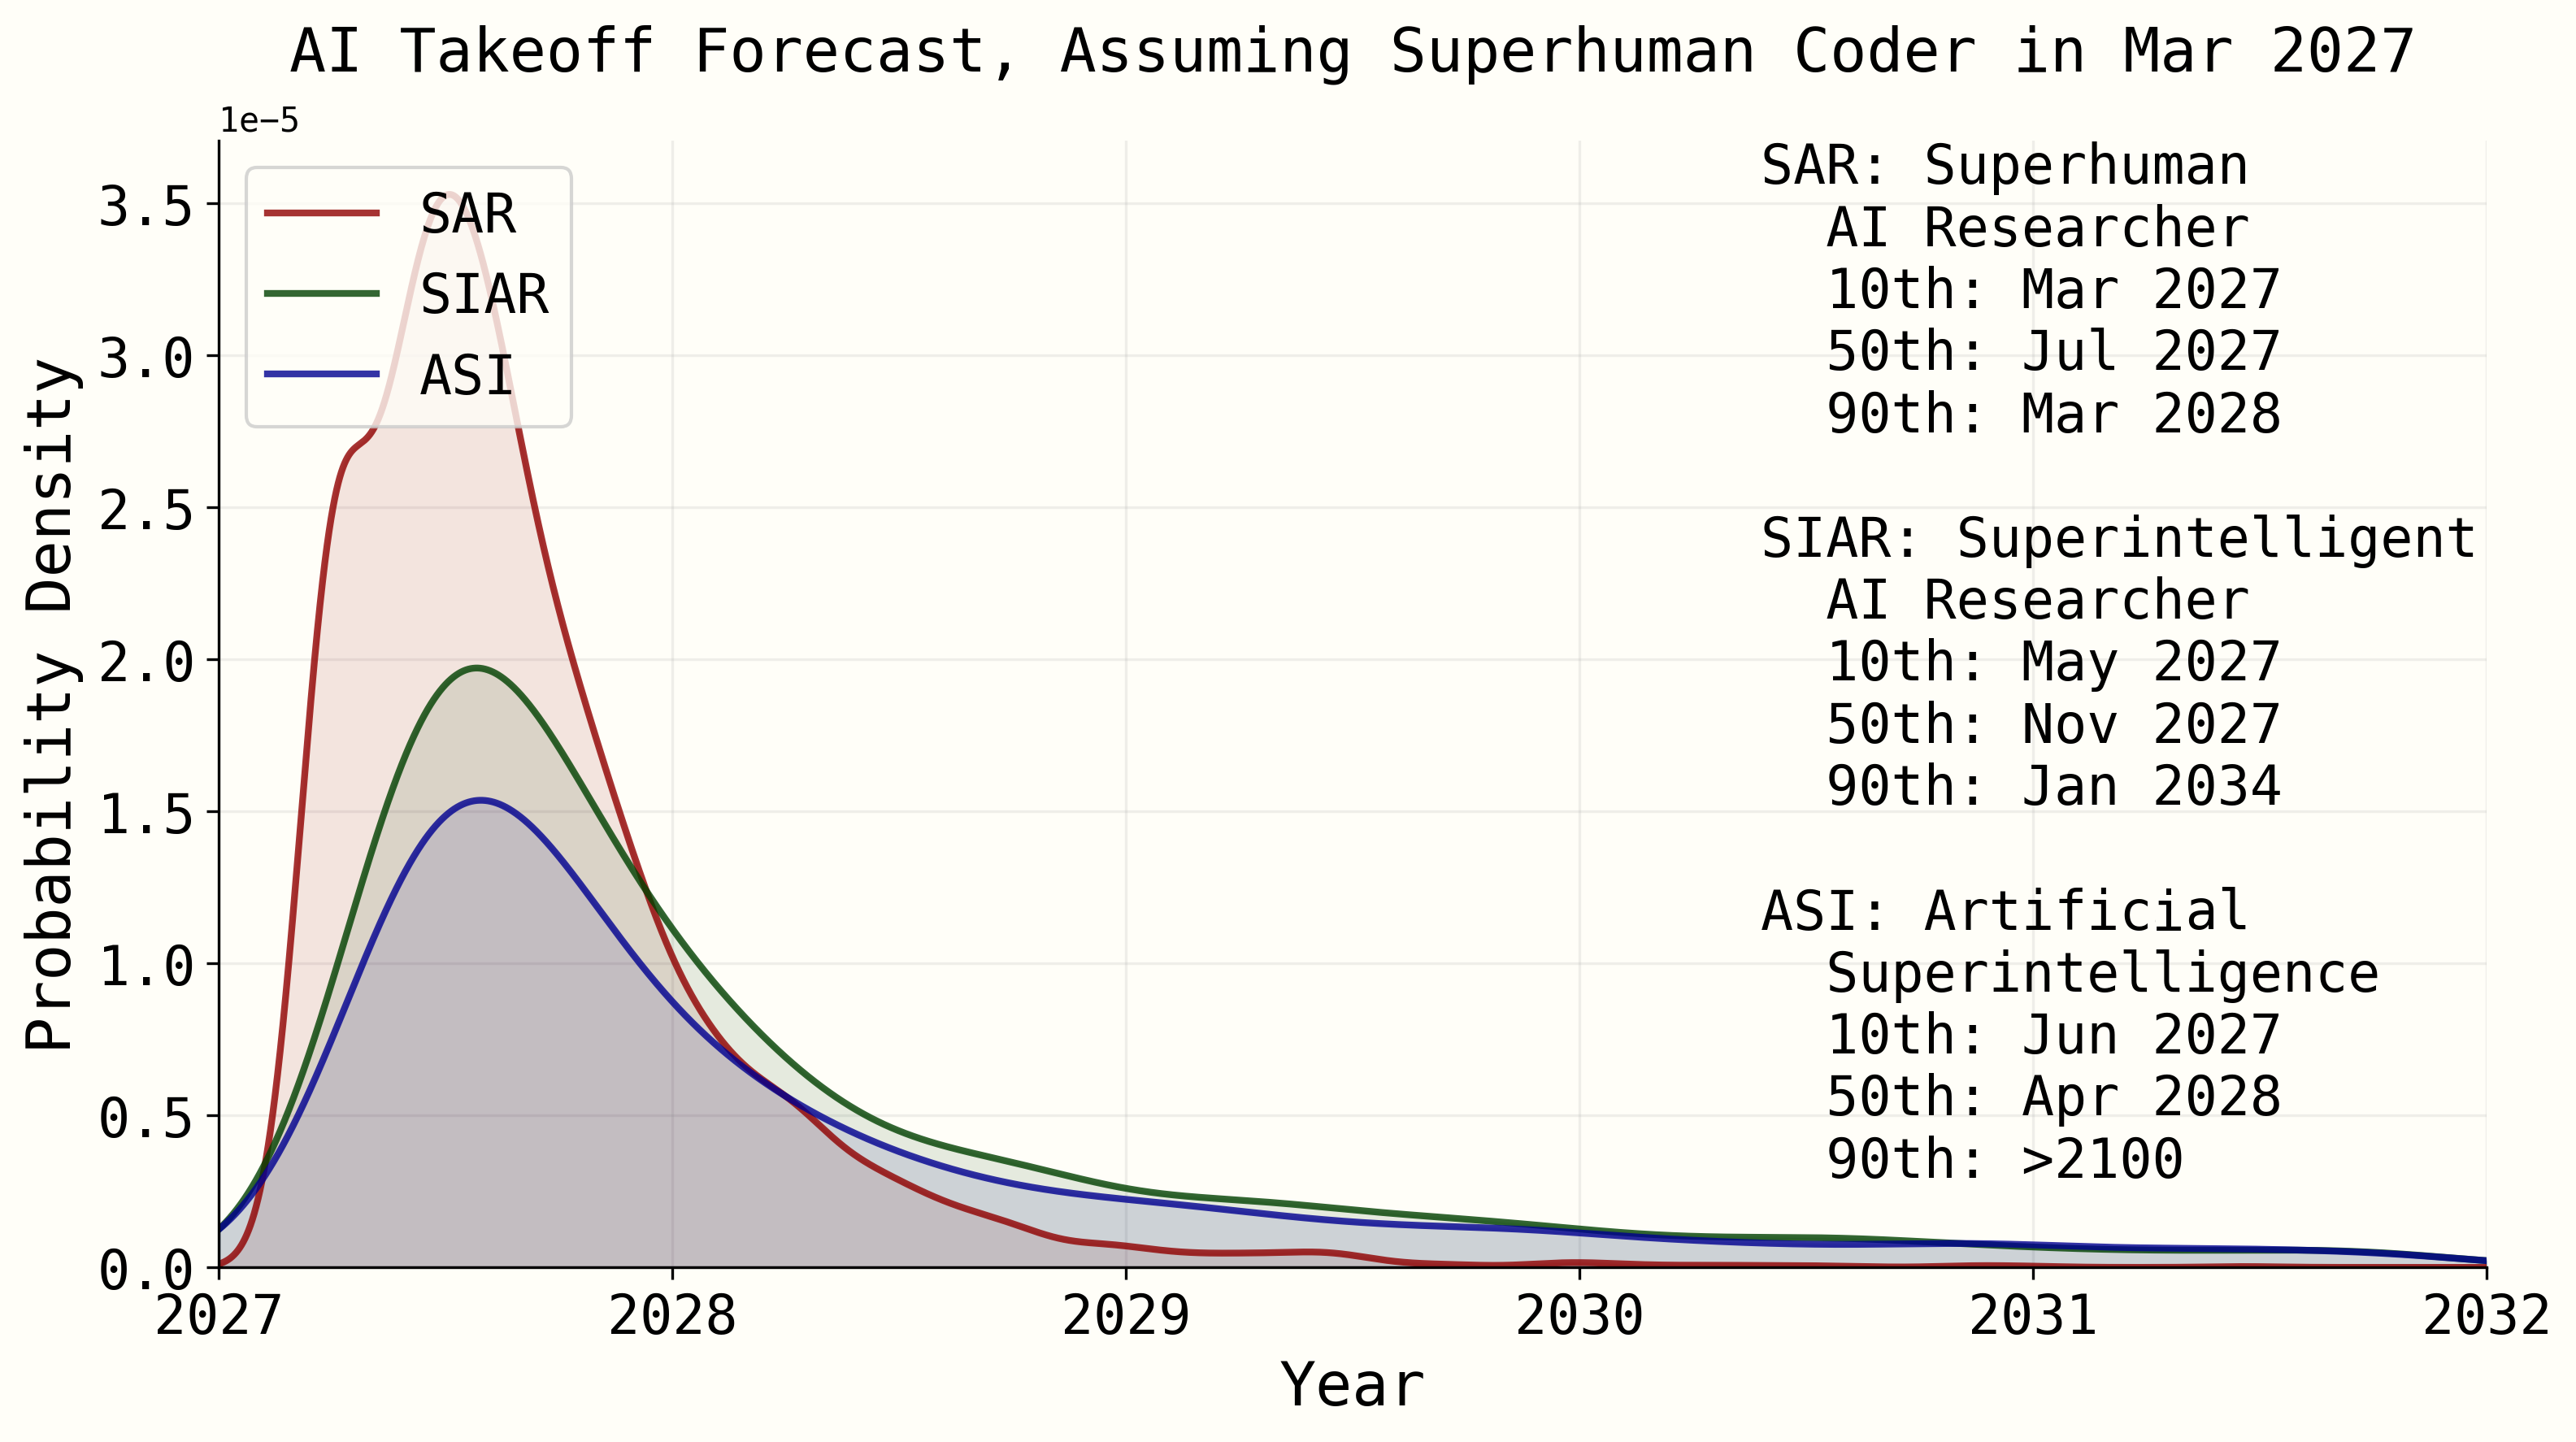
テイクオフ予測の概観(訓練計算量が増えないと仮定した場合)。超人的コーダー(superhuman coder、SC)のマイルストーン(2027年3月に達成)から人工超知能(ASI)までの期間について、私たちの予測の中央値は約1年で、誤差の幅は大きい。
要約
2025年12月31日の更新:タイムラインとテイクオフのモデルを刷新したものをaifuturesmodel.comで公開した。
タイムライン予測では、現在から超人的コーダー(SC)の登場までの期間を予測した。超人的コーダーとは、AGI企業の最も優秀なエンジニアがこなすあらゆるコーディング作業をこなせ、しかもはるかに速く安いAIシステムである。この予測では、SCが2027年3月に達成されることを前提とする。これは私たちのシナリオでSCが達成される時期である。
ここからはテイクオフ、つまり超人的コーダーから桁外れに超人的な能力に至るまでの期間を予測する。この隔たりを越えるのに必要なAI研究開発の大部分は、超人的コーダーとそれ以降のAIが自動化することになる。
私たちの方法論は、ソフトウェア主導の知能爆発が起こりうるか、どれほどの速さで進むかの予測に重点を置く。ソフトウェア主導の知能爆発とは、数か月から数年の規模でAIの能力が大きく向上する現象で、その主な原動力が訓練や推論の計算量の増加ではなく、計算資源をより効率的に使うこと(ソフトウェアの改良)にあるものを指す。まず、AIの能力のマイルストーンを順に並べる。重点はAI研究開発の能力に置くが、汎用的な能力も向上していくと私たちは考えている。そのうえで、マイルストーンAとBのあいだの各区間について、次のことを行う。
人間だけの場合の所要時間:人間だけがソフトウェアの改良に取り組んだ場合に、AからBまで到達するのにどれだけかかるかを分布として予測する。
AI研究開発の加速:マイルストーンAとBそれぞれによるAI研究開発の自動化が、進歩をどれだけ速めるかを予測する(AI研究開発の進歩倍率)。そのうえで、加速の度合いを時間の経過に沿ってこの二つの値のあいだで補間するシミュレーションを行い、AからBまでにかかる暦の上の期間を分布として予測する。
SCが2027年3月に達成されることを前提とした私たちの予測を、下の図と表にまとめる。いずれも訓練計算量が増えないと仮定したものである。
ai-2027.com
| マイルストーン | SCが2027年3月に達成された場合の予測時期(中央値+80%信頼区間) | シナリオ(「競争」エンディング)での達成時期 | 人間のみ・ソフトウェアのみの場合の次のマイルストーンまでの期間(中央値+80%信頼区間) | AI研究開発の進歩倍率:人間だけの場合に比べ、AIによってアルゴリズムの進歩がどれだけ速まるか |
|---|---|---|---|---|
| 超人的コーダー(SC):AI研究に関わる作業で、最も優秀な人間のコーダーの仕事をこなせるAIシステム。しかもより速く、多数のコピーを動かせるほど安価である。 | 2027年3月 | 2027年3月 | SCからSARまで:15%の確率で0年。それ以外の場合は4年(80%信頼区間:1.5〜10年、対数正規分布)(根拠) | 5(根拠) |
| 超人的AI研究者(superhuman AI researcher、SAR):最も優秀な人間のAI研究者の仕事をこなせるAIシステム。しかもより速く、多数のコピーを動かせるほど安価である。 | 2027年7月(2027年3月〜2028年3月) | 2027年8月 | SARからSIARまで:19年(80%信頼区間:2.3〜380年)(根拠) | 25(根拠) |
| 超知能AI研究者(superintelligent AI researcher、SIAR):AI研究において、最も優秀な人間の研究者をはるかに上回るAIシステム。 | 2027年11月(2027年5月〜2034年) | 2027年11月 | SIARからASIまで:95年(80%信頼区間:2.4〜1,000,000年)(根拠) | 250(根拠) |
| 人工超知能(ASI):あらゆる認知的作業において、最も優秀な人間よりはるかに優れたAIシステム。 | 2028年4月(2027年6月〜2100年より後) | 2027年12月 | N/A | 2,000(根拠) |
以下では次のことを行う。
テイクオフを予測する私たちの方法論を説明する。
上記のマイルストーンとAI研究開発の進歩倍率を、より厳密に定義する。
各マイルストーンについて、それに対応する進歩倍率と、そこから次のマイルストーンに至るまでの人間のみ・ソフトウェアのみの場合の期間を見積もる(リンクは上の表にある)。
シミュレーションのコードはこちら。
2025年12月に追記した注意書き:この予測は直観的な判断に大きく依存しており、不確実性がきわめて高い。残念ながら、AIのテイクオフの速さを予測するには直観的な判断を取り入れざるをえないと私たちは考えている。外挿によって確定的な結論を出せるだけの証拠が、とにかく足りないからだ。
方法論
概要
私たちが予測の対象として重点を置くのは、起こりうるソフトウェア主導の知能爆発である。これは、数か月から数年の規模でAIの能力が大きく向上する現象で、その主な原動力が訓練計算量の増加ではなく、計算資源をより効率的に使うこと(ソフトウェアの改良)にあるものを指す。
まず、AIの能力のマイルストーンを順に並べる(より厳密な定義は後述)。
超人的コーダー(SC):AI研究に関わる作業で、最も優秀な人間のコーダーの仕事をこなせるAIシステム。しかもより速く、多数のコピーを動かせるほど安価である。
超人的AI研究者(superhuman AI researcher、SAR):最も優秀な人間のAI研究者の仕事をこなせるAIシステム。しかもより速く、多数のコピーを動かせるほど安価である。
超知能AI研究者(SIAR):最も優秀な人間のAI研究者をはるかに上回るAIシステム。SARとSIARの差は、AGI企業の研究者の中央値を自動化したAIとSARとの差の2倍である。
人工超知能(ASI):あらゆる認知的作業において、最も優秀な人間をはるかに上回るAIシステム。
そのうえで、マイルストーンAとBのあいだの各区間について、次のことを行う。
人間だけの場合の所要時間:人間だけがソフトウェアの改良に取り組んだ場合に、AからBまで到達するのにどれだけかかるかを分布として予測する。
AI研究開発の加速:マイルストーンAとBそれぞれによるAI研究開発の自動化が、進歩をどれだけ速めるかを予測する(AI研究開発の進歩倍率)。そのうえで、倍率を時間の経過に沿ってこの二つの値のあいだで補間するシミュレーションを行い、AからBまでにかかる暦の上の期間を分布として予測する。
ソフトウェアの改良に焦点を当てる
私たちはAIの進歩を二つに分けて考える。ハードウェア、つまりどれだけの計算能力(「計算資源」)を使うかと、ソフトウェア、つまり計算資源をより高い能力のAIに変えるためのアルゴリズムとデータである。
この文書では主に、起こりうるソフトウェア主導の知能爆発に焦点を当てる。これは、数か月から数年の規模でAIの能力が大きく向上する現象で、その主な原動力が訓練計算量の増加ではなく、計算資源をより効率的に使うこと(ソフトウェアの改良)にあるものを指す。ソフトウェア主導の知能爆発の可能性については、こちらのレポートが詳しく論じている。ソフトウェアに焦点を当てるのは、そちらのほうがフィードバック・ループが強いからだ。改良されたアルゴリズムは、より優れたAIの訓練にほぼすぐ使える。一方、改良されたハードウェアの設計は、(現在のようなやり方である限り)大量生産までにかなりの時間を要する。
マイルストーンの定義
以下に、私たちが予測の対象として選んだAIの能力のマイルストーンを示す。
| マイルストーンの名称と簡単な定義 | シナリオのサイドパネルでの名称 | 完全な定義 |
|---|---|---|
| 超人的コーダー(SC):AI研究に関わる作業で、最も優秀な人間のコーダーの仕事をこなせるAIシステム。しかもより速く、多数のコピーを動かせるほど安価である。 | 超人的コーダー | 企業が計算資源予算の5%を使って、人間の研究者の30倍の数のエージェントを動かせるAIシステム。各エージェントは、AI研究に関わるコーディング作業(たとえば実験の実装。アイデア出しや優先順位づけは含まない)を、その企業のトップコーダーの30倍の速さで平均してこなす(作業にかかる時間が30分の1になるという意味で、人間の30倍の速さで書いたり「考えたり」するとは限らない)。また、補完的なスキルを持つ他のトップコーダーについても平均して同じことができるだけの、専門知識の幅が必要である。SCはAI研究の一部分なので、完全に超人的なAI研究者(後述のSAR)より後に達成されることはありえない。とはいえ、SCが最初に達成された時点で、ある程度の「研究センス」やその他のAI研究のスキルも備えているだろうし、コーディングが最後に必要なスキルであれば、完全なSARになっている可能性さえある。 |
| 超人的AI研究者(superhuman AI researcher、SAR):最も優秀な人間のAI研究者の仕事をこなせるAIシステム。しかもより速く、多数のコピーを動かせるほど安価である。 | 超人的AI研究者 | 最も優秀な人間のAI研究者の仕事を、上の超人的コーダーのマイルストーンで定義したとおり30倍の速さで、かつ30倍の数のエージェントでこなせるAIシステム。補完的なスキルを持つ他のトップ研究者についても平均して同じことができるだけの、専門知識の幅が必要である。 |
| 超知能AI研究者(SIAR):最も優秀な人間のAI研究者をはるかに上回るAIシステム。SARとSIARの差は、研究者の中央値を自動化したAIとSARとの差の2倍である。 | 超知能AI研究者 | 最も優秀な人間の研究者をはるかに上回るAIシステム。SARとSIARの差は、AGI企業の研究者の中央値を自動化したAIとSARとの差の2倍である。ここで2倍というのは、次の意味である。AGI企業の研究者のスキル分布(該当する認知的作業でのスキルで測る。計算資源のボトルネックを含めた全体の生産性ではない。つまり実質的には労働の価値)を考えたとき、そのAIがトップ研究者を上回る幅が、トップ研究者が中央値を上回る幅より倍加2回分大きい(つまり対数空間での差が2倍大きい)。さらに、作業をこなす速さが30倍、コピーの数が30倍という要件も満たす。 |
| 人工超知能(ASI):あらゆる認知的作業において、最も優秀な人間をはるかに上回るAIシステム。 | 汎用的な超知能 | おおよそ、SARをあらゆる認知的作業に広げたもの。あらゆる認知的作業において、最も優秀な人間の専門家に対する優位の幅が、最も優秀な人間の専門家が中央値の人間の専門家に対して持つ優位の2倍あるAIシステム(SARのように一企業の中ではなく、その分野全体で比べる)。 |
人間のみ・ソフトウェアのみの場合の予測
SCの時点から出発し、人類がSARを作るよう課されたが、研究の加速にSCを使うことはできない、というシナリオを考えよう。ハードウェアの供給量も固定されており、SCの訓練に使った量を超える総訓練FLOPでシステムを訓練することはできない。人間の研究者の数も固定されている。このシナリオの詳細については、後述の「AIなし」条件に関する補足を参照のこと。
時間がたつにつれて研究者たちは収穫逓減に突き当たる。私たちは予測でこの点を考慮に入れるようにしている。
私たちの方法論では、上のシナリオで人間の研究者がSCからSARに到達するのにどれだけかかるかを予測し、その先のマイルストーン間の飛躍についても同様に予測する。そのために、能力の飛躍の具体的な中身についての推論と、収穫逓減の明示的な考慮とを組み合わせる(SC→SARの予測では収穫逓減を明示的には考慮せず、所要時間についての直観を通じて暗黙のうちに考慮するようにしている)。
AI研究開発の自動化を考慮する:AI研究開発の進歩倍率
概要
要するに、AI研究開発の進歩倍率とは、AIを使った場合に、使わない場合と比べてAIのソフトウェアの改良がどれだけ速く進むかを表す。
進歩倍率を予測に組み込むため、まずマイルストーンAとBそれぞれによるAI研究開発の進歩倍率を予測する。そのうえで、倍率を時間の経過に沿ってこの二つの値のあいだで補間するシミュレーションを行い、AからBまでにかかる暦の上の期間を分布として予測する。
進歩倍率の予測は、AIが研究プロセスに及ぼす影響についての推論と、AI研究者へのアンケート調査にもとづいている。
AI研究開発の進歩倍率の定義
要するに、AI研究開発の進歩倍率とは、AIを使った場合に、使わない場合と比べてAIのソフトウェアの改良がどれだけ速く進むかを表す。
より包括的に言えば、次の二つの条件を考える。
AIあり:首位のAGIプロジェクトは通常どおり進み、アルゴリズムの進歩を速めるためにAIを使う。
AIなし:首位のAGIプロジェクトは、アルゴリズムの進歩を速めるためにAIを使うことを許されない(ここでアルゴリズムの進歩とは、計算資源を能力に変える効率が上がることを指す)。
どちらのプロジェクトも、計算資源を大幅に増やすことは許されない。このとき、AI研究開発の能力は、(2)に比べて(1)でどれだけ速く向上するだろうか。言い換えれば、あなたの会社のアルゴリズム面の研究の生産性について、(a)2024年以降のAIによるアルゴリズムの進歩の加速がない状態でのN週間と、(b)2024年以降のAIを使った1週間とが等しくなるのは、Nがいくつのときか。たとえばNが5なら、AIなしの5週間分の進歩がAIありの1週間分の進歩に相当するので、AIは生産性を5倍にしていることになる。
進歩倍率の定義の細部に関する補足は、付録を参照のこと。
SCからSARへ
概要
2027年3月に超人的コーダーに到達したと仮定する。では、超人的AI研究者(SAR)、つまり最も優秀な人間の研究者と同等のスキルを持ちながら、30倍の速さで、30倍の数で作業をこなすAIエージェントに到達するまで、どれだけかかるだろうか。
私たちのアプローチは(上述のとおり)次のとおりである。
ハードウェアの供給量を固定し、人間だけがAI研究開発を行った場合に、SCからSARに到達するのにどれだけかかるかを予測する(こちら)。
途中段階での加速を考慮しながら上の二つを組み合わせ、SCからSARまでの期間を予測する。
結果の概要は次のとおり。
| 予測 | 根拠 | |
|---|---|---|
| SCからSARまで:人間のみ・ソフトウェアのみの場合の期間 | 15%の確率で0年。それ以外の場合は4年(80%信頼区間:1.5〜10年、対数正規分布) | SARの訓練に必要な条件に応じた場合分けによる分析(詳細)。 |
| SCの進歩倍率 | 5 | SCがもたらすさまざまな加速の要因分解(詳細)。 |
| SARの進歩倍率(次節で扱う。途中段階での加速の計算に必要) | 25 | 3つの手法の組み合わせ。中心となるのは、さまざまな仮想シナリオについての質問にAI研究者が答えたアンケート調査(詳細)。 |
| SCからSARまでの期間 | 0.3年(15%の確率で0年、90パーセンタイルは0.95年) FutureSearchの集計 (n=4):0.55年(0、2.1) | シミュレーションの結果 |
人間のみの場合のSCからSARまでのタイムライン
人間だけがAI研究開発を行い、訓練計算量も増えない場合、SCからSARに到達するのにどれだけかかるだろうか。SCからSARに進むのに何が必要になりうるかを場合分けした、私たちの予測を示す。
| SCからSARに進むのに何が必要か | 人間のみ・ソフトウェアのみの場合のタイムライン | 根拠の要約 |
|---|---|---|
| 1) 最初のSCがすでにSARであるか、SARにきわめて近い(15%) | 0年 | モラベックのパラドックスと、どのスキルが他より難しいと判明するかを一般に予想しにくいこと(詳細)。 |
| 2a) SARに欠けているスキルの訓練に、SCより多くの計算資源は要らない(25%) | 2年(80%信頼区間:1〜4年、対数正規分布) | 新しい訓練環境が必要になるかもしれないが、スキルがそれほど違わないため、SCに必要だった環境より多くの計算資源は要らない(詳細)。 |
| 2b) アルゴリズムのさらなる進歩がなければ、SARに欠けているスキルの訓練にはSCより多くの計算資源が要る(30%) | 約5年(80%信頼区間:2〜15年、対数正規分布) | 新しい訓練環境が必要になるかもしれず、しかもその環境は計算資源もかなり多く要する。たとえば、主観的な数か月にわたる中規模のMLコーディングプロジェクトではなく、主観的な数年にわたる大規模なML研究プロジェクトを、より大きなエージェントのチームで行うようなもの(詳細)。 |
| 3) SCからSARへの隔たりを越えることは、工学ではなく科学の問題である(30%) | 約5年(80%信頼区間:2〜15年、対数正規分布) | 私たちの推測では、これは克服に数年はかかるが数十年はかからない種類の制約だろう。過去10年の進歩、たとえばAlphaGoからEfficientZeroまでを見ればわかる(詳細)。 |
| 全体の分布 | 15%の確率で0年。それ以外の場合は4年(80%信頼区間:1.5〜10年、対数正規分布) | 上記の混合分布を対数正規分布で近似したもの。 |
ケース1:最初のSCがすでにSARである(15%)
そうなりうる理由をいくつか挙げる。
モラベックのパラドックスと、どのスキルが他より難しいと判明するかを一般に予想しにくいこと。
こうなりうる筋書き1:SARがSCに十分近いため、汎化や転移学習によってその差が埋まるのかもしれない。
こうなりうる筋書き2:SCとSARのスキルセットは、エージェンシーに関わるスキルは共通で、違うのは世界についての知識や理解だけである。たとえば、優れたエンジニアと優れた科学者の違いは、何を知っているか、何を理解しているかにあり、行き詰まったときにそれに気づく、計画を立てる、といった汎用的な経験則にあるのではない。
ケース1が成り立つなら、SCからSARまでの期間は0年である。
ケース2:訓練環境が必要なスキルを教えないため、最初のSCはSARではない(55%)
この場合、SARへの最短の道筋は、おそらくそのスキルを教える新しい改良版の訓練環境をコーディングすることだろう。たとえば新しい環境では、SCからなる研究チームを管理し、「この論文を再現せよ」「このSOTAを改善せよ」「この実験の結果を実行前に予測せよ」「訓練データのカットオフが6か月前だったとして、過去6か月で最も有望な研究上のブレークスルーを予測せよ」といったタスクをこなすのかもしれない。
しかし、こうしたタスクについて正解データを得るのは非常に難しそうで、適切な訓練環境を作るうえで概念上の大きな障害になりうる。とはいえ、これはすべてのタスクにとっての障壁ではないし、この時点ですでにSCはある。SCのタスクの多くも正解データを得るのが非常に難しい。たとえば「プロジェクトを管理する科学者の意図を忠実に汲んだ、安全でクリーンなコードを書け」といったタスクだ。SCでうまくいった方法が、少し手を加えればSARでもうまくいくのかもしれない。うまくいかなければ、後述のケース3に進む。
サブケースA:SARに欠けているスキルの訓練に、SCより多くの計算資源は要らない(25%)
SARに欠けているスキルを訓練する環境は、基本的にはSCの訓練にかかった以上の計算資源を必要としない。この場合、ボトルネックは新しい訓練環境の設計、構築、テストである。
人間のエンジニアがこの作業を行う場合、1〜4年かかるというのが私たちの推測である。
サブケースB:アルゴリズムのさらなる進歩がなければ、SARに欠けているスキルの訓練にはSCより多くの計算資源が要る(30%)
この場合、SARの訓練に必要な環境には、計算資源への支出を大幅に増やす必要がある。したがってSARのマイルストーンは、「実効計算量」がある程度増えた後に達成される。ここで実効計算量の増加とは、たとえばより効率的なアーキテクチャ、より効率的な強化学習アルゴリズム、より洗練された訓練環境などによって、アルゴリズムの進歩が必要な計算量を引き下げることを指す。
人間のエンジニアがこの作業を行う場合、およそ2〜15年かかるというのが私たちの推測である。
ケース3(30%):SCからSARへの隔たりを越えることは、工学ではなく科学の問題である
最後に、最初のSCが何か別の制約のためにSARではない、という可能性もある(たとえば、データ効率の悪いアーキテクチャと強化学習アルゴリズムの組み合わせを使っている、あるいは正解にもとづく訓練信号を必要とする、など)。ケース3では、SCからSARへの隔たりを越えることは単なる工学の問題ではなく科学の問題になる。たとえば次のような場合である。
研究エンジニアの仕事にはデータ効率のよい学習は要らないが、リサーチサイエンティストの仕事には要る。そしてデータ効率は、モデルや訓練環境よりも、アーキテクチャと強化学習アルゴリズムの組み合わせの性質なのかもしれない。
コーディングの作業(そのコードはすべてのテストケースに通るか)は、研究の作業(その研究は分野に実質的に貢献しているか)より評価しやすい。そして、この違いは根深く大きいため、隔たりを越えるには新しい手法を発明する必要があるのかもしれない。
全体として私たちの推測では、これは克服に数年はかかるが数十年はかからない種類の制約だろう。過去10年の進歩を見て、似たような障壁がどれだけ乗り越えられてきたかを考えればよい。たとえば、ゲームをプレイする強化学習AIの歴史では、AlphaGoからEfficientZeroまでおよそ10年で進んだ。
忘れないでほしいが、私たちはSCが2027年3月に達成されると仮定している。2027年にSARの実現を阻むような障壁は、そのほとんどが2027年のSCの実現も阻むだろうと私たちは考えている。
したがってこのケースでは、人間がAI研究開発を行う場合、およそ2〜15年かかるというのが私たちの推測である。
SCはAI研究開発を約5倍に加速する
超人的コーダー(SC)の定義を思い出してほしい。
| 超人的コーダー(SC):企業が計算資源予算の5%を使って、人間の研究者の30倍の数のエージェントを動かせるAIシステム。各エージェントは、AI研究に関わるコーディング作業(たとえば実験の実装。アイデア出しや優先順位づけは含まない)を、その企業のトップコーダーの30倍の速さで平均してこなす(作業にかかる時間が30分の1になるという意味で、人間の30倍の速さで書いたり「考えたり」するとは限らない)。これには、どの人間の研究者の専門領域にある作業もこなせることが含まれる。 |
|---|
私たちは、AIソフトウェアの研究開発のプロセスには、大まかに言って2種類の活動が含まれると考えている。
実験の選定:実験のアイデアを出して優先順位をつけ、実験結果が何を意味するかを解釈する。
実験の実装:実験をコーディングし、実行し、監視する。
実験の実装は、実験の選定より自動化しやすいと私たちは考えている。自然なコーディングデータを大量に得やすく、またコーディングは実験の選定より評価しやすいので合成データも生成しやすいからだ。このことは、実験の選定よりもコーディングで役立っている現在のAIシステムにも表れている。
SCについて論じるとき、私たちが指しているのは、(2)実験の実装において最も優秀な人間と同等に優れ、しかもより速く安いAIである。主要なケースでは、SCがAI研究開発を完全に自動化するわけではない。そうではなく、AGIプロジェクトの精鋭の人間の科学者たちがAIエージェントの大規模なチームを管理し、そのチームが科学者たちの研究構想をすばやく実行に移す。
AIソフトウェアの研究開発について、より詳しいモデルがEpochのレポートにある。
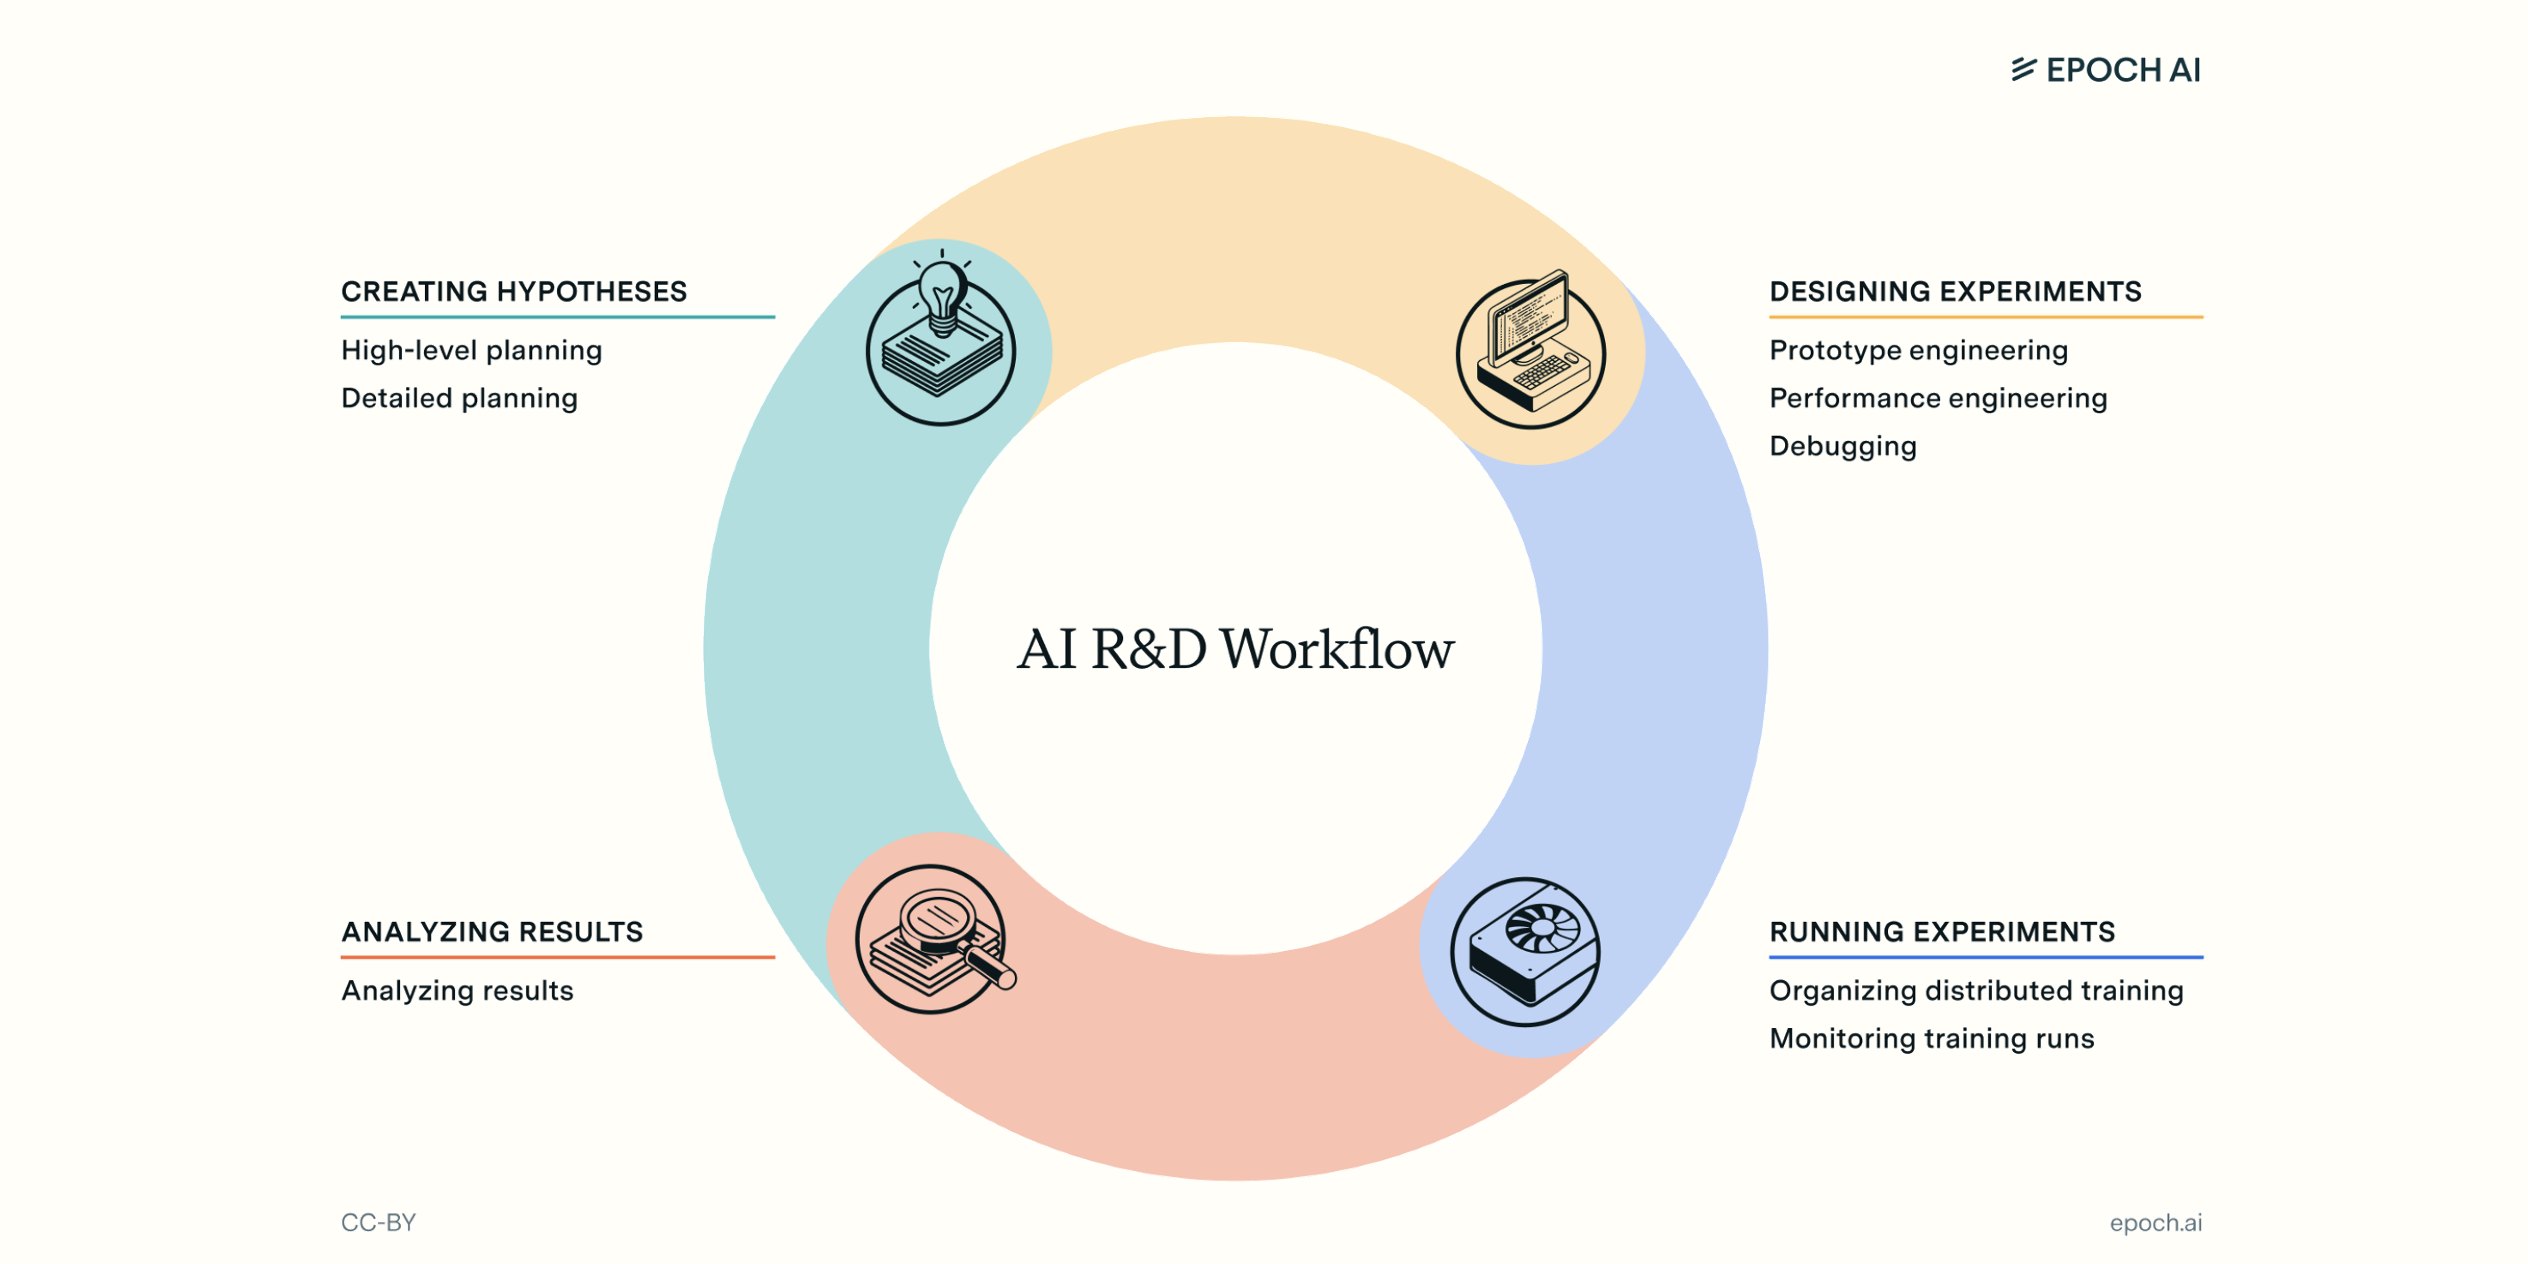
より現実的な姿はフラクタルになっているだろう。大きなループは小さなループからなり、その小さなループもさらに小さなループからなる。拡大してみれば、「コードに持たせるべき新機能を考える。ざっと書く。コードを実行してうまく動くか確かめる。繰り返す……」といった小さなループが見つかるはずだ。たとえば、典型的なひと月は次のようなものかもしれない。
プロジェクトの計算資源の大半は、進行中の新しい大規模な訓練ランにつぎ込まれている。残りの計算資源はN個のチームに分けられる。N個のチームはそれぞれ週に1回、小規模な訓練ランを行う。その合間に、チームの各メンバーはごく小規模な「ウォームアップ実行」をしてコードをテストし、デバッグする。つまり、アイデアはまずごく小規模で試されてデバッグされ、次にそのアイデアのより良い版が小規模で試される。そして生き残った最も有望なアイデアがさらに試され、いっそう規模を広げられ、最終的に訓練ランに組み込まれる。一般に計算資源が無駄になることはない。あるチーム(または個人)がコードを書いたり最新の結果を分析したりしているあいだは、GPUは唸りを上げて別の誰かの実験を回している。
SCが存在し、このプロセスに組み込まれたとすれば、ループ内のいくつかの作業にかかる時間を大きく縮め、ひいては全体の進歩のペースを速められるだろう。安くて速いコーディングの労働力が大量にあれば、個々の研究プロジェクトは、コードを書くことと実験を回すことを交互に繰り返す必要がなくなる。代わりに、プロセスのうち「コードを書く」部分が大幅に速まり、他の部分に比べて無視できるほどの時間しかかからなくなる。SCは平均して最も優秀なコーダーの30倍速いので、定義上少なくとも30倍は速まる。さらに、SCのコピーが人間のコーダーの30倍の数だけあり、しかもAIが人間のコーダーの平均ではなく最も優秀な者の水準にあることから、もっと速まる。ここでは約100倍速まるとしよう。
ただし、コーディングが100倍速まっても、研究全体の速度は100倍よりはるかに小さい倍率でしか速まらない。研究のループ全体には、たとえば実験が終わるのを待つこと、実験結果について議論し分析すること、次にどんな実験をすべきかを議論することなどが含まれ、私たちが想定するSCはそれらをあまり速めないからだ。したがって、プロセスのそうした部分がボトルネックになる。
こうしたボトルネックを考慮に入れると、全体でどれだけ加速するだろうか。私たちにはわからない。だが、現時点での最善の推測による内訳を示す。
柔軟な優先順位づけ:
通常、企業や研究チームは、並行して進む複数のプロジェクトに資源を分けている。たとえば、GPUで複数の実験を同時に回したり、チームBがコーディングしているあいだにチームAの実験を回し、次にチームAがコーディングしているあいだにチームBの実験を回す、というように切り替えたりする。
これは、すべてのプロジェクトが同じくらい価値が高く緊急だからではない。一つのプロジェクトに集中しても収穫が逓減するからである。企業が計算資源のわずか20%ではなく100%を、最も価値の高いプロジェクトに取り組む最も価値の高いチームに与えたとしても、そのプロジェクトが5倍速く進むことはないだろう。チームは依然としてコーディングに多くの時間を費やさなければならず、そのあいだGPUは遊んでいるか、少なくとも比較的重要でないことをしているからだ。むしろ、進みはせいぜい約1.5倍速くなる程度で、他のチームが被る損失に見合わないだろう。
重要なのは、SCのマイルストーンに達した後は、一つのサブプロジェクトを一気に加速させるために計算資源を一時的に集中させた場合の収穫は、逓減がよりゆるやかになると私たちが予想していることだ。計算資源の100%を最優先のチームにしばらく投入し、そのチームを約5倍速く進ませることが、実際に可能になるだろう(ここでも通常は20%と仮定している)。コーディングがはるかに速く進むので、前の実験が終わってからすぐに次の実験を始められるからだ。
これによって研究は1.5〜3倍速まる、というのが私たちの見積もりである。
可能なときは実験を小さくする:さらにSCのおかげで、すべての研究プロジェクトが、少しでも実験を小さくする方法を探すようになる。計算資源の節約がそのまま研究の速度につながるからだ。
研究の中には本当に多くの計算資源を必要とし、安価な版の実験では価値の大半が失われてしまうものもある。だが、そうでない研究もあり、そうした研究は一気に加速する。組織は、たとえば非常に複雑なスキャフォールドを作るといった、計算資源にそれほど依存しない種類の研究に、余分に投資できる。
これにより、上の加速に掛け合わさる形で、さらに1.2〜2倍の加速が生じるかもしれない。
無駄を減らす:SCがあれば、研究チームは膨大なエンジニアリングの労働力を使って、計算資源の無駄を減らせる。
小規模な実験も含めてすべての実験の前に、SCがレッドチーミングとバグテストを行い、結果を台無しにするバグが紛れ込んでいる確率を下げられる。
実験をリアルタイムで監視し、ある種の問題は起きるとほぼ同時に気づいて修正する(対照的に、今日のフロンティア企業では、中規模の実験でさえ誰も見ていないまま一晩中回っていることがよくある)。実験がうまくいったか、いかなかったかが明らかになった時点で、すぐに実験を打ち切ることもできる
たとえば利用率を上げることで、同じ実験をより少ない計算資源で行う
全体として、これによってさらに1.2〜2倍の加速が生じると私は推測する。
より手の込んだ実験:実験そのものを、より手の込んだものにすることもできる。たとえば、一度により多くの変数を試したり、ありうる交絡要因をより多く取り除いたりする。(速くて安いSCは、2024年のエンジニアよりはるかに多くのコードをはるかに速く書けるからだ。)
推測:1.1〜1.5倍の加速
多様性の欠如:SCが最も優秀な人間のエンジニアと同等に優れていたとしても、SCはみな互いのコピーである。これに対して人間のエンジニアは多様だ。したがって、たとえばSCにもときおり盲点がある(おそらくどの人間よりも少ないが、ゼロではない)のに、人間と違って、新鮮な目と異なる視点を持つ仲間を呼んで助けてもらうことができない、という可能性がある。もちろん人間を頼ることはできる……。いつもどおり、これがどれだけ物事を遅らせるのか、そもそも遅らせるのかどうかを推測するのは難しい。0.8〜1倍の「加速」といったところかもしれない
これら四つの加速の見積もりをGuesstimateのモデルで組み合わせると、全体の加速は5.8倍(90%信頼区間:3.4〜10倍)になる。(これはモデル内の不確実性であり、私たちの実際の全体的な不確実性はもっと大きい)。ほかにもいくつか調整がある。
このリストに挙がっていない、SCの他の有用な使い道があるかもしれない。それが上と組み合わされば、研究全体の速度はさらに速くなるだろう。たとえばSCは、より豊かで多様で難しく、報酬がよりうまく設計された訓練環境を、安く速く構築できるかもしれない。これは科学的な理解を深めるものではないが、訓練されるモデルを直接賢くするので、やはり勘定に入れるべきだろう。
私たちが気づいていない別のボトルネックがあるかもしれないし、考えたり分析したり計画したりすることなどに費やす時間のボトルネックが、予想より早く効いてくるかもしれない。とはいえ、SCはその点でもある程度役立つかもしれないし、その必要を一部なくしてしまうかもしれない……
この分析にはいくつかの限界がある。
超人的コーダーは実験の選定にもいくらか役立つはずだが、それを考慮していない。この点は、値がより高いことを示唆する。
ここで使ったモデルを拡張して後述のSARに当てはめると、進歩倍率がありそうにないほど高くなる。この点は、値がより低いことを示唆する。
私たちの予測は5倍とする。繰り返すが、これはあくまで推測であり、現実にはかなり速くも遅くもなりうる。
SARからSIARへ
概要
さて、超人的AI研究者に到達し、それがAI研究開発を25倍に加速しているとする。では、超知能AI研究者(SIAR)に到達するまで、どれだけかかるだろうか。SIARとは、最も優秀な人間の研究者がAGI企業の研究者の中央値を上回る幅の2倍の幅で、最も優秀な人間のAI研究者を上回り、しかも30倍速く30倍多いAIシステムである。
結果の概要は次のとおり。
| 予測 | 根拠 | |
|---|---|---|
| SARからSIARまで:人間のみ・ソフトウェアのみの場合の期間 | 19年(80%信頼区間:2.3〜380年) FutureSearchの集計 (SARが2027年に達成された場合、n=3):11.5年(1.75、27) | 研究者の中央値を自動化したAIからSARまでの期間との比較にもとづく(詳細)。 |
| SARの進歩倍率 | 25x | 3つの手法の組み合わせ。中心となるのは、さまざまな仮想シナリオについての質問にAI研究者が答えたアンケート調査(詳細)。 |
| SIARの進歩倍率(次節で扱う。途中段階での加速の計算に必要) | 250x | 人間の範囲内でより優れた研究者がもたらす収穫についてのアンケートデータにもとづく(詳細)。 |
| SARからSIARまでの期間 | 0.3年(80%信頼区間:0.04〜56) FutureSearchの集計 (SARが2027年に達成された場合、n=3):1年(0.1、2.1) | シミュレーションによる |
人間のみの場合のSARからSIARまでのタイムライン
固定されたハードウェア供給のもとでAIアルゴリズムの改良に費やされる人間の労働が、OpenBrain内の人間の範囲を基準に測ったAI研究開発の能力の向上にどうつながりうるかについて、単純化したモデルを示す。
OpenBrain内のAI研究開発の能力の分布は、研究の進歩の全体的な差として表れる労働の価値で見ると、対数正規分布である。
プロジェクトで最も劣る研究者と中央値の研究者とのあいだで、労働や進歩の差がどれくらいになるかは、どう考えればよいかわかりにくい。この分布は対数正規分布ではないかもしれない。一定の水準を超える人を選抜しようとする、足切りのようなものがあるからだ(ただし、おそらく外れ値もいくらかいるので、考えるのは難しい)。
給与から見ると、中央値と最下位のあいだの労働の倍率は、中央値と最上位のあいだの倍率よりかなり小さい。ここには、足切りの効果による何らかの実際の差があると思う。この予測では、時間の制約からこの点を無視している。
AIアルゴリズムの改良に費やされる人間の累積労働が倍になるたびに、AIの労働の価値は一定の倍率で増える(これはDavidsonのレポートの仮定とよく似ている)。具体的には、累積労働が1回倍加するごとに、労働の価値がr回倍加する。
(1)の分布は対数正規分布なので、労働生産性を一定の倍率で高めることは、OpenBrain内の人間の範囲で一定の標準偏差分だけ高めることに等しい。
SAR→SIARは、労働の倍率で見ると2×(OpenBrainの研究者の中央値を自動化したAI→SAR)と同じなので、SAR→SIARに必要な累積努力の倍加の回数は、OpenBrainの研究者の中央値を自動化したAI→SARに必要な回数の2倍である。
この単純化したモデルの枠内で、私たちのシナリオにおいてOpenBrainの研究者の中央値を自動化したAIが登場する時期、そこに至るまでにどれだけの研究の蓄積が必要だったか、そして中央値の研究者からSARに至るまでにどれだけの研究が必要だったかを考える。
研究者の中央値を自動化したAIからSCまでの、人間のみの場合の年数:SCの研究センスが25パーセンタイルだと仮定すれば約0〜3年。そうでなければ不確実性がより大きい。 SCが、私たちが予測する中央値水準の研究センス(25パーセンタイル。上述を参照)を持つ場合、中央値の研究者の自動化は、SCのおよそ0〜3暦月前になる。SCはコーディングが非常に強いので、平均をやや下回る研究センスをある程度補えるからだ。 SCは中央値のケースでアルゴリズムの進歩を5倍に加速するので、この0〜3暦月は、人間のみの場合のおよそ0〜3年に相当する。SCの研究センスの水準にはばらつきがあるので、不確実性はさらに加わる。その中には、SCがすでにSARであり、中央値の研究者の自動化はその数か月前に達成されていたはずだ、というケースも含まれる。
研究者の中央値を自動化したAIからSARまでの、人間のみの場合の年数:5年(80%信頼区間:1〜25年、対数正規分布)。 上では、SCがまだSARでない場合のSCからSARまでの期間の中央値を4年としたが、不確実性は大きく、90パーセンタイルは20年である。これに、上の(1)の人間のみの場合の0〜3年(研究センスが中央値のケース)を加える。SC登場時の研究センスのばらつきを考慮すれば、不確実性はさらに加わる。(1)研究者の中央値を自動化したAI→SCの期間と、(2)SC→SARの期間は、負の相関を持つ。SCの研究センスが高いほど(1)は長くなり、(2)は短くなるからだ。したがって下限は0より大きい(SARは中央値よりはるかに優れていると定義されているので、0にはなりえないというのが常識的な判断でもある)。
研究者の中央値を自動化したAIの時点での、2025年換算の研究年数の総蓄積:約10。これは、2025年より前の蓄積と、2027年3月のSCのころまで(中央値のケースではそれより少し前まで)の暦上の期間にもとづく、手早い見積もりである。
この単純化したモデルのもとで収穫逓減がどう働くかを、いくつかの例で場合分けして考えてみる。
研究者の中央値を自動化したAIまでの、人間のみの場合の年数:10
研究者の中央値を自動化したAIからSARまでの、人間のみの場合の年数
ケース1:5
これは約0.6回の倍加で、上のアンケートによれば約5倍の進歩倍率につながる。したがってrは約4(総努力が1回倍加するごとに進歩倍率が4回倍加する)となる。これはDavidsonの計算の高めの側にあるが、大きく外れてはいない。私たちのrの推定がDavidsonより高くなりがちなのは、能力の質的な飛躍の重要性をより重く見ているためである(詳しくは後述)。
ケース2:10
この場合、進歩のrは約2.3となる。これは、(AI研究開発が完全に自動化された時点での)r=2というDavidsonの最善の推測(2022年時点)に近い
SARからSIARまでに必要な、人間のみ・ソフトウェアのみの場合の期間(前の段階の2倍の回数の研究努力全体の倍加が必要だとして計算)
ケース1:19 = 15*2^(2*log(15/10)/log(2))-15
ケース2:60 = 20*2^(2*log(20/10)/log(2))-20
全体として、私は予測を次のようにモデル化する。
研究者の中央値を自動化したAIまでの、人間のみの場合の年数:簡単のため10と仮定する
研究者の中央値を自動化したAIからSARまでの、人間のみの場合の年数:5年(80%信頼区間:1〜25年、対数正規分布)。SC→SARの人間のみの場合の年数と強く相関させる(0.8)。
そのうえで、SARからSIARまでに必要な人間のみ・ソフトウェアのみの場合の期間を、上の式でモデル化する。
これにより、中央値は19年(80%信頼区間:2.3〜380年)となる。これを私の予測として採用する。
SARはAI研究開発を約25倍に加速する
概要
まず、SARがあるとどのような状態になるかを論じる。次に、いくつかの手法でSARの進歩倍率を予測する。
| 予測される進歩倍率 | 根拠 | |
|---|---|---|
| 手法1:加速の要因分解 | 417(90%信頼区間:130〜1900) | SARから予想される加速の内訳を組み合わせる |
| 手法2:下位の問いについてのアンケート調査 | 26(90%信頼区間:8〜139) | AI研究者へのアンケート調査を踏まえた、一連の仮想シナリオ |
| 手法3:より直接的なアンケート調査 | 24(90%信頼区間:5〜112) | 企業の全従業員が、30倍の速さで考える自分のコピーを30体使えたら進歩がどれだけ速まるかについて研究者に尋ねた最近のアンケート調査を使い、そのうえで、SARがすべて最も優秀な研究者と同等に優れていることを踏まえて上方修正する。 |
| 全体の予測 | 25 | 手法2と3はどちらも手法1より信頼でき、しかも意外なことに似た答えに収束した、と私たちは考えている。したがって、SARの進歩倍率を25倍と予測する。 |
SARがあるとどのような状態になるか
いまやすべての労働が自動化されている。これは定量的にはどのような状態だろうか。
私たちの計算資源予測では、OpenBrainは2027年にH100換算で約10,000,000基分の計算資源を持つと予測している。計算資源の5%をAI研究開発のための推論に割り当てれば、(モデルの規模や遅延のボトルネックなどについての私たちの他の推測を踏まえると)自動化された研究者のコピーを200,000体、それぞれ毎秒約400トークンで動かせると私たちは考えている。SARの定義に照らすと、この労働力は、最も優秀な人間の30倍の速さで作業をこなすエージェント50,000体に相当する。
また、少量の専用チップ(たとえばCerebras)を使えるかもしれず、それを使えば、より少数のAIを最大で毎秒約2000トークンで動かせると私たちは考えている。
SARの効果は、SCに比べて分析しやすい。(実験の選定を含む)すべての労働が30倍速まり、しかも並行して働く労働者が30倍多い。さらに、すべてのAIが、個々の研究者それぞれに対応するのではなく、最も優秀な研究者を高速化したようなものになる。
手法1:加速の要因分解
SARの進歩倍率を予測するため、まず先ほどのSCの場合と同様の内訳を考えた。SCがすでに達成することに加えて、SARがあることで物事がさらに加速しうる、あらゆる経路を考えた。その結果が次のリストである。
| 要因 | 加速 |
|---|---|
| 柔軟な優先順位づけ | 1.5〜3 |
| 実験設計のデバッグと早期打ち切り | 1.5〜3 |
| 可能なときは実験を小さくする(その2) | 1.5〜3 |
| さらに手の込んだ実験 | 1.1〜1.5 |
| 多様性の欠如が盲点を生む | 0.3〜1 |
| 量による研究センスの向上 | 2〜8 |
| 質による研究センスの向上 | 1.5〜5 |
| SCのAI研究開発の進歩倍率 | 5 |
| SARのAI研究開発の進歩倍率 | 417(90%信頼区間:130〜1900) |
しかし、この進歩倍率は高すぎるように感じられる。
手法2:下位の問いについてのアンケート調査
| シナリオの段階 | 進歩倍率の見積もり | 根拠 |
|---|---|---|
| OpenBrainの全研究者が30倍に高速化される | 7 | あるアンケート調査によれば、AI研究者は、計算資源が10分の1になると40%の速さでしか進歩しなくなる。30倍に高速化されるということは、主観的な時間あたりの計算資源が30分の1になるということなので、30倍の進歩の速さの22%となる。 |
| 30倍の並列労働を加える | 3(90%信頼区間:1.5〜6) | 並列労働が何に役立つかを洗い出して見積もった。 |
| 全員を最も優秀な研究者と同等の能力にする | 2.5(90%信頼区間:1.25〜5) | 最も優秀な研究者だけの企業は、中央値の研究者だけの企業に比べてどれだけ生産性が高いか、という問いに対するアンケート結果を半分にしたもの。 |
| 多様性の低下 | 0.25〜0.95 | AIには、人間の組織が持つ多様性が欠けているかもしれない。 |
| SAR達成 | 26(90%信頼区間:8〜139) | Guesstimate |
単純化した仮想状況を考えよう。AGIプロジェクトの人間の研究者とエンジニアが全員、30倍速く作業をこなす自分のデジタルコピーに置き換えられるとする。そのとき、企業内のAI研究開発の進歩のペースはどれだけ速まるだろうか。
私たちの手元には、ML研究者を対象に、関連する二つの問いを尋ねた、非公式で非科学的なアンケートデータがいくつかある。
いまの10倍の計算資源を使えたら、研究全体の進歩はどれだけ速くなるか。
いまの10%の計算資源しか使えなかったら、研究全体の進歩はどれだけ遅くなるか。
結果は次のとおり。
計算資源が10倍になった場合の速度の向上についての、非公式なTwitterの投票(n=185):中央値は1.2〜2倍の区間で、その上寄り。
AI安全性研究者を対象にした、Slackでの非公式な投票(n=6):
計算資源が10倍になった場合の速度の向上:中央値1.18倍(1.01〜1.5倍超)
計算資源が10%になった場合の速度の低下:中央値0.6倍(0.2〜1)
これらの調査は非公式で、サンプル数も少なく、誤差の幅も大きいが、ないよりはましである。ここで最も関心があるのは、計算資源が10%になった場合の速度の低下についての問いだ。Slackの投票では中央値0.6倍という結果が出たが、回答者の仕事はTwitterの投票の回答者より計算資源への依存が小さいように見えた。そしてTwitterの回答者の仕事は、フロンティアのAI研究者よりさらに計算資源への依存が小さいかもしれない。そこで値を割り引き、フロンティアのAI研究者の場合、計算資源が10分の1になると速度は現在の40%に落ちる、と推測する。
この結果を少し外挿すると、計算資源の予算を30分の1にすれば、ソフトウェアの進歩のペースは現在の約22%に落ちると見積もられる。
この仮想状況では、ソフトウェアの進歩のペースは30倍速くなり、それに22%を掛けたものと考えられる(30倍速い労働者は、主観的な時間あたりの計算資源が30分の1になるため)。これにより進歩倍率は7倍となる。
この7倍という数字から出発し、仮想状況の単純化を少しずつ取り除いて、実際のSARのシナリオに近づけていく。
最初に取り除く単純化は、SARの状況では、SARの数がおおよそ企業の研究者の30倍になる、という点である。もちろん、9人の女性が集まっても1か月で子どもは生まれないので、並列労働が30倍になっても実際の進歩は30倍よりはるかに小さくしか増えない。それでも役には立つ。この状況で実験用の計算資源がボトルネックになると仮定しても、科学的な労働が30倍あることでそのボトルネックを和らげる方法はまだある。たとえば次のようなものだ。
実験の進行を見守り、その意味を議論し、学習曲線が伸びていくのを見守り続けるより次の実験を始めたほうが価値が高そうだと判断した時点で、すぐに打ち切る。
各実験の設計に30倍の思考を注ぎ込み、バグがないだけでなく交絡要因もなく、正しい仮説を検証していることなどを確かめる。
各実験の分析と、次に何を優先するかの判断に、より多くの、より優れた思考を注ぎ込む。
機械学習の理論、解釈可能性、評価など、費用のかかる実験を伴わない技術ツリーの部分を、すべて急速に進める……
全体として、この30倍の並列労働という要因によって、物事は3倍(90%信頼区間:1.5〜6倍)速まると見積もる。
もう一つ取り除く単純化は、AIが、能力にばらつきのある人間の従業員全員のデジタルコピーである、という点である。SARは定義上、最も優秀な科学者やエンジニアと同等に優れている。したがって、能力の平均水準が最高水準まで上がる。
これについての情報を得るため、私たちは自分たちで小規模なアンケート調査を行った。具体的には、2024年11月から2025年3月にかけて、OpenAIやGoogle DeepMindで研究者やエンジニアとして働いている、または働いていた友人の何人かに尋ねた。質問の趣旨は「あなたの会社の全員が(社内で)最も優秀な人と同等だった場合、全員が(社内の)中央値の人と同等だった場合に比べて、研究はどれだけ速く進むか」である。回答を見る前の私たちの見積もりは4倍だった。回答の中央値は6.25倍だった(n=8)。
私たちの見積もりでは、現在の分布から全研究者が最も優秀な者の水準になるまでの変化は、全員が中央値の研究者から全員が最も優秀な研究者になるまでの加速の半分に相当する。したがって、この要因による全体の加速は約2.5倍(90%信頼区間:1.25〜5倍)と見積もる。
残る要因が一つある。多様性の喪失だ。「研究者全員を最も優秀な者の水準に引き上げる」ほうが、「研究者全員を最も優秀な者のコピーにする」より優れている。どの個人にも、他の人にはない盲点や弱点があるかもしれないからだ。SARはほとんどが互いのコピーになるので、この問題は人間の研究組織よりも深刻になるかもしれない。人間の研究組織には、複数の従業員がいるというだけで、ある程度の多様性が最初から備わっている。この点は大いに効いてくるかもしれないと私たちは考えているが、不確実性は高い。当てずっぽうの推測だが、これによって研究全体の速度は0.28〜0.95倍になるとする。
これらの数字をすべて組み合わせると、SARによる倍率は全体で26(90%信頼区間:8〜139)になる。
手法3:より直接的なアンケート調査
最近のレポートは、2024年3月にフロンティアAI企業の現従業員または元従業員5人を調査し、次の仮想シナリオについて考えてもらった。このシナリオは偶然にも私たちのものとかなりよく似ている。
「実験と訓練に使える計算資源は、基本的にここ数年と同じペースで増えているとします。ただし今回は一つ大きな違いがあります。あなたの会社の一人ひとりについて、AIで動くコピーが30体ずつおり、30倍の速さで働いているのです……。では、ごく大局的な見地から見てください。フロンティアのラボにおけるAIの能力の進歩の全体的なペースは、現在のペースと比べてどれくらいになると思いますか」
結果はおよそ1.5倍から20倍の範囲で、対数平均は約5倍だった。私たちはこれを、中央値約5、90%信頼区間1.25〜20の対数正規分布で表す。
この調査とSARの進歩倍率とのあいだには、二つの違いがあった。
調査はAI全体の進歩について尋ねているが、私たちはソフトウェアの進歩に焦点を当てている:そこで2倍を掛ける。現在の進歩の約半分は訓練計算量によるものなので、進歩倍率が高い場合、全体の進歩の加速はソフトウェアの進歩の加速の約½になるからだ。
調査は全研究者のコピーを作ることについて尋ねているが、SARは最も優秀な研究者と同等の能力を持つ:2.5(90%信頼区間:1.25〜5)
これにより、結果は24(90%信頼区間:5〜112)となる。
この研究者たちは、より具体的な質問にも答えている。たとえば、実験を実行する前に確実にデバッグできること、資源の優先順位をよりうまくつけられること、可能なときは実験を小規模で行えること、より手の込んだ実験を行えることなど、それぞれ個別に得られる加速についての質問である。不確実性がきわめて大きく、考える時間もわずかだったことを考えれば驚くには当たらないかもしれないが、要因ごとの加速として回答された数字を掛け合わせると、たいてい直接回答された答えよりかなり高い結果になる(要因ごとの加速を組み合わせたものの対数平均は14)。
SIARからASIへ
概要
さて、超知能AI研究者に到達したとする。では、人工超知能(ASI)に到達するまで、どれだけかかるだろうか。ASIとは、あらゆる認知的作業において、最も優秀な人間の専門家に対する優位の幅が、最も優秀な人間の専門家が中央値の人間の専門家に対して持つ優位の2倍あるAIシステムである(SARのように一企業の中ではなく、その分野全体で比べる)。
結果の概要は次のとおり。
| 予測 | 根拠 | |
|---|---|---|
| SIARからASIまで:人間のみ・ソフトウェアのみの場合の期間 | 95年(80%信頼区間:2.4〜1,000,000年) | SARからSIARへの飛躍との比較にもとづく(詳細)。 |
| SIARの進歩倍率 | 250x | 人間の範囲内でより優れた研究者がもたらす収穫についてのアンケートデータにもとづく(詳細)。 |
| ASIの進歩倍率(途中段階での加速の計算に必要) | 2,000x | SARからSIARへの飛躍との比較にもとづく(こちら)。 |
| SIARからASIまでの期間 | 0.16年(80%信頼区間:0.01〜100年超) | シミュレーションによる |
実験の選定についての見方
実験の選定(つまり研究センス)が向上しなければ、ハードウェアと遅延のボトルネックによって収穫は急激に逓減するだろう。したがって、人間の範囲を超えた実験の選定の向上を予測することはきわめて重要である。
これ以降の進歩倍率の予測は、実験の選定についての二つの重要な見方を踏まえている。
人間のばらつきは大きい:AGI企業の従業員の中央値とトップのあいだでさえ、実験の選定の能力には大きな差がある。その証拠に、私たちの研究者アンケートでは、全員が中央値の従業員の企業と全員が最も優秀な従業員の企業とで、研究の進歩に推定6.25倍の差があり、そのうち実験の選定による差が3.25倍だった。
根拠:AGI企業の研究者の観察と彼らとの議論、上記のアンケート、給与の差の観察。
人間の範囲の上には大きな伸びしろがある:知能の限界にあるAIにとって、実験の選定のスキルには、トップの人間を超えたところにきわめて大きな伸びしろがある(実装ではなく実験の選定だけで1000倍以上の差)。
根拠:人間の範囲の最上位で収穫が急激に逓減する様子は見られないし、人間が汎用知能の限界に近いと考える理由もない。
人間のみの場合のSIARからASIまでのタイムライン
これについては、上で予測した、人間のみの場合にSARからSIARまで進むのにかかる期間と比べる形で考える。
SIARとASIのあいだには、越えるべき隔たりが二つある。
一企業ではなく分野全体で見て、最も優秀な人間を(中央値→最上位の飛躍)2回分上回ること:SAR→SIARの飛躍よりやや小さい
AI研究開発については、これにはSAR→SIARよりやや小さい飛躍で足りると私は推測する。機械学習の専門家の中央値は、AGI企業で最も劣る研究者よりやや優れているからだ(最も劣る研究者が中央値を下回る幅が、中央値が最上位を下回る幅と同じだとすれば、の話である。実際には採用の足切りがあるので、そうではないかもしれない)。
AI研究開発だけでなく、あらゆる認知的作業でASIを達成すること:SAR→SIARの飛躍の約半分。
AIがいったんAI研究開発にきわめて長けるようになれば、そのスキルの多くは他の領域にも転移するだろうと私は考えている。したがって、あらゆる領域に汎化するのに、それほど能力を上げる必要はないだろう。汎用的なスキルを教えるよう設計された環境で訓練される場合はなおさらだ。
SARからSIARの場合と同じく、収穫逓減についてDavidson流の関数を使い、次の手順でSIARからASIまでにかかる期間をモデル化する。
SARまでの人間のみの場合の年数の総蓄積と、SARからSIARまでの年数を、SARからSIARの予測結果から求める。
SIARからASIまでの人間のみ・ソフトウェアのみの場合の期間は、次のようにして決める。
SIARからASIまでに必要な、SAR→SIAR相当の飛躍の回数を分布から引く。中央値は1.5回(80%信頼区間:0.3〜7.5回、対数正規分布)。rが増えていくと予想されるので、1.25から上方修正した。
SARからSIARで使ったのと同じ構造の式を使って、予測分布を計算する。
この結果、予測の中央値は95年(80%信頼区間:2.4〜1,000,000年)となる。90パーセンタイルはおそらく高すぎると私たちは考えている。ただし、これはソフトウェアのみの改良であることに留意してほしい。訓練計算量が増えないので、ASIに達する前に改良が劇的に遅くなることも、少なくとも考えられなくはない。
SIARはAI研究開発を約250倍に加速する
私たちのアンケートの中央値によれば、全員が中央値の研究者から全員がトップの研究者に切り替えると、アルゴリズムの進歩が約6.5倍速まる。エンジニアリングではなく「研究センス」だけを考えると中央値は3.25で、こちらのほうが適切かもしれない。超人的な自動化された研究者に到達すると、エンジニアリング以外の作業が大きなボトルネックになるかもしれないからだ。SARを超えたら、倍率はおよそ3.25としよう。
SARからSIARへの移行は、定義上この飛躍2回分に相当するので、3.25^2、つまり進歩倍率が約10倍に増える。これにより進歩倍率は250倍となる。
ASIはAI研究開発を約2,000倍に加速する
上では、rの減少に合わせた下方修正をしなければ、SARからSIARへの移行にはSAR→SIAR相当の飛躍が中央値で1.25回必要だと見積もった。単純に考えれば、これは進歩倍率が10^1.25倍に増えることになる。しかし、rが減少していくことを踏まえて下方修正すべきである。SARに対して8倍まで下方修正し、大まかな見積もりとして2,000倍としよう。
関連研究
Davidsonの「計算資源中心の枠組みはテイクオフの速さについて何を語るか」
Tom Davidsonによる2023年のこのレポートは、経済モデルを使ってAIのテイクオフの動態を予測している(解説、プレイグラウンド)。主要なモデルは、AI研究開発が完全に自動化された後に何が起こるか、たとえばSARからSIARへの移行を予測するようには設計されていない。完全な自動化の後に何が起こるかを予測する節では、ソフトウェアのみのシンギュラリティが起こる確率を65%と予測しており、それが起こった場合、中央値のケースで実効計算量が2〜3桁増えるとしている。近く公表される研究では、Davidsonは、AI研究開発が完全に自動化されたとき、通常のAIの進歩3年分(Davidsonの計算では実効計算量でおよそ3〜4桁)が1年に凝縮される確率を50%と予測している。
私たちは主に通常の進歩の年数の桁数で考えてきたわけではない。だが、SAR→SIARの節で論じたDavidson流の収穫逓減のモデルを使うと、ソフトウェアの進歩に注ぐ努力を増やしたときの収穫率「r」について、私たちの中央値は4になると逆算できる(「ケース1:5」で論じたとおり)。Davidsonの2022年時点の最善の推測はr=2で、近く公表されるより新しい研究では、彼の推定は1.2になっている。rが1を上回るということは、AIの知能の向上が時間とともに次々と速くなっていくことを意味する。そして知能の限界に近づくにつれて、rは時間とともに下がっていく。Davidsonの予想は私たちの予想とかなり重なっていることを指摘しておく。たとえば、r=2は双方の不確実性の範囲内に収まっている。
rについての見解の相違は、主に新しい能力への飛躍をどう考慮するかについての直観の違いに帰着する。Davidsonは主に効率の向上を測ることでrを推定している。たとえば、2015年のAIの性能に達するのに、2025年のアルゴリズムでは訓練計算量がどれだけ少なくて済むかを見る。しかし、能力の向上、つまり訓練計算量を一定の水準に固定したときのAIの能力の向上も考慮に入れる必要がある。これは、下向きではなく「上向き」に測った効率の向上と考えることができる。たとえば、2025年の性能に達するのに、2015年のアルゴリズムでは2025年のアルゴリズムよりどれだけ多くの訓練計算量が必要かを見る。ただし、こちらは測るのがより難しい。
上向きに測ると、rの推定値はずっと高くなるかもしれない。アルゴリズムは質的に新しい能力に対してはうまくスケールしないかもしれないからだ。考えてみてほしい。たとえMagnus Carlsenが何十億年もチェスを学んだとしても、トップのコンピュータチェスエンジンほど強くはならないだろう(彼でなくても、もっと普通の人間なら間違いなくそうだ)。アルゴリズムが十分に大きく改良されれば、実質的に無限の質的飛躍さえありうるかもしれない。
Davidsonは、計算資源の水準を固定したときの能力の向上、つまり私たちが「上向きに測る」と呼んだものを考慮するため、rに2を掛けている。私たちは、新しい能力の水準を解き放つことから得られる質的に大きな利得に対処するには、2を掛けるだけでは不十分だと考えている(最終的には、以前の訓練手法では計算資源やデータが無限にあっても達成できなかったであろう能力の水準に、おそらく到達する)。
この問題については、Eliが執筆した未公開の草稿でさらに論じている。この草稿には、Davidsonのモデルの他の問題点についての節もある。
過去のデータに当てはめた経済モデルを補うものとして、この草稿で行ったように特定の能力水準をモデル化することについて、私たちはおおむね楽観的である。質的な性能の変化を予測するのに数理モデルに頼りすぎることには慎重だが、数理モデルがなお非常に有益だとも考えている。
主にソフトウェアによる知能爆発の一つの捉え方と、その起こりやすさについては、こちらの議論も参照のこと。
GATE
GATEはEpochが最近公開したモデルで、Davidsonのモデルを土台に、経済全体の幅広い自動化により焦点を当てた版を作ったものである(シナリオ探索ツール、論文)。Davidsonと同じく、Epochも、完全な自動化の直前や直後に何が起こるかについて自分たちのモデルがよい予測をするとは主張していない。
ソフトウェアのみの知能爆発が起こりうるかという点に関わる主な変更は、改良されたソフトウェアの効率をそのまま次の研究開発に使えるようにするのではなく、投資(つまり世界総生産(GWP)からの配分)をAIソフトウェアの研究開発の原動力にしたことである。これにより、テイクオフの予測は控えめになるが、タイムラインはやや早まる。
私たちはDavidsonの選択のほうを好む。Epochのモデル化の力点は、AIの価値の大半は研究開発ではなく幅広い自動化から生まれるという見方と結びついている。この記事でErdilとBarnettは、AIの価値は研究開発ではなく経済への幅広い展開によって生まれると論じる。その理由は次のとおりである。
研究開発の価値についての経済学的な推定では、一般に、研究開発が説明するのは労働生産性の伸びの約20%で、残りはおおむね労働時間あたりの資本の増加(資本深化)で説明される。
私たちの応答:AIが生み出す価値の大半が、最終的には研究開発以外のものになるというのはありうる話だと思う。だが、研究開発は依然として短期間で巨大な能力を解き放つだろうと私たちは考えている。
AI研究開発の自動化は特別なケースではない。実験用の計算資源とデータへの依存を考慮するとrはおそらく1未満か1に近く、1を上回って始まったとしても、ソフトウェアのみの知能爆発が始まってまもなく1未満に下がる可能性が高い。その結果、効率の向上は10倍未満にとどまる。
AI研究開発の自動化には幅広い能力が必要であり、一般的な労働の後に自動化されるのかもしれない。
私たちの応答:AI研究開発には、他の領域にも転移するような幅広い能力が必要だという点には同意する。しかし実際には、(a)AI研究開発を最初に自動化しようとする誘因、(b)データの入手しやすさ、(c)認知的なスキルへの依存、という理由から、AI研究開発は早い段階で自動化されると考えている。また、これまでのところ、コーディングが最も自動化の影響を受けやすい仕事の一つであることも見て取れる。
さらに、Epochのデフォルトのケースでは、ソフトウェアの効率の上限を現在の10,000倍に設定している。これは私たちから見て低すぎる。Davidsonのモデルでは、このパラメータのデフォルトは1e12である。
よくある反論に答える
上では、AIのマイルストーンがいつ達成され、それが何を意味するかについて、比較的機械的な分析を行った。その結果、「ソフトウェアのみの知能爆発」が起こる可能性が高い、という結論に達した。つまり、固定されたハードウェア供給のもとでのAIソフトウェアの進歩によって、1年以内に超人的コーダーから超知能AIへと進む可能性が最も高い、ということだ。ハードウェアがある程度増えることを認め、ソフトウェアが「主体の」知能爆発とすれば、その可能性はさらに高まる。
以下では、(a)これほど速い進歩が起こりうるか、(b)これほど速い進歩がどのような結果をもたらすか、についてのよくある反論に答える。
アムダールの法則
自動化では研究開発のある側面(たとえば人間のデータの収集)をそれほど速められないので、進歩はそうした作業がボトルネックになり、進歩倍率はそれほど大きくならない、という議論をする人が何人かいた(アムダールの法則を参照)。
具体的には、次のような議論である。作業Xは現在、AIソフトウェアの研究開発で研究者の時間の10%を占めている。したがって、作業Xが自動化によって速まらなければ、AIソフトウェアの研究開発は10倍より速くはならない。
これにも一理あるが、この主張は成り立たない。現在のAIソフトウェアの研究開発の下位作業をこなす速さが、プロセス全体の速さを制約するわけではないからだ。
これが概念的に誤りである理由を見るため、実験の選定の能力は大きく超人的だが、実験の実装のスキルは人間に及ばない、理論上のAIを考えよう。自動化によってAIの実験の実装がまったく速まらず、しかも最初は実装が研究者の時間の50%を占めていたとしても、自動化によってはるかに優れた実験が選ばれるようになれば、2倍を超えるAI研究開発の進歩倍率を達成できる。
この種のボトルネックが実際にどの程度効いてくるかについて。人間のデータの収集については、合成データがこのボトルネックを和らげる可能性が高いと考えている。さらに上で論じたように、実験の選定の向上には高い天井がある可能性が高い。そして、N倍価値の高い実験を選べるなら、研究プロセスの他の部分がどうであれ、その分だけ進歩倍率はN倍になる。
計算資源がAIの進歩の主な原動力である
この見方は、次のいくつかを組み合わせたものを想定している。(a)訓練計算量はアルゴリズムの進歩よりはるかに重要である。(b)アルゴリズムの進歩にとって、実験用の計算資源は研究者の質と量よりはるかに重要である。(c)アルゴリズムの進歩は、より大きな計算規模への適応によってもたらされる。(d)AI研究開発が完全に自動化されるころには、アルゴリズムの進歩は根本的な限界に近づいており、その先の進歩の主な原動力は計算資源になる。
これについて言えることはたくさんある。まず、計算資源が(a)AI全体の進歩の重要な原動力であること、そして(b)実験にとって重要であること、の両方に私たちは同意する。私たちは予測でこうしたボトルネックを考慮に入れているが、そのボトルネックがどれだけ厳しく効くかについては、私たちと意見の異なる人もいる。
AI研究開発の進歩倍率を論じた上の各節である程度扱っているので、ここでは、私たちがより急進的な予測をしている理由について、いくつかの議論だけを挙げる。
数人のフロンティアのAI研究者へのアンケート調査では、計算資源の予算を固定したとき、企業が中央値の研究者のコピーだけを持つ場合と最も優秀な研究者のコピーだけを持つ場合とでは、アルゴリズムの進歩のペースにおよそ6倍の差が出るという見積もりが得られた。
AGI企業はトップ研究者にきわめて高額の報酬を支払っており、しかも急速に成長している。
AIモデルは、計算コストを固定しても、時間とともに一貫して大きく向上してきた(ただし、その一部は蒸留によるものである)。
AIは人間に比べて、集団としての構造的な優位を持っている(記事を参照)。
AI研究開発が完全に自動化される時点で、AIが知能や学習の物理的な限界に近づいているとは考えにくい。その根拠は、(a)その時点のAIは人間より効率が悪い可能性がある、(b)人間の範囲内でのスキルの分布を見ると最上位付近での利得が大きく、したがって最上位を超えたところでも利得が大きい可能性が高い、(c)人間の脳には既知の非効率がある、という点である。
AI研究開発の進歩倍率はどこかで頭打ちになるはずだ。なぜ10,000倍未満で頭打ちにならないのか? なぜ1,000倍未満ではないのか?
進歩倍率がどこかで頭打ちになるはずだという点には同意する。私たちのシナリオでは、SC、SAR、SIAR、ASIの各マイルストーンが達成されるにつれて倍率が上がり続け、その後もさらに上がっていくように描いている。なぜか。なぜ2035年までに1,000,000倍まで上がっていくように描いているのか。
実のところ、頭打ちになる水準がどれほど高いか(あるいは低いか)について、私たちの不確実性はきわめて大きい。この量の見積もりにはあまり労力をかけなかった。物語にとって重要ではないように思えるからだ。たとえば進歩倍率が1000倍で頭打ちになっても、物語は基本的に同じように進むだろう。
とはいえ、私たちの最善の推測では、倍率は最終的に1000倍よりはるかに高くなる。
思い出してほしい。フロンティアAI企業の研究者を対象にした私たちの小規模なアンケート調査によれば、研究センスだけで、社内の中央値の研究者と最も優秀な研究者のあいだに約3倍の差がある。また、研究センスとは基本的に、実験からどれだけ速く学べるか(たとえば、実行すべき実験をよりうまく選んだり、より正しい結論にたどり着いたりすることによって)だということも思い出してほしい。フロンティアAI企業の中央値の研究者はかなり優秀なのだ! 研究センスの倍率で言えば、世界全体のAI研究者の中央値に比べておそらく少なくとも3倍、もしかすると10倍にもなる。そして、平均的な人間(基本的にAI研究開発などまったくできない)に比べれば、はるかに優れている。
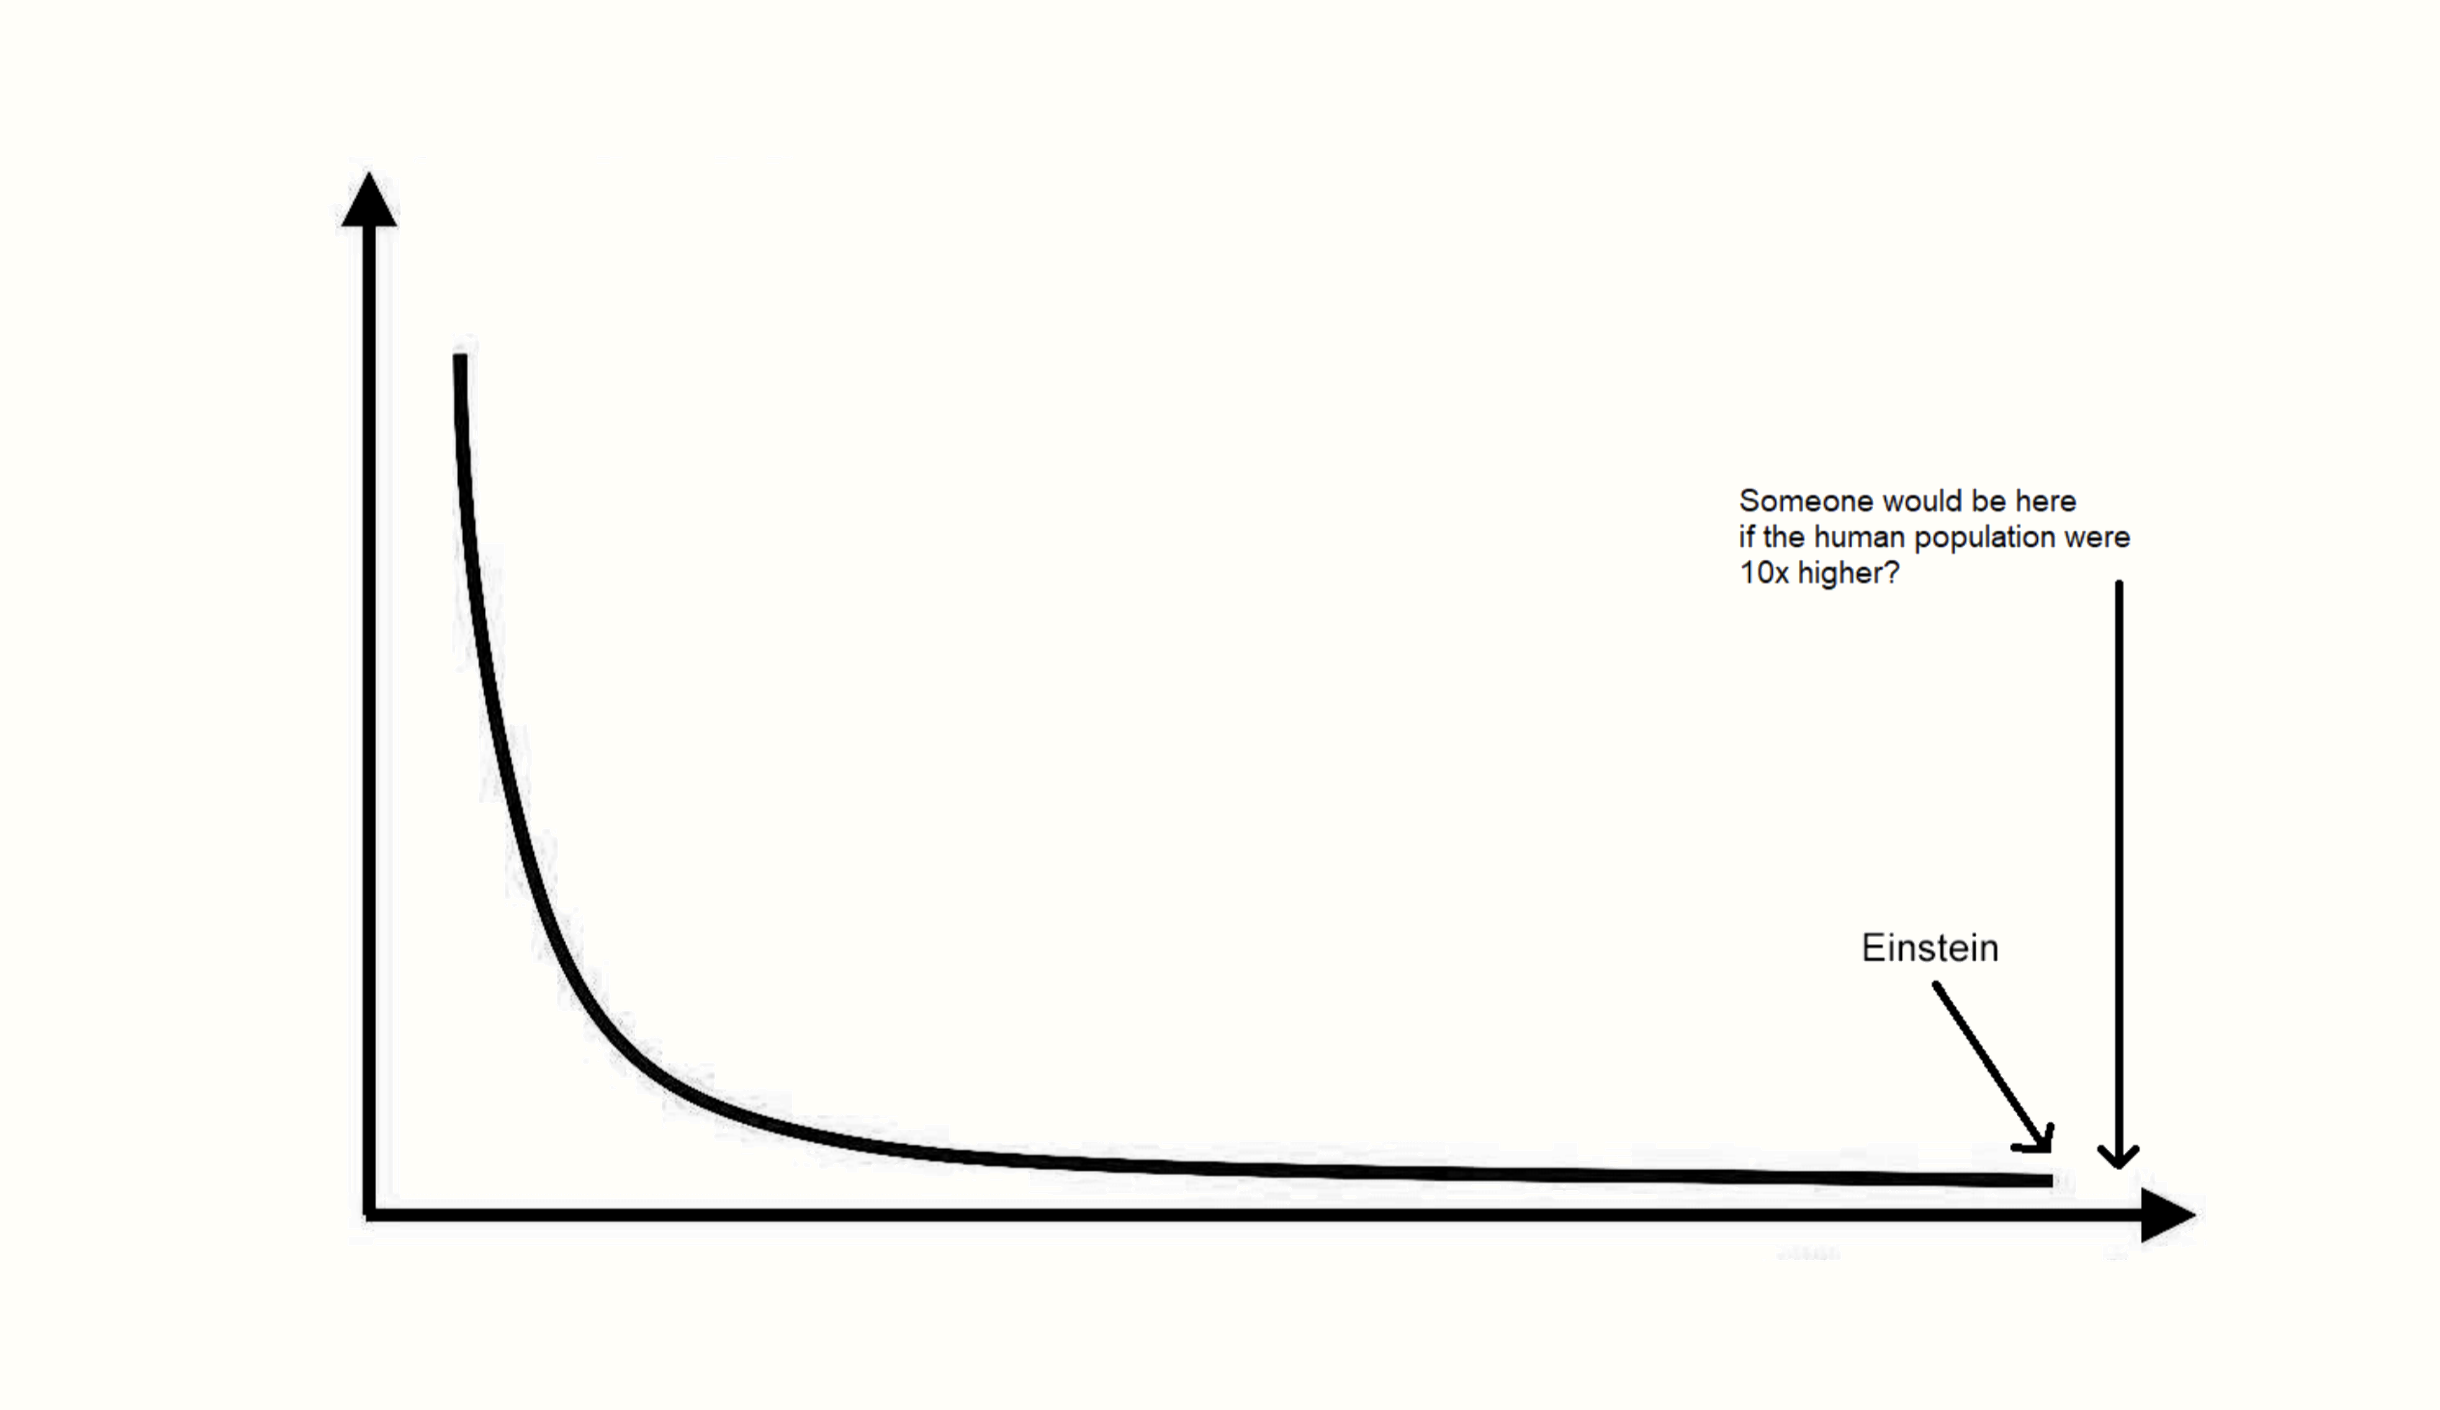
私たちが言いたいのは、研究センスで見た人間の分布は裾が重いように見え、何らかの本質的な限界に漸近しているようには見えない、ということだ。
 ai-2027.com
このような形の分布があるとき、天井や漸近線はどこにあると予想すべきだろうか。私たちの考えは、リンディの法則とのアナロジーに影響されている。リンディの法則によれば、分布の未知の部分は既知の部分に比例して大きくなるはずだという。つまり、芝生の上の落ち葉の山が数日前からあるなら、その残りの寿命についての事前の見込みは日単位で測るべきであり、大ピラミッドが数千年前からあるなら、その残りの寿命についての事前の見込みは千年単位で表すべきである。同じ原理を大ざっぱに当てはめて、人間に達成可能な最高の研究・エンジニアリングの速さは、トップの人間の天才たちから、その天才たちがより普通の同僚から離れているのと同じくらい離れているのではないか、と私たちは推測する。これはきわめて憶測的な話であり、確信を持って主張したいことは何もない。ただ、分布の上端が、私たちが測定した最後の点にたまたまぴったり一致しているということは、おそらくない、という点を除いては。
このことは、人間の人口を大幅に増やすだけで(たとえば地球を1000個、あるいは100万個用意すれば)、今日の最も優秀な人間より研究センスがかなり優れた人間が存在するだろう、ということを示唆する。具体的には、おそらく約10倍優れている。つまり、同じだけのアルゴリズムの進歩を遂げるのに、AIの実験に必要な資源が10分の1で済む。(これはおおまかにSIARに対応する。SIARはSARのおよそ10倍優れており、SARは最も優秀な人間の研究者をより速く安くしたようなものである。)
しかし、ありうるすべての人間の空間は、ありうるすべての心の空間のなかのごく小さな領域にすぎない。実際、データセンター上のSIARの天才たちの大軍が設計空間の中で到達できるありうる心の空間は、人間の心の空間よりはるかに大きい。実験できる自由度がもっと多いのだ。たとえば、脳の大きさ、中核となる学習アルゴリズム、中核となるニューラルネットのアーキテクチャ、さまざまなものの組み合わせ……
このことは、SIARの研究センスと、知能爆発のなかで最終的に到達しうる水準とのあいだに、さらなる隔たりがあるはずだということを示唆する。この隔たりはどれほど大きいのか。脳の非効率と、それらの面でAIがどれだけ優れたものになりうるかについて考えることはできる。特に、ニューラルネットワークよりはるかに効率的なアーキテクチャや、脳のものよりはるかに効率的な学習アルゴリズムが存在する可能性は高いように思われる。
しかし全体として、この種のことは考えるのが難しい。私たちの状況は、浜辺を歩いて海に入っていった原始人が、水が深くなって歩けなくなったことに気づき、岸から何キロも離れたところでは最終的にどれほど深くなるのだろうと思いをめぐらせているようなものだ。
もう一つの考慮事項は、ある意味では、一部の領域で進歩倍率は無限大にならざるをえない、ということだ。思い出してほしいが、進歩倍率は相対的なものである。つまり、AIの助けを借りない人間が進めた場合の速さに対する研究開発の速さである。100倍の倍率とは、人間なら1世紀かかる研究が1年で進むということだ。しかし、いずれAIは、人類の文明にはとうてい成しえなかった発見をするようになる。(人類の文明が、チンパンジーにはとうてい成しえなかった発見をしてきたように。)これを素朴に言い換えると、進歩倍率は無限大ということになる。これを概念的にどう扱えばよいかは私たちにもよくわからない。それでもこの点を持ち出すのは、(そう考えたければ)1,000,000倍のような途方もなく大きな倍率を、実際には次のようなことを言っているものと考えられるからだ。「ある領域では、ASIの進歩倍率は1,000倍だ。別の領域では、それよりはるかに高い。また別の領域では無限大だ。後者の領域は前者に比べて十分に多いので、実質的に『平均すると』1,000,000倍になる。」
限界
時間の制約から、重要な動態でありながらモデル化できなかったものがある。以下はその一部である。
AI研究開発の進歩倍率の不確実性。
訓練用と実験用の計算資源の増加。
今後の研究でこれらの限界を改善できるだろう。
ここで示した見方を補う、テイクオフ予測の他の手法にも私たちは期待している。
付録
AI研究開発の進歩倍率についての補足
以下の補足は洗練されていないように見えることを自覚しており、改善案をぜひ提案してほしい。
「AIなし」条件で認められるAIの使い方:AIは、(a)訓練や設計のプロセス(たとえば合成データの生成や蒸留)、または(b)実験において、「静的な役割」を果たすためにだけ使える。訓練や設計のプロセスを改良したり、実験のアイデア出しや優先順位づけ、実装を改良したりするために使うことはできない。
AIの使い方をある程度は含める必要がある。たとえば、実験の対象としてAIを使うことは認める。私たちが制限したいのは、人間の研究者が現在行っているような活動についてのAIによる生産性の向上だからだ。
出発時点の条件(つまり2027年3月のSC)については、プロジェクトの進歩倍率の条件を、OpenBrain(私たちのシナリオに登場する架空の首位のAGI企業)の人間の労働供給と計算資源の水準によって定めるものと仮定する。これらの水準は、研究の自動化を無視したトレンドの外挿による私たちの予測にもとづく。このように設定したのは、状況が違っても同じ進歩倍率を保てるようにするためだが、個々の状況との関連性とのトレードオフになるので、どうするのが最善かは確信が持てない。詳しい根拠は脚注に記す。
「AIなし」条件について:人間の研究労働は、OpenBrainについて現在の成長トレンドが続いた場合と同じとする。計算資源の供給も同様である。つまり、どの企業にも、過去の成長率を持つOpenBrainの研究者にもとづいて定義される「AIなし」条件がある。仮に新しい人間の研究者が加わる場合は、企業とAIに適応するための時間が与えられる。
「AIあり」条件について:上と同じだが、該当する企業(つまりOpenBrainではなく、進歩倍率を計算する対象の企業)の最新のAIシステムによる支援を認める。
アルゴリズムの進歩に限定する:主にアルゴリズムの進歩を目的とする活動に限定し、計算資源の拡大はわずかな量(たとえばFLOP/sの1%程度、最大の訓練ランの拡大は合計で最大1%)にとどめる。その計算資源は、改良されたアルゴリズムの実験にのみ使うことを想定している。
上の(2)のため、AI研究開発の進歩倍率は、該当する期間における現実の人間の労働に対する倍率と解釈すべきではない。そうではなく、AIによる自動化がなかった場合に起こることから予測した労働供給に対する倍率である。
AIの能力が異なれば、追求される研究課題の種類も異なりうることに留意してほしい。進歩倍率を論じる際には、簡単のため、どの課題が追求されるかについての質的な違いの可能性も含めて、こうした違いを一つの次元にまとめる。
「実験が見つけにくくなること」のモデル化
2024年初め、Eliは実験のプロセスを直接モデル化するモデルをコーディングした。このモデルは、実際の実験の候補の集まりと、それぞれの実装にかかる時間、それぞれの価値をモデル化するものである。モデルの詳細はこちら。
この手法には見込みがあると考えているが、残念ながら詳しく検討する時間がとれていない。
補間は指数的に行う。
モデルのパラメータの一部はDanielが、残りはEliが選んだ。時間の制約から、各パラメータについて二人がそれぞれ独立に見積もることはできなかった。この予測が一人の見解を表している限りでは、EliよりもDanielの見解に近い。とはいえ、二人とも全体の分布はありうるものだと考えている。
FutureSearchのプロの予測者4人にも予測を依頼した(経歴はhttp://futuresearch.ai/ai-2027)。SC→SARとSAR→SIARについての彼らの予測は、下の表に脚注として載せ、後の節で詳しく述べる。
これらが予測時期と異なる場合があるのは、シナリオの展開を確定させた後も、私たちがタイムラインとテイクオフの予測に調整を加えてきたからである。見てのとおり、私たちの不確実性は十分に大きいので、シナリオ中の時期も、私たちの中央値とほぼ同じくらいありうるものだと考えている。
FutureSearchの集計:2027年10月(2027年3月〜2029年4月)
FutureSearchの集計、SARが2027年に達成された場合のSAR→SIARの年数:1年(0.1、2.1)(詳細)
補間は指数的に行う。
5%を使うのは、AIプロジェクトがSCに到達するころにこの用途に費やしていると私たちが予測する割合が、おおよそそれくらいだからである。計算資源予測の「研究の自動化」の行を参照のこと。
「エージェント」は、平均して複数のモデルのコピーやインスタンスを同時に動かしている場合がある点に注意。たとえば最も単純なケースでは、多数の試行を並行して行い、その最良のものを採る。
厳密には、このマイルストーンと以下のマイルストーンは、研究の自動化を無視した2025年時点の私たちの最善の予測にもとづいて企業が抱えるであろう人間の研究者の数の30倍として定義する。自動化が進んだために採用が遅くなったり人が解雇されたりしてマイルストーンが大きく変わってしまう、といった問題に対処するためである(下の補足(2)を参照)。
作業を完了する速さを測る際には、実験のボトルネックや、その他の認知以外のボトルネックは含めていない。
この定義は、AI研究開発の自動化についてAI研究者にインタビューしたこちらのレポートの定義に似ている。私たちの場合、すべてのエージェントが最も優秀な研究者より30倍速いとしているのに対し、そのレポートでは各研究者のコピーを1体ずつ30倍に高速化したものを論じている。
定義にlog(労働)ではなく労働を使うのは筋が通らない。そうするとAI研究者の能力の分布への当てはまりが悪くなるからだ。
AI研究開発の能力に焦点を当てるのは、それがテイクオフの予測に最も関係するからである。ただし、汎用的な能力や他の領域での能力も、AI研究開発に特有の能力に比べてさまざまな程度の遅れを伴いつつ、急速に向上していくと私たちは考えている。
これは計算資源のボトルネックは考慮しているが、手の届きやすい成果から先に摘み取られることによる時間の経過に伴う収穫逓減は考慮していない(後者を含めないほうがよいと考えるのは、テイクオフ予測においてアルゴリズムの進歩という変数を切り分けるためであり、また、最もわかりやすい調整のやり方は、選んだ指標のlog()をとるかどうかといった選択に非常に敏感だからでもある)。
5%を使うのは、AIプロジェクトがSCに到達するころにこの用途に費やしていると私たちが予測する割合が、おおよそそれくらいだからである。計算資源予測の「研究の自動化」の行を参照のこと。
「エージェント」は、平均して複数のモデルのコピーやインスタンスを同時に動かしている場合がある点に注意。たとえば最も単純なケースでは、多数の試行を並行して行い、その最良のものを採る。
厳密には、このマイルストーンと以下のマイルストーンは、研究の自動化を無視した2025年時点の私たちの最善の予測にもとづいて企業が抱えるであろう人間の研究者の数の30倍として定義する。自動化が進んだために採用が遅くなったり人が解雇されたりしてマイルストーンが大きく変わってしまう、といった問題に対処するためである(理由は上の(2)と同様)。
作業を完了する速さを測る際には、実験のボトルネックや、その他の認知以外のボトルネックは含めていない。
文字どおりあらゆる作業で速く安いとは限らないが、多くの重要な点で大きな優位を持つ可能性が高い。
労働について直接論じることもでき、その場合も全体像はおおむね変わらないというのが私たちの最善の推測である。
研究センスの向上を助ける人間がいなかったとしても、彼らの労働の価値は、おそらくOpenBrainの研究者の中央値よりは高く、90パーセンタイルよりは低い。エンジニアリングのスキルが研究センスの不足を補うからだ。
log(15/10)/log(2)
厳密にはRも時間とともに下がるはずだが、短い期間ではその効果は大きくないはずなので、同じままだと仮定している。
(10+AMR_to_SAR)*2^(2*log((10+AMR_to_SAR)/10)/log(2))-(10+AMR_to_SAR)
これは、2027年のOpenBrainの研究者数として私たちが予測する値の約30倍である。
0.4^(log(30)/log(10))=0.22 なお、この見積もりをした後で、AIは眠ったり食べたり休んだりする必要がなく、24時間ぶっ通しで働けることを思い出した。つまり、トップの人間と比べると、ある意味では30倍ではなく60倍や100倍速い、と言えなくもない。しかし、これはさまざまな理由から、文字どおり思考時間が逐次的に速まるほどの価値はない。しかも私たちのアンケートデータは計算資源が10分の1になる仮定についてのもので、30分の1、60分の1、100分の1になる仮定についてのものではない。私たちは結果をあまり遠くまで外挿したくない(30倍はそれほど遠くないと感じるが、100倍は遠すぎると感じる)。Eliは、この考慮事項を踏まえて、全体としてこの節の進歩倍率を7から約10に引き上げるべきだと考えているが、Danielは上に挙げた理由から7のままにすべきだと考えている。また、Davidsonらのアンケートデータは、この眠る必要がないという効果を考慮に入れるよう回答者に明示的に促していたので、この考慮事項を踏まえて手法3の結果を更新する必要はない。
結果は次のとおり。20%未満の高速化:25.6%、20〜200%の高速化:37.5%、2倍を超える速さ:36.8%
データ点:1.1、1.02〜1.1、1.3、1.5超、1.25、1.01〜1.1
データ点:「0.5を少し下回る」、0.2、0.75〜0.9、「理論研究では1倍、実証研究では0.5倍(これらは別々のデータ点として数える)」、0.5〜0.9
0.4^(log(30)/log(10))=0.22
6.25の平方根
計算はこのスプレッドシートを参照のこと。
((STOCK_THROUGH_SAR+SAR_TO_SIAR_YEARS)*2^(SAR_TO_SIAR_EQUIV_JUMPS*log(((STOCK_THROUGH_SAR+SAR_TO_SIAR_YEARS)/STOCK_THROUGH_SAR)/log(2))-((STOCK_THROUGH_SAR+SAR_TO_SIAR_YEARS)
EthとDavidsonは最近、ソフトウェアによる知能爆発が起こる可能性についての続編の研究をこちらで公表した。より洗練された形で示されてはいるが、2023年のレポートの該当する節の要点から大きく外れてはいない。
Epochもこの論文で同様の方法でrを推定している。
倍率を現在の状況により特化したものにすると望ましくない結果になる理由の例として、次のことを考えてほしい。大きく超人的な自動化された研究者がいて、AI研究開発の進歩倍率が大きいとき、進歩倍率は「AIなし」の場合の人間の研究者の量と質にきわめて敏感になる。つまり、AIシステムが変わらなくても進歩倍率が変わってしまう。企業ごとの違いを認めれば、人員の規模によって結果が大きく変わりかねない。そのため、ある企業が不要になった従業員を大量に解雇すれば、その企業の進歩倍率は跳ね上がるだろう。同様に、企業の進歩倍率が人間の従業員の数に応じて時間とともに変わることを認めれば、人を解雇したときに倍率が上がってしまう。計算資源の量に応じて進歩倍率が変わることを認めた場合にも、同様の問題が起こる。AIは大量の計算資源を活用するのが相対的に得意なので、計算資源が流入すると進歩倍率が上がってしまうのだ。これはこの問題について私たちが見つけた、最も悪くない解決策だが、他の人からのフィードバックを歓迎する。
この制限は少し厳しすぎるかもしれず、明確な線を引くのも難しい。ただし、後で訓練計算量の増加を組み込む。また、こちらのレポートも参照のこと。このレポートは、モデルを再訓練する必要があることが、ソフトウェア主導の知能爆発が起こるか起こらないかを分ける要因になる可能性は低い、と論じている。さらに、私たちのシナリオでは、SC以降は基本的にゼロからの再訓練は行われない。ただし、新しいパラダイムで訓練を続ける前に、大規模な蒸留を行うことはときどきある。実験や訓練などに使うFLOPsは、SCが訓練された時点で利用できた水準で一定である。