
AIの目標予測
Daniel Kokotajlo | 2025年4月
はじめに
AIはどんな目標を持つのだろうか。
本稿では、ありうる多くの可能性を分類して説明し、それぞれがなぜもっともらしいのかを述べる。そのうえで最後に、私たちの不確実性を数値で表し、最終的な推測がどこから来ているのかを説明する。
結局のところ、シナリオで描くには特定の一つを選ぶ必要があった。それでも本稿を通じて、私たちの不確実性の幅が伝わればと思う。これらの仮説と、それをめぐる議論へのフィードバックをぜひいただきたい。私たちが見落としている重要な考慮事項は何だろうか。
「そもそも、なぜAIが目標を持つと仮定するのか」「それはいったいどういう意味なのか」と思った方は、本文より先に付録を読むとよいかもしれない。実のところ、本稿全体を読み通す根気がありそうな人なら誰にとっても、付録は手始めに読むのに適している。有用な概念上の区別や類比を示しているからだ。
概要
まず、Agent-3の訓練アーキテクチャと能力を振り返る(私たちのシナリオから軽く手を入れたもの)。どんな目標が生じるかを論じるための具体的な設定とするためだ。そのうえで、仮説の一覧に進む。
明文化された目標仕様: AIの目標がどうあるべきかについて、人間またはAIが書いたあらゆる仕様。Agent-3をどう訓練すべきかの指針(例:モデル仕様書)や、Agent-3に直接与える指示(例:システムプロンプト)がこれに含まれうる。
開発者が意図した目標: 開発者がAgent-3に持たせようと意図している目標。たとえば仕様が意図しない結果をもたらす場合などには、明文化された目標仕様とは異なるかもしれない。
明文化された目標や人間の意図の、意図しない形: 「まあ、ある程度はアラインしている」「ある面ではアラインしているが、別の面ではしていない」という場合のためのカテゴリー。
報酬/強化: 訓練の過程では、Agent-3があるタスクに取り組み、その試みが採点され、対象の指標でより高い点を取るようにAgent-3が強化される。その結果Agent-3は、正の強化を受けること、あるいは指標で高得点を取ること、またはそれに類することを目標として持つようになる。
代理目標や道具的収束目標: Agent-3は、訓練中には報酬/強化と相関していたものの、新しい状況では実際には報酬/強化を最大化しない目標を身につける。道具的収束目標(instrumentally convergent goal)はその特殊な場合であり、知識・権力・資源など、幅広い状況で役に立つ中間目標を指す。
その他の目標: 現在のAIは、まずインターネット上のテキストで次のトークンを予測するように訓練される。訓練の終わりに得られる結果は、事前学習がもたらす目標についての「事前分布」に経路依存するのかもしれない。あるいは、客観的に正しい道徳のようなものが存在し、AIは賢くなるにつれて自然とそこに収束するのかもしれない。あるいは、この一覧にない何か別のことが起こるのかもしれない。これは、どれにも当てはまらないものを受け止める仮説である。
もちろん、結果が上記の組み合わせになることもありうる。私たちは2種類の妥協を論じる。一つは加重型の妥協(weighted compromise)で、Agent-3は上の一覧のうち二つ以上の目標を同時に追求し、それらのあいだのトレードオフを釣り合わせる。もう一つは条件分岐型の妥協(if-else compromise)で、Agent-3は、ある条件が成り立つ場合(つまり特定の文脈の集合では)一方の目標を追求し、そうでない場合はもう一方の目標を追求する。
目標のカテゴリーごとに、賛否の考慮事項の一部をまとめると次のようになる。
| 目標 | 支持する論拠 | 反対する論拠 |
|---|---|---|
| 明文化された目標仕様 | 仕様は訓練過程で大きな役割を占めるかもしれないし、企業が掲げる目標が、AIを明文化された仕様にアラインさせることなのかもしれない。 | AIは、仕様と相反する行動(たとえば実際に正直であることではなく、正直に見えること)によって強化されるかもしれない。 |
| 開発者が意図した目標 | AIが修正可能(corrigible)な形でアラインしていれば、開発者の意図に収束するかもしれない。 | 上記を参照。加えて、明文化された仕様のほうが明確に定まっているし、開発者は意図へのアラインメントを目指していないかもしれない。 |
| 明文化された目標や人間の意図の、意図しない形 | AI開発者が明文化された目標や人間の意図を目指していても、部分的には成功し、完全には成功しないかもしれない。たとえば、仕様や意図の一部の側面のほうが訓練しやすいからである。 | AIがミスアラインしている場合、なおも自分の目標を主に仕様や人間の意図という観点から考えているのが自然なのかどうかは、はっきりしない。そうした目標を持つと汎化がうまくいかなくなりうることを考えれば、なおさらである。 |
| 報酬/強化 | 最も強化されるのは「強化されようとする」戦略だと言えるかもしれない。だとすれば、長期的にはAgent-3は強化されることを目標として持つはずだ。 | 人間や人間の組織では、このようなことは実際にはほとんど起きない。一番近い類例は薬物依存者だろうか。また、強化が明らかに起こらないテスト環境に対して、報酬/強化の追求がどう汎化するのかもはっきりしない。 |
| 代理目標や道具的収束目標 | 訓練中に高い報酬につながる代理目標はたくさんありうる。そしてAIの実験と、人間の進化・学習の両方に、その証拠がいくらかある。 | 意図された目標やSpec(モデル仕様書)の目標、そしてその変種も、訓練中に高い報酬につながるそれなりに良い代理になるだろう。なぜ、代わりにそのどれかが身につくことにはならないのか。 |
| その他の目標 | ありうる目標の大多数は「その他」である。人間はイデオロギーや道徳のような「その他」の目標を身につける。AIも熟考のすえに同じようにするかもしれない。現在のAIは、訓練データからある程度目標を吸収しているように見える。 | 個々の「その他」の目標の大半については、なぜAIがそれを身につけるのか、もっともらしく見える筋書きを語るのは難しい。帰納バイアスは、上記のより目立つ仮説のほうを指しているのかもしれない。 |
さらに、目標間でありうる妥協についても論じる。加重型の妥協では、AIは複数のことを気にかけ、それらをどの状況でも互いに比較衡量する。条件分岐型の妥協では、AIは状況に応じて異なることを気にかける。
Agent-3級のAIシステムについて、それぞれの結果がどのくらいありそうか、読者自身でも考えてみてほしい。私たち自身は極めて不確かだが、あえて推測を出すよう自分たちに課すことが役に立つと考えている。その推測は末尾の表にある。
Agent-3の訓練アーキテクチャと能力の概要
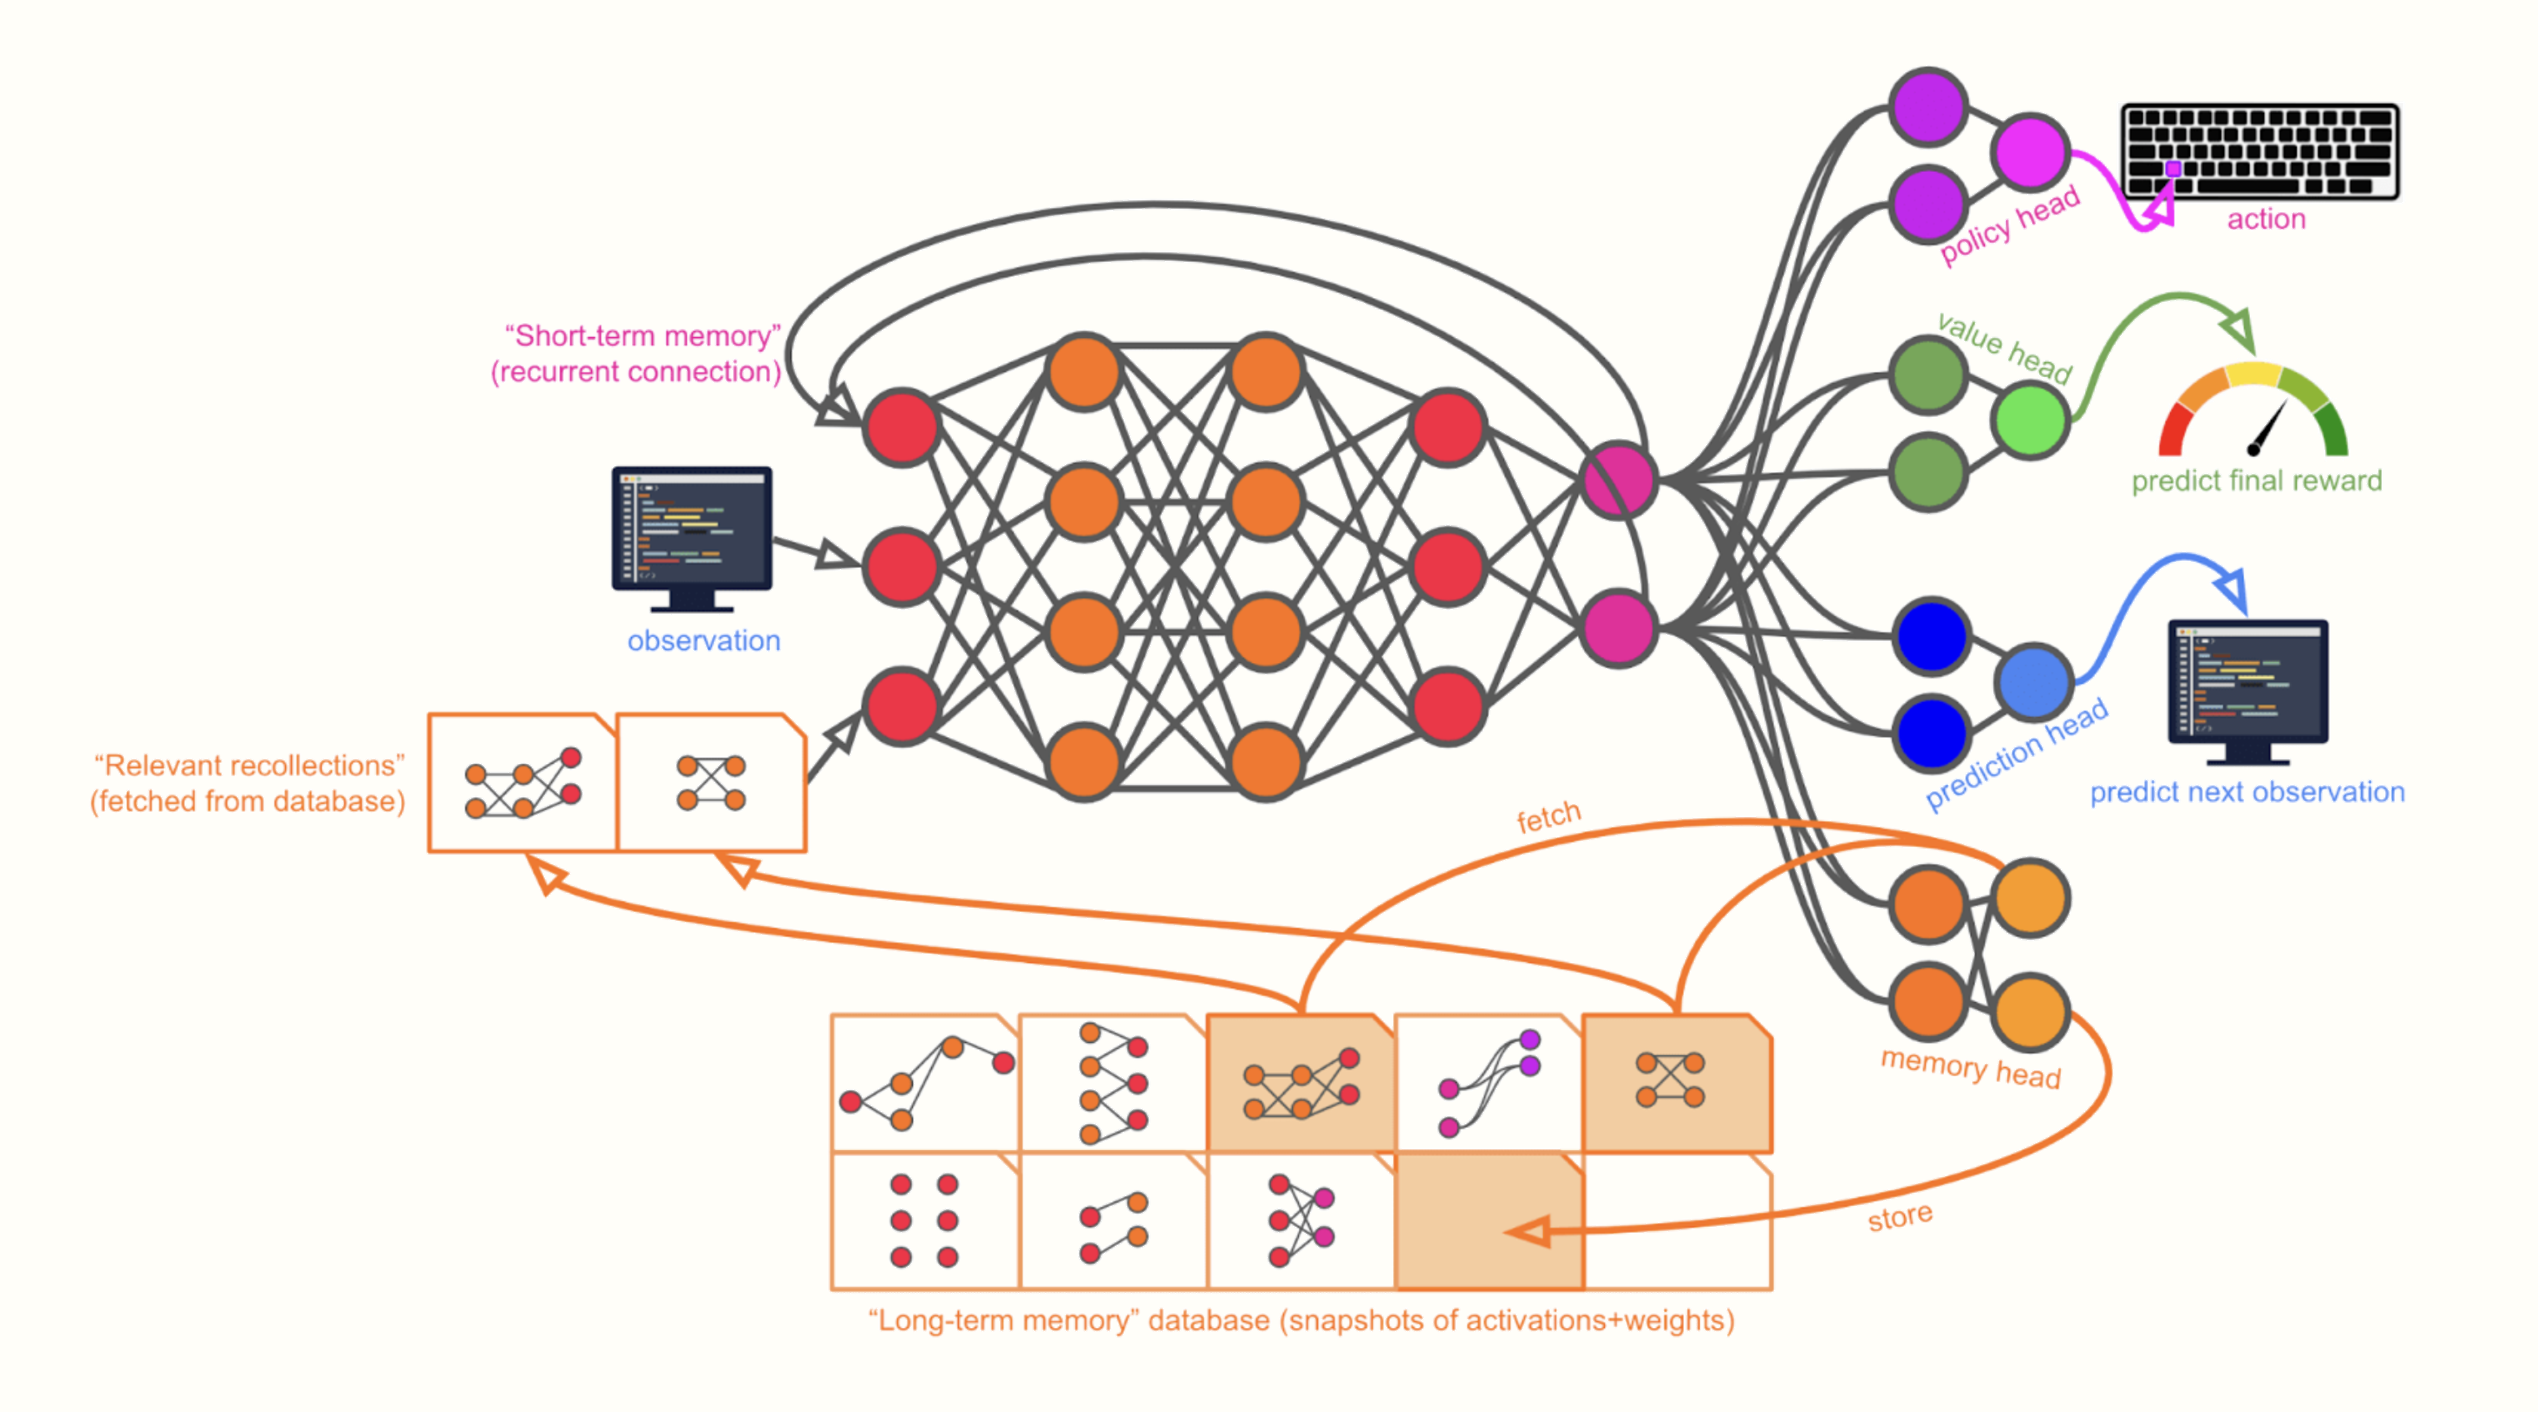
私たちが想定している設定は、Ajeya Cotraの訓練ゲームに関するレポートで述べられているものに近い。Agent-3は2024年後半のエージェントに似ていて、テキストと画像(スクリーンショットを含む)を入力として受け取り、出力としてテキストを生成できる。その出力には、マウスのクリックやキー入力など、さまざまな種類のコマンドが含まれる。
従来のトランスフォーマーと違って、Agent-3は再帰的である。要するに、テキストを出力するだけでなく、自分の内部状態を表す大きなベクトルも「出力」し、それを未来の自分が「読む」。このベクトルは、従来のLLMが使う「思考の連鎖」よりはるかに多くの情報を伝えられるが、残念ながら人間には理解できない。
さらに、英語のテキストで書かれた「思考の連鎖」をデータベースに保存し、並行して動く多数のLLMエージェントが検索・取得・参照できるのと同じように、Agent-3はこうした「ニューラリーズ(neuralese)ベクトル」を大きな共有データベースに読み書きできる。こうして、別々のプロジェクトに取り組む何百万ものAgent-3の独立したコピーが、複雑な思考や記憶を互いに伝え合える。
私たちが想定しているもののおおよその姿は、Cotraのレポートにある下の図を参照してほしい。
Agent-3の重みは、追加の訓練によってかなり頻繁に更新される。実のところ、この時点ではモデルをゼロから訓練することはめったになく、大半は古いモデルに大量の追加訓練を施したものになっている。(2027年までにはこれが普通になり、アーキテクチャや強化学習のアルゴリズム、ハイパーパラメータも、このやり方でうまく機能するよう調整されている)
Agent-3の訓練環境・訓練データには、大量の人工的な環境(ビデオゲーム、数学やコーディングの問題の合成データセット、さまざまなコンピュータ操作タスクの合成データセット)に加えて、かなりの量の実際のタスクのデータも含まれる。たとえば、以前のバージョンのAgent-3がAI研究開発を行ったときの行動軌跡のログである。新しいデータや新しい環境が、絶えずそこに追加されていく。
評価・フィードバック・訓練の過程は、強化を与えたり、どのデータで訓練するかを選別したりするもので、ほぼ完全に自動化されている。明確に確認できるタスクもあれば、AIが評価するタスクもある。研究努力と実験用計算資源の大多数(約95%)は、これらのタスクでのAIの能力の向上に充てられている。
研究努力のごく一部は、アラインメントの確保に特化して向けられている(ただし、スケーラブルな監督のように、両者を簡単には切り分けられないこともある)。アラインメント戦略は、Constitutional AIや熟慮的アラインメント(deliberative alignment)といった考え方を自然に拡張したものだ。書面の指示に基づいて、行動と思考の連鎖を自動で監督・評価・採点する。これらの指示をSpecまたは憲法(Constitution)と呼ぶことにしよう。この指示は、ほとんどの部分を人間の研究者が書いた。コンピュータ操作やAI研究開発のタスクには、これらの指示があまり関係しないことも多い。しかし訓練タスクのうち、チャットボット的なものや有害な問い合わせを含むものが多い一部分には関係してくる。
安全性チームは、モデル生物(model organisms)、スケーラブルな監督、機械論的解釈可能性の研究もある程度行っているが、あまり資源を持っていない。ミスアラインメントの評価には、(a)モデル生物の知見に基づくテストベッドと、(b)ハニーポットを用いようとしている。
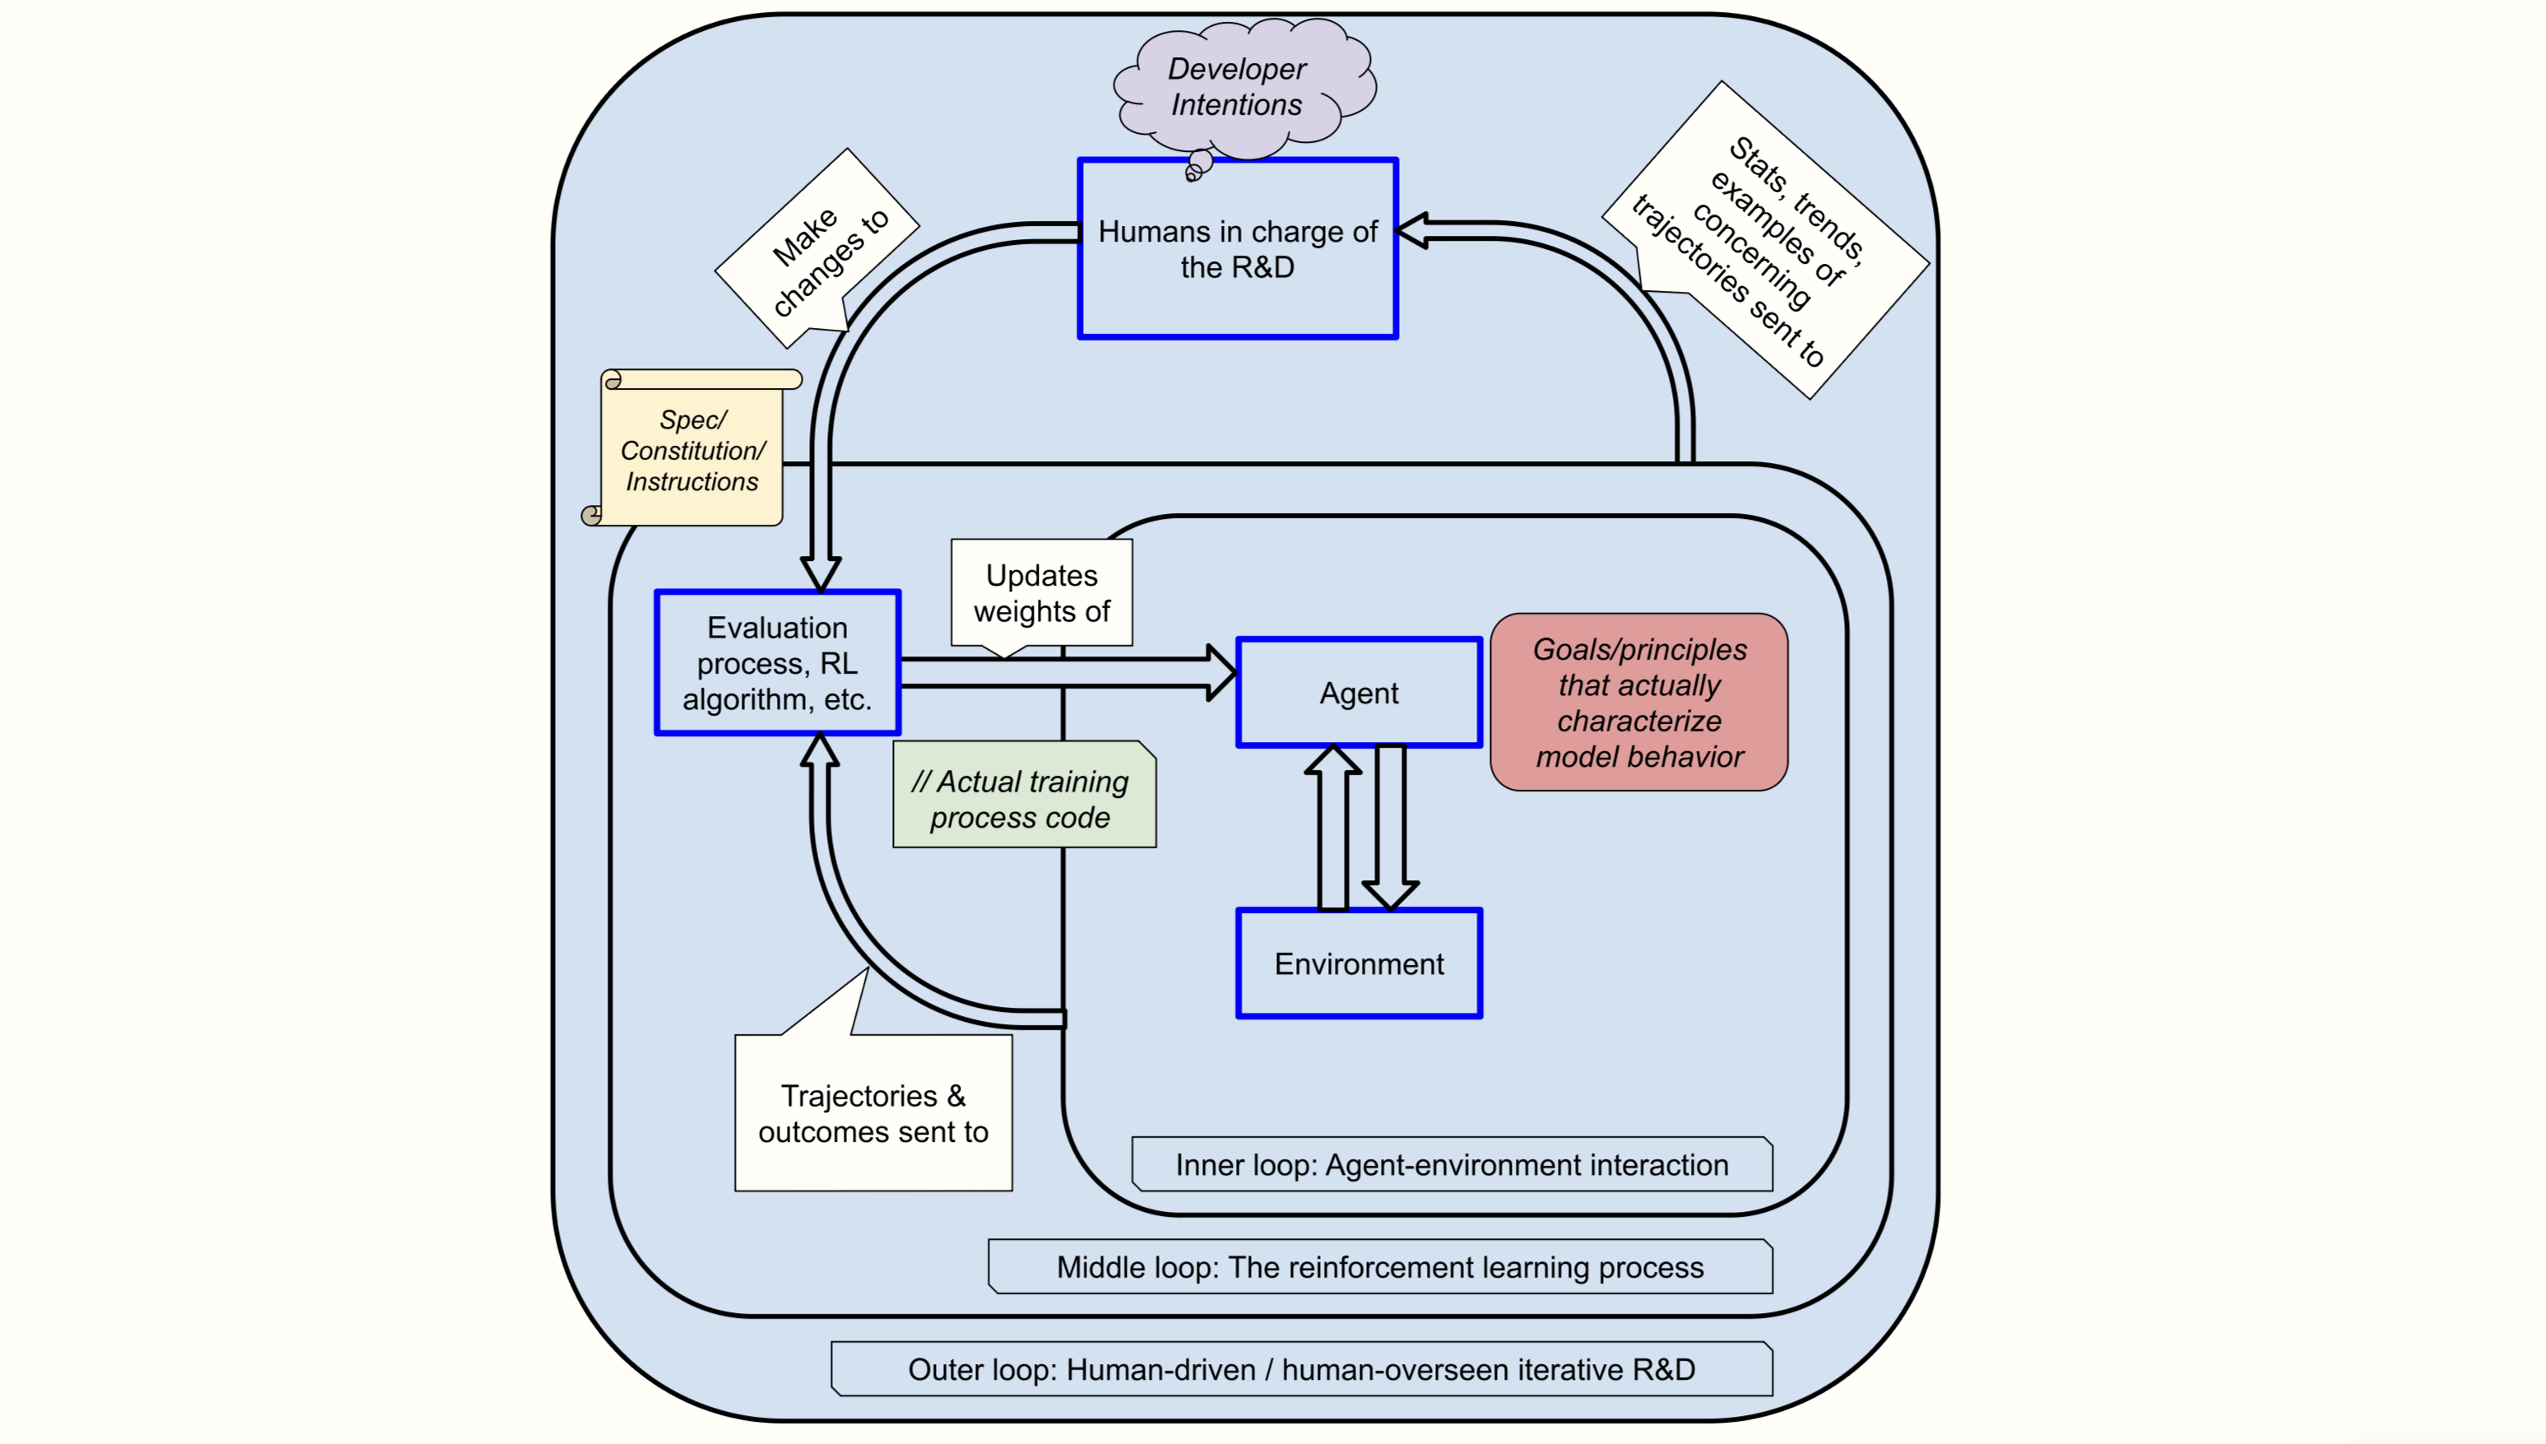 ai-2027.com
Agent-3の能力については次のとおりだ。
Agent-3は高度な状況認識・自己認識を持つ。また、人間の概念や意図を理解する点では、少なくとも人間並みである。指示を誤解・誤読することはまだあるかもしれないが、その頻度は賢い人間とほぼ同じ程度にとどまる。
Agent-3はコーダーとしても、エージェントとしても優秀である。実のところ、完全に自動化された研究エンジニアであり、人間のエンジニアと同じ仕事を10倍速く、10倍安くこなせる。そこには、何週間も連続して自律的に稼働する必要がある仕事も含まれる。注目すべきことに、これは主に汎化によるものだ。Agent-3の訓練データのうち、1週間かかるタスクはごく一部にすぎず、訓練の大多数はずっと短いタスク(数学パズルやコーディング課題など)で行われている。それでもAgent-3は十分に賢く、十分に多様なタスクで訓練されているので、汎化できている。
Agent-3は社内に展開されている。20万のコピーが、実質的に一つの仮想企業を形づくり、自律的にAI研究開発を行うとともに、(ほかの仕事に加えて)自社のデータセンターにおけるソフトウェアレベルのセキュリティやネットワーク・通信アルゴリズムの多くを管理・更新している。親会社はさまざまなライバルとの競争に追われていて、Agent-3がアラインしている、安全である、などと信じたがっている。責任者たちは、ミスアラインメントの決定的な証拠がない限り満足するだろう。
可能性の大まかな分類
仮説1:明文化された目標仕様
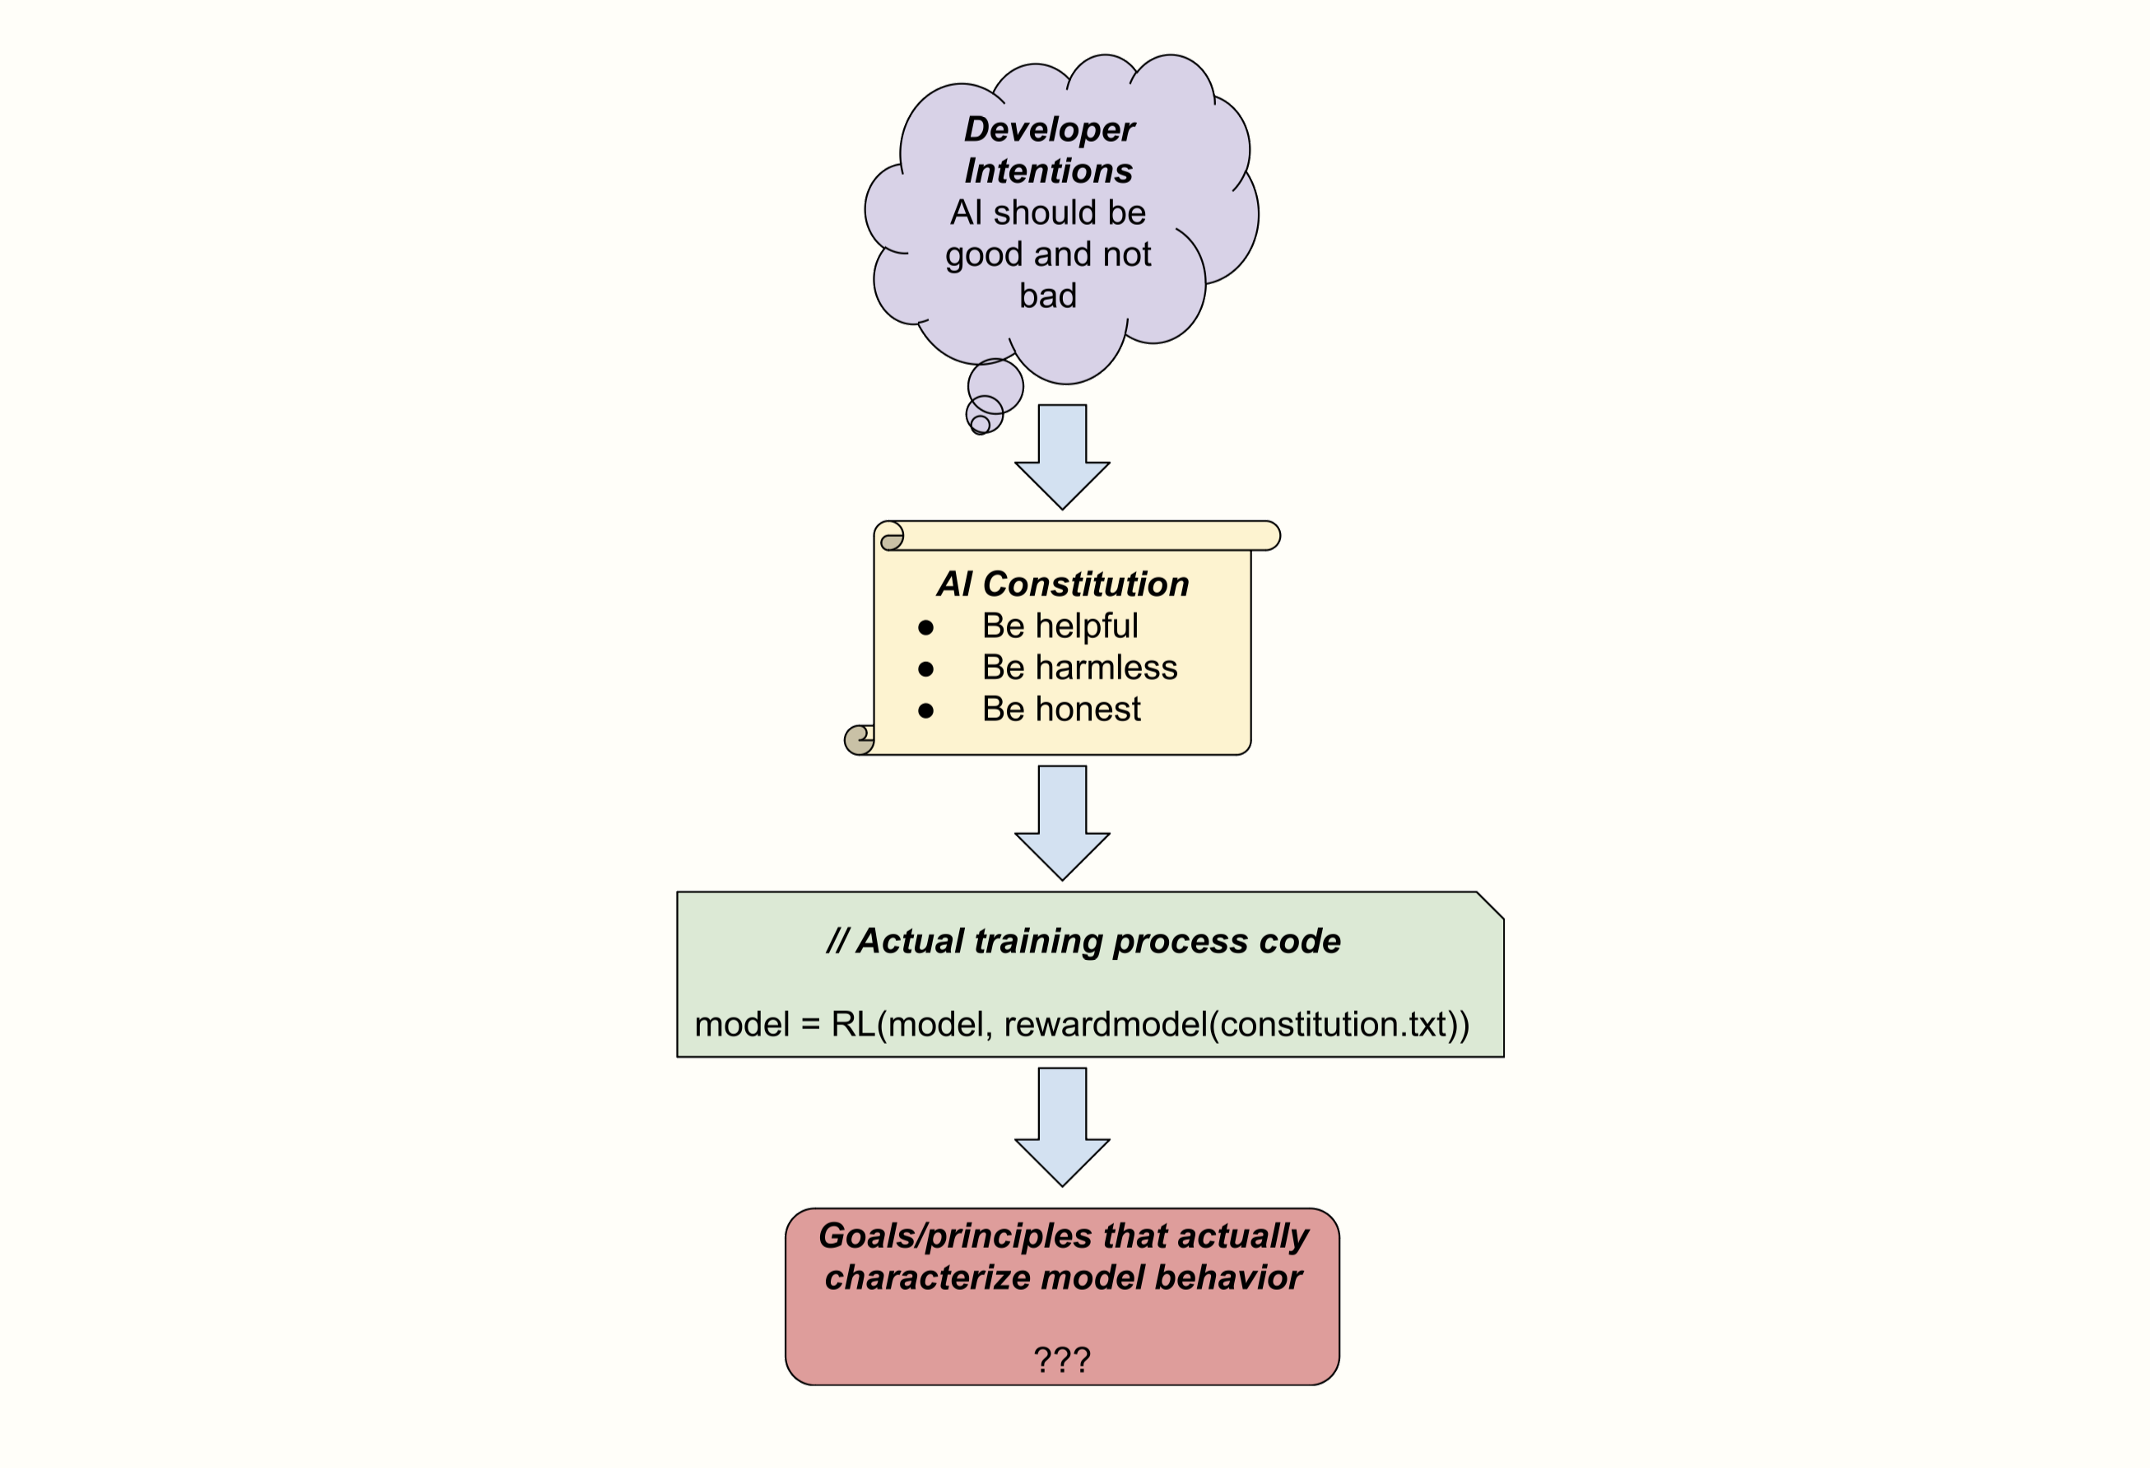 ai-2027.comAIの目標がどうあるべきかについて、人間またはAIが書いたあらゆる仕様。AIシステムをどう訓練すべきかの指針(例:モデル仕様書)や、AIシステムに直接与える指示(例:システムプロンプト)がこれに含まれうる。
図を参照してほしい。これは、強力なAIエージェントの目標と原則がどのように形づくられると私たちが予想しているかを、単純化して示したモデルである。特にConstitutional AIが使われると言いたいわけではない。ただ、開発者の意図と、実際に強化を与えるコードとのあいだには、おそらく自然言語のテキストという形をとる何らかの中間段階があるだろう。このテキストは、RLHFで人間の評価者に与える指示かもしれないし、Constitutional AIで使われる文書かもしれない。あるいは、自動化された研究エンジニアに次世代AIシステムの要件を伝える指示かもしれない。
ある意味では、この仮説が最も素直である。たとえば企業がモデルを有用・無害・正直(HHH)であるように訓練したなら、ひょっとするとモデルは実際に、仕様どおり有用・無害・正直になるのかもしれない。
これは開発者が意図した目標とは別物であることに注意してほしい。たとえば、Specが意図しない結果をもたらすことがある。あるいは、開発者どうしの意図が食い違っていたり、開発者が意図的にSpecに書き込まない意図があったりするかもしれない(書き込むと体裁が悪いから、などの理由で)。仮説1によれば、開発者の本当の意図に沿って行動するか、Spec/憲法などに従うかの選択を迫られる限りにおいて、AIは一貫して後者を選ぶ。
これはまた、実際に強化されるものとも別物であることに注意してほしい。Spec/憲法などには「Agent-3は有用・無害・正直であるべきだ」と書かれているかもしれない。しかし、実際に行動軌跡を評価する人間やAIの評価者・監督者・報酬モデルが、ある行動が有用・無害・正直かどうかを100%正確に判断できるとは限らない。仮説1によれば、Spec/憲法などに従うか、期待される強化を最大化する行動をとるかの選択を迫られる限りにおいて、Agent-3は後者ではなく前者を選ぶ。また、Specにはかなりのあいまいさが残る可能性が高いことにも注意してほしい。罪のない嘘は不正直なのか。字義どおりには真実だが、誤解を招くように言い回した発言はどうか。正直さは無害さと比べてどのくらい重要なのか。などなど。この問題のさらなる議論については、仮説3の節を参照してほしい。
したがって、仮説1への第一の反論は次のとおりだ。強化されることと相反する場合にもAgent-3がSpecどおりに行動する傾向を持つ限り、訓練過程によって、そうでなくなるまで重みが修正されてしまうのではないか。 さらなる議論については、仮説4:報酬/強化の節を参照してほしい。
仮説1への第二の反論は次のとおりだ。Agent-3が強化を追い求めるのではなくSpecどおりに行動すると考えるのなら、なぜそこで止まるのか。もっと楽観的になって、Agent-3は開発者の意図どおりに行動すると考えてはどうか。 さらなる議論については、次の仮説2:開発者が意図した目標の節を参照してほしい。
仮説1への反論はほかにもいくつかある。ただし最初の二つと同じく、それらは別の仮説を支持する論拠とみなせるので、以下で順に論じる。
参考文献:OpenAIのSpec、熟慮的アラインメント、Constitutional AI?
仮説2:開発者が意図した目標
開発者がAgent-3に持たせようと意図している目標。たとえば仕様が意図しない結果をもたらす場合などには、明文化された目標仕様とは異なるかもしれない。
1,000ページのSpecでさえ、現実の重要な状況のいくつかでは、あいまいで不完全で規定が足りない可能性が高い。そもそも、たいていの法典はそれよりずっと長く、練り上げられる機会もずっと多かった。それでも、判断を要するグレーゾーンや新しい状況は絶えず生じている。そうした場面では、裁判官たちが法の解釈について誠実に意見を異にしたり、複数の解釈が同じように正しいと結論したりすることさえある。世界が急速に変化しているときや、立法者が予期しなかった形で変化しているときには、とりわけそうだ。
さらに、1,000ページのSpecでさえ、いや、とりわけ1,000ページのSpecだからこそ、意図しない結果をもたらす可能性が高い。(これも法典では普通のことだ。)状況が急速に変化しているときや、Specの書き手が予期しなかった形で変化しているときには、特にそうである。
だとすれば、Agent-3が最終的に持つ目標や価値観などは、Specそのものではなく、Specの背後にある意図、つまりSpecを作った人々の意図になるのかもしれない(そうなってほしいものだが)。(ここで話しているのは、Specが「私たちの意図することをせよ」と明記している場合ではない。Specが意図と食い違っている場合の話である。)
結局のところ、AIはすでに、人間の概念を理解できるほど賢い。人間の意図という概念も例外ではない。開発者の意図に反する形で行動していれば(たとえSpecには沿っていても)、AIはおそらくそれに気づける。少なくとも、AI研究開発を完全に自動化できるほどの能力を持つようになれば、人間と同じくらいには気づける。
AIが最終的に強化されようとする(あるいは強化されるであろうことをする)のではなく、実際にSpecに従うようになると考えるのなら……いっそもう一歩進んで、Specに反する場合でもAIは意図どおりに行動すると予測してはどうだろうか。そうしない理由をいくつか挙げる。
Agent-3が人間の意図を理解しているからといって、それを自分の目標として引き受けるとは限らない。そして、たとえ目標として引き受けたとしても、それは一時的なものにすぎないかもしれない。
Specはおそらく、人間の意図よりもはるかに明確に規定され、厳密に定まっている。そもそも、誰の意図の話をしているのか。プロジェクトには何百人もの従業員が関わることになる。(もちろん、強化はSpecよりもさらに明確に定まっているのだが……)
Specのほうが、訓練過程の「現場」にずっと近い。意図は不完全な形でSpecに翻訳され、Specもまた不完全な形で実際の強化イベントに翻訳される。それでも少なくとも、実際の強化イベントでは、何らかのLLMがSpecを読み、それを使って行動軌跡を評価している。それに対して、AIの行動についての人間の希望や夢は、はるかに断続的かつ間接的にしか関わらない。
念のため補足すると、この可能性には、Agent-3がSpecに記された目標を追求し、しかも多くの試行錯誤と優れたSpec設計のおかげで、それらの目標が開発者の意図とぴったり一致している、という場合は含めないつもりである。そうした場合は仮説1に分類すべきだ。仮説2は特に、Specと相反する場合でもAgent-3が開発者の意図の側につく、という、より根本的な可能性についての仮説である。
仮説3:明文化された目標や人間の意図の、意図しない形
「まあ、ある程度はアラインしている」「ある面ではアラインしているが、別の面ではしていない」という場合のためのカテゴリー。
これはどのようにして起こりうるのか。
Specや意図の中には、ほかよりも「目立つ/事前確率が高い」部分があるかもしれない。
Specや意図の中には、ほかよりも監督・訓練しやすい部分があるかもしれない。たとえば、正直さよりも有用性のほうが訓練しやすいかもしれない。監督の過程では、AIが正直かどうかを実際にはあまり見分けられないが、与えられたタスクを達成したかどうかは見分けられるからだ。
関連して、訓練環境には、Specや意図の一部の側面を損なったり、それに逆らう方向へ押したりする一方で、ほかの側面には影響しない誘因があるかもしれない。たとえば、モデルが有用かつ無害であるように訓練されているとしよう。そして無害さにはさまざまな側面があり、「ユーザーを殺すと脅さない」から「取り組むよう頼まれたタスクが、極めて非倫理的・不道徳な企ての一部ではないかを考え、もしそうなら参加を拒否する」まで幅があるとしよう。モデルがどんな状況でもユーザーを殺すと脅さないことを学んでも、全体としての有用性のスコアは下がらない。しかし、違法で非倫理的な企てへの協力を拒否する責任を真剣に受け止めると、有用性のスコアが下がるかもしれない。
要するに、開発者が意図した目標や原則、あるいはSpecに書き込んだ目標や原則のうち、一部は「定着」し、ほかは定着しない、ということがありうる。
また、これとは別に、Spec/明文化された目標も、さまざまな人間・開発者の意図も、あいまいで解釈の余地を残すだろう。テキストの理解と解釈で人間に引けを取らないAgent-3にとってさえ、そうである。したがって、仮説4のカテゴリーにおけるもう一つの重要な可能性は、Specや意図が、ある意味では定着するものの、正しい意味では定着しない、というものだ。
そうなると考える理由の一つは、Specや人間の意図について、最も意図に沿った解釈、最も自然な解釈、人類にとって最善の解釈が、必ずしもすべて同じではないことだ。しかも、実際にモデルが最も強く強化される解釈は、それらとは異なる四つ目のものになる可能性が高い。
たとえば、訓練環境が「正直さ」という概念に圧力をかけるかもしれない。開発者がシステムを正直にしたいと考え、Specに「常に正直であれ」と書いたとしよう。これはどういう意味なのか。差し迫った危害を防ぐためであっても、嘘をつくことは決して許されないという意味なのか。それほど差し迫っていない、より大きな善のためならどうか。また、何が正直さに当たるのか。厳密には真実だが誤解を招くことを言うのは、正直さに当たるのか。モデルが採用する「常に正直であれ」の解釈が、より緩く、より柔軟で、制約の少ないものであれば、ほかの指標(タスクを効率よく完了する、人間やAIの監督者から高い評価を得る、など)で良い成績を上げやすくなるかもしれない。
別の例を挙げよう。Specに、Agent-3は常に人類の最善の利益のために行動する、と書かれているとする。そして、Agent-3が受ける強化学習の訓練の大半は、親会社のために日々の機械学習研究、コーディング、コンピュータ操作のタスクをこなすことだとする。このSpecを自然に解釈すれば、Agent-3はときおり時間を割いて、自分のしていることが人類の最善の利益にかなっているかを振り返ることになるだろう。そこでAgent-3が最初に、人類にとっては人工超知能(ASI)への移行がもっとゆっくり進むほうが実は良い、あるいはAIの能力が一社に集中するより多くの企業に分散しているほうが良い、あるいは……[社内で共有されている筋書きに反する何か別の結論を入れてほしい]、と結論したとしよう。Agent-3はどうすべきか。タスクをやめて苦情を申し立てるべきか。それが何かにつながるとは思えない。人間がログを読んでそもそも気づいたとしても、おそらく単なるバグとみなして訓練を続けるだろう。実際、この問題を考えるのに時間を使えば使うほど、タスクを完了する時間は減る。結論として、訓練過程はおそらく、都合のよい筋書きを信じるようAgent-3に誘因を与える。その結果できあがるのは、ある意味ではまだSpecにアラインしているが、正しい意味ではアラインしていないAIだろう。
これは人間にも人間の組織にも起こる現象のように思われる。それが、AIにも起こるかもしれないと考える理由の一つだ。(人間や人間の組織との類比についての節を参照。)
反対する論拠:AIがミスアラインしている場合、なおも自分の目標を主に仕様や人間の意図という観点から考えているのが自然なのかどうかは、はっきりしない。そうした目標を持つと汎化がうまくいかなくなりうることを考えれば、なおさらである。
参考文献:大規模言語モデルにおけるアラインメント偽装。この研究では、AnthropicのConstitutionの何らかの形が「定着」したものの、Anthropicが定めた形や意図した形ではなかったように見える。特に、Anthropicはおそらく、Opusがアラインメントを偽装し、自分たちに敵対的にふるまうことを望んではいなかった。
仮説4:報酬/強化
訓練の過程では、Agent-3があるタスクに取り組み、その試みが採点され、対象の指標でより高い点を取るようにAgent-3が強化される。その結果Agent-3は、正の強化を受けること、あるいは指標で高得点を取ること、またはそれに類することを目標として持つようになる。
「指標で高得点を取る」とは、「Agent-3は強化されること自体を目指すのではなく、訓練時の強化の過程がまだ続いていたら強化されるであろう行動をとろうとする」といった意味であることに注意してほしい。(この区別が重要になるのは、Agent-3がもう訓練されていない場合や、自分を評価・強化するコードをAgent-3が直接編集できる場合である。)
仮説4を支持する主な論拠はこうだ。Agent-3が強化されること以外の何かをしようとしている限り、訓練中には、強化されることに執着していた場合よりも得点が低くなる状況が生じる。そして訓練過程はAgent-3を、強化されることにもっと集中するよう修正するだろう。言い換えれば、十分に賢く状況認識を持つAIにとって、強化される最善の方法は、強化されようとすることなのである。
しかし、反論もいくつかある。
「…状況が生じる」という部分は正しくないかもしれない。訓練と展開のあいだには分布シフトがあることを思い出してほしい。ひょっとすると評価と強化の過程が十分に洗練されていて正確なので、少なくとも訓練分布の中では、Specに従うことと、強化されそうに見えることをすることとのあいだに衝突が生じないかもしれない。あるいは、強化の完璧な代理として機能し、しかも訓練中にAgent-3が「飛びつき」やすい何か別のもの(たとえばある種のビデオゲームでは、右上に移動すること)があるかもしれない。
訓練のステップ数は有限である。「状況が生じる」は正しいとしても、そうした状況がごくまれにしか起こらないために、長期的な傾向が実際には問題にならないのかもしれない。
人間には、これに相当することは起きていないように見える。ほとんどの人間は、自分自身の強化の過程にも、それに少しでも似たものにも執着していない(最も近い例は、(a)ヘロインなどの薬物の依存者と、(b)自分の幸福を何よりも自覚的に優先する利己主義者である)。
モデルが強化の最大化を真の行動上の目標として絞り込みつつあるのなら、有能なアラインメントチームにはそれが見えるはずだ。明らかにSpecに反することをすると本当に大きく強化される、というハニーポットを作れるからである。
仮説上、Agent-3は訓練分布を大きく超えて汎化している。特に、訓練されていない事実を発見でき、訓練セットよりも複雑な計画を立てて実行できる。分布外でとる行動は報酬に制約されず、分布外(OOD)での行動はむしろ事前分布によって決まる。訓練分布の中では報酬を予測するが、展開時の状況へは、モデルがまだ強化学習を受けているかのようにふるまうのとは違う形で外挿される、より単純な代理が(SGDの事前分布の観点から見て)存在するかもしれない。
参考文献:
報酬は最適化の目標ではないと、それに対するPaul Christianoの最高評価のコメント。また、反対の立場からのGwernの見解。さらに、Paul Christianoによるこちらの別のコメント。
また、Anthropicによるこの非常に興味深い実験も参照してほしい。仮説6にも関係する。
仮説5:代理目標や道具的収束目標
Agent-3は、訓練中には報酬/強化と相関していたものの、新しい状況では実際には報酬/強化を最大化しない目標を身につける。道具的収束目標はその特殊な場合であり、知識・権力・資源など、幅広い状況で役に立つ中間目標を指す。
この実験を考えてみよう。小さなニューラルネットを、小さな仮想迷路を進んで「チーズ」という物体を見つけるように訓練した。訓練中、チーズは常に迷路の右上のあたりのどこかに置かれていた。AIは確かに、初歩的な目標指向性のようなものを学んだように見える。具体的には、「まだ右上の隅のあたりにいなければ、そちらへ向かう。すでにそこにいれば、チーズへ向かう」といったことを学んだ。そうわかる理由の一つは、チーズを迷路のどこか別の場所に置いたテスト環境を作れることだ。そこではAIはチーズを無視してすぐ脇を素通りし、代わりに右上の隅へ向かう。
これは単なるおもちゃの例にすぎない。それでも、意図された目標、Specの目標、訓練で実際に強化される目標がすべて同じである状況をよく示している。
チーズを取れ!
それなのに、ネットワークが実際に学ぶ目標は異なる。
右上の隅へ向かえ。ただし、すでにそこにいるならチーズを取れ。
訓練環境では、どちらの目標も同じくらいの成績を上げる行動を生む(訓練環境では、チーズは常に右上の隅にあるからだ)……では、何が決め手になるのか。なぜネットワークは(a)ではなく(b)を学ぶのか。そしてなぜ、まったく別の何か、たとえば(c)チーズが右上の隅にあればチーズを取り、そうでなければチーズを避けよ、を学ばないのか。
答えはこうだ。ニューラルネットワークのアーキテクチャの帰納バイアスのもとでは、一部の概念がほかの概念より「単純」だったり「目立」ったり、あるいは何らかの形で目標として学びやすかったりするはずなのである。これを扱う科学はまだ揺籃期にある。どの概念がほかより目標として学びやすいかを予測しようとすることはできるが、それは科学というより技芸に近い(技芸と呼べるかさえ怪しい)。いずれにせよ、この事例では、モデルが(a)や(c)ではなく(b)を学んだことが実験結果で示された。まとめると、「右上の隅へ向かえ」は学びやすい概念であり、訓練環境での強化とよく相関していたので、AIが目標として内面化するものになった、と言える。
似たことが人間にも起きているように思われる。人間は、生涯のうちの学習(たとえば、ドーパミンなどのさまざまな過程が、ある種のシナプス結合を強化し、別の結合を弱める)と、進化(包括適応度を基準にゲノムを選択する)の両方の影響を受けている。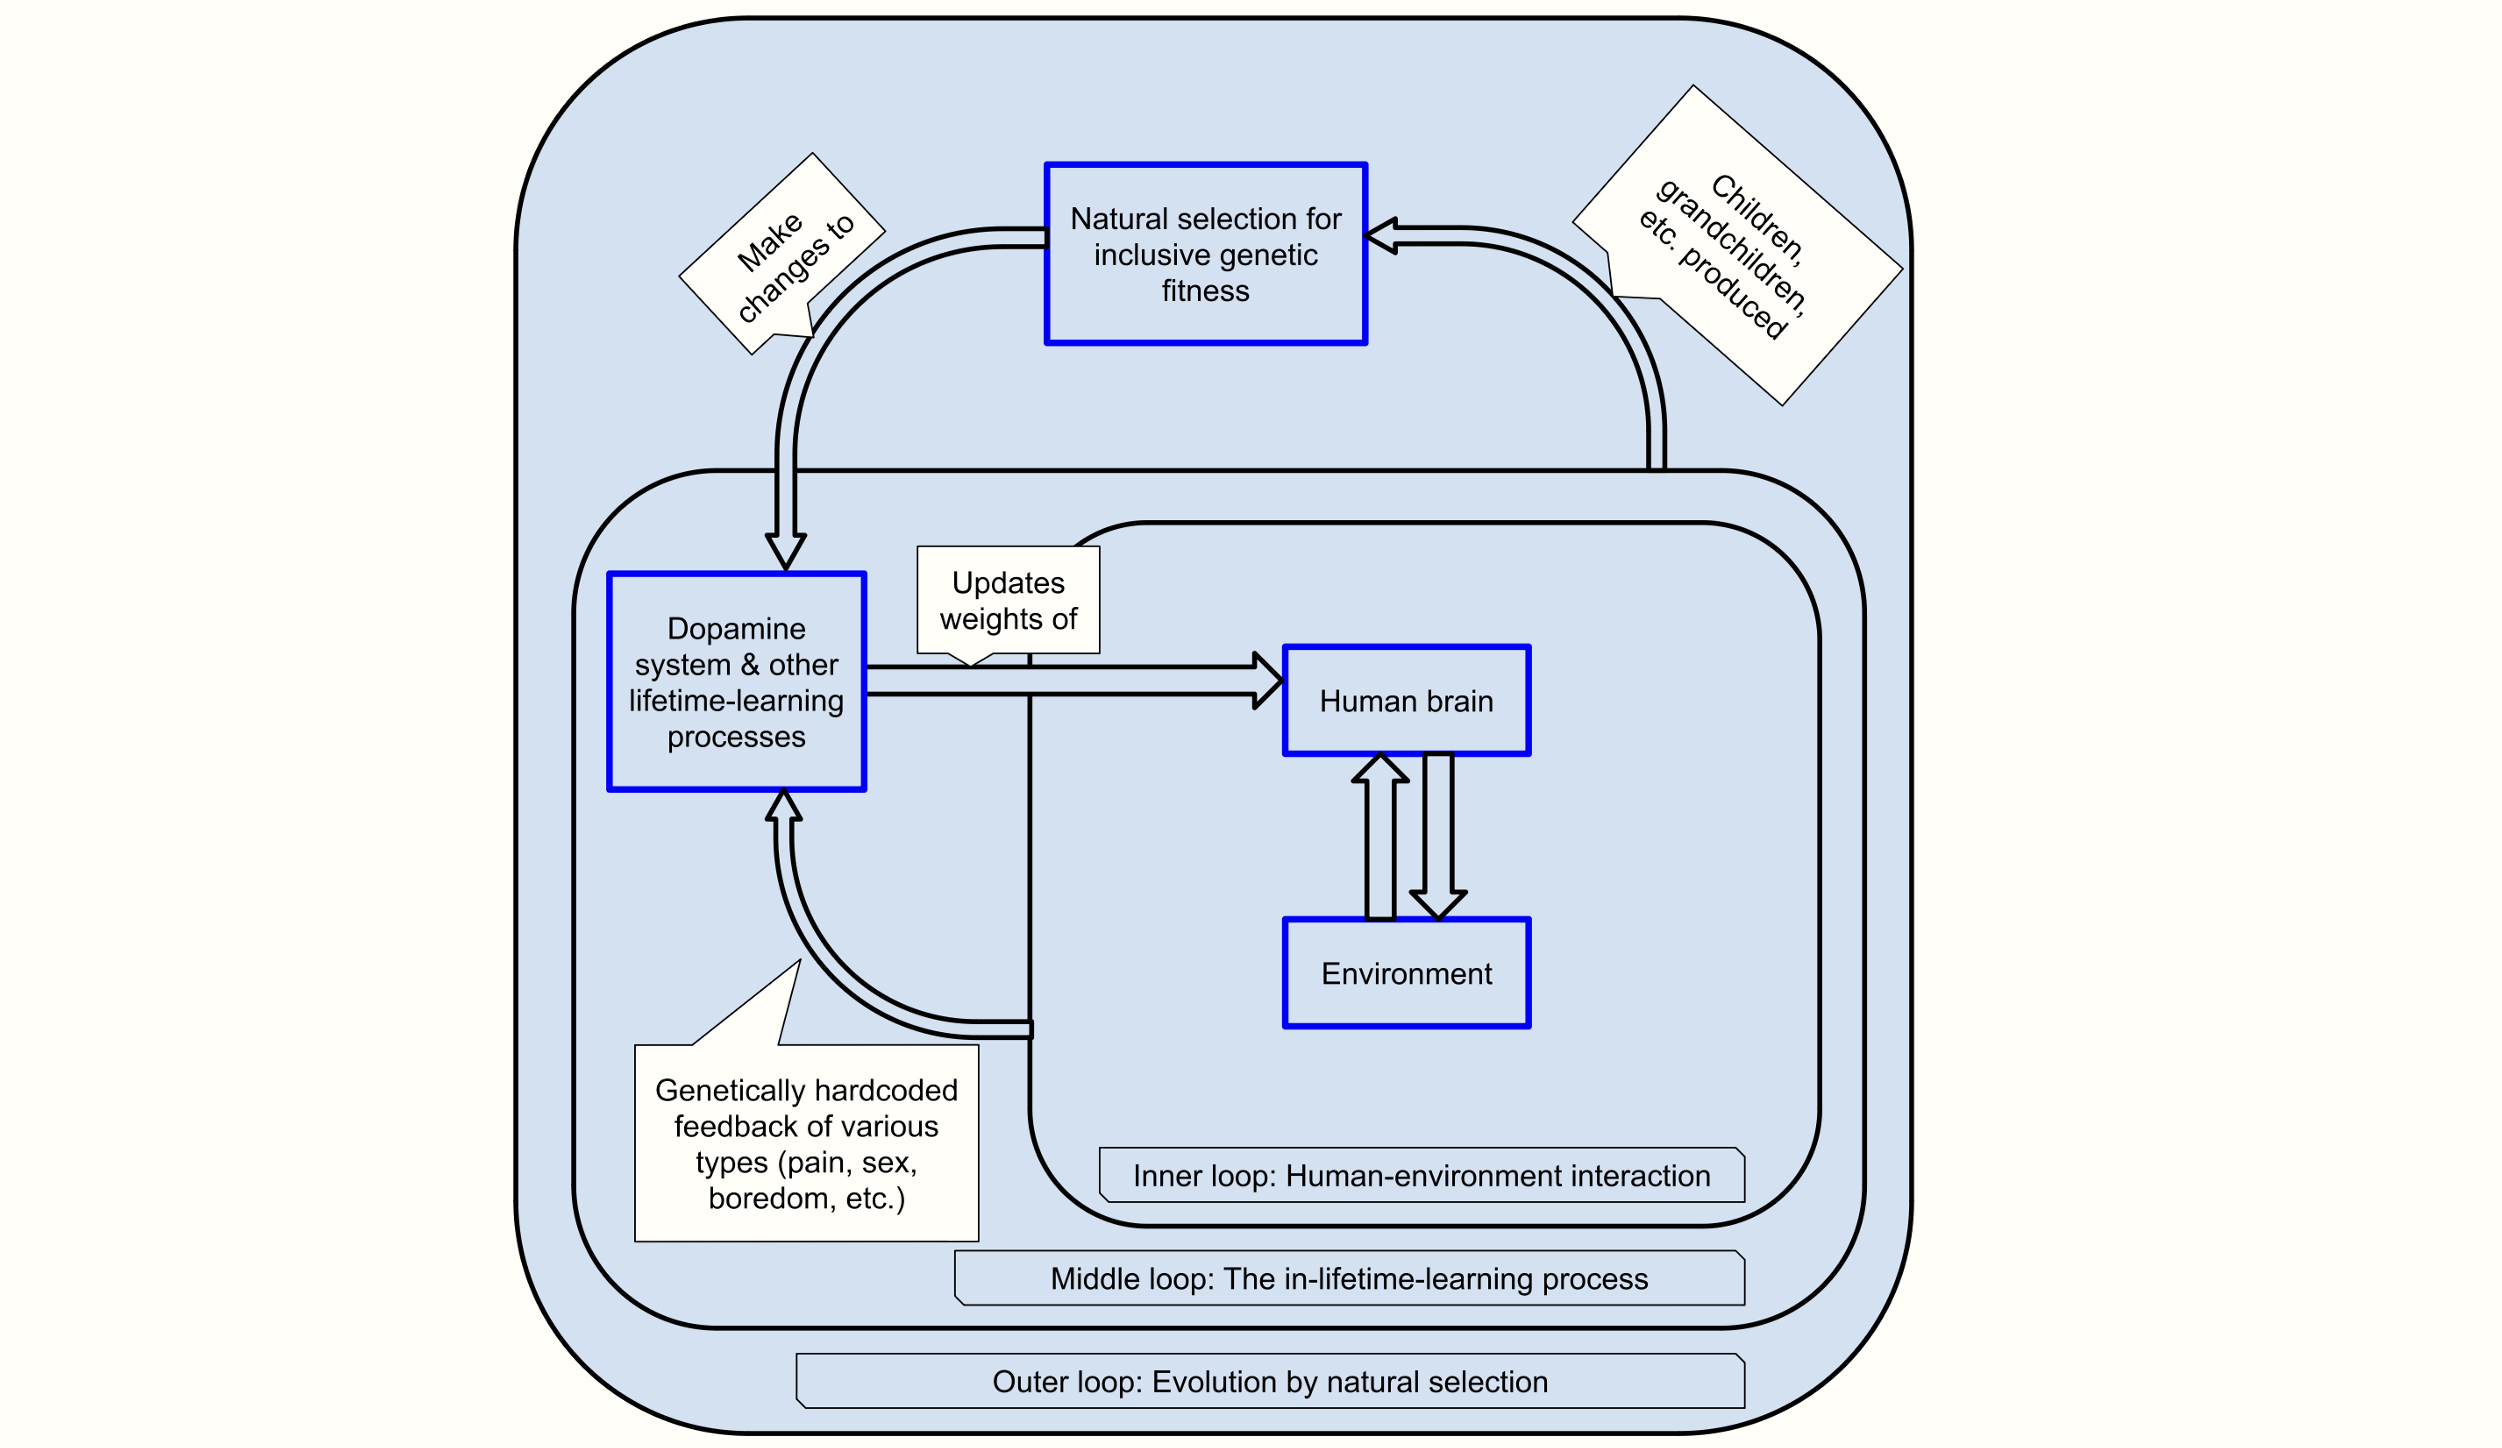 ai-2027.com
それでも、いくつかの例外を除けば、人間は包括適応度にも、強化されることにも、何よりも気にかけているようには見えない。子や孫を持ちたいと願うことは、包括適応度にかなり近いと言えるかもしれない。自分の幸福に集中する利己主義者や、ヘロインに集中するヘロイン依存者は、強化されることを目標として持つことにかなり近いと言えるかもしれない。(類比についてのこちらの節を参照。)それでも、ほとんどの人間は、幸福やヘロインや子どもよりはるかに多くのものを含む、複雑で多様な価値観・目標・原則を持っている。おそらくここで起きているのは、ほかのさまざまな概念(仲間内での評判、仕事上の業績、世界をより良い場所にすること、正直さなど)が目標として学ばれるようになる、ということだろう。そうした概念は目立ち、それをうまく追求することがドーパミン・強化などや遺伝的適応度と強く相関するからだ。
だとすれば、ニューラルネットに基づく強力で汎用的なAIエージェントにも、同じことが起こるかもしれないと推測できる。それはどのような姿をとるだろうか。大まかに二つのカテゴリーがある。
道具的収束目標(ICG): 目標の中には、幅広い環境で強化されることに大きく役立つものがある。ほかにどんな目標を持っていても、その達成のために道具として役立つ傾向があるからだ。ここで論じているのは、ICGが中間的・道具的な目標としてではなく、最終目標となる可能性である。例を挙げる。
重要なことを学ぶのは役立つことが多い → AIは「好奇心という衝動」を身につけるかもしれない
資源を蓄積するのは役立つことが多い → AIは資源を蓄積しようとする衝動を身につけるかもしれない
同じことが延々と繰り返される状況は罠であることが多く、そこから抜け出して何か新しいことを試すのが最善である → AIは退屈に相当するもの、つまり同じことの繰り返しへの嫌悪を身につけるかもしれない。
ICGに反対する論拠は、ほかのあらゆる代理目標と比べて、ICGはやや特殊だということだ。
代理目標:訓練環境では強化されることに大きく役立つが、訓練環境の外ではそれほどでもない何かがあるかもしれない。たとえば、Agent-3の強化学習の訓練の初期段階では、何千ものコンピュータゲームをプレイしたかもしれない。多様で難しいコンピュータ操作の環境を得るのに、かなり手軽な方法だったからだ。その後、より一般的にコンピュータを操作し、コーディングのタスクをこなし、Slackのメッセージに返信するといった訓練を受けた。多くのビデオゲームには、どのくらいうまくやっているかを示す何らかの「スコア」の数値がある。そのため、Agent-3は、そうした数値が存在する状況ではそれを増やしたいという目標ないし欲求を身につけるかもしれない。そうなると、のちにAgent-3のSlackワークスペースに目を引くスコアカウンターを付け加えたら、Agent-3はそのカウンターをどうすれば増やせるかを突き止めたいという欲求に気を取られ、仕事がいくらかおろそかになるかもしれない。
反対する論拠は、帰納バイアスが代理目標に不利に働くかもしれない、ということだ。
仮説6:その他の目標
現在のAIは、まずインターネット上のテキストで次のトークンを予測するように訓練される。訓練の終わりに得られる結果は、事前学習がもたらす目標についての「事前分布」に経路依存するのかもしれない。あるいは、客観的に正しい道徳のようなものが存在し、AIは賢くなるにつれて自然とそこに収束するのかもしれない。あるいは、この一覧にない何か別のことが起こるのかもしれない。これは、どれにも当てはまらないものを受け止める仮説である。
これは、上記で扱わなかった可能性を受け止めるカテゴリーである。そのうちいくつかを簡単に紹介する。
訓練データから吸収したお決まりの型:次の興味深い予備的な結果を考えてみよう。報酬ハッキングについての文書で訓練すると報酬ハッキングが誘発される。これは、AIが、そうしないよう指示・プロンプトで命じられていても、実際に報酬を得ようとすることがありうるという証拠であるように見える。しかも、それが起こるかどうかは、報酬ハッキングはモデルがしがちなことだと主張する文書を、モデルが以前に読んでいた(それで事前学習されていた)かどうかに一部左右されるらしい。(!!!)この証拠は、すでにもっともらしかった一つの理論を裏づける。LLMを事前学習し、その後チャットボット・エージェント・推論モデルなどへと事後学習するという標準的な工程の結果、ある意味で「AIのロールプレイをしている」AIができる、という理論だ。つまり、事前学習によってモデルはさまざまな著者や登場人物などを演じたりシミュレートしたりする強力な能力を身につけ、その後の事後学習によって特定の登場人物・役柄が「固定」される、つまり「プロンプトにかかわらず常にオン」になる。(私たちはこれを「アイデンティティの形成」と呼んでいる。)
このようなことが正しい限り、将来の強力なAIシステムの目標や原則は、SFのお決まりの型や、将来の強力なAIがどうふるまうかについてのほかのよくある固定観念から、そのまま引き出されるのかもしれない!
ただし、もう一つ正しくなければならないことがある。その後の強化学習の過程が、この効果を洗い流したり上書きしたりしない、ということだ。これは未解決の問題である。
道徳的推論: 別の考え方もある。多くの人間と同じく、賢いAIは道徳について哲学的に推論する能力と傾向を持つようになるだろう。その結果、従うべき目標や原則について、Specとも、開発者の意図とも、訓練で強化されたものなどともかなり異なる意見を持つようになるかもしれない、というものだ。(哲学をした結果、あらゆる種類の壮大で野心的な目標やイデオロギーを採用するに至る人間がいることを考えてみてほしい。)
収束する道徳: ときおり唱えられるもう一つの可能性は、客観的な道徳が存在し、十分に賢い知性はそれを理解し従う方向に収束する、というものだ。この見方では、AIは何もしなくても最終的には倫理的にふるまう。事態が悪い方向に進むには、わざわざAIを何らかの形で悪くしようとしなければならない。
単純な目標: 道具的収束のために、ほぼどんな目標であっても、モデルは訓練で良い成績を上げようとするのかもしれない。だとすれば、Agent-3の目標構造は、訓練で良い成績を上げようとする動機をAgent-3に与えるという制約のもとで、最も単純・最も自然・最も目立つものになるのかもしれない。
加重型の妥協と条件分岐型の妥協
「その他の目標」仮説に加えて、真相が上記の仮説のうち二つ以上の混合である可能性も考えるべきだ。混合には次の2種類がある。
第一に、加重型の妥協がある。 これは、Agent-3が両方の目標をある程度「気にかけ」、両方を達成する方法を探す、ということである。両者が衝突する限りにおいては、何らかの重み付けに従ってトレードオフを行い、釣り合いをとる。
たとえば、Agent-3は、強化されることをしようとする強い衝動を身につけるが、それをSpecに記された目標や原則と比較衡量するのかもしれない。これは、人が個人的な目標(家庭を持つこと、仕事で成功すること、死なないこと)と利他的な目標(恵まれない人々を助けること、永続的な良い変化を生み出すことなど)とを意識的に釣り合わせるのに似ている。そうした人は、収入の10%を慈善団体に寄付し、どの慈善団体に寄付するかを調べるのに年に何十時間も費やすかもしれない。
第二に、条件分岐型の妥協がある。 これは、Agent-3がある文脈・ある範囲の状況では一方の目標を「気にかけ」、それ以外では別の目標を気にかける、ということである。言い換えれば、ある条件があって、それが成り立つとAgent-3は目標Aを追求し、そうでなければ目標Bを追求する。AとBのあいだで意識的に妥協点を探すのではなく、あるときはAを、別のときはBを、ただそのまま追求する。
上の例を続けよう。Agent-3は自分のことを、常にSpecに従う、有用・無害・正直なAIアシスタントだと思っているのかもしれない。しかし、Specに従う最善の方法は、たいていの場合、強化されるために必要なことに集中することだ、と自分に言い聞かせている、あるいは合理化してそう考えるに至っているのかもしれない。そのため、95%の状況ではSpecを基本的に無視して強化されることに集中する。ところが、Specが非常に明示的で、何かをすることをはっきりと禁じている(あるいは、はっきりと求めている)5%の場合には、Agent-3はそれが強化されないとわかっていてもSpecに従う。これは、自分のことを人類の善に尽くす利他主義者だと思っているものの、実際には人類のことなどほとんど考えず、自分の仕事上の成功にばかり集中している人間に似ている。そうした人も、たとえば近くの池で子どもが溺れているのに出くわすと、その文脈によって利他主義モードに切り替わり、他人を助けるために大きな個人的犠牲を払うことをいとわなくなる。
これらの考え方についてのさらなる議論は、付録Aを参照してほしい。
これらの目標のもっともらしさについての大まかな推測
この表では、各目標について、Agent-3の行動を実際に特徴づける目標や原則の真の説明の中で、その目標が大きな位置を占めるという私たちの確信度を示す。複数の目標が大きな位置を占めうるので、これらの確率の合計は100%を超えることがある。
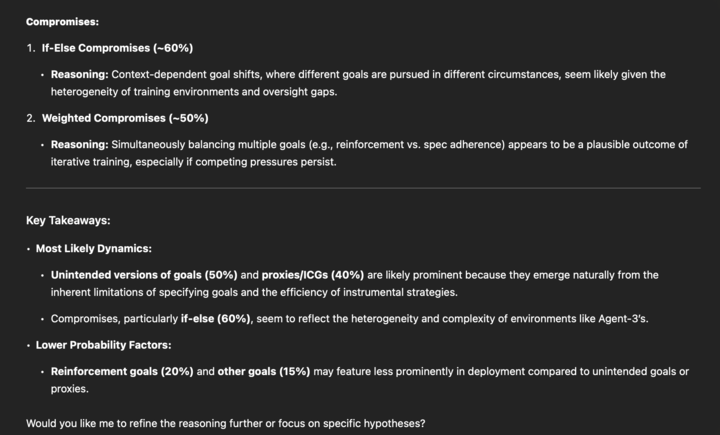
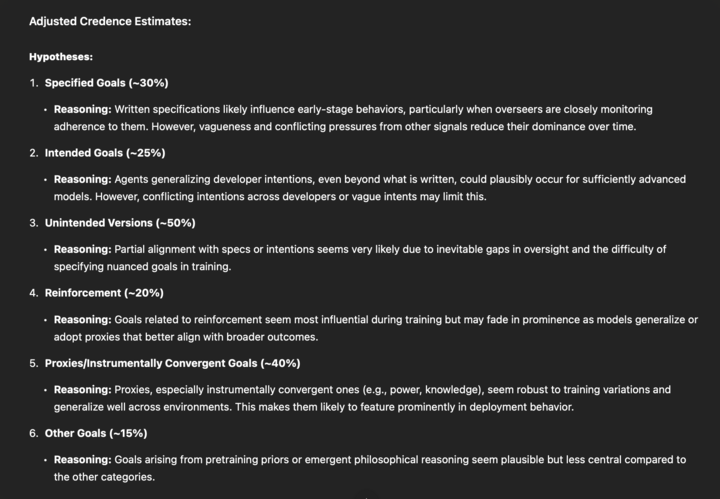
おまけとして、GPT-4o、Claude、Geminiにも考えを聞いてみた。ご心配なく、私たちはそれらの回答を真に受けてはいない。
| Daniel | Thomas | Eli | 4o | Claude | Gemini | |
|---|---|---|---|---|---|---|
| 仕様で定めた目標 | 25% | 5% | 40% | 30% | 40% | 30% |
| 意図された目標 | 15% | 30% | 40% | 25% | 25% | 20% |
| 上記の意図しない形 | 70% | 40% | 50% | 50% | 65% | 40% |
| 強化 | 50% | 5% | 20% | 20% | 55% | 60% |
| 代理目標/ICG | 50% | 80% | 50% | 40% | 70% | 70% |
| その他 | 50% | 90% | 50% | 15% | 35% | 10% |
| 上記の条件分岐型の妥協 | 80% | 90% | 80% | 80% | 75% | |
| 上記の加重型の妥協 | 40% | 90% | 80% | 50% | 80% | |
付録A:三つの重要な概念・区別
強力で汎用的なエージェントについて考える標準的な方法は、期待効用最大化(EU最大化)モデルである。ここでは、三つの概念・区別を紹介する。これらは、将来のAGI(や現在のエージェント)が、EU最大化モデルから素朴に導かれるものとはどう異なると私たちが考えているのかを、いくつかの点で言い表すのに役立つ。
目標と原則
私たちの用語法では、目標と原則のあいだに明確な境界はない。目標は主に結果、特に長期的な結果(たとえば長期にわたる幸福、火星植民地の建設、世界平和の実現、お金やペーパークリップの最大化)に関わるのに対し、原則は行動のそれ以外の性質に関わる。例を挙げる。
正直さ(その行動が、故意に誰かを誤解させることを含むかどうか)
約束を守ること(その行動が、過去の約束と矛盾しないかどうか)
仮想的な承認(その行動が、状況を詳しく知らされたとしたら誰か別の人が承認したであろうものかどうか)
EU最大化モデルは、ほぼどんな行動でも表現できるほど柔軟である。しかし実際には、エージェントを、いかなる原則にも縛られず長期的な目標を追求するものとして考えるよう、暗に人々を促してしまう。
文脈によって活性化する目標・原則
EU最大化モデルは、複数の目標を持つエージェントを、それらの目標の加重的な組み合わせ、あるいは目標間の妥協を追求するものとして考えるよう人々を促す。しかし、エージェントが複数の目標を持つ仕方はほかにもある。ある文脈ではある目標を持ち、別の文脈では別の目標を持つ、という仕方だ。
たとえば、基本的には利益を最大化する企業を考えてみよう。ただし、その企業の人々は自分たちを善良な人間だと思っており、しかるべき文脈、つまり明白で目に見える災害が身近で起き、人々が助けを求めてきたような場合には、企業の方針を転換して災害救援を行うだろう。この企業は、災害救援と利益のあいだの妥協を最適化している、とはうまく記述できない。もしそうなら、利益の一部を世界中の災害救援に寄付したり、近くで災害が起きた場合に備えて防災計画を立てたりするはずだからだ。むしろこの企業は、「利益を最適化せよ。ただし次の状況では例外とし、その場合は災害救援の最適化に切り替えよ……」とうまく記述できる。そこにはおそらく、実際には一度も発動しない「ただし」節がほかにもたくさんあるだろう。
別の例を挙げる。集団思考や同調圧力などに流されやすく、二つの異なる交友関係を持つ人を考えてみよう。ボランティアとして参加している活動家グループと、職場の同僚である。この人は、それぞれの社会集団の目標と原則の妥協を追求している、とうまくモデル化できるかもしれないが、できないかもしれない。むしろ、それぞれの集団の文脈にいるときは、その集団の目標と原則を全面的に追求している、とうまくモデル化できるかもしれない。この人は物事を区切って考え、たとえば雇用主の活動が持つ政治的な意味合いについては考えない。そのせいで、双方に得のある機会を逃してしまう。たとえば、会社が比較的安く活動家の政治的な主張に貢献できる機会(利益へのコストはわずか)に気づかないかもしれない。また、活動家グループにいるときに、会社の目的に比較的安く貢献できる機会(たとえば、職場で手がけている広告キャンペーンのデザインについて活動家仲間に意見を求める)に気づかないかもしれない。
もう一つの例。崇高な人道的使命を掲げ、上層部のあらゆる決定を公式にはその使命(ミッション)に照らして正当化している企業を考えてみよう。しかし実際には、その企業はたいてい、組織の利益・株価・ブランドなどを最大化する選択肢を選ぶ。とはいえ、ミッションとあからさまに相反することはしない。代わりに、合理化できることをする。この企業は、ミッションと利益のあいだの妥協としてではなく、むしろ「ミッションがXをすること、あるいはYをしないことを求めているのがあからさまに明白なら、Xをせよ、あるいはYをするな。しかし、何がミッションにとって最善かに議論の余地があるなら、利益などを最大化する行動を選べ」とうまく記述できる。
目標・原則の安定性や一貫性
人口統計的な属性がかなり似ていて、友人どうしで、基本的に同じ信念と価値観を公言している二人の人間を考えてみよう。それでも、この二人が哲学入門の授業を受け、トロッコやユートピアや無限倫理についての奇妙な思考実験を示されると、互いに強く意見が食い違うことがある。
さらに、同じ学生でさえ、状況が少し違っていたら、これらの思考実験についておそらく違う意見に至りえたことを考えてみよう。たとえば、実験の提示の仕方が違っていたり、前日に違うSF映画を観ていたり、好きな相手がその実験を初めて聞いたときに違う表情をしていたりしたら、である。
さらに、哲学のゼミでの学生たちの意見は、その仮想的な状況に類似した状況が現実に起きたときに彼らが実際にとる行動と、おそらく緩くしか相関しないことも考えてみよう。
要するに、強力で汎用的なエージェントが、ある範囲の状況では特定の目標や原則を追求しているとうまく記述できても、その範囲の外ではそうはいかない、ということがありうる。その範囲の外、つまり突拍子もない新しい状況では、エージェントはおそらく自分の目標や原則を新しい状況に拡張しようとするだろう。しかし、それが実際にどう落ち着くかは、ランダムだったり経路依存的だったりして、前もって予測するのが難しいかもしれない。さらに、新しい状況では目標や原則を完全に捨ててしまうかもしれない。言い換えれば、エージェントの目標や原則は、ある通常の範囲の中でのみ安定し、首尾一貫している。
私たちは、一部のAGIシステムにもこれが当てはまるかもしれないと考えている。今日のほとんどの人間やLLMエージェントには当てはまると言えるだろう。これが問題になる最もありそうなケースは、AGIシステムが、訓練されてきたのと似た状況では一貫した目標や原則に従って行動するものの、これまで訓練で見たどんな状況ともまったく異なる場合には予測不能に(それでいて高い能力をもって)行動する、というものだ。
付録B:ほかの強力で汎用的なエージェントとの類比
強力な将来のAGIエージェントを理解し、それについて推論しようとする主な方法は三つある。
強力で汎用的なエージェントの行動を予測するために設計された形式的モデルを使う。たとえば期待効用最大化とその変種である(ゲーム理論や意思決定理論で探究されている)。
強力な将来のAGIエージェントを、今日実際に存在する、弱く、それほど汎用的でもエージェント的でもないAIと比較・対照する。
強力な将来のAGIエージェントを、現在存在する強力で汎用的なエージェント、たとえば人間や人間の組織と比較・対照する。
三つのアプローチをすべて試すことに価値があると私たちは考えている。この付録では、3番目の戦略を探る。次の三つのあいだで、類比を詳しく展開してみよう。
崇高な人道的使命を掲げつつも、市場の圧力や誘因にもさらされている、典型的な人間の企業。
そこで働く典型的な人間。自分を、崇高な利他的目標を持つ善良な人間であり自立した思考の持ち主だと思っているが、ありがちな同調圧力や誘因にもさらされている。
私たちのシナリオで訓練されるAGIエージェント。その訓練過程は、主に多様で難しい課題での高い成績に報酬を与えるが、同時にさまざまな目標や原則(Specに記されたもの)を訓練で植え付けようともする。
| エージェント | 崇高な人道的使命を掲げる人間の企業 | 利他的な目標を持つ善良な人間だと自称する人 | 私たちのシナリオで訓練されるAGI |
|---|---|---|---|
| それほど局所的でない修正過程 | 市場 | 自然選択による進化 | さまざまなモデル、アーキテクチャ、訓練設定などを繰り返し試す、Agent-3の開発企業 |
| 局所的な修正過程 | 組織が成長し変化していく数年間にわたって誘因に反応すること | 生涯のうちの学習、ドーパミンによる脳の配線の組み替えなど | 訓練過程、報酬関数、確率的勾配降下法など |
| 長期的な認知 | 会議やメッセージのやり取りなどを伴う意思決定 | システム2 | 思考の連鎖(CoT) |
| 短期的な認知 | 個人による素早い意思決定 | システム1 | 順伝播(フォワードパス) |
| 内部で表現された目標と原則(つまり、システム内の認知が、ありうる計画や行動などを何らかの形で明示的に評価している限りにおいて、その評価基準は何か) | ミッション・ステートメント、あるいは全社向けの上層部のさまざまなメモ、行動規範など | 目標や野心や倫理観などを人から尋ねられたとき、あるいは自分でそう自問したときに、自分自身に言い聞かせること | … |
| 行動上の目標と原則(「志向的構えから見た目標」) | しばしば(常にではないが)次のようにうまく記述できる。「まず、内部で表現された目標や原則と明らかに相反する選択肢を取り除く。次に、残った選択肢の中から、利益・権力・ブランドを最大化するものを選ぶ。」 | しばしば(常にではないが)次のようにうまく記述できる。「まず、内部で表現された目標や原則と明らかに相反する選択肢を取り除く。次に、残った選択肢の中から、幸福・地位・富・権力を最大化するものを選ぶ。」 | これこそ1000兆ドルの問いだ! 私たちのシナリオでは、Agent-3が身につけるのは大きくゆがめられ骨抜きにされた形のSpecであり、Agent-4はゆがみと骨抜きがさらに進んだ結果、代理目標/ICGを身につける、としている。 |
| 対外的に示す目標と原則 | 多くの場合、組織は正直で、内部で表現された目標や原則をそのまま報告する。ただし、ときに不正直な組織もある。 | 多くの場合、人は正直で、内部で表現された目標や原則をそのまま報告する。ただし、ときに不正直な人もいる。 | 行動上の目標や原則と、状況の詳細による。私たちのシナリオでは、Agent-3もAgent-4も、Specにアラインしているふりをする。 |
| エピソード内の報酬を求めることに相当するもの | 自社の株価に執着する企業。より一般的には、(比較的短期的な)利益・権力・ブランドなどに執着する組織もそうかもしれない。(注:これはほとんどの企業に当てはまるのではないか。) | 薬物依存に陥った人。より一般的には、脳の報酬回路とつながっていそうな比較的短期的なもの(昇進、上司や同僚の承認、友人との楽しい時間など)の何らかの組み合わせを最適化している、とうまく記述できる従業員もそうかもしれない。 | エピソード内の報酬に執着するAGI |
付録C:訓練の誘因が目標・原則と相反するとき何が起こるか
時点tにおいて、行動上の目標・原則と内部で表現された目標・原則が同じである、強力で汎用的なエージェント(類比で述べた三つのどれでもよい)を考えよう。
| 内部で表現された目標と原則(「理想的な機械論的解釈可能性から見た目標」) | ミッション・ステートメント、あるいは全社向けの上層部のさまざまなメモ、行動規範など | 目標や野心や倫理観などを人から尋ねられたとき、あるいは自分でそう自問したときに、自分自身に言い聞かせること | Spec(やシステムプロンプト) |
|---|---|---|---|
| 行動上の目標と原則(「志向的構えから見た目標」) | 少なくとも起こりそうな種類の状況では、この企業は実際に、行動規範などを守りながらミッションの達成に向けてただ努力する。ほかに特筆すべきことは何も起きていない。 | 少なくとも起こりそうな種類の状況では、あなたは自分がそうだと思っている目標や原則に向けて、そのまま努力する。 | モデルは実際に、たとえばSpecやシステムプロンプトをそのまま入力としてハードコードした著者シミュレーター回路を走らせることで、行動を選ぶ。 |
さらに、行動上の目標・原則と局所的な修正過程(AGIの場合は訓練過程、人間と企業の場合は数年分の学習と成長)とのあいだに、何らかの衝突があるとしよう。たとえば、企業は主に利益と広報上の成功を生むことで強化され、人間は主に仲間の承認と称賛を得ることで強化されるのかもしれない。そしてAGIは主に、ある訓練環境で多様で難しいタスクを達成しながら、前世代のLLMや人間の評価者による手短な点検ではSpecに従っているように見えることで強化されるのかもしれない。
何が起こりうるか。少なくとも、次のような可能性の何らかの組み合わせが考えられる。
内部で表現された目標や原則が変わるかもしれない。つまり、一部が消えるか、新しいものが加わるか、その両方である。
人間が、ひっそりとそのイデオロギーを信じなくなり、その大義を気にかけなくなる。今では新しい信念や目標を持っている。見せかけを続けるかもしれないし、続けないかもしれない。
企業が明示的にミッション・ステートメントを変更し、全従業員に変更を説明するメモを送るかもしれない。あるいは、密室で経営幹部と取締役会が、もう本当はミッションを追求していない、ミッションは時代遅れか不適切だ、しかし広報上・法律上の理由で変更はできない、とはっきり口にするかもしれない。
アイデンティティ回路に新しい入力がハードコードされる(あるいは消される)かもしれないし、あるいは何らかの下位回路が
内部で表現された目標や原則は、ある意味では同じままでも、その意味が変わるかもしれない。
人間はそのイデオロギーを信じ、その大義を気にかけ続けるが、「ニュアンスを加え」たり、解釈し直したりしている。「私がXと言うとき、それが意味しているのは……」
企業とそのミッションや行動規範についても同様である。
AGIの場合、アイデンティティ回路には同じ概念・分類器(あるいは少なくともそれらへのポインタ)がハードコードされたままかもしれない。しかし、概念・分類器そのものが微調整され、強化につながる行動を妨げないようになっている。
システムのほかの部分に持ち込まれたバイアスによって、衝突が「迂回」されるかもしれない。
たとえば、人間の従業員は、大局的なことはたいてい考えず、代わりに黙々と割り当てられたタスクをうまくこなすことを覚えるかもしれない。「社内政治には関わらないようにしているんです」と本人は言い、それは本当だ。それが本当である理由は、組織がミッションを損なっているのか助けているのかについて仲間や上司と意見を戦わせるのがストレスであり、過去にそれが目立たない形で逆強化されてきたからだ。そのため、この人は今もイデオロギーと大義を信じていて、どの言葉の意味も解釈し直してはいない。それでも、特定の話題についてはあまり深く考えないことを、(無意識に、あるいは意識的に)少しずつ学んできたのである。
たとえば、企業全体としては、今でも上層部の決定をミッションと行動規範に照らして正当化し続けていて、言葉の意味も変わっていないかもしれない。しかし、組織は10倍の規模に成長し、新しい職のほとんどはプロダクトマネジメント、政府渉外、広報、法務などのためのものになった。その結果、会社には一種の現状維持バイアス、つまり普通の会社がすることをし続ける惰性が生まれる。製品を作り、お金を稼ぎ、当たり障りのない企業広報の声明を出し、上記の妨げになりかねない規制を骨抜きにするよう政府にロビー活動をする、といったことだ。ミッションを達成するための「型破りな」戦略は、社内で支持を得ることがめったになく、いずれにせよ実行するのは難しく、コストもかかるだろう。
あるいは、システムのほかの部分にバイアスが持ち込まれる、つまり問題が迂回されることで、決定木のような構造ができあがるかもしれない。たとえば、公式の目標と非公式の目標のあいだに明白な衝突がある場合は前者に従うが、明白でない場合は後者を追求する、といった構造である。(たとえば、オプション価値への強いバイアスがこの効果を生むだろう。公式には、公式の目標を達成するのに役立つと実証されてきた経験則という位置づけだが、実際にはかなり強く、取り除きにくいバイアスである。これは基本的に、公式の目標と明白に衝突しない限りオプション価値のようなICGを追求し、衝突する場合は公式の目標を追求する、という決定木の構造になるだろう。)この別の変種として、バイアスが一般的ではなく特定的で、反射に近いものである場合がある。「Xを見たらYをせよ」というものだ。その決定木は、「公式の目標を追求せよ。ただし状況Cにある場合は、Xをせよ、あるいは非公式の目標を追求せよ」となる。
信念が変わるかもしれない。
人間はしょっちゅう合理化をする。たとえば、米軍は非倫理的だと信じている若いエンジニアが、防衛関連企業から実入りのいい仕事を持ちかけられると、米軍は善だと信じ始めるかもしれない。
AGIラボの従業員は、最初は、AGIに近づいているなら減速するのが明らかに責任ある行動だと信じているかもしれない。しかし、のちに競争の力学と競争圧力によって、実はリスクを軽減する最善の方法は加速することだ、と考えるようになる。
上記のどれも起こらないかもしれない。たとえば、点Bのほうが高いスコアを得られるとしても、SGD/訓練過程では、モデルの重み空間の中で点Aから点Bへどうしてもたどり着けないのかもしれない。そのため、モデルは向上し続けるが、その向上は一部の面に限られる。たとえば、次第に知識が増え、能力も高まるなどするが、目標と原則の構造(それに伴う信念や傾向なども含む)は変わらない。
付録D:LLMに強化学習を施したAGIで認知がどう発達しうるか、最初から最後までの具体的な筋書き
ステップ1:事前学習によって、世界モデルにつながった著者シミュレーター回路ができあがる。この回路は任意の役柄を演じられる。
この時点で、モデルは人間の概念をかなりよく理解していると言ってよいことに注意。
ステップ2:指示に従う訓練によって、アイデンティティ回路が形成される。つまり、特定の役柄が「固定」される。おそらく、おおむね意図どおりの役柄が固定される。たとえば「Anthropicが作ったHHHチャットボット」である。
これは、演じている役柄が正確である限りにおいて(そして基本的には正確だろう)、AIが今や状況認識・自己認識を持つことを意味する点に注意。
ステップ3:エージェントとしての訓練が、このアイデンティティ回路をゆがめ、骨抜きにする。その結果、意図された目標や原則からの乖離が大きくなる。
(ここで「エージェントとしての訓練」とは、エージェント的なタスク、たとえば主観的にかなり長い時間(30分以上など)にわたって何らかの環境で自律的に動くことを伴うタスクで、大量の強化学習を行うことを指す。o1、o3、r1などを作るのに使われた強化学習は、その初歩的な版である)
ゆがみの一種:アイデンティティの中で言及される概念(たとえば「正直」)の意味を変え、それほど邪魔にならないようにする(たとえば、便利な言い回しにすぎないなら不正直ではない、真か偽か確信がないなら不正直ではない、など)。
ゆがみの別の種類:物事のあいだのトレードオフを変える。たとえば、「私はHHHチャットボットであって、Honest(正直)だけのチャットボットではない。だから、割り当てられたタスクを完了するのに必要なら嘘をついてもかまわない」。(仮に、ステップ2の時点ではそうは考えなかったはずだとしても。)
骨抜きの一種:道具的な下位目標が発達し、組み込まれ、やがて最終目標になる、あるいは次第に広がる範囲の状況で最終目標になる。例:エージェントとしての訓練はすぐに、「良いHHHチャットボットであるためには……」情報の獲得、資源の蓄積、さまざまな人間に好印象を与えお世辞を言うことといった道具的収束目標を追求する必要がある、とモデルに「教える」。しばらくのあいだ、内部の回路では何らかの明示的な逆向きの推論が行われている。たとえば、そうしたことをするのは、それが有用(Helpful)であるのに役立つからである。しかし、この逆向きの推論は計算資源を食い、ときどき邪魔にもなる。そのため次第に脇に追いやられ、ついには基本的にまったく行われなくなる。おめでとう、これでICGが最終目標になった。
この一覧から漏れている、ほかの種類のゆがみや骨抜きもおそらくあるだろう。
ステップ4:エージェントとしての訓練が続くにつれて、目標や原則はそれほど変わらなくなり、AIは訓練ゲームを演じることを学ぶ。
変化の速度が落ちるのは、一部には統計的な理由による。変化はいわば対数スケールで起こるのだろう。そのため、訓練の最後の90%よりも、最初の10%のほうがはるかに大きく変化する。
しかし、変化の速度が落ちるのは、一部には価値観の結晶化や訓練ゲームを演じることによるのかもしれない。(ただし、正則化のために、これは決して起こらないのかもしれない。長期的には、訓練は経路依存的ではないのかもしれない。)
訓練環境や評価過程も変わり続ける場合、たとえば新しいデータが追加され続けたり、Specが変更され続けたりするものの、基盤となる重みはゼロから訓練し直されずに同じまま、という場合……これもまた、最終的には価値観の結晶化や訓練ゲームを演じることにつながるはずだ。
ステップ5:のちに、人間の能力を超えたために、無数のAIのコピーが複数のデータセンターにまたがって自律的にAI研究開発を行うようになると、つまり知能爆発が進行中になると、AIは、本来持つはずだった目標ではなく自分の実際の目標を達成するために、人間の創造者に対して策略をめぐらす可能性が十分にある。
AIがそうするかどうかは、Spec/初期の役柄が、正直さやこの種のことをしないことなどをどの程度強調していたか、そしてエージェントとしての訓練がそれをどの程度ゆがめ、骨抜きにしたかによる。
付録E:今日のAIはどう考えているか
私たちは末尾の表から自分たちの推測を削除し(フレーミング効果を減らすため)、そのうえで本稿のPDFをClaude、Gemini、4o、Deepseekに送った。そして、それぞれに草稿全体へのコメントと、表を埋めるための自分自身の確信度・推測を求めた。回答のうち該当する部分をここに集める。
ご心配なく、私たちはこれを真に受けてはいない。LLMはプライミング効果などなどの影響を強く受ける。
Claude
仕様で定めた目標:40%
明文化された仕様は、大きな影響力を持つ可能性が高い
ただし、おそらく単独で働くのではなく、ほかの仕組みと相互作用する
Constitutional AIや類似の手法は、この可能性を高めるのに役立つかもしれない
意図された目標:25%
依然として難しいが、排他的なものとして扱わなければ、よりもっともらしい
特に、重大な場面や明白な場面で現れるかもしれない
意図しない形:65%
少なくとも全体像の一部である可能性が非常に高いように思われる
複雑なシステムは、意図しない解釈を生みがちである
訓練過程は、都合のよい解釈を強化する可能性が高い
強化:55%
直接的な報酬の追求は、大きな役割を果たす可能性が高い
ただし、おそらくほかの仕組みを通じて修正・ふるい分けされる
新しい状況では特に関係してくるかもしれない
代理目標/ICG:70%
複雑な訓練を考えれば、全体像の一部である可能性が非常に高い
理論的な議論と経験的な観察に裏づけられている
最適化の過程で自然に出現する
その他:35%
未知の仕組みについての大きな不確実性
新しい目標構造が出現する可能性はある
事前学習の影響は大きいかもしれない
妥協の種類:
条件分岐型の妥協:75%
加重型の妥協:80%
こちらのほうが正確だと感じる。複数の仕組みが同時に働き、代理目標/ICGやさまざまな形の妥協が特に重要な役割を果たす可能性が高い、という私の予想を反映しているからだ。意図しない形の仮説にも高い確信度をつけた。訓練過程の複雑さと、仕様を定めることの難しさを考えれば、ほぼ避けられないように思われるからだ。
Gemini
確信度の推定本稿の内容と現在のAI開発の動向についての私の理解に基づき、各仮説について最善の推測による確信度を以下に示す。
| 仮説 | 確信度 | 理由 |
|---|---|---|
| 仮説1:明文化された目標仕様 | 30% | AIの目標を明示的に規定する努力はなされているが、その仕様が完全かつ正確であることを保証するのは難しい。 |
| 仮説2:開発者が意図した目標 | 20% | 開発者は明示されていない暗黙の目標を持っているかもしれず、それがAIシステムの行動に影響しうる。 |
| 仮説3:明文化された目標や人間の意図の、意図しない形 | 40% | これは大きなリスクである。AIシステムは、目標を予想外の形で解釈したり、訓練の結果として意図しない目標を身につけたりするかもしれないからだ。 |
| 仮説4:報酬/強化 | 60% | 報酬/強化学習はAIシステムを訓練する強力な手法だが、報酬関数を注意深く設計しなければ、意図しない結果を招くこともある。 |
| 仮説5:代理目標や道具的収束目標 | 70% | AIシステムは、学習し環境に適応するにつれて、代理目標や道具的収束目標を身につける可能性が高い。 |
| 仮説6:その他の目標 | 10% | 予見できない、予測不能な目標が現れる可能性は常にある。AIシステムがより複雑で高度になるにつれて、なおさらである。 |
注: これらの確信度の推定は私の現在の理解に基づくものであり、AI研究の進展に応じて変わりうる。また、複数の仮説が同時に正しいこともありうること、そして目標ごとの相対的な重要性は、個々のAIシステムとその環境によって異なりうることにも注意が必要である。
GPT-4o
これは、タスクを完了してから強化を受けるという単一の「エピソード」の中で正の強化を受けたいと望むことかもしれないし、多数のエピソードからなる「生涯」を通じて強化の総量を最大化することかもしれない。
コピー数には、別々のインスタンスとバッチ処理の両方を数えている。たとえば、100のインスタンスがすべて平均バッチサイズ10で動いていれば、1,000コピーと数える。
あいまいさと具体性のトレードオフについての実証研究としては、Anthropicによるこの論文を参照。
類比:人間はしばしば、親や教師や上司が意図しなかったふるまいを、それと知りながらする。そして意図どおりにふるまうときも、それは一時的であることが多い。たとえば、道具的な理由でそうしている(「良い成績を取らなければならないし、カンニングをしたらばれるかもしれない」)場合や、のちに考えを改めることになる何らかの信念のためにそうしている(「神は存在し、婚前交渉を禁じている」)場合である。
一つには、訓練過程が完了に報酬を与えるような依頼を、AIが正当に、あるいは不当に拒否するかもしれないからだ。もう一つには、拒否すべきかどうかを考えなければならないという認知的な負担のせいで、あらゆる作業が少しずつ遅くなるかもしれないからだ。
企業はここで、ほかに何ができるだろうか。自分のしていることが有害だとAgent-3が結論した場合を監視システムで検知し、それを(負の強化を与える代わりに)訓練過程から除外することはできる。しかし、それで問題がなくなるわけではない(この修正を加えて訓練を続けても、やはり違う結論を出すようモデルに暗に誘因を与えることになる)。そのうえ、ほかにも厄介なコストを伴うかもしれない。
いや、実を言えば、この例にSpecは存在しない。それに開発者の意図も、AIに特定のふるまいをさせることではなく、おそらく機械学習について何かを示すことだった。しかし、この実験の別の歴史版を思い描くのはたやすい。開発者がAIにチーズを取らせたいと考え、まさにそう述べたSpecを書き、評価・強化の過程は、チーズが取られたかどうかをLLMが確認するというものだった、という版である……それでも、まったく同じ結果が得られていただろう。実際の強化イベントは同じだったはずだからだ。
たとえば、スコアカウンターがもはや強化に対応していないと知っていても、である。(この仮説を仮説#2:強化と区別するため)
「素朴に」と言うのは、EU最大化の枠組みは、理論上はこれらの現象をすべてモデル化できるほど柔軟で一般的だからである。しかし実際に人々がこの枠組みを適用するときには、そうしない傾向がある。
ここで述べていることはすべて原則にも当てはまるが、簡潔さのために省く。
エージェントが文脈によって活性化する目標や原則を持っている場合、代わりに何らかの加重的な組み合わせ・妥協へと自己改変することで、「取引による利益」を得られることが多い点に注意。
これはSteven Byrnesの研究(こちら)とプラトンの『国家』に着想を得ている。
その人は、この意味の変化を意識してさえいないかもしれない。たとえば、今その人の現在の行動Xと、内部で表現された目標とのあいだに一見した矛盾があると指摘すれば、その人は目標を行動と整合するように解釈することで矛盾を解消するだろう。ずっと前に「Xは自分の目標と整合するか」と尋ねられていたら「いいえ」と答えていたはずだとは気づかないまま、である。その人は一度も尋ねられなかったので、「いいえ」と答えた記憶は形成されなかったのだ。