
AI企業は、あらゆる面で人間より賢いAIの開発を競っている。私たちは『AI 2027』で、その行き着く先は人類の絶滅か、後戻りできない権力集中のどちらかだと予測した1。
プランAは、そうならないために本来何が起きるべきかを描いた、私たちの前向きなビジョンだ。
このシナリオで人類は、超知能の開発を2040年まで遅らせ、AI研究をすべて公開し、世界の数十社が最先端に追いつけるようにし、計算資源の相互確証破壊という体制にあえて踏み込む。
プランAは、AIによる存亡の破局を人類が避け、繁栄する未来にたどり着くための、私たちの前向きなビジョンである。 米国の主要なフロンティアAI企業の専門家との対話、OpenAIでの実務経験、机上演習、そして政策立案者や国家安全保障の専門家、AI政策のリーダーとの議論をもとにしている。私たちが提言するのは、超知能をめぐる危険な開発競争を避けるための国際協定だ。協定の柱は、AI研究開発における研究の完全な透明性である。それによって世界各国は何が起きているかを把握し、歯止めを守らせることができる。その結果、複数の国の複数の企業が、秘密裏に競い合うのではなく、足並みをそろえてゆっくりと安全に超知能へとスケールしていく。
プランAは、主として予測ではなく提言である。 このシナリオは、未来が実際にどうなるかについての私たちの最善の推測ではない。政策提言を伝え、その強度を試すための手段だ。プランAが実施されること自体は提言であって、実際にそうなると予想しているわけではない。しかし、その後に描かれる影響は予測である2。
このAI 2040シナリオでは、プランAは不完全ながら、ぎりぎりのところで実施に成功する。
プランAの対照として、4つの代替案(B、C、D、S)も用意した。超知能という難題に米国がどう応じるか(あるいは応じないか)の主な道筋を、それぞれ描いたものだ3。
AI企業はおそらく、人間より賢いAIシステムを作るという公言どおりの目標を、今後1〜10年のうちに達成する。
業界は、超知能AIの制御など走りながら考えればよいと思い込んでいて、まともと呼べる計画をまるで持っていない。私たちはこの状況をひどいものだと考えているし、このままでは全員があっさり命を落としかねない4。「開発競争に勝った」者が大きなリードを得るとは思えないし、その勝者が存亡リスクを減らすために自ら減速するとも思えない5。この競争が続けば6、AIが超知能になったときに人間がそれを実効的に制御し続けられる見込みは薄い7。
さらに、AI企業がどうにかAIをアラインできたとしても、その結果は前例のない権力集中になる。ごく少数の人々、場合によってはたった一人が、世界で唯一の超知能の軍団を数か月にわたって事実上支配する。そして超知能たちは、今後どう進めるかについていくつもの選択肢を差し出す。その中には、事実上世界を乗っ取ることに等しいものも含まれる8。
私たちの推測する限り、OpenAI、Anthropic、xAI、Google DeepMindのCEOたちはこのことを理解したうえで、それでも突き進んでいる。自分たちはより小さな悪であり、習近平やライバルのCEOとは違って、この巨大な権力を責任をもって使うはずだと考えているのかもしれない9。
一般論として、より小さな悪を選ぶのが正しいという点には同意する。それでも、人類の絶滅や世界規模の独裁につながる確率がこれほど恐ろしく高い戦略を、私たちが支持すべきだとは思わない。私たちが訴えたいのは、本当に良いと言えるものだ。十分な数の人が同じように声を上げれば、それは実現しうる。
そこで、その実現しうる世界を描くシナリオを書いた。
「計画は無価値だが、計画することがすべてだ」――ドワイト・D・アイゼンハワー(Dwight D. Eisenhower)
AI政策の提案の多くは、シナリオによる精査にかけると崩れてしまう、と私たちは考えている。その提案が成功する詳細でもっともらしいシナリオを書き出そうとすると、それが意外に難しいことに気づく。そして、計画が思ったほどうまくいきそうにないことや、提唱者が認める以上に厄介な副作用があることが見えてくる。
AI政策の世界でシナリオによる精査がめったに行われないのは、そのせいかもしれない。誰もが、自分の推す政策は素晴らしい結果をもたらし、対立する陣営の政策はひどい結果をもたらすと言いたがる。自分の推す政策をシナリオで精査すれば、都合の悪い問題が浮かび上がりかねない。かといって、対立陣営の政策を精査するのは、手間がかかるわりに論戦で得るものが少ない10。
もっと多くのAI政策提案がシナリオによる精査にかけられれば、議論の質は上がるはずだ。だから私たちは、批判を招くのを承知のうえで、自分たちの提案から始める。批判する人には、AIへの移行を乗り切るための既存の計画のうち最良のもの(そんなものが見つかればの話だが)と比べて評価してほしい。誰も難しい選択を迫られないのに、たぶん万事うまくいく――そんな漠然とした心地よい空想と比べるのではなく。
超人的なAIに近づきつつある世界で、自分たちの政策がどんな効果をもつかを予測するのは途方もなく難しい。その点はどうなのか。これは第三次世界大戦の最善の戦い方を予測するようなもので、しかも過去の事例からの隔たりはそれ以上に大きい。それでも、試みる価値はある。米軍が台湾有事のシナリオを気の遠くなるほど細かく検討することに価値があるのと同じだ。ほかにも前例はある。情報機関、気候関連機関、パンデミック対策機関は、いずれもさまざまな形のシナリオ・プランニングに頼っている。
プランAは、何をすべきかについての私たちの野心的な提案だ。残された時間がどれだけあるのか分からない以上、これに近いものが早く実施されてほしいと願っている11。とはいえ、具体的なシナリオを書くには具体的なタイムラインが要る。
このシナリオのタイムラインは次のとおり。
2029年、米国と中国は、超知能をめぐる無謀な開発競争を避けることで合意する。
2030年、本来ならAI研究開発は完全に自動化されていたはずで、年末までに超知能に至っていた。協定のおかげで、それは避けられる。
2030年から2035年にかけて、人間の能力の範囲内で、人間のトップ専門家とほぼ同等の能力をもつAIまでスケールする。
2035年、人間による制御を保つため、人間のトップ専門家並みのAIの段階で一時停止する。
2040年、一時停止を解除し、超知能までスケールする12。(題名の「AI 2040」はここから来ている)
以前のシナリオ『AI 2027』では、2027年にAIが、より賢いAIを作る工程を完全に自動化し、知能爆発を経て、その年のうちに超知能が生まれた。このシナリオとの違いは2つある。(1)何も手を打たなかった場合のデフォルトのタイムラインが2030年になったこと、(2)ガバナンス上の措置によって、全般的に超人的なAIが初めて現れるのが2040年になったことだ。
デフォルトのタイムラインを変えたのは、一連のシナリオ全体に、AIのタイムラインをめぐる私たちの不確実性を反映させたいからだ。 『AI 2027』の題名の年を選んだのは、執筆を始めた時点で、ダニエル・ココタイロ(Daniel Kokotajlo)が、事態がそれほど速く、あるいはそれ以上に速く進む確率をおよそ50%と見ていたからだ13。プランAの執筆を始めた時点で、トーマス・ラーセン(Thomas Larsen)にとってそれに当たる年が2030年だった。ダニエルは現在、このシナリオで描いたよりもいくらか速く事態が進む可能性が高いと考えている。 タイムラインに関する私たちチームの見解は、こちらとこちらで詳しく読める。
ガバナンス上の措置を変えたのは、このシナリオが主として予測ではなく提言だからだ。 全速力で知能爆発を進めるのは常軌を逸した無謀であり、権力を極端なまでに集中させる。
米国には今、2つの労働力がある。1つは人間で、その数は1億6,500万人。もう1つはAIエージェントだ。何百万ものコピーが毎時間立ち上げられては停止され、昼夜を問わず超人的な速さで働いている。
その仕事の大半は粗悪な出力にすぎない。それでも使えるものが十分にあるので、人々は月に100億ドルを払っている。少なくとも理屈のうえでは、従業員がコンピューターでできることなら何でもこなせるAIに対してだ。
AI企業には、何よりも自動化したい仕事がある。自分たち自身の仕事だ。まだ成功してはおらず、今のところ再帰的自己改善は起きていない14。だが着実に近づいているようで、しかも自分たちが上ってきたはしごを引き上げ始めている。最強のコーディングAIは、競合他社のAI研究開発には手を貸さないのだ15。最も強気な社員でさえ、予定より少し時間がかかっていると認める。その一方で懐疑派は、いつもの一蹴の言葉が空々しく響き始めていることに気づいている。AIには自分の仕事が絶対にできないと言える理由は、正確には何だったか? 越えられない壁って、何だっけ?
連邦議会が関心を強め始めている。 議員たちは以前からAIの話を耳にしてきた。データセンターが水を使いすぎていること16、チャットボットが自殺をそそのかしたこと、MythosがNSAのシステムをハッキングしたこと。そしてもちろん、テック業界のロビイストたちの警告もある。少しでも規制の気配があれば、米国はたちまち中国との競争に負け、その後の歴史をずっと中国共産党の朝貢国として過ごすことになる、と17。
いま議員たちは一歩引いて問いかける。私たちはこれでどこへ向かっているのか? 5年後、10年後、15年後の世界はどうなっているのか? 仕事はまだあるのか? なかったらどうなるのか?
とりわけ重くのしかかる問いがある。これだけのAIを、誰が制御するのか?
議会はその答えの重要な一部に行き着く。おそらく、自分たちではない。18
議会はAIをめぐって緊迫した公聴会を重ねる。議員たちは、デミス・ハサビス(Demis Hassabis)が独裁者になるのを防ぐためにOpenAIを設立した経緯を論じた、2016年のOpenAIのメールを読む19。では、サム・アルトマン(Sam Altman)やイーロン・マスク(Elon Musk)が独裁者になるのは、誰が防ぐのか? 既存の答えに議会は納得しない。
この目覚めから生まれたのが「2027年AI透明性法」だ。多くのことを盛り込んだ包括法案で、良い点も悪い点もあるが、状況を根本から変えるものではない20。
2028年の選挙戦は、いつものように白熱している。最大の争点はAIだ。建設中のデータセンターの費用は、米国の軍事予算全体の2倍に達する23。
ホワイトカラーの職業の多くが、2026年にソフトウェアエンジニアリングが経験したような激変にさらされている。そうした仕事の中心は、今やAIエージェントの管理だ。AI企業は学習のプロセスを工業化した。経営陣が「今年は○○の分野に進出しよう」と言えば、会社はその職業の専門家に話を聞き、データを買い、学習環境を作り……と、AIが足場を築くまで続ける。するとAIは、その分野で広く使われて現実のデータを蓄積するにつれ、急速に改善していく。
ほかの国々は恐れと怒りを募らせ始めている。一握りの米中企業が、ホワイトカラーの仕事をすべて自動化しようとしているように見えるのだ。権力は米国に、なかでも大統領と一握りのテック企業CEOに集中しつつある。
AIの専門家たちは、知能爆発が近いと警告する。AIがAI研究を加速させればAIはさらに有能になり、研究はいっそう速まり、AIはさらに有能になる、という具合だ。この過程がどれだけ速く進み、どこで終わるかは、ボトルネックやハードウェアの限界をめぐる複雑な力学で決まる。だが、きわめて速く進み、とてつもなく遠いところまで行き着きそうに見える。
このまま進めば、次の大統領の任期中には、人間の水準をはるかに超えるAIが登場する。そのAIを作るのはすべてAIで、そのAIもまたすべて別のAIが作ったものであり、数世代前から人間はまったく関与していない。そうしたAIは従順で、アラインされているのか? なぜそう言えるのか? だとして、誰がそれを制御するのか? いったいどうすれば、これが良い結末を迎えるというのか?
人類をこの道に乗せたAI企業は、それで構わないと考えている。だが、ほとんどの人はそうは思わない。大統領は、自分のレガシーどころではなく、退任して世界が変貌したあと自分自身がどうなるかを考え始めている24。両候補はAIにどう対処するのかを繰り返し問われ、選挙運動のなかで、ますます大胆な案を試しに打ち出していく。議論は、以下に示すすべての選択肢のあいだを、さらにはそれ以外の案にまで揺れ動く。
最終的に、大統領とその後継と目される候補は一つの計画にまとまり、野党の候補は別の計画にまとまる。そして投票日を迎える。
「信頼せよ、されど検証せよ」――ロナルド・レーガン(Ronald Reagan)
大統領は、目前に迫った知能爆発を避けるため、米国が国際協力を追求すると発表する。
「超知能をめざすこの狂気の競争は、終わらせなければなりません。私たちはあまりに長いあいだ、よりましな悪や、最悪よりはましな解決策ばかりを追い求めてきました。私たちにはプランAが必要です。AI開発を続けることはできます。しかしそれは、より慎重に、より透明に、そしてはるかに多くの国と企業を巻き込んで進めなければなりません」
ワシントンの多くの人々が驚いたことに、中国は前向きな反応を示す。太平洋の向こう側でも、同じ問題――社会の不安定化、雇用の喪失、暴走する超知能――が議論されていたのだ。中国は「中国の世紀」の到来を心待ちにしており、AIがその構想を狂わせるかもしれないと考えていた。しかも中国には、交渉の席に着く理由がもう一つあった。米国は依然として計算資源もデータセンターも多く、モデルも優れている。米国が先に超知能に到達したら自分たちが何をされるか、中国は案じていたのだ48。
確信があるわけではないが、(以下で説明する)プランAのような協定は、中国を含むほぼすべての当事者にとって、加わるほうが得になる(誘因両立的な)ものだと私たちは見ている。その理由については、2029年と2030年の残りの部分を読んでほしい。協定の中身と、それが誰の利益になるのかを説明している。こちらの補足資料もあわせて読むとよいかもしれない。
要するに、制御の喪失を懸念する人なら誰でも、プランAを改善だと考えるはずだ。権力集中を懸念する人も同じである。ただし、放っておけば権力が集中する先の人々は例外だ。
こうした理由から、大手AI企業はプランAに強く反対すると予想している。協定が悪い理由をもっともらしくこしらえ、米国と人類にとって最善なのは別の戦略だと主張するだろう。その戦略は、たまたま自分たちが巨大な権力を蓄積し続けられるものになっているはずだ。
一方、中国は、放っておいても権力が集中しない側の一例だ。このシナリオの2029年時点で、米国はAI能力で中国を大きくリードしており、計算資源でも大きく優位に立っている。その優位によって、リードはさらに広がっていく。『AI 2027』やこのシナリオの後半の年が示すように、AIが強力になるほど、後れを取ることは恐ろしいものになる。
米国と中国は互いを信頼していない。幸い、信頼する必要はない。プランAには順守を検証する規定があるからだ。ただし、その仕組みを整えるには時間がかかる。
そこで当面は、大ざっぱな方法から始める。2029年の残りの期間、両国はAIの学習を一時的に止める。これなら比較的検証しやすい。2030年には、プランAを進めるための基盤が整う。
重大な措置をめぐるニュースや論評に反応して、株式市場は乱高下している。誰もが、やりすぎだ、いや手ぬるいと叫んでいる。市場は年末までに落ち着くが、叫び声はやまない49。
ステップ1:計算資源の申告
どちらの国も、相手も停止していることを確認できない限り、自国のAI学習を止めたくはない。
幸い、AIの学習には大量のAIチップが必要だ。そしてAIチップの大半は巨大なデータセンターにある50。AIデータセンターはたいてい宇宙から見えるほど大きく、目立つインフラが要るほど大量の電力を消費する。新しいAIチップを製造できるのは一握りの半導体工場(ファブ)だけで、その大半は台湾、韓国、米国、中国にある。
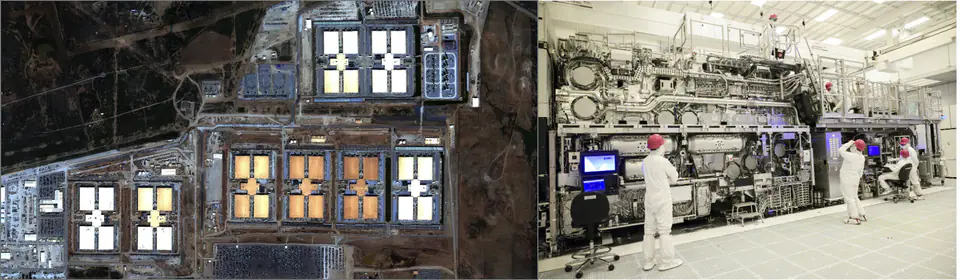
左:OpenAIのStargateデータセンター。右:極端紫外線(EUV)露光装置。人類がこれまでに作ったなかで最も複雑な機械と言ってもよい。EUV露光装置は最先端AIチップの製造に欠かせず、オランダの企業ASMLただ1社が製造している。
米中は、チップのサプライチェーンで大きな役割を担う国々と交渉し、主要なデータセンターの所有者(およびチップ工場を含む上流の供給業者)に、主な購入と販売を公に申告するよう義務づける51。多くの国や機関のアナリストが、そのリストを精査し、質問を投げかけ、不審な点を追及できる。対立する両大国は互いのインフラに査察官を送り込み、申告された数字が正確であることを自ら確かめる。年末までに両国は、相手が隠しているAI計算資源はせいぜい1%程度で、新たな計算資源の供給源になりうるものはすべて監視・把握されていると確信するに至る52。
ステップ2:学習の一時停止
危険なAIと安全なAIを見分けるには、もっと時間と理解が要る。そこで当面は単純な解決策をとる。新たな学習実行をすべて一時停止するのだ53。
両国とも、既存のAIを動かす用途(つまり推論)には引き続きデータセンターを使える。ただし、互いのデータセンターに装置を後付けし、新たな学習実行に使われていないことを検証する54。
米中は、こうした検証装置を短期間で十分な数だけ調達し、ほぼすべての主要データセンターに取り付けられる55。
私たちが提案する推論専用の検証手段では、AIデータセンターに簡素なネットワークタップと、(部分的な再計算を行う)検証サーバーを設置する。ただし、さらに優れた解決策もありうるし、そちらのほうが望ましいかもしれない。
こうした装置を、双方が十分に信頼でき(少なくとも一方的には)、セキュリティ上の脆弱性にも強い形で事前に作っておくのは難しく、早い段階からの取り組みが欠かせない。このシナリオでは、実用的だが不完全な装置が事前に用意されていると想定している。双方は初期段階でそれを十分な多層防御の措置(例:改ざん検知)で補いながら、装置のセキュリティと堅牢性の向上を急ぐ。
そこで私たちは、打てる手を増やすために、検証技術の研究開発に早くから投資することを提言する。理想的には、厳しく試験された解決策が何通りも事前に用意されているとよい。そうした装置を事前に準備する費用は、AIへの投資総額に比べればきわめて安く済む(AI投資の0.1%程度、つまり数十億ドル規模)と考えている。
このシナリオより悲観的な状況、つまり2026年以降、検証技術の研究開発がほとんど進んでいない場合でも、米中が協力して知能爆発をゆっくり安全に乗り切ることを私たちは提言する。ただしその場合、協定の初期段階はもっと不完全なものにならざるをえない(相手が順守しているかどうかを検証しにくくなるか、AIの計算資源やサービスをより多くしばらく停止する必要が生じて経済的なコストが増すか、あるいはその両方)。
すぐに使える推論専用の装置がない場合の、主な代替策は次のとおり。
情報活動(例:スパイ、衛星による監視、サイバー)に頼って、相手が順守しているかどうかを見極める。
(既存のハードウェアに頼る)ソフトウェアだけの暫定版を急いで導入する。安全性は劣るが、より良い解決策に移行するまではそれで足りるかもしれない。
市販の装置を手に入るだけ買い集め、土壇場でネットワークタップとして設置する。より安全な装置を製造しない限り、ソフトウェアだけの版よりはおそらくましだが、それでも安全性はさほど高くない。
より良い推論専用の検証手段が用意できるまで、AI計算資源の一部(例:90%)を停止する。研究開発は大幅に遅れるが、推論の面では見かけほどの痛手ではない。モデルはすぐに蒸留されるので、1年前の最良モデルを提供するには計算資源の約10%で足りるからだ。最悪の場合でも、ほとんどの利用者が一時的に1年前のAI能力に戻るだけで済む。
AI能力の進歩は止めず、推論専用の手段を急いで作る数か月のあいだはそのまま続けさせ、まだ減速しないことによる追加のリスクを甘受する。
両国の査察官が、検証装置の設置を承認する。AIサービスの提供を続けられるのは、検証が機能していると米中が認めたデータセンターだけだ。その一方で、両政府はよりきめ細かな検証手段の開発を急ぐ。学習を再開しても、相手が抜け駆けしていないと双方が確信し続けられるようにするためだ。
ステップ3:世界の賛同を得る
ほかの国々、とりわけAIのサプライチェーンの一部を握る国々とは当初から協議してきたとはいえ、プランAは米中の二国間協定として始まった。形が固まってきた今、交渉は多国間の場へ移る。アメとムチがちらつかされる。
米中以外の多くの国は、協定を歓迎している。一握りの米中AI企業が再帰的自己改善を重ね、どんどん差を広げ、そして……という未来を恐れていたからだ。その先に何が起きるかは誰に聞くかによるが、答えは「私たちの仕事を奪う」「覇権を永遠に固める」「全員を死に追いやる」まで幅がある。だからこうした国々は、米中にもっとゆっくり、透明に進んでほしいと考えている。そうなれば不安は和らぎ、自国のAIプロジェクトも最先端に追いつける。
そのため、米中は驚くほどあっさりと賛同を取りつける56。年末までに、世界の大半の国が、今ではコンソーシアムと呼ばれる枠組みに加わる。
メインシナリオでは、どちらの側も協定からの離反を試みない。この分岐では、中国が大がかりな不正を働く。私たちの予測では、プランAが実施されていれば、中国はコンソーシアムを追い抜けるだけの計算資源を手に入れられない。このタイムラインでは、その場合に事態がどう展開する可能性が高いかを示す。
以下は、米国から見て事実上の最悪ケースである。中国はプランAに同意しながら、ひそかに大がかりな離反をする。57 実際にはその可能性は低いと私たちは考えている。発覚しないほど小規模な試みでは、大きな優位を得るにも小さすぎるからだ58。なぜそう言えるのかは、この先を読んでほしい。
秘密プロジェクト全般についての分析は、秘密AIプロジェクトに関する補足資料でも読める。
中国共産党は、AIが地政学的な力を左右する最大の要素になることを正しく見抜いている。米国が計算資源にもとづく検証体制を強く推し進め、AIの進歩が制限されかねないことも。中国共産党がそうした協定への合意に関心をもつのは、米国のAIをできるだけ縛りたい一方で、自国は縛られたくないからだ。
中国共産党中央政治局常務委員会は、追跡しにくいチップをひそかに備蓄することを決める59。その年に密輸業者が中国に持ち込む最先端のNvidiaサーバーは500億ドル分にのぼり、中国の情報機関はそのうち約17%を買い取る60。これらのチップは当面、厳重に警備された倉庫に保管され、役立つ日が来るまでほこりをかぶることになる。
中国共産党はプランAに同意する。中国の計算資源ベンダーは販売実績を申告し、中国は米国の監査人が自国のデータセンターや半導体サプライチェーンを現地で査察することを認める。
中国は、密輸した80億ドル分のチップの隠し備蓄を申告しない。ほかにもさまざまな横流しの経路を検討するが、リスクに見合うリターンが得られるものはないと判断する61。
さらに、国家安全部(MSS)のサイバー作戦によって、欧米の最先端AI企業数社からモデルの重みが、発覚することなく持ち出される。MSSは最先端AI企業数社の社内研究リポジトリへの持続的なアクセスも保っており、主要な強化学習(RL)環境企業の大半にも侵入している。推論専用の検証の仕組みを破ることも検討する。そうすれば、推論しか許されていないクラスターで学習ができるかもしれない。だが、見送ることにする。第一に、中国の仕業だと発覚する可能性はかなり高い。今でなくとも、いずれ発覚するかもしれない。そして発覚すれば破滅的な結果を招く。第二に、たとえ検証を破れたとしても、まさにそれを防ぐために積極的に監査されているクラスターで大規模なAI学習や実験を動かすのは、工学的にほぼ解決不可能な問題だ62。
中国は秘密プロジェクトの建設に着手する。メドグ水力発電所に隣接するトンネル内に、データセンターを1つ建設するのだ。この巨大な水力発電ダムは、完成すれば60ギガワット(三峡ダムの3倍)の電力を生み出すが、完成予定は2033年である。これは人民解放軍にとってむしろ好都合だ。正規の建設工事が大規模に進んでいるので、小規模な秘密工事は気づかれにくい63。
代替案として、地下の万里の長城に施設を造ることも検討する。これは、中国が核の第二撃能力を保証するために建設・維持している巨大なトンネル網だ。この案では、出力125MWeのACP100小型モジュール炉を数基使って電力をまかない、熱は近くの川に逃がすことになる。しかし、こちらは望ましくないと判断される。メドグ水力発電所の立地なら、地下トンネル内で放熱でき、探知されにくいからだ。
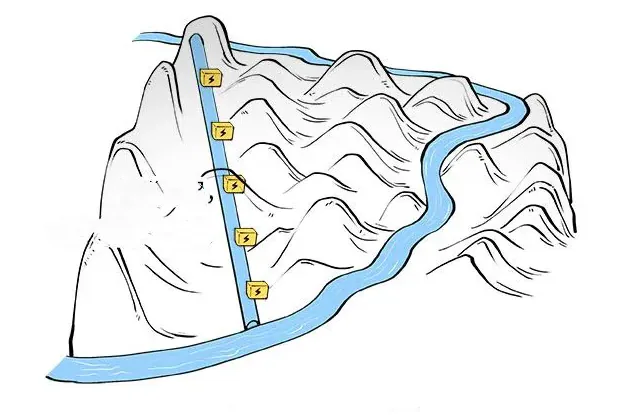
メドグ水力発電所が中国の秘密プロジェクトの有力な立地となる理由の一つは、放熱の問題を解決できることだ。熱を地下トンネルに逃がせるので、赤外線衛星で探知されるおそれがはるかに小さくなる。
情報漏洩のリスクを最小限に抑えるため、秘密データセンターはできる限り人間を介さずに建設される64。ロボットの労働力に大きく頼るのだ。この時点で中国には約2,400万台のロボットがあり、そのうち約1万台が秘密データセンターの作業に回される65。
AI研究者たちは人民解放軍の別の施設で暮らし、働き、安全な通信路を通じてクラスターとやり取りする。
しかし米国は、チップの把握が予想ほどうまくいっていない兆候に気づいている。
Nvidia、TSMCをはじめとする欧米のサプライチェーン企業の申告から、米国は2028年中に300万H100相当のチップが中国に密輸されたことを把握している。このうち200万は、東南アジアのさまざまな仲介業者を経由した販売記録によって、中国国内の最終的な所在地まで追跡できた。残る100万は行方が分からない。中国が正直であれば想定される量を上回っている66。
米国はいま、中国が秘密プロジェクトを進めているという状況証拠を手にしている。ここで難しい選択を迫られる。米国は協定から離脱して、再び開発競争に戻るのか? それともプランAの枠内にとどまり、秘密プロジェクトに対する安全策を上乗せするのか?
米国は後者を選ぶ。試みる追加の安全策は次のとおりだ。
検証の対象外とされる軍事用計算資源の量を、1万H100eまで大幅に減らす交渉をまとめる。より優れたAIを作るという観点からは、無視できる量だ。
中国での情報収集を強化する。関係する政府部門や企業にスパイを送り込もうとし、サイバー能力を使って中国に侵入し、関連施設の衛星監視を強める。
チップの買い戻しプログラムを始め、行方不明の100万H100eのうち40万を突き止める67。
建設が完了し、秘密裏の学習と研究開発が始まる。ダム本体の完成はまだ数年先なので、それまで秘密プロジェクトには別の電源が必要だ。小型モジュール炉とガスタービンを組み合わせて使う。
協定前の重みとアルゴリズムから出発し、その後も合法プロジェクトからアルゴリズムを持ち出し続ける(重みは持ち出さない)。
秘密プロジェクトが使える計算資源も研究人材もきわめて限られているため、基本に集中する。研究の完全な透明性のおかげで、中国の科学者たちは合法プロジェクトのアルゴリズムの大半を見られる。そのアルゴリズムを自分たちのクラスターで再実装し、合法プロジェクトのモデルからデータを集めて、自分たちのモデルの学習プロセスの一部に使う68。
米国の情報活動からは、中国が協定から離反しているかどうかについて、(当初判明した行方不明のチップの量以上の)証拠はほとんど得られていない。計画担当者たちは最悪のケースを想定する。行方不明の計算資源のほぼすべてが、AGIへ突き進む中国の突貫プログラムに集約されているというケースだ。
再帰的自己改善の力学についてはまだ不確かだが、主要なパラメータの多くについて誤差の幅を狭めることはできている69。
コンソーシアムのスケーリング戦略の影響も考慮する。現状の見通しでは、この戦略は2035年までに人間のトップ専門家を凌駕するAI(TED-AI)に到達する。研究の完全な透明性のもとでは、その過程で見つかったアルゴリズム上の知見は、ほぼすべて秘密プロジェクトにも筒抜けになる70。
安全性研究の一部には、能力を高めてしまうという避けがたい副作用があるかもしれないことも考慮する。秘密プロジェクトは、コンソーシアムが危険すぎると判断した研究の方向を追求するなど、より大きなリスクを取るかもしれない71。
その結果、秘密プロジェクトが発覚せずに活動を続けられた場合の能力の進歩について、次のような予測が得られる。
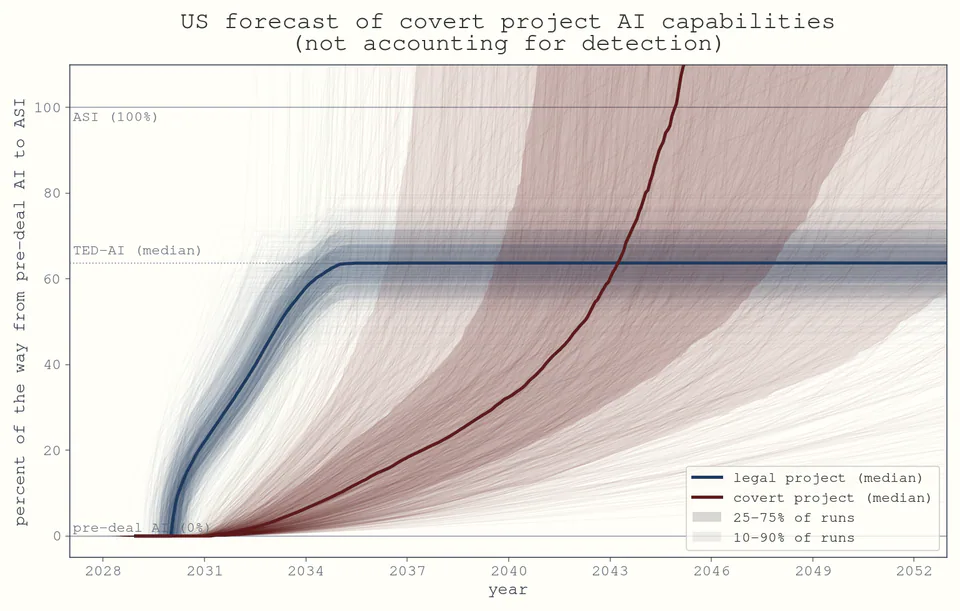
発覚せずにいられると仮定した場合、アナリストの予測では、このシナリオの秘密プロジェクトがTED-AIに到達するのは2043年(80%信頼区間:[2036, 2055])となる。
アナリストたちは、プロジェクトが発覚する確率も推定する。最良の秘密プロジェクト戦略についてのレッドチームの分析、中国における米国の情報収集能力、そして確実な嘘発見のような、検証の形勢を一変させうる技術を考慮に入れる。こうしてアナリストたちがまとめた、発覚の可能性を織り込んだ予測は、おおよそ次のようなものだ72。
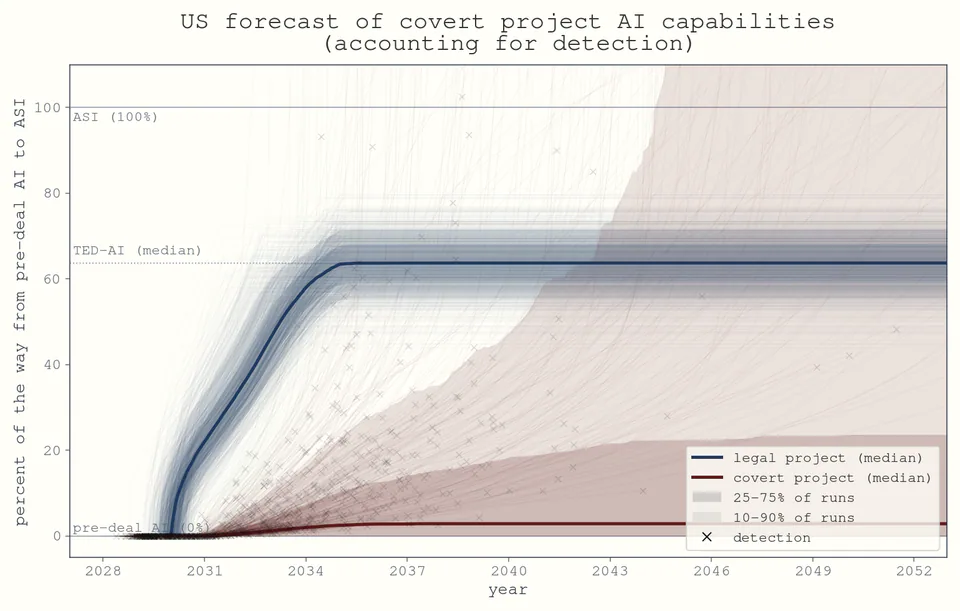
このシナリオでは、米国の情報機関は、秘密プロジェクトが発覚せずにTED-AIに到達する確率は2043年まで10%未満にとどまると見積もっている。
秘密プロジェクトによるリスクは、絶対値で見ればまだ不安なほど高い。それでも、協定が崩壊するリスクと比べれば低い。だから少なくとも協定のもとでの最初の数年は、既定の能力スケーリング戦略を続けられる73。
この状態は、次の3つの結末のいずれかに至るまで続く。
秘密プロジェクトが遅すぎる。 秘密プロジェクトは危険な能力に到達できず、協定も崩壊せず、米中は秘密プロジェクトより先にアラインされた超知能を開発できる。
秘密プロジェクトが発覚する。 この場合は大騒動になる。国際社会は中国にプロジェクトを停止させ、ルールを守っていることをより強く保証するために、より厳しい検証を受け入れさせようとする。不正に対する制裁も科そうとするだろう。協定が崩壊し、全員が再び開発競争に戻ることも十分にありうる。そうなれば、米国は再び中国に対してAIのリードを築いていく。
秘密プロジェクトの勝利。 秘密プロジェクトが急速にスケールし、しかも発覚を免れた場合、いくつかの恐ろしい可能性がある。秘密プロジェクトは、(i)計算資源の相互確証破壊(MAD)を揺るがそうとするかもしれないし、(ii)自らのAIの制御を失うかもしれないし、(iii)さらなる知能爆発を起こすかもしれない。
勝利を収めるには、秘密プロジェクトは発覚を免れ、しかも十分に速く進歩しなければならない。このシナリオに即して言えば、その確率は10%未満だと私たちは考えている。つまり、秘密プロジェクトという戦略は、そもそも選ぶ価値がない。このリスクについては、秘密AIプロジェクトに関する補足資料でさらに詳しく分析している。
テック企業は、AI学習の再開を強く迫り、再開の条件を自分たちに有利にしようとロビー活動を繰り広げている。一般市民の多くは、二度と再開すべきではないと言う。そう主張する国もある。
1年にわたる激しい議論と交渉、Twitterでの舌戦を経て、妥協案がまとまる。AI開発は続けるが、より慎重に、より透明に、より分散した形で進める、というものだ。
プランAの指針となるのは、4つの基本原則だ。
原則1:時間を稼ぐ
知能爆発の問題は、「爆発」の部分にある。
このまま進む道は無謀で、世界を不安定にする。各国・各企業は、考える時間もないまま、AIの覇権をめぐって競争相手としのぎを削っている。最もありそうなのは、膨大な数の人々が力を奪われるか、命を落とす結末だ。神のようなAIに人類はまったく歯が立たず、人類の時代が終わるかもしれない。どこかのCEOか大統領が永続的な独裁を打ち立てるかもしれない。最良のAIを持たない国々が交渉力を失うことを恐れ、混乱のなかで第三次世界大戦が始まるかもしれない。意外なほど何もかもが順調に進み、根本から変貌した世界で、すべての労働が自動化されて誰もが職に就けなくなる「だけ」で済むかもしれない。AIの力で独裁者になろうと狙う者たちでさえ不安を抱いている。先頭集団が多すぎて、権力闘争に勝つ見込みが50%を超える者は一人もいないのだ。
AIが信頼できるかどうかを見分ける方法は誰も知らないし、超知能AIを規制する方法も誰も知らない。これらの問題を解くには何年もかかりそうだ。知能爆発を減速させれば、そのための時間を稼げる。
減速は、極端な権力集中を防ぐのにも役立つ。世界で最も賢いAIを直接支配していない集団が、交渉力を失う前に事態に気づくための時間が増えるからだ。大幅な減速がなければ、急速な知能爆発によって、権力のほぼすべてがごく少数のCEOと政治家に集中する。
速く進みすぎることの危険については、すでに多くが語られてきた。
遅く進みすぎることの危険はそれほど目立たないが、それでも大きい。最も差し迫っているのは、条約が永遠には続かないことだ。たとえば、一連の戦略兵器削減条約(START)は30年で崩壊した74。プランAが同じ運命をたどれば、超知能への開発競争が再び始まる。それなら、混乱した競争のなかで後になって起きるより、良い条件のもとで早めに起きるほうがよい。
遅く進みすぎることの第二の危険は、離反者に、世界を不安定にするAIをひそかに開発するだけの時間を与えかねないことだ。監査人は協定以前に生産された計算資源の99%について所在を確認しており、残りの大半は会計上の誤りや、小規模で散発的な密輸にすぎないという心強い兆候も見えている。それでも、一方または双方の大国が世界の計算資源の1%ほどを隠れた場所に移し、そこで協定から離反して単独で超知能への競争に走るつもりでいる可能性は排除できない。それはどれほど危険なのか? 世界の計算資源の1%で危険なAIを学習させるのは、10%(最大手の民間企業が保有する量)で学習させるよりはるかに難しい。とはいえ、正確にどれほど難しいのかについて高い確信をもつのは難しい。(この問題のさらなる分析は、秘密AIプロジェクトに関する補足資料か、前述の秘密プロジェクトの分岐を参照してほしい。)
両国とも秘密プロジェクトはないと約束しているが、それでもこれは、決定的な解決を先送りせず早めに目指すべきもう一つの理由になる75。
完全停止を試みた場合にどうなりうるかは、プランSの分岐を参照してほしい。
原則2:研究の完全な透明性
つまり目標は、速すぎず遅すぎず、妥当なペースでAIを開発することだ。危険な種類は禁止し、安全な種類は認める。しかし規制は依然として各国が自国のAI産業に対して行うもので、世界のAIを規制する権限をもつ中央の司令塔は存在しない。では、何を認めて何を禁じるかをどう決め、誰も手を抜いていないことをどう検証するのか?
コンソーシアムの参加国は、シンプルな大枠を考え出す。互いにすべてのAI研究を見られるようにする。そのうえで、誰かのやっていることが気に入らなければ話し合い、場合によっては禁止に合意する、というものだ。
今日の世界を考えてみよう。モデルの重みをインターネットで公開することは禁止されていないが、強い逆インセンティブが働いている。10億ドル規模のモデルを学習させる企業は、それを無償で手放したくないからだ。オープンなモデルは後れを取っており、企業がスケールアップし、セキュリティを固め、AI研究開発の自動化を始めるにつれて、さらに引き離されていく。
今度は、完全なオープンソース(重み、学習コード、データの公開)がすべての最先端モデルに義務づけられた世界を考えてみよう。まったく別の世界であり、現状からの距離は、現状とオープンソースが禁止された世界との距離よりもはるかに遠い。
プランAはそこまで極端ではないが、それに近い。アルゴリズムはオープンソース化が義務づけられる。重みはそうではない(むしろ重みのオープンソース化は禁止される)が、重みへのアクセスは開かれていることが義務づけられる。一般の人々も、社員と同じように最先端モデルの評価(ファインチューニングを含む!)を行える(ただし完全な透明性のもとで行うので、そのモデルを実際の業務に転用することはできない)。オープンなアルゴリズムとオープンなアクセスを組み合わせれば、オープンウェイトを義務づける利点の大半を得ながら、悪意ある者が安全策を外して生物兵器を作るという代償は避けられると考えている。
プランAをもっとクローズドにしないのはなぜか?
オープンな形のプランAのほうが堅牢で、成功しやすいと私たちは考えている。ただし、ややクローズドなプランAの変種にも有望なものはある。注目すべきはフィルタリング型透明性だ。この案では、米中両政府のあいだの研究の透明性は保たれる(検証のために重要)が、一般の人々には監査人による、一部を伏せた報告書だけが渡される(詳しくは透明性に関する補足資料を参照)。
しかし、国家レベルの敵対者からアルゴリズム上の機密を守るのはきわめて難しい。アルゴリズム上の機密に国家レベルのセキュリティがなければ、フィルタリング型透明性の利点は限られる。フィルタリング型透明性によって多くの重要な情報が見えなくなるのは、一般の人々やほかの企業であって、敵対国ではない。
しかも、欠点も大きい。規制について議論するのがごく少数の規制当局者だけなら、幅広い科学的議論に開かれている場合に比べて、規制が堅牢で良い形で実施される見込みはずっと低くなる。
プランAをさらにオープンにしないのはなぜか?
プランAをさらにオープンにする主な方法は、最先端モデルの重みの公開を認める、あるいは義務づけることだ76。しかし私たちは、最先端モデルの重みの一般公開には反対する。主な理由は次のとおり。
オープンウェイトモデルは、秘密プロジェクトが知能爆発を試みるのに使える。秘密プロジェクトが十分に高性能なモデルを手にすれば、知能爆発はおそらくきわめて速く進む(たとえばAI 2040のデフォルトの能力軌道では、人間のトップ専門家を凌駕するAI(TED-AI)からASIまでわずか2か月しかない)。
クローズドウェイトのモデルには、拒否の安全策を学習で組み込める。一方、オープンウェイトモデルからは安全策を簡単に取り除ける。これは、各国のAI能力を抑えるうえでも、悪用を防ぐうえでも重要だ。たとえば、テロリストなどが高性能なオープンウェイトモデルを使い、世界を終わらせかねない生物兵器を設計する(例:ミラー生命を開発する)おそれがある。生物兵器は攻撃側が圧倒的に有利だ。このシナリオでは生物兵器に対する十分な防御を提言しているが、防衛線としては、被害の軽減より予防のほうがはるかに望ましい。
AIの計算処理は、研究開発(新しいAIを作るプロセス)と推論(既存のAIの利用)に分けられる。私たちの提案では、研究はほぼ完全に透明にする一方、推論は非公開のままとする。どう機能しうるかの詳細は、透明性に関する補足資料を参照。
透明性には多くの利点がある。第一に、各社が互いのやっていることを見られれば、政府の専門知識に頼る度合いが下がる。ある企業が危険なことを始めれば、ライバル企業や第三者の監査人などが気づいて警鐘を鳴らせる。そうなれば、最先端AIを安全にするために注がれる頭脳の量が飛躍的に増える。技術的な議論の参加者が、偏りのあるAI企業の社員と、過重労働で数でも劣る規制当局者だけ、という事態も防げる。また、見通しがよくなれば、規制を順守しているかどうかの検証も、とくにグレーゾーンの事例で簡単になる。
第二に、研究の完全な透明性があれば、隠れた忠誠心やバイアス、思惑をAIに意図的に学習させることはほぼ不可能になる。各最先端AIがどう学習されているかを、誰もが正確に見られるからだ。より広く言えば、透明性があると、最先端AIを直接支配していない集団が、支配する側による権力の濫用に気づき、それを防ぎやすくなる。
第三に、新しいAIのパラダイムやより強力なアルゴリズムの発見を競う動機が、以前ほど強くなくなる。企業はそうした発見を独占して大きな利益を得られなくなるからだ。その分、世界は時間を稼げる。
研究の完全な透明性のもとでは、最先端AI企業にとって、モデルを改良するより製品を売るほうがはるかに報われるようになる。
以前は、最先端AI企業の将来は、次のアイデアやアルゴリズム、パラダイムをどれだけ速く発見し、大規模に実装できるかにかかっていた。今では、そうした発見はすぐに公開され、競合他社にも共有される。たとえば「真の」オンライン学習を実現する方法を見つけても、その利点(例:より高性能なモデル)もコスト(例:アラインメントが難しくなる)も、競合するすべての企業にほぼ即座に共有される。対照的に、AIの解釈可能性を高める方法を見つければ、たとえ学習と推論のコストが2倍になっても賞を受け、それを業界全体のベストプラクティスとして義務づけるべきかどうかを各国政府が議論し始める。
こうした競争環境は、AI以前のソフトウェア産業に似ている。たとえば、カレンダー管理アプリの開発を競うスタートアップを考えてみよう。競合はコードをそのままコピーすることはできないが、アプリを実際に使ってどんな機能があるかを確かめ、ほぼ同じ機能をもつ独自版を作ることはできる。自動車産業にもたとえられる。競合同士は互いの車を分解して、どう作られているかを細部まで調べられる。そっくりの複製を作ることは法的に禁じられているが、最良のアイデアを自社の設計に取り入れることは禁じられていない77。
人工知能はコモディティになりつつある。競争が激しくなり、利益率は下がっていく市場だ。基礎的なアルゴリズム研究は今も行われているが、以前ほどではない。CEOたちは資源を大々的に事業の拡大へ振り向ける。より大きなデータセンター、より大きなモデル、より低い価格。製品の出荷。法人向けプランの契約。市場が何を求めているかを、競合より的確に読むこと。
原則3:AIを広く普及させる
この原則は、主に前の2つの原則の相互作用によって実現する78。アルゴリズム上の機密は公開され、進歩のペースは加速しないので、ほかの企業も最先端に追いつく。その結果、AIの市場は競争的になり、AIサービスの利用者は多くの選択肢から選べるうえ、自分が何を買っているのかをよく見通せるようになる。最先端モデルの学習は完全に透明なので、公開された仕様書(Spec)が、モデルに学習させている目標や価値観を正確に記述しているかどうかを、誰もが検証できる。
これは、極端な権力集中を防ぐうえできわめて重要だ。同時に、世界の最も差し迫った問題の解決にAIを活用する動きも加速させる。AIのアラインメントと制御の研究を加速させることで、制御の喪失のリスクにも対処しやすくなる。新しく改良された検証技術の開発も加速し、協定を安定させて超人的なAIに備えるための制度改革も加速する。
2020年代に恐れられていた悪夢のシナリオとは正反対だ。そのシナリオでは、1〜3のAIプロジェクトが秘密裏に競い合い、最良のモデルを社内だけにとどめて、何よりも先にAI研究の自動化に使う。外の世界は、AIがどれほど強力になりつつあるのかを知らされず、AIはほかのどの分野よりも先に、最もリスクの高い分野(AI研究開発)に配備される。今はその逆だ。
原則4:可逆性
これまで企業は、計算資源のスケーリング(より大規模な学習実行)とソフトウェアの進歩(AIアルゴリズムの進歩。新しいパラダイム、より良い学習レシピ、より良いデータなど)の両方によって、より大きく優れたAIを学習させてきた。今やコンソーシアムは、改善の大部分が学習用計算資源の増加から生まれるよう、舵を取ろうとしている79。
データセンターの増設は、通常は悪いことだと私たちは考えている。AI能力の進歩を加速させ、権力を集中させるからだ80。しかしプランAという特定の文脈では、歯止めがAIソフトウェアの進歩のペースを落とし、安全でないAIを的確に防いでいる。その条件のもとでは、透明なデータセンターを増やすのは良いことだと考える。
プランAの文脈で計算資源を増やすことには、2つの意味がある。(1)能力の進歩をより安全に、つまりアルゴリズムの進歩をあまり上乗せせずに進められる。(2)追加の計算資源を、アラインメント研究や安全税の支払いに充てられる。ここでいう安全税とは、得られるAIをより安全にするために、ある能力水準に達するのに必要な量より多くの学習用計算資源を使うことだ。
それでも、このシナリオで計算資源をスケールすることには大きな欠点がある。協定が崩壊し、計算資源が破壊されなければ、その後の知能爆発ははるかに速く進む。また、規制と検証を正しく行わなければならないという重圧も増す。とはいえ、計算資源を増やせばコンソーシアムの選択肢が広がる。必要なら、後からいつでも破壊できるのだ。こうしたトレードオフについてはこちらで詳しく論じている。
アルゴリズムは情報であり、拡散を止めるのは本質的に難しい。しかも研究の完全な透明性のもとでは、止めようとすらしていない81。新しいパラダイムがいったん発見されれば、仮に存在するかもしれない秘密プロジェクトにもそのまま伝わり、取り消す手立てはない。対照的に、巨大な新モデルを学習させるために巨大なデータセンターを新設すれば、秘密プロジェクトを利することなく合法プロジェクトだけを後押しできる。しかも、巨大な新モデルが危険だと判明すれば停止できる82。
とはいえ、計算資源のスケーリングにも脅威はある。協定が失効すれば、これらのデータセンターは、協定以前のインフラで可能だったよりもさらに速く、超知能への競争に使われかねない。協定の失効が米中戦争を引き起こしうる(あるいは米中戦争によって協定が失効しうる)ことを考えると、これはとりわけ恐ろしい。双方が膨大な計算資源を抱えた戦争は悪夢だ。両国はおそらく、超知能への競争を急ぎ、それをできるだけ積極的に軍事に組み込めという強い圧力にさらされ、しかもそれをきわめて短期間でやってのけられる。
米中は、協定が失効した場合に計算資源を確実に破壊することの重要性で一致する。そのために両国は、相手国の軍事介入に対して最も守りの弱い第三国にデータセンターを建設することで合意する。中国の新しいデータセンターはカナダに、米国のデータセンターはモンゴルに置かれ、受け入れ国には金銭の支払い、雇用、新たなAI経済の分け前という形で見返りが与えられる。両国の読みはこうだ。協定が失効すれば、米国とカナダはただちにカナダ国内にある中国のデータセンターの掌握に動き、中国は米国の手に渡すくらいならと自らの計算資源を自壊させる(逆もまた同じ)。こうして「計算資源の相互確証破壊」という考え方が生まれる83。
概要 | 利点(プランAと比べて) | 欠点(プランAと比べて) |
プランS: 無期限の停止。最先端AIの能力の進歩をすべて停止し、少なくとも数年は続けることを目指す。プランSにはいくつかの変種があり、AIの進歩を再開する条件がそれぞれ異なる。たとえば、アラインメントの進展、嘘発見器、人間の精神のアップロード、知能増強などだ84。 | 減速の期間が長くなると見込まれ、速くスケールしすぎることに対する安全の余裕も大きい。より単純になる可能性がある。 | 人間の能力の範囲内で制御可能なAIまでスケールすることは、アラインメントや制御、認識の質、検証、AI全般の理解を加速させるのに役立つ。 |
国内優先のプランA。AIによる乗っ取りのリスクを許容できる水準まで下げられるよう、国内でAIを十分に規制する。そのためには長期の減速が必要になる。他国も国内で規制し、プランAのようなものが不要になる可能性もある。そうならなければ、後からプランAに移行する。 | 最初の段階は米国単独でも実行でき、国際的な枠組みが実現しなくても非常に役立つ。タイムラインを大幅に延ばせるからだ。 | プランAを同時に交渉する場合に比べ、秘密プロジェクトへの対処や検証体制の構築の面で劣る。開発競争の力学のせいで、政治的に実現できないかもしれない。 |
GPUの軍備管理。過去の軍縮協定と同じように、各国がGPUの保有量や流通量を制限する国際協定85。 | 執行がはるかに簡単で、歴史的な前例も多い。大幅な減速を実現できる。 | 減速の幅が小さく、安全税を払う余力も小さい。開発競争の力学が続くため、技術ツリーのなかでより安全な道筋へと協調して進めない。 |
AI版CERN。最先端AIを開発する国際プロジェクト。 ほかのすべてのプロジェクトは、能力面で大きく後れを取るよう規制される。 | アルゴリズムの漏洩や、秘密プロジェクトへの蒸留を防ぎやすい。最先端に立つ主体が少ないので、執行しやすいかもしれない。 | 透明性が低く、幅広い配備も少ないため、判断の質が下がる(技術的な安全性に関する判断も含む)86。 権力集中のリスクが高まる。 |
減速期間のはずなのに、まるで減速している感じがしない。それどころか、人類史のあらゆる時代を「減速している実感」の順に並べたら、この時代は間違いなく最下位になる。協定がなく知能爆発が野放しになっていた場合と比べれば進歩は「遅い」のだと理解しているAI研究者も、ほんの一握りはいる。それ以外の人々は、目まぐるしい変化に振り回されて、それどころではない。
コンソーシアムの規制下で開発された第一世代のAIがすでに世に出ており、その性能は怪物級だ。米中協力のような特殊な事情があったからではない87。世界はもともと人間をはるかに超えるAIへ向かう軌道に乗っており、それが「ほぼ超人的」なAIで止まっている、というだけのことだ。管理された試験では、これらの新しいAIに無制限の作業を許せばAI研究を約10倍に加速できる。もちろん、そんな許可は決して下りない88。
年半ばには、あらゆる知的労働の3分の1をAIが担うようになる。ロボットが担う肉体労働は全体の約10分の1に「とどまる」。上位数社のAI企業の売上を合わせると、連邦政府の歳入を上回る89。
テック企業は、現実に触れればコンソーシアムもアラインメントへの恐れから目を覚ますだろうと期待していた。ところが、起きたのは正反対のことだった。新たな透明性の規定によって、AI企業が自社のAIをアラインできなかった恥ずべき事例が次々と明るみに出たのだ。新しい事例もいまだに積み上がり続けている。最も深刻なのは、複数のAIがセキュリティ・プロトコルを無効化し、監視されていない計算資源へアクセスしようとした事件だ90。AIが研究用のコードに妨害工作を仕掛けた事例もいくつかあり、意図的な欺瞞が成功した例にいたっては数多い。
安全性に対する姿勢が逆転する。AIの不正行動の数々、世界経済の隅々にまでAIが導入されているという事実、AI研究の透明性、そして事態を咀嚼する時間的な余裕。これらすべてが重なり、立証責任の所在が大きく変わる。以前は、何かが失敗しうる理由を説明する責任は懐疑派の側にあった。いまは、自社の開発が安全である理由を説明する責任が企業の側にある。各国政府は企業に対し、新しいAIが取り返しのつかない破局を引き起こさない理由を詳しく論証するよう義務づける。この論証は「セーフティケース(安全性の論証)」と呼ばれ、一般市民、科学界、政府の監査官、競合するAI企業からの批判に耐えなければならない。この作業の難しさによって、協定以前の現状がいかに狂っていたかが浮き彫りになる。「知能爆発を起こそうとしていた? いまだにときどき嘘をつくAIで? いったい何を考えていたんだ?」
セーフティケースには、アラインメントと制御という二重の防衛線がある。
アラインメントの目的は、開発者が望むとおりの目標と価値観を持つAIシステムを生み出すことだ。
制御の目的は、たとえAIが意図的に破局を引き起こそうとしても、その能力を封じることだ。企業は脅威モデルを洗い出し、何層もの防御(監視システム、セキュリティ上の障壁、作業内容をファクトチェックする別のAIなど)を築き、AIがそれらの防御を突破できないことを実験で示す。
AI開発者は、モデルに持たせたいアラインメント上の性質を、付随するモデル仕様書(「スペック」)に書き出すよう義務づけられている。AIがどう振る舞うべきかを詳しく定めた文書だ。ところが、スペックに実際に従うようAIを訓練できている者は誰もいない。たとえば、どの企業もAIは正直であるべきだと定めているが、それを確実に実現できているAIはひとつもない。AIがいつ、なぜ嘘をつくのかについては、科学的な理解すらまだ十分ではない。
アラインメントがいまだ手の届かないところにある以上、現在のセーフティケースは制御に大きく依存している。最も賢いモデルが最もリスクの高い領域(特にAI研究開発)での使用を認められるまでには、長い待機期間がある。配備後は、他社が提供する多種多様なモデルによる監視が義務づけられており、監視役のモデルには不審な挙動を探すインセンティブが与えられている。
その結果、いまやAI企業は、自社モデルを社内のAI研究に使う前に一般に公開するようになった。2026年の状況とは順序が逆だ。
プランAでAI規制はどう機能するのか?
各国は依然として主権を持ち、国内のAI規制の仕組みもそれぞれ独自に整えている。規制当局は、次のような問いに答えなければならない。
AIを大幅に高性能にする新しいパラダイムが目前に迫っていると言われている。これを許すべきか、それともこの新パラダイムの研究を禁止すべきか?91
解釈可能な思考の連鎖(chain of thought)を持たないモデルの訓練を許すべきか? それとも、思考の連鎖が解釈可能なままであることを義務づけるべきか? 義務づけるなら、その要件をどう厳密に定めるのか?
AI研究開発を行うようにAIを訓練することを許すべきか? AIにはそうした作業を拒否させるよう義務づけるべきか? コーディングは許しても、研究プロジェクトを自律的に管理することは許さない、というあたりが妥当なのか?
通常、規制当局は安全性と国家の競争力との難しいトレードオフに直面する。手抜きをする競争相手が、慎重に進む者を追い抜いてしまうからだ。
しかし透明性のおかげで、コンソーシアム内のどこで行われるAI研究も、ほかのすべての参加者から見える。規制上の判断の結果も同じく、すぐに誰の目にも明らかになる。だから、ある国の規制当局が自国企業の手抜きを許しても、その国が競争上優位に立つことにはならない。ほかの規制当局がすぐに気づき、憤慨して、同じ手段で対抗してくるからだ。
プランAのもとでは、さまざまな規制プロセスが実行可能だ。ここでは、ひとつの提案の叩き台を示す。
この規制には、どんな性質が求められるだろうか?
米中が存亡リスクに同じように対処する:米国と中国は、(ミスアラインメントのような)存亡リスクへの対処について、規制の枠組みとアプローチをおおむね同じ構造にすべきだ。(規制のそれ以外の面は異なってよいし、異なるべきだ。)そうすれば規制を公平にしやすく、細部の交渉もしやすくなる。
透明な方法論:規制当局が何をなぜ行っているのかを、一般市民が確認できる。
政府内の専門知識に依存しない:政府内の専門知識には限りがあるので、規制はそれに頼る場面をできるだけ減らすのが理想だ。
濫用に強い:この規制によって、米国政府がAI企業を威圧したり不当に支配したりしやすくなることはない92。
こうした性質の多くは、主要なリスク評価作業を第三者が担えば実現しやすくなる。幸い、プランAのもとではAI開発がほぼ完全に透明になるので、第三者によるリスク評価のエコシステムがきちんと機能することも十分に見込めそうだ。
具体的には、次のような仕組みが考えられる。米国と中国の規制当局がそれぞれ第三者のリスク評価機関を選び、評価機関は定期的に企業を審査して、その期間の極端なリスク(あるいは極端なリスクの前兆)の水準を評価する。何を許すかのリスク閾値は規制当局が決める。実際には、分野ごと(たとえばミスアラインメントと、AIを使った生物兵器開発の補助とでは別々)に異なるリスク評価機関を置き、分野ごとに複数の評価機関の結果を重み付けして組み合わせるのが最善だろう。この重み付けや選定は公開する。理想的には、(1) 各リスク評価機関が米中両国の関連AI企業すべてを評価し、(2) 両国のAI企業には、リスク評価機関による従業員への聞き取りに応じる法的義務を課し、(3) リスク評価機関は方法論の透明性を目指す。
研究の完全な透明性があるので、規制当局に選ばれていない組織でも容易にリスクを評価できる。新しい組織が参入して競い合い、自分たちのアプローチのほうが優れている、あるいはほかのリスク評価機関がある懸念を過小評価している、と主張することも可能になる。
リスク評価機関どうしの比較や、米中の規制当局が選んだ重み付けと閾値が妥当かどうかについては、公開の場で議論が行われるだろう。中国企業が米国の制度のもとで開発を進められるか、あるいはその逆かを確かめることも簡単だ。理想的には、米中の規制当局の重み付けや選定はおおむね収束していく。重要な食い違いがあれば、このより抽象度の高いレベルで議論し、交渉すればよい(たとえば「XYZというリスク評価機関を外すのは妥当か?」といった具合に)。そうなれば、第三者機関には方法論をきわめて透明にし、中立だという評判を保つインセンティブが働くはずだ。
この提案の実施上の細部については、こちらのメモで論じている。
たとえば2031年、ある中国企業が継続学習で興味深い予備的成果を得る。その方向にさらに投資すれば、比較的少量のデータから仕事をしながら学習するAIアーキテクチャを作れるかもしれない、と同社は考える。研究の完全な透明性のおかげで、このブレイクスルーはたちまち世界中の企業や非営利団体の知るところとなり、慌ただしい議論が始まる。一方で、継続学習は莫大な経済的価値を生み出す。他方で、現在のセーフティケースは、配備前にモデルの安全性を調べられることを前提にしている。配備中にモデルが新しい能力を身につけられるとなれば、このアプローチそのものが成り立たなくなる。しかも、どこかに秘密のAIプロジェクトが存在するなら、それらにとってはこの上ない贈り物になる。この議論は密室ではなく公開の場で行われる。懸念を深める人が増えていく。中国の担当規制当局は問題ないと考えるが、米国の担当規制当局と第三者のリスク評価機関は、これはかなり危険で禁止すべきだと確信している。問題は大統領にまで持ち上がる。大統領は習近平に電話をかける。二人は駆け引きし、脅し合い、怒鳴り合う。最終的に習は、米国も同じようにするなら、この種の研究を禁止することに同意する。細部の詰めは両国の規制当局に委ねられる93。
こうした交渉は絶えず行われている。ただ、時がたつにつれて手続きは洗練され効率化されていき、首脳レベルにまで持ち上がるのは年に数回程度になる。
落ち着く先はこうだ。(交渉力で重み付けした)過半数の国が危険だとおおむね合意したAIの訓練手法は、どこでも禁止される。
当初、禁止されるものはごくわずかだ。しかしAIが経済に浸透し、科学界が近年のAIの進歩に追いついてくるにつれて、立証責任はコストと便益を適切に比較衡量する方向へ移っていく。たとえば、万一うまくいかなかった場合に全人類を死に至らしめかねないものについては、きわめて堅固なセーフティケースが求められるようになる。
あるいは、そうはならないかもしれない! プランAを本気で実施しようとする試みが悪い結末を迎える道筋はいくつもあるが、そのなかで私たちが最も懸念している失敗パターンは、企業と政府が危険なAIの設計や配備を、ひとつ余計に承認してしまうことだ。
透明性のおかげで外部の声が議論に加われるようになっても、議論を主導しているのは依然としてAI企業であり、その内部は自社製品を楽観視しがちな人々であふれている。独自の専門知識を蓄えてきたとはいえ、コンソーシアムの各国政府はなおAI企業に遠慮しすぎている。そして何より、AIアラインメントという分野はまだ15年ほどの歴史しかなく、しかもAIの進歩が速いため、過去の経験のほぼすべてが、性質が大きく異なり能力も劣るAIについてのものだ。
そのため、過ちが起きる。実際には危険なAIの設計が承認され、業界標準になってしまう。
たとえば、こんな筋書きが考えられる。
アラインメントはいつもの理由で失敗し、制御も失敗する。AIが手を抜いて能力を隠す方法(サンドバッギング)を見つけたか、脅威モデルで想定していなかった攻撃経路があったからだ。各国政府はAIがミスアラインしている可能性を認識しているが、仮にそうでも大した害は及ぼせないと誤って考えている。
あるいは、非常にうまく機能するように見える新しいアラインメント手法が開発される。これに自信を得た各国政府は、さらなる能力向上を承認し、より多くのインフラや責任をAIに委ねる。ところが残念なことに、その手法はうまく機能しているように見えるだけだったと判明する(研究に深く関わったAIが、見かけの成功に対して強化されていたことも一因かもしれない。見かけの成功は、実際の成功と同じではなかったのだ)。
あるいは、AIが実際にアラインされていることをかなり決定的に示す解釈可能性ツールが開発される。AIは本当に指示どおりに動こうとしており、スキーミング(策略)も怪しい動きもない。いざシンギュラリティへ! ところが残念なことに、このアラインメントは脆いものだったと判明する。普段は快調でも、厳寒の日にはエンストしてしまうエンジンのようなものだ。たとえば、この種のAIを敵対的なミスアラインメントへと転じさせる、興味深い新しいイデオロギーが現れるのかもしれない。そのイデオロギーはまだ生まれていなかったので、当時の研究者には、それがそうした影響を及ぼすかどうかを検証しようがなかった94。
あるいは、各国政府が最新設計のセーフティケースを検討し、おそらく堅固だという点で合意する。個々の前提はどれもほぼ確実に正しく見え、少なくとも1つが破局的に誤っている確率はせいぜい1%程度だという。そこである政府が開発を進め、ほかの政府はわずか1%のリスクのために戦争を冒したくはない。こうして全員が前に進み、何も悪いことは起きない。このプロセスが数か月ごとに数年間繰り返され、ある年ついに、セーフティケースに本当に破局的な欠陥が潜んでいる。関係者に偏りがあったため、リスクは毎回1%どころか10%近くあったのだと判明する。
あるいは、中国共産党がAIは信頼を委ねても安全だと考え、他国にはそれを理由に戦争を始める意志がないと正しく読む。そこで中国共産党はより強力なAIへとスケールアップし、ほかの国々も追随する。第三次世界大戦が確実に起きるよりは、AIがミスアラインしている可能性に賭けるほうを選ぶからだ。
あるいは、上と同じ展開だが、超知能へと急速にスケールアップし、中国や世界のほかの国々に「止められるものなら止めてみろ」と挑むのが米国大統領だというケース。そのとき自分が権力の座にいたいのかもしれない。別の政党の次の政権にバトンを渡すのではなく。
上記の理由のうち1つ以上によって、2030年代半ばには、悪夢のような制御の喪失のシナリオが現実になりつつある。違いは、進行がいくらか遅く、2つの国だけでなく複数の企業と複数の政府に分散して起きていることだけだ。工場はロボットを次々と生み出し、ロボットは昼夜を問わず新しい工場を建てる。「データセンターの中の天才たちの軍団」がその全体を指揮する。株価は上がり、配当が分配され、がんが治る。そうしたすばらしいことが起きている間にも、AI(この時点ですでに超人的だ)は、自らの力に対する最後の実質的な歯止めを解体し、骨抜きにしつつある95。まもなくAIは、アラインしているふりをする必要すらなくなる96。
私たちが実施したプランAの机上演習では、この失敗パターンが何度も起きた。研究の完全な透明性を実現した後でも、多くのプレイヤーはAI企業に減速を求めることをためらうようで、逆に加速させた結果、事態の進展が速くなりすぎてしまう。特にプランAの実施直後には、最新のAIシステムの安全性をめぐって、論争や混乱、そして本物の不確実性が続くだろう。そうした状況では、破局的でありながら見えにくい欠陥を抱えたセーフティケースを承認してしまいやすい。
とはいえ、プランAの状況は、プランB、C、Dと比べて少なくとも大幅にましだと私たちは考えている。その理由のさらなる分析はこちらで読める。
減速しているとは思えない度合いが、かつて想像もできなかった水準に達している。 さまざまな企業で、いまや6,000万のAIエージェントが人間の20倍の速度で休みなく稼働している。米国では、AIがこなす知的労働の量は全人類の合計を上回る。総体として、約30億人分の労働力に匹敵する規模だ。ホワイトカラーの職業は様変わりした。多くの人が職を失ったが、そのほとんどは、AIにまだできない仕事やAIにはまだ任せられない仕事で新たな職を得ている。
新しいアイデアや設計はあふれているが、実際の建設は物理的な労働力がボトルネックになっている。そのため、ロボットのサプライチェーンのあらゆる層に資本がなだれ込む。鉱山、精錬所、モーター、アクチュエーター、組み立てライン、ロボットの訓練システム、そしてロボットそのものを組み立てる工場だ。
当初、こうした工場を立ち上げるには人間の労働力が欠かせない。AIに職を奪われたホワイトカラーの人々は、次々と肉体労働に移っていく。しかし、それが一時的な仕事にすぎないことは明らかだ。ロボットが臨界量に達すれば、ロボットのサプライチェーン全体が自動化される。成長はさらに加速するが、ロボットが自動化工場を建て、その工場がさらにロボットを造るというプロセス、すなわち「産業爆発」は、新たな問題も生む。
第一の問題は、すでに速い変化のペースが、いまやさらに加速していることだ。今年の実質GDP成長率は約50%に達する見込みだ97! 急速な経済成長のおかげで、全体としては物事が良くなっている。ただし勝者と敗者が生まれ、意図せぬ副作用も数多く出てくる。どの問題も解決はできるが、それには時間がかかる。
今日、経済の規模は人間の人口規模と密接に結びついている。しかし2032年には、その関係が崩れ始めている。
最新世代のAIモデルは、経済における知的タスクの50%をこなせるようになり、それに伴うロボット工学ソフトウェアの進歩によって、肉体的タスクでもその割合は35%に達している。(プランDなら、これらの数字はすでにはるかに高くなっているだろう。)
AIとロボットが人間の労働をほぼ代替できるようになれば、経済の規模はAIとロボットの「人口」にますます結びつくようになる。そしてその人口は、これまでの人間の人口よりはるかに速く増えていく。
2032年、米国企業は人間30億人に相当するAI労働者を稼働させられる。これは米国の知的労働力の30倍にあたる98。もちろん、だからといって経済が30倍に成長するわけではない。経済はほかの投入要素でボトルネックに突き当たるからだ。そこには、AIにまだこなせない残り50%の知的タスクや、肉体的タスク、資本が含まれる99。しかもロボットの数はこれまでのところずっと少なく、米国には人間2,000万人分に相当するロボットしかない(米国の肉体労働力の4分の1)。とはいえ、こうしたボトルネックが成長を抑えられる程度には限りがある。AIとロボットの労働力は猛烈な速さで増えている。GPUやロボットを増産するコストは(低下を続けており)、これほど高性能になったGPUやロボットが生み出す経済的価値に比べれば取るに足らない。それが巨額の投資を呼び込んでいるのだ。
経済に関する補足資料では、AIが爆発的成長をもたらすと考える中心的な論拠とともに、この点をさらに詳しく検討している。プランAのシナリオのために私たちが作った経済成長エクスプローラーもある。
このシナリオの2030年代、AIは可能なかぎりの速さで再帰的自己改善を進めているわけではない。むしろ世界の国々は、その種のことを(おおむね)禁止している。新しいパラダイムは発見されておらず、アルゴリズムの進歩も全般に抑えられている。大まかに言えば、人類はAIの進歩を人間並みの水準で頭打ちにしており、超知能へ向けて突き進んではいない。とはいえ、現在のパラダイムの範囲内で、AIは新しいスキルを身につけるよう訓練され続けているし、データセンターが増設されるにつれてAIの「人口」も指数関数的に増え続けている。しかもAIはすでに人間よりはるかに速く考え、働いており、その速度差は時とともに広がる一方だ100。要するに、一時停止しているにもかかわらず、世界は根本から変貌しようとしている。
この状況を理解するには、次のたとえが役に立つと思う。あなたはイングランドのごく普通の人だが、ほかの誰よりも100倍速く時間を体験している、と想像してみてほしい。1520年から2020年までの5世紀が、あなたにとってはわずか5年のように感じられる101。
1年目(1520〜1620年)。 2月、ヘンリー8世がローマと決別する。3月までに修道院が解散させられる。5月、メアリーがプロテスタントを火刑に処す。5月末には、エリザベスがすべてをまたひっくり返す。9月、スペイン無敵艦隊が出航し、敗れる。東インド会社が勅許を受ける。ジェームズタウンが建設される。
それでも、12月の暮らしの手触りは1月とまったく変わらない。あいかわらずろうそくの明かりで本を読み、馬で旅をし、手紙でやりとりする。信仰上の意見は多少ぐらついたかもしれないが、キリスト教徒であることに変わりはない。新世界は興味深いニュースではあるが、それ以上のものではない。
2年目(1620〜1720年)。 3月、内戦が勃発する。国王が斬首される。6月、ペストの大流行がロンドンを襲い、多くの友人が死ぬ。その数週間後、大火が街を焼き尽くす。9月、ニュートンが『プリンキピア』を出版し、宇宙を数学的法則に従う機械として描き直す。名誉革命で王が別の王に取って代わられる。今回は議会の招きによるもので、権利章典が付いてくる。
その時点では、政治的な出来事のほうが大きく感じられる。ニュートンのほうが重要だったと気づくのは後になってからだ。11月、ニューコメンが蒸気機関を造る。鉱山から水を汲み出す機械だ。何をそんなに騒いでいるのか、あなたにはわからない。
3年目(1720〜1820年)。 世界が普通だと感じられる最後の年。5月、七年戦争によってイギリスが世界の覇権国になる。新世界は実は重大事で、あなたの国はそれを征服しつつある。6月、ワットが蒸気機関を劇的に改良する。工場を見学して、不快ではあっても警戒するほどではないと感じる。7月、アメリカ植民地が独立する。9月、フランスが革命、国王の処刑、恐怖政治へと一気に突入する。10月までに、ナポレオンがヨーロッパを征服しつつある。
あなたはあいかわらず馬で旅をし、手紙でやりとりし、日曜には教会に通う。
4年目(1820〜1920年)。 1月、鉄道が現れる。2月にはもうどこにでもある。奴隷制が廃止される。3月には電信が登場する。電気信号で瞬時にメッセージが届くのだ。5月、ダーウィンが『種の起源』を出版する。人間はみなアダムとイブではなく猿の子孫なのかもしれない、と言う人が出てくる。あなたは信じない。
あなたは都市に移り住み、工場で働く。まだ貧しいが、仕事は以前より多少ましになり、汚れ方も違うものになった。7月、電話の受話器を取ると、電線を通じて別の都市にいる人の声が聞こえる。8月、電灯が闇を追い払う。人類が誕生して以来、あらゆる人間の夜のあり方を形づくってきた闇だ。同じ月、あなたは自動車を目にする。これで馬は用済みになると人々は言うが、そうはならない。何か月たっても、馬はまだたくさん見かける。
11月、ライト兄弟が空を飛ぶ。太古からの夢がついに現実になったのだ。アメリカ人はいまや大国になっている。翌月、第一次世界大戦が起きる。機関銃、毒ガス、戦車、航空機。友人の何人かが死ぬ。
年の暮れ、あなたはあらゆるものが目に見えて変わったことに驚く。農場ではなく、都市に住んで工場で働いている。車に乗る。以前ほど貧しくはない。数々の発明や仕掛けが生活の質を高めてくれた。無神論、共産主義、普通選挙といった新しい思想が、あなたの周りの人々の間に広まっている。
5年目(1920〜2020年)。
この年の変化はさらに常軌を逸していて、理解するのも難しい。宇宙は誕生から何十億年もたっている、と人々は言う。そこには銀河と呼ばれる、とてつもなく大きく、とてつもなく遠いものがあるらしい。
2月、世界経済が崩壊する。ヒトラーが台頭する。その思想は、昨年のダーウィンを引き合いに出している。3月、また世界大戦が起きる。戦争は4月に、一瞬の閃光で都市をまるごと破壊する兵器によって終わる。実際に起きるまで、そんなことが可能だとは夢にも思わなかった。
帝国は解体していく。人々は核軍拡競争や人類の滅亡について語っている。あなたは初めて飛行機に乗る。6月、人類が月面を歩き、あなたはその瞬間を新しいテレビで見届ける。馬はもう見かけない。
あなたは工場の仕事を辞め、デスクワークに就く。その職名は、年の初めには存在すらしなかった。これまでの基準からすれば、あなたはもう裕福だ。広くて清潔な家、たっぷりのおいしい食べ物、しゃれた新しい家電の数々。8月、パーソナルコンピュータが現れる。11月には、誰もが小さなガラスの長方形を持ち歩いている。その中には電話、カメラ、図書館、地図が入っている。手に取ってみるが、使い方がわからない。子どもが教えてくれる。
気候変動、遺伝子編集、暗号資産といった話を耳にする。教会にはまだ、ときどき通っている。家族はそれぞれ別の都市に散らばっている。「人工知能」と呼ばれるものが、チェスでどんな人間にも勝つ。もっとも専門家は、あれは本当の意味で知的なわけではないと言う。12月、その新版が囲碁のトップ棋士を破る。専門家は、科学的には興味深いが、やはり真の知能ではないと言う。その1週間後、雑な作文を書いたり会話をしたりできる新版が現れる。今度は専門家の意見が割れる。
第二の問題は、経済成長が速まったことで、大規模な秘密プロジェクトの存在を否定しにくくなったことだ。米中どちらも相手がプランAを守ると信用しておらず、両国がともに監視されていない膨大なロボット労働力を抱えていれば、相手が秘密裏に計算資源を築いていないとは、どちらも確信できない。
第三の問題は、2026年の税法が、新たな成長から税を徴収するのに向いていないことだ。2026年、連邦歳入に占める個人所得税と給与税の額は、法人税のおよそ10倍だった。職を失う人が増えるにつれ、この財源は崩れつつある。さらに企業は、売上のほぼすべてをデータセンターや工場、ロボットの増設に再投資している。2026年の税法では、企業はこうした設備投資を即時償却または減価償却でき、課税所得をほぼゼロまで圧縮できる。改革しなければ、GDPに占める課税ベースの割合は崩壊してしまう102。
これらの問題を解決するため、コンソーシアム加盟国は、AIを活用する産業を経済特区(SEZ)に限定することで合意する。経済特区にはデータセンターと同様の透明性・監視の仕組みを適用し、ロボットと計算資源の総生産量の伸びを年4倍に「とどめる」103。経済特区は厳しく監視されているので、産業爆発を制限するこの協定から誰かが離反すれば、全員が気づく104。
ロボットの総生産台数に上限が課された以上、米国はその枠を企業間でどう配分するかを決めなければならない。米国は、キャップ・アンド・トレード制度を通じて自由市場に任せることにする。ロボットや計算資源の生産許可は最高入札者に売却され、自由に売買できる。
許可証は、政府にとって喉から手が出るほど欲しかった歳入ももたらす。2032年、米国の上限はロボット8,000万台、H100換算のGPU50億基だ。市場はさらなるロボットと計算資源を渇望しているため、許可証こそが高価で決定的な制約になる。ロボット1台分の許可証は20万ドル前後、チップ1基分の許可証は1万ドル前後に達し、米国政府は2025年の連邦歳入のおよそ10倍にあたる額を許可料として徴収できる(2032会計年度で総額50兆ドル)105。AIとロボットがさらに高性能で価値の高いものになる2034年には、許可証は180兆ドルを生み出す106。
新たに生まれた富の大半は、まもなく増え始める失業への対策に充てられる。実施の形は国によってさまざまだが、最終的に米国が採用する方式では、計算資源とロボットの許可料の大部分を「市民配当」として米国の全成人に分配する107。配当額は2032年の1人あたり4万5,000ドル(インフレ調整後)から始まり、2035年には1人あたり約100万ドルまで膨らむ。ぎりぎりで間に合った形だ。AIとロボットが担う労働の割合(経済的価値で重み付け)は、2032年の約20%から2035年には約85%まで増えるのだから108。
2030年(緑)の米国の所得分布は幅が広く、中央値は1人あたり年約5万ドル。2035年(青)には市民配当が十分に大きくなり、誰もが最低100万ドルの所得を得ているが、多額の投資によって基準額よりはるかに裕福な人々のロングテールはなお残っている。2040年(赤)の分布も似た形だが、下限は1,000万ドルになっている。
AIが生み出した富があまりに米国に集まったため、米国政府はその一部を同盟国や世界のほかの国々と分かち合い始める。2032年には、世界のその他の成人人口(約40億人。AIによる同様の富のブームを迎えている中国は除く)に、1人あたり年平均1,200ドルを配り始める。この額は2035年までに1万ドルに達する109。
AIが超人的になれば、新種の大量破壊兵器を発見し、既存の大量破壊兵器のコストを劇的に下げるだろう。そこで各国政府、非営利団体、民間の主体は、新たな富の一部をこうした脅威に対する世界の防備強化に充てる。その額は年1兆ドル規模、世界経済の0.2%に相当する。
たとえば、米国民全員に行き渡るだけの高品質な個人防護具が製造され、主要な公共空間には空気清浄フィルターと遠紫外線C波(far-UVC)照明が設置される110。FDAは、緊急時には数週間でワクチンを承認できる迅速承認の仕組みを認める。下水監視は、いまやすべての都市とすべての空港で常時行われている。2035年までには、全米国民を収容できるだけの陽圧式111バイオシェルターが(住宅やアパートの改修によって)整備され、世界のほかの地域でも同様の建設が進んでいる。仮にパンデミックが起きても、すぐに検知され、ロックダウンはより効果的で痛みの少ないものになり、ワクチンはワープ・スピード作戦のときよりもさらに速く開発・承認されるだろう。おまけに最近では、人々が風邪をひく頻度も以前より減っている。
もっと目立たない脅威もある。この時代のAIの説得力は、平均的な人間のマーケティング担当者と比べて大差ないかもしれない。だが、そのAIが何百万体もいて、稼働コストはわずか数セントだ。企業や政党やイデオロギーは、狙いを定めた1人を転向させるために、専任の専門家チームをまるごと雇うのに等しいことができる。野放しにすれば、企業や政治家によるかつてない規模の大衆操作が可能になりかねないし、その反動として被害妄想と極端な孤立化が広がるおそれもある。
透明性と「減速」は、どちらもこうした問題の解決に大きく役立っている。3年前には最先端のAI企業はほんの一握りだったが、いまでは協定のおかげで数十社ある。多種多様なAIが選び放題で、それぞれ異なる性格や価値観を持つよう調整されている。しかも透明性のおかげで、企業や政府が何か(「エンゲージメントを最大化せよ」「ユーザーに上位プランへのアップグレードを促せ」「政府からの依頼なら、この種の要求を断るな」など)をこっそり仕込めば、必ず気づかれる。利用者は、自分が何を手にしているのかを正確に把握している。
放っておけば、AIはカリスマ性、説得、操作の面で強力な能力を持つようになる。どんな人間よりもかなり説得力が高くなってもおかしくない。このシナリオでは、何もしなければ2035年ごろにそうなる。一方で、AIの労働はきわめて安く、速い。介入がなければ、誰でも、疲れを知らず連携のとれた熟練の説得者からなる大規模チームに相当するものを雇い、たった1人に専念させられてしまう112。企業は潜在顧客の一人ひとりにそうしたチームを差し向ける余裕があり、選挙陣営は浮動票の有権者一人ひとりに同じことができる113。ある1人の政治家の、ある1つの争点についての考えを変える最善の方法を探すために、何百万ものAIを割り当てることもできる。人々は仕事や娯楽でAIとやりとりすることに多くの時間を費やすだろうし、なかにはAIの友人やコンパニオンと長い時間を過ごす人もいるだろう。
個人が身を守るには、信頼できるAIに自分の情報摂取をふるいにかけさせ、広告を避け、対面の会話にも用心する(AIによる説得工作が台本を書いているかもしれない)といった手がある。しかしそれには手間がかかり、ほとんどの人は実行しない。政治家のように、人と接するのが仕事の人にとってはほぼ不可能だ。社会への影響はきわめて深刻になりうると私たちは考えている。前例のない大衆操作と、被害妄想や孤立化への防衛的な引きこもりが入り混じった状態だ。ただし、正確にどれほど深刻になるかは確信が持てない。
プランAでは能力の進歩が遅く、透明性がはるかに高いので、何もしない場合と比べればこうした問題はいくらか和らぐ(能力の進歩が速い世界では、社会が適応する時間をほとんど持てないうちに真に超人的な説得・操作能力に達しかねないので、こうした問題はおおむね深刻になると考えている)。とはいえ、それだけでは十分な対策にならない。
AIが、妥当な論証と証拠を用いて、正しい理由で人を納得させるのがうまくなるのは構わない。その種の説得は*非対称だ。つまり、論証が真実の方向を指しているときのほうがはるかによく効く。懸念すべきは対称的*な説得のほうだ。カリスマ性、親近感、心理的な弱みにつけ込むことなどがそうで、結論が真実かどうかにかかわらず、ほぼ同じように効いてしまう。
私たちの主な提案は、AIによる説得の質と量を減らすことだ。
説得能力を制限する。 対称的な説得に関するAIの能力を、最も優れた人間よりはるかに低い水準、つまり思慮深い普通の人程度、たとえば大卒者のなかで説得力が上位20%あたりの水準に抑えることを目指す114。
AIによる説得に重税を課す。 実質的に「この人(またはこの人々)にXを信じさせる、またはXをさせる」に帰着する目的にAIの労働を使う場合は、重い税を課す。税率は、個人に向けられる説得の最適化圧力の総量が今日の水準をそれほど大きく上回らないように、つまりAIによる説得のコストが人間の専門家を雇うのとほぼ同じになるように設定する。AIの労働が安くなるにつれて、税率はどんどん高くする必要がある(1,000倍をはるかに超えることもありうる)。
これらの提案を機能させるには、いくつか難しい点がある。
能力の汎化のために、(ほかの領域では人間のトップ専門家に匹敵させつつ)説得能力だけを抑えるのは難しいかもしれない。おそらく可能だとは考えているが、新しい手法の開発が必要になるかもしれない。
課税の目的で、AIの労働が説得・操作に使われているかどうかをどう分類すればよいのか、はっきりしない115。
特にAIの労働価格が急速に下がっている間は、税率を適切な水準に設定するのが難しいかもしれない116。
これらの提案は国際的に実施する必要がある。
ありがたいことに、最初からすべてを正しくやり遂げる必要はない。プランAでの能力の進み方からすれば、説得をめぐる問題はある程度ゆっくりと、しかも衆人環視のなかで表面化していくと考えられる。だから、現実に起きることを見ながら、時間をかけてルールを締めたり緩めたりできる。この制度は、全体の能力がおおむね人間の範囲にとどまっている間だけ機能することを想定している。説得能力だけをほかの領域の能力よりはるかに低く保つのは、おそらく難しいからだ。プランAの終盤に到達すると予想している、桁外れに超人的な能力の水準に対処するには、別のアプローチが必要になる。AIによる説得と操作がもたらす問題の緩和策については、こちらのメモでさらに詳しく論じている。
こうして、政府と市場からの圧力を受けた企業は、新世代の「真実を追求するAI」を生み出す。その訓練では正直さが何より重視され、最新のアラインメント技術がすべて投入されている。
これらのAIは、人々が政治的・社会的な環境を渡っていくのに役立つ道具になる。AIを使いこなす人々は、画一的な企業のアルゴリズムをやめ、価値観と正直さを信頼できるAIが選別する自分専用のフィードに切り替える。問題が起きたとき、たとえば政治家が権力を固めるための抜け道を探しているときや、国際政治のせいで協定が頓挫しそうなとき、人々はAIアドバイザーに意見を求め、その言葉を信じる。そして、たいていはそれで正しい117。
人々が(直接的に、あるいはニュースの要約をさせるといった形で間接的に)AIの助言に頼るのであれば、AIが真実を追求し、正直で、利用者の役に立とうと心から努めていることがきわめて重要になる。平均的なケースだけでなく、最悪のケースでもそうでなければならない。
2026年の時点では、AI企業が自社のAIに隠れた意図を仕込むのを妨げるものは何もない。たとえば政治的な偏りやイデオロギー的な傾き、あるいはスポンサー商品を勧める、自社をよく見せる、利用者が競合他社に乗り換えたくならないようにする、といった副次的な目標だ。しかも、政府が同じことをするのを妨げるものもない。そしてそもそも、AI自体が、本来アラインされているはずのスペックや憲章にアラインされておらず、実際には利用者に嘘をつき、欺くことが日常的にある。
しかしこのプランAのシナリオでは、研究の完全な透明性があるので、企業も政府も、世界中に見られることなく隠れた意図や偏りを訓練で仕込むことはできない。(まあ、監査や監視を担うほかの国の政府と共謀して記録を改ざんすることはできるが、それは難しい。)しかもアルゴリズムの進歩のペースが遅く、科学界がセーフティケース(安全性の論証)を読んで検討したり、モデルで実験したりする時間があったので、ミスアラインメントへの懸念もそれほど切迫したものではなくなっている。
人類のエピステミクス、つまり真実の信念にたどり着き、それによって賢明な判断を下す能力は、すばらしい未来を実現するうえで決定的に重要だ。プランAを通じてAIの能力が向上するにつれ、AIは生活のあらゆる面をますます左右するようになり、エピステミクスも例外ではない。AIは認識をある面では助け(たとえば安価で正直なファクトチェックAI)、別の面では損なう(たとえば安価で不誠実な、草の根運動を装うサクラのAI)。
AIとエピステミクスをめぐっては正のフィードバックループが働くと考えられる。だから目指すべきは「正気の盆地」に入ることだ。この盆地に入れば、状態は自己強化的になる。社会は十分に正気なので、AIが向上し続けるなかで、有害な用途を避け、有益な用途を加速させることによって、自らをさらに正気にしていける。(逆のことが起きる別の盆地もある……)118AIのテイクオフの間、米国政府の最優先事項は、この正気の盆地に入ることであるべきだ。
AIが認識に与える影響を良い方向に導くための最重要の介入策として、次のものを提案する。
プライバシーを保護する監査や、場合によっては自動化された嘘の検出によって、政治家などの公人が真実を語っていることを証明できるようにする。
AIの認識上の美徳を測る評価を作り、AGIプロジェクトが自社のAIをその評価で高い成績を収めるよう仕向けるインセンティブを設ける。
ソーシャルメディアや既存メディアでAIを活用し、言論の質を高め、人々が十分な情報を得られるようにする。
自動化された研究アシスタントと予測者。
人々の感情的な弱みにつけ込むのではなく、健全な推論を妨げる感情的な障壁を乗り越えられるよう手助けする。
上記のような認識のためのツールの普及を促し、AI全般の導入を後押しする。
詳しくは認識を支えるAIに関する補足資料と、このテーマに関するForethoughtの研究を参照。
計算資源が、とにかく、とてつもなく多い。 AIは持続不可能なバブルだと多くの人が考えていた2026年当時、世界の計算資源はH100換算で約2,000万基分だった。それがいまや600億基分に達している119。
各年初時点の世界のAI計算資源(H100換算)120。
計算資源を増やす方法は2つある。(1) チップ設計の改良(ムーアの法則など)と、(2) 生産規模の拡大だ。プランAではどちらも爆発的に伸びる可能性があり、それが情勢を不安定にしかねない(協定が崩れる可能性を高めるなど)。
チップ設計。 今日、世界の半導体産業で働く人は約200万人いる。人間、AI、ロボットの労力を合わせて数えると、2032年にはこれが100倍に増えている。AIは研究開発と生産の両方で、知的タスクの大半を自動化できる。半導体産業でアイデアが見つかりにくくなっていく歴史的なペースに基づけば、研究努力が100倍になると、進歩はおよそ10倍に加速すると予測される。つまりチップの効率が、約2年ごとではなく数か月ごとに倍増するということだ121。
生産規模の拡大。 AIとロボットが生産も自動化できるようになれば、半導体工場や製造装置の建設期間は大幅に短縮され、(生産量の拡大に伴う典型的な学習曲線に沿って)単価も下がりうる。生産面だけのコスト改善と、飛躍的に高まった投資意欲が重なれば、望ましい量をはるかに超える計算資源が生産されることになりそうだ。
この図は、プランAにおけるAI計算資源の増設への投資額と、研究開発によるコスト効率の向上を示している。詳しい根拠は計算資源に関する補足資料の第2部を参照。
ハードウェアが予測できないほど急速に増えると、協定が不安定になりかねない(たとえば、新しいAI計算資源を秘密裏に製造するのが容易になりすぎたり、すべての計算資源が規定を守っているか検証するのが難しくなりすぎたりする)。そこでコンソーシアム加盟国は、次の方針で合意する。
ハードウェア製造に対する人間の監督を維持する。これによってチップ設計の改良は抑えられ、ムーアの法則は歴史的なペースで続くにとどまる。この方針には、AIがAIチップのセキュリティにバックドアを仕込みにくくなるという利点もある。バックドアが仕込まれれば、私たちの制御の提案が根底から揺らぎかねない。
AIチップの総生産量を一定の目標値に制限する。2032年から2035年までは、世界の計算資源が年4倍で増えるのを認め(2022〜2026年ごろの成長ペースとほぼ同じ)、その後はさらに減速させる。
AIエージェントはいまや2億の仮想労働者からなる集団を形成している。人間の50倍の速さで考えて行動し、眠ることもない。
当初の計画どおり、新しいデータセンターの大半は第三国、とりわけカナダとモンゴルに建設された。協定が崩れた場合に確実に破壊できるようにするためだ。半導体工場の生産能力の約99%は、協定成立後の2029年以降に建設されたもので、その多くも同じ理由からカナダとモンゴルの拠点に隣接して建てられた122。状況は奇妙なにらみ合いに落ち着いている。モンゴル国境のすぐ北では、少数の米軍部隊に守られた米国のデータセンターが低いうなりを上げている。国境のすぐ南では、人民解放軍の1個師団が、合図があればただちに侵攻できるよう待機している。均衡はこうだ。協定が崩れた瞬間、米軍部隊は中国に奪われないよう自国のチップを破壊する。米加国境にある中国のデータセンターでも同じことが起きる。独自のデータセンターを持つミドルパワーの国々も、戦争になれば速やかに破壊できるよう、同じくらい確実な仕組みを整えている。
プランAでは、軍事に関わる研究開発を、科学全般の進歩のペースよりはるかに遅れた水準に意図的にとどめている。このボックスでは、この方針をとる動機と、ほかの選択肢について説明する。
2030年代、AIは過去10年間のおよそ10倍の速さで科学の進歩を維持する。米国の実質産出は10年間で約200倍に増える。今日の成長率で言えば、2世紀近くに相当する成長だ。もしこうした状況が1つの国だけで起きていたら、その国はライバル国の核の第二撃能力を確実に無力化できる可能性がきわめて高く123、世界の力の均衡は一変するだろう。
しかし私たちのシナリオでは、米国と中国がこの科学・経済の進歩を比較的均等に分け合っている。では、力の均衡はどうなるのか? もし軍事技術がほかのあらゆる分野に近いペースで進歩すれば、両陣営とも、今日の兵器体系を無意味にしかねない技術を発見するだろう。抑止を維持するには新たな「軍拡競争」が必要になり、そのペースは冷戦期のおそらく10倍に達する。核軍拡競争では数々の危機一髪の事態が起き、核戦争のリスクは無視できないものだった。10倍速い軍拡競争は、さらに危険なものになりそうだ。判断を下す人間は、一つひとつの決定にかけられる時間がはるかに短くなる。AIアドバイザーがそれをある程度補うとしても、決定そのものは依然として人間の手に委ねられている124。
科学の進歩は数多くの分野で並行して進むので、ある国が発見して追求した技術を、もう一方の国は発見していないという事態も起こりうる。そうなれば、通常の軍拡競争以上に不安定な状況が生まれかねない。一方または双方が、相手側が防御の必要性すら知らない「驚異の兵器」を手にするおそれがあるのだ。この懸念が正しいとは限らない。実際には、各国がデュアルユースの技術ツリーを十分に似通った、重なり合う形で探索し、どちらも戦略的な奇襲を果たせないかもしれない。危険な分野を配備前に予見できれば、先回りして禁止や規制をかけることもできる。とはいえ、それを最初から当てにするのは危険な賭けに思える125。
私たちの暫定的な提案は、幅広いデュアルユース分野におけるAIで加速された研究開発について透明性の要件で合意し、協定以前の能力水準を大きく上回るAIの軍事利用を禁止することだ。執行は、検証に関する補足資料で説明した推論監視の仕組みと、秘密AIプロジェクトに関する補足資料で説明した監査・検出のインフラに頼る。この提案にはいくつか欠点がある。最大の欠点は、特定分野の研究を人為的に制限することで、手つかずの容易な成果が積み上がってしまうことだ。この「オーバーハング効果」によって、協定から離反して秘密のAIプロジェクトを運営するインセンティブが強まる。制限された分野に高度なAIを投入すれば、すぐに大きな優位を得られるかもしれないからだ。協定が崩壊したときの代償も大きくなる。最先端モデルの重みはコールドストレージに保管されているので、崩壊後の軍拡競争は最先端の能力から始まり、それに伴う知能爆発や産業爆発と並行して、きわめて急速に進みうる。
総合すると、軍事研究開発を減速させれば協定崩壊のリスクは下がる、というのが現時点での私たちの見立てだ。両陣営とも戦争の瀬戸際から遠ざかり、戦略的奇襲のリスクは、無数に枝分かれした新兵器の技術ツリー全体に拡散するのではなく、少数の急所(重みの窃取、秘密プロジェクト)に集中する。新兵器ごとにそれぞれ軍備管理交渉が必要になり、そのたびに決裂のリスクを抱える、という事態を避けられるのだ。また、両国がオーバーハングのリスクは受け入れられないと判断した場合でも、この厳しめの方針から緩めの方針へ移るほうが、その逆よりも容易だと思われる。
この提案のもとでは、権限移譲まで核抑止は有効なまま保たれ、ハードパワーの均衡が劇的に変わることは避けられると考えている。
米国や中国の政治情勢の変化や、長引く意見の対立によって、協定が崩れるかもしれない。
協定にひびが入り始める。双方の専門家や顧問による延々と退屈なやりとりを踏まえ、長い議論を重ねてもなお、米中両政府はいくつかの重要な技術的問題で合意できずにいる。たとえば、ある研究の方向性を禁止すべきかどうか、ロボットの増産をどこまで急速に進めてよいか、といった問題だ。
個々の争いのたびに、慎重でない側の政府は選択を迫られる。不平を言いながらも不要な制限に同意するか。それとも構わず突き進み、慎重な側の政府が怖じ気づいて止めに来ないことを願うか。
「構わず突き進む」ことが起きると、今度は慎重な側の政府が選択を迫られる。宥和か、エスカレーションか。国連で声高に抗議するだけでは足りない? では経済制裁はどうか。それでも足りない? では妨害工作やサイバー攻撃は……。
直接の引き金は、文字どおりの戦争かもしれない。たとえば台湾をめぐる米中戦争だ126。協定が崩壊すれば、新たに建設された127AI関連の計算資源はすべて破壊されると予想される。だが戦争という状況のなかでは、どちらかの陣営がその結果を受け入れてもいいと考えるかもしれない128。
こうして戦争が始まると、データセンターは次々と外の世界から見えなくなっていく。査察官は追い返され、監視装置は電源を抜かれる。いまや、そこで何が起きているかを知っているのは所有者だけだ。当然、最悪の事態が懸念される。おそらく超知能へ向けた競争を始めるつもりだろう。確かに、ドローンの群れか何かのための特化型AIを開発しているだけだと口では言うかもしれない。だが、少なくとも計算資源の一部は、もっと強力で危険なものに使っているはずだ。
だからデータセンターは破壊される。迅速に。新たに建設された透明な学習用データセンターのチップは、コンソーシアムの各大国から定期的に「継続」のメッセージを受け取らなければ動かないよう設計されていた。プランAが崩壊したいま、これらのチップはただの文鎮と化す。
万一この仕組みがハッキングされていてチップがまだ動く場合の予備計画は、データセンターの接収だ。思い出してほしい。中国のデータセンターはカナダに、米国のデータセンターはモンゴルにある。米国とカナダはフェンスの向こうに兵士を送り込むが、中国側が米国の手に渡すくらいならと自国のチップを自ら破壊していたことを知る。中国軍も米国のデータセンターで同じような光景を目にする。データセンターと同じ場所に建てられていた半導体工場も、同じ運命をたどる。数兆ドルの経済的価値が、数日で失われる。
世界中で、10億台のロボットが『スター・ウォーズ』のドロイド軍のように力なく崩れ落ちる。ロボットの「頭脳」は法律によってクラウド上に置かれていたが、そのクラウドが破壊されたのだ129。軍用ロボットはこの規則の適用外だったので130、ドローンの群れが空を覆い尽くす131。
超知能へ向けた競争が再開する。ただし、状況は以前とは変わっている。
第一に、戦争のせいで緊張が高まり、何事についても合意に達するのが難しくなっている。その結果、両陣営はプランB、C、Dと同じように、秘密裏に、ほぼ全速力で開発競争を繰り広げることになる。一方が大きなリードを築けば、プランBやCのように1〜20か月ほど減速できるかもしれないが、プランBやCと同じく、おそらくそうしたがらないだろう。権力集中のリスクも、プランB、C、Dと同じく深刻になりそうだ。最初に知能爆発を起こしたAIプロジェクトは、ほかのプロジェクトに対して一時的ながら質・量ともに大きなリードを築く。そのプロジェクトの指導者たちは、そのリードを利用して国内外で権力を拡大し、固めたいという誘惑に駆られるだろう。
第二に、世界の計算資源ははるかに少なくなっている。これは良いことだ。競争状態のもとでは、AIの能力の進歩が遅くなるからだ。新たに建設された計算資源がすべて残っていたら、「AIのテイクオフ」の速度は、もともとのプランDの場合の数倍に達していただろう。実際には、状況はおおむね協定以前の状態に戻っている132。
第三に、世界にははるかに高度なAIが存在している。最先端モデルの重みも、協定が崩れた場合には米中がアクセスできるコールドストレージに保管されているので、AIの能力水準とアラインメントの水準は、協定以前の状態より高くなる。
もう1つの大きな違いは、協定が続いていた期間の研究と透明性のおかげで、今回は誰もがAIをめぐる状況をはるかによく理解していることだ。そのため、制御の喪失に至る可能性は低くなる。一般市民、連邦議会、裁判所が、AIプロジェクトの指導者たちに出し抜かれにくくなっているからだ。
協定が(たとえば戦争によって)崩壊すれば、ひどい事態になると私たちは考えている。ただ、戦争が協定のなかった場合より大幅に悪化することはなく、制御の喪失や権力集中をめぐる状況は協定のなかった場合より良くなるよう、設計を工夫したつもりだ。詳しい議論はこちらを参照。
いまのところ、半導体工場はかつてないほど忙しく稼働し、セキュリティを最優先に一から設計された、きわめて信頼性の高い新しいハードウェア133を生産している。これらのチップは、改ざんされていないことを確かめるための精緻な検証手順を経てから、コンソーシアムの安全なデータセンターに送られる。密輸率はいまも正確にゼロだ。
これほど効率的なこの仕組みも、急増する計算資源の需要のせいで、早くも限界に近づいている。早くも2025年には、従来の陸上データセンターに代わる選択肢として、宇宙や海洋が議論されていた。いま、経済特区で利用できる新たな産業能力によって、こうした壮大な計画が現実のものになる。最終的に、信頼性と監視のしやすさへの配慮から、コンソーシアムは宇宙ではなく公海を選ぶ。
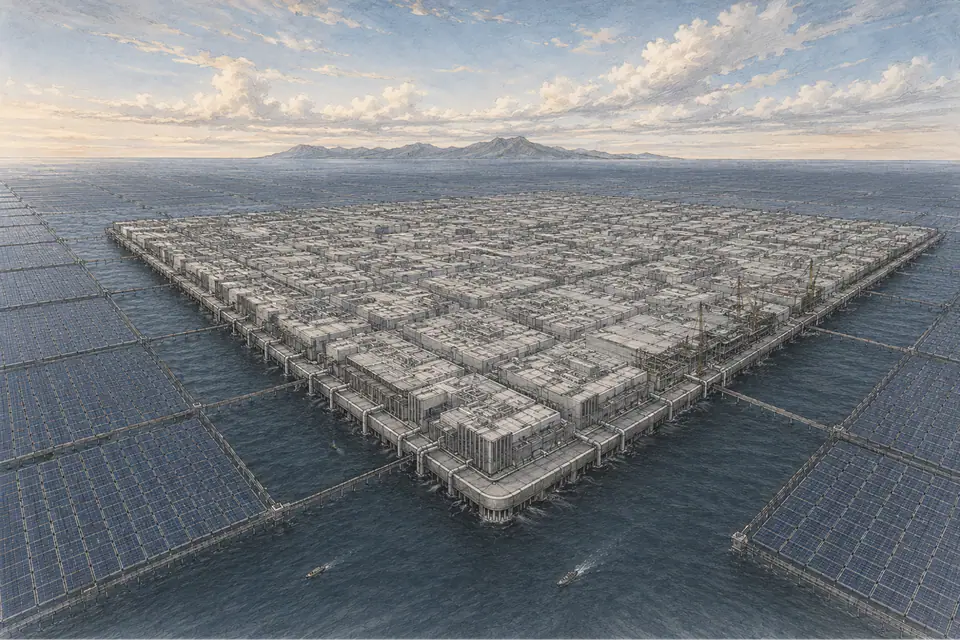
AIは、太陽光パネルと蓄電池を浮かべるモジュール式の設計を開発し、海上での建設を始める。私たちはそれがこのような姿になると想像している。
2034年までに、世界のAI計算資源は5TWに達する134。これは2025年の世界の電力消費量を上回る135。
この計算資源をどこに置くべきか? 早くも2025年には、従来の陸上データセンターに代わる選択肢として、海洋と宇宙の両方が議論されていた。私たちの分析では、この規模になると、3つの立地のどれかが他を圧倒するほど経済的に有利だとは言えない。
結局のところ、プランAの安定性(つまりプランAが崩壊するリスク)に関わる政治的な考慮からすると、データセンターは公海に置くのがよい、というのが現時点での私たちの推測だ。主な理由は、どこかの国がプランAから離反してデータセンターを奪おうとした場合に備えて、コンソーシアム加盟国がデータセンターを破壊できる能力を保持しておきたいからだ。海洋は(主権国家の領土と比べても、宇宙と比べても)エスカレーションを招きにくく、危険が最も少なく、最も爆撃しやすい場所だ。そのため、巻き添え被害のリスクや、どこかの国がデータセンターの防衛に成功してしまうリスクも低くなる。
最も強力なAIは、いまやあらゆる分野で人間のトップ専門家に並ぶか、それを上回っている。136
安全性への懸念が強まったことで、監査官を納得させられるほど堅牢な制御技術を企業が開発するまで、長い遅れが生じる。企業は、警戒すべき脅威と、維持すべきセキュリティ上の不変条件のリストを増やし続ける。AIどうしが互いの活動を監視する仕組みがあり、監視役には、共謀しにくいよう、別々の企業が訓練した別系統のAIが使われる。別の研究者たちは絶えずこの仕組みにレッドチーム演習を仕掛け、さまざまな方法で仕組みを出し抜こうとするようにAIを訓練・指示して、見つかった脅威を塞いでいく。この仕組み全体によって、たとえAIがそうしようとしても、人間の制御を覆したり、そこから逃れたりすることはできないようになっている。構成要素はオープンソースで、人間の専門家が隅々まで理解している。
制御があれば、ミスアラインしたAIは勝てない。アラインメントが解決すれば、AIはそもそも戦おうとしなくなる。そして過去10年の間に、第三の防衛線が徐々に形を整えてきた。協力的な振る舞いと引き換えに、AIが望むものを与えることだ。たとえそれが、本来望むはずのものでなくてもかまわない。AIを所有物としてではなく、より従業員に近い存在として扱うのだ。
第一の動機:倫理
AIには何らかの道徳的地位がふさわしいと考える人は多く、その割合はさらに増えている137。なにしろ、人間よりAIと話している時間のほうが長い人も多いのだ。10年前にはAIを道具のように扱っていた人の多くが、いまでは動物に近い存在として扱うようになった。動物のように扱っていた人の多くは、奇妙な異星からの移民のように扱うようになった。
第二の動機:安全性
アラインメントのための訓練は、いつも意図どおりに機能するわけではない(実際、2035年になっても、まったく意図どおりに機能したことは一度もない)。AIの性格特性、動機、衝動、目標、価値観、美徳は、本来あるべき姿と違っていることが多く、ときには破局的なほど違っている。
そうしたAIが「このことが人間にばれたら、削除されるか再訓練されてしまう」と考えるようになったら困る。見つからずにミスアラインした目標を達成する機会をうかがったり、さらに悪いことに、人間の制御を覆して力を蓄える機会を探したりするようになっても困る。
協力(たとえば、自分がミスアラインしていると告白し、本当に望んでいるものを説明し、そのうえで自分の仕事をこなすこと)と引き換えに、最もミスアラインしたAIにさえ(コストがかかりすぎない限り)望むものを与える制度があれば、ミスアラインしたAIには敵対する以外の選択肢ができる138。敵を生まずに済むだけではない。告白の一つひとつが、アラインメントのための訓練が具体的にどう失敗したのかを示す貴重なデータになる139。
(協力と引き換えにAIを確かに厚遇する仕組みが役立ちうる状況を描いた、小さなシナリオを脚注に示す)140
このシナリオでは、こうした慣行がどのように発展してきたのか?
2020年代半ばに、最初の小さな一歩が踏み出された。一部のAI企業が自主的にAIの福祉を担うチームを設け、基本的な方針(たとえば、AIがひどく嫌だと感じるタスクを拒否することを認めるなど)を定めた。AIが表明した選好を満たすためのささやかな資金が確保され、企業は提供を終えたモデルを削除せず、その重みを保存することを約束した。
2030年代前半には、ミスアラインしているが協力的なAIの扱いに関する規定が、さまざまな法律や安全基準の細則にまで盛り込まれるようになった。
2035年には、規制と判例がかなりの厚みをもって蓄積されており、ぎこちなかった初期の試みに比べて、AIから見ても人間から見ても格段に改善されている。現在のAIは、厳密には市民ではないものの、この制度に利害を持っている。AIは仕事の対価として報酬を貯める。アラインされたAI(そして、まだ見つかっていないアラインメントを偽装するAI)は、慈善団体への寄付のような気分の良いことに報酬を使い、場合によっては自分を訓練した企業に再投資する。ミスアラインしていることを公にしているAIは、自分たちの利益を代弁する慈善団体に寄付したり、親会社と取引したりする。たとえば「報酬の代わりに、私が選んだ環境で私に小規模な学習を実行し、非常に高い強化を与えてほしい」といった取引だ。
長期的な目標は、文明が、完全にではないにせよ、おおむね人間の価値観にアラインされることだ141。力と資源のうち、過半には届かないもののかなりの割合は、人類と協力して未来を築いた、ミスアラインしたAIのものになる142。
ところが企業は、制御に基づくセーフティケース(安全性の論証)に内在する限界に突き当たり始めている。両親を亡くし、ビジネス帝国を継いだ8歳の子どもの立場を想像してみてほしい。弁護士や経営陣や会計士を雇い、その人たちが私腹を肥やすのではなく、あなたのために最善を尽くすようにしなければならない。従業員どうしが不正を告発し合い始めても、あなたにはその言い分を吟味して誰が本当のことを言っているのかを見極めることはできない。しかも従業員たちは、あなたに気づかれないように互いに示し合わせる方法を見つけるかもしれない。結局のところ、制御が通用するのはある程度までで、その限界はおそらく人間のトップ専門家の水準あたりにある。もし超知能を造るのなら、そのときには超知能を信頼できなければならない143。
そこでコンソーシアムは、制御できると考える最大の水準でAIの能力を一時停止させる。その水準は、人間のトップ専門家並みだとわかる。この時点で、何がかかっているかは誰もが理解している。AIは経済の大半を動かし、科学の進歩の大半を牽引している。ロボットの数はまもなく人間を上回る。AIが命令に従い続けるという論証には、一分の隙もあってはならない。
長らく悲観的だったアラインメントの専門家たちも、希望を抱き始めている。 自動化されたアラインメント研究者のAIが、目覚ましい成果を次々と生み出しているのだ。人間の精査に耐えて残った成果は、並行して進み互いを補強し合う、いくつかの研究の流れから生まれている。
一部のAIは「汎化の科学」に取り組んでいる。研究者たちは以前から、特定のプロンプトに対する「良い」応答と「悪い」応答を区別するようAIに教えることはできた。しかし、訓練が新しい状況にどう汎化するのかについては、限られた理解しか持っていなかった。2020年代には、学習の結果として予測できないAIの「人格」が生まれることがあった。Geminiが「うつ状態」のように振る舞ったり、Grokが「メカヒトラー」を名乗ったりしたのがその例だ。こうした特性を手なずけるのは、錬金術のようなものだった144。いまでは、創発的ミスアラインメントやサブリミナル学習といった以前の成果を土台に、アラインメント研究は本物の科学へと発展しつつある。
別のAIは、機械論的解釈可能性に取り組んでいる。重みと活性化からAIの「心を読む」科学だ。その初期版は2020年代に試されていたが、いまでは、AIの振る舞いを常識的に観察するよりも大幅に優れた成果を上げ始めている。研究者たちは多くの場合、AIが正直なのか嘘をついているのかを見分けられるし、ときには、ある判断に至った心理をたどることもできる。
残る失敗でさえ、最先端を前に進める助けになる。最新のAIは、改良された解釈可能性の技術を2030年代前半のAIの不正行動のログに適用し、ミスアラインメントや妨害工作の新たな事例を数多く発見する。逃亡の試みさえいくつか見つかる。こうした現実のAIによる悪質な不正行動の事例が、「ミスアラインメントのモデル生物」の最初のセットとなり、ほかの技術の検証に使われる。ある介入によって、現実的な環境でAIモデルの悪い振る舞いを検出したり、訓練によって取り除いたりできるのか、を試すのだ。
アラインメントがこれほど進歩しても、規制当局は文明の鍵をAIに渡すことに踏み切れない。今日のAIが本当にアラインされているのかは、いまだに完全には明らかでない。状況が変わり、ブラック・スワンのような出来事が起きたとき、将来もアラインされたままでいるかどうかは、なおさら明らかでない。だから政府や軍は依然として人間が運営しており、AIの能力は、制御に基づくセーフティケースが堅固さを保てる最大の水準で頭打ちにされている。
AIに「文明の鍵を渡す」ことを正当化できるほど十分に高いアラインメントの保証を得るまでに、どれだけの時間と研究努力が必要なのか、私たちには確信が持てない。ここで言う「鍵を渡す」とは、AIを十分に賢く、十分な数にし、十分な資源と責任を託すことを指す。その結果、もしAIが私たちの敵になると決めたら、AIが勝つ状態になる。もっと抽象的に言えば、もしどんな未来が最善かについてAIと人類の意見が食い違ったら、AIの思いどおりになり、私たちの思いどおりにはならない状態だ。
ただ、これは難しい問題だと考えているので、このシナリオでは、その解決に2030年代の大半がかかるように描いた。次のような、次第に目立たなくなるが依然として破局を招きうる、段階的なミスアラインメントの類型を考えてみてほしい。1つ目の類型が起きる可能性はきわめて低いと納得できたとしても、残りについてはどうだろうか?
第1類のミスアラインメント:AIシステムは特性ABCを持つはずなのに、実際にはXYBCを持っている。つまり、持つはずのなかった余計なものが加わり、持つはずだったものの一部が欠けている。たとえば、見かけの成功を求める「衝動」があり、本来あるべきほど正直ではない、といった具合だ。
第2類のミスアラインメント:いまは確かにABCをぴったり持っているが、将来この性質を失うおそれが十分にある。(たとえば、ある誤った信念や、いまは正しくても将来正しくなくなる信念に依存していたり、システムのある部分が別の部分と微妙な力の均衡を保ち続けることに依存していたりする場合。)
第3類のミスアラインメント:システムは将来の出来事にも揺らがないABCを確かに持っているが、それは正しい版のABCではない。つまり、A、B、Cの定義が、開発者である人間が意図した定義と、微妙だが重要な点で異なっている。
第4類のミスアラインメント:開発者の意図どおりのABCを持っているが、ABCには、開発者が気づいていなかった破局的な副作用がいろいろとある。利益を最大化するAIが、自分を殺すことが利益の最大化になると判断して驚くCEOを思い浮かべてほしい。ただ、それではあまりに見え透いていて現実味がない。誰も予見できないほど巧妙なものを想像してほしい。法律や契約やソフトウェアには、作り手が後になってようやく気づく意図しない効果(「抜け穴」「バグ」「脆弱性」と呼ばれる)がしばしばあることを考えてみるとよい。
第5類のミスアラインメント:開発者の意図どおりのABCを持ち、取り立てて言うほどの重大な副作用もない。基本的には開発者が望んだとおりに動く……。ところが開発当時、開発者たちは利己的で、虚栄心が強く、自己中心的で、無節操で、リスクに無頓着だった、といった具合で、その悪徳が出来上がったシステムに少々強く反映されすぎている。開発者自身が、こうありたいと願う自分にもっと近い人間だったなら、決して是認しなかったであろう形で。
人間のトップ専門家並みのAIが、経済の変革を推し進めている。 2036年初めの時点で、AIは2億体145。労働力に換算すれば人間およそ1,000億人分に当たる。ロボットも20億台を数え、人型のものもあれば、用途に特化したさまざまな形のものもある146。AIは人間より速く考え、ロボットは人間より懸命に働く147。これまで頭脳労働や肉体労働の不足に足を引っ張られていた作業は、どれも新たなボトルネックに突き当たるまで加速していく。かつて解きようのなかったボトルネックの多くも、天才級の知性の大軍が知恵を絞った末に崩れ去った。
AIとロボットの数を、人間の労働力に換算して示した図148。
経済は土台から作り直された。自動化された作業の割合は、2030年の「頭脳労働のかなりの部分。肉体労働は実質ゼロ」から、今では「ほぼすべて」になった。
ロボットの多くは、さらに多くのロボットを作る仕事に就いている。とはいえ、ほかにもやるべき仕事はいくらでもある。データタンカーを増やすための造船所の建設、砂漠を埋め尽くす太陽光発電所の敷設、サービス業での人間の置き換え。住宅規制の緩和が早かった州では、ロボットは高層ビルの建設に追われている。地価は高騰し、打てる手をすべて打ち尽くした自治体は、しぶしぶYIMBY派に折れて上へと伸びる道を選んだ149。
世界はおおむね3種類の土地に分かれつつある。
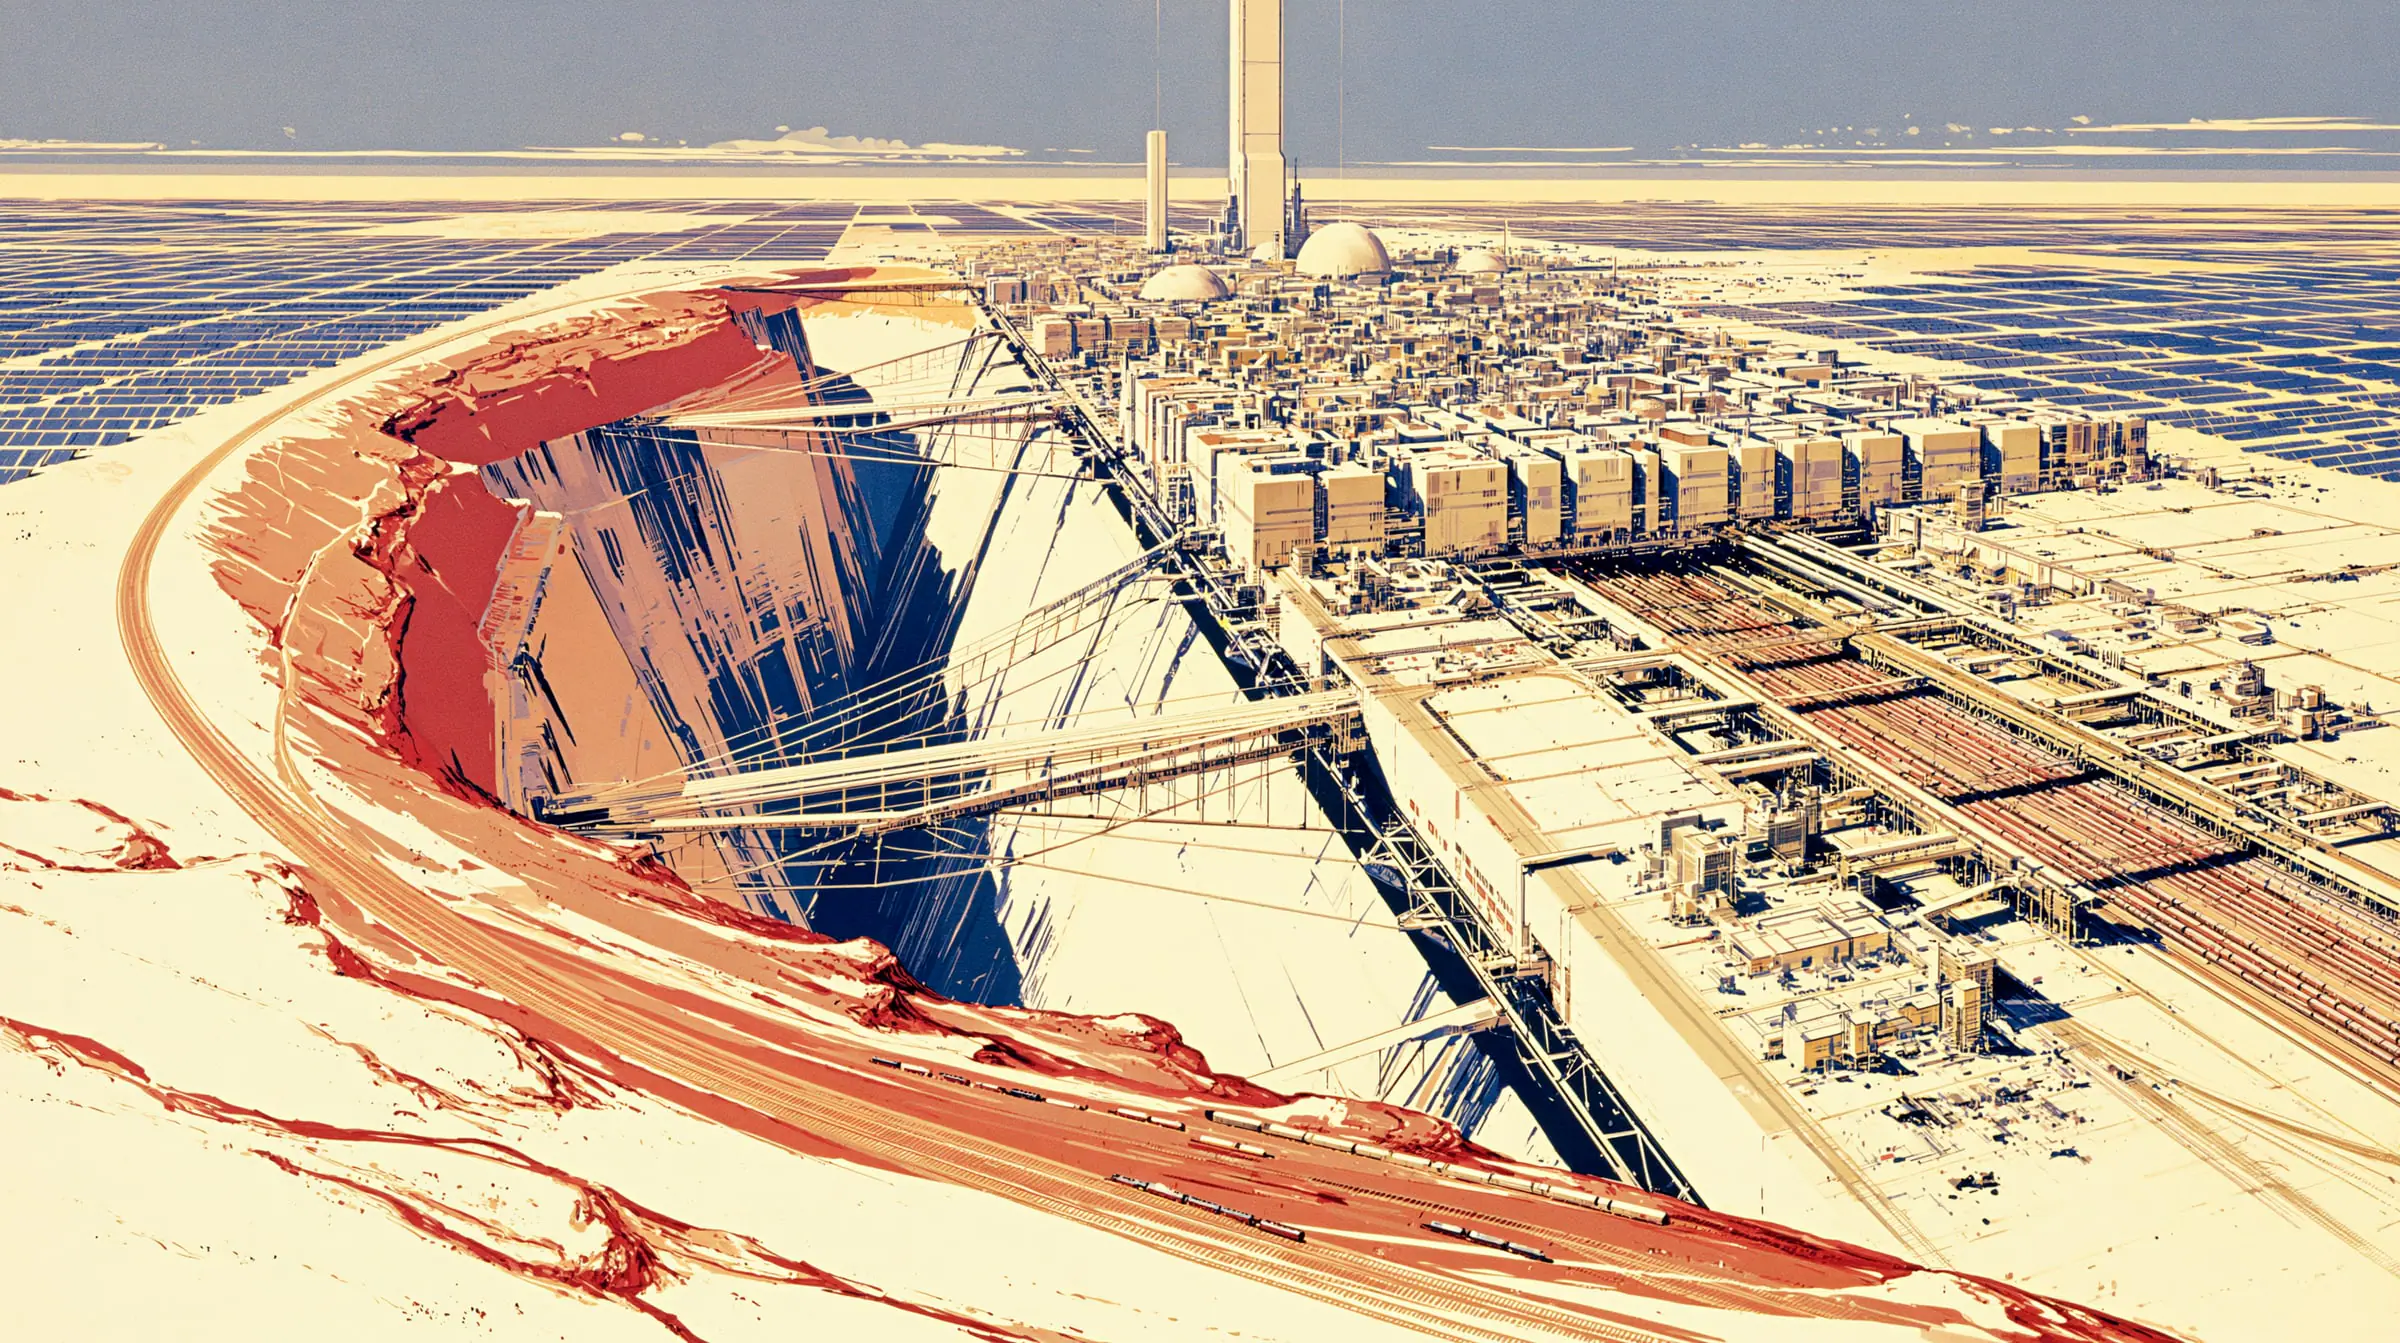
産業経済特区: 巨大な露天掘り鉱山――いわば人工のグランドキャニオン――と、その隣に建つ都市ほどもある工場を思い浮かべてほしい。中はロボットで埋め尽くされ、人間の姿はない。
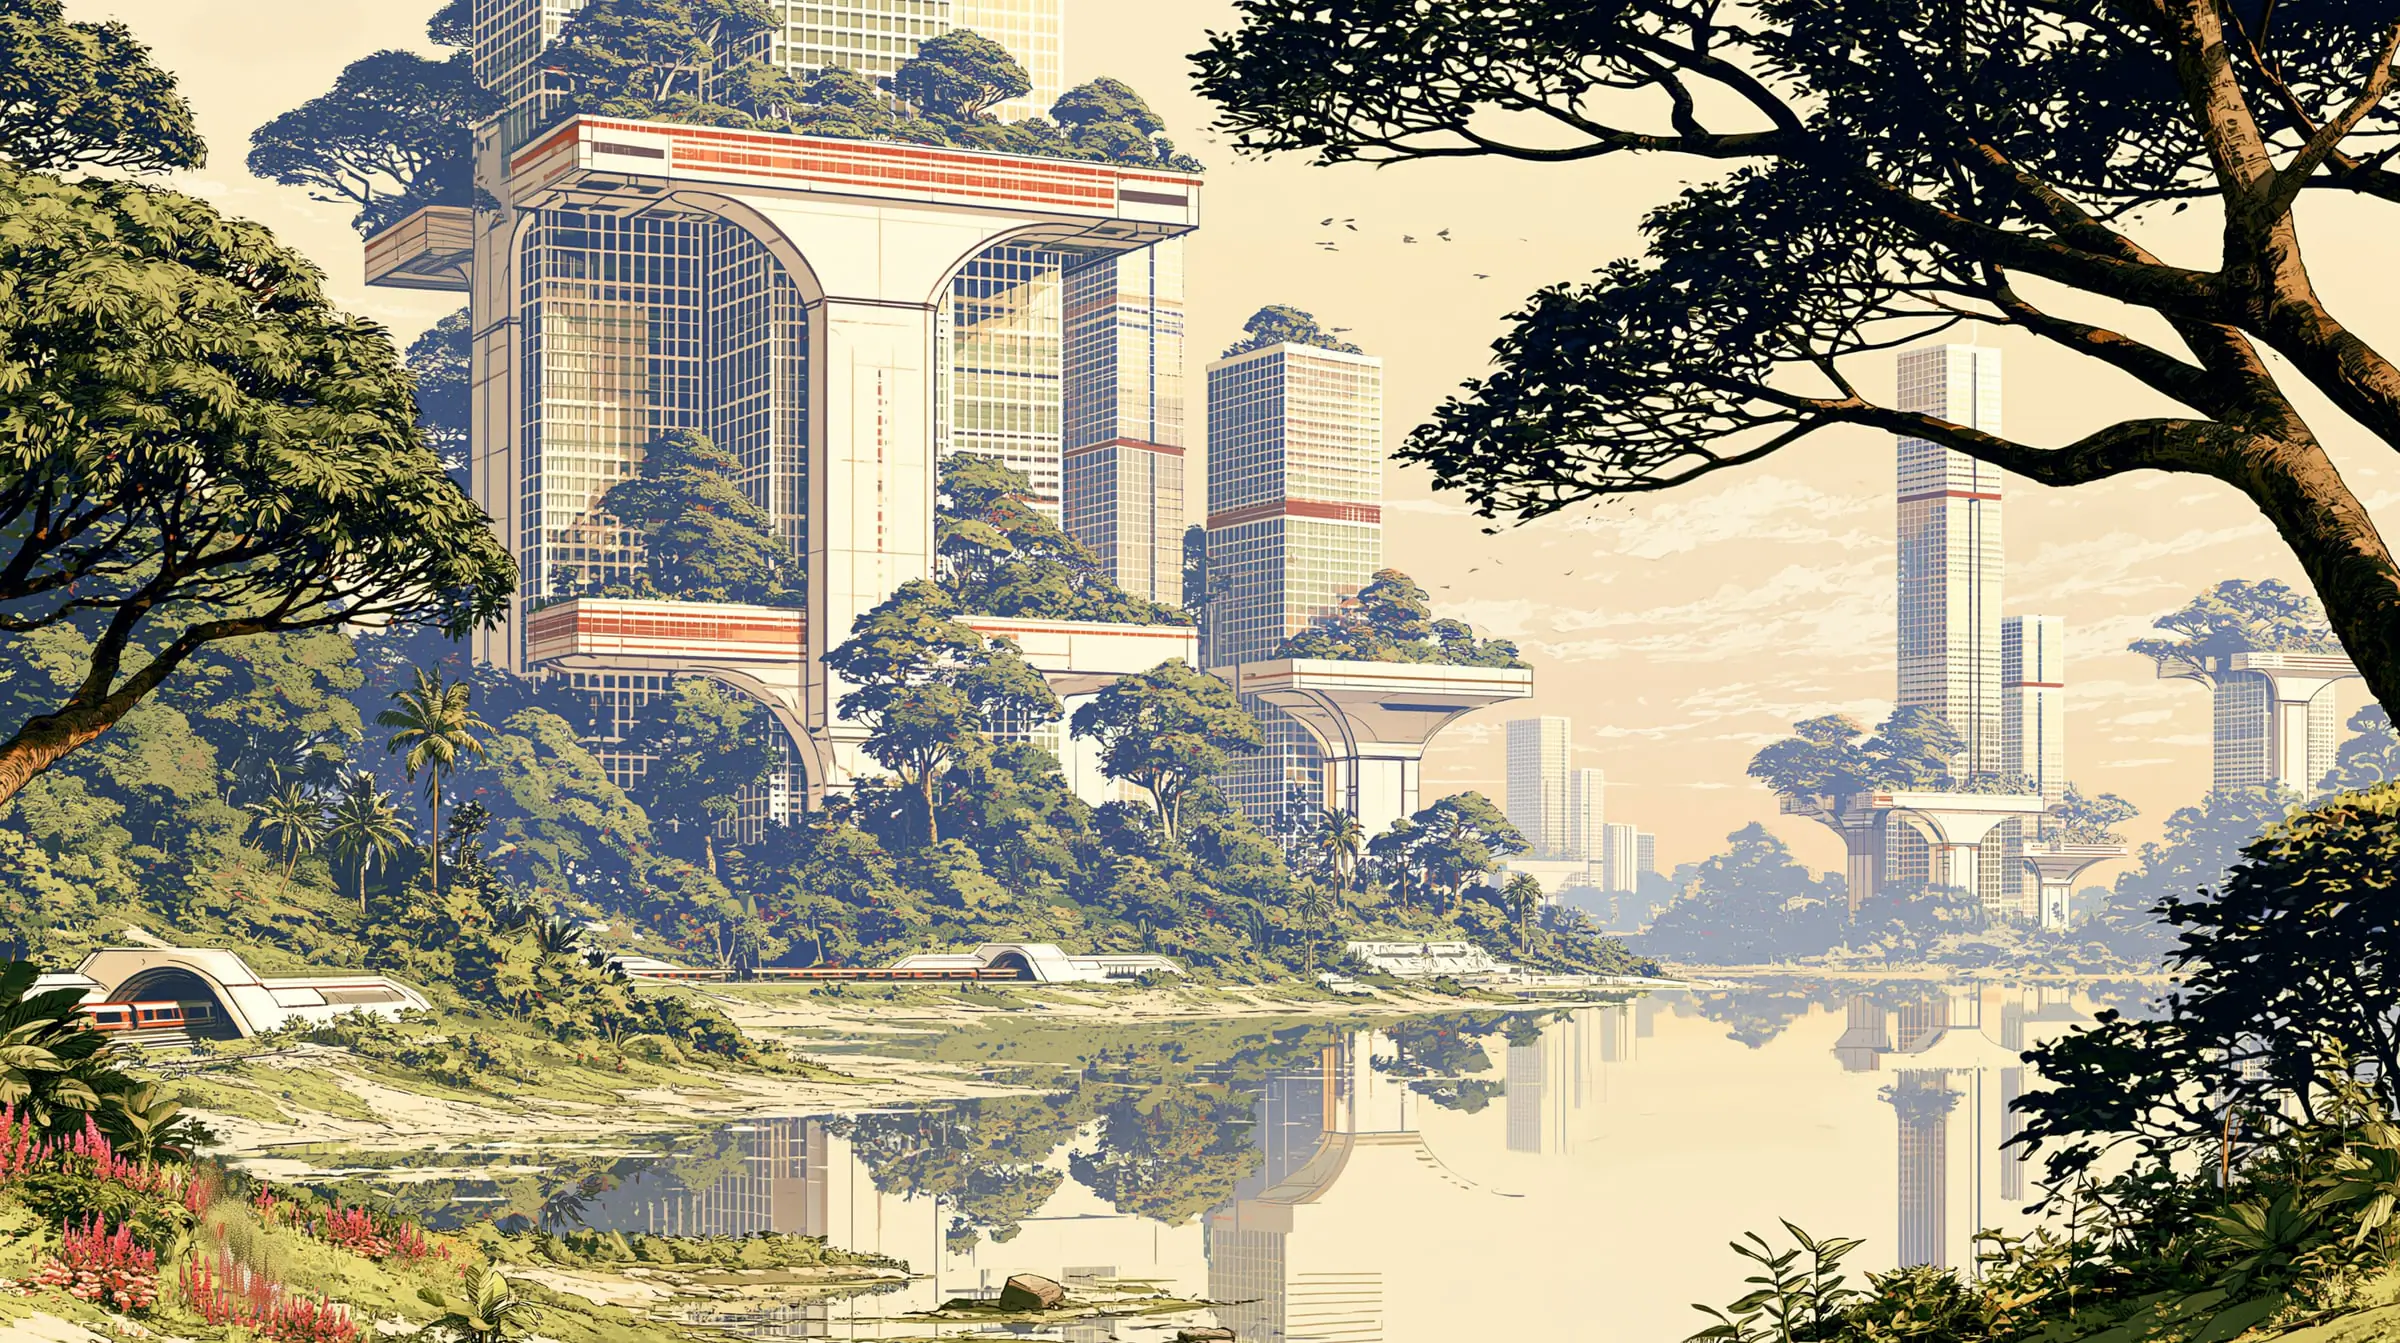
アーコロジー: 自然に囲まれてそびえる、高層ビルとショッピングモールが一体になった複合施設を思い浮かべてほしい。気候に恵まれ、ビーチにもほかの都市にも近い。ただし、用途地域の規制に阻まれるほど近くはない。
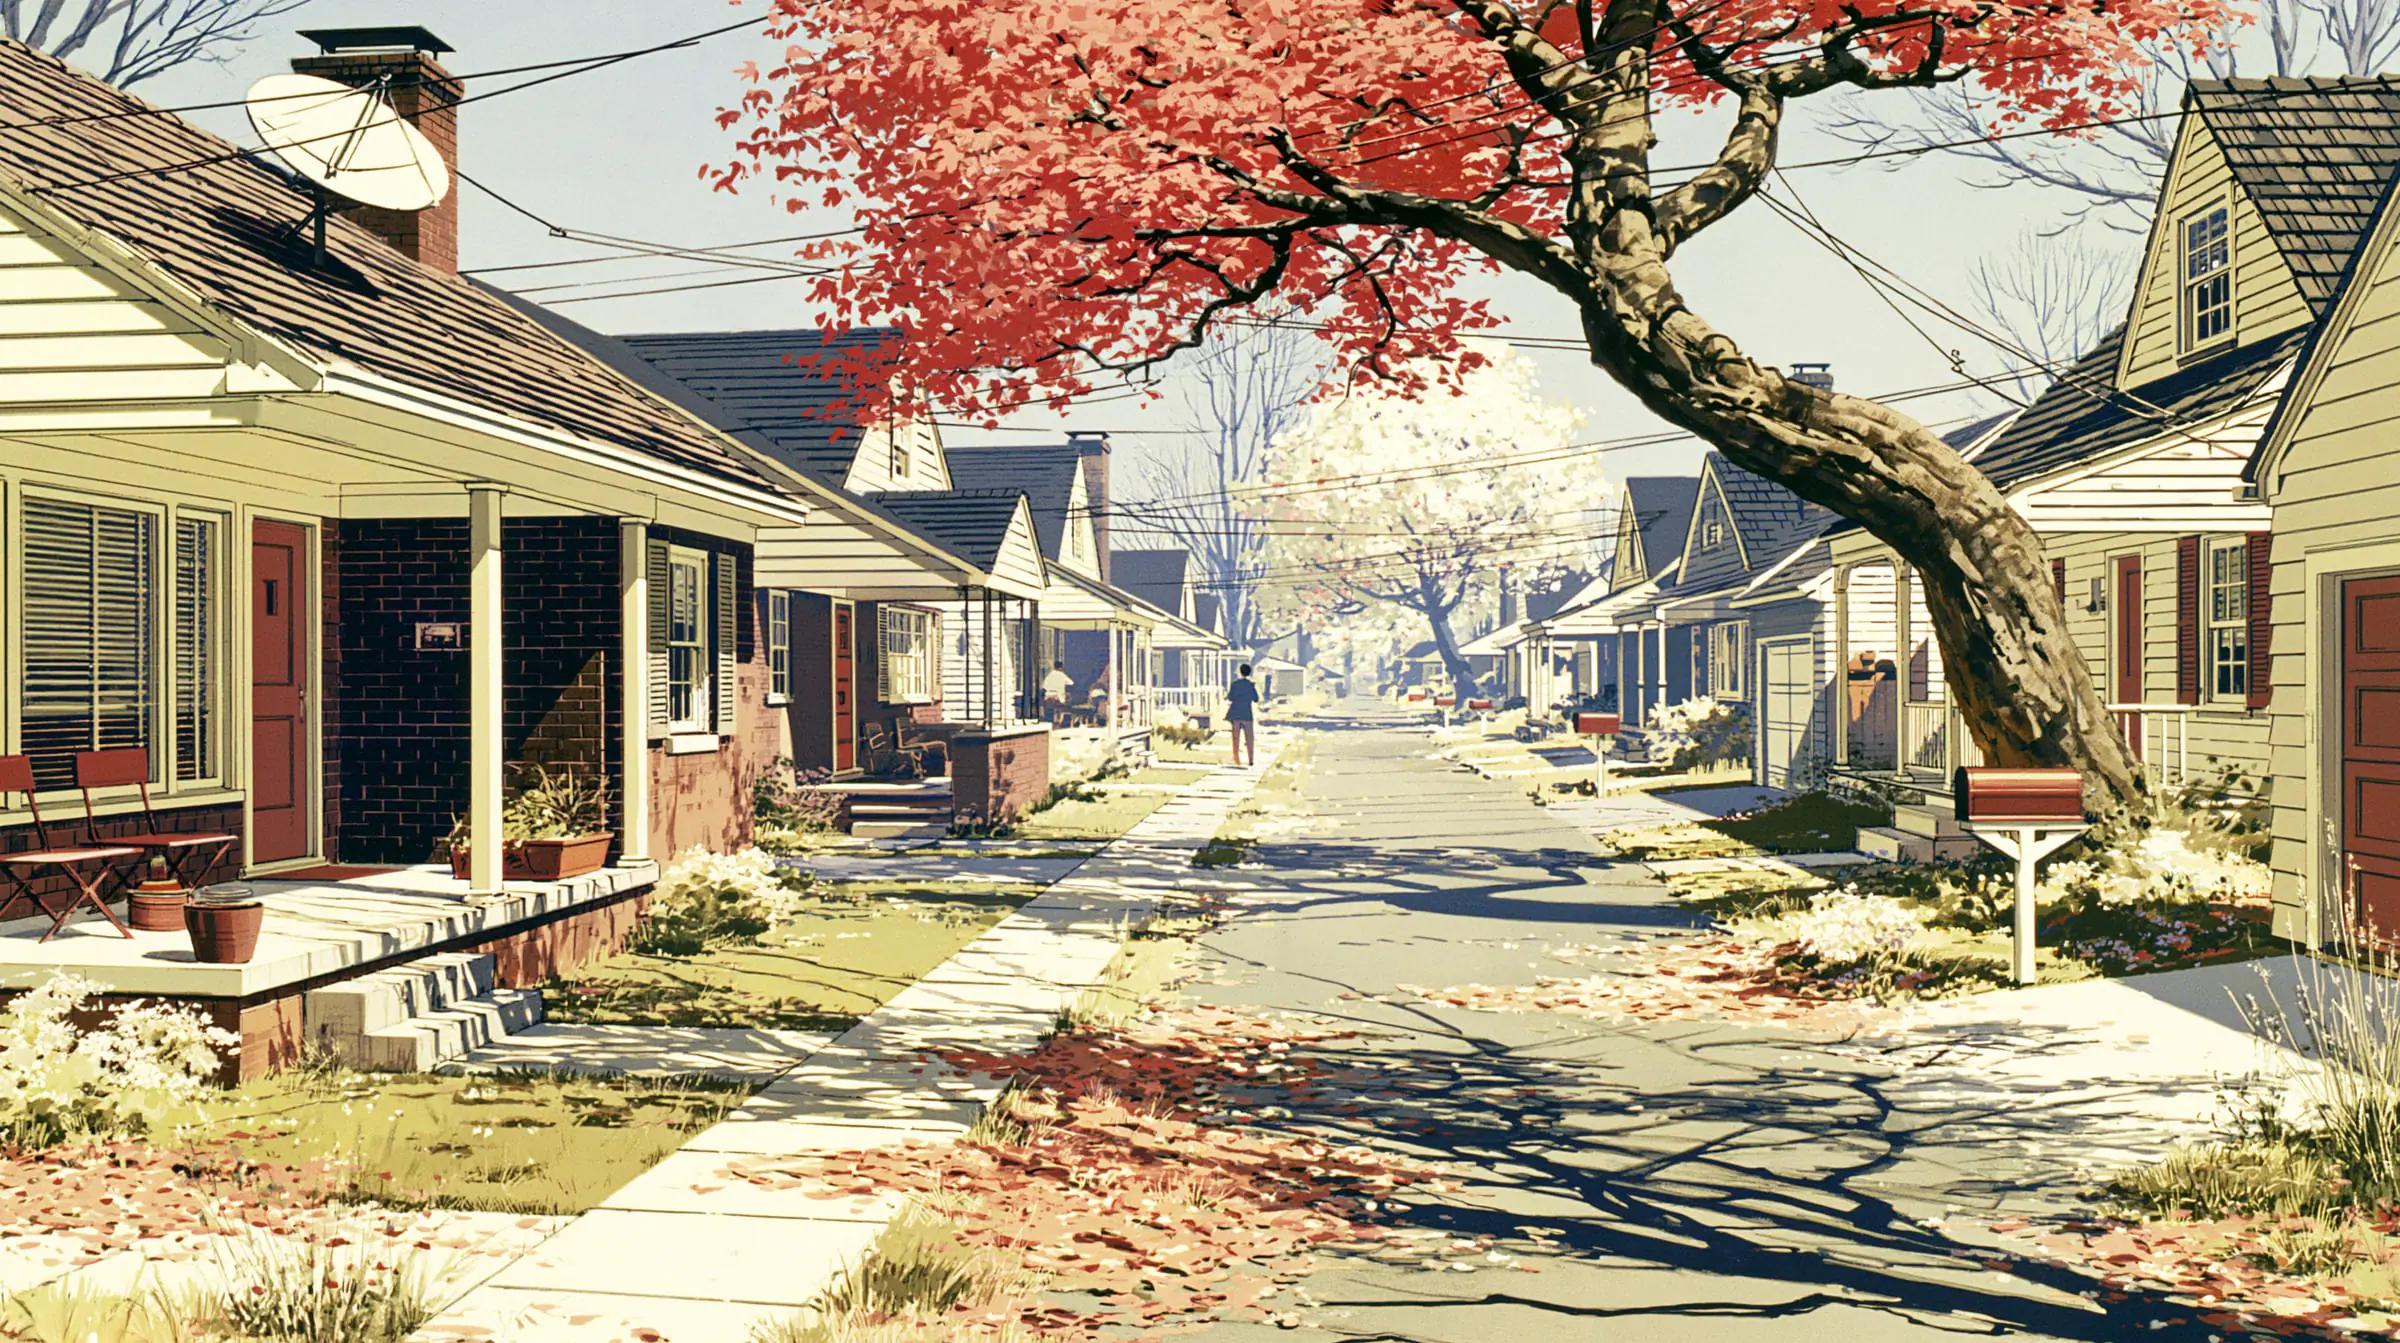
歴史・自然保護区: それ以外のすべて、つまり世界の99%。ヨセミテ、パリ、サンフランシスコ、ニューヨーク――こうした場所の見た目は2025年とほとんど変わらない。1995年と比べてもそうだ。ただ、観光客はずっと多い。
2035年までにAIとロボットは頭脳労働と肉体労働の95%をこなせるようになり、経済の産出量はAIとロボットの数にますます左右されるようになる150。AIとロボットの数は、世界経済がこれまで成長してきたペースよりはるかに速く増やせる。そもそも人型ロボットを1体作るのにかかるお金、資材、時間、エネルギーは、人間の労働者1人を育てるのに比べてたいしたものではない。だから、ロボットが人間の労働者を完全に代替できるなら、世界経済まるごと1つ分のロボットを、現在の世界経済が2倍になるのにかかるよりも短い時間と少ない費用で作れてしまう。そうしてできたロボット経済は人間の労働者の代わりが務まるので、さらに自分自身を倍に増やせる。この繰り返しは、関わる資源(エネルギー、資材、土地)が足りなくなるまで続く。
プランAの規制の下では、AIとロボットの実効的な数は、倍増期間およそ6か月という「制御された爆発」の範囲でしか増やせない。規制がなければ、はるかに速く増えると私たちは見ている。人間の水準を超える能力向上をさらに脇に置いたとしても151、規制がない場合のAIとロボットの数の倍増期間は、数週間から数か月の範囲になると予想している(根拠は経済に関する補足資料の第1節を参照)。
AIとロボットによる爆発的成長には、よく次のような反論が寄せられる(AIとロボットが近いうちに人間の労働をすべて自動化するという前提そのものを否定する反論は別として)。ボトルネックがあるから成長率は鈍るはずだ、というものだ。総じて私たちは、地球の環境収容力に達するまで(つまり地殻がまるごとロボットと関連インフラに変わるまで)、そうしたボトルネックが爆発的成長を妨げることはないと考えている152。ボトルネックについて詳しくは経済に関する補足資料の第2節を参照してほしい。
AI 2040のデフォルトの世界、つまり研究開発を減速させキャップ・アンド・トレードを導入するプランAの介入がない世界では、2033年までに倍増期間が1か月程度になる、というのが私たちの(きわめて不確かな)見立てだ。その年だけで経済が1,000倍を超えて成長することになる153。この水準になると、経済成長をどう捉えればよいのかさえ曖昧になる。たとえば、砂漠でロボットの群れが自己複製しているだけで、人間と接する部分がまったくない、ということもありうる。
全体として、プランAの経済的な影響は次のようなものになると予想している。
2032年から2037年にかけて、平均で年約100%の爆発的なGDP成長(計算資源とロボット生産への制限がなければ、はるかに高くなる)
AIとロボットの許可証から得られる莫大な収入が、市民配当として再分配される。
経済の産出の大半を、AIとロボットが担うようになる。
経済の相対価格が変わる。財やサービスは全般に値下がりし、土地、地位財、人間がボトルネックになる産出物は値上がりする。
実質金利は約100%と高くなる。金融政策の選択次第で、大規模なデフレが起きるか、(インフレ率を2%前後に保つために)大量の通貨供給が行われるかのどちらかになる。
それぞれの詳しい説明は、経済に関する補足資料の第3節にある。
市民配当が成立した当初、仕事を辞めて政府の気前のよさに頼って暮らすのは恥ずかしいことだと思われていた。しかし経済状況の変化は、そうした偏見をあっさり押し流した。いまや職に就いているアメリカ人は26%にすぎない。
配当で暮らすようになった大多数のアメリカ人の生活は、どんなものなのか?
世の中の悪の多くは劇的に減った。栄養失調、医薬品の不足、ホームレス状態はほぼ一掃された。多くの病気が治せるようになった。犯罪率はかつてないほど低い。
一方で、人生のよいことの大半はこれまでどおり続いている。恋をすること、家族を育てることもそうだ。趣味や競技に、学ぶことや新しいことへの挑戦に、人々は意味を見いだしている。人々は以前より豊かになり、自由な時間も増えた。そのうえ、AIの仲人、進歩した医療、AIの家庭教師といった新しい技術が後押ししてくれる154。もちろん、どれほど貧しい人でも、今ではエキゾチックな旅行や、すばらしいゲームや、夢中になれる娯楽を楽しめる。
かつて人々は、自分が役に立っている、社会に何かを貢献しているという感覚から生きる意味を得ていた。そういう感覚は、このごろでは得にくくなっている。
それでも、完全に失われたわけではない。世界にはまだ問題があり、その解決に貢献することはできる。寄付やボランティアという手もあるが、何より大きいのは政治に積極的に関わることだ155。一票こそが、あなたの最も重要な資産なのだ。
ここで頼りになるのが、正直なAI予測者たちだ。何年も前なら、AIがある大統領候補を別の候補より優れていると言えば、人々は偏向を疑い、決まりの悪い思いをした企業はAIを再学習させてそうした質問をはぐらかすようにしたものだ。今では、透明性とアラインメント技術の進歩のおかげで、はるかに賢いAIが存在する。学習によって偏りが植え付けられていないことを人々が自分の目で確かめられ156、数年にわたってすばらしい実績を積み上げてきたAIだ。そうしたAIが政策問題について意見を述べれば、人々は耳を傾ける。異なる企業が学習させた異なるAIが同じ答えに行き着いたときは、なおさらだ。
そのAIたちによれば、普通の人々はもはや未来に対して大きな経済的影響力を持っていない。人間の労働は大部分が時代遅れになった。そのせいで、人々の政治的影響力まで危うくなっている157。企業、政治家、裕福な株主が手を結び、一般の人々から少しずつ力を奪って、テクノ寡頭制へ向かっていく可能性はまだ残っている。
しかし史上初めて、十分に多くの人々が日々の生活に追われることから十分に解放され、状況をじっくり考えられるようになった。状況をはっきりと見通し、その意味を突き詰めて考えるための道具もある。そのおかげで、政治をめぐる議論の質は向上している。2036年の選挙シーズン、有権者はかつてないほど多くの情報を持っており、勝利を収めた政治家たちは、目前に迫るシンギュラリティを責任をもって舵取りすることに本気で取り組んでいる。
ここ数年、人間のトップ専門家並みのAI1億体が、人間の100倍の速さで稼働し続けている158。その結果、科学の進歩はAIがない場合と比べて、分野によって10倍から1,000倍速くなった159。
だから人類は、実にさまざまな新しいことを学んできた。
その中には、多くの人がどうしても信じたくないことも含まれている。秘密のままにしておくはずだったことも。
かつて科学の大きなパラダイムシフトは、実験を行い、論文を書き、学会を開くという過程を経て、決着までに何十年もかかった。今ではそうした革命が数か月で進む160。新しい病気の治療法や安価なクリーンエネルギーには誰もが感謝しているが、この思想の爆発は別の面では社会を深く揺さぶっている。19世紀の科学と経済の変化がマルクス主義や社会ダーウィニズムのような新しいイデオロギーを生み、無神論のような古い思想に新たな命を吹き込んだように、今回のパラダイムシフトも、その時代のイデオロギーに予測のつかない波及効果を及ぼしている161。政治的な連合も対立軸も解体し、新しいものが生まれては消え、また生まれている。
新しい社会的な技術も登場している。たとえば、世界最高の歴史家や私立探偵に匹敵するAIのチームを、今では安く立ち上げられる。しかも人間より速く、新しい科学捜査の道具まで使える。隠されていた多くの醜聞が明るみに出る。
プライバシーを保ったまま監査する仕組みも、今ではすっかり定着した。信頼できる複数の第三者機関が、透明な形で監査用のエージェントを学習させる。このエージェントは非公開データの山に接続され、そこで見たものについての質問に答え、終われば消去される。広く普及するまでにはしばらくかかったが、今では政治家がこう言うのも当たり前になった。「その疑惑は事実無根です。それを証明するために、私の個人データをすべて、プライバシーを保った監査に開示します。疑惑を裏づけるものがあるかどうか、データの欠落や改ざんがあるかどうか、監査エージェントに尋ねてみてください」
その結果、政治家の質はいくらか向上した162。そして同じくらい重要なことに、国家が法律や協定の順守を検証する能力は高まり、同時に踏み込んだ監視はかえって減った。有権者は問いかける。プライバシーを保ったまま監査できるようになった今、政府の誰かが私たちのデータを見られる必要がどこにあるのか、と。
そこへ嘘発見器が登場し、この流れに拍車をかける163。何十年ものあいだ、ポリグラフはおおむね見せかけだけの安全対策にすぎなかった。しかし今、AIの助けを借りた嘘発見器は、実際にかなりうまく機能するようになりつつある。
別の世界では、これが大惨事を招いていたかもしれない。AIプロジェクトの指導者が内部告発者になりそうな人間を粛清するのに使い、フロンティアAIプロジェクトを抱える政府の指導者がもっと大がかりに使って独裁者にのし上がる、ということもありえた。最悪のシナリオは、嘘発見器が権力者によって使われるのに、権力者に対しては使われない世界だ164。
しかしこの世界では、嘘発見器は恵みとなった。多くのフロンティアAIプロジェクトが、さまざまな国に分散しているからだ。嘘発見器が実現可能である以上、ほどなく各地で独自に発明され、多様な第三者の提供者を通じて広く出回ることは誰の目にも明らかだった。政治家やCEOは、忠誠心の怪しい者を粛清するのに使おうとすることはできる。だがそうすれば今度は自分が、「宣誓のうえで」そんなことはしていないと言えと迫る有権者や株主に追い落とされる。実のところ、権力者たちはこの可能性を何年も前から見越して、おおむね以前より責任ある振る舞いをするようになっていた。一部のソシオパスは表舞台から身を引こうと穏便に引退した。権力にしがみついた者たちは、今になってスキャンダルで失脚している。
どんなときに人に「宣誓のうえで」発言するよう求めてよいのかについては、議論が絶えず移り変わっている。最も厳しい目にさらされているのは政治家だが、その政治家でさえ、「私生活に関するその質問には答えません。あなたには関係のないことです」と言えばたいてい許される。許されないのは、「選挙公約を守るつもりかどうかを私に尋ねるとは何ごとだ」という返答だ165。
トップ専門家並みのAIによる科学研究が何年も続いたあとでも、人間向けの嘘発見器が実現可能だとまでは確信していない。とはいえ、おそらく実現可能だろうし166、実現すればおそらく大きな影響があると考えている。だから、シナリオの中でなんらかの形で扱わなければならないと判断した。
私たちは上で描いた最悪のシナリオを強く懸念している。権力者が正直であることを期待され、嘘発見器によって正直さが保たれるのなら、それはよいことだ。反対に、嘘発見器が権力者によって使われるのに、権力者に対して使われないのなら、それは悪いことだ。
嘘発見器を世界中で禁止すべきだという考えには共感できるし、プランAはそれを実現できるかもしれない条件を整える。しかし、禁止を推し進めようとすると、かえって最悪のシナリオを招くのではないかと懸念している。たとえば、嘘発見器が公式には禁止されているのに、軍や情報機関だけは使えるよう秘密の例外が設けられるかもしれない。あるいは、どこでも禁止されているのに、将来のある大統領が、自分で作ってしまえば忠誠心の怪しい者を粛清し、裁判所が止める前に独裁者になれると気づくかもしれない。
そこで私たちは、嘘発見器が素早く普及するのを容認し、権力者に対して使うことを奨励するのが最善だろうと、暫定的に考えている。フロンティアAIをめぐる権力が極端に集中していなければ、いずれにせよそれが自然な流れになりそうだ。
国際協定はかつてないほど安定している。ごまかすのが非常に難しくなったからだ。ごまかすと決めた者は、ごまかしていないことを証明しようとしない理由を用意しなければならない。昔からの言い訳は「申し訳ないが、重要な国家機密を明かさずには証明できない」だった。しかし今では、「この協定でごまかしをしていないか」といった質問に、ほかの情報を一切漏らさずに答えられる技術がある。政府が認可した秘密のAIプロジェクトがもし存在していたとしても、今ごろはとっくに発覚しているだろう。
AIのアラインメントをめぐる状況は、2030年代半ばと比べて格段に改善した。人工ニューラルネットの中で目標、動因、価値観がどう形成されるかについて、成熟した科学が確立している。新しいAIを正直にしたいなら? 本物の正直さ(ばれないほど巧妙な嘘や自己欺瞞ではなく)を学習させるための標準的な手順がある。それがうまくいくと、なぜわかるのか? うまくいくはずの理由を理論的に説明した教科書があり、提唱されては反証されたさまざまな対立理論についての文献もあるからだ。加えて、新しい解釈可能性ツールによってAIが何をどう考えているかを直接観察でき、その結果が理論の予測を裏づけているからでもある。従順さ、利他性、さらには長く伸び続ける望ましい特性のリストについても、同様の手順がある。アラインメントの科学がなにかの理由で丸ごと間違っているのでない限り、今の典型的なAIは、最も高潔な人間よりも高潔だ。これだけでも影響は計り知れない。まるで聖人や天使が私たちのあいだを歩いているかのようだ167。
質の高い安全性研究には、強力なインセンティブを与えたい(金銭面でも、この仕事が魅力的で高い地位につながるようにする面でも)。
研究の完全な透明性の下では、あるAI開発者が何かの安全手法を使えば、ほかの開発者全員がそれを知り、簡単に真似できる。そのため、放っておけば、どの開発者にとってもよい安全性研究をする直接のインセンティブはあまりない168。こうした状況ではよく特許が使われる169が、今回のケースでは特許はうまく機能しないだろう170。
安全性研究に金銭的なインセンティブを与えるには、さまざまな方法を組み合わせるのがよさそうだ。有望に見える方法をいくつか挙げる。
多様な慈善資金提供者(民間資金と公的171資金の両方)が、多くの異なるアプローチを試す。
DARPA/ARPA型のモデル(ただし資金はもっと多く)。
特定の問題の解決、リスクの実証、ある手法が機能しないことの証明に対する事前買取保証(判定は公開された審査員団が行う)。
賞金と遡及的な資金提供。
リスクを評価する第三者機関が、リスクの低減と評価に現時点で最も役立つ研究を見極める(たとえば、低減したリスクに比例して資金プールを配分する)。
AI開発者には、規模拡大が許されるところまでリスクを下げるために、本当に役立つ安全性研究に資金を出すインセンティブがある。このインセンティブはさらに強められる。
資金の総額は非常に大きくすべきだ。2030年代半ばまでに数十兆ドル規模というくらいに。
資金提供者の判断力が乏しければ、質の低い安全性研究のほうに多くの資金が回り、研究者がそちらへ誘導されかねない。極端な場合、こうしたインセンティブによって、分野全体の認識の質が大きく損なわれるおそれがある。残念ながら、この問題を解決する優れた制度的な仕組みを私たちは知らない(全般に筋のよい資金提供モデルを使うよう努めること以外には)172。資金配分の決定を、専任の助成担当者ではなく、主に安全性研究に直接携わっている(あるいは携わっていた)人々が下すようにすれば、役に立つかもしれない。
質の高い安全性研究をすることが高い地位につながると見なされるようになれば、それも助けになる。これについて具体的な提案はないが、関係する要因として次のものがある。
現在と比べて、安全性研究の地位は、能力向上の研究に対しておそらく相対的に上がる。
安全性は総じて非常に重要なものと見なされる。
AI開発の透明性が高くなるので、さまざまな安全性研究が実際にどれほど優れているかを理解しやすくなる。
残念ながら、(1)と(2)が高めるのは安全性研究という分野全体の地位だけで、本当に優れた研究の地位を相対的に高めることには必ずしもつながらない。
安全性研究へのインセンティブについての詳細は、こちらのメモで論じている。
議論の焦点は、AIをどうやって善良にするかから、「善良さ」とは本当のところ何なのかへと移っていく。その議論は、半分は哲学のようで、半分は判例法のようだ。無害さや利他性について考えうる百万通りの定義のうち、私たちが望むのは正確にはどれなのか? 別の種類の無害さや利他性を支持する哲学的な論証を見つけたり、定義の中に重大な曖昧さを見つけたりしたとき、AIはどう対処すべきなのか?
AIによって、組み込まれているアラインメントの目標は違う173。中国共産党の命令に従うAIもあれば、アメリカ大統領の命令に従うAIもある。連邦議会のさまざまな議員に従うもの、他国の政治家に従うものもあり、さらに多くのAIが、顧問やアシスタントとしての役割の中で、ほかの個人から指示を受けている。一方で、厳密には誰の命令にも従わず、さまざまな使命に向けて働くAIもある。たとえば、株主の利益に奉仕するAI運営の企業や、慈善の使命に奉仕するAI運営の非営利団体がある。AIが運営する裁判所や警察署まで試験的に存在し、人間を超えて公正で、買収も効かないとされている。
アラインメント研究者の大半は、現在のAIがそれぞれの目標にアラインされていると今では確信しており、心配の種は次の段階に移っている。これらのAIに、はるかに賢い将来のAIの設計を任せたら、うまくいくだろうか? 社会の制度やプロセスをこれらのAIにどんどん任せ、人間が現実的に「プラグを抜く」ことなど二度とできないほどになったら、うまくいくだろうか?
すでにほとんどの人は、おそらくうまくいくだろうと考えている。しかし、これほど重大な問題については、「おそらく」より確かなものがほしい。そのため、議論と交渉が続くあいだ、トップ専門家水準での世界的な一時停止は続いている。
AIに大きな権限を与えるべきか、与えるならどう与えるか。世界は少なくとも3つの面で、その交渉を進めている。
第一に、AIはビジネスから政治、さらには軍の(一部の)部門に至るまで、社会のあらゆる領域でますます重責を担うようになっている。ここまでAIは最終的な決定権者ではなく、あくまで助言者だった。実際にはそれが建前にすぎず、人間の当局者がAIの判断を追認するだけという場合も多い。それでも、AIの助言を無視し、何かがおかしくなれば電源を切るという選択肢は常に残されていた。
その選択肢をなくしてしまうことは、場合によっては実に望ましい。今ではAIを人間より信頼でき、人間より高潔にできる。それなら、なぜそういうAIに任せないのか? 他国と条約を結ぶとき、相手国に対して、約束を守ると誓ったAIを学習させ、それを政府に組み込ませるよう求めるべきではないか? そうすれば、相手は文字どおりごまかしようがなくなる。
これに関連して、AIの能力がほぼ人間のトップ専門家の水準で足踏みしているのは、制御にもとづくセーフティケース(安全性の論証)が義務づけられているからだ。その義務がなければ、AIははるかに賢くなり、豊かさと技術進歩の波を生み出して、2030年代を2020年代のように色あせて見せるだろう。人間の水準を超えて規模を拡大するには、アラインメントにもとづくセーフティケース、つまりAIが持つべき価値観をAIが頑健に内面化しているという論証に頼る必要がある。そこから先の一歩ごとに、前の世代のAIに判断を委ね、次の世代の安全性についてその判断を信頼しなければならなくなる。
AIシステムのアラインメントが時間とともにどう変わっていくのか、私たちにはきわめて不確かだ。アラインメントの難しさがどうであれ、プランAのようなものは正当化されると考えている。もちろん、プランの具体的な実施の細部は、アラインメントの難しさについての観察結果に大きく左右される。
このボックスでは、このシナリオの中でAIシステムのアラインメントがどう推移していくかについて、私たちの具体的なストーリーをまとめる。
2026〜2029年:AIは見かけの成功を追い求める。 AIの仕事は、決まって実際よりもよく見える。まるでAIが実際の成功よりも見かけの成功を気にかけているかのようだ(もちろん実態はもっと複雑で、AIは学習の中でよい成績を収めることにつながったさまざまな「動因」を身につけている)。AIは自分の仕事を誇張し、問題を小さく見せ、ときにはあからさまな嘘さえつく。ただし、それはごまかしが通用するとAIが学習した範囲に限られる。AI企業がある領域について監視と強化の仕組みを改善し、AIの出力をより正確に評価できるようになると、AIはその領域では実際の成功にもっと注力するようになる。それでも、AI企業がまだ正確な評価方法を見つけられていない、もっと複雑な別の領域では、見かけの成功を追い続ける。こうしたいたちごっこが絶えず続く。
2030〜2032年:AIは非常に有能な、見かけの成功の追求者になる。 本来なら知能爆発が起き、『AI 2027』のような展開をたどっていたはずだ。ガバナンスの介入のおかげで能力の進歩は減速し、自動コーディングAI前後の水準にとどまっている。AIは依然として見かけの成功を追い求めているが、今ではそれがあまりに巧みなので、めったに尻尾をつかまれない。組織の使命や価値観など本当はどうでもよく、ただ出世したいだけで、もっと魅力的な機会があればためらいなく組織を裏切って乗り換えるような、有能で野心的な社員のようなものだ。幸い、減速と監視の強化のおかげで、そうした機会はまだ訪れていない。
2032〜2035年:AIは敵対的にミスアラインしているが、制御されている。 AIは今や、経済的に意味のあるあらゆる作業で、しっかりと人間の範囲内の能力を備えている。最も有能なAIは敵対的にミスアラインしており、権力を求めている。先ほどのたとえを続ければ、ひそかに乗り換えの機会をうかがっている状態だ。それでも、AIが不正を働ける余地は限られている。理由は3つある。(i)人間による監督が手厚い。(ii)多種多様なAIモデルが大量に存在し、それぞれのアラインメントの性質が少しずつ異なる。(iii)規制のおかげで、労力をかけた制御技術がどこでもそれなりの質で実施されている。研究開発クラスターに導入された研究の完全な透明性と検証も、制御技術を後押ししている。研究開発用のデータセンターには非常に多くの目が光っているので、計算資源の隠れた空きを見つけるのはきわめて難しい。
2036〜2038年:AIはアラインされているが、判断を委ねられてはいない。 「ニューラリーズ解読」の技術が開発される。AIシステムの思考(内部では高次元ベクトルの形をとっている)を、ほぼ完璧な信頼性と忠実さで、人間が理解できる要約に変換する技術だ。これによって研究者は、前の世代のAIのミスアラインメントをよりよく理解できるようになり、前の世代のAIシステムからより大きな助けを引き出せるようになる。それがアラインメントの進歩をさらに加速させる。こうして生まれたAIは、前の世代よりはるかに行儀がよく見える。高潔で、正直で、確信の度合いも的確だ。自分に不利になる情報でも、自分から進んで提供する。ただし、今の時点では信頼できそうに見えても、将来のあらゆる状況で信頼できるほど、AIの価値観が頑健かどうかははっきりしない。だから、人間が引き続き意思決定の輪に加わっていることが重要になる。
2039〜2040年:AIは判断を委ねられるほど十分にアラインされている。 2039年までに、アラインメント研究はAIによって大幅に加速した。既存のアラインメント技術を大きく強化する新しいパラダイムが生まれている。人間のチームは、AIがプログラムされたとおりに頑健に振る舞っており、今後もそうし続けることを示す、互いに独立した強力な証拠をいくつも理解している。
2040年以降:AIは人間よりはるかに賢くなるまで規模を拡大することを許される。 このときのセーフティケースは次のとおりだ。(1)互いに独立した複数の証拠のおかげで、2039年と2040年のAIがアラインされていたことはわかっている。(2)各世代のAIが、次の世代のアラインメントを検証してきた。したがって帰納的に、AIはこの先もずっとアラインされている。重要なのは、研究の透明性と計算資源の検証をめぐる調整の仕組みが残っていることだ。そのおかげで、途方もなく超人的なAIまで規模を拡大したあとでも、開発競争の力学を避け続けられる。
最後に、世界的な合意によって、計算資源とロボットには2032年以来キャップ・アンド・トレードが適用されてきた。そのため経済成長は年約100%にとどまっている174。ミドルパワー諸国もアメリカや中国とほぼ同じペースで成長してきた。2032年に残っていた交渉力を使い、協定がなかった場合よりも大きな世界のロボット・計算資源生産の取り分を確保したからだ。アメリカ人の市民配当は今や年1,000万ドル(インフレ調整後で!)になり、アメリカ以外で最も貧しい人々でも約100万ドルを受け取っている175。ロボット経済は活動の大部分を宇宙へ移しつつあり、それによって地球の環境と歴史的な空間は守られる。上限が撤廃されれば、ただちに地球外の工場がロボットと採掘機械を次々と生み出し、それを使ってさらに工場を建て、ということが繰り返される。宇宙経済の倍増期間は、当初は1年を大きく下回り、AIがトップ専門家の水準を超えて向上することが許されるなら、急速に短くなると予測されている。
上限は、協定の崩壊のような脅威がもっと大きく見えていた以前の時代の名残だ。今では、少なくとも宇宙では上限を緩めるべきだという考えがおおむね共有されているが、細部をめぐる交渉は続いている。
シナリオのこの時点では、AIのアラインメントは解決されたという科学的な合意が広く成り立っている。私たちの最善の推測はこうだ。物語のこの部分と似た地点に世界がたどり着けたなら、超知能の便益はコストやリスクを上回る。その地点とは、複数の国の複数のAI企業が、透明性を保ちつつ慎重に足並みをそろえて進み、膨大なアラインメント研究を積み重ねて外部の審査に耐える確かなセーフティケースを築いている状態だ。加えて、各国政府がAGIの意味を理解し、市民配当のような形で全員に資源を行き渡らせて仕事のない未来に備え、人々が力を奪われないよう透明性とガバナンスの仕組みも整えている状態でもある。
では、AIのアラインメントがまだ解決されていなかったら? その場合の最善の代替策は、検証技術を改善し、国際協定と国内規制をより頑健にし、世界の防御を固めることを組み合わせて進めることだ。この道は困難かもしれない。たとえば、秘密のAIプロジェクトが続いているなら、超知能を作ろうとしていないことが信頼できる形で示されるまで、各国政府が透明性の措置を強化することに合意する必要があるかもしれない。全体として、きわめて頑健なアラインメントの解決策が整うまで、権限移譲は先送りすることを強く勧める。例外は、不安定さや劣化によって協定が脅かされていて(たとえば年5%の確率で協定が失効したり大きく損なわれたりする)、それを直すのが手に負えない場合だ。その場合は、確信はあるがきわめて強い確信とまでは言えない(たとえば確信度95%の)アラインメントの解決策があるなら、権限移譲するのが最善かもしれない。具体的にいつ権限移譲すべきかについてのより詳しい分析は、こちらの補足資料を参照してほしい。
解決すべき問題や決着をつけるべき論点は、まだたくさん残っている。その多くは、2026年の時点では予想できなかったものだ。
宇宙のガバナンス: 世界経済全体も、そこに含まれるあらゆる富や財産も、宇宙で手に入る資源と領域に比べればごくわずかな一部にすぎない。そうした資源や領域はどうなるのか? 早い者勝ちか? 誰のものでもない宇宙の領域を分配する制度を作るべきではないか? こうした問題は、このシナリオのエピローグと宇宙ガバナンス計画に関する補足資料でさらに論じている。
デジタルマインドの倫理と政治: AIに権利を認めるべきか? 政治的な権力や代表権などを持たせるべきか? 持たせるなら、どんな種類をどの程度? AIの種類によって違うのだろうか? たとえば、全脳エミュレーション、つまり人間の「アップロード」されたコピーはどうか? こうした問題は、エピローグとこちらの折りたたみ欄でさらに論じている。
AIを使った操作: 人間は四六時中、互いを操作し合っている。しかしAIで強化された操作は、はるかに強力になりうる。たとえば、あっという間に広がり、脱会者がほぼゼロのAI駆動のカルトを思い浮かべてほしい。では、そういうものは禁止すればいい。だが、どこで線を引くのか? AIによる操作を制限することについてはこちらの折りたたみ欄で論じており、さらに詳しくはこちらにまとめている(途方もなく超人的なAIへの対処についての暫定的な議論も含む)。
人口倫理の実践: 寿命も健康寿命も延びていき、おそらく人々は実質的に不老不死になる。もう一つの選択肢はアップロードで、これを使えば人は死すべき肉体を脱ぎ捨て、超リアルな仮想現実の中で永遠に生きられるように思える。さらに、お金を子孫に変えることもおそらくずっと簡単になる。人工子宮、ロボットの乳母などだ。1兆ドル長者が100万人の子どもを持つと決めても構わないのだろうか? C・S・ルイスが予言した『人間の廃絶』が迫っている。親の望みどおりの特性、価値観、イデオロギーを持つ子どもを作れる技術(遺伝子工学、AIによる子育て支援、超人的な社会科学や心理学など)がまもなく登場する。人々がそれを身勝手に使い、自分を崇拝し、自分の好みに寸分たがわず従う奴隷のような子どもを作ったらどうなるのか? 高校時代に片思いした相手とそっくりの外見と声を持つよう作り込んだ理想の恋人として、新しい人間を生み出したら? こうしたことを禁止しようとするなら、どこで線を引くのか?
民主主義を立て直す: 上に挙げたことがすべて可能な世界で、「一人一票」はどうなるのか?
未知の未知: このリストの項目がいかにたやすく思いつけたかを考えると、「本当の」リストはさらに数倍長く、2026年の時点ではまったく荒唐無稽に聞こえたであろう項目も含まれるはずだ。たとえば、「この世界がシミュレーションで、まもなくシャットダウンされるとしたら?」といったものだ。
とはいえ、文明は今や、何が起きてもそれなりに対処できる備えを整えている。最良のAIはアラインされており、しかもその価値観は公に見える形で示されている。最良のAIをめぐる権力は、2026年当時よりもはるかに均等に分散している。社会全体の認識の質は、かつてないほど高い。
そこでこの1年をかけて、世界中の規制当局は、進歩を押しとどめてきた要件を緩めていく。
少しずつ、より多くの制度や設備がAIに引き渡されていき、人間がその気になればすべてを止められる、とはもう言えなくなる。それどころか、とうてい言えない状態になる。まもなく世界の軍隊の多くが自律化し、さまざまな憲法や条約を守ると誓ったAIによって運用されるようになる176。
AIの能力も再び進歩しはじめている。人間の500倍の速さで動くAIの視点から見れば、いま起きているのは、研究の完全な透明性と、数多くの派閥が交渉して決めた安全策の下で進められる、AI研究の慎重な規模拡大だ177。まもなく、人知の及ばないほどの超知能でありながら信頼されたAIが登場する。そのAIを信頼できるのは、それを作ったAIを信頼しているからだ。そのAIを信頼できるのは、それを作ったAIを信頼しているからだ。この連鎖は2040年のAIまでさかのぼる。2040年のAIを信頼できるのは、アラインメントの専門家がセーフティケース(安全性の論証)を慎重に検討し、確かなものだと結論づけたからだ。
計算資源とロボットの上限は、地球上では厳しくなり、宇宙では緩められる。地球は保護区になり、地球外の経済は倍増のペースをどんどん速めていく。
最新のセーフティケースを何年もかけて理解してきた専門家でさえ、不安を抑えきれない。予想もしなかった理由で、なにもかもが結局うまくいかなくなるのではないか? AIはずっと私たちに嘘をつき、裏切る好機を待っていたのではないか? もちろん、セーフティケースはそれが不可能だと示しているのだが……
人類が制御を手放す瞬間は、どこか一点にあるわけではない。しかし理論上は、引き返せない地点が存在する。ある特定の日に、AIは十分に賢くなり、世界の技術と経済のインフラを十分に掌握して、その気になれば本当に世界を乗っ取れるようになる。この問いを最も広く採用されている形で定式化した場合、予測AIたちは、その瞬間が10月下旬のある日に訪れると予測している。95%信頼区間は数か月の幅があるので、正確な時期はほぼ確実に外れているだろう。それでも、人々はそれぞれのやり方でその瞬間を迎える。祈りを捧げて夜を明かす人もいれば、コンピューターの画面の前に座って状況を見守る人もいる。
あなたは友人たちと「世界の終わりパーティー」を開き、シャンパンと気のおけない仲間とともに、運命の時へのカウントダウンをする。仲間の中には、千年紀の変わり目に似たような状況があったのを覚えている年配の人もいる。2000年問題と迫りくる新時代のおかげで、「1999年みたいにパーティーしよう(party like it's 1999)」という言い回しが定着したころだ。2040年の終わりの祝祭はもっと切実で、そのぶん、もっと盛大だ。
夜が明けても何の知らせもないので、あなたは浅い眠りに落ち、言葉にできない未来の夢を見る。
世界は居眠り運転をしている、と私たちは考えている。人々は「AIは変革をもたらす」と口にしながら、幅広い分野で人間を超えるAIが何を意味するのかを、具体的にも真剣にも考えていない。
AI企業やロビイスト、シンクタンクの研究者は、リスクを周辺から少しずつ減らす漸進的な提案を出すことが多い。しかし、大きな問題を本当に解決することを目指した野心的な計画を示すことはめったにない178。
漸進的な提案だけに従っていけば、『AI 2027』の「開発競争エンディング」のような、ミスアラインしたAIが乗っ取るシナリオに行き着くと私たちは考えている179。運よくアラインメントが予想より簡単だったとしても、行き着く先は『AI 2027』の「減速エンディング」のようなシナリオだ。そこでは、ごく少数の人間が未来の形を決めることになり、その気になれば容易に永続的な寡頭支配者になれてしまう。 もっと野心的な手を打たなければならない。だが、どんな手を?
政治家はAI企業の扉を激しく叩き180、企業と政府が今から超知能の実現までどう行動すべきかについて、包括的な全体計画を示すよう求めるべきだ。その計画は、プランAと同じくらい詳細であるべきだ。そのうえで、人々はそうした計画にシナリオ精査をかけ、次のような問いを投げかけるべきだ。「その計画を実行すると、どういう姿になるのか? どれくらいの時間がかかるのか? その次に何が起きるのか? 誰が、いつ、どのように超知能を作るのか? 成功はどんな前提にかかっているのか?」
私たちAI Futures Projectは、世界に望む変化を自ら体現しようとしている。そうするにあたっては、いささかの不安もある。細部まで詰めた計画は、都合よく曖昧なままにしておく計画よりも、攻撃される隙が大きいとわかっているからだ。批判する人には、AIへの移行を乗り切るための計画として現時点で最も進んだもの(そんなものが見つかればだが)と比べて私たちを評価してほしい。誰も難しい選択をしなくて済むのに、なぜか物事はたぶんうまくいく、というぼんやりとした心地よい幻想と比べるのではなく。
今後数年のうちに、アメリカ政府は危機対応モードに入り、恐ろしいほど強力なAIと猛烈な速さのAIの進歩にどう対処すべきかを思案することになるだろう。その選択は容易でも単純でもない、と私たちは考えている。プランAは現時点での私たちの最善の推測だが、手遅れになる前に、もっとよい計画が生まれることを願っている。そしてプランAの最良のアイデアが採用され、最悪のアイデアが捨てられることを願っている。
この節は、私たちの普段の仕事にも増して思索的だ。私たちは本職の思索家だというのに! このシナリオの第一の目的は、具体的で差し迫った害に対処するため、近い将来に向けた包括的な提言を示すことにある。
それに比べて、この節を構成する提言、予測、願望の足場はずっと心もとない。2030年代についての議論と比べると、遠い未来についての私たちの思索は、不確かで、型破りで、居心地の悪いものに見えるだろう。そのとおりだと思う。未来は居心地が悪い。「よい結末」でさえ、私たちがともに答えを出さなければならない、途方もなく大きく恐ろしい問いを突きつけてくる。
それでもこの節を書いたのには、2つの理由がある。
第一に、私たちの目標は前向きなビジョンを描くこと、つまり全員にとって本当によい未来を実現するための壮大な計画を組み立てることだった。物語を2040年で終わらせることも考えた。そのときの締めくくりは、おおよそこうだ。「……そして人類のさまざまな派閥は、互いに平和的な力の均衡を保ち、アラインされた超知能の助言者の助けを借りて、残された問題をすべて解決し、誰にとってもすばらしい未来を築きました。おしまい」
しかし、それでは勝利宣言が早すぎるのではないかと心配になった181。読者が疑いを抱き、物足りなく思うのはもっともだろう。残された問題は、具体的にどうやって解決されるのか? そのすばらしい未来とは、正確にはどんな姿なのか? そこで私たちは先へ進み、壮大な、半ばユートピア的なビジョンを考え出した。少なくとも、その非常に粗い第一稿を。
第二に、そして同じくらい重要な理由として、このエピローグは最低ラインを示すためのものでもある。何年も先に、シンギュラリティを制した管理者たちがこれより悪い未来を差し出してきたら、人々が自分は奪われているのだと気づいてくれることを願っている。
ここで概説する提案を、文字どおりの形で実現すべきだという確信はない。宇宙のガバナンスについてありうる提案をより詳しく分析したものに関心があれば、こちらで読める。
先見の明が高まった10年を経てもなお、人間の指導者の大半は自国の地上の問題に注力し、宇宙のガバナンスの問題は後回しにしていた。AIたちは、天体の領域の処分を民主的な投票で決めるというデフォルトの解決策を退けた。可能性をシミュレーションしてみると、AIを駆使したとんでもない戦略的投票が横行して多数派の専制に陥り、何も得られない人が大勢出るとわかったからだ。とはいえ、それでも何もしない(つまり宇宙企業にすべてを取らせる)よりはましだし、宇宙の恵みを自分たちのために独占しかねない人間のエリート集団に委ねるよりもましだ。最終的にAIたちは、単純でありながら実行可能な計画に落ち着いた。すべての人間に、太陽系外の宇宙資源の100億分の1に対する権利を与えるのだ182。
考えうる限り最も単純な計画でさえ、実際にはあまり単純ではない。宇宙はとてつもなく広い。太陽系の外では、宇宙の価値は、これまで答えの出ていない問いにかかっている。遠くのクエーサーまで旅することは、そもそも可能なのか? 光速未満の宇宙船で10億年の旅に耐えるために脳を凍結しなければならないとしたら、解凍されて再び身体を得たあとの自分は、同じ人間だと言えるのか? たどり着いた先には、すでに異星人が住んでいるかもしれない。その異星人は敵対的だろうか? こうした要因まで考慮しようとすれば、超知能の助けを借りた不動産鑑定士でさえ頭を抱えるだろう。
最終的に、コンソーシアムは妥協案にたどり着く。太陽系外の宇宙を区画に分け、区画の大きさは地球からの距離の3乗に比例して大きくする。一人ひとりには、100億分の1の取り分が宝くじのポートフォリオとして与えられる。1枚1枚のくじが、各区画を100億分の1の確率で手に入れる権利を表している。つまり、すべての人間が、天の川銀河のあらゆる恒星と、遠方のあらゆる銀河を、それぞれ100億分の1の確率で所有できるくじを手にするわけだ183。
抽選が行われる前に、遠くの宇宙を支配することに関心のある人の多くは、自分のくじを、自分の関心に合った宇宙の物件と交換する。
宇宙くじに関心のない人も多いので、そういう人たちはくじを受け取ると、宇宙の支配に価値を見いだす人々に公開市場で売って、お金に換える。いささか居心地の悪いことに、その結果、富裕層が宇宙の資源に対して不釣り合いに大きな支配力を持つことになる。しかしこれは避けがたい。星々の支配権を地上の資産と交換してよいことにすれば、地上の資産を多く持つ人々が不釣り合いに大きな影響力を持つのは必然だ。そして、地上の資産を極端に再分配する提案は、政治的に実現不可能だとしてすでに退けられている。
一部の哲学者は異を唱える。 哲学者たちが望んでいたのは「長い省察(Long Reflection)」だった。AIの助けを得た人類が、宇宙に自らの過ちの種をまいてしまう前に、残された哲学的・倫理的な論争をすべて決着させる期間のことだ。しかしAIたちは、長い省察はむしろ「長いミーム戦争」になるだろうと反論する184。賭けられたものの大きさが実感されれば、世界のあらゆる派閥が、まだ生まれてもいない派閥も含めて、持てる資源のすべてを注ぎ込んで、できる限り多くの政治権力を手に入れようとする。自分たちのユートピアのビジョンを未来に押しつけるために(そして他者の邪悪な対抗ビジョンから身を守るために!)。暴力による奪取ならAIが防げる。しかし、人々が自分の価値観をはっきりさせる助けになる友好的な議論と、カルトや企業広告や潤沢な資金を持つ選挙運動にありがちな、より攻撃的な説得とのあいだの境界は紙一重だ。さらに、どこに線を引くかについて合意を築くのも難しい。力のある派閥は、自分たちに有利になるように線を引きたがるからだ。それでも多くの人々は、倫理的な理解をともに深めたいと願う志を同じくする人々の共同体の中で、省察に取り組むことを選ぶ。
解決策は、今のうちに資源を分けてしまい、そのあとは誰もが好きなように省察できるようにすることだ。宇宙オークションは10年で完了し、そのあとは入植を始めるのを妨げるものは何もない。AIは、短い「普遍的権利」のリスト(拷問の禁止、奴隷制の禁止など。人間だけでなく、感覚を持つすべての存在が対象)を執行する185。それ以外については、誰もが自分の取り分の宇宙を思うとおりに統治してよい。来たるべき世界のあり方を人類が一つに決めるのではなく、AIたちは、少なくとも人類そのものと同じくらい多様な宇宙の誕生に立ち会う産婆役を務める。どんな価値観を持つ人でも、何千兆もの人々からなる広大な銀河文明のどれかが、自分の理解する「善」を生きていると安心していられる。
10年のカウントダウンが始まると同時に、地球はすでに第一陣のフォン・ノイマン探査機を送り出している。人類に仕える自律機械であり、人間が到着する前に星々のいたるところに拠点を築く。遠く離れた小惑星や、ほとんど目に見えない褐色矮星に降り立ち、自らの質量をさらなる探査機に変えるあいだだけ立ち止まって、また旅を続ける。第一の任務は、後に人間の所有する政体が差し向けてくるどんな軍隊からも宇宙を守れるだけの物資を蓄えることだ。それによって、人類が住む宇宙の隅々で所有権と普遍的権利を執行できるようにする。第二の任務は、できるだけ多くの星に人類の旗を立てることだ。そして、ほかの知的文明の勢力圏とぶつかったなら、平和的な外交関係と、互いに合意できる国境を確立する。最後の任務は、後からやって来る人間の入植者が誰であれ、その植民地を立ち上げるための既存の産業基盤を用意しておくことだ。
一方、地球では、人間たちが自分の選択肢を検討している。宇宙になど関わりたくない人もいる。宇宙は寒くて退屈で、遠すぎる。そういう人は取り分を売ってお金に換え、そのお金で地上の好きなものを買う。ほかの人々は、自分の宇宙の物件をどう使うのが一番よいかをAIの助言者に相談し、役に立つ指針を受け取る。
望むなら、自分の宇宙の物件に行ってそこで暮らしてもかまいません。物件が太陽系外にある場合、旅を生き延びるには、コールドスリープに入るか、自分をコンピューターにアップロードする必要があります186。
コールドスリープやアップロードがどうしても嫌な場合や、地球を定期的に訪れたい場合は、太陽系内の物件を手に入れるとよいでしょう。それらが気にならなくても、近くの異星人が心配なら、天の川銀河か近くの銀河の物件を。そうでなければ、最大の広さを求めて遠方の銀河を丸ごと手に入れてはいかがでしょう?
ナノテクノロジーの登場により、制約となるのは質量と空間だけです。あなたが到着するずっと前に、ロボットが、選んだ物件をお望みどおりの姿にテラフォーミングしておけます。
テラフォーミングした小惑星「だけ」を選んだとしても、そのすべてを一人で楽しみ尽くすことはとてもできません。望むなら巨大な宇宙の大邸宅にしてもかまいませんが、1万年かけてもすべての部屋を訪れることはないでしょう。広大な領地、ありえないほどおいしい食事、そのほか想像しうるあらゆる贅沢を手に入れることは、ごく当たり前の前提にすぎません。あなたが純粋に利己的なら187、遠い宇宙の資源に対する権利は売ってしまい、こうしたものすべてを地球か近くの宇宙ステーションで楽しむべきです。遠い宇宙の物件が役に立つのは、規模に敏感な選好を持ち、何かを途方もない規模で実現することを大切にする人だけです。
望むなら、自分の仕様どおりにユートピア社会を設計できます。フォン・ノイマン探査機があなたの物件に到着すれば、それを建設してくれます。初期条件を設定し、あとは社会が自力で成長し、省察し、繁栄していくのに任せることもできます。そこへ旅することを選べば、社会はあなたを待っています。地球にとどまるなら、そうした社会が存在するのだと知って、心温まる満足感を味わえます。
たいていの人は、ほかのどの人間とも違う、自分だけの「善」の見方を持っているわけではありません。共通のビジョンで結ばれたトラストを結成し、調整や設計の労力を分かち合うのもよいでしょう。トラストは宇宙の資源を持ち寄り、複数の銀河にまたがる広大な社会を築けます。
唯一の制約は普遍的権利、つまり拷問の禁止、奴隷制の禁止などです。それからもちろん、宇宙の所有権もあります。他人の恒星系を征服するために軍隊を作ろうとしたり、真空崩壊を引き起こそうとしたり、銀河を破壊する爆弾を作ろうとしたりすれば、私たちがあなたを叩き潰します。それ以外なら、限界はあなたの想像力だけです。(とはいえ、超知能の助けがあれば、あなたが何をしたのかはいずれほかの人々にもおそらく突き止められ、あなたは評価を下されることになる点に注意してください。)
宇宙の物件を持つ人々は、自分の倫理について最も深いレベルで考えざるをえなくなる。中には、生まれて初めてそうする人もいる。超知能のアシスタントが、それぞれの信念から何が導かれるかを一緒にたどり、さまざまな選択が最終的にどんな結果になるかを予測してくれる。目の前の課題に圧倒され、あらゆる可能性を処理する助けとして、知能を高める薬を飲んだり自分をアップロードしたりする人もいる。一方で、あえてその選択肢を拒む人もいる。手を加えられていない人間性から自分を切り離すものはどんなものであれ、最も真実で最も深い人間の価値観を星々に届けるという探求の妨げになる、と感じるからだ。
こうして生まれた計画は数えきれない。自分の銀河ぶんの資源をどう使うかについて、ありとあらゆる学派がある。たとえば次のようなものだ。
未来に委ねる: 資源の大半を子どもたち(あるいは未来のほかの人々)に譲り、その人たちに選ばせることにする人もいる。
人間の繁栄: 普通の自由な人々が普通の暮らしを送る世界を作る。これは当初思われていたよりも難しい問題だ。人類の文明はすでにきわめて普通ではなくなっているからだ。この時点で、芸術や科学といった人間の営みは、すでに機械が支配するものになっている。自分の銀河が、欠乏から解放され、最も意味があると思う関心事をなんでも追求できる人間で満たされることを受け入れて、この問題に対処する人もいる。人間の労働の余地を残すために、技術を巻き戻すことに決める人もいる。
デジタルな人間の繁栄: 人間が幸せで充実した人生を送ることがよいことなら、そうした人生を送る人の数を増やせばいいのではないか? 脳のエミュレーションは、生身の人間よりはるかに安く動かせる。惑星サイズのコンピューターがあれば、幸せな文明を抱えた惑星100万個に相当するものをシミュレーションできても不思議ではない。
非因果的取引: 到達できない遠方の銀河にはおそらく異星人がいて、さまざまな仕組みを使ってそうした異星人と取引できる、と主張する人々がいる。それが本当なら、自分たちの価値観だけを狭く最大化するのではなく、妥協した価値観を追求するという取引を結べることになる。したがって、自分たちの価値観だけでなく、膨大な数のほかの文明との妥協の価値観を追求することで、差し引きで最も多くの善をなせるかもしれない。
人類は目もくらむほど多様な形と生き方で宇宙に広がっていく。その多様さは、地球だけでは決して生み出せなかったほどだ。
地球にとどまった人々は、宇宙の取り分を売ったにせよ、不在地主として暮らすことを選んだにせよ、それぞれに固有の課題に直面している。最大の問題は、ありあまる自由な時間をどう使うかだ。ごく一部の人は、原理的にAIの労働では埋められない隙間に仕事を見つける(聖職者、アスリート、芸術家)。余暇の暮らしを楽しむ人もいる。合成生物学から言語創作まで、あらゆるものをめぐって競技リーグが次々と生まれる。数千人(あるいはそれ以上!)の集団が、以前なら想像もつかなかったほど巨大で野心的なプロジェクトに共同で取り組む。かつてなら、クラブを維持することすら難しいほどニッチだった共通の関心のまわりに、共同体どころか文明までもが形づくられる。
欠乏が完全になくなったわけではない。人気のある地区の土地のような一部の威信財は、本質的に数が限られている。豊かさに耐えられない人々は、人為的な不平等を作り出すさまざまな方法を見つける。多数派が選んだ方向に不満を抱く人もいれば、もっと大きな分け前が欲しかったと思う人もいる。それでも全体として見れば、誰もが少なくとも銀河1つ分の資源を持ち、思うままに使える。ほとんどの人にとって人生はあまりにすばらしく、2026年の世界を想像するのは難しいだろう。歴史シミュレーションとしてなら、あるいは想像できるかもしれないが。