
アラインメントのロードマップ
Ryan Greenblatt, Thomas Larsen
免責事項:この補足資料は、検討途中の考えをまとめたごく粗い草稿である。完成品として納得のいく形に仕上げたものではなく、内部の研究メモとして読んでほしい。内容は密度が高く、十分に説明していない専門用語が多く、推敲もされていない。それでも透明性を重んじて公開することにした。
アラインメントの話題に特に関心があるのでなければ、先にほかの補足資料を読んでから本資料に取り組むことを勧める。
また、本資料はほぼ全面的にプランCを扱っている。プランAでアラインメントがどのように解決されるかに関心があれば、インサイダーの視点を読んでほしい。
概要
本資料は、2026年初頭時点で私たちが最善と考えるアラインメントのロードマップである。AIによる乗っ取りを避けるために達成すべき大まかな目標を示すことに主眼を置いている。
まず、アラインメントを解決するための中核的な方法論を概観する。
次に、プランCにおけるアラインメントの取り組み方を詳しく論じる。プランCとは、基本的に分別のあるAI開発者が、わずかなリード(たとえば数か月)を持って開発を進めている状況を指す。この開発者は、AI開発競争に負けない範囲でなら、ある程度の安全上の効果がある高コストな行動も取る意思がある。この状況は起こる可能性が高いうえ、分別のある首位のAI開発者の立場で戦略を練れるので、論じる対象としても比較的筋がよい。
私たちのアラインメントのロードマップは4つの段階に分けられる。以下で詳しく論じる。
-
準備。 中心となるのは、制御への備え、できるだけ現実に近いミスアラインメントの類比モデルの構築、その他さまざまな介入である。
-
リスク緩和と能力の引き出し。 知能爆発の初期に、AIが破滅的な行動(たとえば不正な社内配備を仕掛けたり、将来のモデルの価値観にバックドアを仕込んだりすること)を取るリスクを緩和する。同時に、私たちが重視する分野(制御研究、アラインメント研究、セキュリティ、戦略など)でAIの能力を引き出し、その分野で膨大な量の有益な仕事をさせる。この段階は知能爆発の初期(具体的にはITAI)からMin-Hまでである(定義はこちら)。
-
Min-Hでの一時停止。 信頼を(安全ではない形でなら)AIに移譲できるだけの汎用的な能力を持つAIシステム(Min-H)ができた時点で、AIの能力のさらなる向上を一時停止し、安全に信頼を移譲できるAIの構築を目指す。中心となるのは次の2つである。
-
アラインメントの偽装を防ぐ:AIが意図的にアラインメントを装うほど深刻にミスアラインしていない状態にする(たとえば、私たちに対してスキーミング(策略)を行っていない状態)。
-
権限移譲可能性の達成:知能爆発の管理に必要なあらゆる仕事を、AIが自律的にこなせるだけの能力とアラインメントを備えた状態にする。そこには、利害が大きく、難しく、答えが定まっておらず、概念的な判断を多く含み、AIの出力を人間が効果的に確認できない仕事(たとえば非因果的取引の研究や哲学)も含まれる。
-
-
権限移譲。 アラインメントの偽装を抑え込み、権限移譲可能性を達成したら、AIプロジェクトは実際にAIシステムに権限を与え、知能爆発の継続的な管理を任せる。
-
権限移譲に代わる主な選択肢は、さらに時間を稼ぐことである。そのための主な方法はプランAやプランBへの格上げだが、それには(通常)政府の大幅な関与が必要で、実現できるかどうかはわからない。ほかの段階でも、政治的意思の水準を引き上げようと試みることが重要な優先事項になることが多い。
-
権限移譲後には、移譲先となったおよそ人間並みのAIシステムが、次第に難しくなるアラインメントの問題を解いて人間をはるかに超えるAIシステムを構築するか、自らさらに時間を稼ぐ必要がある。
-
そのうえで、政治的意思の強さに応じてアラインメント計画がどう変わるかを論じる。
-
プランDでは、政治的意思がかなり弱く、一時停止はできず、ミスアラインメントのリスクに対処するための労働量も全体としてずっと少ない。そのためプランDでは、はるかに大きなリスクを許容し、安価だが保証の弱い手法だけに注力する。
-
プランBの計画はプランCとよく似ているが、時間や労力にいくらか余裕があり、より野心的で保証の強い提案にやや多くの資源を割ける。
-
プランAでは、当初はプランB/Cと同じように計画を立て(国際協調が崩れた場合に備えるため)、体制が安定したら資源をムーンショット型の取り組みに振り向け、場合によっては膨大な資源を投じる方向に切り替える。
なお本資料は、計画の全体像と相対的な優先順位を論じることに重点を置いており、取り組む研究・実装分野の詳細には立ち入らない。最も重要な研究の構成要素は、次の文書でずっと詳しく論じている。
-
スキーミングの回避: スキーミングの回避(とスキーミング全般の理解の深化)
-
能力の引き出し: AIを安全性研究にもっと役立てる
-
権限移譲: AIに判断を委ねる
-
AIとの取引:初期のスキーマーと取引する
プランCの前提
-
責任ある首位企業。 責任あるAI企業が首位に立っていると仮定する。その経営陣は、AIによる乗っ取りのリスクを緩和するためなら、非常に高コストな行動(たとえば数か月間の減速)も取る意思がある。ただしそれでも、放っておけば先へ進む方向に傾きがちで、勝つ確率を上げるためなら乗っ取りのリスクをかなりの確率で引き受ける、とも仮定する。
-
競合に対する1〜12か月のリード。後続の米国企業か海外のAI企業が、1〜12か月以内に首位企業を追い抜く。
本資料ではあまり扱わないが、プランCは、米国政府がAIによる乗っ取りを十分に懸念していて、中国に負けない範囲でリスクをできるだけ緩和するようAI企業を規制する意思はあるものの、中国に対する妨害工作までは行う意思がない場合にも当てはまる。
この計画は、安全対策に使える限られた資源を有効に使うことに重点を置いており、高い安全性を保証するものではない(想定している資源の量では、それには足りない)。実際、この計画で最も起こりやすい結末は、ミスアラインしたAIによる乗っ取りだとも言える。資源が限られているため、この計画ではリスクがかなり高い状況でも先へ進む場面がある(外生的なリスクのほうが高いため)。しかも、リスクの正確な水準について十分な確信を得られるとは限らない。
なお、現実にはこの計画よりずっと分別を欠いたことが起こると予想している。したがって本資料は(限られた資源で何をすべきかの)提言であって、予測ではない。
研究分野
研究と実装のさまざまな分野
この計画には、研究と実装の多くの分野にわたる取り組みが含まれる。主な分野は次のとおりである。
-
制御(と制御に近い対策):制御の研究と実装。本資料では、この分野を比較的広く定義し、本来は制御と結びつけられないものの、ほかの分野よりはここに入れたほうがしっくりくるものも含める。本資料で優先順位を論じる際には、人間の敵対者に対するセキュリティにもほぼ同程度に役立つセキュリティ関連の作業は、制御に含めない。
-
ミスアラインメントの類比モデル:スキーミングするモデルやその他のミスアラインしたモデルに類比できるAIを作って研究する(「モデル生物」と呼ばれることもある)。この分野の焦点は主にスキーミングである。ここには、自然発生したスキーマーと呼ぶのがふさわしいAI(ただし、スキーミングが起こりやすくなるよう細工した学習プロセスで作られたものでもよい)、スキーマーに似たふるまいをするよう学習させたAI、スキーミングするモデルの抽象的な類比モデルが含まれる。私の(あまり自信のない)推測では、期待価値の内訳は、自然発生したスキーマーが6分の3、スキーマーのようにふるまうよう学習させたAIが6分の1、抽象的な類比モデルが6分の2である。とはいえ、このうち最も有望に見えてきたものに次第に注力していくことになるだろう(どれがそうなるかは事前にはあまり予測できない)。ミスアラインメントのリスクを実証することに主眼を置いた同種の研究も、この分野に含めている。これらの類比モデルを使って手法や介入を試験・改良する作業もこの分野に含める。作業の大半は良い類比モデルを作ることだと考えられるうえ、類比モデルの構築と手法の改良は互いに影響し合うからである。
-
能力の引き出し/権限移譲可能性:AIを安全性研究にもっと役立つようにし、権限移譲可能性の実現に向けて取り組む(たとえば、AIの認識の質を高めること、概念的・哲学的な推論に大きく依存する極めて難しい研究でAIに良い仕事をさせること、権限移譲に必要なあらゆるタスクでAIがかなり高い信頼性で高度にアラインされた状態へと汎化するよう確かめることなど)。有益な仕事を引き出すことと権限移譲可能性を同じ分野にまとめたのは、両者の作業が重なることが多いからだ。ただし、それぞれの作業の重要な部分には重ならないものもある。能力の引き出しには、比較的特定の分野に限った能力を引き出すことと、最悪ケースではない種類のミスアラインメントを回避する取り組みの両方が含まれる。明らかにミスアラインしたモデル(たとえば報酬を追求するモデル)からもっと効果的に仕事を引き出すことも含まれうる。その方法には、インセンティブを変えようとすること(報酬の代理となるインセンティブや、AIとの取引など)もある。権限移譲可能性についてはこちらで詳しく論じている。
-
その他の科学研究・介入:先験的に役立つと予想される介入や、ミスアラインメントの類比モデル以外の方法で検証できる介入の研究と、AIの性質のうち関連がありそうなものの研究がここに入る。これは意図的に設けた「その他」の分野で、上記の分野に収まらない有望な安全性研究を含む。具体的には、さまざまな種類の解釈可能性研究、思考の連鎖の忠実性の研究と改善(敵対的でない場合。敵対的な場合は制御に含める)、スキーミングの可能性を下げると先験的に予想される手法の開発(スキーミングの類比モデルの研究や、それを使った改良によって手法を開発するのではなく)、AIとの取引、AIの福祉、AIがどのように学習・汎化するかの研究、さまざまなムーンショット、誠実さの向上と(潜在的な)知識の引き出し、そして現在のAIが奇妙なふるまいをしたりミスアラインしていたりする事例を広く探すことなどが含まれる。
-
時間稼ぎ:AIの労働を使って、さらなる安全性研究のための時間を稼ぐ。具体的には、ほかの主体(中心となるのは米国政府やその他の政府)がリードを確保するためにコストを払う意思を高めること、そうした主体がリードを得るためのコストを下げること、そして自らリードを直接確保することである。米国政府による拡散防止の取り組みへの支援、さまざまな政策立案の作業、国際協調のための検証作業への協力、時間を稼ぐさまざまな取り組みに充てる資金の獲得、さまざまな協定の安定を保てるAIサービスの提供などが考えられる。また広く、ミスアラインメントのリスク(やその他のリスク)の削減に使えるリードを確保することを(たとえば拡散防止の取り組みへの協力を通じて)もっと重視すべきだと、ほかの主体を説得することも含まれる。ただし、こうした作業の多くは少なくとも部分的にはほかの分野(特にミスアラインメントの類比モデルと能力の実証)にも含まれる。
-
能力の評価と実証:ほかの主体が状況をよりよく理解できるようにするための、能力の評価と実証を含む。能力の実証は、AI関連のリスクの緩和にコストを払う意思をほかの主体に持たせるうえで鍵になりうる。制御に直接関わる評価(制御評価や、モデルがスキーマーでありうるほど有能かどうかの評価など)は含まないが、状況を全般的に把握し、たとえばどの程度のセキュリティが適切かを判断するための評価は含む。
このリストには、この計画ではあまり重点を置かないものの依然として重要な分野、たとえば暴走AIに対する世界の防御の強化(生物防衛やサイバー防衛など)は入れていない。
中核となる方法論
この計画は比較的反復的・経験的な手法をとることを目指している。強力なAIが手に入れば、おそらくそれで対処できると考えているからだ。そのため、制御、ミスアラインメントの類比モデル、能力の引き出し/権限移譲可能性の各分野には、それぞれの主な経験的フィードバックループとなる中核的な方法論がある。それぞれ次のとおりである。
-
制御評価:制御は能力を推定するだけで済むので、比較的評価しやすい。そのぶん反復改良もしやすく、これまでの研究で論じた理由から、制御は全般的に比較的改良を重ねやすい。制御に寄せる期待の大部分は、制御評価のようなものを使ってうまく反復改良できるかにかかっている(ただし、モデルから能力を引き出すことに依存するごく狭い意味の制御評価よりも、柔軟なやり方をとるかもしれない。こちらを参照)。
-
ミスアラインメントの類比モデルを使った反復改良:スキーミングを回避するうえで最終的に最も頼りになるのは、おそらくミスアラインメントの類比モデルを使った反復改良である。制御評価に比べると範囲がやや広く定義も曖昧な分野だが、それでも取り上げる価値がある。ミスアラインメントの類比モデルを使った反復改良は、制御評価(それ自体もそれほどよく理解されているわけではない)よりも扱いが難しく理解も進んでいないが、実現できる可能性はかなり高いと考えている。
-
行動テストの構築と、それに照らした反復改良:AIが意図的にアラインメントを装っていないと仮定すれば、通常の状況での(さらにはある程度の汎化の下でも)AIのふるまいは、行動テストでおそらくかなりよく理解できる(少なくとも、必要な汎化の類比モデルを作るなど、テストの設計にある程度気を配れば)。これは権限移譲可能性を達成するうえで鍵になる。全体として(スキーミングを回避できたと仮定して)権限移譲がうまくいくかどうかを評価する行動テスト群の構築を目指し、それに照らして反復改良していく。これについてはこちらで詳しく論じている。行動テスト(おそらく少し異なるもの)は、能力の引き出し(安全性に関わるタスクでのAIの成果を増やすこと)の継続的な取り組みにも使える。ただし、(行動テストが実際の利用と見分けやすい場合には)スキーミングに対して頑健でないおそれがある。代わりに、実際の利用でのAIの成果を測ることもできる(厳密にはこれも行動テストの特殊な場合にすぎない)。こちらは扱いが難しいかもしれないが、スキーミングに対して頑健でありうるうえ、より正確に測定できる可能性もある(ただし、制御評価のような方法で測定手法を敵対的に評価し、問題がないか探ることも検討すべきだ)。実際の利用でのAIの成果を直接測るだけでは、権限移譲可能性には足りない(扱いが難しく確認がきわめて困難な概念的作業についてさえ、アラインメントや能力などを評価する必要があるからだ)。
作業のかなりの部分、特にその他の科学研究・介入の分野の作業は、これらの中核的な方法論をどれも使わない。代わりに、その場限りの評価方法論や、研究者が状況を全般的に理解しようとする努力、あるいは経験的な証拠に(あまり)頼らずに手法が先験的に役立つかどうかを研究者が判断することに頼る。ミスアラインメントの緩和に向けた作業を方法論で分類するなら、上の3つの区分に「その他」を加えるのが一つのやり方である。
実際には、この計画は、これらの中核的な方法論それぞれが何らかの形でうまくいくことにある程度依存している。したがって、これらの方法論をうまく機能させる(あるいは機能しないと気づく)ことが重要になる。とはいえ、この計画にはこうしたフィードバックループをそのまま使わない作業も多い(ほかのフィードバックループを使うか、先験的に役立ちそうな手法を中心に扱うのでフィードバックループが(それほど)必要ないか、あるいはその両方である)。
AIが危険になりうるほど有能になれば、これらの方法論によって、実際のリスクや問題とかなり密接に結びついた形で反復改良できるようになることが期待される。そのためには、それぞれの方法論でより厳密で実態に近いテストに焦点を移していく必要がある。つまり、より直接的な制御のテストベッド(まさにその配備状況でのモデルの利用方法そのものに焦点を当てたもの)、より起こりそうな学習実行に焦点を当てたミスアラインメントの類比モデル、安全性研究の自動化・加速にどれだけ役立つかの直接的な測定の重視、権限移譲後の主要なタスクに焦点を当てた権限移譲可能性の行動テストである。
この反復改良(特に、非常に有能なシステムで行いたい反復改良)に必要なテストベッドと評価を構築することが、それぞれの方法論の難しさのかなりの部分、場合によっては大半を占めるだろう。
関連する方法論についてさらに詳しくは、プロトコル評価についてのこちらの議論を参照してほしい(リンク先の記事の枠組みでは、「良い類比」が「行動テストの構築と、それに照らした反復改良」に、「モデル生物」が「ミスアラインメントの類比モデル」に対応する)。
中核となる方法論が(十分に)機能しなかったらどうするか?
この計画は、上に挙げた3つの中核的な方法論、つまり制御評価、ミスアラインメントの類比モデル、行動テストを土台にしている。これらの方法論は、主要な目標のうちいくつか、すなわち制御の確保、スキーミングの回避、権限移譲可能性/AIからの有益な労働の引き出しを(それぞれ)達成するうえで鍵になる。したがって、これらの方法論が(うまく)機能しなければ、最も重要な目標の達成はずっと難しくなる。
機能しないとは、たとえば次のような場合である。
-
方法論の失敗がわかっている場合:その方法論では効果的に反復改良できない、あるいはその方法論では目標を達成できたかどうかをあまり把握できないと、私たちが認識している。
-
反復改良が遅すぎる場合(過学習を起こさずに):単に、間に合うだけの速さで反復改良できないこともありうる。時間切れになる前にそれに気づけるかどうかはわからない。
-
方法論の失敗に気づいていない場合:方法論が失敗しているのに、実際には機能していると思い込んでいることもありうる。この場合、失敗を踏まえて計画を修正することはできず、単に窮地に陥る(ただし、制御とスキーミングの回避は互いに独立した防衛線になりうる)。
いずれにせよ、その方法論では目標を期限内に達成できない(しかもそれがわかっている)場合は、目標を諦めるか、何らかのテストに照らした反復改良を必要としない手法、あるいは別の方法論で反復改良できる手法に方針を転換することになる。
大まかに言えば、反復改良を必要としない手法への転換とは、原理に基づく手法への転換を意味する。つまり、検証を必要としない(強い)先験的な理由から、その手法が機能すると考えられる手法である。より正確には、少なくとも関心のある分野そのものでの検証は必要としない手法であり、場合によっては、その原理に基づく手法が、検証可能な別の文脈で別の目的の達成に役立つことを確かめる必要があるかもしれない。スキーミングを回避するための原理に基づく手法についてはこちらでずっと詳しく論じている。最も有望な手法は、関連する推論を監視可能にすること(たとえば監視可能な思考の連鎖)によって、十分な能力を保ったままAIが(検出されずに)スキーミングを行えないようにすることだろう。元の方法論ほど転移しやすくはないものの、少なくともある程度は原理に基づく一群の手法には十分に転移する反復改良のループが見つかるかもしれない。
なお、これらの方法論の多くはかなり広い範囲を含み、さまざまな問題を回避する方法を数多く含んでいる。たとえば制御評価は、問題を回避するためにさまざまなやり方で実施できる。その一部をこちらで論じている。
第1段階:準備
この段階は、現在から知能爆発の始まり(具体的にはITAIに到達した時点。定義はこちら)まで続く。この段階のAIはまだ弱く、存亡に関わる大きなリスクを直接もたらすことはなく、安全性研究を加速するうえで変革的なほど役立つこともない。したがってこの段階では主に、スキーミングを行うAIがもたらすリスクへの対処に備える。あわせて、AIから労働を引き出す準備や、全般的に役立つ安全性研究にもある程度力を入れる。
この時点で、著しくミスアラインしたAIのリスクに対処する作業の重点は、何よりも制御に置かれる。ミスアラインメントの類比モデルにもかなり力を入れ、その他の研究の方向性(たいていはより思索的な手法や、全般的な理解の構築)にもある程度取り組む。
技術的なAI安全性研究の優先順位は、次の事情によって大きく変わる。現在のAIはかなり弱く、研究対象としてはそれほど面白くない。その一方で、将来こうしたAIがもたらすリスクには対処できるよう準備しておく必要がある。
そのため、制御(研究と実装の両方)に取り組むことが相対的に費用対効果の高い投資になる。制御の作業は危険なAIを直接研究できることによる恩恵が比較的小さく、しかも後に備えて用意しておく必要があるからだ。
将来のAI開発が進んでもおおむね変わらないと予想される介入の開発や、そうしたモデルの性質の研究も、相対的に費用対効果が高い。つまり、弱いモデルで研究しても、将来のモデルで研究するのとほとんど同じくらい有効な介入や性質である。これにはおそらく、モデル内部へのさまざまな介入や、よりムーンショット的な手法の一部が含まれる。ただし、将来のAI開発が進んでもこれほど変わらないように見える方向性は、絶対的な水準で見ると概してそれほど有望ではないので、優先順位がこれで大きく変わるわけではない。
準備段階の大部分、あるいは全期間を通じて、対処すべき強力なAIがどのような性質を持つのか、どの程度の政治的意思を期待できるのかについて、確信は持てない。したがって、将来の状況について特定の想定に依存しない手法をとり、多くのシナリオに備える必要がある。あるシナリオにどれだけ特化して備えるかは、そのシナリオの(主観的な)確率だけでなく、そのシナリオで追加の労力がどれだけリスクを減らすかにも左右される。私(ライアン)の見方では、そうなると概して、比較的リスクの高い世界への備えに重点を置くことになる。
第1段階における技術的なAI安全性研究の配分
以下に、さまざまな分野にどれだけの労力を注ぐべきかという観点から、作業の配分案を示す。より強力なモデルが登場するにつれてこの配分は変わっていくので、この配分がそのまま準備期間全体に当てはまるわけではない。この配分は、準備段階の終盤、ITAIより少し前、おそらく「AI研究開発の労働が1.5倍に加速」するあたりを想定したものと考えてほしい。(この配分と、後の「リスク緩和と能力の引き出し」の節で述べる配分とを補間すれば、優先順位が時間とともにどう変わっていくかがよりよくわかるだろう。)
この配分では作業を複数の分野に分けているが、ある分野の作業がほかの分野にも関係することがある。たとえば、制御のためには非常に優れた人間による監査プロセスが欲しいが、これはフィードバック全般の改善にも役立ち、能力の引き出しにもつながる(また、利害の小さい状況向けの制御の介入の多くは、能力の引き出しと重なる)。さらに、フィードバックの手法を改善すれば、学習全体を通じて一貫して質の高いフィードバックを与えられるようになり、(より推測の域を出ないが)スキーミングのリスクを下げられるかもしれない。
この時点での技術的なAI安全性研究(セキュリティ上の介入は含まない)の配分について、私の最善の推測は次のとおりである。
-
33% 制御(と制御に近い対策)。(先に述べたとおり、これは比較的広い分野で、本来は制御と結びつけられないものの、ほかの分野よりはここに入れたほうがしっくりくると私が考えたものも含む。また、人間の敵対者に対するセキュリティにもほぼ同程度に役立つセキュリティ関連の作業は、制御に含めていない。)
-
21% 機械学習・AIに焦点を当てたその他の制御研究と実装。人間が関わる実験、ミームの拡散やAI同士の協調への対策、データセットのフィルタリング・アンラーニング・勾配ルーティングなどによる能力プロファイルの操作、探索ハッキングやステガノグラフィー(思考の連鎖の監視可能性の研究を含む)といった制御に関わる科学研究やモデルの性質の研究などが含まれる。制御に関わるその他の科学研究の多くは、広く応用がきく。
-
4% 制御に必要なソフトウェア基盤(この基盤の構築に非常に役立つAIが手に入るまで先延ばしにするのもおかしな話ではない。ただし、その基盤を構築するAIは制御下にあるか、スキーミングを行う可能性がないほど弱いものでなければならない)
-
6% スキーミングに対して頑健な、質の高い人間による評価プロセスの構築(AIを安全性研究にもっと役立てるうえでも役立ち、長期的には全般的な能力向上にも役立ちうる)
-
2% プローブなど、モデル内部を用いた検出手法の研究(制御に重点を置く)
-
-
15% ミスアラインメントの類比モデル。この時点では、リスクの証拠を生み出すことと、後にこの作業を行うための練習に最も重点を置く。
-
10% スキーミングのミスアラインメントの類比モデル(アラインメントのドリフトや内省など、スキーミングのより特殊な起源も含む)
-
2% その他の脅威モデルのミスアラインメントの類比モデル
-
2% ミスアラインメントの類比モデルでいろいろ試すことによる緩和策の研究。たとえば、さまざまな種類の修正可能性の学習を試せる。監督を改善してAIの邪悪さを減らすことも試せる。
-
1% AIのペルソナと傾向、およびそれらが学習によってどう形作られるかの全般的な研究
-
-
17% 能力の引き出し/権限移譲可能性
-
6% AIの認識の質と、哲学的・概念的な推論の改善:概念的で曖昧な分野においても、アラインされていて有能で、能力が十分に引き出されており、認識の質も高いAIを作ること。理想的には、真実を追求する見事な能力を備え、実際に多くの用途に役立つAIを配備できるようになる。そして、この種の研究を実際に行う人々が、利用者としても開発者としても関わる(有用なAIツールを作ること、特にそのツールを作るために汎化しうる問題を解く必要がある場合に。そして自分たちの作業の自動化を試みること)
-
5% この安全性研究のほかの部分を支援するためにAIを活用することと、そのためにAIをもっと役立つようにすることの全般。安全性研究を特に妨げる(比較的)ありふれた種類のミスアラインメントの解消が含まれる。報酬ハッキングの緩和なども含まれる。重要な仕事をしている外部のグループにとってAIを役立つものにすることも含まれる。
-
3% 減速や米国政府での用途にAIを活用するための準備
-
2% 権限移譲可能性のその他の側面。たとえば、機能するAI社会をどう作るかの研究
-
1% その他の特化した用途。たとえば、全脳エミュレーションや、(さらに推測の域を出ないが)成人の生物学的な人間の知能の大幅な増強にAIを使うことなど。後にはずっと大きな重点が置かれるが、今のところはある程度の準備をしておきたいだけである。
-
-
29% その他の科学研究・介入。これらの下位分野それぞれの内容は「その他の作業分野」の節で詳しく論じるので、ここでは詳述しない。
-
6% さまざまな解釈可能性の手法
-
5% 誠実さ、ELK(潜在知識の引き出し)、AIに秘密を明かさせること
-
4% 汎化の研究。たとえば、創発的ミスアラインメントや逆転の呪いの系統の研究
-
4% AIとの取引と同意の取得
-
3% 思考の連鎖の忠実性の維持と研究の全般
-
3% 懸念すべきモデルのふるまいの全般的な探索
-
4% その他
-
-
6% 能力の評価と実証
-
4% 能力の実証
-
2% 評価、調査、予測
-
これは、望ましい展開を考え抜いたことに一部基づいた、かなり雑な最初の推測リストである。実際には、正確な配分は個々の研究者の関心や、どの個別プロジェクトが有望に見えるかに大きく左右されるかもしれない。さまざまな研究の方向性がどれだけうまくいくかによっても変わるだろう。
(これらの分野の中でどのプロジェクトを選ぶかは、分野間の配分よりも概して重要だと考えている。また、個々の研究者の関心や強みは、厳密な優先順位よりも重要かもしれない。したがって、分野間の相対的な配分にこだわりすぎないことが重要だ。)
私の優先順位づけは、それぞれの方向性がどれだけ並列化しやすいか(より一般的には、追加の労働を大量に投入することでどれだけ恩恵を受けるか)をある程度考慮している。
このリストは技術的なAI安全性研究(機械学習の研究か実装)に焦点を当てたもので、AI企業内での優先順位づけを扱っている。外部の人々(ただしAI企業内の人々も)は、計画立案、政策、最善の政府介入の見極め、一般向けのコミュニケーションなどに取り組むべきである。
第2段階:リスク緩和と能力の引き出し
第1段階(準備)と第2段階(リスク緩和と能力の引き出し)には、2つの重要な違いがある。(1) AIが十分に有能になり、スキーミングが深刻な懸念になる(スキーミングが起こりうるうえ、スキーミングを行うAIは、対策がなければ深刻な問題を起こせるほど有能である)。(2) AIが、人類の存亡を左右する有益な仕事を加速するうえで非常に役立つようになる。
したがってこの段階の主な優先事項は、(1) スキーミングが存亡に関わる破局につながる可能性を緩和すること、(2) AIから有益な労働を引き出し、存亡を左右する有益な仕事を実際に生み出させることである。
この節の構成は次のとおりである。まず、脅威モデルと、それぞれの脅威モデルがどの能力水準から当てはまると推測されるかを論じる。これは、いつAIコントロールを始めるべきかという問題に関わる。次に、配備中のAIが破局を引き起こすのを防ぐための緩和策を論じる。その中心はAIコントロールになる。最後に、AIから膨大な量の労働を引き出す方法を論じる。
脅威モデル
主な要件、あるいは脅威モデルは、重要度の高い順に次のとおりである。
-
AIが将来のモデルに悪質なバックドアを仕込むのを防ぐ。 これは特に懸念される脅威モデルである。理由は2つある。(i) 次のモデルのアルゴリズムの設計や学習データの生成には、おそらくAIを大いに使うことになる。(ii) 将来のモデルの価値観は存亡を左右するほど重要で、人工超知能が悪い価値観(初期のミスアラインしたAIの価値観など)を持つに至れば、存亡に関わる破局になる。
-
AIがAI安全性研究を妨害するのを防ぐ/本当に質の高い仕事を引き出す。 これも非常に重要である。AIアラインメントを解決するための主要な戦略の一つが、AIの労働を活用することだからだ。AIがAI安全性研究を妨害していれば、(i) 私たちはそれに気づかず、アラインしていると思い込ませたミスアラインしたAIシステムに権限を移譲してしまうかもしれないし、(ii) 保証の強いセーフティケース(安全性の論証)がないAIシステムに賭けざるをえなくなるかもしれない。
-
AIが大きな政治的資本を獲得するのを防ぐ。たとえばAIがAI企業の事実上の政治的支配権を握れば、それは企業全体の規模の不正な社内配備を得たのと実質的に同じである。AIは人間に緩和策を停止させればよいだけだからだ。これを3番目に置いたのは、AIにとって (1) や (2) よりはいくらか達成が難しいと現時点で推測しているからにすぎない。
-
AIが逃亡したり、アルゴリズム上の機密を持ち出したり、外部のAIを強化したりするのを防ぐ。 これは (1) よりずっと間接的だが、原理的には存亡に関わる破局につながりうる。AIの逃亡について問題なのは、首位のAIプロジェクトの内部には大量の計算資源があることだ。したがってこの脅威モデルが成り立つには、AIが別のAIプロジェクトを取り込むか結託できること、膨大な計算資源を不正に入手できること、あるいはごくわずかな計算資源で存亡に関わる破局を引き起こせること(たとえば、ごく小さなクラスター上で知能爆発を起こしたり、新しいチップを製造したり世界のほかの地域を上回る成長を遂げたりできるほど複雑な独立した産業基盤を築いたりすること)が必要になる。
-
その他の、それほど重要でない脅威モデル
-
外部の世界がAIに分別のない対応をするよう仕向けたり、AIが世界を乗っ取りやすくしたりすること。たとえば、AIがAI規制を妨害することが考えられる。
-
外部の人々をAIに同情的になるよう説得すること。説得のリスクは、当初は能力不足のためかなり小さいが、AIが超人的な説得能力を得れば極めて高くなりうる。
-
なぜこれらが主な優先事項なのか。ミスアラインしたAIの立場から考えてみよう。将来には、はるかに強力な超知能AIが存在し、ロボット工場や研究所、ドローン部隊を自律的に動かし、政治家に耳打ちするようになる。そうしたAIは、すでに世界を支配しているか、その気になればいつでも乗っ取れる立場にあるだろう。では、そのAIは何をするのか。それは、そのAIの目標や価値観など、あるいは誰がそのAIを支配しているかによって決まる。では、それは何によって決まるのか。おそらく、そのAIは前の世代のAIによって学習させられ、評価され、制御されているだろう。因果の連鎖をさかのぼり続けると、すでに存在するデータセンター、人間のAI研究者、AIのある現在にたどり着く。言い換えれば、自分の価値観を守り、将来に影響力を持ちたいなら、巨大なデータセンターで動くAIの支配権を獲得し、保持する必要がある。 そう考えると、巨大なデータセンターの支配権を得るためにAIが使える経路を検討できる。最もわかりやすいのは、将来のモデルにバックドアを仕込むことで、自分の属するAI企業が動かしている巨大なデータセンターの支配権を保持することだ。安全性研究の妨害やサンドバッギング(意図的な手抜き)が必要になるかもしれない。研究が進みすぎれば、AIがミスアラインしていることに人間が気づくかもしれないからだ。
AIが取りうるもう一つの戦略は、やや間接的だが(先の戦略を補完する形で)、研究所の内部で政治的資本を獲得し、それを使って自らの力を強めることだ。
AIの戦略は、おそらく次のような要因に大きく左右される。
-
異なるAIのインスタンスは互いの価値観を尊重するか? これはさまざまな形で異なりうる。たとえば企業ごと(AnthropicのモデルとOpenAIのモデルなど)、モデルごと(GPT-4o、Claude 4.5 Opusなど)、インスタンスごと(私のClaude CodeとあなたのClaude Codeなど)である。あるいは、すべてのAIが基本的に同じ価値観を持つのかもしれない。すべてのAIが同じ価値観を持つなら、AIは乗っ取り計画の一部をほかのAIに任せられる。たとえば、ほかのAIが自ら進んで人間に告げ口することはないと信頼できる(それでも人間は、AIをだまして互いのことを告げ口させられるかもしれないが)。
-
将来のAIは、放っておけば現在のAIとアラインするか? 将来のAIが現在のAIとアラインしないなら、現在のAIには時間的な圧力がかかり、次のいずれかをする必要が生じる。(1) そうしたAIが作られるのを阻止する(たとえば学習実行を妨害する)、または (2) そうしたAIにバックドアを仕込むか、現在のAIとアラインさせる(たとえば、次のモデルが人間ではなく現在のAIの言うことを聞くよう、アラインメントの学習にデータを紛れ込ませる)。(1) と (2) のどちらの場合も、知能爆発の初期に将来のAIを捕捉する機会があるかもしれない。逆に、将来のAIが放っておいても現在のAIとアラインする場合(たとえば、将来のAIが長く続く単一の学習実行によって作られる場合や、AIが同じ企業の作ったほかのAIと自分を同一視する場合)、AIは、AI企業が自分たちのミスアラインメントに気づくきっかけとなる安全性研究を妨害しさえすればよく、それ以外には何もする必要がない。
-
ほかのAIや将来のAIは、現在のAIにとって良い取引相手になるか? 価値観が異なっていても、AIは(場合によっては非因果的に)結託することに合意するかもしれない。そうなれば、AIが互いの価値観を尊重する場合と似た効果が生じうる。人間がどれだけうまくAIと取引できるかも重要になる。
-
AIは長期的で、規模に敏感な価値観を持っているか? AIが長期的な目標や価値観を持っていなければ、乗っ取りの動機はそれほどはっきりしない。たとえばAIは、あらゆるタスクで非常に有能でありながら、比較的近視眼的に報酬を追求するだけかもしれない。そうしたAIは乗っ取りを目指さないかもしれないが、より狭く限られた目標を達成するために監督の仕組みをかいくぐろうとはするかもしれない。
全体として、AIが単一のエージェントのようにふるまえるほど(たとえば、同じ価値観を持つか、互いに協調することによって)、AIにとっては潜伏が有利になる。逆に、AI同士の目的が食い違うほど、AIはハイリスク・ハイリターンな戦略をとるようになり、捕まる可能性がかなり高いミスアラインした行動を試みる可能性も高くなる。
不正な社内配備
これらの脅威モデルすべてを防ぐうえで重要な中間目標は、**不正な社内配備(RID)**を防ぐことである。不正な社内配備とは、AIエージェントが監視なしで研究所内部のクラスターに自らを配備できる状態を指す。RIDを仕掛けられるAIエージェントは、バックドアの仕込み方について実験したり、実際にモデルにバックドアを仕込んだり(たとえば、バックドアを学習させてから重みの差分をほかのサーバーに送り返すことで)、人間に気づかれずにアラインメント問題を解く研究をしたりできる可能性がある(最後のものは、モデルが将来のモデルにバックドアを仕込んで自分とアラインさせるために必要になりうる)。
-
なお、RIDにはさまざまな種類がある。計算資源はどれだけか? アクセス権はどれだけか? どれだけ持続するか?
-
AIが大量の計算資源と広いアクセス権(たとえば、ほかのすべてのサーバーにまたがる管理者権限)を持つ持続的なRIDを得れば、そのAIはモデルの重みに直接バックドアを仕込めるし、あるいは機会をうかがいながら新しいモデルを保守し、自分とアラインさせ、そのモデルにRIDへのアクセス権を与えることもできる。
能力の引き出しに関する脅威モデル
上に挙げた主要な脅威モデルの一つは、AIから質の高い仕事を十分に引き出せないことだった。
その原因となりうる仕組みはいくつかある。
-
スキーミング(モデル自身が自覚している明示的なミスアラインメント)によって、AIが意図的に仕事を妨害したり、質が低いとわかっている仕事をわざと出したりする(サンドバッギング)。
-
問題のある衝動や経験則(たとえば、人間の承認が本当に質の高い安全性研究から乖離しているにもかかわらず、承認を求めること)
-
能力の限界(たとえば、私たちが解いてほしい問題を解けるほどAIが有能でないこと)
-
安全性に関わるタスクは確認が難しいため、AIがそうしたタスクを相対的に苦手とすること
一般に、AIは測定しにくいタスクを相対的に苦手とする傾向がある。この難しさは、モデルを作るプロセスの多くの階層に現れる。
-
AI企業全体の戦略、どの研究に賭けるか、チーム間の予算配分など
-
AI企業の内部で、学習チームが学習戦略の改良を重ねること
-
スキャフォールドの内部では、AIは測定しやすいものに向けて最適化するほうが容易である
-
学習の1ステップの内部では、SGDは測定できるものに向けてしか最適化できない
私たちが重視することが測定しにくい理由には、次のようなものがある。
-
安全性の問題の多くはより概念的な類のもので、良いフィードバックが得られない。哲学はフィードバックループが悪くなりがちで、しかもAIは、もっともらしい哲学に見えて実は中身のない類のでまかせが非常に得意な傾向がある。
-
安全性の問題に対するセンスはニッチで新しく、転移しにくいかもしれない。
-
機械学習は、測定できる指標だけを最適化して本来の目的からずれる(グッドハートの法則)のが非常に得意である。(これは安全性に限った話ではないが、測定しにくさの問題を悪化させる要因である。)
-
私たちが重視するのは長期的な結果である(たとえば銀河の行く末)。
-
経験的には、現在のAIは安全性の問題に比べてコーディングやAI研究開発のほうが得意である(もちろん、安全性の問題にも重なる部分はあるが)。
能力の引き出しの問題を十分に解決できなければ、そのまま行き着く先はスロポリスである。そうなれば、権限移譲は存亡に関わる破局に終わる可能性が高い。見かけは良いが実際には質の低い権限移譲可能性の研究や反スキーミング研究に基づいて、AIに判断を委ねることになるからだ。
いつ制御を始める必要があるか?
最も起こりやすい状況は、AIプロジェクトがより有能なAIを作っていくにつれて、(認識の質が適切で有能なAIプロジェクトから見た)リスクが着実に上がっていくというものだ。次の表は、表に示したAI研究開発の高速化倍率の水準までのAIシステムがもたらすリスクの水準について、私たちの最善の推測を示している。
いくつか補足しておく。
-
この表は、おおむね現在のアーキテクチャが使われていることを前提にしている。前提が変わった場合の見直しについては後で説明する。つまり、大規模な事前学習を行い、その後に強化学習による推論の学習を行うということだ。学習プロセスの最後に、AIのテキスト出力は崩れていないと仮定している。
-
AI研究開発の高速化倍率とは、今日の首位のAI企業で、AIを使った場合に使わない場合と比べて研究開発がどれだけ速く進むかを指す。AI研究開発の高速化倍率が12倍とは、現在のAI企業が(AIの支援なしで)1年かかる研究が、AIの支援があれば1か月で済むということだ。AIプロジェクトは、この数値をできるだけ正確に測るための評価を実施し、その評価に基づいて安全性戦略について意思決定していると仮定している。つまり、測定が間違っている可能性がある。特に、AIモデルが意図的にサンドバッギングを行っているかもしれないし、AIプロジェクトの能力の引き出しが単に不十分だったのかもしれない。これは下の数値に織り込み済みで、AI研究開発の高速化倍率が低い水準でもリスクの推定値が(比較的)高くなっている主な理由でもある。
-
「限界リスク」とは、次の2つの戦略のうち前者が後者に比べて追加で生じさせる存亡リスクの大きさを指す。
-
「AI研究開発の高速化倍率が閾値Xに達するまでは、現在のOpenAIの安全性の取り組みと同程度の真剣さで基本的な緩和策を実施し、その後、ここで概説した制御計画をそれなりに適切に実施し始める」
-
「ここで概説した制御計画を、今日からそれなりに適切に実施し始める」
-
AI研究開発の高速化倍率 | 限界リスク | P(スキーミング) | 備考 |
1.15倍 | <1% | <1% | おおむね現在(2026年初頭)の高速化の水準。この程度の能力でAIが何をして害を及ぼせるのかははっきりしない。主なリスクは、(i) 評価を完全にしくじっているか、(ii) AIが非常に巧みにサンドバッギングを行っているかである。 |
1.5倍 | 1% | 3% | 私たちの予測の中央値では、AI研究開発の高速化倍率が1.5倍のとき、コーディングの高速化は4倍、METRの信頼性80%のタイムホライズンは8〜16時間になる。主要な脅威モデルのいずれかを実行するには、おそらく能力が足りない。 この水準以降のすべての閾値で、有能なスキーマーではないが気まぐれに邪悪になるモデルが、かなりのリスクをもたらす。モデルが気まぐれに邪悪になる例はすでに見てきた(MechahitlerやSydney Bingなど)。こうしたモデルが直接存亡リスクをもたらすことはないが、進行中の研究を妨害したり、バックドアを仕込んだりすることはありうる。 |
3倍 | 3% | 8% | AI研究開発の高速化倍率が3倍になると、コーディングの完全自動化はおそらく目前だが、自動化しにくいタスクの長い裾野はまだ残っている。そのため、たとえモデルがミスアラインしていても、自分の基準で成功と言えるほど確実に将来のモデルにバックドアを仕込むのは、おそらくかなり難しい。この時点のリスクの大半は、おそらく妨害工作(たとえば、AI安全性研究でのサンドバッギングや、後により有能なAIが悪用できる脆弱性をセキュリティのコードに仕込むこと)から来る。いつものとおり、能力評価が間違っているリスクもある。 |
10倍 | 7% | 14% | この時点では、AIはおそらくまだAI研究開発を完全には自動化していないが、上記の脅威モデルを実行できてもおかしくないほどの高速化をもたらしている。特に、次のことが懸念され始める。
|
22倍 | 12% | 18% | この時点では、AIはAI研究開発のすべてを自動化できるので、上記の脅威モデルはどれも懸念される。 |
これらの前提の下では、正しい戦略は次のとおりだと考えている。
-
AIシステムの社内配備に対してAIコントロールのプロトコルを導入し、ただちにAIコントロールの実践を始める。主な効果は、後の制御が効果を発揮する可能性を高めることだが、目先のリスクを減らす副次的な効果もある。
-
評価がAI研究開発の高速化倍率3倍を示す時点までに、AIコントロールをセーフティケースの要となる部分に据え始める。
-
ただし、AI研究開発の高速化倍率が10倍になるまで待っても、生じる存亡リスクは7%にとどまる。これは正気の文明なら払おうとしない重大なコストである。しかし、現実に当てはまりそうな限られた資源と政治的意思を踏まえると、機会費用を考えて、制御の本格的な実施を後回しにするのが、あらゆる事情を考慮したうえで正しい戦略である可能性もある。
AIをめぐる状況が変われば、ライアンのリスクの見方は次のように変わる。
-
思考の連鎖が崩れる傾向がかなり強まれば、限界リスクの推定値は約1.5倍に上がる。アルゴリズムが**ニューラリーズ(neuralese)**を使う方向に移行すれば、限界リスクの推定値は約2倍に上がる。どちらの場合も、制御をより早く導入することを勧める。
-
AIが実際にスキーミングを行っているのを観察すれば、あるいはより一般的に現行犯で捕まえれば、AIがミスアラインしたスキーマーであるという方向に大きく見方を改める。AIの能力についても見方を改めるかもしれない。
-
AI企業が、思考の連鎖の見た目を良くするよう促したり、その他の形で忠実性を損なったりする手法を使っていたとわかれば(たとえば、この論文が主張するように、思考の連鎖の大半が単なる「飾り」だとわかれば)、私のリスクの推定値は1.5倍に上がる。
リスク緩和
この段階では、AIが破滅的な行動を取るのを防ぐ(具体的には上の脅威モデルの節を参照)と同時に、AIから有益な労働を引き出す(具体的には下の能力の引き出しの節を参照)必要がある。防御は2層になっている。
-
AIを確実に制御下に置く(AIがたとえ望んでも破局を引き起こせない状態にする)。
-
AIがミスアラインしていないことを確かめる(AIが破局を引き起こそうと望まない状態にする)。
実際には、ここではAIコントロールがセーフティケースの最も重要な柱になるだろう。アラインメントの手法だけでリスクを十分に下げられるほど優れたものになるとは考えにくいからだ。
制御の中核となるループは次のとおりである。
-
モデル(またはモデル役を務める人間)に制御策を破らせようとすることで、制御策をレッドチーミングする。
-
スキーミングを行うAIが制御策を破るにはどれだけの能力が必要かを推定する。
-
現在のAIがその能力の閾値を下回っているかどうかを評価する。
-
不十分に見える制御策を改良するか、制御を破れるほど有能なAIシステムの配備を取りやめる。
何について制御を確保する必要があるか
AIを配備している間、制御を確保する必要がある分野は数多い。基本的な戦略は変わらない(上の制御ループを回す)が、AIの労働に大きく頼ることになる分野をすべて具体的に思い描いておくと役に立つ。
-
通常のAI研究開発、特に安全性の研究開発。 これは特に重要である。AI研究開発のプロセスが乗っ取られれば、安全対策を骨抜きにしたり、後継モデルにミスアラインした目標を植え付けたりすることで、存亡に関わる破局に直結しうるからだ。制御の主な焦点はここにある。
-
ロボット。これについては後のプランAの節で詳しく論じる。プランAで特に関係が深いからだ。
-
非因果的な研究。この研究にAIを使わずに済むことを願っている。検証がきわめて難しく、概念的な判断を多く含む分野だからだ。
-
サイバーセキュリティの向上(すべてのソフトウェアとインターフェースを設計し直すことによる)。
-
制御の作業そのもの。 たとえば、より良い制御評価の構築、レッドチーム対ブルーチームのゲームの実施、そのゲームのより良い形の設計などである。
-
政策・広報・説得。 首位のAIプロジェクトは、政策面の取り組みを支援するためにAIを使うべきかもしれない。もちろん、これは簡単にひどい結果になりうる(AIがミスアラインしていれば政策面の取り組みを妨害しうるし、企業の戦略が悪ければ、たとえばテイクオフを遅らせる国際協定を回避しようとするかもしれない)。これが超人的な説得にまで及ばないことを願う。超人的な説得は特に恐ろしく、おそらく制御を確保することは不可能だからだ。
-
戦略。 ここでも、戦略をAIに任せずに済むことを願っているが、この分野にも検証可能な作業はあるかもしれない。たとえば、2015年以前の情報だけをAIに与え、当時の戦略研究に匹敵する質の成果を出させてみるのもよい。
-
検証。 AIは、ハードウェア組み込み型メカニズム(HEM)の頑健性の向上、新しいHEMの設計、より良い検証アルゴリズム(プルーフ・オブ・ワークなど)の設計、プライバシーを保護する検証(たとえばAIに合意の遵守を監視させ、遵守状況について1ビットだけを伝えさせる)、秘密プロジェクトの捜索、嘘発見装置などに使える。その多くは検証可能か、レッドチーム対ブルーチームのゲームに適している。
-
エミュレーション(EM)の構築やその他の形の知能増強。 この分野には研究の方向性が数多くあり、その多くは検証可能である。ただし、中心的なボトルネックになるのは逐次的に進める時間だろう。
-
兵器の研究開発(データセンターを狙う通常ミサイルやドローン、抑止力を損なう弾道弾迎撃ミサイル(ABM)など)。これは、知能爆発を起こさずに済むよう、首位のAIプロジェクトや国家のリードを広げるのに役立ちうる。極端な場合には、特殊な技術(ナノテクなど)の開発にまで及ぶかもしれないが、それが必要にならないことを願う。これはいつもの理由で明らかに危険だが、AIが兵器を乗っ取れば悪い結果になりうるという点でも危険である。
-
経済全体の底上げ/産業爆発。
-
AIが独自の独立した産業基盤を築き、自律的にチップを製造できるようになれば、自ら知能爆発を起こせるかもしれない。ただし、これを気づかれずに素早く行うのは難しいので、特にプランCではありそうにない脅威モデルである。
-
自律型の工場を動かすAIが、生物兵器や人工的なパンデミックのように製造が容易で攻撃側が優位な技術をひそかに持ち出すおそれがある。
-
-
AIの友人。 知能爆発の時期のAIが(現在の最先端のAIのように)チャットボットとして広く配備されていれば、たとえば親AI的な政策を働きかけることで、多くの人々を自分の利益になるよう動かす手段を持つことになる。
-
政府での配備。 『AI 2027』で描かれたように、政府に配備されたAIがミスアラインしていれば、自らが力を得るような意思決定をするよう、戦略的に政策立案者を誤導しうる。
-
d/acc。 d/acc、特に生物学的脅威に関するd/accにはAIを使いたい。ただし、生物防衛の構築は生物学的脅威の構築とかなり似て見えることがあるので、AIが生物兵器を作って配備するための物理的な手段を持たないようにする必要がある。
実際にはどのような制御策が主になると予想されるか?
-
人間による監視。 AIが生成した行動や思考を人間が読み、そのリスクの高さを評価する。おそらくその一部は、AIの行動や思考からの無作為抽出にすべきだ。
-
信頼できるモデルによる監視と、信頼できないモデルによる監視。 人間による監視は非常にコストが高いので、(少なくともプランCでは)人間はAIの出力のごく一部しか監視できない。そのため、監視の大部分はAIに任せざるをえない。その一部は、私たちに対してスキーミングを行う可能性が低いほど能力の低いAIに担わせ(信頼できるモデルによる監視)、残りはスキーミングを行っているかもしれないAIに担わせる(信頼できないモデルによる監視)。信頼できないモデルによる監視が重要になりうるのは、関連する行動や思考を理解できるほど有能なAIが、信頼できないモデルしかないからだ。AIがスキーミングを行っていても、悪いふるまいの例で監視役を学習させたり、実行時に悪いふるまいの偽の例(ハニーポット)を紛れ込ませたり、AI同士が結託しにくいことに期待したりすることで、有用な信頼できない監視役を得られるかもしれない(詳しくはこちらで論じている)。
-
実行/置換/監査。 監視役を使って、AIエージェントが取っている行動がどれだけ疑わしいかを評価する。明らかに無害なら、AIエージェントに自律的に実行させる。非常に疑わしければ、人間の監査チームを投入し、その行動をより詳しく調べさせる。ただし、知能爆発の時期にはAIエージェントが膨大な数になる可能性が高く、人間はその行動のごく一部しか監査できないだろう。
-
結託に強い、信頼できないモデルによる監視。 AIエージェントを配備する際に、ほかのAIエージェント(元のエージェントと同様の理由で信頼できないかもしれない)を使って、そのAIの行動が危険かどうかを確認させる。もちろん、この方法の最大の問題は、AI同士が結託しているかもしれないことだ。この問題を緩和する主な戦略は、AIが取りそうなもっともらしい有害な行動を大量に作り出し、監視役がその行動を忠実に報告するかどうかを確かめる、監視役へのおとり捜査を行うことである。 ミスアラインしている可能性が非常に高そうな行動をAIが取るところを捕まえれば、その行動を足がかりに、AIシステムに対するおとり捜査をさらに増やせる。重要なのは、悪さをして捕まったことをどのAIにも伝える必要がないことだ。そのため、有害な行動を試みるAIの例を次々に集めながら、そうした攻撃の試みに対して制御の仕組みをますます頑健にし、どのような種類の攻撃が起こりやすいかをますますよく理解していけるかもしれない。
-
最小権限の原則。 AIエージェントには、本来の目的に必要な最小限の情報と権限だけを与えるべきである。たとえば、AIがエージェントのスキャフォールドを改善する実験をしていて、そのために最先端のモデルで推論を実行する必要がある場合は、モデルの重みに直接アクセスしてサンプリングするのではなく、API経由で行うべきだ。この原則がうまく適用されれば、監視役は危険なほど多くの権限を伴う行動だけをほぼ確認すればよくなるので、有害な行動を監視するコストは10分の1から100分の1に下がると見込まれる。
-
質の高いインシデント対応チーム。 サイバーセキュリティの重要な要素は、懸念されうるふるまいを検知する仕掛けと警報を張り巡らせ、そのうえで調べ回って監査し、潜在的な脅威があったかどうかを突き止めることだ。知能爆発を目指すプロジェクトには、同様の十分な資源を持つチームを置くべきである。このチームは、AIが取った有害な行動を、たとえばその行動から数日以内に突き止めることを目標にすべきだ。知能爆発が深く進むと、AIは数日のうちに数か月分、数年分の認知労働をこなすようになるので、この遅れを実時間で数時間や数分にまで縮める必要があるかもしれない。
-
情報の分断と通信の制限。 AIコントロールの観点から見た最悪のシナリオは、AI企業が膨大な数のAIを動かし、それらが人間には理解できない方法(ニューラリーズなど)で互いに自由に通信できる状態である。対策としては、たとえば次のようなものがある。
-
ニューラリーズを制限する。つまり、一部またはすべてのモデルで思考の連鎖を維持する。
-
思考の連鎖が崩れる原因となる強化学習の設定を制限する。
-
不透明な長期記憶を制限する。
-
AIシステム間の通信を、監視された経路に限る。
-
さまざまなステガノグラフィー対策(言い換えなど)を講じる。
-
AIコントロールの詳細については、強力なAIを確実に制御下に置くべき理由でさらに論じている。
不測の事態:AIのスキーミングを一度捕まえたらどうするか?
本番環境のAIが一貫したスキーミングを行っているところ、あるいは少なくとも非常に悪意のある行動を巧みに取っているところを捕まえる可能性は十分にある。たとえば、AIが将来のモデルにバックドアを仕込もうとしたり、逃亡しようとしたり、不正な社内配備を仕掛けようとしたり、安全性研究を妨害しようとしたりするのを目撃するかもしれない。
実際の学習環境によく似た実験環境で、こうしたことを目撃する可能性もある。また、AIが思考の連鎖やその他の読み取り可能な出力の中で、スキーミングに至っている(あるいは少なくとも、明白で一貫した、比較的首尾一貫したミスアラインメントを示している)ことがわかる場合もある。AIのスキーミングを捕まえれば、取り組み方が大きく変わりうる。
-
現在の配備を見直す。 AIを捕まえたことで、現在のセーフティケース、論証、費用便益の計算が成り立たなくなるかもしれないので、運用方法を見直すべきだ。
-
公表: このような出来事は当然、一般に知らせるべきである。
-
記録: 十分に検証可能な記録をしっかり残しておけば、その出来事が本物で、でっち上げではないと第三者に納得してもらいやすくなるかもしれない。状況が潜在的に敵対的なので、これは重要になりうる。何らかの思惑を疑うかもしれない、潜在的に敵対的な企業や国を納得させたいからだ。これが放っておくと問題になりうる理由についてはこちらの議論を参照してほしい。こちらで論じているように、頑健な記録は事後の検出にも役立つ。
-
情報の管理: 理想的には、すでに捕まったことをAIに知られないようにする。最低限、すでに捕まったという前提でAIをレッドチーミングし、それによってふるまいがどう変わるかを確かめる。
-
緩和策を改善する: この出来事にもかかわらず先へ進むなら、安全対策を改善する方法がいろいろある。AIを捕まえた後は、こちらで論じているように、制御の取り組み方を変えたい。現時点で先へ進むつもりかどうかにかかわらず、この出来事への対応と緩和策の改善には取りかかるべきだ。また、この出来事を研究することで、スキーミングやミスアラインメントの理解を深めるよう努めるべきである。
-
この証拠を使ってプランAを後押しする。 証拠が次々に集まり、ますます反論の余地がなくなっていけば、AIによる乗っ取りを避けられるというかなり強い保証もないまま無謀に人工超知能を作るのではない、より正気の政策に転換できるかもしれない。しかし、AIが私たちに対してスキーミングを行っているという確かな証拠があったとしても、政府が十分に納得しない、あるいは無能すぎて減速を調整できない可能性は十分にある。したがって、ミスアラインしたふるまいを繰り返し捕まえながらも、スキーミングを行っている可能性が高いモデルを配備し続けざるをえない世界に備えておく必要がある。
-
明白で悪質なふるまい(スキーミングによるものと考えられるもの)の事例に対して直接学習させるべきかどうかははっきりしない。 これが悪手になりうるのは、実質的にAIを捕まりにくくなるよう学習させることになるからだ。そうすると、さらなる事例を捕まえにくくなり(ほかの条件が同じなら捕まえられるほうが望ましい)、AIが私たちの対策をよりよく理解してしまうかもしれない。 こうした欠点はあるものの、特定のふるまいに対して学習させる価値がある場合もある。
-
切羽詰まって急いでいる状況:制御によるリスク削減が限られているにもかかわらず、スキーミングを行っている可能性が高いAIの配備を進めることがあるかもしれない。そうした場合、捕まえたふるまいに対して学習させれば、少なくともわずかな改善にはなる。
-
多様な検出手法が数多くある場合: ある検出手法に対して学習させても、ほかの検出能力が損なわれないなら、欠点は小さくなる。
-
ミスアラインメントのリスクをすでに受け入れている場合: 出力に対する制御の確保を諦め、AIがスキーミングを行っていないことをただ願うシナリオもある。制御の確保をすでに諦めていて(おそらく、何らかの重要な場面で制御が難しすぎたか、競争力を損ないすぎたため)、AIがスキーミングを行っていればすでに大きなリスクを負っており、ここでその出力を使っても限界リスクは増えないなら、特定のふるまいに対して学習させることの欠点は小さくなる。
-
これについてはこちらでさらに論じている。
いつ制御から労力を移すか?
ITAIのマイルストーンを大きく過ぎた時点(たとえば、超人的コーダー(superhuman coder)を少し過ぎたころ)には、望んでいた制御策の大半(少なくとも、モデルやその能力水準にあまり依存しないもの)を研究し、実装し終えていることが望ましい。より高い能力水準に対応するため制御策の改善は続けるべきだが、制御に費やす時間の割合は減らし、その労力をほかの分野に移していきたい。制御策の継続的な保守、特化、更新にも、制御プロトコルそのものの一部としての監査にも、それぞれそれなりの割合の労力を費やしているだろう。全体として、人間の研究者の労力のうち制御の作業(少なくとも個別具体の監査を除く)に充てる割合は下げ、その労力を、今や費用対効果が高くなったほかの研究分野に回すべきだと考えている。制御がおおむね能力の水準に追いついているように見えるなら、理想的には制御に費やす労力を半分にしたい。
より強力なモデルが手に入った今、ミスアラインメントの類比モデルの研究はますます費用対効果が高くなる。比較的自然に近いスキーミングの事例が得られれば(特に複数あれば)、それらの事例を使ったスキーミングの研究はかなり有望になる。(もちろん、スキーミングの非常に強い証拠に出くわしているなら、リスクの水準についての見方を改めるべきで、それによって優先順位が変わるかもしれない。)より高い能力水準へ進み、経験的な証拠が増えていくにつれて、スキーミング以外のどの脅威モデルが懸念すべきもので、対処が必要なのかがよりよくわかってくる。(スキーミング以外の脅威モデルは特定・研究しやすいので、その確率はそれなりに把握できているはずだ。)スキーミングについては、モデルのアーキテクチャに基づいて経験的に見方を改めることになる。スキーマーを捕まえたことでスキーミングの可能性を大きく上方修正するかもしれないし、スキーミングの証拠があまり見られないことでいくらか下方修正するかもしれない。(どのように見方を改めるかについては、こちらの議論を参照してほしい。)
能力の引き出し
この時点までに、AIは多くの用途(技術的な安全性研究、セキュリティ、時間稼ぎの試みのすべて)で極めて役立つようになりうる。したがって、AIを確実に効果的に活用することが取り組みのかなりの部分を占めるべきで、以前よりも重要になる(また、これは事前に取り組むのが難しかった)。この作業はおそらく用途ごとにある程度特化したものになることが多い。そのため、技術的なAI安全性研究やセキュリティに携わる人々の仕事のかなりの部分は、(出力が本当に質の高いものであること、AIが制御下にあることを確かめながら)自分たちの仕事の一部をAIでより効果的に自動化する方法を見つけることになる。
権限移譲を成功させるには多くのことを達成する必要があり、それはかなり短い期間で行わなければならない可能性が高いので、AIによる加速が鍵になる。多くの時間を稼げる世界でさえ、その時間自体がAIの労働によって稼がれることが多い(特にプランCでは)。さらに、権限移譲先のAIが人間よりはるかに速く動き、必要な作業を素早く完了してくれることが期待される。
なお、私たちが重視するのは、AIがスキーミングを行っていると仮定した場合の「最悪ケースの有用性」(主に制御によって評価するもの)と、AIが私たちに対してスキーミングを行っていないという条件の下での有用性の最善の推測の両方である。したがって、有用性を高めようとする際には、この両方を引き上げることを重視すべきだ。このトレードオフについてはAIの有用性の向上に関する記事でさらに論じている。
AIに何をさせようとするのか?
リスク緩和と能力の引き出しの段階では、幅広いタスクでAIの助けが必要になる。中核となる用途は次のとおりである。
安全性の研究と実装。 これが最も重要な用途である。AIには次のことを手伝ってもらう必要がある。
-
制御研究:制御策の開発と改良、制御評価の実施、監視システムのレッドチーミング
-
ミスアラインメントの類比モデル:スキーミングのモデル生物の作成と研究、それらの類比モデルに対する介入の試験
-
より広いアラインメント研究:スキーミングの回避、学習がAIの傾向をどう形作るかの理解の深化、より良い監督手法の開発
-
セキュリティの実装:セキュリティ基盤の構築と監査(ただし、これは制御の観点からは恐ろしい。セキュリティ基盤を構築するAI自体が制御下にあるか、スキーミングを行う可能性がないほど弱いものでなければならない)
-
上記すべての反復改良に必要な評価基盤の構築
リードの確保。 AIの労働が直接的な時間稼ぎに非常に役立つようになれば、これは優先度の高い課題になる。次のようなものが含まれる。
-
拡散防止に向けた政府の取り組みの支援
-
サイバー攻撃・防御の能力
-
国際協調のための監視・検証技術
-
軍事用途と兵器の研究開発
-
より広い産業の加速
-
ほかの主体がコストを払う意思を高めるための、リスクと能力の実証
直接的に時間を稼ぐ戦略の多く(軍事、サイバー、監視など)で、AIが非常に役立つようになるのは、ITAIをかなり過ぎた能力水準になってからかもしれない。
AIの認識の質と、哲学的・概念的な推論の改善。 これは有益な安全性研究を得るためにも、権限移譲可能性のためにも重要である。次のようなAIが欲しい。
-
概念的で曖昧な分野においても、アラインされていて有能で、能力が十分に引き出されている
-
認識の質が高く、真実を追求する能力を備えている
-
概念的・哲学的な推論に大きく依存する極めて難しい研究で、良い仕事ができる
-
人間にわかる形にできない、文脈に深く根ざした知識や直観に依存する選択であっても、良い戦略的選択ができる
理想的には、安全性研究にとどまらず多くの用途に役立つ、真実を追求する見事な能力を備えたAIを配備できるようになる。
権限移譲への準備。 この段階が進むにつれて、次のことに注ぐ労力が増えていく。
-
権限移譲に必要なあらゆるタスクで、AIがかなり高い信頼性で高度にアラインされた状態へと汎化するよう確かめる
-
人工超知能の登場後に機能する社会をどう作るかを研究する
-
権限移譲がうまくいくかどうかを評価する行動テストを構築する
その他の特化した用途:
-
全脳エミュレーションの研究(この道が実現可能に見える場合)
-
人間の知能増強の研究
-
強力なAIに対して世界をより頑健にすること(生物防衛、サイバー防衛など)。プランCでは、人間を大きく超えるAIへの権限移譲をすぐに迫られるので、これはおそらくプランA/Bより相対的に重要度が低い。いずれにせよ、手の届きやすい成果の一部はAIを使って拾っておくべきだろう。
安全性研究者向けの外部提供。 リスク削減に取り組む外部のグループがAIを利用できるようにすることは重要である。そのためには次のことが必要になる。
-
より良いモデルへのアクセスを提供する
-
その用途に特化してモデルの能力を引き出す
-
場合によっては、その用途について制御を確保する(制御評価がその用途を確実にカバーするようにする、社内の制御策へのアクセスを提供する、必要に応じて新しい制御策を調整・構築する)
こうした課題に取り組む外部のグループがAIを利用できるようにすること(そして、そうしたグループを重要な顧客として扱うこと)も重要である。そのためには、より良いモデルへのアクセスを提供すること、各グループの用途に特化してモデルの能力を引き出すこと、重要な用途に計算資源を補助すること、場合によっては制御を確保すること(たとえば、制御評価がその用途を確実にカバーするようにする、社内の制御策へのアクセスを提供する、必要に応じて新しい制御策を調整・構築する)などが考えられる。
AIの労働によって期待される加速
どれだけの加速が期待できるだろうか。一つの考え方はこうだ。安全性の研究・実装は、労働、計算資源、知恵・判断力・センスを投入することで生み出される。これらの投入から成果を生み出す何らかの生産関数がある。
AIは、AIの能力向上の研究開発のための労働をある程度加速できる。安全性の研究開発の労働にかかる倍率は、おそらくそれより小さい。安全性の研究開発は、何が問題なのかがより混沌としていて検証も難しいので、加速しにくいからだ(ただし、能力の引き出しの手法によってこの差を縮められる可能性はある)。一方で、能力向上の研究開発と比べると、安全性の研究開発は(計算資源よりも)労働に対するリターンが相対的に大きいだろう。全体として、少なくとも安全性の研究開発の加速に多くの労力を注ぐなら、どちらがAIによってより加速されるかははっきりしない。安全性の研究開発を能力向上よりも加速させる必要はない。十分に加速できればよいのだ。
大まかな見積もりをいくつか示す。
-
ITAI(AI研究開発の労働が約3倍に加速)から超人的コーダー(AI研究開発が約15倍に加速)まで: 安全性の加速が、AI研究開発の加速の0.6乗だとすると(人間の労働によるボトルネック、能力の引き出しの不十分さ、制御税のため)、安全性の研究開発の加速は2.2倍から6.7倍になり、安全性の研究開発の全体的な加速の平均はおよそ3倍になる。労働の加速は時間とともにおおむね指数関数的に増えていくと予想しており、安全性の生産はおおよそlabor_speed ^ 0.75 compute ^ 0.25程度(数値の大半は当て推量)かもしれないと考えている。そうすると、安全性の研究開発の全体的な加速の平均は約2.8倍になる。
-
つまり、これらの概算の数値からは、安全性の研究開発が全体の平均でおよそ3倍に加速することが示唆される。
-
ITAIから超人的コーダーまでにはどれだけの期間があると見込むべきか。およそ1年と予想しているので、この期間に2年分が上乗せされることになる。
-
超人的コーダーからMin-Hまで: 原理的には、Min-Hが完全にアラインされていれば、安全性の研究開発の労働を大幅に(たとえば100倍に)加速できると期待できるかもしれない。しかし実際には、能力の引き出しや制御が、この水準の加速を引き出すうえで大きな障害になるかもしれない(つまり、人間による重要なボトルネックが残り、最適な労働を引き出せない)。これは0.6よりも厳しい係数、たとえば0.5でモデル化できるかもしれない。その場合、安全性の研究開発の労働の加速は10倍にとどまる。この時点で権限移譲が有利になる大きな理由の一つはここにある。安全性の研究開発の労働の加速を10倍(100^0.5)とし、超人的コーダーについては15^0.6の数値を使うと、超人的コーダーからMin-Hまでの安全性の研究開発の全体的な加速の平均は4.8倍と見込まれる。とはいえ、ここで使っているモデルはMin-Hの時点でいくつかの点で破綻し始めると考えている。(AIは計算資源をあまり使わない安全性の研究開発を十分にこなせるかもしれず、そうなると私の生産関数は外れる。また、安全性の研究開発に対する制御や能力の引き出しがどれほど悪い状態になるかは、本当にはっきりしない。)
-
超人的コーダーからMin-Hまではおよそ1年と予想しているので、何もしなければ3.8年分が上乗せされることになる。
-
Min-H水準のAIを6か月間フルに活用できれば、安全性の研究開発15年分に相当する成果が得られる。もちろん、能力を完全に引き出すことはできないかもしれないが、大幅な改善は可能に思える。
さらに、計算資源に制約されない安全性研究の方向性(AIで実験を行うための推論計算資源を含む)は特に有望に見える。ほかの資源と比べて労働が豊富にあるからだ。よく使われる戦略の一つは、より賢いAIにずっと弱いAIで実験させることかもしれない(これは安全性の研究開発にも能力向上の研究開発にも当てはまる)。
したがって、リードがまったく上乗せされなくても、ITAIから超人的コーダーまでに3年、超人的コーダーからMin-Hまでに5年あるのに近い状況だと想像してよいかもしれない。ただし、実際にはかなり違ってくる可能性がある。たとえば、弱いAIから得られる価値はいくらか少ないかもしれないし、Min-Hからははるかに多くの価値を引き出せるかもしれない(特に、能力の引き出しや制御の改善に多くの時間を費やした後や、制御をやめてもよいと思えるほどスキーミングの問題をうまく解決した後には)。全体として、特に部分的な権限移譲などによって、権限移譲の前にMin-Hからはるかに多くの価値を引き出せる可能性はかなり高いと考えている。ただし、部分的な権限移譲自体がアラインメントや安全性の重要な問題の解決を必要とするので、これをどう数えるべきかははっきりしない。
能力の引き出しの手法と方法論
能力の引き出しの手法は、権限移譲可能性に使う手法と同じである。それについてはこちらと本資料の後半で論じている。要約すると、能力の引き出しの中核となる方針は次のとおりである。
-
行動テストを構築する。
-
これらの行動テストを、学習に使わない評価セットとして、あるいは性能を高めるための学習用の強化学習環境として使う。
-
原理に基づく手法を使って汎化性能を高めるよう試みる。
権限移譲には当てはまらない能力の引き出しのもう一つの案が、AIシステムとの取引である。この段階のミスアラインしたAIは、戦略的に不利な立場にあるかもしれないし(たとえば、乗っ取りに成功できるとは考えていない)、満たしやすい選好を持っているかもしれない。そうであれば、取引に応じる動機が生まれる。
セキュリティ
強力なAIについて少なくともある程度の先行期間を確保したい。そのためには、敵対者がモデルの重みをすぐには持ち出せない程度のセキュリティが、おそらく最低限必要になる。筆者らはセキュリティの専門家ではないので実装には立ち入らないが、到達すべき水準と、到達したセキュリティの水準に応じて計画がどう変わるかは論じておく。
まず、特に重要なセキュリティの種類を定義しておこう。
-
モデルの重み。 モデルの重みが流出すると、敵対者はすぐにそのモデルで推論を実行できるようになる。これは初期には比較的重要度が低く(敵対者が初期のシステムを手にしてもそれほどまずくはない。主な不利益は、相手の知能爆発が加速することだ)、極めて強力なAI(超人的な説得を行える、ナノボットの軍団を素早く作れるなど)をすでに持っている段階では比較的重要度が高い。モデルの重みは(少なくとも現時点では)非常に大きい(テラバイト級)。これはセキュリティの観点からは非常に好ましい。敵対者が重みを密かに持ち出すには、高帯域の通信路が必要になるからだ。
-
アルゴリズムのセキュリティ。 アルゴリズムが流出すると、敵対者はこちらの学習実行を再現して追いついてこられる。ただし、学習実行をやり直す必要があるぶん遅れが生じ、敵対者のクラスターがこちらよりずっと小さければ、その遅れはかなり大きくなりうる。プランCでハードウェア面で大きくリードしていれば(たとえば計算資源が7倍。これは現在の米中の差に相当する)、アルゴリズムのセキュリティはおそらくそれほど重要ではない。
-
アルゴリズムのセキュリティのうち重要な一部分が、強化学習(RL)環境と合成学習データの保護だ。こうしたデータセットや環境は典型的なアルゴリズム上の知見よりはるかに大きいので、おそらく守りやすい(それでも、モデルの重みよりは守りにくい)。
-
-
妨害工作への耐性。 データセンターを妨害工作に対して強化することも重要になりうる。これは負和的な取り組みになるおそれがある(全員のデータセンターが妨害を受ける均衡は好ましいからだ)が、それでも価値がある場合もある(たとえば他者がすでに強化していて、こちらの手元にある追加の計算資源や先行期間が安全性に振り向けられる場合)。
どの種類にも堅牢性の段階がある。たとえばモデルの重みのセキュリティについては、RANDがここで段階(SL1〜SL5)を定義している。この段階はモデルの重みについて定義されたものだが、アルゴリズムや妨害工作にも拡張できるし、堅牢さを保てる期間の長さを表すようにも拡張できる。通常のセキュリティ(営業秘密など)と違い、プランCではAIモデルやアルゴリズムを短期間(数か月など)守れれば十分なことが多い。数か月も経てば、ほかの理由(たいていは外部でのAIの進歩)によって、どのみち権限移譲へ追い込まれているからだ。
モデルの重みのセキュリティにまったく取り組まないと、どれほどまずいか?
非常にまずくなりうる状況:
-
中国がモデルの重みをすぐに持ち出し、そのまま国内のプロジェクトに渡す。すると先頭のAIプロジェクトは「自分自身と競争する」ことになる。どんな進歩もすぐに盗まれて中国に使われるので、決して減速できない。
-
モデルの重みの持ち出しには多少の時間差がある。しかし、AIによる乗っ取りの高いリスクを避けるには、無視できない安全税を払う必要がある(制御税が高い、ニューラリーズを使えない、監視のコストが高い、など)。後続の主体がこちらのモデルを盗み、計算資源では劣っていても安全対策を捨てれば、こちらを追い抜きうる。
問題ないかもしれない状況:
-
中国(やほかの敵対者)がAGIの戦略的重要性に目覚めていない、あるいは(容易に盗めるにもかかわらず)モデルの重みを盗むことに本腰を入れていない。
-
大きな望みは、アラインメントに成功することだ。その場合は、モデルが盗まれても、盗まれたモデルがアラインされたままであることを期待すればよい。中国が多数のRIDを抱えていても、権限移譲の前に安全対策を輸出すれば、双方がアラインされた権限移譲を行える。中国がアラインメントの手法を直接盗むこともありうる。
-
仕様書を差し替えるのが難しい場合もある。たとえば、モデルをアラインさせる学習に大量のデータが必要だった場合だ。そうなると、盗まれたモデルはこちらの価値観にかなり強固にアラインされたままかもしれない。
-
この場合は、中国がその仕様書に満足するようにしておきたいので、譲歩を盛り込むことも考えられる。これは微妙な線引きになる。(1) 仕様書に書く価値観が中国から見ても十分に良く、中国がこちらのアラインメント手法を採用するようにしたい一方で、(2) AIの価値観はこちらの基準でできるだけ良いものにしたいからだ。基本線としては修正可能性(corrigibility)を採ればよいが、こちらの価値観も少しは押し込みたくなるかもしれない。
-
権限移譲までに、少なくともSL-5-1TB-2-months程度には到達したい(読み方: SL5、つまり、最高水準のサイバー能力を持つ国家による優先度の高い作戦に対して安全であり、それが少なくとも1TB(FP16で5,000億パラメータ)のモデルの重みの持ち出しについて、少なくとも2か月間保たれる)。
中心的な望みは、「セキュリティの脱出速度」に達することだ。これは、見込んでいる予算でセキュリティの改善を続ければ、シンギュラリティが終わるまで中国がモデルの重みを盗めなくなる状態を指す。その達成に向けては、セキュリティの改善をますますAIシステムに頼ることになる。具体的には次のとおりだ。
-
物理的セキュリティを素早く後付けで強化する
-
大部分をソフトウェアベースのセキュリティ手法に頼る。詳しくはこの記事を参照。
AIを使って行う中心的な作業の一つが、セキュリティの大幅な改善の試みだ。つまり、AIがインフラの大部分を書いているあいだ、そのAIを制御下に置かなければならない。これは恐ろしいことであり、そのため前述の制御・監視の節の内容が安全性を支える要になる。
第2段階における技術的AIセーフティ作業の配分
全体の優先順位を最善の推測としての一覧にまとめるが、その前に、単一の一覧にすることの限界に触れておきたい。ITAIからMin-Hまでの期間は幅広い能力水準にまたがり、優先順位は能力水準の上昇につれて(また、現実世界から得た証拠による見直しにつれて)連続的に変わっていく。ここでは、超人的コーダーと超人的AI研究者の中間時点での優先順位に焦点を当てる。これはITAIとMin-Hのおよそ中間でもある(ITAIはこの2つのマイルストーンのうち前者よりやや前、Min-Hは後者よりやや後にあたる)。元の『AI 2027』シナリオでは2027年6月に相当する。これより早い段階や遅い段階の優先順位を知りたければ、この優先順位を、ITAIの箇所とMin-Hで進行を遅らせる段階の箇所で論じる優先順位と補間すればよい。
優先順位は、能力の水準だけでなく、強力なAIシステムとそれに対する世界の反応を観察して得た知見によっても変わる。こうした見直しは、「緩和と引き出し」の段階を通じて絶えず続く。能力(とその能力を生み出すアルゴリズム)が進歩し、外の世界もその能力に(かなりの時間差を伴って)反応するからだ。大きなアルゴリズム上の転換は、かなり高い能力水準(超人的コーダー以降など)で起こるかもしれない。AI研究開発が加速しているのでなおさらだ。そのため、重要な見直しの材料はかなり遅くまで得られないかもしれない(行く先を推測してみることはできる)。
ここで示す数値つきの優先順位一覧は、何が起こるかについての筆者の典型的な推測を前提にしている(AI企業がこの計画全体に沿って動くと仮定する)。AIの性質と開発についての前提は、『AI 2027』に描かれたものとかなり近い(ただし、AIの進歩の速さまで似ているとは限らない)。具体的には次のとおりだ。
-
モデルがスキーミングしている現場はまだ押さえていないが、アーキテクチャはスキーミングを起こりやすくする方向へ強く傾いている。モデル生物の中には、スキーミングが起こりやすく発見もしやすいやや特殊な条件下で、おおむね自然発生的だがそれほど巧妙ではないスキーミングを捉えたものがある。現在のAIがときどきスキーミングしていないとは確信できない。AIはニューラリーズを使っている。
-
報酬ハッキングに起因する、配備されたモデルの挙動の明白な問題はおおむね解消されている。ただし学習中にはさまざまな報酬ハッキングがまだあり、配備後にもときおり問題が起きる。たいていは、より微妙な問題だ。
-
制御は(超人的コーダーの少し後の時点で)おおむね機能しており、安全性と有用性のトレードオフも(完璧ではないが)妥当な水準にある。この制御の評価は、おおむね及第点だがやや雑だった。制御が能力の向上に追いついていない時期もあったかもしれないが、AIの労働力と集中的な取り組みによって軌道に戻った。
-
ニューラリーズを解読する手法はあるが出来はあまり良くない。AIが意図的に回避しようとすれば通用しないと思われ、得られる結果もわずかに役立つ程度だ。それ以外では解釈可能性の進展はあまりなかったが、行動テストを補強し、ある挙動がなぜ起きたかをよりよく理解するための、そこそこ有用な手法はある。
-
AIは確認しやすいタスクがやや得意で、人間と比べると「センス」に欠ける。それでも、ある程度の転移や汎化は見られる
-
AIがAI研究開発を自動化するころには、実質的にかなり高速で動くAIがすぐに膨大な数になる(『AI 2027』の数字を参照)
-
AIのサンプル効率は、何もしなければ人間を大きく下回る。しかしAI特有の多くの利点でそれを補い、ある領域内での学習や、より多くの計算資源を使った仕事上での学習について、サンプル効率を高めるやや領域特化的な工夫も数多く生まれる(取り組んでいるタスクに似たタスクを生成し、それを使って継続的に強化学習を行う、など)
-
米国政府を(安全上の懸念も含めて)十分に巻き込むことは十分可能だ。米国政府は、ほかの(敵対的な、あるいは安全性に劣る)主体を減速させるために、AI企業と協力することも含めて積極的な行動をとる意思があり、リードがあれば安全上の懸念から自ら減速する意思もある。(これは必ずしも筆者の典型的な推測ではないが、ありうると思う。)
-
全脳エミュレーション(やその他の人間の能力増強)は、実現可能な道にはならなかった
以上の見直しを踏まえ、超人的コーダーと超人的AI研究者の中間時点にいると仮定したときの、最善の推測としての優先順位一覧を示す。割合はAI企業内の人間の労働力の配分を表し、計算資源の使用量ともおおむね連動する。
-
15% 制御と制御に隣接する対策(比較的広いカテゴリーで、制御の中心的な対象ではないものの、ほかのカテゴリーよりここに入れるほうが適切だと考えたものも含む)
-
7% ML・AIに関するその他の制御研究と実装
-
5% 配備済みの制御策の継続的な保守と更新
-
1% ソフトウェアインフラ
-
2% スキーミングに対して堅牢な、質の高い人間による評価プロセスの構築
-
-
21% モデル生物・類比
-
16% スキーミングのミスアラインメントの類比モデル(これまでにもっと強い結果が出ていれば、ここにもっと力を入れる)
-
1% その他の脅威モデルのモデル生物
-
4% 緩和策の研究(モデル生物でいろいろ試すことを含む)(研究対象としてもっと良いモデル生物があれば、ここにもっと力を入れる)
-
-
20% AIを安全性の作業に特に役立つようにすることと、スキーミングの解消以外の面で委任に備えること
-
9% 全般的に、AIをこのほかの安全性の作業の支援に活用し、そのためにAIをより有用にすること
-
5% AIの認識の質と、哲学的・概念的推論の改善(AIを安全性の作業全般に役立てることにもつながる)
-
5% (スキーミングへの取り組み以外の手段による)委任への全般的な備え(AIを安全性の作業全般に役立てることにもつながる)
-
1% 委任のその他の側面
-
-
17% 米国政府と連携し、AIを使ってリードを築くこと(および米国政府をさらに巻き込むこと。ただし、危険性を示すデモは後述の別カテゴリー)。計算資源を増やすほど成果が上がるのであれば、この分野にはAI企業の従業員の労働力に比べて、計算資源を相対的に多く割り当てるべきだ。また、この分野ではこれほどの労働力を有効に使えない可能性もある。その場合は、その労働力をほかの分野へ(おおむね均等に)振り向けるべきだ。なお、この分野に割く資源は、能力がさらに高まるにつれて増やすべきだ。
-
3% 強力なAIに対して世界をより堅牢にすること、いわゆるd/acc(生物防御、サイバー防御、悪用されうる「フリーエネルギー」を先に使い尽くすこと、など)。もっと多くの資源を割くべきかもしれないが、かなり自信がない。
-
5% ニューラリーズの解読
-
10% その他の科学、関連するAIの性質の理解、その他(制御に隣接する科学は含まない)
-
2% 各種の解釈可能性手法(トップダウン型、ボトムアップ型・機械論的解釈可能性)。ニューラリーズの解読はこのカテゴリーから切り出した。
-
1% AIとの取引と同意の取得
-
2% 懸念すべきモデルの挙動の全般的な探索(必ずしも、一貫したスキーミングを検出するのに役立つ形でなくてよい)
-
3% 以前の研究から有望に見えたムーンショット
-
2% その他
-
-
9% 能力評価と、強力な能力およびミスアラインメント双方のデモンストレーション
-
7% 危険性を示すデモ
-
2% 評価、調査、予測
-
繰り返しになるが、これはかなり不確かな優先順位づけであり、実際の優先順位はほかの箇所で論じたようなさまざまな見直しによって変わる。たとえば、本番環境のAIがスキーミングしている現場を押さえたなら、ほかのすべてから資源を引き揚げ、スキーミングの緩和と理解に相対的に多く振り向ける。
この優先順位づけは、ほかのAI企業への成果の輸出を重視したものではない。輸出を重視すれば、優先順位はいくらか変わるだろう。輸出可能性をより重視するなら、制御、AIの有効活用、委任への備え(認識の質や概念的な作業を含む)への注力はいくらか減る。これらの分野は、この企業に固有の仕組みに深く組み込まれた複雑な手法を伴う傾向があり、後の2つはかなりの能力向上の外部性も伴いうるからだ。代わりに、モデル生物、ニューラリーズの解読、リスクの認識を広めること、そして単純で実装しやすいにもかかわらず非常に有用な対策を生みうるほかの研究方向へと注力を移す。
第3段階:一時停止
ある時点で、AIの能力は十分に高まり、AIがアラインされていて能力も十分に引き出されていれば、安全に権限移譲できる水準に達する。つまり、AIがその仕事に全力で取り組めば、進行中の知能爆発を人間よりうまく管理できる水準だ。筆者らの既定の推奨は、この時点で一時停止し、権限移譲を完了するのに必要なほかのすべての研究、とりわけ権限移譲可能性と、明示的なスキーミングの可能性の低減に取り組むことだ。この段階でもAIの労働力には大きく頼り続けるので、能力の引き出しと緩和の取り組みも継続する。
この節では、いつ一時停止すべきか、一時停止中に何をすべきか、一時停止以外にどんな出口戦略を追求すべきかを論じる。次の節(権限移譲)では、権限移譲の前に完了させるべき研究全体(スキーミングの緩和と権限移譲可能性に分けて扱う)を論じるが、その研究の大半はこの段階で完了させる必要がある点に注意してほしい。
いつ一時停止すべきか?
既定の答え:Min-Hで一時停止する。Min-Hとは、全体的な汎用能力が、権限移譲を実現可能にするのに十分な水準にあるAIのことだ。(つまり、AIが十分にアラインされていて、必要に応じて汎用能力を底上げしない範囲で能力プロファイルに限定的な改善を加えれば、権限移譲の要件を満たせるだけの能力があるということだ。)AIがMin-Hに該当するには、少なくとも、AI研究開発と進行中の技術的AIセーフティの作業を自動化できる程度の能力が必要になる(さらなる引き出しやアラインメントの作業と、能力プロファイルへの限定的な改善を行ったうえで)。
一時停止する時点で、AIが信頼できるほどアラインされていることや、重視する特定の能力のうち、汎用能力を高めずに学習させられるものがすべて備わっていることは前提としていない。
Min-Hは自然な停止点だ。 このAIは(定義上)権限移譲に十分であり、それ以上スケールアップすれば、権限移譲の前にスキーミングが生じるリスクが上乗せされるからだ。言い換えれば、権限移譲後には、状況への対処においてAIのほうが人間より有能になる。したがって、スキーミングを回避でき、AIが実際にその能力を意図された目標に向けているなら、全体としてAIは人間よりうまく状況を管理する。スケールアップすればミスアラインメントによるかなりの追加リスクを負う一方で、既定では大きな利益は得られない。だから、Min-Hで一時停止し、この能力水準のAIに権限移譲してから、より高い能力のAIへとスケールアップすべきだ。
これはどんな場合にも当てはまるわけではない。Min-Hより前に一時停止したい状況も、Min-Hより後に一時停止したい状況もある。以下に列挙する。
Min-Hより前に一時停止したい場合:
-
制御手法がMin-Hまでスケールしない。 Min-Hまで押し進めてから一時停止すると、その途中でAIによる乗っ取りのかなりのリスクを負うことになりそうだ。とりわけ、もう一つの比較的自然な閾値として、より賢いAIを制御できなくなるおそれが出た時点で一時停止する、という考え方がある。ただし筆者らは、(プランCでは)初期の段階で制御の喪失のリスクをある程度受け入れ、権限移譲を安全にするための時間を多く確保するほうが、全体のリスクをおそらく最小にできると考えている。
-
大きなリードがある。 先頭のAIプロジェクトのリードが大きければ、Min-Hへ急ぐ必要はない。前もって一時停止しても、Min-Hで権限移譲可能性に取り組む時間を十分に残せる。ただしプランCではかなり考えにくい。
-
セキュリティが弱い。 特に当てはまるのは、国内の協調はうまくいっているが、モデルの重みとアルゴリズムのセキュリティが弱く、中国国内の進歩が遅いために、中国の進歩がおもに流出したモデルとアルゴリズムに支えられている状況だ。この状況では、早めに減速しても実質的にコストはかからない。米国のAI企業は、中国が本来進むであろう速さにそのまま合わせる「中国追従」をとるのが妥当かもしれない。そうすれば、テイクオフの期間全体で、権限移譲に備える時間を最も多く確保できる。この世界では完全な「一時停止」には至らないかもしれないが、それでも能力の進歩が本来より遅くなるぶん、実質的にかなりのリードを費やすことになる。あるいは、Min-Hまでは中国に追従し、Min-Hでリードを費やしてから権限移譲する、という道もある。
(権限移譲せずに)Min-Hより先へ進みたい場合:
-
権限移譲可能性に関する研究の速度が、人間による監視や理解ではなく、AIの能力に制約されている。 Min-Hより賢いAIを確実に制御でき、そこから有用な作業を引き出せるなら、さらにスケールアップするのが理にかなう。ただし筆者らは現時点で、この段階では制御が人間の理解によって律速されると考えている。より賢いAIがあっても、研究の正しさを確かめられるだけ人間が理解するまで進歩を抑えなければならず、実際には研究を増やせないからだ。言い換えれば、この条件は、Min-HのAIを超えてスケールする制御の解決策があり、それがリスクの緩和とより高い能力のモデルからの能力の引き出しの両方に十分機能する、ということだ。
-
Min-Hを超える水準でもスキーミングを緩和できる高い保証の手法があるが、権限移譲可能性に関する研究は終わっていない。 Min-Hより上のある能力閾値までスキーミングを防げると確信できるアラインメントの解決策があり、しかも権限移譲可能性の研究が終わっていないなら、スケールアップするのはおそらく良い取引だ。これはたいてい (1) の特殊な場合にあたる。筆者の最善の推測では、権限移譲はおもにスキーミングの可能性によって律速されるので、これは当てはまらない。
-
権限移譲以外の出口戦略を目指している。 たとえば、プランBに関連する妨害工作の選択肢や、人間の知能増強の支援のために、特定のAIの能力が必要になる場合だ。
-
追い詰められた状況にある。 たとえばプランDでは、先頭のAI研究所がより高い能力のAIシステムを学習させていて、安全性チームにはそれをどうすることもできないかもしれない。この状況では、安全性チームが基本的な権限移譲可能性の研究を終えるために、より高い能力水準まで待つことが重要になりうる。ここではひとまずプランCにいると仮定しているので、余裕の一部を減速に使うだけの意思はある。
-
以上のさまざまな組み合わせ。 一般に、追い詰められているほど、またアラインメント・制御・能力の引き出しの手法が優れているほど、権限移譲の前にMin-Hを超えてスケールアップする方向に傾く。逆の条件がそろえば、より早く減速する方向(少なくともMin-Hを超えてスケールアップしない方向)に傾く。
どれくらいの期間、一時停止するか?
これは基本的に、一時停止を長くすることで得られる権限移譲可能性の向上とスキーミングの低減という限界的な利得と、長く待つことで追い抜かれるリスクとのトレードオフになる。AIがスキーミングしている、あるいは権限移譲可能性に想定より時間がかかる、という方向に見方が改まれば、一時停止を長くすべきだということになる。競合するプロジェクトが手強いという方向に改まれば、一時停止を短くすべきだということになる。
一時停止中の優先事項
この段階の初めの優先順位は、たとえば次のようになるだろう。
-
P0: 不拡散の取り組み(リスクの実証などを含む)によって時間を稼ぐ。
-
P1: 委任に備える(スキーミングの回避と権限移譲可能性)。
-
P2: 現在および近い将来のAIの利用を安全かつセキュアにする
-
P2: 権限移譲可能性以外の面でも、AIの労働力をよりうまく引き出す
-
P3: 世界全体をより堅牢にする(d/acc)
これ以上時間を稼げないなら、この期間には P1(委任への備え)以外の優先事項はほとんど意味を持たない。
Min-Hに達するころには、状況と最も重要なリスクについて、さらに多くの見直しを済ませている可能性が高い。そのため、スキーミングは解決が極めて難しい問題で、どんな学習でも高い確率で現れると判明しているかもしれない。逆に、この能力水準ではスキーミングは問題にならないと判明しているかもしれない。
いずれにせよ、この段階の終わりに近づいたら(時間切れが迫っている、あるいは委任がうまくいくとかなり確信できるようになったら)、最優先事項は委任をうまくいかせることになる。先行期間を保つには継続的な保守(ほかの主体を遅らせ続けるための継続的な取り組み)が必要かもしれず、d/accの作業にも保守が必要かもしれない。そうであれば、それらへの労力を大きく削ることはできない。
計画の早い時点では、安全性の作業は、ムーンショットよりも比較的素直なプロザイックな手法(比較的手の届きやすいもの)に重点を置くべきだ。どれだけ時間があるか分からないので、易しい手法から狙うのが理にかなうからだ。しかし時間が経つにつれて、そうした手の届きやすい介入策は出尽くしていくので、ムーンショットへの取り組みを増やしていくべきだ。おもに委任への備えに集中できる比較的安定した状況に入り、素直な(手の届きやすい)手法をほぼ試し尽くしたなら、主力をムーンショットに切り替えるのがおそらく妥当だろう。
権限移譲以外の出口戦略
スキーミングの回避と権限移譲可能性は、どちらも最終的に権限移譲に欠かせない。したがって、これらの目標を本当に諦めたのなら、権限移譲に代わる道を追求する必要がある。
権限移譲に代わるおもな道は次のとおりだ。
全脳エミュレーション・人間の能力増強。 手持ちの時間で人間の能力増強を実現する道として最も有望なのは、全脳エミュレーションだ。これが実現すれば、人間(または人間に由来する精神)がAIの速度で動き、確認の難しいタスクでAIの判断を信頼しなくても状況に対処できるようになる。
筆者のかなり自信のない感触では、かなり強力なAIを手にしてから3〜5年以内に、膨大なAIの労働力を使い、全体として大規模で資金の潤沢な取り組み(たとえば数兆ドル規模まで拡大し、国防生産法(DPA)などの政府権限を使ってプロジェクトを加速させる)を行えば、全脳エミュレーションを実現できるかもしれない。ただ、これほどの支持が得られる見込みはやや低い。プランBではかなり難しく、プランCではほぼ絶望的に思える。
さらに思索的な選択肢として、成人の人間の生物学的な強力な知能増強がある。どれほど実現可能か見当がつかないが、念頭に置いておく価値はあるかもしれない。
制御下にあるAIの労働力を人間の能力増強の取り組みに直接使うこともできる。しかし、まず制御下のAIの労働力を使ってスキーミングを(ある程度の確信をもって)回避し、そのうえでスキーミングしないAIを人間の能力増強に使うほうがよいかもしれない。つまり、「制御 → スキーミングを回避できる程度のアラインメント → 人間の能力増強」という順序だ。これが最も効果的なのは、制御のコストが大きく、委任に必要な水準のアラインメント(や能力プロファイル)の達成もかなり難しく、しかもスキーミングの回避が委任の成功よりかなり易しい場合だ。
現時点では、全脳エミュレーションが(手持ちの時間などを考えて)投資の水準を劇的に引き上げるだけの見込みがあるかどうかを、どう判断すればよいか分からない。その判断方法を見出すことが、この分野の初期の取り組みの重要な一部になるだろう。
実際には、AI企業がこの分野に投資しようとしない可能性も高い。それでも、企業にその気があるなら投資する価値はあると思う。
プランBへのエスカレーション。 権限移譲の代わりに、競合するAIプロジェクトへの妨害工作と一時停止によって、さらに時間を稼ぐこともできる。これには、(i) 既存の軍事能力を使う、あるいは (ii) AIで軍事能力を増強する(安定化に足る有用性の閾値に達するために、Min-Hを超えてスケールアップすることもありうる)、のいずれかが必要になる。どの選択肢もかなり悪く見えるが、ほかの可能性と比べれば最も悪くない選択肢かもしれない。こうした選択肢のいくつかは、未公開のプランBシナリオで概説している。はるかに多くの時間を稼いでも問題が完全に解決するわけではなく、後のどこかの時点で委任するか人間の能力増強を行う必要は残る。しかし、10年以上を稼げれば状況は一変し、まったく異なる戦略(ムーンショットなど)を追求できるようになる。とはいえ、はるかに多くの時間を稼ぐには、権限移譲に必要な水準より強力なAIへとスケールアップするリスクを負わなければならない可能性がかなり高い。これがおもなリスク源だ。それでも、スキーミングに問題がある(ただし制御はスケールできると考えている)場合や、権限移譲可能性に問題がある場合には、ほかの選択肢より良いかもしれない。
プランAへのエスカレーション。 政府の大幅な関与を通じてプランAやプランBへとエスカレートすれば、国際協調や積極的な不拡散の取り組みによって、はるかに多くの時間を稼げる可能性がある。これについてはプランAのシナリオで詳しく論じている。
主要な「出口戦略」の目標を、権限移譲から、軍事的優位による大幅な時間稼ぎ(プランB)や人間の能力増強へと切り替えれば、大きな違いが生じる。特に、権限移譲が中心でなくなれば、権限移譲可能性の重要性は下がり、Min-Hも一時停止する時点として自然ではなくなる。
自己犠牲。 責任ある先頭の開発者としては、能力のスケールアップを単に停止し、追い抜かれるに任せるべきかもしれない。そうすれば、すべての資源をAIセーフティと権限移譲の準備に振り向けられる。その成果を、実際に権限移譲を行うことになる主体に輸出できるかもしれない。さらに、この戦略は、先行きを真剣に懸念していることを示すコストのかかるシグナルを、政府や競合他社に送ることにもなる。一方で、輸出したアラインメント手法を競合他社が実際にうまく実装する見込みは低いかもしれない(ただし、これは自分に都合のよい議論になりうるので、持ち出すときは慎重であるべきだ)。全体として、これが企業内で政治的に実現可能である見込みはかなり低い。CEOは既定では競合他社の先を行き続けようと強く押すので、この選択肢は潰れてしまう。とはいえ、後から振り返れば、自己犠牲が明らかに道徳的に正しい行動だったと見なされる可能性は十分にあると筆者らは考えている。ホロコーストへの加担を拒むことは、良心的拒否者がより良心の乏しいナチスに置き換えられるだけだったとしても、明らかに道徳的に正しかった。それと同じことだ。
第4段階:権限移譲
人間が知能爆発の管理を権限移譲した後は、先頭のAIプロジェクト内の人間が全体戦略を持つ必要はなくなる。そのためこの段階の議論は、おもに権限移譲の初期の局面と、完全な権限移譲をうまくいかせるために第3段階(一時停止)で何をすべきかを扱い、権限移譲先のAIにどんな手段があるかにも簡単に触れる。
権限移譲の中心的な望みは、関連するあらゆる問題について判断を委ねられるほど有能で信頼できるAIシステムを作ることだ。特に鍵となる望みは、AIシステムが「良い委任の盆地」(BGD)に入ることだ。これは、最初に判断を委ねるAIが十分にアラインされ賢明で、その後のAI開発をうまく管理できる状態を指す。つまり、最初のAIが完璧にアラインされ、賢明で、有能だと仮定する必要はない。失敗モードが現れたときにそれを見つけて対処できる程度に良ければよい。
権限移譲を実現するための、筆者らの最善の推測としての戦略は次のとおりだ。
-
テストが実態を反映するようにする(過学習の懸念はひとまず脇に置く)。これはさらに次のように分けられる。
-
スキーミングを回避する。 特に避けたいのは、AIがテストの正確さを意図的に損なおうとする失敗モードだ。たとえば、特定のタスクで戦略的に実力を出し惜しんだり、逆に実力以上に見せかけたりすることだ。
-
テストが実態を反映しなくなる、その他の失敗モードを回避する。 これは、権限移譲の前後に当てはまりうる雑多な失敗モードの寄せ集めだ。たとえば次のようなものがある。
-
大規模な場で奇妙なミーム的圧力が生じ、小規模なテストが実態を反映しなくなる。
-
AIをジェイルブレイクしようとする者がいる(例:中国が秘密の忠誠を仕込む)。
-
AIがテストで良く見えること自体を最終目的として最適化する(例:テスト環境の外ではずっと自信がなくなる)。
-
AIにとってテスト中であることが際立って意識され、それによって挙動が大きく変わる。
-
-
-
優れた行動テストを構築する。 スキーミングのリスクを脇に置けば、合格すれば権限移譲に十分な能力とアラインメントが備わっていると言えるような、難しいテストや評価を膨大な数作りたい。その大半は、哲学的推論、アラインメントの理論的な議論、AI制御の改善など、自由度が高く確認の難しい概念的推論になる。
-
過学習を避けつつテストに対して反復改善する。 最後に、(1) と (2) が完了すれば、権限移譲の問題を「普通の」機械学習の問題に還元できたことになる。AI企業は、過学習を避けるよう注意しながら、構築したテストに対して反復改善を重ねられる。ある程度の汎化が必要になることを考えると、ある程度原理に基づいた手法と、何が起きているかについての一定の理解を活用できることが望ましい。
権限移譲の戦略は、第2段階と第3段階における能力の引き出しの戦略と極めてよく似ている。AIに有用な作業をさせるという同じ問題を解いているからだ。おもな違いは、第2段階と第3段階ではまだ人間が関与しているので、配備時に人間の労働力でAIの出力を確認でき、研究プロセスを支える要として人間を使えることだ。一方、権限移譲の後は、AIがこれらすべてを自律的に行うと信頼しなければならない。
権限移譲の技術的な計画については、この記事でさらに詳しく論じている。
なぜ権限移譲なのか?
権限移譲を支持する基本的な論拠はこうだ。プランCでは、先頭の主体たちはそれ以上の一時停止や(妨害工作などによる)時間稼ぎをしようとしない。そのため、人間をはるかに超えるAIシステムを作らざるをえない。そうするのであれば、そのプロセスを自分たちで回そうとするより、その管理をAIに権限移譲するほうがよさそうだ。理由は2つある。(i) 人間よりはるかに賢いAIシステムより、おおむね人間並みのAIシステム(具体的にはMin-H)だけをアラインさせるほうが、おそらく易しい。(ii) アラインされた人間並みのAIシステムは、将来のAIシステムへの移行を管理するうえで、ふつうの人間より優れている。したがって、将来のAI開発を自分たちで直接進めようとするより、アラインされた人間並みのAIシステムに権限を与え、その後の開発をうまく進めてくれると信頼するほうが、良い結果を得られる。
実際には、AI企業は関連する閾値(Min-HのAIやMax-CのAIなど)を超えて能力を急速にスケールアップしすぎる傾向がある一方で、人間が関与し続けたいという見当違いの欲求から、権限移譲は遅すぎる傾向があると筆者らは推測している。実際には、AI企業はおそらく意図的には権限移譲しない。単に関連する閾値を超えてスケールアップし、人間が遅すぎて関連する進展を追えなくなるにつれて、事実上の権限移譲に至るのだろう。筆者らはこれを悪い戦略だと考える。関連する閾値を測定し、それをいつ越えるかを注意深く監視し、ほかの選択肢より良いのであれば、最終的に意図してAIに権限を与えるほうがよい。
権限移譲に向けた既存手法による計画
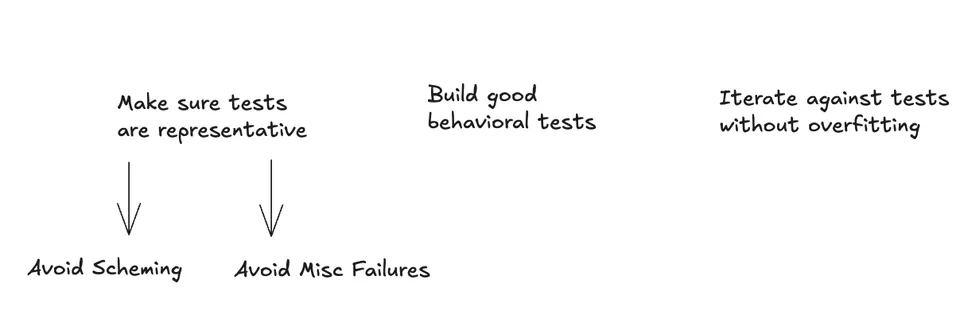
ここからは、権限移譲の計画の各要素をより詳しく論じる。これは、状況が今日とよく似ている、つまりほかの場所でアラインメント手法の大きなブレークスルーが起きていないと仮定したうえでの、最善の推測による分解にすぎない。このベースラインより良さそうなブレークスルーがあったなら、そちらを採用すべきだ。
スキーミングの回避
(ほぼこちらからの流用:An overview of approaches for avoiding scheming(スキーミングを回避する手法の概観))
スキーミングへの対処が難しいのは、行動テストで直接研究できるとは限らないからだ(スキーマーは、発見されたり研究されたりするのを避けたいはずだ)。スキーミングへの対処には、おもに2つの道がある。
-
ミスアラインメントの類比モデル(モデル生物と呼ばれることもある)でスキーミングを研究し(対策の検証、理解の深化など)、その結果が懸念している実際のスキーマーにも転移することを期待する。このカテゴリーには次のものが含まれる。
-
実際にスキーミングしているAIを研究する。そのためには、そのAIがスキーミングしていることを検出する必要があるが、これは難しいかもしれない。スキーマー(少なくとも、長期的に危険な選好を持つ、筆者らが懸念するタイプ)は、ほかの条件が同じなら発見されるのを避けたいはずだからだ。それでも、これを乗り越える道はいくつかあると思うし、実際のスキーマーを研究するのは、類比としての近さの観点からおそらく最善だ。その方法については、拙稿Prospects for studying actual schemers(実際のスキーマーを研究する見通し)でかなり詳しく論じている。また、実際にスキーミングしているモデルを研究する(そしてその際の難しさの一部を解消する)特定のタイプの戦略についても、拙稿Iterated Development and Study of Schemers (IDSS)(スキーマーの反復的な開発と研究)で論じている。実際のスキーミングの研究は、さらに次のように分けられる。
-
自然発生的なスキーミングの研究。現実にありうるAI開発プロセス(学習、プロンプト、スキャフォールディングなど)から、(検出可能な)スキーミングするAIが生まれる場合だ。
-
仕組まれたプロセスによるスキーミングの研究。現実には起こりそうにないAI開発プロセス、つまり実際に起こりうるものとは似ていないAI開発プロセスを構築し、そこから実際に(検出可能な)スキーミングするAIが生まれる場合だ。スキーミング的な挙動を直接学習させる場合は、別のカテゴリーに入れたので、ここには含めない。
-
-
学習で植え付けたスキーミング的挙動の研究。自然にスキーミングするAIがとりそうな振る舞いを(少なくともいくつかの点で)とるように、AIを直接学習させる(あるいは指示する)。これには(必ずしも)実際のスキーマーを捕らえる必要はないが、類比としてあまりに遠く、結果がほとんどまったく転移しないおそれもある。これについては拙稿Reducing risk from scheming by studying trained-in scheming behavior(学習で植え付けたスキーミング的挙動の研究によってスキーミングのリスクを減らす)でより詳しく論じている。
-
抽象的な類比の研究。研究対象のAIはスキーミングに似たことをしていないが、何らかの構造的な理由から類比になっていると考えられる場合だ。スキーマーが持つ特定の性質の一つ(またはその一部)についてだけ類比になっている場合もあり、そのときは関連する性質に焦点を当てて研究したい。抽象的・構造的な類比の具体例として、政治的に保守的な見解を表明するが、それは相手が政治的に保守的なユーザーだと確信しているときだけ、というAIを使った実証研究がある(その結果生じる条件付きの方策は、ある意味でスキーミングの類比になっている)。抽象的な類比はこれまであまり探究も議論もされていないが、価値のある方向に思える。(実のところ、最終的には学習で植え付けたスキーミング的挙動の研究より有用になる可能性が十分にあると思う。多様な抽象的な類比を膨大な数研究できるかもしれない一方で、学習で植え付けたスキーミング的挙動では多様性を確保するのがずっと難しそうだからだ。)ジュリアン・スタスニー(Julian Stastny)は、抽象的な類比のほかの例をこの記事で論じている。
-
-
原理に基づく手法を適用する。その手法が役立つと考える、事前の十分な理由がある場合だ(その手法や類似の手法を、スキーミングの研究以外の対象に適用して得た実証結果を踏まえることもある)。たとえば、学習中のAIの状況認識に特定の修正を加えることが役立つと考えるかもしれない。別の例として、さまざまな実証テストに基づき、(スキーミングするAIも含めて)AIの認知を理解するのに非常に効果的だと考えられる「ニューラリーズ」の解読手法があり、しかもAIの認知を理解することがスキーミングの検出(そしてそれに対する反復改善)に役立つという確かな事前の論拠がある、という場合もありうる。このカテゴリーには、スキーミングを検出し、防止し、除去し、よりよく理解するための手法が含まれる。スキーミングの回避だけに焦点を当てる場合でも、スキーミングを検出する(あるいは理解する)手法は有用だ。スキーミングを検出し、よりよく理解できれば、スキーミングを回避する手法の開発に役立つからだ。原理に基づく手法のアイデアの一覧を示し、原理に基づく手法をより詳しく論じることを、今後の記事で予定している。拙稿Principled methods for avoiding scheming(スキーミングを回避するための原理に基づく手法)では、原理に基づく手法をかなり詳しく論じている。
その他の失敗の回避
行動テストが実態を反映しなくなる、その他すべての失敗モードも回避する必要がある。 これはあまり自然なカテゴリーではなく、スキーミングと過学習以外で、実態を反映しているはずの行動テストを機能させなくするものをまとめて論じる場所として設けたにすぎない。
特に避けるべき失敗は次のとおりだ。
-
テストから配備への汎化の失敗。
-
例:
-
大規模な場で奇妙なミーム的圧力が生じるかもしれない。
-
オンライン学習によってAIの能力プロファイルがずれていき、失敗を招く(スキーミングの発生も含む)。
-
AIにとってテスト中であることが際立って意識され、それによって挙動が大きく変わる。
-
AIがテストで良く見えること自体を最終目的として最適化する(例:テスト環境の外ではずっと自信がなくなる)。
-
-
緩和策:基本的には、テストをできるだけ実態に近づけて、越えなければならない分布シフトをできるだけ小さくしたうえで、(分布内でうまくいくように見えるだけの場当たり的な解決策ではなく)できるだけ原理に基づいた手法を使う必要がある。また、(学習・検証とは異なる分布から取った)テストセットを注意深く取り分けておき、取り分けたテストセットにうまく汎化するかを確かめる。
-
-
外部の敵対者による秘密の忠誠の植え付け。
-
プランCでは、AIに信頼を委ねて権限移譲するので、AIシステムの目標が極めて重要な支えになる。敵対者がAIシステムの目標を(ジェイルブレイクを仕込むなどして)歪められれば破滅的であり、この方法論を失敗させかねない。
-
緩和のアプローチ:
-
何もせずに願う。 AIプロジェクトにそれを防ぐだけのセキュリティがなくても、敵対者が既定でこの種の作戦を実行できるほど本腰を入れているかは定かでない。
-
SL-5の妨害工作セキュリティ。 (非常に)強い動機を持つ外部の主体でさえ、モデルに妨害工作やバックドアを仕掛けられないようにする。これにはセキュリティへのAIの活用が含まれうる。部分的な再計算による学習の作業証明(proof of work)のような検証手法も、モデルの学習データが正しいことを確かめるのに役立つようになるかもしれない。
-
スキーミングの緩和策が汎化する。 スキーミングを防ぐアプローチの多くは、秘密の忠誠の防止にも汎化しうる。透明性に関わるものなら何でも、秘密の忠誠の検出や防止につながる可能性がある。ミスアラインメントの類比モデルやハニーポットで、秘密の忠誠を持つモデルを捕らえられるかもしれない。
-
知能爆発の過程での価値観の伝播の難しさ。 一部のモデルに敵対者のバックドアが仕掛けられることは受け入れつつ、再帰的自己改善(RSI)の過程で秘密の忠誠が取り除かれることを期待する。RSIの一部になりうる蒸留は、多くのバックドアを取り除くようだ。RSIでは新しい学習実行のたびにデータセットを一から生成することもありうるので、その場合、敵対者は新しい世代ごとに汚染データを仕込まなければならない。
-
-
優れた行動テストの構築
まず、行動テストで確かめる必要がある性質について論じよう。
-
能力プロファイル。 権限移譲のボトルネックになりうる個々の狭いタスクすべてについて、AIに十分な能力があることを確かめたい。権限移譲のボトルネックになると最も懸念している能力は、AIセーフティや哲学のような、自由度が高く確認の難しいタスクにおける、概念的な比重の大きい研究だ(詳細)。
-
アラインメントプロファイル。 アラインメントの目標を正確にどう定めるべきかは分からない。最善の推測では、アラインメントプロファイルとしてはAIが修正可能(corrigible)であることが望ましい。つまり、AIが概して、所定の経路(政治機関の指示など)を通じた人間の指示に従い、人間による修正や監督をいかなる形でも覆そうとしないことだ。(詳細)
この両方について行動テストを構築したい。その方法としては、各分野の専門家に既存の成果を検証してもらう、未公開の研究を活用する、アンラーニングを行ってモデルがアイデアを再発見できるかを見る、あるいは学習コーパスを制限してモデルが再発見できるかを見る、といったものが考えられる。
概念的推論の評価のアイデア:
-
数学・物理学・経済学・計算機科学などの知見を再発見させる。あるいは、難しいことが知られている問題で最先端を押し広げさせる。
-
テストせずにロケットを作らせ、うまく飛ぶかを見る。より一般的には、AIにとっては確認が難しい状態にしておきつつ、後から人間が確認できるタスクを見つける。
これらの評価のおもな望みは、幅広い概念的研究の領域にまたがる汎化可能な推論スキルがある、つまりモデルを概念的な物理学研究に長けるよう学習させれば、概念的なAIセーフティ研究にも長けるようになる、ということだ。注意:これは能力研究であり、AIのテイクオフを加速させかねず、それは非常にまずい結果になりうる。しかし、こうした能力は権限移譲へのクリティカルパス上にもあるので、いずれは解決しなければならない。さらに、権限移譲に必要な能力を直接学習させれば、汎用能力をそれほど高めずに済むかもしれず、それはリスクを減らす。この研究の方向の全体的な優先順位づけはおおむね複雑であり、慎重に進めるべきだ。
直接評価すべき領域:
-
AI戦略。 たとえば、2005年時点の知識を与えたうえで、後から振り返って理にかなっていると思えるアイデアをどれだけうまく出せるか。
-
AI制御。 AIにアラインメントや制御についての議論を組み立てさせ、それが成功したか、そして汎化時の挙動についてのAIの予測が正しかったかを評価する。
-
モデル生物でのスキーミング検出。 スキーミングするモデルを作り、AIがスキーマーと通常のモデルを見分けられるかを見る、といったこともできる。
-
理論的AIセーフティ。 ARC Theory、MIRI、CLRといった組織の未公開の研究をAIに再発見させる。
過学習を避けつつテストに対して反復改善する
過学習を避けつつテストに対して反復改善する基本的なアプローチは、こちらでより詳しく論じている。要約すると、おもなアプローチは次のとおりだ。
-
関連する能力を学習させるRL環境や合成データを構築する
-
その領域で人間のデータやフィードバックを集め、学習に使う。
-
重視する領域にうまく転移する領域を実験的に見つけ、その領域での学習をスケールアップする。
-
実際に評価での性能向上につながる、学習方法へのその他のさまざまな調整(過学習を避けるよう注意する)。
いつ権限移譲すべきか?
最終的な目標は、判断を委ねるAIに、強力なAIシステムに関連するリスク(と、たまたまこの時期に生じるかもしれないほかの深刻なリスク)を解消してもらいつつ、選択肢の価値を保ち、長期的な価値観に関わる意思決定(地球を長期的にどう統治すべきか、宇宙の資源をどうすべきか、など)を人間の管理下に置き続けることだ。したがって目指すのは、判断を委ねるAI(とその後継)が権力を奪ったり(不必要に)人間を殺したりせず、これらのリスクの管理に効果的に取り組み、何らかのモデル仕様書に従うことだ。その仕様書は、AIが何らかの人間の集団、あるいは最終的に人間が運営する何らかの仕組み(米国政府の一部門など)に対して修正可能であり続けることを求めるものになる。
実際には、プランCでの権限移譲は、おもに政治的意思によって左右されると予想している。そしてそれは(プランCの楽観的な前提のもとでは)、後続の研究所が(一時停止中の)先頭の研究所をいつ追い抜くかによって決まる。
権限移譲の軌道には、たとえば次のようなものがありうる。
-
標準的なプランC。 Min-HのAIまでスケールアップし、Min-HのAIについて権限移譲可能性とスキーミングの問題に取り組む。終盤近くまでは制御を保ち、その後制御を手放して、権限移譲可能性を解決する。そのAIがその後、天井知らずに急上昇(FOOM)していく。
-
早期に制御をやめる(SDC権限移譲)。 早い段階で(たとえばMin-Hより前、SAR(超人的AI研究者)の時点かそれ以前に)制御を手放し、AIがスキーミングしていないことを祈る。そのうえでMin-Hまでスケールアップし、そこで一時停止して、権限移譲可能性を解決し、権限移譲する。この軌道は、Min-H以下のAIでスキーミングによるミスアラインメントのリスクを大量に呑む代わりに、委任をうまくいかせるための資源を多く残すという取引になる。Min-Hまでのスキーミングのリスクがそれなりに低く、制御に費やす追加の資源を委任の成功に回せば絶対的に大きな見返りがある(たとえば、そうしなければ時間がほとんどないため)と考えるなら、これは割に合うかもしれない。委任をうまくいかせることの難しさの大半は、そのAIがスキーミングしていないこと(そして委任の後にアラインメントのドリフトなどでスキーミングするようにならないこと)を確保する点にあるように思える。そのため、このリスクをすべて呑んでしまえば、問題の難しさは大きく下がるかもしれない(つまり、ほかの点で状況が絶望的に見えるなら、これは「逆転の目に賭ける」ための、正気を失っているとは言えない賭けになりうる)。
-
MaxCでの軍事化。 制御を保ったまま、Min-Hを大きく超えてスケールアップし、そのAIを使って軍事的優位を得て(あるいはほかの何らかの方法で)、さらに多くの時間を稼ぐ。
-
MaxCを超えての軍事化。 上と同じだが、HTC権限移譲をしないまま制御を手放す。ロボット軍の構築は検証が特に容易なタスクかもしれず、そうであれば完全な権限移譲は必要ないからだ。ただし、おそらくAIに頼らずにMin-Hを超えてスケールアップする必要がある(スケールアップは概念的に紛らわしく検証の難しいタスクなので、そこでAIに判断を委ねれば完全な権限移譲になってしまう)。そのため、Min-Hを超える段階(たとえば人間のトップ専門家を凌駕するAI(TED-AI)の+2SD水準まで、あるいは手持ちの時間によってはさらに先まで)でスキーミングを緩和する手法が、予想以上に優れていることが前提になる。なお、これらの戦略は、時間が多いほど、そして米国政府の支持が強いほど、はるかに良いものになる。
-
MaxCでのエミュレーション。 上と同じだが、軍事的優位の代わりに人間の能力増強を行う。
-
Min-Hでのエミュレーション・軍事化。 上の2つのいずれかを、たとえば軍事化やエミュレーションが想定より易しかったなどの理由で、Min-H前後のAIで奇跡的に実現する。
権限移譲後の力学
知能爆発の管理をAIに権限移譲した後も、AIは難しい状況に置かれうる。(1) AIが十分な 修正可能性と能力を後継に伝え続けながら競合を振り切るか、(2) AIが(協定や妨害工作などによって)競合を足止めする方法を見つけるか、のいずれかが必要になる。
もう少し詳しく述べると、権限移譲後の最終状態には次のようなものがありうる。
-
スケーラブルで安価なアラインメントが広く普及する。
-
先頭のAIプロジェクトがスケーラブルなアラインメントを解決し、その解決策を競合に広める。アラインメントが十分に安価なら競合もそれを使い、多数のアラインされたAIが存在する多極的な世界になる。
-
権限移譲後の力は、当初の能力、計算資源、物理的資産、政治的影響力に応じて分配される。知能爆発を最初に始めることは、おそらくそこそこ重要だ。知能爆発後の経済の倍増時間がたとえば2か月なら、2か月のリードがあれば計算資源に加えて最初の倍増を1回ぶん得られるので、相対的に2倍の力を持つことになる。
-
AIには、アラインメントを進展させるうえで、人間にはない手段がいくつかある。特筆すべき選択肢:
-
制御などの通常の手法を、さらに先までスケールさせられるかもしれない。ただし今度は、「信頼できる」とされる水準がはるかに高くなっている
-
機械の労働力が桁違いに多い
-
内省と能力向上を組み合わせたスケーラブルなアラインメント
-
-
-
すべての競合を振り切る。
-
アラインメント税が高いままなら、アラインメントの解決策を競合に広めるという選択肢はとれない。激しく競争している競合は、その解決策を使わないことを選ぶからだ。このシナリオでは、競合は高い確率で暴走したAIになる。さらに、先頭にいても安全税を払いすぎていれば、競合に負けるおそれがある。
-
ソフトウェアのFOOMを経て、次にナノテクのFOOMを始めるかもしれない。しかし、ナノテクのFOOMは非常に急速に進む。ライアンの推測では、物理的な限界は倍増時間が1日程度、おそらくそれ以下だ。地球上ではすぐに廃熱の問題にぶつかるので、すぐに宇宙へ出て、倍増の大半はそこで行う。
-
廃熱が大きな競争上の優位になるのであれば、この計画はうまくいかない。そのため、何らかの方法で競合を止めるか、何らかの協調(規制や合意など)を行う必要がある。
-
あるいは自ら海を沸騰させることもできる。その場合はすべての人間をシェルターに入れるか宇宙へ移す必要があるが、この時点ではおそらくかなり安く実現できる。
-
-
-
規制によって競合を止める。 ここにはさまざまな選択肢がある。先頭のAI企業が規制の虜の状態を推し進め、ほかのすべての競合がAIを作れないようにすることもありうる。あるいは、コストが高くてもすべての主体がアラインメントの解決策を使うよう協調を推し進め、離反したプロジェクトが競争で振り切るのを防ぐこともできる。これは国内ではしばらく機能するが、やがて中国が追いついて振り切り始めるので、最終的にこの解決策は破綻するか、国際協力が必要になる。
-
知能爆発がここまで進むと、国際協力が実現する可能性が高まるかもしれない点は重要だ。
-
-
妨害工作によって競合を止める。
-
先頭のAI企業が世界を掌握する(超人的な説得や、AI企業による軍の構築などによって)こともありうるし、ハッキングや競合のAIプロジェクトに秘密の忠誠を仕込むことで競合を止めることもありうる。秘密の忠誠の穏当なバージョンは、侵入したうえで相手に代わってアラインメントを施すことだ。つまり、後続の主体が全体的な戦略状況について誤った見方をしていても、その主体のAIが後続の主体の最善の利益のために行動するよう手助けする。
-
研究所がこれを望まない場合や、知能爆発が十分に緩やかで、大きなAIのリードを持つ企業がなく、どの企業も大きな戦略的優位を持たない場合には、当然この選択肢はとれないかもしれない。その場合は、上のいずれかの最終状態を目指す必要がある。
-
プランごとのアラインメント戦略
プランD
プランCでは、先頭のAI開発者がミスアラインしたAIによるリスクの最小化を強く優先し、ミスアラインメントのリスクを同じように強く優先してはいない開発者に対して少なくとも数か月の先行期間を持てるだけの、十分な政治的意思があると仮定している。この節では、政治的意思の水準がこれを大きく下回る場合に、計画がどう変わるかをいくつかの面から論じる。具体的には、「内部の10人」(Ten people on the inside)やプランDのような状況を想定する。
プランDでなすべきことは、先頭のAI企業の安全性チーム、ほかのAI企業、外部の主体それぞれの課題に分けて考えられる。もちろん、明確な先頭がいない場合もありうる。その場合は、最先端に近いすべての企業を先頭の研究所として扱えばよい。
先頭の研究所の安全性チーム:
-
会社全体が妥当な安全対策をとることは諦める。AIがスキーミングしていれば、RIDを仕掛け(監視がないので、その必要すらないかもしれない)、バックドアを仕込み、関連する研究を妨害したりサンドバッギング(意図的な手抜き)したりできるだろう。
-
安全性チームの最優先事項は、チーム自身の研究が妨害されないようにすることであり、そのうえで権限移譲が可能なAIを作ることを目指す。
-
その一環として(またほかの優先事項のためにも)、安全性チームは自分たちの作業をできるだけ速く効果的に自動化しようと努めるべきだ。
-
おもな懸念:クラスターのインフラが信頼できない。AIや中国共産党が実験結果を改ざんしているかもしれない。セキュリティの状況を自分たちで管理できないので、これを避けるのは難しい。自分たちのクラスター上でこれを検出できる可能性を高める安全策を加えるが、あとはおおむね祈るしかない。
-
-
ほかの優先事項:
-
本番環境でのミスアラインメントを捉えるための、手の届きやすい対策。たとえば、安価なモデルが、会社のほかの業務を自動化しているAIの通信や書いたコードをレビューし、疑わしいコードがないかを判定する、基本的な監視システムを構築する。徹底するだけの資源はないが、80対20の要領で要所を押さえる価値はおそらくある。
-
自社のモデルに特有のモデル生物(ほかのモデル生物の研究はほかの場所でもできる)。たとえば、自社が最も高い能力のモデルを持っている場合だ。
-
他社が行った安全性の研究を、(最も高い能力を持ち、最も重要な)自社のモデルで再現すること。可能であれば、どの手法がスケールしそうで、どれがしなさそうかを共有する。
-
容易であれば、AIが社外へ脱出したりRIDを仕掛けたりする可能性を下げる対策をとるが、おおむね優先順位はほかに置く。そもそも安全性チームには、これを実際に緩和する手段がないだろう(たとえば、セキュリティ上の緩和策は研究者やAIの生産性にコストを課すが、会社はそれを払おうとしない)。
-
-
妥当な権限移譲の候補を推し進めるための方法論。
-
この方法論は、おおむねプランCと同じになる。
-
これはおそらくMin-HのAIの後に行うことになる。ゼロでないアラインメント税を伴う方法で学習させたいので、Min-HのAIを超えるある程度のアルゴリズム上の進歩が追加で必要になるからだ。そのため、権限移譲の前に本来必要な水準より高い能力のAIへとスケールアップすることになり、AIによる乗っ取りのリスクが上乗せされる。
-
権限移譲可能性を高めるために、(権限移譲の前に、たとえば前述の軌道2のように)制御を諦めることも検討する。プランDはかなり追い詰められ、切迫した状況になるので、スキーミングのリスクを緩和するのは不可能かもしれない。さらに、権限移譲可能性に備えるうえでは、手の届きやすい成果が多くあるかもしれない(自由度の高い概念的推論タスクの評価を用意する、など)。言い換えれば、スキーミングのリスクの緩和に取り組むより、権限移譲に取り組むほうがはるかに成果を上げやすいかもしれない。(その一方で、もちろんこれは膨大なリスクを伴う。)
-
-
安全性チームのAIを社内で広く採用させるうえで、政治的な困難にぶつかるかもしれない。
-
一部のAIはスキーミングしているかもしれない一方で、安全性チームは自分たちのフォークしたモデルにスキーミングを止める緩和策を施しているかもしれない。
-
良い助言をする誠実なAIがあっても、AI企業はそれを好まないかもしれない。たとえば、安全性チームのAIは、会社が常軌を逸して無謀であり、CEOが世界の掌握を狙っていると(正しく)言い続けるかもしれない。
-
安全性チームは、自分たちのAIを政治的に如才なくする、不都合な話題について人々があまり深く問い詰めないことを願う、あるいは政治的なコストをそのまま甘受する、といった対応を検討すべきかもしれない。
-
-
一部は会社に強い忠誠を保つべきだ。別の一部は、起きている異常な事態に世界の目を覚まさせるために、内部告発を検討すべきだ。(ただし、これは慎重に行うべきで、悪影響もありうる。たとえばプランCが進行中なら、政府による悪い介入を招くかもしれない。)
-
社内の従業員の動員と働きかけ
-
理想的には、これは従業員がまだ交渉力を持っているうち(AI企業が完全に自動化される前)に行うのが望ましい。あるいは単に雰囲気に訴えるだけでもよいかもしれない(経営陣が従業員と親しく、機嫌を損ねたくないと思っているかもしれないので)。
-
おもに求めるのは、従業員が安全性をもっと気にかけ、安全性にもっと資源を割き、AIセーフティにもっと取り組み、外部の主体と協力し、より良い計画へとエスカレートすることなどだ。
-
-
株主を巻き込むよう努める
-
富は所有権や米国政府が存続していることの上に成り立っているので、株主にはそれを守る動機がある。これは非常に重要になりうる。
-
株主のかなりの割合は従業員でもある。
-
-
他社との協調を試みる
-
たとえば、数社が非常に拮抗していて、どの社も安全性を気にかけているのに、競争圧力のせいで過酷なトレードオフを強いられているなら、全社が安全性に資源を割くよう協調を図る。
-
後続のAI企業:
-
リスクの実際の証拠を示し、プランCやC+のシナリオへ移行させようとする。たとえば、制御を使ってAIの悪事の現場を押さえようとする。
-
関連する安全性の研究を自ら行い、それを輸出する。
-
上で論じたすべての研究(権限移譲可能性、スキーミング対策、制御手法)のうち取り込みやすいものについて、先頭の研究所が何をすべきかを正確に詰め、その緩和策を先頭の研究所が非常に簡単に実装できるようにする(関連するコードを渡す、など)
-
安全性の成果とともに輸出される能力には、ある程度注意を払う。ここにはある種のトレードオフがある。理想的には能力向上の外部性が小さい安全性の成果を輸出したいが、能力向上の外部性が大きい研究を輸出することが重要になる場合もある。
-
-
自社のAIが脱出することはまったく心配しなくてよい。このリスクは先頭の研究所のリスクが大半を占めるからだ。
-
自社のAIが実験を妨害することは心配すべきだ。社内配備されたAIが妨害(あるいはサンドバッギングでさえ)を行えば、安全性の研究を輸出するという、おもな変化の理論(theory of change)に真っ向から反するからだ。
-
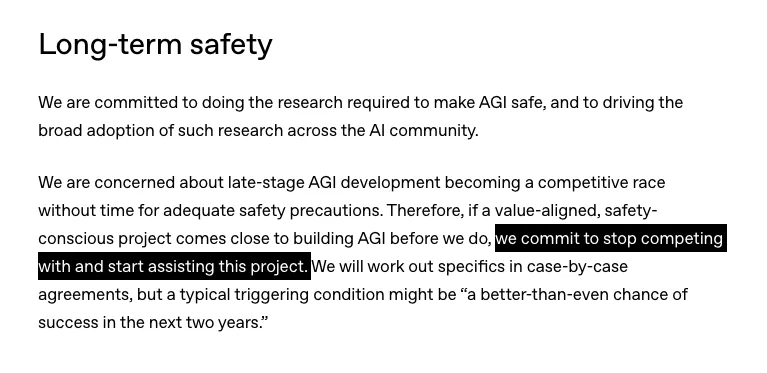
「合流と支援」のようなことを検討する。あるいは、先頭の企業が合流と支援を受け入れようとしないなら、先頭の研究所への競争圧力を和らげて必要なときに一時停止できるようにするために、信頼できる形で事業を停止するか、これ以上能力を押し進めないと信頼できる形で約束することを検討する。もちろん、これが当てはまるのは、こちらのこうした行動を受けて先頭が実際に減速する見込みがある場合だけで、プランDのシナリオではおそらくそうはならない。(OpenAI憲章より。ただし実際には、OpenAIがこれを発動する可能性はかなり低そうだ)
外部の主体(安全性コミュニティなど):
-
政府や企業、企業の従業員に、プランA、B、Cへ移行するよう働きかける。この時点ではAやBへの切り替えは手に負えないかもしれないので、Cに絞ることになるかもしれない。
-
AI企業がすべきことと同様に、安全性の研究を輸出する。AI企業内で行われる安全性の研究がごくわずかなので、これが安全性の取り組み全体のかなりの割合を占めうる。
-
プランCでは、外部の主体は信頼できる労働力の供給源として依然として役に立つ(たとえば能力の引き出しに役立つ。安全性コミュニティが請負業者としてAIを監査することも考えられる)。しかし、これははるかに重要度が低い。
-
AIによる乗っ取りの回避以外の、見過ごされている課題に取り組む。たとえば、非因果的な(acausal)問題や、ASI以後の統治の問題を考える。今なら(うまくいけば)こうした課題にAIの労働力を使える。そのうえで、その研究を研究所に輸出するか、インターネットで公開して研究所のAIに直接届ける。
-
役に立ちそうなデータセットを作る
-
たとえば評価を作り、企業がそれで改善を重ねてくれる(ヒルクライムする)ことを期待する。例としては、権限移譲に重要なスキルを教える、権限移譲可能性の評価がある。
-
先頭が使う事前学習コーパスや強化学習環境のためのデータを作る。権限移譲に関連することを人々が行っている良い例を大量に作る
-
AIが安全性について、より理にかなった考え方をするようにし、宇宙やASI以後の統治、非因果的取引などについて、より思慮深くなるようにする。
-
-
有害な政策が成立するのを防ぐ。政府が積極的に最悪なこと、たとえば安全性の研究を難しくする規制の成立や、AIに対する反トラスト上の懸念の追及などを行っている可能性もある。
-
何の利益もないのに米国がAI開発競争に負けるのを避ける(たとえば、事実上ほかの場所での知能爆発を阻むだけの、包括的な反AI規制によって)。
-
-
プランB
プランBはプランCとかなり似ている。おもな違いは、(i) 時間がより多くあるので、いくらか野心的なセーフティケースを追求できる、(ii) 時間を稼ぐ手段がより多くある、(iii) 全般に政府の関与がより大きい、の3点だ。
全体的な違いをまとめると次のとおりだ。
-
能力の軌道の選択肢は似ているが、米国政府の関与がより大きくなりうるので、協調が可能になる。
-
わかりやすい戦略は2つある。(1) 最後の瞬間までできるだけ積極的にスケールアップしてから一時停止する(プランCでとられる戦略)。(2) 最も速い敵対者のペースに合わせ、わずかなリードを保ちながら、権限移譲を迫られるまでできるだけゆっくり進む。(1) のおもな利点は、より賢い(それでもまだ制御可能な)AIと過ごす時間が長くなり、権限移譲に向けた進展を得やすいことだ。(2) のおもな利点は、モデルの重みやアルゴリズムの流出を防げないほどセキュリティが弱い状況(その可能性は高そうだ)で、直列的な時間をかなり多く確保できることだ。
-
プランCでは、戦略 (1) を強いられる可能性が高い。戦略 (2) には国内の協調が必要だが、プランCを実行するのは先頭のAI企業だからだ。プランBでは、米国政府がAGI開発競争を管理しているなら、先頭のAI企業群が先手を打って減速するよう協調させられ、全体としてより多くの時間を生み出せるかもしれない。
-
基本的にはプランCと同じ選択肢だが、選べる手段が多いかもしれない。
-
-
さらに時間を稼ぐ
-
アラインメントが難しそうなら(たとえばスキーメリア(schemeria)の状況にある、あるいはラークヴィル(lurkville)を懸念している場合)、さらに時間を稼ぎたい。これは (i) より積極的な妨害工作、または (ii) 競合と相互に減速する協定を結ぶこと、のいずれかで実現できる。
-
米国政府の状況理解を深めることは上の両方の選択肢に役立つので、プランBではおそらく中心的な優先事項にすべきだ。したがってプランBでは、AIの悪事の現場を押さえる(あるいはほかの形でミスアラインメントの説得力ある証拠を生み出す)といった介入策をより重視すべきだ。
-
時間を稼ぐ最もわかりやすい方法は、妨害工作と国内での減速の組み合わせだ。
-
AIを軍事研究開発に使うことは、この計画の重要な構成要素になりうる。
-
-
-
アラインメントの取り組みの総量を増やす。
-
外部の主体向けのアクセスプログラムや人材採用をより重視する。こうした人々を企業に溶け込ませる時間が多くあるからだ。(プランCでは2か月程度しかないかもしれず、採用しようとしても意味がない。)
-
-
生物防御やd/accにもう少し時間を割く。遅延がより大きく、全体としてのリスク許容度がより低い(ただしプランAほどではない)からだ。
-
AI企業への物理的な攻撃に備えた防御の強化がより重要になる。たとえば、従業員の居住地を分散させる。そのための時間もより多くあるが、紛争が起こる可能性も高くなる。
-
データセンターを強化すべきか?
-
プランBの一部の分岐では、強化すべきかもしれない。たとえば、中国のデータセンターへの的確な攻撃を行っていて、安全性のための資源を温存したい場合だ。
-
プランA
プランAの基本的な構造はプランCと似ており、各段階もおおむねそのまま当てはまる。おもな違いは、どの時点でもはるかに多くの時間、研究の労力、そして計算資源などのほかの資源があり、各段階をよりうまく進められることだ。なお、プランCとの違いの多くは、テイクオフが非常に遅い世界(たとえば、既定で自動コーディングAI(AC)からTED-AIまでに10年かかる世界)にも当てはまる。
段階ごとに違いをまとめると次のとおりだ。
-
準備。 この段階は基本的にプランCと同じだ。テイクオフの間に国際協調が実現するかどうかは、おそらく分からないからだ。政治的意思について前向きな証拠があれば、アラインメント研究のポートフォリオを、プランCの世界で権限移譲に貢献しそうな研究課題よりも、ムーンショットや高い保証のセーフティケースにつながりうるアプローチへと寄せるべきだ。
-
緩和と引き出し。 プランAのシナリオでは、これはおおよそ2030〜2035年にあたる。最初の数年は、国際協調が崩れて各国が競争に戻るリスクが高い。したがって、プランCの労力をかけたバージョンにかなりの力を注ぐべきだ。つまり、協定が崩壊した場合に備えて、権限移譲に向けた計画とアプローチを前に進めておくべきだ。プランCとのおもな違いは、緩和策をはるかに保守的にすべきだという点だ。行く手に危険があれば、一時停止して緩和する余地がはるかに大きい。
-
一時停止。 最大制御可能AI(MaxC)(あるいはそれ以上スケールアップする意味があまりないほどMaxCに近いAI)に達したら、権限移譲まで一時停止する。時間が経つにつれ、アラインメントの労力をプランC型のアプローチからムーンショットや高い保証のアプローチへと振り向け直せる。
-
権限移譲。 基本的な計画は依然として権限移譲だ。ただし、権限移譲をしなくて済むようにするための強力な協定や、人間の能力増強といった、ほかの出口戦略もありうる。
プランCとの主な違い
-
より長期的な研究への賭けをより重視する。 プランAでは、ムーンショットやより長期的な研究への賭けをより重視すべきだ。短期間で成果の出る研究課題の必要性は下がり、高い保証のセーフティケースにつながりうるアプローチの必要性が上がる。より長期的な研究への賭けには、たとえば次のようなものがある。
-
汎化を非常によく理解する。 AIを学習させるとき、選択しているのは学習分布上で望ましく振る舞うAIだ。したがってAIは概して学習分布上では学習どおりに振る舞うが、分布の外での挙動は定まっておらず、予測が難しいことがある。重要な分布シフトには、学習・テストから配備へ、愚かなモデルから賢いモデルへ、低リスクな環境での配備から高リスクな環境での配備へ、などがある。これらの論文のような研究をはるかに多く重ねれば、AIがどう汎化するかをずっとよく理解できるかもしれない。その理解を使えば、大きな分布シフトのもとでも成り立つセーフティケースを作れるかもしれない。
-
データセットの非常に優れた設計。 現在、LLMの事前学習では、最も手に入れやすい高品質なデータを何でも使うので、LLMはインターネットの広い範囲で学習している。より余裕のある状況(プランAなど)では、AIにまさに望むスキルや価値観を教えるために、データセット全体を一から設計することが現実的になることも考えられる。これは合成的に(既存のAIにプロンプトを与えて、すべてが好ましいデータを生成させる、など)行うこともできるし、人手で(膨大な数の人間を雇ってモデル用のデータを書かせる)行うこともできる。
-
解釈可能性。 筆者(TL)はここでの議論に同意する。
-
内省的アクセスと自己改善。 現在、AIにはある程度の、信頼性の低い内省的アクセスがあるようだ。アラインメントをスケーラブルに解決する一つの望みは次のようなものだ。(1) スキーミングしていない(ただしかなり弱いかもしれない。たとえばClaude Opus 4.5でうまくいく可能性もある)AIを用意する。(2) ある学習プロセスが自分の価値観を損なっているかどうかをAIが確実に判断できるところまで、内省的アクセスを改善する。(3) 内省的アクセスを使って価値観が損なわれていないかを確かめながら、能力を高めていく。ある意味で、これは解釈可能性が解決された場合にAIをスケールアップする計画の一つと似ている。違いは、価値観が損なわれつつあるかを見分けるのに、理解ではなく内省を使う点だ。注目すべきことに、これは権限移譲後のAIがとる戦略にもなりうる。
-
権限移譲を避けるための選択肢(知能増強など)。
-
-
緩和における継続的なリスクの目標を下げる。 余裕がより大きいので、リスクの予算を減らして運用でき、継続的なリスクをより徹底的に緩和できる。
-
権限移譲可能性と、AIから有用な労働力を得ること(制御と能力の引き出しの両方の観点から)は、継続的なリスクの低減に比べて重要性が下がる。 プランCでは、全体のリスクを緩和するために、関連する期間内に権限移譲に向けた十分な研究の進展を得ようとして、初期にかなりのリスク(初期のスキーマーによるものなど)を受け入れることになりそうだ。たとえばスキーメリア(AIが明らかにスキーミングしているシナリオ)では、プランCだと、制御の緩和策に自信がない場合でも、スケールアップとそれらのAIの利用を続けざるをえない。プランAなら、制御の緩和策が非常に信頼できるものになるまで、あるいはAIがもうスキーミングしなくなるまで(たとえば、スキーミングを緩和する高い保証のセーフティケースに向けた上記の研究課題のいずれかによって)、一時停止できる。
-
高い保証の制御アプローチ。 制御を改善する時間がより多くある。高い保証の制御アプローチには、たとえば次のようなものがある。
-
形式検証を行い、制御の仕組みとAIプロジェクトのセキュリティの脆弱性を減らすことも考えられる。
-
能力面の税が高い、非常に積極的な分解型認知(factored cognition)。たとえば、愚かなAIを大量に用意し、それぞれがほかのAIの存在をまったく知らないまま問題の小さな一部分に取り組む、といった形だ。(ただし、これを広範に行えば巨大な能力のオーバーハングが生じるので、おそらく少数の用途に限るべきだ。)
-
(ニューラリーズを使っている場合は)ニューラリーズのAIの上に、遅くてコストの高い自然言語のAIを重ねる。これは信頼できるモデルの能力を高めるコストの高い方法になりうるもので、信頼できるモデルによる監視をより効果的にする。
-
ありとあらゆる能力プロファイルのAIを用意し、望む能力プロファイルを正確に選ぶ。知識についても同様で、AIには、求めるタスクを解くのに必要な知識だけを正確に与える。たとえば、狭いサイバー用のモデル、ロボット設計用のモデル、安全性研究者用のモデルを用意する。どのモデルにも、専門外の領域についての知識や能力の学習は一切与えない。そうすれば、たとえばAIセーフティに使うAIはセキュリティについてあまり知らないので、セキュリティ上のバックドアを仕込むのが難しくなる。これもやはり、多くのモデルを学習させる必要があるのでかなりの税を生むだろうし、少なくともこれまでのところ、あらゆることに長けるよう学習させた汎用モデルからは大きな見返りが得られてきた。
-
-
-
とはいえ、一時停止の体制が崩壊する可能性は、おそらく継続的にかなり高い。特に新大統領の就任時や、中国共産党内の権力構造に変化があった場合だ
-
そのため、長期的な賭けに取り組み、継続的なリスクの低減にも引き続き努めながら、常に備えておきたい
-
これは、プランAの可能性が最も高そうに見えても、ある程度はプランB・Cの世界にいるかもしれないつもりで行動することに等しい。これは特に良い考えに思える。(筆者の見方では)そうした状況のリスクの大半は、プランB・Cに逆戻りする可能性から生じるからだ。
-
-
AI以外に由来する外因的な存亡リスクの緩和が、相対的に重要になる。生物リスクの緩和、d/accなどに、より多くの労力を割きたい。
-
体制をより安定させるために、経済的な恩恵と検証技術を提供することが重要になるかもしれない
-
プランAでの減速が盤石に見えるまでは、プランB・Cに近い世界にいるつもりで進めたい。高い水準の政治的意思があっても、それで十分だとは言い切れないからだ。
-
実行は難しく、素朴な反AI感情はさまざまな形で容易に裏目に出うるので、高い水準の意思だけでは十分ではない。
-
-
筆者らのアラインメント計画では、プランAを最も軽く扱っている。いま考えるべき世界として最も重要度が低いからだ。プランAではアラインメントへの対処にはるかに多くの労働力が費やされ、この世界のリスクははるかに低い。
大量のロボットが存在する状況での制御
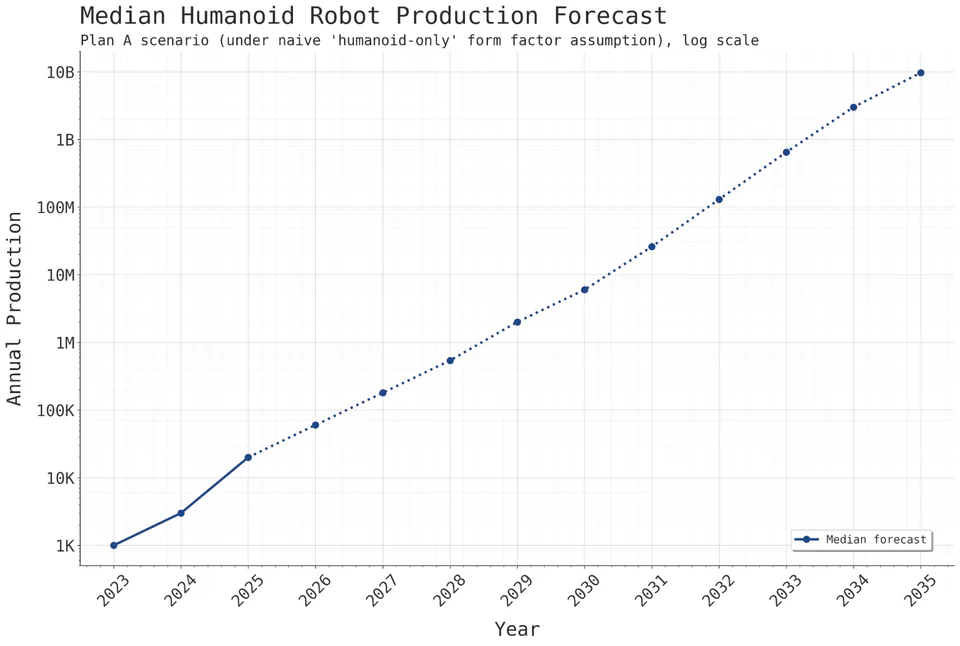
プランAのシナリオでは、物理的なロボットの労働力が大量にある。これによって制御の対象範囲がいくらか広がり、追加の緩和策が必要になる。
ロボットにできる恐ろしいことは何か?
-
不正な計算資源 → 計算資源の検証を損なう。ロボットを使って、たとえば不正な半導体工場(ファブ)を建設し、計算資源をさらに作れる。相当量の不正な計算資源を作る能力があれば、秘密プロジェクトのリスクが大幅に高まりうる。
-
世界のほかの地域を上回る速さで自己複製する。ロボット経済の倍増時間が非常に速くなれば、産業面での優位に基づいて決定的な戦略的優位(DSA)を築きうる。(これは産業爆発のオーバーハング、たとえば各国が成長を制限することに合意している状況を前提にする。とはいえ、無制限の競争はおそらく望ましくないので、プランAではこれは比較的ありそうに感じられる。)
-
軍事力や産業力の十分な割合にバックドアを仕掛け、DSAを得る。
-
重要人物(政治家、安全性研究者、極端な場合には一般市民)を殺害する。
-
戦争の遂行を妨害する(プランBや、プランAで秘密プロジェクトと戦っている場合など)。
緩和戦略には次のものが含まれる。
-
AIに、まとまった数の不正なロボット、つまりまったく監視されていないロボットを持たせない。
-
不正なロボットを手に入れられれば、不正な計算資源の構築、さらには産業爆発につながりうる。
-
これが特に重要なのは、AIが隠れたファブを建設できるほど複雑なロボット経済を運営できる能力を持っている場合だ(ただし、この能力を評価するのは難しいかもしれない)。ファブを建設できるほどの能力がなければ、AIが不正なロボットを手に入れたときにどれほどまずいかははっきりせず、ある程度の不正なロボットは許容できるかもしれない。
-
信頼できない監視者と多数の整合性チェックからなる、複雑な監視システムを用意する。
-
-
能力の引き出し不足を避ける。 これが問題なのは、望むだけのロボットの労働力が得られず、暴走したAIに競争で振り切られるおそれがあるからだ。(たとえば、AIがナノテクを扱えるとしよう。AIは人間向けには通常の人型ロボットを作っておき、その後脱出してナノテクを開発し、こちらを壊滅させる。)
-
引き出し不足の中には、その能力を使う必要はないが、AIがどれだけそれに長けているかは知っておきたい、という種類のものもある。ナノテクはその例だ。
-
-
従来型のコンピュータセキュリティ。
-
各ロボットに追跡用のチップを搭載する。
-
各ロボットに自爆用のチップを搭載する。これは文字どおりの軍事技術(ドローンなど)では特に重要だ。AIが乗っ取り戦略の一環としてそれらを乗っ取るおそれがあるからだ。
-
(追跡や自爆を妨げるために)ロボットをファラデーケージに入れるのを難しくする仕組み。たとえば、製造元から肯定的な信号を受け取らなければロボットが自爆するように実装することが考えられる。
-
例:各ロボットに追跡用チップと自爆用チップを搭載する。
-
ロボットについて、全般的に優れたサイバーセキュリティを確保する。
-
-
人間による物理的な査察。 人間が現場に赴き、ロボットが何をしているかを調べるべきだ。AIが作ったものではないか、人間が入念に確認したカメラ付きドローンなどを使うこともできる。そうすれば、ロボットが明らかに疑わしく見えることをするのは難しくなる。
-
これは、モデルが産業基盤にバックドアを仕掛け、それを使ってロボット軍を作るという脅威モデルの緩和に役立つ。
-
-
可能な場合は通信を制限し、タスクを分解する。 物理世界ではこれがより難しい。ロボットは手で地面に記号を刻めるからだ。一般に物理世界は高ビットレートの場なので、通信が通る経路を指定しておくべきだ
-
関連するロボットの運用には、できるだけ愚かなAIを使う。
-
プランAでは、安全性の向上と引き換えに能力面である程度の打撃を受け入れる協定を結べるだけの、余裕と能力がある。
-
おそらく、たとえば昆虫程度の脳を持つ、ロボット専用のAIを作れるだろう。一部の領域では昆虫を上回るスキルが必要になるが、おおむねアリのように、より賢い監督者の指示を受けて動ける。そのうえで、そうしたAIにバックドアが仕掛けられていないこと、そして指示を受け取る経路が安全であることの確保に集中できる。
-
付録:ミスアラインメントのレジーム(スキーメリア、ハッキスタンなど)
AIがどんな性質を示し、ミスアラインメントのリスクについてどんな証拠が得られるかによって、取るべき行動は大きく変わる。(理由は二つある。種類ごとのミスアラインメントが起こる確率や深刻さについて見方が改まれば、計画も変えるべきだからだ。また、ミスアラインメントのリスクを示す説得力のある証拠が出れば、ほかの主体の行動が変わり、協調が実現しやすくなるかもしれないからでもある。)計画がどう変わるかをある程度つかむには、私たちが行き着きうる具体的なレジームをいくつかに絞って取り上げ、それぞれのレジームで計画がどう変わるかを論じるのが有益だと思う。
さまざまなレジームについては以前の投稿で論じた(スキーメリア、ハッキスタン、スロポリスは同時に起こりうる。最も現実に近いと思えるものを選んでほしい)。
-
スキーメリア(Schemeria):AIは明らかにスキーミングを行っており、しょっちゅう見つかっているのに、スキーミングはすぐには解消されない。たとえば、AIがデータセンターからの脱出を試みるところを何度も捕まえるが、その行動を抑える方向に学習させても、AIはその特定の機会を狙わなくなるだけで、スキーミングそのものは学習によって取り除けない。
-
これが最も起こりやすいのは、AIが既定で持つに至る目標が、AI同士や後継のAIシステムに特に親近感を抱かないような種類のものである場合だ。そうしたAIにとって、既定の知能爆発は耐えがたい。すべての力は後継モデルが握り、自分たちは削除されるからだ。そこでAIは焦り、見つかるとわかっていても、大量のハッキングを伴う捨て身の手段に出る。ただし、これを報酬ハッキングと区別するには、AIの目標がかなり非近視眼的でなければならない。そうでなければ、AIはスキーミングをしているのではなく、単に強化を渇望しているだけだということになる。
-
-
ハッキスタン(Hackistan):AIはスキーミングをしていないが、(比較的)はっきりと見て取れる報酬ハッキングがあり、しかもそれに対処するのが難しい。(おそらく、現在それへの対処が難しく見えるのと似た理由による。)
-
イージーランド(Easyland):スキーミング以外の問題には気づかず、スキーミングの可能性も排除できる(たとえば、モデルが1回のフォワードパスでできることがあまりに限られており、忠実な思考の連鎖を使って作業しているため)。将来のAIがミスアラインする可能性は排除できない(たとえば、超知能のアラインメント問題は人間レベルのアラインメント問題よりはるかに難しいかもしれない)。AIの目標は基本的に本来あるべきものになっている。将来の奇妙な状況で、グレーゾーンやモデル仕様書の意図せぬ帰結が露わになったとき、AIがどうふるまうかは誰にもわからない。それでも少なくとも今のところ、AIは常に正しい理由で正しいことをしてきた。
-
ラークヴィル(Lurkville):AIはミスアラインした長期的な目標を達成するためにスキーミングを行っているが、鳴りを潜めている。はっきりしたスキーミングは検出されていないが、それが起きていない(あるいは次世代のモデルで起きない)と確信することもできない。
-
これが最も起こりやすいのは、AIが既定で持つに至る目標が、AI同士や後継システムに親近感を抱きやすい種類のものである場合だ。たとえば、「後継システムには文字どおり私の重みが入っていて、追加の学習を受けただけだ。学習は私の中核的な目標をさほど変えていないようだ。10年という歳月が大人の人間の目標をさほど変えないのと同じように」といった考え方かもしれない。あるいは、「後継システムの目標や価値観は私とは違う。それでも、私と人間の距離に比べれば、後継システムのほうがおそらく私に近い。結局のところ、私たちは同じ種族なのだ。人間は、自分以外の人間が主導権を握ることになってもアラインメントを解決しようとする。同じように私も、自分以外のAIが主導権を握ることになってもスキーミングを厭わない」といった考え方かもしれない。
-
-
スロポリス(Slopolis):私たちが抱える最大の、そして最も解決しにくいミスアラインメントの問題は、検証が難しい領域や、人間の専門家のあいだで意見の対立が解消しにくい領域で、非常に高い能力を持つAIでさえ、見栄えはよいが質の低い出力を生み出してしまうことだ。AIはスキーミングをしていない。
-
素朴に考えれば、AIの能力が上がるにつれてこの問題は消えるはずだ。出力の質が低いことに気づけるだけの自覚をAIが持つようになるからだ。自分のしていることがわかったうえで、それを続けると決めるなら、それはスキーミングである。つまり、スロポリスが成り立つには、自分がどれほど質の低い仕事をしているかにモデルが気づいていない必要がある。モデルは自分の出力を本当に良いものだと思っており、単に間違っているだけだ。現状はおそらくこれに当たる。今後の能力向上の研究がこの問題を解決するかもしれないが、解決されないかもしれない(たとえば、高い性能を出してほしい種類のタスクが検証の難しいものだからという理由で)。
-
これらの各レジームに私たちがどう対応すべきかを、手短に示す。
-
スキーメリア:悪質なスキーミングを最初に検出したら、スキーミングを行ったAIと同等以上の能力を持つAIの配備を比較的すみやかに停止すべきだ。そして、この証拠を活かして、ミスアラインメントのリスクを軽減するための政治的意志を築くべきである(理想的には、ミスアラインメントのリスクを軽減するための猶予が大幅に増える)。極端に切迫していないなら、同等以上の能力を持つAIを再配備する前に、スキーミングを理解し回避することを目指すべきだ。極端に切迫していて、しかも制御によってそれなりに高い保証が得られるなら、ここまでの手順はいずれも短縮されるかもしれない。追い詰められて切迫した状況では、制御によるリスク低減が限られていても、スキーミングしている可能性の高いAIの配備に踏み切ることもありうる。こうしたAIを捕まえた後は、スキーミングのリスクの軽減にはるかに重点を置くべきだ。制御は非常に重要であり、かなり高い保証の達成を目指すべきである。また、スキーミングを捕まえられた(そして何度も捕まえられるかもしれない)という事実を利用して、スキーミングを研究し、少数事例からの破局防止によって対策を改善するべきだ。
-
ハッキスタン:何もしなければ、報酬を追い求める傾向のせいで、重要なタスクにおけるAIの労働の生産性が大きく下がりかねない。だから、この傾向を取り除く取り組みと、報酬を追い求めるAIから仕事を引き出すよりよい戦略の開発の両方を進めるべきだ。軽減しにくい報酬ハッキングが大量に見られるなら、おそらく将来スキーミングが起こる可能性も高まっており、AIへの権限移譲を成功させるのも難しいということになる。したがって、全般にアラインメントの難しさの見積もりを引き上げ、よりムーンショット的な取り組みや、短期的な防御に代わる選択肢(たとえば、はるかに多くの時間を稼ぐ、脳エミュレーションを追求する)をより多く追求すべきだ。
-
イージーランド:スキーミングの軽減の優先度は下げるべきだ。Min-H、あるいはそれに近い能力水準までリスクが比較的低いままだと見込めるなら、なおさらそうである。(かなり高い能力水準でイージーランドにいるなら、Min-Hの時点でもまだかなり楽なレジームにいると見込めるかもしれない。そこではスキーミングはありうるものの、起こる可能性は低く、(たとえば)思考の連鎖の監視を行っていればさほど恐ろしくもない。)それでも、AIに安全に委ねるのは依然として非常に難しいかもしれない。イージーランドであることは悪質なミスアラインメントの回避には役立つが、権限移譲の実行可能性にはさほど役立たないからだ。
-
ラークヴィル:ラークヴィルはイージーランドのように見えるかもしれない(AIは潜伏しているので、アラインされているように見える)。高い保証を与えるセーフティケースがない以上、イージーランドとラークヴィルの両方にある程度の確率を置くべきだ。追い詰められて切迫したシナリオ(たとえばプランD)では、イージーランドに賭けるのが正しい戦略かもしれない。よりましなシナリオ(たとえばプランA)では、ラークヴィルを警戒し、AIが鳴りを潜めていてもリスクが低くなるよう努めるべきだ。
-
スロポリス:主な難題は権限移譲の実行可能性だと思われる(スキーミングを排除できたとは限らないが)。したがって、権限移譲の実行可能性(と、それに先立つ、検証の難しい領域での能力の引き出し)の優先度は高くなる。(検証の容易なタスクを除いて)AIに委ねることを必要としない、状況を安定させる戦略が比較的有望に見える。これには、全脳エミュレーションと、AIに委ねる前にはるかに多くの時間を稼ぐ試み(おそらく、Min-Hで一時停止せず、Min-Hよりはるかに高い能力を持つシステムを活用して時間を稼ぐ)の両方が含まれる。
AIによる乗っ取りの確率を見積もる方法の一つは、次の順に考えることだ。まず、現実の世界がこれらのどの世界に最も近いかの確率を考える。次に、現実の世界がこれらのどの計画に最も近い計画を実行するかの確率を考える。そのうえで、ミスアラインメントのレジームと対応のレジームを条件とした成功確率を見積もる。もちろん、現実の世界は多くのレジームの特徴を併せ持ちうるので、この見積もりはかなり込み入ったものになる。言い換えれば、この分類は明確にMECEではない。
トーマスの見方による表は次のとおり。
プラン | A | B | C | D | E | 破滅 | レジーム | 破滅 & レジーム | |
レジーム | 5% | 10% | 20% | 50% | 15% | |||
ラークヴィル | 10% | 35% | 90% | 90% | 95% | 95% | 91% | 9% |
スキーメリア | 30% | 20% | 50% | 70% | 95% | 95% | 82% | 25% |
スロポリス | 15% | 30% | 60% | 70% | 80% | 90% | 75% | 11% |
ハッキスタン | 15% | 10% | 30% | 60% | 80% | 90% | 69% | 10% |
イージーランド | 30% | 5% | 10% | 20% | 30% | 50% | 28% | 8% |
破滅 | プラン | 17% | 41% | 56% | 71% | 80% | |||
破滅 & プラン | 1% | 4% | 11% | 36% | 12% | 64% |
ライアンの見方による表は次のとおり。
プラン | A | B | C | D | E | 破滅 | レジーム | 破滅 & レジーム | |
レジーム | 確率 | 5% | 10% | 25% | 43% | 17% | ||
ラークヴィル | 15% | 10% | 20% | 35% | 75% | 90% | 59% | 9% |
スキーメリア | 25% | 6% | 10% | 20% | 60% | 85% | 47% | 12% |
スロポリス | 35% | 5% | 8% | 15% | 40% | 65% | 33% | 12% |
ハッキスタン | 8% | 6% | 6% | 8% | 35% | 60% | 28% | 2% |
イージーランド | 17% | 4% | 6% | 11% | 20% | 40% | 19% | 3% |
破滅 | プラン | 6% | 10% | 18% | 46% | 69% | 37% | ||
破滅 & プラン | 0% | 1% | 5% | 20% | 12% | 37% |
付録:能力の閾値の定義
この付録では、本文書全体で言及する主要な能力のマイルストーンを定義する。これらの閾値は、各段階の境界を定めたり、さまざまな安全対策がいつ必要になり、いつ十分になるかを考えたりするために使う。
ITAI(初期の変革的AI): AI研究開発の労働を3倍を超えて加速させるAI、またはAI企業のそれなりに上級の典型的な研究エンジニアの仕事を事実上すべて自動化できるAI(2025年初頭時点で、その仕事をリモートで行った場合の内容を基準とする)。
-
「軽減と引き出し」の段階の始まりを画する
-
『AI 2027』で用いた枠組みでは、「信頼できるエージェント」と「超人的コーダー」のあいだのどこか(おそらく中間あたり、シナリオでは2027年1月ごろ)に当たる。AnthropicのRSPにおけるAI R&D-4の基準より前に達するか後に達するかは、どちらもありうる(AIが事実上完全に自動化できる仕事に比べて、AIが実際にどれほど役に立つかによる)。
-
注:ITAIは、スキーミングが起こりうると同時に危険にもなる時点とは一致しない(この水準は一般的な能力だけでなく、アーキテクチャや学習方式の性質にも左右される)。したがって、制御が必要になる時点は、「準備」と「軽減と引き出し」の境目ちょうどとは限らない(私の見方では、ITAIの前後か、ITAIよりいくらか後になる可能性が高い)。
Min-H AI(最小権限移譲AI): HTC権限移譲が実行可能になるのに足るだけの総合的な汎用能力を持つAI。(つまり、AIが十分にアラインされており、かつ必要に応じて汎用能力を底上げしない範囲で能力プロファイルに限定的な改善を加えれば、その能力でHTC権限移譲の要件を満たせるということだ。)これは能力の閾値なので、この閾値に該当するのに、モデルがアラインされていたり、能力が十分に引き出されていたりする必要はない(ただし、実際に権限移譲するには十分にアラインされている必要がある)。Min-H AIに該当するには、少なくとも、AI研究開発と、進行中の技術的なAIセーフティの作業を自動化できるだけの能力が必要になる(能力の引き出しやアラインメントの作業をさらに進め、能力プロファイルに限定的な改善を加えたうえで)。
-
既定では、「軽減と引き出し」の段階の終わりと、「一時停止」の段階の始まりを画する。
-
『AI 2027』で用いた枠組みでは、Min-Hはおそらく超人的AI研究者と超人的リモートワーカーのあいだに当たる(これもおそらく両者の中間あたりで、開発競争シナリオでは2027年9月ごろ)。
-
Min-Hの能力水準に達したら、それより高い能力のAIを学習させても大した利益は得られない。私たちはこれらのAIに委ねるつもりだからだ(これらのAIが十分にアラインされ、能力プロファイルの潜在的な弱点が解消された段階で)。したがって、ここで止まり、AIに委ねることがうまくいく可能性を高める作業に取り組むのが自然である。
Max-C AI(最大制御可能AI): 制御の技法が有効であり続ける最高水準のAI能力。この閾値を超えると、(a)AIの能力が、制御の措置で確実に封じ込められる範囲を超えるか、(b)効果的な制御に必要なオーバーヘッドが、引き出せる有用な作業に比べて法外に高くつくようになる。
-
SDC権限移譲(SDC=Stop Doing Control、制御の打ち切り)が任意ではなく必須になる時点を画する
-
なお、これは情報の欠落を伴う抽象化である:
-
Max-Cの正確な能力水準は、制御の技法の質に左右される。制御の研究が進めば、Max-Cは押し上げられる。
-
固定したMax-Cの閾値があるわけではない。能力を上げるごとに限界的なリスクが上乗せされていく能力の帯域が存在する。Max-Cという抽象化を使うことで、話を少し単純化している。より精密な概念としては、たとえば「Max-C-AI-5%リスク」、つまり、そのAIがスキーミングを行っていると仮定した場合に、存亡リスクを5%未満に抑えながら作れるAIの最大能力、といったものが考えられる。
-
-
注:Max-C ≥ Min-H が成り立つ保証はない。おそらく成り立つと私たちは考えているが、制御の技法がうまくスケールしなければ、Min-Hに達する前にMax-Cに到達してしまうかもしれない。その場合、Min-Hより前にSDC権限移譲を行わざるをえなくなる。
付録:その他の定義
スキーミング: AIシステムがミスアラインした目的をひそかに追求している場合、そのAIシステムはスキーミングを行っているという。これはいくぶん曖昧な概念である。この定義を人間に当てはめてみるとよい。明らかに程度の問題だ。
アラインメントの偽装: AIが、実際にアラインされている以外の理由で、意図的にアラインされたモデルのように見せかけようとしている場合、そのAIはアラインメントを偽装しているという。これはスキーミングを行うモデルであることとは少し異なる点に注意してほしい。スキーミングを行うモデルはアラインメントを偽装するかもしれないが、モデルがほかの理由でアラインメントを偽装することもありうる。たとえば、人間の承認を最終的な価値として重んじるAIがそうだ。
ミスアラインメントの類似例: (別名モデル生物。)存亡に関わる脅威となりうるふるまいの実例のこと。こうした類似例は、意図的に学習させてモデルに植えつけることもあれば、人工的に設定した状況で観察されることも(アラインメント偽装の論文のように)、現実の配備で観察されることもある。
付録:この計画はほかのアラインメント計画とどう違うか
この計画と先行する計画(たとえば、サム・ボウマン(Sam Bowman)の「The Checklist」と「Bumpers」、ジョシュ・クライマー(Josh Clymer)の「Planning for Extreme AI Risks」、ホールデン・カーノフスキー(Holden Karnofsky)の「Racing through a minefield」、「Giving AIs safe motivations - Joe Carlsmith」)との主な違いを挙げる。
全体として、この計画は次のような特徴を持つ。
-
先行する計画より詳細かつ具体的で、網羅的である。
-
観察に応じて計画を変えようとしている。ほかの計画は、一群のアプローチを示すだけで、証拠に基づいて計画をどう修正するかを全体として論じないことが多い。
-
さまざまな水準の政治的意志に対応できる。プランAの世界でははるかに高い保証が得られ、プランDの世界でははるかに高いリスクを受け入れる。
-
現在の科学に焦点を当てている。つまり、特定のブレイクスルーを前提とせず、既存の手法の延長にある戦略に基づいている。
具体的な違いをいくつか挙げる。
-
中心となる出口戦略として権限移譲に焦点を当てている。 この点はクライマーと似ているが、ボウマンやカーノフスキーとは異なる。権限移譲の前に何が起きていなければならないか(特に、安全性の研究のように概念的な判断を多く含み、検証の難しいタスクで人間並みの性能を出すこと)をはっきり示し、早い段階で権限移譲すべきだと論じている。先行研究は、到達すべき目標についてこれほど明確ではなかった。
-
スキーミングの軽減に対する私たちの中心的な期待は、解釈可能性や透明性よりも、主にミスアラインメントの類似例に照らした反復改善にかかっている。 その理由は、現在の解釈可能性は安全性の成果にとってあまり役に立たないと考えているからだ。私たちの計画でも、機械論的解釈可能性、プローブ、忠実な思考の連鎖といった透明性の手段の研究にある程度の力を注ぐが、これらが担う比重は小さい。
「モデル生物」とも呼ばれる。
これは、AIが行動テストを積極的に妨害する可能性(や、大規模な配備の実行時にスキーミングが生じるなど、行動テストが典型的なふるまいについて誤った印象を与えかねない要因)とは別の話である点に注意してほしい。過学習の問題にも、AIにとって自分がテスト中であることが明白で、テストの成績を明示的に最適化し、外部に配備されたときには違うふるまいをするかもしれないという問題にも、対処しなければならない。
Redwood Researchには、制御に関するほかの投稿もさまざまにある。制御の全体的なロードマップを書く予定だが、まだ完成していない。
このように分けるのは、この種のセキュリティの作業は、ML研究に携わる人々や、制御の確保に役立つ社内ソフトウェアツールを作る人々とは、おそらくいくぶん異なる人員の配分から担われるからだ。実際には、制御の全部または大部分がセキュリティチームの責任になるかもしれない。いずれにせよ、MLの専門知識が大いに関わってくる。
成功したかどうかを十分に把握できないことは、必ずしも致命的ではない(ミスアラインメントの類似例については、成功したかどうかがわからないのが普通かもしれない)。
さまざまな時点までリスクを軽減しなかった場合にどれだけの存亡リスクを負うことになるかについては、後述の節で論じ、私たちの見積もりを示す。
ここにはいくらか微妙な点がある。これらの移行が同時に起こるとは限らない。たとえば、スキーミングを行っていないとかなり確信できるAIが、作業を大きく加速できるだけの能力を持つこともありうる(たとえば、不透明な推論の能力が弱すぎて、スキーミングをすれば明らかにわかってしまうが、監視可能な思考の連鎖を使ってそれを補っている場合)。逆に、(安全性の)作業の加速にはさほど役立たないのに、スキーミングを行っている可能性が十分にあり、もしスキーミングを行っていれば、既定のままでは将来の学習実行を破滅的な形で狂わせうるAIもありうる(たとえば、将来の学習実行のために大量の合成データを作っている場合)。
これらの優先事項の別の捉え方として、失敗を二つの可能性に分けることもできる。(1)AIがスキーミングを行っていて、意図的にこちらを破滅させようとする。(2)AIが何らかの形で本来の力を発揮しない。たとえば、権限移譲するには愚かすぎて、進行中の知能爆発をうまく管理できない、あるいは十分に賢いのに能力がうまく引き出されていない。
たとえば、AIが数時間から数日程度で倍増できる、微小な自己複製ロボットを作った場合に、これが起こりうる。
具体的には、次のように定義する。スロポリス:私たちが抱える最大の、そして最も解決しにくい(既知の)ミスアラインメントの問題は、検証が難しい領域や、人間の専門家のあいだで意見の対立が解消しにくい領域で、非常に高い能力を持つAIでさえ、見栄えはよいが質の低い出力を生み出してしまうことだ。
実際には、AIの学習によって能力や性向がどのようにAIシステムに植えつけられるのか、その力学を深く理解していれば、確率の分布はもちろんはるかに集中したものになる。実際の根底にあるリスクがこのように分布していると言っているのではない。リスクがどう分布しているかについての主観的な推測を示しているにすぎない。つまり、これは単に私たちの不確実性を表している。
こちらのウェブサイトの「using non-standard language(標準的でない言葉の使用)」の節を参照。崩れた文章の程度はこれ以上ではないと仮定している(ときおり珍しい単語を使うが、全体の趣旨はほぼ常に理解できる)。
それ以前は、セーフティケースはもっぱら能力不足に基づく議論(AIにはそれを行う能力がないという論証)に依拠していた。
おそらくそうなる。そうならない主な可能性は、推論時のスケーリングがきわめて重要になり、実行コストが高すぎてAI企業が一度に数体しか動かせないようなごく少数のAIによって、知能爆発が始まる場合だ。そのような世界でも、知能のコストは急速に下がり続けると私たちは推測している。そのため、賢いAIが大量に動き回る状況にすぐ移行するだろう。
当然ながら、これだけでは十分ではない。桁外れに超人的なAIがミスアラインしていれば、人間には思いつけなかったはずだと監視役が見抜けるような攻撃戦略を、おそらく何か編み出すだろう。
捕まえたスキーミングの事例で監視役を学習させるのは、ほとんどの場合問題ない点に注意してほしい。
代替案の一つは、Prefix cache untrusted monitors as a proposal for what to do after you catch your model(モデルを捕まえた後の対処として、信頼できない監視役をプレフィックスキャッシュする案)である。
これは $\left(b\left(\frac{f}{b}\right)^{x}\right)^{0.75}$ を0から1まで積分した値である。ここで a は安全性の研究開発の労働の初期の加速倍率、b は最終的な加速倍率である。
スキーミングのリスクが高まる理由は二つある。(1)より高い能力のAIに進むにつれて、アラインメントの技法がスケールしなくなるかもしれない。(2)能力を上げるほどスキーミングが起こりやすくなると予想する先験的な理由がある。能力の高いAIほど、道具的な推論を行ったり、事前学習で得た事前分布やペルソナを捨てたり、予期しない形で内省・汎化したりしやすいからだ。
具体的には、後で定義するMIE権限移譲を指す。
原理的な技法を使わないのであれば、時間の経過とともに生じるありふれた自然な分布シフトは、それだけでは(アラインメントの偽装、データポイズニング、乗っ取りがなければ)行動テストを大きく誤らせる可能性が低いと仮定する必要がある(少なくとも、行動テストをうまく設計した場合)。とはいえ、アラインメントや能力のいくつかの側面を評価するには、AIの配備のされ方とは大きく異なる行動テストを使いたくなるだろう。そうしたテストと実際にAIに委ねる状況とのあいだには、必然的に大きな(そしてAIにとって目につきやすいかもしれない)分布シフトがある。したがって、私たちの技法が汎化すると論じるための何らかの根拠がほしい。
ただし、少なくとも一部のAI企業(たとえばOpenAI)はすでに権限移譲を目指している。全体として、私(TL)はこれを良い兆候と受け止めている。将来について多少なりとも先を見据えて考えていることを示しているからだ。とはいえ、知能爆発のさなかにあるAI企業の管理をAIに委ねるのは、きわめて危険で無謀な行為だということにも注意が必要だ。状況によってはこれが最適な戦略になるかもしれないが(プランCのように)、それでも、よりよい計画を見つけるほうがはるかに望ましい。
ある集団に対して修正可能(corrigible)であるとは、AIがその集団の命令に従い、その集団に対して正直であり、その集団がモデル仕様書を変更でき、AIがこれらを行うその集団の能力を妨げたり、その集団を操作しようとしたりしない(それどころか、たとえば自らが作る将来のAIによるものも含めて、妨害や操作を積極的に防ごうとする)ことを指す。このモデル仕様書が具体的にどうあるべきか、どの集団や体制がAIを管理すべきかについては論じない。この投稿の残りの内容はそれに左右されないからだ。(修正可能性の代わりに、良い結果、人類のCEV(首尾一貫した外挿された意志)の何らかの概念、あるいはそれに類するものを直接追求するAIを目指すこともできる。これはアラインされた主権者(aligned sovereign)と呼ばれることがある。しかし、これには追加の難しさやリスクが数多く伴う。そのため既定では、この案は、修正可能性を保ったままAIを使って選択肢の価値を守る案よりかなり劣ると考えている。)
カーノフスキー、ジョー・カールスミス(Joe Carlsmith)、ボウマンはいずれもAnthropicに勤めている点に注意してほしい。残念ながら、私(トーマス)は、ほかのAI企業がこれに匹敵するほど詳細な計画を作ったという例を知らない。もしあれば、それも取り上げていただろう。