
検証計画
Romeo Dean
プランAは、AIの進歩を減速させる国際協定を、相手への信頼に頼らずに執行できることを前提にしている。検証措置によってそれは可能になると私たちは確信している。相手の離反は発覚するか、発覚しないとしても影響のない規模にとどまる。検証措置は、米国と中国の双方にそう確信させるだけの保証を与えられるからだ。
最善の検証手段にも、コストと信頼性の面で幅がある。これを「検証のフロンティア」と考えられる。現時点で、検証のフロンティアは成熟していない。米中間でAI開発の一時停止を極めて高い保証水準で検証しようとすれば、今のところおそらくデータセンターの電源を落とすしかなく、それより低コストな方法では違反されるリスクがかなり残るかもしれない。とはいえ、検証という問題は本質的に防御側が優位だと私たちは考えている。しかもAIの検証は極めて若く、これまでのところごく小さな分野にすぎない。だから今後数年で大きく前進できる見込みは十分にある。
この補足資料では、まずプランAを実現可能にするために取るべきだと考える検証計画の概要を示す。続いて、プランAのシナリオの中で検証がどのように展開していくかを、より詳しくたどる。
この取り組みに協力したい方へ: Get Involvedタブを参照してほしい。なすべきこと、この分野が必要としている人材、関心表明フォーム、検証分野全体で募集中の機会をまとめている。
計画の概要
超知能をめぐる破滅的な開発競争を避けるために、米国と中国が主導する国際協定を私たちは提言する。この協定は、相手への信頼に頼らずに執行できるものでなければならない。検証できない合意を米中が結ぶとは考えにくいからだ。また、離反すればおそらく発覚するとなれば、両国が合意を破る可能性はずっと低くなる。
検証の問題は、二つの主要な要素に分けられる。
-
問題1:把握されている計算資源が協定を順守していることを検証する。
-
信頼に頼らない協定を可能にする検証措置は実現できると、私たちは確信している。とはいえ、もし明日にでも協定が必要になったら、信頼に頼らない執行を低コストで行う準備はできていない。AIサービスを止めずにおく経済的なインセンティブはますます大きくなっている。そのため、(起動にさほど時間のかからない)すぐに使える検証手段があるかどうかが、協定の成立にとって極めて重要になるかもしれない。
-
-
問題2:把握されていない計算資源が取るに足らない規模であることを検証する。
-
私たちの秘密プロジェクトに関する補足資料の推定では、有能に実行された秘密の転用工作であっても、協定開始時点で「闇の計算資源」として確保できるのは、AIに関係する世界の計算資源の中央値で約0.5%(80%信頼区間:0.1%〜1.4%)にとどまる。最先端の進歩はおそらく計算資源に左右されるので、これで協定は十分な時間と安定性を得られるはずだ。協定が続くにつれ、探知の取り組みが積み重なり、検証下に入る計算資源も増えるので、この上限はさらに厳しくなるはずだ。
-
私たちが推奨する解決策は、三つの段階からなる。
第1段階:協定の選択肢を確保する。 米国と中国は、協定を執行可能かつ持続的なものにするための行動を取る。推論専用の検証を実施できる態勢を整え、AIの計算資源がどれだけ存在し、誰が所有しているかを綿密に把握しておく。
第2段階:協定を実施する。 米国と中国は計算資源を相互に申告する(これを第三国にも広げ、理想的には世界の計算資源の99%超に及ぼす)。世界のAIデータセンターの計算資源の約99%に推論専用の後付け改修を施し、そのうえで、協定後に新たに生産される計算資源を使う安全な研究開発の検証体制を、全力で急いで構築する。
私たちのシナリオで2029年に協定を実施するとしたら、このような姿になると考えている。中規模・大規模のAIデータセンター(1万H100e超、およそ1億ドル超)すべてに推論専用の後付け改修を施せば、AIに関係する世界の計算資源の約99%をカバーできる。残りの小規模クラスターは所在を把握し続け、秘密プロジェクトに使われないよう対策を講じる。データセンターの規模の集中度のモデル化には確信がないので、具体的な線引きや介入策は変える必要があるかもしれない。
第3段階:堅牢性を高める。 米国と中国は時間をかけて検証体制の安定性と持続性を高めていく。特にハードウェアのセキュリティや検証の堅牢性などを通じてだ。
第1段階:協定の選択肢を確保する
協定締結前の取り組みは、最低限の検証パッケージを大急ぎで整えることに集中させるべきだ。このパッケージによって、世界のAI計算資源の99%を、推論専用であることを検証できるよう安全に後付け改修できるようにする。あわせて、世界のAI計算資源の少なくとも99%について、その存在を低い不確実性で(少なくとも情報機関が)把握しておく。そうすれば、将来の計算資源の申告から(したがって検証体制から)、もっともらしい否認の余地を残したまま計算資源を隠すことはできなくなる。
なぜこれを推奨するのか?
仮に2029年になっても検証の進展が現在と変わらなければ、協定締結後、最先端のAI開発が急速に続いていないことを双方が高い確信を持って確かめるには、フロンティアAIのサービスの大部分(たとえば90%)を6〜12か月停止させておく必要がある、というのが私たちの最善の推測だ。最低限実用的な推論専用の後付け改修手段が用意されていれば、同じ期間は2〜5か月程度で済む。経済的影響で見れば、両者の差は2029年までに数兆ドル規模になるかもしれない。もちろん、より汎用的な検証手段、たとえば承認された学習や実験の継続も認められるものが用意されていれば、なおよい。しかしそれはおそらく難しく、推論専用の手段に上乗せできる利益もわずかだと考えている。経済的な利益の大半は、推論だけを動かし続けることで確保できるからだ。減速協定のもとでは、学習や実験はいずれにせよ意図的に制限される。AI開発をどう進めるかを交渉している初期には特にそうだ。
こうした検証手段が用意されていても、協定の検証が及ぶ範囲の上限は、世界の計算資源のうち協定の下に置ける割合で決まる。米国や中国、あるいは他の主体が、保有する計算資源の量についてもっともらしい否認の余地を持っていれば、その余地を使って計算資源を協定から隠し、秘密プロジェクトで検証されていない計算資源として使える。しかし、把握されていない計算資源の合計が世界の計算資源の1%未満なら、そうした秘密の取り組みはおそらく取るに足らないと私たちは考えている。秘密プロジェクトに関する補足資料はこの点を直接モデル化しており、私たちが推奨するスケーリング戦略のもとで、有能に進められた秘密プロジェクトが発覚や権限移譲の前に協定を揺るがすAIに到達する確率を、およそ13%と推定している。これらの推定は協定開始時点のものだ。協定が続けば、追跡と監査の結果が収束し、探知の取り組みが積み重なり(秘密プロジェクトに関する補足資料の探知に関する推定を参照)、検証下に入る計算資源も増える。それにつれて不確実性は狭まり、秘密裏に保有されうる量も減っていくはずだ。もちろん、把握されていない計算資源は少ないほどよい。それでも、世界の計算資源の1%前後という目標はおそらく達成可能であり、安定した協定には十分だと考えている。
最優先の提言:
-
検証の研究開発に投資し、特に安全な推論専用の後付け改修計画の開発に、検証の研究開発全体の約80%を振り向ける。
-
あわせて、検証の研究開発の約20%を補完的な取り組みに充て、有望な追加手段を追求する。たとえば、ソフトウェアのみによる手段、プライバシーを保護する検証手段、より汎用的な検証手段(学習や実験が順守されていることも検証できるものなど)だ。
-
-
(たとえば情報機関が担う形で)計算資源の計数と追跡に投資し、AIに関係する計算資源が世界にどれだけ存在し、どの主体が保有しているかを把握する。
-
注意してほしいのは、この初期段階のチップ追跡についての提言では、計算資源がどこにあるか、何に使われているかを知ることを優先していない点だ。協定を実現可能にするうえでの利点の大半は、単に計算資源がどれだけ存在するかを知り、どの主体がいつ保有しているかを追跡し続けることにある、と私たちは考えている。もっともらしい否認の余地がなければ、協定交渉の時点で計算資源を申告させるにはそれで十分なはずだからだ(協定に加わる大きなインセンティブもある)。とはいえ、所在も把握していれば役に立つ。転売やチップの故障を装った記録の偽造のような、もっともらしい否認の余地を生むケースを防げるし、(何らかの理由で)米中両政府が保有主体にほとんど影響力を持たないケース(保有が知られている計算資源の所在を申告するよう圧力をかけられない場合。たとえばロシアの計算資源)にも対処しやすくなる。
-
第2段階:協定を実施する
安定した協定を築くには、ただちに計算資源の相互申告とサプライチェーンの記録監査を実施し、協定の下に置く計算資源の量を最大化することを推奨する。次に、その計算資源に利用可能な最善の推論専用の検証手段を導入し、学習と実験の短期的な一時停止を執行する。並行して、学習と実験の再開に向けた検証体制を大急ぎで整えることを推奨する。
なぜこれを推奨するのか?
把握されていない計算資源は協定の検証の対象にできないので、最優先すべきは把握されていない計算資源を最小限にすることだ。そのために急を要するのは、既存の計算資源と、現在輸送中または生産中の計算資源の申告をただちに行うことだ。そのうえで米中双方が相手の申告を監査・査察し、(事前の準備が適切に行われていれば)自国の独自の情報収集の結果と照らし合わせて、相手の計算資源量についての不確実性を解消できるはずだ。
世界の計算資源の約85%は米国か中国の主体が保有しているはずなので、計算資源の99%を協定の下に置くことを目指すなら、残りの差を占めるとみられる他の5〜10か国にもこうした申告の合意を広げる必要がある。他国への拡大をどれほど急ぐべきかは、それらの国が保有する計算資源の量について情報機関がどれだけ不確実性を抱えているか、またそれらの国が相当量の計算資源を探知されずに隠しおおせる可能性がどれだけありそうかによる。
申告の後には、短期間のAI研究開発の一時停止(新たな学習実行と実験の停止)を行い、既存の計算資源を推論専用に切り替えることを推奨する。先に説明したとおり、これなら協定の目的(AIの進歩の減速)を達成しつつ、経済的な利益の大半を保てる(AIのサービスや製品は動き続ける)。しかも比較的検証しやすい。その時点で用意できている最善の推論専用の検証手段を使うべきだ。現時点では、ネットワークタップと再計算を軸にした手法を目指すことを推奨するが、別の手法のほうが優れているかどうかを見極めるにはさらなる研究開発が必要だ。劣った手段しか用意できていない可能性もあるが、それでも、より良いものが用意できるまでの協定の初期構築には十分に使えるだろう。
最後に、学習と実験の再開に向けた検証体制の構築は、協定開始後に行う別個の取り組みとして進めることを推奨する。研究開発の検証には、協定が発足してから決めるべき重要な性質がいくつかあるからだ。加えて、今後も協定を安定させるには、研究開発の検証に極めて高いセキュリティ要件が求められる。特に、どの水準の透明性を目指すかを決めなければならない(私たちは「研究の完全な透明性」体制を推奨するが、選択肢については透明性に関する補足資料で詳しく扱う)。いずれにせよセキュリティ要件は高いので、検証対象のデータセンターは一から建設する必要があると考えている。新規建設にかかる時間が受け入れがたいほど長いと判断された場合や、研究開発の検証に十分安全な後付け改修の手段がある場合には、既存のデータセンターを研究開発に使う暫定期間を設けてもよい。とはいえ、約2年後には検証とセキュリティの要件が引き上げられ、世界の計算資源の90%ほどはいずれにせよ協定後の新しい計算資源になる。その時点では、協定後に新設した高度に安全なデータセンターを使うことを、より強く推奨する。
最優先の提言:
-
既存の計算資源と新たな計算資源の生産の両方について、二国間の計算資源申告とサプライチェーン監査を実施し、相当量の計算資源を保有または生産している第三国にも広げる。
-
主要なデータセンターの所有者と、サプライチェーンで大きな役割を担う企業はすべて、購入と販売の記録を公に申告する。そして互いの国と企業に監査人・査察官を受け入れ、記録と最終的なチップの数を検証させる。輸送中の計算資源や、生産中の計算資源も対象に含める必要がある。これ以降、既存の計算資源と新たに生産される計算資源は厳重に追跡・警備され、探知されずに秘密プロジェクトへ回されることがないようにする。この申告は、相当量の計算資源を保有している国や生産能力を持つ他国にも広げる。計算資源の移動を探知できる確かな情報態勢が整っていない限り、これは急いで行う。
-
-
既存の計算資源と新たに稼働する計算資源のすべてに、推論専用の検証を導入する。
-
既存の計算資源に推論専用の検証を展開し、AIサービスの稼働を続けながら、短期間のAI研究開発の一時停止を執行する。理想的には、高度に安全な手段がすぐ使える状態で用意されているのが望ましい。そうでなければ、利用できる最善の手段を導入する。手段がまったく用意できていなければ、計算資源を停止するか、より良い手段への移行を急ぐあいだ、技術以外の措置(たとえば互いの企業に監査人を常駐させ、誰も実験や学習実行を行っていないか確認する)だけに頼る。
-
-
選択した透明性体制に沿って、研究開発の検証体制を大急ぎで整える。
-
プランAのシナリオでは、「研究の完全な透明性」と呼ぶ特定の体制を推奨している。ただし透明性に関する補足資料で説明するとおり、条件によっては別の手法のほうがよい場合もある。どの体制を取るにせよ、高度に安全な研究開発クラスターと、協定後の高度に安全な推論クラスターを何らかの組み合わせで建設すべきだ。ほとんどの透明性体制で、少なくともAIモデルの重みと検証の正しさにはSL5水準(国家レベルの攻撃者に耐えられる水準)のセキュリティが必要になると考えられるからだ。そのため、これらのクラスターは一から建設すべきだと考えている。
-
実際にはどのようなAI研究開発の取り決めを検証すべきか?
協定の第一の目的は、安全性を高めるためにAI開発を減速できる条件をつくることだ。そのために、安全資源の配分(たとえば能力研究の代わりにアラインメント研究を行う)や開発の方向性(たとえば、安全性の劣るかもしれない特定の研究方向を追求しない、特定の効率的なアルゴリズムを使わないと合意する)の面で安全税を払う。安全性を重視したAI研究のこうした減速を、全体として「AI研究の滴定」と呼ぶ。AI研究の滴定の方法は、最初は粗いもの(たとえば実験用計算資源の厳しい上限)かもしれないが、時間とともに洗練されていく(たとえば能力向上の外部性についての科学的理解に基づく個別判断)。
さらに協定では、不安定化を招きかねない水準のハードウェア研究やハードウェア生産にも対処する必要があるかもしれない。プランAのシナリオでは、こうしたリスクに対処するため、ハードウェア研究の滴定と、ロボットおよび計算資源の生産に対するキャップ・アンド・トレード政策を推奨している。これらはすべてプランAにおける検証の展開で詳しく扱う。
第3段階:堅牢性を高める
協定がいったん発足すれば、その堅牢性はさまざまな面で改善できると見込んでいる。私たちが推奨するのは次のことだ。ハードウェアのセキュリティに重点的に投資する。検証体制を改善する。協定の堅牢性に有利なハードウェア設計上のトレードオフを追求する(たとえば検証を容易にする、各種のセキュリティ特性を改善する、秘密プロジェクトよりも協定の参加者を相対的に有利にする)。そして、協定から離脱するインセンティブを減らす(たとえば計算資源の相互確証破壊や、協定が崩壊したときの結果を主体間で釣り合わせることによって)。
なぜこれを推奨するのか?
協定の堅牢性は、実現可能な多くの点で改善できると見込んでいる。協定の弱体化に関する補足資料で検討したとおり、協定の崩壊はプランAの成功を脅かす最大の要因の一つなので、協定から離脱するインセンティブを減らすことは、協定の安定性を高めるうえで中核をなす。協定からの秘密裏の離反も、協定に対するもう一つの中核的な脅威だ(秘密プロジェクトに関する補足資料で検討した)。したがって、協定の堅牢性を高めるもう一つの柱は、検証体制の改善になる。把握されている計算資源についての保証水準を高めることと、把握されていない計算資源の量を減らすことの両面でだ。さらに、モデルの重みのセキュリティなど各種のセキュリティ特性を改善し、より広く言えば、離反しうる主体が自ら進歩を生み出したり、進歩を盗んだりすることを難しくする。
協定の堅牢性を高めるための具体的なアイデア
-
協定崩壊への備えとインセンティブの設計
-
計算資源の相互確証破壊。 主体が協定から離脱する動機をそぎ、離脱が起きた場合にもAI開発をより安全にするための主要な提案の一つが、協定後の計算資源を互いに破壊できる態勢を整えておくことだ。
-
これが強固に整っていれば、計算資源の一部を守り抜いて開発競争に戻り、持続的な優位を得ようと協定から離脱する主体は、正気である限り現れない。それでも協定が崩壊した場合には、どの主体も協定後の計算資源を破壊できるので、状況ははるかに安全になりうる。巨大な計算資源のオーバーハングがなくなるからだ。各主体が開発競争を繰り広げる通常の世界に戻ったとき、このオーバーハングはAIの進歩を極端に速め、極めて危険なものになりかねない。
-
-
コールドストレージの計算資源バンク。 協定から離脱するインセンティブを減らすもう一つの方法として、小規模な計算資源バンクを設けることが考えられる。協定期間中は使われていないことを検証するが、協定が崩壊した場合には各陣営が確実に守り、再稼働させられるようにしておく。
-
これが想定されるどの秘密プロジェクトよりも確実に大きければ、最大の秘密プロジェクトを持つ主体であっても協定から離脱するインセンティブはなくなり、そもそも秘密プロジェクトを試みるインセンティブも減る。私たちのシナリオでは、米国が500万H100e、中国が50万H100eのバンクを維持する(これらの備蓄の数値は協定の弱体化に関する補足資料を正とする)。米国のバンクは、秘密プロジェクトに関する補足資料で想定される転用量の80%信頼区間の上限である約400万H100eを余裕をもって上回る。米国と中国の計算資源バンクの規模の比率(独自のバンクを交渉で得る第三国があればそれも含む)は、協定前の現状の計算資源比率で固定してもよい。
-
-
コールドストレージのモデルの重み・データバンク。 協定が崩壊した場合の状況を改善するもう一つのアイデアとして、米国と中国が合意のうえで、堅牢化されたコールドストレージのモデルの重みバンクにモデルを預けることが考えられる。
-
双方は相手の重みがほかのどこにも流れていないことを検証できる必要があるが、協定が崩壊しても相手の重みを破壊できるわけではない。両国がこれを望むとすれば、最終的な学習済みモデルや大規模なデータセットという形でアラインメントの大きな進展が得られており、協定崩壊時にそのモデルの重みやデータセットを保持できるほうが世界にとって安全だと相互に合意している場合だ。
-
-
-
協定下の計算資源に対する検証の保証水準を高める
-
ハードウェアのセキュリティ。 協定のもとでは、ハードウェアのセキュリティ特性をいくつか飛躍的に改善できるかもしれない。特に、AIによる研究の自動化をこれらの分野に重点的に投入し、設計上の選択でハードウェアの「セキュリティ税」を払うことによってだ。対象には、形式検証の拡大のようなソフトウェア面のセキュリティ改善と、改ざんを極めて困難にするハードウェア面のセキュリティ改善の両方が含まれうる。その一歩として、ファブをはじめサプライチェーンの各所で監視とセキュリティを強化することが考えられる。計算資源の相互確証破壊にも(純粋に暗号技術によって)役立ちうる好ましい特性として、オフライン・ライセンシングもある。また、外部からは観測できないハードウェア由来の鍵を使い、AIクラスター内の安全な部分でモデルの重みを暗号化したまま保持する計算クラスターを構築できるかもしれない。これを十分に堅牢にできれば、モデルの重みのセキュリティは飛躍的に高まり、SL5水準のモデルの重みに関する他の措置(帯域幅の制限)を緩めることもできるだろう。
-
検証の粒度。 ハードウェア改善のより具体的な領域として、検証の堅牢性を高めることもある。たとえば極めて高い忠実度での再現性、より細かい粒度のログ記録への対応、固定機能のハードウェア設計のようなより具体的な手段だ(たとえば重みのハードコードは、推論専用の検証を格上げするうまい方法かもしれない)。
-
-
秘密プロジェクトに使われうる計算資源を減らす
-
秘密プロジェクトの可能性を突き止める。 時間がたつにつれ、一定規模以上の秘密プロジェクトの存在を、より小さな規模まで順に否定できるようになるかもしれない。手段は、情報活動、把握されている計算資源をさらに(たとえば軍事用として除外された計算資源やごく小規模な民間クラスターを)プライバシー保護型の検証措置の下に置く合意、あるいは電力使用量の計数(たとえば相互申告と抜き打ち査察)の合意だ。秘密プロジェクトに関する補足資料では、探知の方法(排熱の追跡、その他のIMINT/MASINT、SIGINT、HUMINT)を扱い、秘密データセンターの規模ごとに探知確率を推定している。時間をかけて交渉しうるより強い検証上の譲歩についても論じている。
-
新たな計算資源が秘密プロジェクトに流れないようにする。 協定の極めて重要な性質の一つは、協定後に生産される計算資源がまったく秘密プロジェクトに流れないことだ。秘密プロジェクトに関する補足資料の推定では、生産は少数の厳重に管理されたファブを通じて行われるため、新しいチップの転用はほぼゼロに抑えられ、合計が10万H100e未満にとどまると非常に高い確信を持って言える。これをさらに堅牢にするには、AIチップの生産をより少ない拠点に集中させること、あるいは生産拠点を最終的な行き先(データセンター)と同じ場所に置くことが望ましいかもしれない。総生産量が年3倍のペースで増えていれば、2年ごとにファブの90%が新設になるので、これは実行できる。新しいファブは比較的容易に別の場所に建てられるということだ。消費者向けの計算資源は別の場所で生産してもよいが、それが秘密プロジェクトに使われるリスクには別途対策を講じるべきだ。
-
秘密プロジェクトに使われうる消費者向け計算資源を制限する。 2029年までに、消費者向けの計算資源には、AIに関係する計算資源もある程度含まれるだろう(たとえば愛好家が持つ高性能なゲーム用GPUや、自動運転車のチップ)。大半はAIの作業負荷ではあまり役に立たない、AIに関係しないチップだが、それでも数は非常に多い。最先端のAIの作業負荷にどれほど役立つかは、その時点でより正確に検証すべきだ。有用性が高いと判明すれば、大量の消費者向け計算資源がかき集められて秘密プロジェクトに使われる事態を避けなければならない。監視(つまり報告義務や抜き打ち検査)は最後の手段とすべきだ。代わりに、自発的な買い戻しプログラムや、検証されていない消費者向け計算資源の新規生産総量に対するキャップ・アンド・トレードが考えられる。理想的には、これが許可のコストを避けるための「エッジ検証」(たとえば堅牢な固定機能のハードウェアの仕組み)に関するイノベーションにつながるだろう。上限は、秘密プロジェクトを目に見えて加速させるには、容易に気づかれるほどの割合の消費者向け計算資源を転用しなければならない水準に設定できる。
-
-
想定される秘密プロジェクトよりも協定の側を相対的に有利にする方向性
-
AIのスケーリングにおけるトレードオフ。 プランAの中核的な提言の一つは、能力の進歩を意図的に進める場合には、可能な限りソフトウェア(アルゴリズム効率)ではなくハードウェア(つまりモデルの規模、学習用の計算資源、データなど)のスケーリングによって進めるべきだ、というものだ。後者のほうが統制しにくい(つまり秘密プロジェクトから守りにくい)うえに、望ましくもないからだ。協定が進むにつれ、この考え方をかなり先まで押し進める方法がおそらくある。極めて巨大なAIモデルへと進めば、盗むのは非常に難しくなり、たとえ盗まれても、秘密プロジェクトが協定前の計算資源でそれを動かすことすら極めて難しくなる。秘密プロジェクトに関する補足資料の推定では、コンソーシアムのソフトウェアの進歩のうち中央値でおよそ3分の2が秘密プロジェクトに漏れる。同資料は、ハードウェア寄りのスケーリング戦略が秘密プロジェクトのリスクをどれだけ減らすかも定量化している。
-
ハードウェアとソフトウェアの協調設計。 技術的に可能だと判明すれば、協定前の計算資源ではうまく動かず、新たに設計・製造された協定後の計算資源ではよく動く新しいAIアルゴリズムに移行する。たとえば、協定前の計算資源が最適化されていたものとは異なるモデルアーキテクチャや数値形式を導入する。そうすれば秘密プロジェクトは、コンソーシアムからアルゴリズムを盗んでも、主に協定前の闇の計算資源の上で動かすことは容易でなくなる。
-
プランAのシナリオにおける協定の検証
プランAのシナリオは、前節で描いた検証計画の大枠に沿って進む。検証に関する補足資料のこの部分では、実施と検証の展開を、より具体的な細部とともにたどっていく。これは未来についてのシナリオであり、しかも研究開発が進行中の極めて若い分野を扱うので、具体的な細部には確信がない。それでも、上で描いた検証計画が実際にどう実施されうるかについて、具体的で有用な基準線を示せればと考えている。
2026〜2028年:協定の選択肢の確保
2026年:チップの追跡が始まる
米国の情報機関は、中国へのAI計算資源の密輸と中国国内の生産量を内部で把握し始め、年末までに中国の主体が保有するAI計算資源の総量を不確実性10%で把握できるようになる。ただ、この情報はまだ何にも使わない(たとえば密輸に関する情報をBIS〔米商務省産業安全保障局〕と共有しない)。米国の情報機関がこうした活動をしていることを知った中国も、同じことを始める。主に台湾のTSMCにある既存の情報源を活用して、総生産量の正確な数と記録を入手する。中国は米国のAI計算資源の総量を不確実性10%で把握するに至る。不確実性の大半は、既存の計算資源と、台湾以外(たとえば韓国や米国)での生産に関するものだ。新たな計算資源の生産量についての不確実性ははるかに小さい(1%程度)。
2027年:検証の研究開発に資金がつく
米国の行政府は、協定の選択肢と、それを可能にしうる検証措置に関心を示し始める。一連のRFI(情報提供依頼)を経て、推論専用の後付け改修の手段として、ネットワークタップと再計算を軸にした手法に力を注ぐことを選ぶ。互いのデータセンターに機器を設置するという構想は当初警戒を呼ぶが、セキュリティの問題としては十分に取り組める。結局、ネットワークタップの設計のいくつかが極めて単純であること(要するに光信号を分岐させるガラス片だ)と、さまざまな物理的セキュリティの研究課題への並行投資のおかげで、必要になった場合に備えてこのタップを大量生産しておく価値が本当にあるかもしれない、という見方が現実味を帯びてくる。一方、各国が単独で信頼する再計算サーバー(ネットワークタップが通信を転送する先で、実際に検証を行う役割を担う)はより複雑なので、そのままでは信頼しにくい。しかし、ここにも大規模な投資が行われる。研究開発プログラムは、信頼を築くために意図的に透明にされ、オープンソースで公開される。中国も、同様に透明な形で独自の対称的な手段を開発・構築するインセンティブを見いだす。年の後半には、両国は検証に関係するものの、それ以外の点では機微でない重要な情報、特に互いのネットワークと計算の方式に関する情報を共有することで合意する。互換性のあるネットワークタップと再計算サーバーを作るには、それが欠かせない。年間を通じて、さまざまな資金源から、世界各地で複数のパイロット事業が実施され、設計の改良が繰り返され、生産規模の拡大に向けた準備が進む。最終的に米国と中国は、脆弱性の入り込む余地がほとんどない極めて単純な光分岐設計のネットワークタップを採用する。下のボックスで私たちが提案するような、より野心的な設計や、暗号技術に基づく別の手法は選ばれない。後者はより不確実だが、(十分に低いコストで)うまくいけば、さらに優れていて信頼しやすいものになるかもしれない。
推論専用の後付け改修についての具体的な提案
現時点での私たちの最善の推測では、米国と中国は、ネットワークタップと再計算サーバーを使う推論専用の手段を目指すべきだ。この手段なら、当初の減速協定を高い水準で検証でき、経済的なコストも低く抑えられるという利点の大部分を得られるうえ、実現可能で構築も容易だと思われる。ただ、後半の点については確信が低い。だからこそ、RFIを出し、パイロットと手法の改良に向けた試行錯誤をできるだけ早く始めることを、より強い確信を持って推奨している。
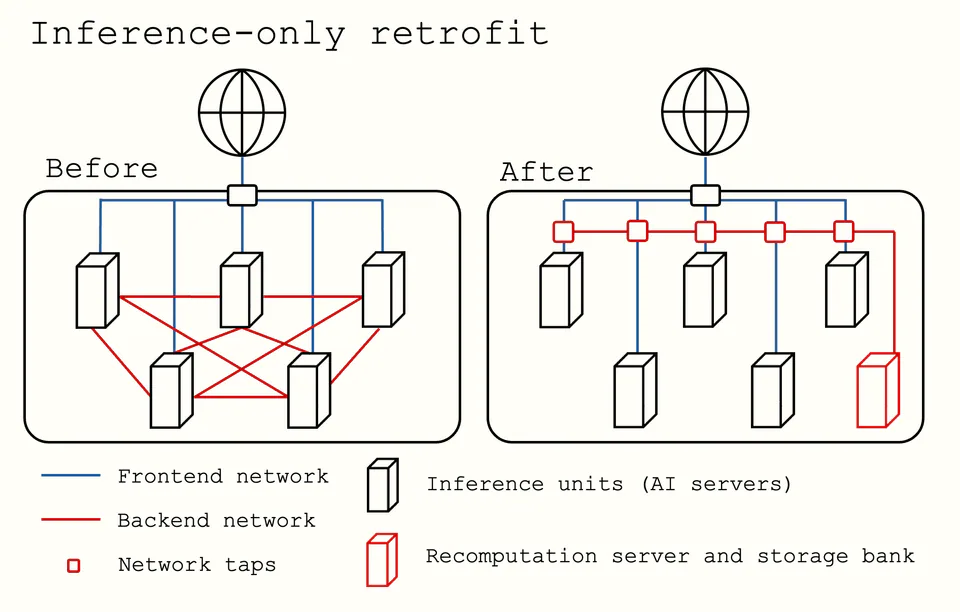
提案の概要:
-
バックエンドのネットワーク(イースト・ウエスト方向のネットワークとも呼ばれる)の(かなりの部分を)取り除き、データセンターを互いに隔離された推論ユニットの集まりに転換する。
-
現在、データセンター内のAIサーバー同士は大量の高帯域通信を行っているが、これは(主に)学習にしか必要ない。比較的小さなオーバーヘッド(たとえばユーザーのメモリ保存の再編成)で、大規模な推論はスケールアウト用の相互接続を大幅に減らしても動かせるはずだ。この相互接続を取り除くことは、クラスターを大規模な学習実行に使いにくくする、多層防御の重要な一手になる。
-
-
フロントエンドのネットワーク(ノース・サウス方向のネットワークとも呼ばれる)に、単純なパッシブ型ネットワークタップを追加し、すべての入出力通信の複製を再計算サーバーに転送する。
-
フロントエンドのネットワークに設けるこうしたネットワークタップには、いくつもの実装方法がある。現時点では、完全にパッシブで、光信号を二つに分岐させる方式がおそらく最も信頼しやすいので、それが望ましいと考えている。これとは別に、ストレージバンクから推論ユニットへ戻る経路も設けるべきだ。
-
-
すべてのAIの作業負荷(推論、エージェントによるツール利用など)を、離散的で再現可能なパケットに整理させる。パケットはネットワークタップを通過するので、再計算サーバーから中身が見える。
-
再計算サーバー上で部分再計算(パケットの無作為抽出)を行い、パケットの正しさを確認する。
-
この段階では再計算サーバーの完全性が極めて重要になる。とはいえ、その計算と出力が信頼できるなら、無作為抽出による部分再計算は極めて有利にスケールし、元の計算資源のごく一部だけを使って、すべての出力の正しさを極めて高い確率で検証できるはずだ。計算は付録を参照。
-
-
強固な物理的セキュリティを備え、改ざん攻撃などから検証措置の完全性を守りやすくする
-
検証プロセスの完全性を保つには、改ざんや、検証プロセスを無力化しうるその他の攻撃を防ぐだけの十分な物理的セキュリティ措置が必要だ。
-
-
サイドチャネル通信の最大量に上限を設けることと、定期的なメモリ消去(おそらく強制的な記憶の上書きによる)によって、網羅性を検証する。
-
この検証提案の網羅性、つまりクラスターからの出力が検証済みの推論トークンだけであることを保証するには、ここで述べたようなサイドチャネル対策とメモリ消去が必要になる。余った計算資源が承認されていない作業負荷に使われていないことまでは検証しない(それは非常に難しそうだからだ)。その代わりに、出力という形で後に残る結果が、検証済みの推論出力だけになるよう努める。そのためには、推論ユニットに強力なサイドチャネル対策と定期的なメモリ消去が必要になる(後者は強制的な記憶の上書きで実現できると考えている)。
-
この提案を発展させる一案として、ネットワークタップより多くの機能を持つ、より複雑な「セキュア・ネットワーク・ゲートウェイ」を構築することが考えられる。このゲートウェイは、再現用パケットのログを整理して無作為抽出し、堅牢な形で再計算サーバーに送る。
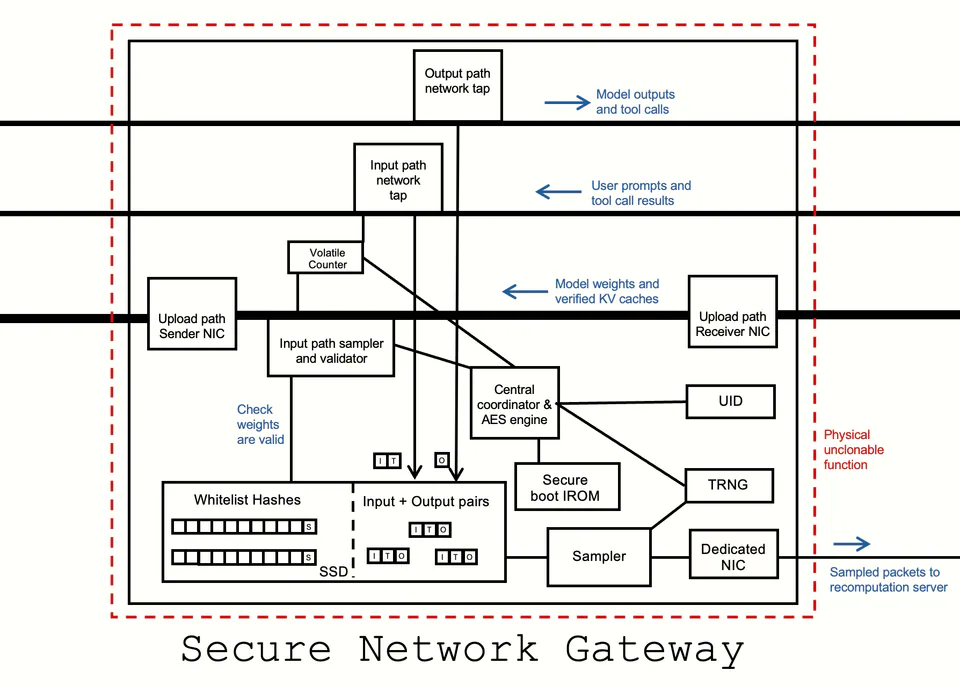
セキュア・ネットワーク・ゲートウェイのおおまかなイメージ。データの経路には入力と出力の二方向があり、それぞれの経路にネットワーク分岐器が置かれる。分岐器がデータの流れをログに記録し、ログはパケットに整理されて無作為に抽出され、安全な再計算サーバーに送られる。起動フェーズでは、ゲートウェイはさらに、ホワイトリストに載ったモデルの重みだけが推論ユニットにアップロードされていることを確認できる。こうしたゲートウェイに求められるハードウェアのセキュリティ特性の中には、前例のあるものもある。たとえばiPhoneのSecure EnclaveやPUF(物理的複製困難関数)だ。
これらは、先ほどと同様の構成でネットワークタップの代わりに使える。
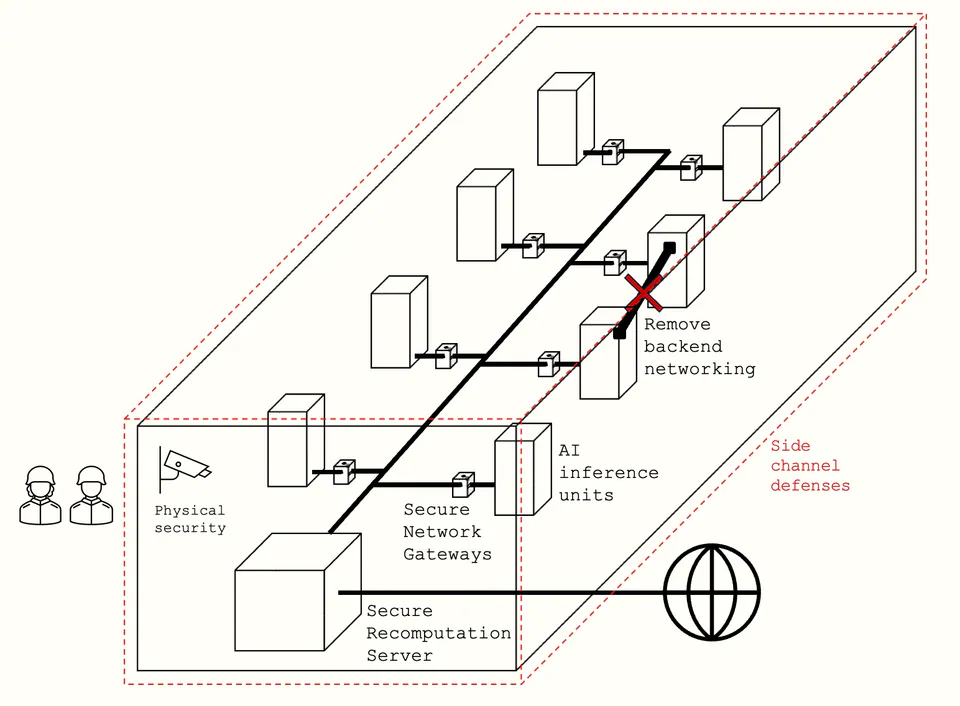
ネットワークタップと再計算を軸にした手法を構築するこの主要な取り組みに加えて、他の手法の研究開発にも相当な資金(1億ドル規模)が投じられる。ソフトウェアのみによる手法や、暗号技術を中心とする手法(たとえばZKP(ゼロ知識証明))などだ。さらに、推論専用の後付け改修の手段を補う物理的セキュリティの研究開発にも、同程度の資金(1億ドル規模)が用意される。
その他の有望な検証の方向性
私たちが描いた部分再計算の手法の代わりに、推論専用であることを別の方法で検証できるかもしれない。たとえば次のようなものだ。
-
純粋に暗号技術によるプロトコル。たとえばAIの作業負荷向けのゼロ知識証明(ZKP)
-
プライバシーを保護でき、ハードウェアの後付け改修も少なくて済む可能性があるのが利点だ。ただ、そのための十分に計算効率の高いアルゴリズムが見つかっていないため、現時点ではやや推測の域を出ない。
-
-
メモリへのチャレンジに基づく検証
-
こちらもハードウェアの後付け改修が不要になる可能性があるのが利点だが、網羅性の検証ではおそらく困難に直面する。それでも、協定の初期の実施には使えるかもしれない。
-
-
粗いハードウェアの改変
-
主要なスケールアウト用の相互接続を取り除き、たとえば簡単なセンサーやその他の物理的セキュリティの仕組みを設置するだけでも、協定の初期段階(たとえば1年間)なら推論専用であることの検証に足りるかもしれない。より大量の計算資源や、より重大な作業負荷に対応できる、保証水準の高い措置が用意できるまでのつなぎだ。
-
2028年:チップの追跡が成熟する
情報機関は新たな計算資源の生産を綿密に追跡してきた。追跡を始める前から存在していたAI計算資源の量についても、不確実性をある程度まで絞り込むことに成功している。年末までに、中国は米国の計算資源の総量を約2%の不確実性で、米国は中国の総量を約4%の不確実性で把握している。つまり中国から見れば、米国の保有量は2億2,200万〜2億2,600万H100相当の範囲にあると80%の確信を持っている。米国から見れば、中国の保有量は2,500万〜2,700万H100相当の範囲にあると80%の確信を持っている。
2029〜2030年:協定の実施
2029年1月:チップの相互申告と査察
プランAの交渉開始から1週間以内に、米国と中国は計算資源の申告とサプライチェーンの記録監査を実施し、互いの国に数百人を送り込んで記録の査察と監査を行わせる。互いの計算資源量について、もともと比較的小さかった不確実性は、これでさらに小さくなる。いまや双方の最善の推測では、相手が申告から隠せた計算資源は最大でも約150万H100e(80%信頼区間の上限は約400万)だ。これは首位のAI企業の研究開発用計算資源の約4%、世界の計算資源全体の約0.5%にあたる。秘密プロジェクトがどれだけの計算資源を隠せそうかについての推定と論拠は、秘密プロジェクトに関する補足資料を参照してほしい。
クラスター規模の区分ごとに提案する介入策の詳細は、以下のとおりだ。
クラスター規模 | ただちに行う介入 | 2029年1月時点でこの区分に含まれる計算資源の推定量(世界のAIデータセンター計算資源に占める割合) |
中規模・大規模データセンター(1万H100e超、約1億ドル) | 推論専用の後付け改修 | 99% |
小規模データセンターと分散したAI計算資源 | AI性能がA100を上回るものすべてに報告義務。無作為の抜き打ち検査。 | 1% |
AIへの有用性が不明な非AI計算資源(iPhoneなど) | 消費者向け計算資源を大量にかき集めようとする動きを情報活動で監視。 | 0.1〜10%? AIへの有用性をどう補正するかという不確かな要素による。 |
チップの申告には、新たな計算資源の生産すべてを極めて綿密に把握し続けることも含まれる。AIとの関係を示す一定の性能指標を超えるチップはすべて、検証措置の対象に含めるため、把握済みの場所に送らなければならない。一方、性能の低い消費者向け計算資源の生産は、おそらく制限なしのままでよい。
チップの流通制限
米国と中国は、今後生産される計算資源が違法なプロジェクトに流れる可能性を最小限に抑える必要がある。つまり、製造を監視し、輸送を警備しなければならない。幸い、AI計算資源の製造は世界の少数の施設に極めて集中しており、2029年までこの状況は続くはずだ。新たなAI計算資源の生産(高性能なAI用メモリやネットワーク機器などの重要部品も含む)を100%把握することは十分に可能だと考えている。秘密プロジェクトに関する補足資料の推定では、協定後の生産分からの転用はほぼゼロに抑えられ、合計が10万H100e未満にとどまると非常に高い確信を持って言える。企業が新たに購入した計算資源の送り先は、次の二つのどちらかに限って認めることを推奨する。
-
既存のデータセンター/建設中のデータセンター:ここに送られた計算資源は、推論専用の後付け改修が完了した時点で、推論にだけ使うことが認められる。
-
相互管理の一時的なコールドストレージ保管施設:ここに送られた計算資源は、相互に検証される新しい安全な研究開発クラスターが整い、研究開発(学習と実験)に使える状態になるまで警備される。
当初は、相互接続・演算性能・メモリ・帯域幅が十分に低いチップであれば、制限なく生産してよいとすることを提案する。そのうえで2032年までに、暫定的な案として上限を設ける。演算性能の閾値はやや緩め(より高いエッジ計算能力を必要としうる消費者向け用途の余地を残すため)、相互接続の閾値は厳しくする(転用された場合に秘密プロジェクトでの有用性を下げるため)。詳しくは2032年の節を参照。
2029年2月:推論専用の後付け改修が始まる
計算資源の申告と査察を終え、相手の計算資源の大半を把握できていると比較的確信した米国と中国は、短期間のAI研究開発のモラトリアムで合意し、世界に向けて発表する。AI企業は、進行中の学習実行の一時停止も含め、当面ただちに研究開発をやめることになる。互いの最大級のデータセンターに推論専用の検証手段を展開するあいだ、両国は小規模クラスター(1万H100e未満のもの。後付け改修までにしばらくかかるため)の電源を100%落とし、それより大きなデータセンターすべての電源を80%落とすことで合意する。計算資源の約20%があれば、少し処理量が落ちるだけで、すべてのAI製品とサービスを問題なく動かし続けられるはずだからだ。こうすれば、協定の構築中に誰かが離反して相対的な優位を得たうえで、以前より有利な立場から開発競争に戻る、という事態をある程度防げる。
米国は計算資源の約95%を、合計約20万台のAIサーバーラック(1ラックあたり平均で1,000H100eをわずかに上回る)に収めている。中国は計算資源の約95%を、10万台のAIサーバーラック(1ラックあたり平均で約250H100e)に収めている。
幸い、米国には約1万台のネットワークタップと、(単独で)信頼する再計算サーバー100台の在庫がある。中国には約2万台のタップと200台のサーバーの在庫があり、両国ともさまざまな第三者から毎月さらに1万台ずつ購入できる。中国のほうが計算資源が少ないので、米国は中国の計算資源をより速く後付け改修できる。しかし両国は、中国が達成できるペースに合わせた比例的な後付け改修スケジュールで合意する。そのペースとは、既存のネットワークタップの在庫を使って、米国の計算資源の40%を1か月で4ラック(4,000H100e)単位の推論ユニットに改修するというものだ。両国ともこのペースに従い、3か月の時点で80%まで引き上げ、その後は95%超への拡大や推論ユニットの小型化を進める。
2029年3月:研究開発クラスターの建設が始まる
推論専用の後付け改修を進めるあいだに、米国と中国は、目指すべき規制計画の大枠と透明性体制について合意する(選択肢のいくつかは透明性に関する補足資料で取り上げている)。違法なプロジェクトのリスクが比較的小さいと認識されていることや、その他のさまざまな考慮から、両国は「研究の完全な透明性」の手法を目指すことに決める。これには、モデルの重みのセキュリティと検証の完全性がいずれもSL5水準の研究開発用データセンターを整えることが含まれる。両国は、これらのデータセンターを自国で守り抜けないものにしておきたい。そうすれば、協定から離脱して新しい研究開発クラスターで再び開発競争を始めることが難しくなるからだ。そこで相互抑止を狙い、米国の研究開発クラスターをモンゴルに、中国のものをカナダに置く。米国はモンゴルのクラスターに警備要員を置き、中国やほかの誰かが奪取しようとした場合に計算資源を破壊する堅牢な「焦土化」の仕組みを備える。カナダにある中国の計算資源にも、対称的な措置が講じられる。両国は3月にただちに、強い緊急性をもってこれらのインフラ事業に着手し、検証付きの研究開発のパイロットを始められるよう、6か月以内に小規模な処理能力を稼働させることを目指す。予定している検証手法は推論の検証手法と似ており、ネットワークタップを証拠収集に使い、部分再計算で作業負荷を構成するパケットの正しさを検証する。
2029年4〜5月:第三国の協定参加が始まる
4月から2029年の残りの期間にかけて、世界の富裕国上位20か国の大半と、半導体サプライチェーン上で重要な国々が、計算資源を申告し、自国のデータセンターへの推論専用の後付け改修を受け入れる形で協定に加わる。ドイツ、日本、英国、インド、フランス、ブラジル、カナダ、メキシコ、イタリア、オーストラリア、韓国、スペイン、アラブ首長国連邦、サウジアラビア、台湾、オランダ、スイスなどだ。
2029年6〜7月:高度に安全な(SL5)推論専用クラスターの新設が始まる
透明性体制の一環として、承認された最先端モデルを広く一般に提供する計画だ。ただしSL5水準のモデルの重みのセキュリティのもとで行い、それをSL5水準の出力検証と蒸留対策によって実現する。消費者向けにはゼロデータ保持(ZDR)の推論を、リスクの高い用途には透明性のある推論を、組み合わせて提供する計画だ。詳しくは透明性に関する補足資料を参照。SL5水準のモデルの重みのセキュリティと検証の完全性を実現するには、これらのクラスターはおそらく一から建設する必要があると考えている。
ゼロデータ保持(ZDR)の推論
ZDRの利点(AIの利用者が強力なプライバシー保証を得られる)とリスク(AIが存亡に関わる危険な用途に使われる)を両立させるため、協定期間中の推論について、プライバシー保護の3段階の提供形態を提案する。
データが削除される確率 | リスク軽減策 | ファインチューニングAPI | 推論フリートの上限(世界全体) | |
完全ZDR | 100% | 極めて強力な分類器、拒否、ジェイルブレイク対策を備え、リスクの高い領域(たとえばAI研究開発)では能力を持たないモデルを使う。 | なし | 10万H100e |
確率的ZDR | 99.9% (無作為抽出。分類器によってリスクが高いと判定されたものは、透明性のある公開データベースに送られる) | 無作為抽出したデータを分類器にかけ、リスクが高いと判定されたものは透明性のある公開データベースに送る | あり | 1億H100e |
ZDRなし | 分類器の判定によって変わる(無作為抽出。分類器によってリスクが高いと判定されたものは、透明性のある公開データベースに送られる) | 通常の分類器、拒否、アンラーニングなどの対策に加え、圧縮・蒸留対策。 | あり | 1,000億H100e |
2029年8〜9月:世界の計算資源の95%で推論専用の検証が整う
夏のあいだに大規模な計算資源保有国がいくつも協定に加わった結果、世界の計算資源の95%が推論専用の検証の下に置かれる。検証はより細かい粒度(より小さな推論ユニット)に広がり、物理的セキュリティも向上している(サイドチャネルの削減と、多大な労力をかけた物理的な警備・監視)。
2029年後半:研究開発の検証のパイロットが稼働し始める
カナダとモンゴルの両方で、共同で建設したデータセンターが9月までに稼働を始める。規模はカナダで約1GW、モンゴルで2GWほど(世界の計算資源の約2%)で、年末までに世界の計算資源の約15%まで拡大する。企業はこれらのクラスターに計算資源を置くことを認められ、稼働し始めたスペースを入札で奪い合う。当初承認されるのはごく小規模な実験だけで、検証とセキュリティの措置の有効性を試して改善するために、レッドチーミングと改良が繰り返される。
考えられる検証手法の概観
AIの検証に関する既存の研究(Bakerら、Scherら、Harackら、Cankayaら)は、研究開発の検証に活用・発展させられる多くの概念や提案を示している。
検証の問題を考える一つの方法として、私たちはこれを二つの部分に分けることを提案する。(1)証拠を集めること、(2)その証拠に基づいて何かを証明することだ。これは非常に単純なもの(たとえば、把握されているすべての計算施設の電源が切れているので、AIの研究開発は行われていない)から、高度なもの(たとえば、暗号学的な証拠に基づけば、学習実行が承認された学習データと手法を正しく使ったことは極めて高い確率で言える)まで幅がある。
以下は、現時点で私たちが考えている、利用しうる証拠収集と検証の手法の一部を示した例だ(網羅的ではない)。
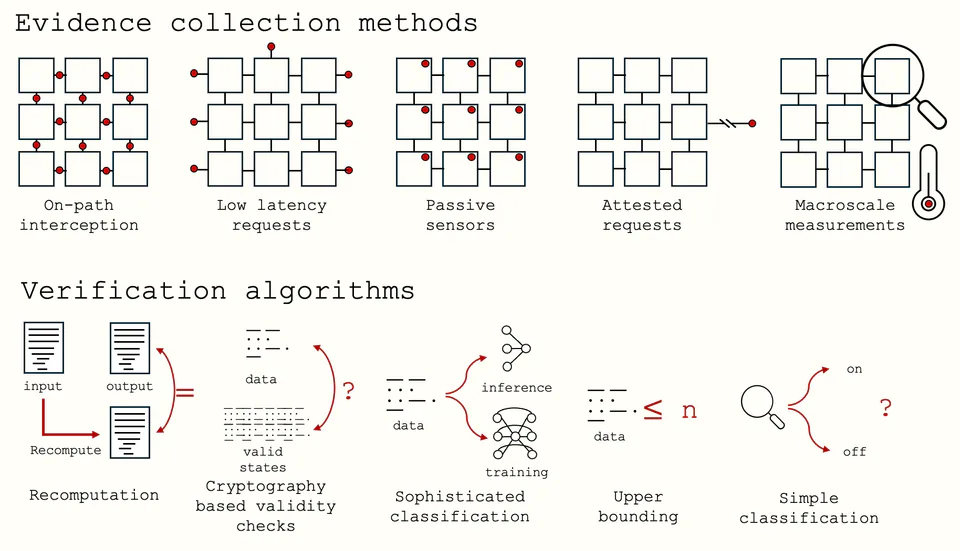
私たちが重視する主要な検証指標には、次の5つがある。
-
保証曲線。 保証曲線は、カバレッジ(検証手段が何らかの主張をしている対象が、AI計算資源の何%にあたるか)と、信頼度(カバーされた資源について検証手段が行う主張がどれほどの確率で正しいか)の水準に関する情報をとらえる。保証曲線は、関連する(カバレッジ、信頼度)の値の組の集合として定義する。この2次元の曲線全体が重要だ。権限移譲のリスクと秘密プロジェクトのリスクがどこで交差するかを知ることが大切だからだ。
は、作業負荷のパケットのうち、正しさを確認するために再計算されるパケットの数を表す。これらの保証曲線の導出と詳しい説明は付録にある。
-
実行の難しさ。 その検証手段を正しく実施するのはどれほど難しいか。たとえば、検証手段のうち要となる部分が、検証ソフトウェアの構築、機器の製造と設置、物理的セキュリティの執行と監視などに、専門家の人手を大量に必要とする場合だ。
-
必要な準備。 その検証手段を実施するのに、どれだけの研究期間が必要か。既存の情報収集能力で実施できる手段なら、必要な準備は極めて少ない。逆に、チップ上の高度な仕組みを要する手段なら、必要な準備は極めて多い。
-
プライバシーの水準。 その検証提案が、証明する側と検証する側のあいだでどこまで非公開情報の開示を求めるか。この点はあまり心配していない。私たちはそれとは別に透明性の向上を推奨しているし、セキュリティ上の対策も講じられると考えているからだ(モデルの重みのように、拡散させたくない情報の場合は特に)。それでも、検証に低いレベルのアクセス(たとえばトークン、モデルの重み、アルゴリズム)が不要であるに越したことはない。
-
経済的コスト。 最後に、検証手段を実施することで、経済的価値が全体としてどれだけ失われるかを示す指標だ。この介入によって、甚大な経済的損失を伴うリスク(たとえばAIによる大惨事や人類の絶滅など)が回避されたかもしれない点は考慮しない。つまり、AI開発が続く「良い世界」を前提として、その反実仮想と比べてどれだけの経済的価値が失われるかを見る。検証手段を実際に開発・製造・実施するコストよりも、どれだけのAI推論の継続が認められるか、そしてそこから生じる下流の経済的便益(こちらは定量化が難しい)のほうが、はるかに大きな比重を占める可能性が非常に高い。
-
対象範囲。 たとえば、その検証手段は推論専用かどうかを確認するだけなのか、それとも大規模な学習実行や実験を含む任意のAIの作業負荷を扱えるのか。
どの検証手段を選ぶかは、これらの指標のあいだの複雑なトレードオフになるだろう。現時点での私たちの最善の推測では、情報収集は主に経路上での収集(つまりネットワークタップ)に頼り、検証アルゴリズムには部分再計算を使うのがよい。極めて高いカバレッジと信頼度まで、最も堅実にスケールできそうだからだ。
どの検証手法にも欠かせないとみなし、実施されることを前提とする要素
これまでのAIの検証に関する研究(Bakerら、Scherら、Harackら、Cankayaら)を踏まえると、どの検証手法にも多層の防御を設けるべきだと考えている。この補足資料のほかの部分では、たいてい最も大きな役割を担えると考える検証手法に焦点を当てている。しかし、ほかにも多くの措置が必要になるか、少なくとも役に立つと考えている。たとえば次のようなものだ。
-
物理的セキュリティ。 どの検証手法も、AI計算インフラの物理的な状態に関する何らかの不変条件に頼ることになるだろう。有望な今後の方向性や既存の手法には、改ざん検知可能な筐体、監視カメラ、境界管理、エアギャップなどがある。推論専用の執行では、ハードウェアが大きく改ざんされていないという確信がほぼ確実に必要になる。検証に物理的な後付け改修が伴う場合は特にそうだ(現時点ではそれが最も有望な道だと考えているが、ソフトウェアのみによる手法も排除されてはいない)。朗報は、検証に必要な物理的セキュリティの要件が、それとは別にデータセンターに持たせたいセキュリティ態勢と大きく重なることだ。
-
人に基づく手法。 内部告発者プログラム、職員への聞き取り、常駐監査人は、特に初期には、大規模な違反を明るみに出すうえで大いに役立ちうる。私たちの提案では、どれもこれらを要となる手段としては位置づけていない。ただ、特に、より堅牢な技術的仕組みが稼働できるようになる前の初期段階では、非常に有用な補完手段になると見ている。
-
相互に信頼できる製造とサプライチェーンのセキュリティ措置。 多くの検証の仕組みは、ネットワークタップ、再計算サーバー、改ざん検知可能な筐体などのハードウェアが、実際に称するとおりのものであることを前提にしている。そのため、検証用ハードウェアそのものの製造とサプライチェーンを相互に検証したいという要請が生じる。Harackらは、特にチップ外の仕組みであれば、非侵襲的な下流での試験や、旧世代プロセスのファブでの共同生産を通じて相互に検証できるかもしれないと指摘している。また、同期した単独の確認によって、一部の領域では相互信頼の問題そのものを回避するという有望なアイデアもある。Cankayaは、パッシブな光ファイバー分岐器(デジタル論理を持たない、融着したガラスにすぎない)を使うことを提案している。そうすれば双方は、相手のハードウェアを信頼しなくても、それぞれ独立にネットワークの通信を観測できる。これを、各自が単独で信頼する機器と組み合わせ、それぞれが独自に検証を実施する。
2030年初め:本格的な研究開発の検証が始まる
カナダかモンゴルにある検証済みの研究開発クラスターには、いまや約1億H100相当が置かれている(当時の世界の計算資源の約20%で、協定開始時に存在した計算資源の35%に相当する)。これらのクラスターには透明性措置が導入されており、企業は、統合されたアルゴリズムを使った協定後初の大規模な学習実行を承認される。数か月でこれらの学習実行が完了し、いくつかのモデルは自動コーディングAI(AC)のマイルストーン前後に達する。モデルは広く試験され、レッドチーミングを受ける。その担い手には、この目的のために研究開発クラスターの計算資源を少量借りる多くの第三者団体や監査人も含まれる。
ここで、研究開発の進歩のスピードをどう制御し、(速く進みすぎる)リスクと(能力を高める)便益のバランスを取るかという、大きな規制上の問題が生じる。 これは、協定の中で有能に実行するのが最も難しい部分だと言ってよいだろう。依存関係は複雑だ。速く進みすぎれば、AIによる乗っ取りのリスクが生じたり、進歩が秘密プロジェクトに拡散したりする(合法プロジェクトのゆとりが減る)。一方、遅すぎれば、協定が崩壊するかもしれない時点までにアラインメントの進展が十分に得られないリスクや、それどころか協定の外で動く違法なプロジェクトに実際に敗れるリスクが生じる。
私たちが推奨する能力向上スケジュールの大枠はこうだ。制御に基づくセーフティケース(安全性の論証)を確実に構築できる最大の能力までスケールアップし(できれば主にハードウェアのスケーリングによって)、そこで一時停止する。そして、アラインメントに基づくセーフティケースの限界的な進展(権限移譲のリスク)が、協定によって負っているリスクを下回るまで待つ。
しかし、目指すべき能力向上スケジュールの大枠を念頭に置いていても、その水準の能力の進歩を実際に執行するのは難しいかもしれない。能力の進歩が投入量(たとえば計算資源)から予測しにくい場合や、測定しにくい場合、放っておけば速く進む場合には特にそうだ。私たちの最善の推測では、計算資源の厳しい上限を設け、その後は質の高い個別ルールを組み合わせれば十分だろう。詳しくは下のボックスで説明する。
研究の滴定:研究開発の進歩のスピードをどう制御するか?
計画のこの部分は、最終的に規制当局の能力に依存する。研究をどのスピードに調整するのが正しいかを決めるという、おそらく厄介で複雑で予測しにくい問題についての能力だ。そのため、これは計画の中でも私たちが懸念している弱い部分であり、今後の研究によって、この問題をうまく乗り切る方法についての考えが改善されることを期待している。結局のところ、私たちが「研究の完全な透明性」を推奨する中心的な理由の一つはここにある。透明性があれば、より正確で効果的な規制上の判断を下しやすくなると考えているからだ。有望な手法もいくつかあると考えている。いずれも、必要な規制能力が少なくて済むことと、目指す研究の滴定の目標をより正確に代理できることのあいだで、トレードオフの関係にある。この二つの概念を、以下では次のように呼ぶ。
-
実施の容易さ。 正しく実施するのがどれだけ容易で、執行するのがどれだけ容易か。
-
規制の正確さ。 その規制が実際に目標を達成する可能性がどれだけ高いか。つまり、正しく実施・執行された場合に、ソフトウェアの研究が高い確率で安全なスピードで進むか。
以下にいくつかの手法を挙げ、それぞれがこのトレードオフのおおよそどこに位置すると考えるかを示す。
-
セーフティケースによる立証責任。 あらゆる研究開発について、承認前に強力なセーフティケースの論証を求める。規制の正確さという観点からは、この手法はほぼ定義上、私たちが望むものだ。しかし、良いセーフティケースと悪いセーフティケースを見分けるのは極めて難しいかもしれない。そもそも良いセーフティケースを作ること自体が、特にAIの支援なしでは非常に難しいかもしれない。この手法が協定の進行とともにようやく実行可能になっていく理由の一つはそこにある。もっとも、協定が進んでAIがより高い能力に達するにつれ、規制の正確さの重要性も増していく。そこで、非常に高い能力を持つAI(たとえば人間のトップ専門家を凌駕するAI(TED-AI))が開発された、あるいは開発間近になった協定の中期から後期には、この体制を用いることを提案する。
-
質の高い個別ルール。 認められる研究の方向性とスピードについて、個別に判断する。極めて複雑になりうる(あるいはそもそも作成すること自体が難しすぎる)セーフティケースを正しく診断しなければならない場合に比べ、この手法のほうがいくらか実行しやすそうだ。どのパラダイムを追求・放棄するか、資源配分の面でどのレバーを引くかといった大局的な判断を下せばよいからだ。その一方で、この手法はおそらく正確さの面でいくらか劣る。大局的な個別ルールには、安全でない開発を許してしまう解釈の余地や抜け穴がありうるからだ。
-
人間による理解可能性の要件。 承認されるすべての手法は、何らかの人間の集団が端から端まで理解できるものでなければならない。人間による理解を研究の進歩のボトルネックにすることは、安全性の代理指標としてかなり優れているかもしれず、実施もかなり容易だ(人間が無作為に抽出したサンプルを見ればよい)。とはいえ、安全でないのに人間には理解できるものは十分にありうるので、この手法に長く頼るのは不安定かもしれない。また、実際には進歩を遅くしすぎる可能性も十分にあり、その場合は緩和版を用いるか、別の手法を使うべきだ。この手法は、ハードウェア研究の滴定には非常に適しているかもしれない。これについては後述する。
-
計算資源と資源の上限。 研究開発用の計算資源に単純な上限を設ける。実施と検証は極めて容易だが、非常に不正確になるかもしれない。一定の計算資源やその他の資源(たとえば人間の研究者)の閾値からどれだけの進歩が生じるかは、不確かなモデル化の問題であり、誤差の幅もおそらく大きい。それでも協定の初期段階では、これらの上限を非常に低く設定することは、実施しやすい良い出発点になりそうだ。その後、能力を高める時間を得るにつれて、より正確な手法へと段階的に移行できる。
研究に関する特定のルールを定めたとしても、そのルールが実際に守られるよう執行するという別の問題が残る。研究開発のルールを執行する問題は、次の二つに分けられる。
-
作業負荷の承認。 企業が申告する作業負荷が、規制ルール(その実施形態がどうであれ)を実際に満たしていること。
-
作業負荷の検証。 企業が申告する作業負荷が、実際に実行されるものと一致していること。
私たちの見方では、作業負荷の検証は、先に論じたのと同様の方法(ネットワークタップによる証拠収集と、無作為に選んだ再現可能なパケットの部分再計算)で解決できる。一方、作業負荷の承認は、どのような形のAI研究開発ルールが設けられているか(たとえば、実験用計算資源の上限だけなのか。特定の手法が禁止されているのか。特定の手法が義務づけられているのか)と密接に結びつく。承認についての私たちの基本的な提案は、研究開発クラスターに常駐する監査人のチームが手作業で行う、というものだ。
作業負荷の承認
ここでの中心的な難しさは、作業負荷がルールに従っているかどうかがはっきりしない場合があることだ。ルールが個別判断に寄るほど、その傾向は強まる。また、AI企業が敵対的な攻撃を仕掛けることもありうる。たとえば、表面上は順守しているように見える作業負荷の中に、順守していない作業負荷を埋め込もうとする攻撃だ。体制が進み、相互検証の下に置かれる計算資源がますます増えていくと、総計算資源のごくわずかな割合を順守していない目的に流用するこうした攻撃も、無視できない規模になるかもしれない。
私たちが考えつく対策は次のとおりだ。
-
申告された作業負荷とデータに対するステガノグラフィー対策
-
監査人によるGPU命令へのコンパイル。できれば、より堅牢で安全なプログラミング言語を使う
-
AIの支援によるデータのフィルタリングと確認
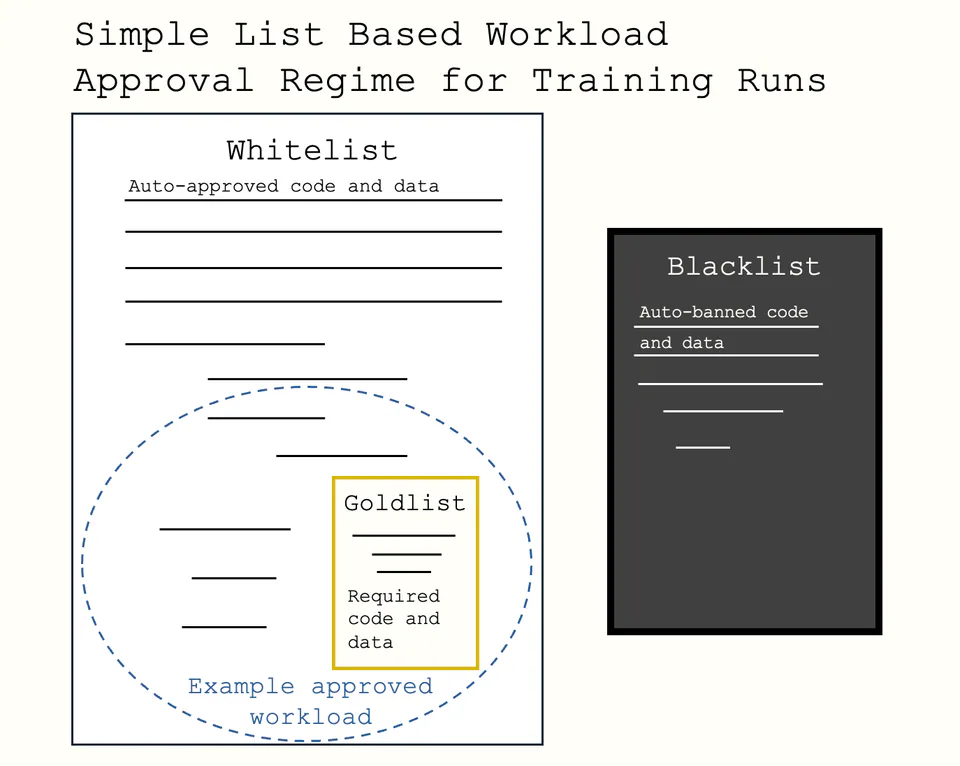
全体的な体制として使えそうなのは、次のようなリストを維持する方式だ。審査を経て使用が承認されたコードとデータの「ホワイト」リスト、禁止されたコードとデータの「ブラック」リスト、特定の種類のすべての作業負荷に義務づけられる手法の「ゴールド」リスト。これらのいずれか、または組み合わせを用いる。そうすれば、作業負荷の承認の問題は、作業負荷を承認するか却下するかを判断するために、これらのリストと照合するだけの問題に帰着させられる。ホワイトリストに載ったコードだけで、ひそかに不正な作業負荷を実行するのは格段に難しくなるかもしれない。ただ、問題を、これらのリストに項目を載せるプロセスのほうに先送りするだけかもしれない。少なくとも、作業負荷の承認を、企業やさらには一般の人々も貢献できる、より透明なプロセスにする助けにはなるだろう(ただし公開されているものすべてについてであり、協定が後半に進めば、透明性の提案で述べる公開猶予(エンバーゴ)の仕組みによって秘匿が図られる、社内で発見されたアルゴリズムの一部は除外されるかもしれない)。
作業負荷の検証
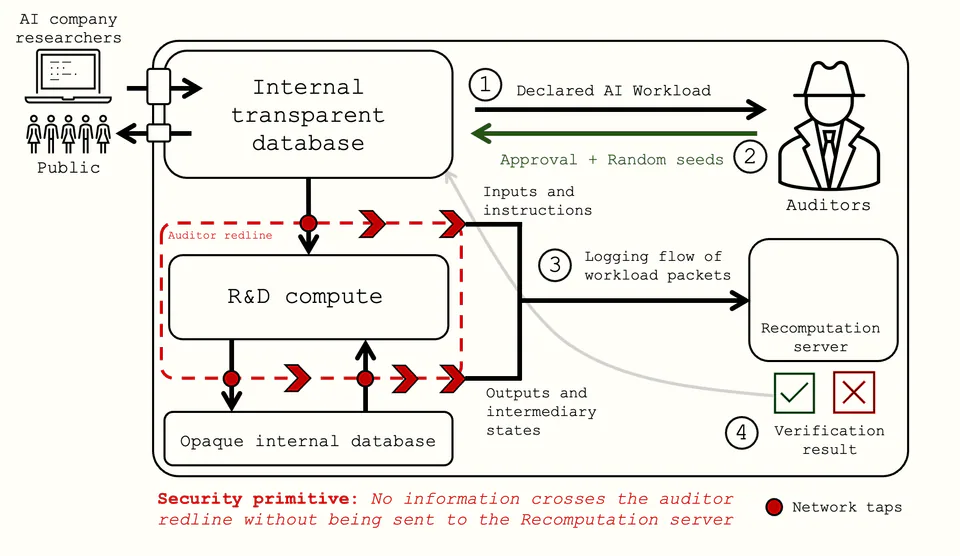
先に、利用できそうな証拠収集や検証の種類をいくつか挙げた。極めて高い保証水準に達するには(プランAではこれがますます必要になる。詳しくは後述)、再現性の義務づけと、完全な(そして粒度をしだいに細かくしていく)経路上での証拠収集を組み合わせ、部分再計算に基づく検証アルゴリズムと対にする方式が実行可能な手法になる、と私たちは推測している。とはいえ、別の手法(たとえば低遅延のチャレンジと妥当性確認を使うもの)が、より低いコストで同じ保証水準に達したり、同じコストでより高い保証水準に達したりすることはない、と確信しているわけではない。検証の問題が解決可能であることを論じるという目的のため、以下では、完全な(そして粒度をしだいに細かくしていく)経路上での証拠収集と、部分再計算に基づく検証アルゴリズムを取り上げる。
検証の問題を考えるうえでもう一つ役立つのは、AIの作業負荷を離散的なステップの連なりとして考えることだ。
これらの計算ステップは、そのままではランダム性を伴って実行される。しかし再現可能にすることを強制できれば(たとえばシードを固定したランダム性なら問題ない)、証拠収集の粒度と検証アルゴリズムの保証水準のあいだに予測可能な関係が成り立つ。作業負荷のごく一部を無作為抽出で再計算する部分再計算は、正しさを確認する個々の作業負荷パケットのサイズを小さくするほど、探知確率が有利にスケールするからだ。詳しくは付録を参照。
協定の最初の数年について私たちが想定している具体的な体制は、引き続きネットワークタップを証拠収集に使い、無作為に選んだ再現可能なパケットの部分再計算によって正しさを検証するものだ。大枠の手法は推論専用の場合と同じで、時間とともにネットワークタップをバックエンドのネットワークのより下位の層へ移し、パケットのサイズをどんどん小さくしていく。
-
申告: AI企業は、実行したい作業負荷を、コードやアルゴリズムなどを完全に開示したうえで申告する。
-
承認: 監査人は作業負荷の承認の実施方法に従って確認を行い、合格すれば承認を返し、必要な乱数シードを提供する(AI企業が偽のランダム性で不正をするという攻撃経路をなくすため)。
-
証拠収集: 監査人は作業負荷から証拠を集める(たとえばネットワークタップを通じてデータの流れを完全に記録する)。図では証拠収集が粗い粒度で描かれているが、実際には個々のサーバーやGPUの単位で、あるいは後にはさらに細かい単位で行われうる。
-
検証: 監査人は無作為に抽出して部分再計算やその他の確認を行い、作業負荷の正しさに関する違反を捕捉する。
-
評価と公開: 最終的な学習実行にあたる作業負荷については、追加のステップを設けられる。評価を実行し、その評価も正しさを検証する。そのうえでモデルの公開が最終承認されると、モデルの重みが非公開の内部データベースからダウンロードされ、推論専用クラスターへ移送される。このプロセスはモデルの重みの窃取という観点から極めて重大なので、慎重に設計・実行する必要がある。
2030年後半:協定後のモデルを配備する安全な推論専用クラスターが稼働する
最初のSL5推論専用クラスターが稼働し、研究開発クラスターから広く一般への提供を承認された協定後初のモデルの提供を始める。これらのクラスターは、後付け改修されたクラスターと基本的に同じ検証手法(ネットワークタップと部分再計算)を使うが、セキュリティ特性は向上している。年末までに、世界の計算資源の約40%(世界全体の約9億3,000万H100eのうち約3億7,000万H100e)が、協定後に新設されたこれらのSL5推論専用クラスターに置かれる。
また2030年末までに、米国と中国は堅牢化されたコールドストレージ施設を設け、互いのAIチップの備蓄を査察官が検証できるようにする。その規模は、想定されるどの秘密プロジェクトよりも大きく(協定の弱体化に関する補足資料に従い、米国のバンクは500万H100e、中国のバンクは50万H100e)、両者の相対的な規模は協定前の現状に近い。これらの施設は、どちらの陣営も容易に守れる場所にある。施設には検証済みのモデルの重みの備蓄も置かれる。協定が失効した場合に使用を認めることが双方にとってプラスになると米中が合意したモデル(たとえば、安全性研究に非常に役立ち、強力なセーフティケースを備えたモデル)を保管するためだ。2033年ごろには自動コーディングAI前後の能力を持つモデルが重みの備蓄として承認され、2037年には最先端に迫るモデル(トップ専門家級のAI)がコールドストレージでの重みの保管を承認される。
2031〜2036年以降:協定の改善
2031年:ハードウェアの研究開発とその他の高リスク領域に対する制限
米中協定が対処しようとする中心的な問題は、知能爆発だ。しかし、対処すべき脅威は知能爆発だけではない。AIが産業爆発や、AIハードウェアの行き過ぎた進歩、その他の危険な科学的進歩を可能にしうることも、中心的な懸念の一つだ。
AIのソフトウェアの進歩を懸念すべき理由は、『AI 2027』で示した。超人的なAI研究者が自らを引き上げて超知能に至り、私たちがそれを制御できず、その目標をアラインする方法もわからない、という事態だ。ハードウェアの行き過ぎた進歩を懸念すべき理由は、速いテイクオフのもとでは、ソフトウェアの進歩への懸念の陰に隠れる。しかしプランAの協定のもとでソフトウェアの進歩だけを減速させるなら、別途の対策がない限り、乗っ取りのリスクの大半はハードウェア主導の乗っ取りが占めることになりかねない。
ハードウェアの無制約な進歩を懸念すべき主な理由は三つある。
-
生産の爆発的拡大の影響
-
設計が改良されなくても、地球上の産業能力(たとえばロボットの数)の爆発的な拡大は懸念すべきだ。
-
既存のロボットの設計でも、新しいロボットにさらにロボットを作らせることで、途方もない数のロボットを短期間に容易に作れるようになるかもしれない。単純に考えれば、倍増にかかる期間は数か月にまで縮みうる。これは非常に速い。産業爆発の可能性については、経済に関する補足資料で詳しく論じている。
-
途方もない数のロボットは、たとえば次のような不安定化を招く事態を引き起こしうる。
-
(1)先行者に莫大な軍事的優位をもたらす(ロボット軍団という直接的な形でも、純粋な産業能力、たとえばミサイルや兵器の生産能力という形でも)。
-
(2)AIハードウェアを秘密裏に製造する(秘密の場所で、そのために必要な装置や施設をすべて一から建設することによって)。
-
-
-
不安定化を招くロボットの設計
-
新しい高度な設計、たとえば自己複製するマイクロボットやナノボット、バイオテクノロジーも懸念すべきだ。
-
生物学的な基準(そして人間が知的な設計で生物学を上回ってきた前例)を踏まえれば、恐ろしいロボットの設計が可能であることを懸念すべきだ。具体的には、倍増にかかる期間が非常に短い、自己複製するナノテクノロジーやバイオテクノロジーを懸念すべきだ。
-
ここでの中心的な懸念は、こうした設計はマクロスケールのロボットとは違って統制が難しすぎ、いったん発明されればどんな規制も破ってしまうかもしれない、という点だ。
-
-
-
不安定化を招くAI計算資源の設計
-
AIハードウェアの製造を容易にする設計上の改良も懸念すべきだ。
-
AIハードウェアの設計上の改良やパラダイムシフトによって、協定からの離反が容易になるかもしれない。ハードウェア設計のパラダイムシフトによって、AI計算資源を作るのに極めて専門的で複雑かつ集中化した製造サプライチェーンが不要になれば、秘密プロジェクトが探知されずにAI計算資源を増産することも可能になりうる。これは協定の安定性を脅かす。
-
-
同様に、生物学研究のような他の高リスクの科学領域でも、研究開発を制限したい。そのための私たちの基本的な提案は次のとおりだ。一般への提供の大部分については、推論時の拒否と監視に頼る。そのうえで、リスクの高いハードウェア研究やその他の科学研究を、相互に検証される研究所で行える専用の拠点を設けることも考えられる。そこでは、セキュリティと透明性のトレードオフについて(必ずしも同一ではない)いくつかの選択を行い、企業がハードウェアの研究開発に関する滴定ルールに従っていることを相互に検証する。そのルールも、(ソフトウェア研究と同様に)セーフティケース、個別ルール、人間による理解可能性の要件、資源の上限を組み合わせたものにできる。
高リスク領域における推論の制限、監視、拒否
高い能力を持つモデルを一般に提供することの欠点の一つは、それが危険な研究を可能にしうることだ。あるいは、違法なプロジェクトがそのモデルをAI研究の助けに使ったり、モデルの出力を直接蒸留して自らのモデルの学習に役立てたりするかもしれない。広く推論を提供しても、蒸留、違法なプロジェクトへの能力の底上げ、その他の危険な研究につながらないようにするには、出力の正しさの検証だけでなく、拒否、監視、圧縮を十分に組み合わせる必要がある。
-
拒否または能力の調整
-
コンソーシアムが一般に公開するAIは、AI研究を苦手とするものにすべきだ。不正なプロジェクトに使われにくくするため、ほかのタスクに比べてMLエンジニアリングが苦手になるよう設計することもできる。ただしこれには、分散して行われる安全性研究の加速にも不利になるという欠点がある。能力を欠かせる代わりに、堅牢な拒否によってこの目標を達成するという方法もありうる。
-
-
監視
-
推論の正しさの検証に加えて、モデル上で監視システムを動かし(能動的でなく受動的なものでおそらく十分だ)、モデルがAI研究や大規模な学習、その他の危険な研究に関与していそうかどうかを確認すべきだ。こうしたケースは、かなり確実に探知できるかもしれない。たとえば、多数のGPUにまたがる学習用のコードを含むコードベースでモデルが作業していれば、違法な使い方であることはかなり明らかだ。
-
-
圧縮
-
推論の途中経過は、原則として利用者に一切見せない。出力は、少量の上限までの要約へと最大限に圧縮する。
-
可能な限り複数の層で垂直統合し、出力だけを生成する。
-
現時点では、これらは実行可能な対策であり、広範な提供の多くを可能にすると考えているが、確信はない。蒸留の有無の試験と、危険な研究の探知は継続的に行うべきだ。
ハードウェア研究の制限
-
ハードウェア研究に関するルールの設定
-
ルールの具体的な一部として、従来型に近いロボットの設計や従来型に近いチップの設計の研究だけを認めることが考えられる。ハードウェア研究のリスクの多くは、ナノテクノロジーや格段に製造しやすいAI計算資源などにつながりかねない、不安定化を招くパラダイム転換的な科学的ブレイクスルーにあるからだ。従来型に近い設計でも、協定のもとでハードウェアやロボットを増強する利点を実現できるだけの改良の余地はまだあるかもしれない。とはいえ、改良の余地が十分でなければ、ハードウェア研究の制限をもっと緩めるほうが賢明かもしれない。
-
ハードウェアについても、投入量と進歩の関係ははっきりしないかもしれない。計算資源とソフトウェアの進歩の関係についても、私たちは非常に不確かなのと同じだ。それでも同じ期待を持つことはできる。投入量(たとえばエネルギーの上限、材料の上限、研究労働力の上限など)を桁単位で大幅に削減する形で運用すれば、精度は粗くとも実施しやすい方法で、ハードウェアの進歩のペースを安全と考えられる水準まで段階的に落とせるかもしれない。
-
-
ハードウェア研究に関するルールの執行
-
ハードウェア研究の滴定ルールを定めたら、それが守られていることを検証する方法が必要になる。一つの方法は、ソフトウェアの執行と同じ大枠の手法を使うことだ。つまり、ハードウェア研究の作業を個別に(あるいは自動化されたホワイトリスト/ブラックリストのプロセスで)承認し、作業をサブステップに分けて証拠を集め、無作為に抽出したサンプルについて順守を確認する。ハードウェアの場合、この手法には一つ問題がある。たとえば化学実験では、高い再現性を得るのがはるかに難しそうなのだ。現実世界の二つの研究所は、AIチップほど均質ではない。これはもっともらしい否認の余地と違反の余地を生む。したがって、すべてについて再現に基づく手法を取るわけにはおそらくいかない。とはいえ、ハードウェア研究の中にも再現可能な部分は多くあるかもしれない。
-
もう一つの方法として、多くのものはマクロスケールなので、信頼できる監視の仕組みですべてを直接監視できるかもしれない。もっとも、信頼できる監視の仕組みを作るのは難しいかもしれない。その場合は代わりに、人間がすべての記録から無作為に抽出したサンプルを調べ、無作為抽出による探知確率の有利なスケーリングの恩恵を受ける、という方法も考えられる。
-
全体として、ハードウェア研究のルールをどう検証するかについて私たちは非常に不確かで、ソフトウェアより難しいかもしれないと現時点では感じている(ただ、より容易である可能性も十分にあると考えている)。とはいえ、放っておいた場合のスピードとリスクの水準、したがって全体として必要な減速の度合いは、おそらく小さいと考えている。
2032年:ロボットと計算資源のキャップ・アンド・トレード
先に述べたとおり、地球上のロボットとAIチップの数が爆発的に増えて協定の安定性を脅かす事態は止めたい。私たちの現時点での素朴なモデル化によれば、放っておけば、現在のハードウェア設計のままでも、プランAのシナリオで到達すると予測するAIとロボットの能力によって、AIチップやロボットを追加生産する素のコストと、その経済的価値とのあいだに巨大な開きが生じる。放っておけば、これが再投資のスパイラルと、非常に短い倍増期間につながると考えている。
プランAでは、2032年から上限を設け、地球上のロボットとAIチップの数の倍増期間を6か月前後に制限することを提案する。キャップ・アンド・トレード規制によってこれを行い、民間企業は各期間の有限なロボットとAIチップの生産許可を入札で取得する必要がある。この上限は、ロボットについては産業生産での有用性、AI計算資源についてはAIの作業負荷での有用性という単位で設定すべきだ。どちらも測定は難しく、あいまいになりうる。ロボットの場合は特に、タスクや形状の違いをまたいで測る必要があるし、ロボットとより従来型の機械との境界もはっきりしない。それでも、さまざまなロボットやハードウェアの設計について、これらをそれなりにうまく測定し、それに応じてキャップ・アンド・トレードの上限を割り当てることは可能だと考えている。
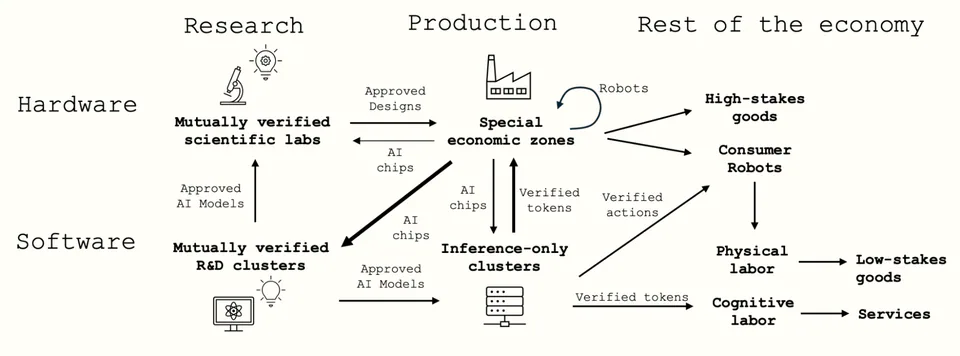
ロボットやAI計算資源の生産が世界中のいたるところで行われるなら、キャップ・アンド・トレードの許可ルールを実際に執行するのは非常に難しいかもしれない。そこで、新たに構築される産業能力とロボットを経済特区(SEZ)に集中させ、キャップ・アンド・トレードのルールを執行しやすくすることを提案する。
キャップ・アンド・トレードのルールをどう執行するか
これについての私たちの提案は、構築された産業能力とロボットのすべてを経済特区に集中させ、執行とそれに伴う監視をこれらの制限区域に集約し、経済のそれ以外の部分はハードウェアの検証による確認の対象にしない、というものだ。
経済特区では、ハードウェア研究の手法、あるいは推論専用とソフトウェアの研究開発の手法と同様の、大枠の検証手法を取れる。生産を離散的なステップに分け、それを人間が(信頼できるAIによる監視の支援も受けながら)無作為に、手作業で監査する。
経済のそれ以外の部分は検証しないままでよいが、ロボット、電力、その他ハードウェア生産の投入になりうるものには、おそらく上限を設けるべきだ。この上限が低ければ、経済特区の外での監視は最小限で済む。とはいえ、人々は分散したロボットを強く望むので、上限を十分に低く保つのはコストがかかりすぎるかもしれない、と私たちは推測している。そのため、分散したロボットについて信頼できる位置情報の把握を行い、場合によっては無作為の査察を実施するのがよいかもしれない。分散した計算資源が多くなりすぎるのを避けるため、堅牢なエッジ計算資源の検証が実現するまでは、ロボットが持つ検証されていないエッジ計算資源はごくわずかにとどめ、主にクラウド経由で、監視され(理想的にはプライバシーを守るためAIによって自動化され)、検証された推論専用クラスターからサービスを受けるようにすることも提案する。
同じキャップ・アンド・トレードの原則は、無制限の量では不安定化を招くが、少ない量なら安全でありうるその他の製品やサービスにも拡大される。主な例は二つある。エッジ計算資源を搭載した製品と、監視されない推論だ。エッジ計算資源に特に頼りそうなものには、自動運転車や消費者向け計算資源がある。一方、監視されない推論は、軍事作戦を行う政府にとって特に価値がありそうだ。キャップ・アンド・トレードのもとでは、協定の安定性を保つ、社会全体として安全な上限の範囲内で、これらの活動を合法として認められる。そのうえで、個人、企業、政府が互いに入札して権利を得る、許可の市場を設けられる。
検証されていないエッジ計算資源の上限
検証されていないエッジ計算資源が世界に存在することを、実効H100e換算で3,000万まで認める上限を提案する。協定前から存在するものが実効H100e換算で2,500万あると推定されるので、検証されていない新規生産に使えるクレジットは500万しかない。 十分なエッジ検証措置を備えた計算資源は、上限の対象から除外できる。
無制限に認めれば、消費者向け機器、自動運転車、ロボットに搭載されたエッジ計算資源は、違法なプロジェクトに使われうる計算資源の相当なストックになりかねない。協定前の消費者向け・エッジの計算資源には、AIに関係する計算資源もある程度含まれるだろう(たとえばGPUを1枚持つ愛好家や、自動運転車のチップ)。大半はAIに関係しない計算資源(AIの作業負荷ではあまり役に立たないチップ)だが、それでも数は非常に多い。スマートフォンは数百億台あり、1台あたりAIの作業負荷ではH100の0.1〜1%程度の有用性しかないが、それでも合計すれば数千万H100相当、つまり世界のAIに関係する計算資源全体の約10%になる。計算資源に関する補足資料では、これを約2,500万**実効**H100eと推定している。
これは、最先端のAIの作業負荷での有用性をより良くモデル化したうえで、その時点でより正確に推定すべきだ。消費者向け計算資源の有用性が私たちの推定より高いと判明すれば、大量の消費者向け計算資源がかき集められて秘密プロジェクトに使われる事態を避けることがより重要になる。その場合は、たとえば計算資源の買い戻しを優先度の高い取り組みとして行うことが正当化されるかもしれない。
私たちが提案する上限は、許可のコストを避けるための「エッジ検証」(つまり本質的には堅牢なハードウェアの仕組み)のイノベーションを急速に促すと見込んでいる。ローカルでのAI能力が低い安価なスマートフォンはたくさん出回る一方、ローカル、つまり「エッジ」のAI計算資源を大量に持つスマートフォンやその他の消費者向け機器は、当初は非常に高価になるが、禁止する必要はない、と私たちは予測している。数年後には堅牢なエッジ検証が実現し、たとえばコードと重みをハードコードすることで、強力なエッジ計算資源も安価に(許可なしで)使えるようになるだろう。上限は、秘密プロジェクトを目に見えて加速させる(あるいは悪意ある主体にあまりに強力な武器を与える)には、容易に気づかれるほどの割合の消費者向け計算資源を転用しなければならない水準に設定される。少なくともプランAの初期には、AIにも転用できる高性能なゲーム用GPUを持ちたければ割増料金を払わなければならない。残念だが、おそらく避けられない現実だ(誰もが持てるようにすると、相当数をかき集めて不正な計算クラスターに回すことが容易になりすぎるからだ)。経済学の言葉で言えば、検証されていないエッジ計算資源には大きな負の外部性(秘密プロジェクトに使われるリスク)が伴う。
検証されていない消費者向け計算資源の上限に加えて、単体での販売を認める消費者向け計算資源について、一定の実効H100eの閾値(たとえば演算性能、帯域幅、メモリ容量、ネットワーク速度の具体的な閾値)を設けることが望ましいかもしれない(チップを秘密プロジェクトにかき集める難しさ、ひいては探知のされやすさが、演算性能よりもチップの絶対数に強く比例する限りにおいてだ)。さらに、位置追跡の措置を義務づける計算資源の区分を設けてもよいかもしれない(秘密プロジェクトによる使用を探知しやすくするため)。
研究の滴定と生産の上限を合わせると、全体像は次のようになる。
2033年:セキュリティの向上
2033年までに、ハードウェアのセキュリティに加え、データセンター、検証体制、能力に関するより全般的なセキュリティ特性も大きく向上していると見込んでいる。2033年末には、世界の計算資源の約99.9%が協定後の計算資源になる。つまり、協定前のクラスターと計算資源の電源をすべて落とし、計算資源の大部分を一から建設された新しい、より安全な場所に置くことは造作もない。さらに2034年末には、存在する計算資源の約90%が2033年か2034年に生産されたものになる。したがって、それまでに実現したセキュリティの向上は、わずか1〜2年で広く行き渡りうる。製造施設(ファブ)についても同様の力学が働く。
ここで何が可能になるかについての私たちの不確実性は大きいが、主なアイデアには次のようなものがある。
-
サイドチャネル対策とエアギャップの特性が極めて優れた、一から建設されたデータセンター。
-
推論や研究開発の作業負荷全般に向けたソフトウェアスタックの、(再現性のための)標準化とセキュリティ向上の大きな進展。
-
相互監視の措置を備えて一から建設された、新たな計算資源の製造施設(ファブ)。攻撃対象領域を最小化するため、サプライチェーンと、場合によっては製造したチップを収める最終的な集中型データセンターとも同じ場所に置く。
-
特にアーキテクチャの変更や数値形式による、ハードウェアとソフトウェアの相互依存の始まり。そうなれば、こうしたパラダイムでの最適化や進歩は、協定前の計算資源には応用しにくくなる。
-
検証体制、特に研究開発用データセンターにおけるログ記録・証拠収集の粒度の向上。オーバーヘッドを減らすため、ログ記録の技術は、バックエンドのネットワーク上の極めて高帯域なデータ経路に対応したものにする。
-
より堅牢な信頼できる実行環境、セキュアブート、暗号化、再現性などによる、ハードウェアのセキュリティ特性の全般的な向上。これらは再計算サーバーにとって特に重要だ。ハードウェアをある程度標準化することも、再現性に役立つかもしれない。
-
特定の作業負荷をデバイス上で自動的に検証するための特殊なハードウェア設計。特に、一部のチップに重みをハードコードし、推論専用であることを検証する。これは「エッジ検証」に特に役立ち、秘密プロジェクトに使われるリスクなしに、消費者向け製品により多くのAI計算資源を搭載できるようになるかもしれない。
2034年:検証の改善
2030年代を通じて、世界のAI計算資源の総量は爆発的に増える。注目すべき重要な力学の一つは、検証下の計算資源の総量が増えるにつれて、検証の負担(より高いカバレッジの必要性)も増すことだ。プランAでは、協定の安定性とのトレードオフに関わる別の理由から、ハードウェアの大幅な増強(検証可能な範囲にとどまるよう、キャップ・アンド・トレード体制で上限を設ける)を予測し、推奨もしている(ハードウェアは違法なプロジェクトに漏れにくいので、合法プロジェクトの取れる選択肢を相対的に広げる)。
検証の保証曲線は、無視できない規模の不正な社内配備があれば、高い確率で探知できる水準まで改善する必要がある。2034年に、最先端の各GPU(それぞれ約100H100e。つまり約100H100e時のパケット)から1時間に1パケットを収集し、再計算の予算が1%だとする。付録の計算によれば、この場合、どんな不正な社内配備でも、承認されていない作業が約46,000H100e時に積み上がった時点で、検証する側は99%の信頼度でそれを捕捉する。したがって、1万H100eの配備を継続すれば約4.6時間以内に、1,000H100eなら約46時間以内に探知される、という具合だ。
これは野心的な検証の規模であり、検証体制の完全性に関する極めて優れたセキュリティにも依存している。特にAIの支援があれば、ここまでスケールさせることは可能だと考えているが、確信はない。検証の負担をここまで増やさないよう、計算資源の上限をもっと低く設定すべきだという可能性も十分にあると考えている。
2035年:データセンターを海上へ移す
継続する最大のリスクの一つは、協定が崩壊して各主体が開発競争に戻ることだ。計算資源の規模は大幅に拡大したが、(安全規制のために)それは能力の進歩に変えられていない。そのため、それまでにアラインメントが進展していても、開発競争への回帰は当初の現状よりさらに危険になりうる。今度は事態がより速く進むからだ。これが、協定が崩壊した場合に協定前の計算資源の水準、あるいはそれより小さな規模に戻すための措置を講じておく動機になる。
ロボットとAIの労働力のおかげで、公海上に新たなデータセンターの処理能力を構築するための工学的・物流的なコストは相対的に十分低くなり、2035年ごろにはそれに見合う価値が出ると考えている。海上のデータセンターは、特定の主体が守るのははるかに難しく、協定が崩壊した場合に破壊してもはるかに事態をエスカレートさせにくいからだ。これは、協定の安定性を高めるための、計算資源の相互確証破壊に向けた意図的な措置だ。
2036年以降:高度な堅牢性の向上
プランAも後半に入ると、セキュリティ、検証、協定の安定性の面でどのような堅牢性の向上が可能になるかについて、私たちの不確実性はますます大きくなる。極めて野心的なことも可能になるかもしれない。思いつくままに挙げると、次のようなものだ。
-
大部分、あるいは全体が形式検証されるよう、ソフトウェアスタックを完全に書き直す。
-
想定されるどの秘密の主体をも圧倒する資源を使い、検証の仕組みやセキュリティ措置に対して大規模なレッドチーミングを行う。
-
相互に合意した対称的な方法で、AIとロボットの労働力を使って秘密プロジェクトの可能性を突き止める。たとえば秘密プロジェクトに関する補足資料で検討した「AIの特効薬」、つまり信頼できる嘘発見器、プライバシーを保護するAIの検証、極めて徹底した産業の検証だ。
付録:パケットベースの検証
この付録では、部分再計算に用いる無作為抽出の計算をたどり、不正な作業負荷の探知でなぜそれほど有利にスケールするのかを示す。この分析では、作業負荷のパケットが完全に再現可能であるという重要な単純化の仮定を置く。
A.1 設定
この分析では、検証をパケットの流れに対する抽出の問題として扱う。パケットとは、検証する側が再計算できる、再現可能な計算の単位だ。その入力、命令、出力はすべて、証拠収集の地点(たとえばネットワークタップ)で収集される。その計算が実際に何であるか(1回の順伝播なのか、1回の学習バッチなのか)は、以下の計算に影響しない。さらに置く単純化の仮定は次のとおりだ。
-
サイズの均一性。 どのパケットも、同じ量の元の計算を表す。均一でないパケットでも、重み付き抽出の議論を使えば同じように扱え、定性的な結果は変わらない。
-
独立した無作為抽出。 検証する側は、各パケットを独立に、同じ確率で監査する。実際には非復元抽出を行うことになる。
検証する側の母集団を、何らかのパケットの集まりとする。それは一つの学習実行かもしれないし、ある月に協定の下で動いているすべての作業負荷のすべてのパケットかもしれないし、一つのクラスターの通信かもしれない。 をその母集団に含まれるパケットの総数、 をパケットのサイズ(各パケットが母集団に占める割合)、 を再計算の予算(検証する側が再計算にかけられる、母集団に対する割合)、 を実際に監査されるパケットの数とする。
A.2 無作為抽出による探知
この節の探知に関する計算は独自に導いたものだが、Rinbergら(2025年)の分析と一致している。攻撃者が 個のパケットをすり替え、それぞれのパケットで申告された計算を自分の無許可の計算に置き換えるとする。
を、偽のパケットの割合とする。検証する側が各パケットを独立に確率 で監査するなら、 個の偽のパケットがどれも監査されない確率は、厳密には
となる。 が小さく、 がそこそこ大きい場合、これは捕捉される偽パケットの数についてのポアソン分布でよく近似できる。その平均は で、
となる。したがって、攻撃を捕捉する確率(攻撃の規模 における探知の信頼度)は
となる。スケーリングを最もすっきり表せるので、以下では一貫してポアソンの形を使う。この近似が崩れるのは、 が1に近づくか、 が一桁の場合だけだ。これはちょうど、無作為抽出が何の役にも立たなくなる場合でもある(§A.3の最後の議論を参照)。
A.3 保証曲線
保証曲線はカバレッジと信頼度で決まる。どちらも、探知されずに見逃すことを許容する偽パケットの割合の上限 で表せる。
-
カバレッジ 。作業負荷のうち、正当だと主張する割合。
-
信頼度 。その閾値以上の実際の違反があれば捕捉できる確率。
信頼度の式は、§A.2の を、閾値 で評価したものだ。再計算の予算は を通じて効いてくるので、監査するパケットが増えるほど曲線は外側に押し出される。
いくつかの検証予算(つまり のさまざまな値)について、信頼度をカバレッジに対してプロットすると次のようになる。
これらの曲線は、 のさまざまな値における信頼度とカバレッジの関係を示している。 が大きいほど保証水準は高くなる(曲線が右に移る)。 なので、曲線を高い側へ移すには、(1)再計算の予算 を増やすか、(2)パケットのサイズ を小さくすればよい。
ポアソン近似が崩れるとき
積 (再計算の予算と偽パケットの数の積)だけで、99%の捕捉確率が得られるかどうかが決まる。この積が約4.6を超えればよい。
このことから、極端な場合を考えると示唆に富む。サーバー1時間あたり1パケットを抽出し、 サーバー時だとする。攻撃も偽のパケット1個だけだとする(ずっと長い、たとえば1年に及ぶ作業負荷の中に、不正なサーバー時が1時間分だけ紛れ込んでいる)。 なら、ポアソン近似では が必要になるが、これは意味をなさない。 は割合であり、上限は1だからだ(パケットの100%を超えて再計算することはできない)。
これがポアソン近似の崩れる領域であり、正しい式は非復元抽出の厳密な式になる。
なら、これは となる。偽のパケット1個を99%の信頼度で捕捉するには、全パケットの99%を再計算する必要がある。つまり、抽出は事実上あきらめて完全な検証をしていることになる。周囲の作業負荷の大きさは関係ない。 の確率で表が出るように偏ったコインを1回投げているだけだ。
ポアソンの式は、 が少なくとも数十あり、 が小さい(たとえば10%未満)場合には正確だ。 なら、99%で捕捉するのに必要な予算は厳密には4.5%で、ポアソンでは4.6%だから、ほぼ同じだ。 なら、厳密な答えは0.459%で、ポアソンでは0.46%だ。 が大きくなるほど両者はよく一致する。食い違うのは が小さい隅の領域だけで、そこはちょうど無作為抽出が役に立たなくなり、すべてを再計算しなければならなくなる領域でもある。
したがって実務上の教訓はこうだ。少なくとも数十のパケットにまたがる攻撃を捕捉するのであれば、無作為抽出は大きな効果を発揮する。それより小さな攻撃を捕捉するには、パケットを小さくし( を減らし)、同じ量の偽の計算作業がより多くのパケットにまたがるようにすればよい。
A.4 計算例
A.4.1 100兆トークンの学習実行に仕込まれた10万トークンのバックドア
分散データ並列を使った トークン(100兆)の学習実行を考える。サーバーラック間のネットワークタップが、各勾配ステップ(入力バッチ、勾配の更新、その結果としてのチェックポイントの更新)をすべて記録するので、各勾配ステップが1パケットになる。攻撃者は、仕様外のトークン 個(10万)でひそかに学習させ、バックドアを仕込みたい。
| 量 | 記号 | 値 |
| --- | --- | --- |
| 学習トークン数 | | |
| 攻撃の規模(バックドア) | | |
| バッチサイズ | | 設計上の選択 |
| パケット数 | | |
| パケットのサイズ | | |
| 偽の割合 | | |
99.9%の探知の信頼度を得るには 、つまり が必要だ。すると、学習実行に対する割合で表した再計算のコストは次のようになる。
| バッチサイズ | | 再計算のコスト |
| ---: | ---: | ---: |
| 10,000 | | 70% |
| 1,000 | | 7% |
| 100 | | 0.7% |
| 10 | | 0.07% |
同じ信頼度であれば、バッチを 小さくすると、必要な再計算のコストは 減る(Cが1に近い値では、非復元抽出によってこれより良い結果になる点は無視している)。パケットのサイズを小さくする実務上のレバーは二つある。(1)バッチを小さくすること(学習実行あたりの勾配ステップを増やす)と、(2)バッチ内の途中の計算(たとえば個々の順伝播・逆伝播)を追跡するバッチ未満の単位でのログ記録だ。後者には、サーバーラック内、あるいはGPUそのものの内部に証拠収集装置が必要になるかもしれない。
A.4.2 1,000億H100eの検証済み研究開発における不正な計算資源使用の上限
2034年:検証の改善の節では、1,000億H100eの検証済み研究開発用計算資源全体について、検証する側の再計算予算が1%の場合に、どのような不正な社内配備の探知確率が低くなるかを検討している。不正な社内配備は、最先端のモデルや研究開発クラスターのその他の部分に内部からアクセスできるため、外部の違法なプロジェクトより恐ろしい可能性がある。探知は、検証システムがその偽のパケットを捕捉できるかどうかにかかっている。以下の計算は、§A.3の保証曲線を具体的な値に置き換えるものだ。
から出発し、 と を代入すると、 が打ち消し合い、探知確率は次のようになる。
この形では、探知確率は再計算の予算 と、攻撃者が生成する偽パケットの絶対数 の関数になる。
99%の信頼度には が必要だ。したがって攻撃者は、偽のパケットを
個積み上げた時点で、99%の信頼度で捕捉される。 なら461パケットで、これは母集団の大きさにも、作業が作業負荷間にどう分散しているかにも依存しない。これにパケットのサイズ を掛けると、不正な計算作業の累積量についての上限に換算できる。
2034年の節の運用設定を考えよう。そこでは検証する側が、最先端の各GPU(2034年にはそれぞれ約100H100e)から1時間に1パケットを収集する。すると H100e時となり、 なら
となる。検証済みの母集団の中で、承認されていない計算作業を約4万6,000H100e時を超えて積み上げた不正な社内配備は、ペースや分散のしかたにかかわらず、99%の信頼度で捕捉される。不正な作業の累積量の上限は に比例して増える。代表的な運用条件をいくつか示す。
| パケットのサイズ | 予算 | 探知されない不正な作業の最大量 |
| --- | --- | --- |
| 100H100e時 | 1% | 46,000H100e時 |
| 100H100e時 | 0.1% | 460,000H100e時 |
| 10H100e時 | 1% | 4,600H100e時 |
| 1H100e時 | 1% | 460H100e時 |
経済的なコストの大きさやその他のトレードオフはさまざまで、それについては本文で論じる。基準として、推論と学習の両方について、コストの非常に高い検証手段(たとえば、検証の研究開発を急ぐあいだ計算資源を検証付きで複数年停止し、安全な形で再構築する)なら可能だと、90%を超える確信を持っている。
秘密プロジェクトが協定を脅かしたり、AI開発競争に勝ったりできる可能性がどれほどあるかは、秘密プロジェクトに関する補足資料で論じている。
少なくとも一方の陣営が、相手が大規模な秘密データセンターを持ち、それを申告せず、電源が切れていることの検証も認めていないのではないか、という大きな不確実性を抱えている限り、これでさえ実行は難しいかもしれない。
現時点ですぐに実行できるもう一つの現実的な選択肢は、データセンターのバックエンドのネットワークを(大部分)外すことだ。これなら多くの推論を継続でき(コストが低い)、しかしAI開発を確実に減速させられないかもしれない(推論は、別の場所で行われる連合学習の学習実行に使うデータを得るためのロールアウトとして使われうる)。
そう考える主な理由は、検証する側は違反を一つ捕捉すればよいのに対し、証明する側は秘密の計算をすべて隠しおおせなければならないことだ。たとえば、無作為抽出による部分再計算が有利にスケールする背景にはこれがある。これについては付録で検討する。
つまり、計算資源を長期間停止させる必要がない形で。
プランAのシナリオ(2029年のチップの相互申告と査察が実施され、チップ追跡に関する私たちの提言が有能に実行された場合)を前提とすると、秘密プロジェクトに関する補足資料の推定では、有能に実行された中国の転用工作で確保できるのは、世界の計算資源の中央値で0.51%(80%信頼区間:0.11%〜1.4%)だ。つまり、「闇の計算資源」の合計が、AIに関係する世界の計算資源の1%未満にとどまる確率はおよそ80%になる。
テイクオフ期(自動コーディングAIから超知能までのマイルストーン)における進歩が、計算資源にどれほど左右されるかは不確かだ。これを(単純化のため)計算資源が10分の1になったらどれだけ遅くなるかで操作的に定義すると、2〜6倍遅くなる範囲のどこかである可能性が最も高いと考えている(How much slower does takeoff go with 10x less compute?と、秘密プロジェクトに関する補足資料の対応するモデルを参照)。プランAのシナリオで仮想的な秘密プロジェクトがたどると予想される具体的な軌跡(合法プロジェクトから漏れるアルゴリズムの進歩の影響も含む)は、秘密プロジェクトに関する補足資料ではるかに丁寧にモデル化・説明している。
「存在を把握している」とは、情報機関が少なくとも計算資源が存在することと、誰が保有しているかを高い確信を持って知っている、という意味だ。正確な所在まで知っている必要は必ずしもない(それも役に立つが)。最初の二つの条件がそろえば、もっともらしい否認の余地を残したまま、将来の相互のチップ申告から計算資源を除外することは不可能になるはずだからだ。
言い換えれば、この措置がなければ、ある主体は次のような戦略を取るかもしれない。発覚せずに済む範囲で最大の秘密プロジェクトを構築し、その秘密プロジェクトで勝てると確信できるだけのアラインメントの進展が得られるまで待つ。その時点で協定から離脱し、協定後の計算資源を破壊すれば、自らの秘密プロジェクトが世界の首位のプロジェクトになり、高い確率で成功できる。敵対者が自らの秘密プロジェクトを圧倒するコールドストレージの計算資源バンクを持っていれば、この戦略はもはや有効でなくなる可能性が高い。
スマートフォンは数百億台あり、1台あたりAIの作業負荷ではH100の0.1〜1%程度の有用性しかないが、それでも合計すれば数千万H100相当、つまり世界のAIに関係する計算資源全体の約10%になる。
つまり、ローカルでのAI能力が低い安価なスマートフォンはたくさん出回る一方、ローカル、つまり「エッジ」のAI計算資源を大量に持つスマートフォンやその他の消費者向け機器は、堅牢なエッジ検証が実現するまでは当初非常に高価になる。
たとえば、ネットワークに関する技術的な詳細(光の速度、帯域幅、周波数など)。
たとえば、権限移譲のリスクが10%を下回ったと考えているとしよう。その場合、ある期間に検証済みの計算資源の1%を使った違反が破滅的な結果を招くリスクが10%を超えるなら(つまり、私たちの曲線が信頼度90%・カバレッジ99%の点を下回るなら)、権限移譲によって協定から抜け出したいと考えるだろう。
たとえば、開示をエアギャップの内側で行う。関連するケースの大半では、これで許容できるはずだ。
AIの研究開発が再開される見通しも、AIへの投資を継続させるうえで重要だ。
これについては能力スケーリング戦略に関する補足資料で詳しく検討している。ここには構図を複雑にする、より深いニュアンスもいくつかある。たとえば、透明性に関する補足資料で論じたように、どの透明性体制が敷かれているかだ。
AI研究における研究開発効率のスパイラルのこと。より賢いAI → より良い研究 → より賢いAIというフィードバックループが、私たちが制御もアラインもできないAIに至るまで続き、制御やアラインメントに投資するために減速すると競争に負けるので、企業も国も多極的な罠に閉じ込められる。そこから抜け出す道は、検証された協調だ。
AIに関係する計算資源は、総処理性能(TPP)が4,000以上、かつ性能密度(PD = TPP / ダイサイズ)が4以上を達成できる計算ユニットと定義する。この定義は、2021年時点でNVIDIAの最先端チップだったA100 SXM GPUをわずかに下回る水準に設定している。
これらの量はいずれも、作業が個々の作業負荷にどう分けられているかには依存しない点に注意してほしい。重要なのは、検証する側がどの母集団から抽出するかだ。100の異なる学習実行が同時に進んでいて、検証する側がそのすべてのパケットから一様に無作為抽出するなら、以下の計算における「作業負荷」は100すべてを合わせたものになる。計算例(§A.4.1)で作業負荷ごとに考えているのは、一つの具体的な攻撃について論じるための便宜にすぎない。