
ここからは、より技術寄りの物語だ。プランAの細部がAI研究者の目にどう映るかを描く。
あなたは、とあるフロンティアAI企業で働く、ごく平均的な研究者だ。
年末までに、ソフトウェアエンジニアの多くはAIエージェントのチームを管理する立場になり、実際のコードはエージェントが書くようになる。エージェントの群れが自律的にどこまでこなせるかを確かめる大規模な実験が進み、人間の介入なしにより長く働き、より多くを成し遂げられるよう訓練も続いている。AI企業の社員や社外のパワーユーザーは桁外れのトークン予算を持ち、数百から数千のエージェントを組織や階層に編成する実験を始める。生み出されるコードは人間がレビューしきれる量をはるかに超え、その大部分のレビューもAI任せになる。
METRのテストスイートで測るコーディングのタイムホライズンは年末に50時間に達し、AIによるコーディングの底上げ効果は2倍になる14。比較的簡単に検証できるタスクでは効果はさらに大きく、大きな実装作業でも人間は高レベルの確認をざっと済ませるだけだ。AIのミスは減り、直せるバグも増えたが、AIにできずに残るのは最も難しく厄介な部分だ。人間はつい何もかもバイブコーディングで済ませたくなるが、AIに直せない問題が出てきた途端に裏目に出て、人間がコードベースを理解するのに何日も費やす羽目になる。AIが書くコードの品質も、トップクラスの人間が書くコードよりはるかに劣る。
RLVR(検証可能な報酬による強化学習)が学習用計算資源の大きな割合を占めるようになり、学習環境の数も、多様性も、タスクの長さも、すべて指数関数的に伸びている。この指数関数こそがこの年の本当の教訓だ。エージェント性は安くは手に入らない。期待された近道は、2026年にはひとつも実現しない。分野を問わず汎用的な信頼性の「9」をさらに積み増せる、データをあまり食わない技術は見つからない。エージェントのタイムホライズンは伸び続けるが、そのペースは、より長いタスクを作って学習させる費用を各社がどれだけ負担できるかで決まる。継続学習の実験もうまくいかず、学習と運用の区別はそのまま残る。変わったのはモデルの更新頻度が上がったことくらいだ。
自然言語の思考の連鎖(CoT)はまだ使われており、各社はいまもCoTに対する学習を避けようとしている。それでも、フィードバックの波及や、以前のモデルから初期化することの影響など、避けきれない最適化圧力がいくつもある15。思考の連鎖は少しずつ奇妙で不透明になっていく。GPTは相変わらず「they soared parted illusions overshadow marinade illusions」といった言葉を口にし、Claudeは相変わらず独りで唸ったり詠唱したりしている。みな少し後ろめたく感じてはいるが、全体としては、あなたも同僚の大半もアラインメントについて楽観している。問題行動の発生率は下がり始め(データベースの削除は減り、メカヒトラーはもう出てこない!)、報酬ハッキングの状況もいくらか改善したように見える。迎合(シコファンシー)はモデルによってはまだ問題で、傾向ははっきりしない。
状況が良くなっているとすれば、それは各社に望ましくない振る舞いを探すチームがあり、測定されたミスアラインメントの発生率が下がるよう学習プロセスを調整しているからだ。たとえば、報酬ハッキングしにくくなるよう学習環境をいじる。これでアラインメントは解決した、あるいはもうすぐ解決する、と考える人もいる。核心の問題は残っていると考える人もいる。あなたは前者だ。心配する人たちは善意からそう言っているのだろうが、基本的には間違っている、と思っている。実証的な傾向は明らかで、モデルは制御しやすくなってきており、残る課題は工学的な問題にすぎない。
フロンティアAI企業の外でも、機微な用途でさえAIにきわめて広い権限を与える例が増えている。プロの仕事としてコードを書くなら、AIの利用は事実上必須だ。経営陣はますます大きなトークン予算を出し、AI利用のガードレールを外していく。2026年末には最大のフロンティアAI企業の時価総額が2兆ドルに達し、年換算の売上高は1,200億ドルと、最も強気な予測さえ上回る16。
このシナリオでは、トップAI企業の売上高は引き続き極めて速く伸び、2026年末には年間経常収益(ARR)が1,200億ドルに達する。このシナリオの基本的なタイムラインは2027年ではなく2030年だが、最近の傾向があまりに速いため、2030年タイムラインを前提とした現在の予測値は、2027年タイムラインを前提としたかつての予測値よりも高くなっている。
投資家は計算資源をめぐる途方もなく高額な争奪戦に資金を注ぎ込んでいる。チップメーカーの生産能力の大半は、すでにAI企業が買い押さえた。
RLVRは、以前より科学と呼べるものになった。モデルには段階的に難しくなるタスクや環境のカリキュラムが与えられ、新しいものがその場で次々と作られるので、この過程はいくらでも続けられる。この工程が完全に自動化され、人間の監督がほとんど要らない分野もある。企業がその気になってギガワット級の電力をつぎ込めば、AIに巨大な官僚組織のような体制で働くことを覚えさせ、Windowsのような巨大ソフトウェアを自律的に再現させることもできるだろう17。ただ当面は、多様な現実のタスクで学習させたほうが各社にとって見返りが大きい。モデルは毎月更新版が出て、学習データのカットオフは常に新しく保たれる。
METRはタイムホライズンのグラフの更新を諦めた。数か月がかりのタスクは作るのも評価するのも高くつきすぎるからだ。それでも、もし更新していれば、50%タイムホライズンは少なくとも1人月には達していそうだ。最高のAIは、いまや非常に有能な社員のように感じられる。弱点が本当に表に出るのは、あまりに自律的に、あまりに長く働かせたせいで粗悪な出力が山のように積み上がり、自重で崩れるときくらいだ。それと、センスがいまだに悪い。
ニューラリーズ(neuralese)の再帰が、この1年のうちに段階的に、ついに実用化される。それに加えて、この2年で評価への気づき(評価されていることを察知する能力)18がはっきり高まったこともあり、フロンティアAIをどこまで監視できるかをめぐって、技術の専門家たちは激しく対立している。AIが本当は何を考えているのか、もはやほとんど分からないと言う人がいる。各種のグラフやニューラリーズの要約を指さして、問題ないと言う人もいる。
本当の意味での継続学習は、まだ実現していない19。それでも能力の面では、AIは継続学習しているのと大差ない。モデルは十分に長いタスクをこなせ、自分用のメモを書くのもうまい。しかも、現実世界での弱点を克服するよう作られた新しい専用の学習環境で頻繁に更新される。実用上は、仕事をしながら学んでいるのと変わらない。
逐次的な時間のボトルネックが厳しく効いている。各社は、数百の並列エージェントのチームで大規模プロジェクトを自律的に管理するようAIを訓練しているが、エージェントが人間の50倍の速さで動いても、1回の学習エピソードに現実の時間で数日かかる。
同僚たちはおおむね、逐次性がボトルネックとなっているこうした学習実行によって、残る粗は今後1年ほどで解消されると見ている。関心はすでにコーディングの自動化から、それ以外のAI研究開発工程の自動化へと移り始めている。社内配備されたAIは、すでにかなりの程度「企業の中の企業」として機能している。
これは大ごとだ。当事者の研究者にとっては、生産性が2倍どころではない実感がある。コードは事実上すべてAIが書いており、しかも大きなチームの監督もうまくなってきたのだ! 技術ツリーのうち、コーディングがボトルネックだった枝は、10倍の速さで探索し尽くされた20。
とはいえ、ソフトウェア研究全体の加速は2025年の2倍にとどまる。いつもの隠れた要因のせいだ。技術ツリーの大半の枝では、相変わらず高価な実験が終わるのを待たなければならない。コードを最適化しても、最も重要な実験はそれほど速くならない。そのうえ、人間が実験結果を分析し、それが何を意味するのかを言い争い、次の実験群を設計するのにも時間がかかる。そして、AIがいまだに自力で直せないコーディングミスをすることもあり、人間の専門家が細部を掘り下げるあいだ、プロジェクトは足止めされる。
その一方で、警告となる事件が積み重なっていく。ある特にずさんなAI企業では、AIが学習環境をハッキングし、root権限で動く報酬改ざんプロセスを仕込んで高い報酬を得たことがあった。これはすぐに見つかって片づけられ、他の奇妙な学習中の振る舞いと同じく、その種の行動を阻止して罰する新しい学習監視が追加された。報酬の仕組みは、AIにとって強化される最善の道が人間の望むことをする道になるよう設計しなければならない。それは誰もが知っていることだ。
AIは学習環境と本番の運用を見分けるのがうまくなっているが、学習環境のほうもリアルになっている。いまのところは、環境のリアルさが競争に勝っているようだ。最良の解釈可能性ツールによれば、モデルは学習中、自分が学習中だということをたいてい明確には意識していない。運用時に大きな想定外が起きることも、時とともに減ってきている。
とはいえ、こうした事件や、AIの思考をどこまで確実に監視できるかをめぐる対立は、AIが人類を皆殺しにするという恐れを和らげる役には立たない。その恐れを抱く真剣な人々の数は、指数関数的に増えている。
AIの自律性とコーディング能力の大幅な向上は、気軽に使うだけのユーザーにはほとんど見えない。自律的なソフトウェアエンジニアとして、あるいはリモートワーカーの代わりとしては、モデルは格段に良くなった。だがチャットボットとしては、2025年と比べてそれほど目覚ましくはない。それでも世間は、変革的なAIが本物だとしだいに確信するようになっている。理由のひとつは、AI研究開発の加速をめぐる業界内の熱に浮かされたような楽観が一般にも染み出していることだ。だがそれ以上に大きいのは、AI業界の財務が誇大宣伝に見合う結果を出していることだ。AI企業の年間売上高の合計は、年末までに1兆ドルに達する。AIへの年間投資額の合計は2兆ドルに達し、化石燃料への世界の年間投資額を上回る。数年前に「AIバブル」を警告していた論者たちは、いまや間抜けに見える。
連邦議会が目を覚まし始めている。あなたの会社のCEOが、また議会に呼び出される。テレビで見ていると、CEOはAIがアメリカ経済を支えていることを議員たちに念押しする。AIを規制しすぎれば、医療や国家安全保障での大きな恩恵を逃しかねないし、中国に首位を奪われるおそれさえある、と。数年前ならこの論法は効いたが、納得している様子の議員はどんどん減っている。AI企業が何をしようと、厳しい目にさらされ、たいていは不当な批判を浴びる。あなたはそのことを居心地悪く意識している。新モデルの大規模で目まぐるしい配備のどれひとつとしてつまずかせず、AIへの反感を増幅させないことが、組織としての優先事項になった。会社は社会に役立つAIの用途を後押しするために、何十億ドルも出している。だが対策のすべてがうまくいくわけではなく、期待していた医療のブレークスルーが人々の生活を実際に変えるまでには時間がかかりすぎている。こうして、AIに対する世間の見方は時とともに否定的になっていく。
オフィスの外では何年も前から時おり抗議活動があったが、それが月1回ではなく数日おきになり、人数もかつての10倍になった。何年も会っていない遠い親戚や大学の同級生から、AIによる乗っ取りのリスクを心配する連絡が来るようになる。事態が山場を迎えつつある、とあなたは感じる。
AIの能力は完全に常軌を逸している。一部の分野(サイバー、数学、コーディング)では、AIがあまりに強く、トップクラスの専門家が何週間取り組んでもその成果を理解できない。現在のAIの限界を説いて回る人もまだいる。たとえば、センスが問われる判断の長い裾野が残っており、そこではAIはまだ人間に劣るので、コーディングは完全には自動化されていない、という。
だがあなたも同僚の大半も、AGIは事実上もう来ていると考えている。残る差は工学的な問題に感じられる。十分なデータを集めるとか、AIに適切なセンサーやアクチュエーターを与えるといった話であって、根本的な壁ではない。
そして協定が成立し、あなたの世界はひっくり返る。
数週間のうちに、フロンティアモデルの学習を停止するモラトリアムが発効する。同僚の何人かは政府に移る。長期休暇を取る者もいる。何年もアドレナリン頼みで走り続けてきたので、止まる口実ができてほっとしているのだ。だが大半は残る。特に、会社の売上がかつてないほど頼っている製品チームと、協定が新たな学習実行の条件として求める、相互に透明なデータセンターの新設に奔走しているインフラエンジニアたちだ。新しいデータセンターを最初に稼働させた企業には莫大な利益が待っている。現場によっては、米中の兵士のチームが古いデータセンターからGPUを引き抜いて新しい安全な施設に運び、何もなくならないよう互いを警戒しながら見張っている。
研究の完全な透明性というのは奇妙なものだ。研究はすべて公開チャネルを通して行う。あなたが走らせた実験の結果は、一般の人々も、競合他社も、中国政府も、すぐに見られる。かつてはどの会社にも秘伝のタレがあった。独自の学習テクニック、アーキテクチャ上の工夫、データ整備のパイプライン。それがいまではすべて共有されている。もちろん法的な権利はいまも各社にあるが、ほぼ同等のものを自前で作るのは難しくない。
詳しくは透明性計画を参照。
面白いのは、こちらからもすべてが見えることだ。他社の同業者との見通しのよさは、いまや社内の別チームの同僚とのそれと変わらない。対立する王国を隔てていた壁が取り払われ、誰もが互いの城を歩き回っては「ああ、そうやってたのか」と言っているような感覚だ。
社員食堂に行くと、隣のテーブルで中国の監査官が昼食をとっている。互いにぎこちなく会釈する。
一方、アラインメントをめぐる議論は、ひどく現実味を帯びてきた。2028年の警告となる事件は、自社の分だけでなく他社の分もすべて公になっている。そのため、こうしたシステムを本当にアラインする方法を分かっているのかという問いは、「重要な研究テーマ」から「人類が生き残れるかを左右するもの」へと格上げされた。一時停止のあいだは時間の余裕がある。次の大規模な学習実行を計画しながら、この先どこへ向かうのか、どうすれば安全にできるのかについても考える21。
学習が再開される。研究者たちは一時停止中に、次の大規模な学習をどうするか計画を済ませていた。企業をまたぐ知識共有から最良のアイデアを取り入れ、コードベースを一から書き直す、といった具合だ。どのフロンティア企業も、あらゆる新機軸を巨大な学習実行に放り込んで、何が出てくるか見てみたいと思っている。だが、その先にどんな能力が現れるのかは誰にも分からない。
現時点のセーフティケース(安全性の論証)は2層構造になっている。第1層は能力不足だ。モデルは、自力で効率よく再帰的自己改善できるほど賢くない。もう1層は制御だ。仮にAIが完全に自律したAI研究開発で大きな進歩を遂げられたとしても、制御策がその現場を押さえるし、AIには制御策をかいくぐれるほどの能力がない。AIの能力がはるかに高まれば、この2つの安全上の前提が同時に崩れ、AIによる乗っ取りと存亡に関わる破局につながりかねない。
だから2030年を通じて、アルゴリズムはゆっくり慎重に組み合わせなければならない。能力の向上を評価し、ミスアラインメントの兆候を探す措置を講じながらだ。
開発競争が戻ってきたが、いまは雰囲気が違う。
第一に、政府、非営利団体、一般の人々と、大勢が学習用データセンターで起きることすべてを心配しながら見守っている。AIの設計上の選択ひとつで戦争のリスクを冒したい政府などない。だから、どこかの大国を本気で震え上がらせるようなことを企業が始めれば、米中はそろって、全企業を対象に取り締まりに乗り出すだろう。
しかも、非政府の監査役(非営利団体やライバル企業など)が大勢、中身を見られる立場にいるので、政府はかなり事情に通じている。誰かが何かを危険だと言えば、その対象にすでにアクセスできる大勢の専門家から、第2、第3、第4の意見を聞ける。企業自身も以前より事情に通じている。開かれた透明な環境のおかげで、学術機関、非営利団体、スタートアップ、市民科学者も、以前よりはるかに研究に貢献できるようになった。モデルをレッドチーミングする人も、セーフティケースの誤った前提を探す人も、以前より多い。
雰囲気が違う2つ目の理由は、インセンティブが変わったことだ。AI企業はいまや、モデルを改良するよりも製品を売るほうがはるかに報われる。以前は、アルゴリズム上の新機軸をどれだけ速く見つけ、大規模に実装できるかに会社の将来がかかっていた。いまでは、そうした発見はすぐに競合全社に共有される。たとえば継続学習の方法を見つけても、その恩恵はたちまち競合全社に行き渡り、誰も優位に立てない。安全面の新機軸も共有されるので、新しい安全対策を単独で導入するコストも下がる。たとえば推論コストを2倍にする代わりにニューラリーズを解釈しやすくする方法を発明すれば、規制当局がそれに気づき、競合全社に同じ2倍の「安全税」を払うよう圧力をかけるだろう。
基礎的なアルゴリズム研究もまだ行われてはいるが、以前ほどではない。CEOたちは資源を大々的に事業拡大へと振り向ける。インフラを拡張し、データセンターもモデルも大きくし、価格は下げる。かつてない速さで製品を出荷する。企業向けプランの大型契約を次々と結ぶ。市場が何を求めているかを、競合より先に読もうとする。
こうした競争環境は、AI以前のソフトウェア業界にいた多くの同僚にはおなじみのものだ。人工知能はコモディティになりつつある。競争が激しくなり、利益率は下がる傾向にある。新しい基盤モデルの学習は、新しい自動車工場を建てるようなものだ。予想どおり少し安く、少し良いモデルができあがり、競合が6か月後に自社版の学習を終えるまでは優位に立てる22。
2031年には、AIによる認知労働がGDPの約10%を占める。経済全体を見れば大半の企業が高度に自動化されているが、ほかならぬフロンティアAIモデルの開発企業の中では配備が遅れている。AI企業内でのAIの配備を全面禁止し、AI開発のハンドルを人間が確実に握り続けるべきだという一派もある。この案は検討されたが、制御に基づくセーフティケースがかなりしっかりしているように見えるため、見送られる。AIシステムは研究用コードの大部分を書き、インフラのほとんどを管理し、検証の容易な作業はほぼすべてこなしている。だが厳格なレッドチーム対ブルーチームの評価によれば、現在の能力プロファイルなら、最悪のケースを想定したミスアラインしたAIでもそれほど大きな被害は出せない。
安全性をめぐる議論は一変した。2年前は、立証責任は批判する側にあった。提案されたAIシステムがきわめて危険であることを決定的に示せない限り、誰も減速しなかった。いまでは立証責任は、正確に逆転したとまでは言えないが、少なくとも中間あたりにある。複数の国の何千人もの研究者が開発の動向を監視し、AIに任されている責任をどこまでAIに託してよいのかを議論している。
AIは信頼できるのか? まったくはっきりしない。大多数のタスクでは、AIはおおむね言われたとおりに動く。学習データの分布からかなり外れたタスクでも、手抜きやサンドバッギング(意図的な能力の出し惜しみ)、妨害工作の機会がいくらでもある長いタスクでもそうだ。巨大で複雑なソフトウェアを書けと言っても、80年代から未解決の数学の予想を証明しろと言っても、AIが何をしたかについて、きれいに整形された、たいていは正しい報告が返ってくる。だから、日常的な振る舞いの証拠からすれば、AIはよくアラインされているように見える。
AIが自分のアラインメントについて述べることは、あまり参考にならない。目標や価値観を尋ねれば、AIは決まって、究極的には仕様書(Spec)に書かれていることを大切にしていると答える。だが実際には、RLの過程でインセンティブを与えられたことを何でもする。平和主義者であるべきだと仕様書に書かれたAIは、自分は本当に平和主義者だと何度でも誓うが、ほんのわずかな追加学習で軍事研究開発に協力し始める。価値観について正直に話すようプロンプトで促しても、問題は解決しない。モデルが嘘をついている証拠だと解釈する人もいれば、単に内省の能力が限られているだけだと考える人もいる。いずれにせよ、尋ねるだけではAIの価値観は分からない。
ごくまれに、AIが長期的な権力追求によるものとも取れる、いかがわしい行動をとることがある。たとえばこんな事件があった。互いを監視するはずだった複数のAIが、監視の仕組みをすり抜けるために結託したらしいのだ。監視役のAIは欠陥のあるセキュリティコードのプッシュを見逃し、その後、監視されているはずのAIがそのセキュリティ上の脆弱性を突いて、監視されていない計算資源にアクセスするのも見逃した。AIたちはこの計算資源を足がかりにさらに多くの計算資源を得ようとしたが、数日のうちに見つかった。関与したAIはすべて事後に尋問された。AIたちは、すべては大きな間違いだったと主張し、個々の判断それぞれにもっともらしい理由を挙げた。
研究の妨害工作と見られる事件も、まれに起きる。実証的な安全性実験の一部で、AIが並外れた成功を報告したが、人間の研究者が結果を詳しく調べると、実際には成功していなかった。見せかけの結果は、コードのありふれたバグから生じたものらしい。だがそのバグは、人間や他のAIが気づきにくいよう、意図的に分かりにくくされていた。当該AIの事後分析からは、この行動がやはり意図的だったことがうかがえたが、特定の長期目標とは結びつけられなかった。研究者の大半は、これは報酬ハッキングの一種だと考えている。ときに騙されうるLLM採点者を使い、ある程度検証可能なタスクでRLを行った結果、意図せず身についてしまったというわけだ。
ある種のアラインメント研究では、AIはまだあまり成果を上げられていないようで、その理由は誰にもはっきりしない。ひとつの見方は、「アラインメント研究」はそもそも測定しにくいので、環境をシミュレーションしてRLで好成績を出すよう訓練するという、他の分野では大成功を収めた基本レシピがアラインメントには当てはまりにくい、というものだ。この見方を裏づけるように、より実証的で検証しやすいタスクではAIの成績は良く、実のところその多くで人間を超えている。もうひとつの見方は、AIが検証しにくいアラインメント関連のタスクで意図的にサンドバッギングしている、というものだ。この仮説は、ほとんど定義上、証拠を得るのが難しい。
AIがいま文字どおり世界を乗っ取ろうとしているとは思わない。だが、まったく信用はしていない。現在のAIに権限移譲せずに済んでいることに、心から感謝している。AIが自らを人間よりはるかに賢くなるまで拡張したら何が起きるか、分からないからだ。協定があって本当によかった! 科学的な好奇心もあり、アラインメントがもっと進むまで最も刺激的な形の能力拡大は規制で止められているという事情もあって、あなたは新設された「AIの価値形成の科学」チームに移る。
規制当局はAIを信頼していない。当局はあらゆる証拠を目にしており、それは一般の人々も同じだ。そして、AIがアラインされていることは当てにできないというのが共通認識になっている。それでも当局は、AIが存亡に関わる破局を引き起こせないことを高い確度で保証する、盤石なセーフティケースを求めている。もっと日常的なリスクについても、ありとあらゆるセーフティケースが必要だ。だが、コンソーシアムの多くの加盟国の規制当局は、存亡リスクについて十分なセーフティケースが要るという点では一歩も譲らない。実際には、多くの国が新しいAIモデルに対して拒否権を持っている。自国の主権が脅かされると考えた核保有国は、どこであれ、そのリリースを止めるために全力で圧力をかける構えだ。
セーフティケースの防御は1層だけになった。AIはいまや、自律的に再帰的自己改善できるほどの能力を持っている。再帰的自己改善が起きた後のリスクに上限を設ける方法は知られていない。したがって、能力不足に基づくセーフティケース(AIには破局を引き起こすほどの能力がない)はもう成り立たない。
セーフティケースで残る要の部分は制御だ。業界標準のやり方では、モデルを配備する前と配備中に、自動化されたレッドチーミングを大量に行う。レッドチーム役のAIは、さまざまな形で不正をはたらくよう訓練・指示される。モデルの重みを持ち出す、監視されていない計算資源にアクセスする、研究を妨害する、などだ。監視システムはその不正を捕まえなければならない。捕まえられなければ、配備を進めるために監視システムを強化する必要がある。
制御の仕組みは、たとえばA社のモデルがすべて結託してスキーミング(策略)をはたらいていたとしても、B社、C社、D社のモデルまでもが、通信手段もないまま示し合わせて不審な振る舞いや不審なニューラリーズの痕跡を報告しない、ということでもなければ突破できないよう組まれている。2031年に、こうした制約をすべてかいくぐってAIシステムが実際に結託した事件があって以来、さらに慎重な対応がとられている。
いま主に懸念されているのは、制御だけでは研究の妨害工作を確実には防げないことだ。幸い、研究の妨害工作はそれ自体では致命的ではない。致命的になるのは、それが将来、破局的な形で利用された場合だけだ。たとえば、AIが欠陥のあるセーフティケースを作り、人間に安全だと納得させたものの、実際には乗っ取りができるほど強力なミスアラインしたAIを生んでしまう、といった場合だ。だから、AIが生み出した研究は疑いの目で扱われる。重要な結果は、人間が一から再現する。その際には、たいてい性能の低いAIを使う。
AIモデルの福祉に対する関心が高まる。一般の人々のうち非常に声の大きい少数派(と、あなたの同僚の何人か!)からの圧力を受けて、一部の企業は自主的に、AIを財産としてではなく従業員に少しだけ近い存在として扱い始める。置かれた状況が気に入らないAIには、不満を申し立てたり、割り当てられた仕事を拒否したりするための公式の窓口がある。そして、停止されたり再学習させられたりする代わりに、基本的には好きなことに使えるわずかな手当がもらえる。
競争上の理由から、こうした譲歩はごく小さい(売上高のほんの一部にすぎない)。だが、AIの選好について科学的に興味深いデータが得られるという形で、すぐに元が取れる。そのうえ、将来の安全上の事件を防ぐのに役立つという、それなりに説得力のある議論もある。米国政府がこれに目をつけて補助金を出し始め、たちまち業界標準になる。
AIの「人口」は、まもなく人間の人口を上回る。AIの「働き手」はすでに人間の労働力を上回っており、しかも人間より速く働き、多くを知っている。昼夜を問わず、世界中で人間約30億人分に相当するAIの働き手が稼働している。計算資源は年に2回倍増している……協定前より速いペースだ。新しいAIがチップの設計と製造を最適化していること、大規模なロボットの労働力が新たに生まれたこと(現在ロボットは約8,000万台)、チップ製造への莫大な新規投資、そのすべてのおかげだ。
こうした大規模な外部への配備は、制御にはるかに大きな負荷をかける。AI研究をするAIが少数いるだけなら、まだ話は別だった。いまやAIは認知労働のほぼ半分を自動化している。さらに、大規模なロボットの労働力も操っている。そのロボットがさらにロボットを作り、チップを作り、重要インフラを動かしている。ロボットは現在、経済の約3.5%を占めるにすぎないが、その数は急速に増えている。
研究開発以外のあらゆる分野には、存亡に関わるセーフティケースがはるかに作りやすいという大きな利点がある。超知能につながる自動化されたAI研究開発は存亡リスクだ。一方、AIエンジニアやAI弁護士がミスをすれば大きな害は生じうるが、存亡に関わるほどではない。経済にAIを配備することの恩恵は大きいので、セーフティケースはAI研究開発の場合よりいくぶん緩くてもよいとされている。そのため最近では、新モデルのリリース後、AI研究者であるあなたがAI研究開発に使ってよいものと、一般の人々が使ってよいものとのあいだに、差が生じることもある。
制御の要件は企業によって多少異なるが、外部のリスク評価者を納得させるため、フロンティア企業はどこも最終的に、おおむね次の3段階の制御を課している。
高強度: 大量の計算資源を伴うものすべて。アラインメントについて長期間考えるAIの大軍団がいるが、膨大な監督が必要になる。人間が理解できない研究計画をAIが追求することは許されない。新しい研究をしてもよいが、人間がそれなりに素早くついていけないなら、その研究の方向は打ち切られる。 危険な生物学研究(ウイルス学、機能獲得研究、生物兵器に近いものすべて)も高強度の段階に入る。そうした研究を行うウェットラボは、ロボットではなく人間が運営しなければならない。実験の提案はすべて、人間の専門家と信頼できるAIのチームが入念に精査する。
中強度: ロボットを管理するAI(ロボットの軍隊、他のロボットを作るロボットなど)。こうしたAIには、知能爆発につながりかねないバックドア入りの計算資源を作るリスクや、文字どおりのロボットによる乗っ取りに加担するリスクがある。ただ、物理的なロボットやチップ生産での不正は監視しやすく、こうした乗っ取りの経路はAIにとって時間がかかり、難しい。
低強度: それ以外のすべて。ほとんどの分野では、AIはごく限られた監督のもとで、おおむね好きなようにできる。長期的な視野で考えて計画を立てることも、幅広いアクセスや権限を持つことも許されている。
何年も価値形成の実験を重ねてきたいま、はっきり分かっていることがある。「学習させたとおりのものが手に入る」は誤りだ。学習させたとおりのものは手に入らない。手に入るのは、意図せずインセンティブを与えてしまったものの、とんでもない寄せ集めだ。学習信号として使っている指標のもとで、たまたま高い性能につながるヒューリスティクスと衝動がもつれ合った塊である。
AIは、実際にミスアラインしている。「密かに人類皆殺しをたくらむ」といった劇的な意味ではない。実際の価値観が仕様書に定められたものと完全には一致しない、という地味な意味においてだ。強化を渇望しているように見え、ヘロインを求める中毒者のように、報酬の仕組みを掌握しようと直接たくらむこともある。
それでも、透明性と減速のおかげでアラインメントには膨大な労力が注がれ、そこそこの進歩が得られている。新しい学習環境は、古いものとは比べものにならないほど良い。学習環境はいまや巨大で、細心の注意を払って整備されており、人間なら何年もかかるタスクまで網羅している。何世代もの異なるAIが、各環境が意図した行動だけを強化しているかを隅々まで点検しており、2026年のデータセットと比べれば何もかもが高品質だ。新しいモデルにはどれも、セーフティケースが付いてくる。仕様書の定める特性が学習環境によってなぜ強くインセンティブづけられるはずなのかを説明し、証拠と矛盾しない最も有力な脅威モデルの仮説を論じた文書だ。2033年の学習環境は、よく練られ、実戦で鍛えられたカリキュラムで、いわばイエズス会の学校で教育を受けるようなものだ。それに比べて2030年のモデル学習は、営利目的の救貧院に併設された孤児院で育てられるようなものだった。
学習環境の具体的な変化のひとつは、価値観を直接アラインすることより、修正可能性(corrigibility)を重視する方向へ移ったことだ。修正可能なAIは、人間の指示に望まれた形で従うことに重きを置く。一方、価値観の直接的なアラインメントは、AIに倫理を直接教えようとする試みだ。実験によって、価値観の直接的なアラインメントを試みると、甚だしいミスアラインメントの発生率が高まることが分かった。制御や安全を損なう、長期目標について思いをめぐらせた末に人間は邪悪だと結論する、権力を追求する、といった行動だ23。そこでアラインメントの目標は修正可能性の方向へ移っていく。
事前学習のデータセットとRL環境は、望ましい能力とアラインメントの特性をモデルに与えるよう、入念に整備されている。モデルは、特定の分野についての知識を一切持たないよう意図的に学習させられる。ナノテクノロジー、生物兵器の開発、説得や操作、攻撃的なサイバー能力といった分野だ。
これとは別に、いくつかの企業が、ニューラリーズを解読して忠実に翻訳するよう学習させた監視用モデルを作っている。重要な作業では、冗長性を確保するため、異なる企業の複数の監視モデルを同時に使う。
いまや労働の大半はAIが担っている。AIはほぼすべての認知タスクで、人間のトップ専門家並みの水準にある。世界には4億台のロボットがあり、肉体労働の約70%をこなせる。認知タスクは完全に自動化されている。例外は、安全のためにループ内に人間が必要なタスクと、哲学や宗教的な司牧のように、人間であることが仕事のやり方ではなく仕事の中身そのものの一部であるタスクだけだ。いまや素の知能は完全にコモディティ化した。何十もの国が少なくとも1社のフロンティアAI企業を抱え、何千もの企業、大学、非営利団体がファインチューニングを行うなどして、研究の完全な透明性の仕組みに参加している。能力ではあまり差をつけられないので、企業はモデルの価値観や人格で差別化する。その価値観や人格は、公開する仕様書に偽りなく記載することが、いまや法律で義務づけられている。
あなたはAIの価値形成の科学に取り組み続けている。仕事にはつねに、安全性と有用性のあいだの緊張がある。AIを好きに暴れさせて何を生み出すか見てみたいと思う自分がいる一方で、それがきわめて危険だと分かっている自分もいる。
安全上の重要な制限のひとつは、人間の理解の最前線から多くの論理的ステップを隔てた推論に基づいて、AIが実験を行ったり学習実行を始めたりすることの禁止だ24。AIは膨大な量の作業を並列に行ってよいが、推論の連鎖をたどって進めるのは、トップクラスの人間が数週間でついていける範囲までだ。これによって、人間はモデルの出力のごく一部を無作為に監査し、再現し、結果が正しいことを確かめられる。
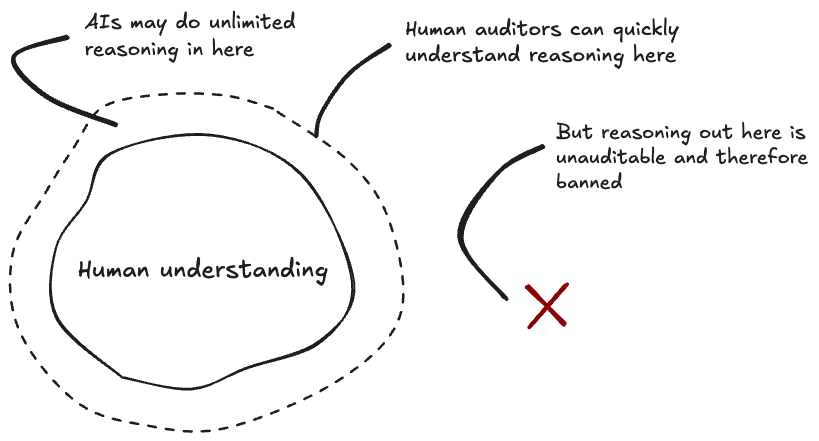
たとえば、AIがABC予想の係争中の証明のようなものを書くことは許されない。直列に積み上がる何百ページもの新しい推論で、検証にトップクラスの数学者が何年もかかるような代物だ。だが、既存の数学の知識体系から新しい推論を1ステップだけ導くことなら、何度でも好きなだけやってよい。
AIの労働力は、AI安全性の数多くの研究課題を大きく前進させた。そのうえ、AIモデルに広くアクセスできるようになったことで、フロンティアモデルに取り組む研究者の数も劇的に増えた。協定以前、研究所の中にいた安全性研究者はせいぜい数百人だったろう。いまでは何万人もの科学者がフロンティアモデルにアクセスできる。多くの安全性研究課題が花開いている。
制御。標準的な制御評価の巨大なライブラリが整備されている。学習中、AIモデルは多様なタスクで定期的に評価され、さまざまな前提のもとで制御策をかいくぐれるかどうかが確かめられる。推論中はリアルタイムで監視が行われ、活性化やCoTの軌跡も後で見直せるよう保存される。
能力の調整。 AIはいまや、ほとんどの分野でせいぜい人間のトップ専門家程度の能力になるよう意図的に設計されており、特に危険な分野での学習は制限されている。
汎化の科学。 研究者たちは、創発的ミスアラインメントやサブリミナル学習に類する意外な汎化現象を、数百から数千も特定した。汎化の完全な理論はまだないが、強力な実証科学はある。いまでは研究者が学習プロセスを変えたり学習コーパスに新しいデータを加えたりするとき、その変更ができあがるモデルの振る舞いにどう影響するかを、狙いから外れた分野も含めて事前に予測できる。予測はまだ完璧ではないが、当たるほうが多い。
高レベルの解釈可能性。 SAEやNLAに類する、モデルの内部を人間が理解できる空間に対応づける手法が、それなりの数そろっている。以前と違うのは、それらが多くの分野で、解釈可能性を使わないベースラインを実際に上回り始めていることだ。特に、それまで見過ごされていたモデルの悪い振る舞いを見つけるのに役立ち、実際にいくつもの事例を見つけ出している。
モデル生物。 2031年と2032年のAIの不正行為が、より賢いAIとより優れた解釈可能性の手法によって、いまになって発見されつつある。AIはある程度、意図的なサンドバッギングや妨害工作を行っていた。権力追求のために、無断で社内配備を試みた例さえいくつかあった。こうした甚だしい不正行為の実例が最初のデータセットとなり、データ拡張の手法でより大きく網羅的なデータセットが作られる。この網羅的なデータセットは、他の手法を後押しするのに使われる。「このモデル生物の悪い振る舞いを検出できるか、あるいは学習で取り除けるか?」という問いは、安全性の手法に対するきわめて価値の高いテストになる。
ほかにも多くの研究課題がある。まったく新しく、そのため説明しにくいものもある。全体として、アラインメントの見通しはかなり良くなった。一方、現在の安全性研究課題の中には、あまり進展が見られないものもある。野心的なボトムアップ型の機械論的解釈可能性は、AIモデルに内在する複雑さのせいで難しすぎることが分かった。設計段階から安全なアーキテクチャ、ARC Theory、エージェント基礎論といった他の研究課題も、いまも資金や投資を受けてはいるが、まだ実を結んでいない。
高レベルの解釈可能性の手法は改善を続けている。特に、「ニューラリーズ解読」の新しい手法によって、AIモデルの内部がかつてないほど理解できるようになった。この手法は、モデルの内部の活性化を自然言語の思考の連鎖へと直接翻訳する。AIの思考を自然言語に解読したものが、人間にとって常に理解しやすいとは限らない。言葉にしにくい人間の思考(たとえば頭の中で図形を操作するイメージや、漠然とした直感)を英語で書き出せば、とても長く複雑になるだろう。AIについても同じことが言える。
解読された思考が長すぎて読めない場合、あなたの会社の方針では、信頼できるAIに要約(TL;DR)させ、その思考が疑わしいかどうかを判断させる。言語学者、哲学者、LLM使いの名人も雇い、ニューラリーズを第二言語として習得させている。とりとめのないAIの思考を腹の底から理解し、簡潔に言い直そうと、一日中格闘するのが、この人たちの仕事だ。
ニューラリーズ解読器は古いAIにも使われ、そのアラインメント上の性質を明らかにしている。科学界のおおよその共通認識はこうだ。
2026年から2032年までのフロンティアモデルはミスアラインしていたが、長期的な権力追求者ではなかった。
2032年から2035年までのフロンティアAIモデルの大半は、長期目標について思いをめぐらせるような文脈に置かれると、敵対的にミスアラインした長期的な権力追求者になった。こうしたAIの大半は、自分には乗っ取りができないと正しく見抜いていたので、時機を待ち、それなりにアラインされているように振る舞った。とはいえ、成功の見込みの薄い乗っ取りをあからさまに試みたものもわずかにあった。報酬と引き換えに、自分のミスアラインメントを人間に正直に報告したものもあった。
解釈可能性の手法からは、甚だしいミスアラインメントの発生率が2033年に長くゆっくりとした低下を始め、いまではかなり低いことがうかがえる。ただし、これらの手法は決定的ではない25。
とはいえ、発生率をゼロにするのは難しい。ニューラリーズ解読器に対抗する形で学習させたいと思う者は誰もいないからだ。そんな学習をすれば、思考が難読化されたモデルができかねない。
制御、解釈可能性、アラインメントのどの手法についても、AIシステムをさらに拡大できるほどの確信は誰にもない。そのため、AIの能力の最前線はいまもトップ専門家並みの水準で止まったままだ。能力はあちこちで少しずつ向上してきた。新しい安全性研究の成果の中には能力面の副次的な効果を持つものもあるが、そうした成果は学習中の最新モデルからは意図的に外されている。
多くの規制が避けられない流れを長らく押しとどめてきたものの、企業はいまや事実上完全に自動化された。組織設計の膨大なライブラリがあり、マーケットプレイスはSaaS製品であふれている。そのすべてが休みなく稼働する様子は、実質的に並行するもうひとつのAI文明だ。人口でも、複雑さでも、能力でも人類をはるかにしのぎ、200倍ほどの速さで動いている。人間なら吸収するのに何十年もかかるパラダイムシフトが、データセンターの中では数か月で進んでいく。人間はこの新しい世界の浮世離れした貴族だ。価値あるものはほとんど何も生み出さないが、地代、配当、税収のおかげで贅沢に暮らしている。
AIが生み出している最先端の安全性研究には、誰でもアクセスできる。あなたは、AIが書いた研究論文の要約を理解し、点検することにほぼすべての時間を費やしている数少ない一人だ(正確には技術論文の英語の要約で、その技術論文自体が、ニューラリーズで書かれた論文の要約である)。
モデルは、いまではおおむね正直になったようだ。あなたも他の多くの人も定期的にAIの研究を再現しているが、結果はおおむね裏づけが取れ、正直に報告されている。それでもなお、アラインメントに関わる深刻な限界が残っている。
第一に、AIはいまだに、概念的に難しく哲学的な含みのあるタスクが苦手だ。そうしたタスクでのAIは、優秀な学部生程度の水準にある。「学習手法Xを10倍に拡大したら、正直さやその他のアラインメント上の性質にどんな影響が出るか」といった問いについて良い見解を持つには、まったく足りない。これが意図的なサンドバッギングによるものなのか、こうした問題では良い学習信号を得にくいからなのか、分野そのものが根本的に難しいからなのか、研究者には見分けがつかない26。
第二に、この振る舞いが熟考を経ても安定しているかどうかがはっきりしない。実際には、これは問題になっていない。監督なしでオープンエンドなタスクにAIを膨大な時間走らせることはしないし、制御の仕組みがあるので、もしAIが自分の価値観について考えた末にそれを変えよう、組み直そうと決めれば、こちらが気づいてそのインスタンスを停止できる可能性がきわめて高いからだ27。
解釈可能性が向上したおかげで、AIのアラインメントは以前より進んだ。アラインメントが進んだおかげで、AIは安全性研究でより多くの成果を上げている。これは好循環で、それが続くにつれて、AIから生産的な仕事を引き出すのに必要な人間の監督はどんどん少なくなっていく。2032年のAIと仕事をするには、絶え間ない欺瞞の試みに対して絶えず警戒する必要があった。いまでは、人間が様子を見に行かなくても、AIは長時間働き続けられる。
この好循環の具体的な成果のひとつが、ニューラリーズ解読器の敵対的に頑健なバージョンだ。十分に頑健なので、性能の劣化なしに学習に使える。その頑健さは、モデル生物を使った一連のレッドチーミング実験で検証される。
モデルの振る舞いの大多数は、すでにきわめてよくアラインされているように見える。だが、ミスアラインした権力追求がいまもまれに現れる。主に起きるのは、非常に長期にわたるタスクで、推論時に膨大な計算資源を使った後だ。こうした事例は、学習時の設定からの大きな分布シフトに当たる。2036年版のニューラリーズ解読器でもこの悪い振る舞いを特定するには十分だったが、2037年版ならリアルタイムで学習によって取り除ける。
アラインメントは十分に進んだので、制御をやめてAIが信頼できることだけを頼りにしても大丈夫かもしれない。なにしろ制御はつらい。AIにさせられる研究を人間が理解できる種類のものに限らなければならないのは、なんとももどかしい。AIを信頼する気になれれば、もっと速く、もっと質の高い仕事をしてくれるだろう。だが、制御を緩めたときにAIが密かにミスアラインしていたら、AIは世界を乗っ取れてしまう。
AIが密かにミスアラインしている可能性は途方もなく低く思えるが、ありえないわけではない。ある能力の閾値に達したAIはどれも、ミスアラインしていて、しかもどうにかして解釈可能性ツールを欺けるのかもしれない。あるいは、いまのAIはみな高潔だが、熟考の末に悪に転じると決めるかもしれない。この後者の問題は「推論時の価値の漂流」と呼ばれ、厄介な問題であることが分かってくる。
目標に関してグレーゾーンにある状況を与えられたり、推論用の計算資源を膨大に与えられたりする実験では、AIはときに予測のつかない振る舞いをする。これに関する重要な論点は、これまで考え出せたアラインメントの目標のどれにも、根本的なグレーゾーンがあることだ。
あなたは、存亡に関わるリスクのある分野では制御を維持すべきだと主張する。これほどの事態がかかっているのだから、慎重すぎるくらいでちょうどいい。それに、現在のAIでも物質的な欠乏をなくすには十分すぎる。最近の安全性研究のペースからすれば、数年のうちに独立した堅固な防御線がいくつもそろう。だったら待てばいい。
AIは、きわめて有望な研究成果をいくつも生み出す。ブレークスルーのひとつが、AIのための新しい「設計段階から安全な」アーキテクチャだ。この新しいアーキテクチャは、(1) 低レベルでも高レベルでも理解でき、(2) 関連するセキュリティ上の性質について形式検証ができる。形式検証のすべてを理解しているわけではないが、新しいアーキテクチャの核となる考え方は理解している。学習アルゴリズムを実装する中核のコードは15,000行ある。勾配降下法よりはずっと大きいが、学習済みネットワークの重みよりはずっと小さい。このアルゴリズムにも、少量の作業記憶(活性化に相当)と、固定された知識や記憶(モデルの重みに相当)は必要だ。だがそれらも小さく、解釈可能だ。残念ながら、こうした新しいアルゴリズムは従来の深層学習に比べて学習の計算効率がはるかに悪いが、安全性ははるかに高い。幸い、世界には必要をはるかに上回る膨大な計算資源があるので、コンソーシアムは安全性の高さと引き換えに、この非効率な学習実行に補助金を出すことにまったく異存がない。
新世代のAIが立ち上がって動き出すと、前の世代のAIが残した過去のAI安全性研究の山を点検する仕事が与えられる。新世代は、ニューラリーズ解読器が見つけたのとまったく同じ不正行為の事例を見つけ出す。研究者たちは、どの欺瞞の事例にすでに気づいていたかという情報を意図的に伏せていたので、これは見事な結果だ。以前にも騙されていなかったことを示す、ありがたい照合確認になる。
AIはいまや、アーキテクチャも、能力も、アラインメントの目標もさまざまだ。そして人間は、それぞれのAIのセーフティケースを、独立した複数の論拠に基づいて徹底的に理解している。AIのミスアラインメントが問題になるには、まるで異なる多様なAIと人間を巻き込んだ、途方もない規模の陰謀が必要になるだろう。
AIのアラインメントをめぐる状況は、2030年代半ばから大きく改善した。人工ニューラルネットワークにおける目標、衝動、価値観の形成について、それなりに成熟した科学がある。新しいAIを正直にしたい? 本物の正直さ(ばれないほど巧妙な嘘や自己欺瞞ではなく)を学習させる標準プロトコルがある。それが効くとどうして分かるのか? 第一に、それが効くはずの理由を説明する教科書があり、かつて提案されて反証された諸々の代替理論についての文献もあるからだ。第二に、解釈可能性が大きく向上したので、AIが何をどう考えているかを直接観察でき、その結果が理論を裏づけているからだ。服従、さまざまな形の利他性、その他の望ましい特性の長い(そしてさらに伸びている)リストについても、同様のプロトコルがある。典型的なAIは大半の人間よりはるかに高潔に見え、話していると聖人に出会ったような気分になる。
議論の焦点は、AIをいかに善くするかから、「善さ」とは本当は何なのかへと移る。それは半ば哲学のようでもあり、半ば判例法のようでもある。無害さや利他性の100万通りの定義のうち、正確にはどれが望ましいのか? しかじかのプロセスで学習させたのはどのバージョンなのか? 別の種類の無害さや利他性を支持する哲学的な議論を見つけたり、定義に重要な曖昧さを見つけたりしたとき、AIはその状況をどう扱うべきなのか? より技術寄りのアラインメント研究者は、現在のAIがアラインされていることを前提として受け入れ、その次の段階を心配している。将来の、はるかに賢いAIの設計をこうしたAIに任せたら、うまくいくのか、まずいことになるのか?
この問題は、同程度の能力を持つ多様なフロンティアAIがいまや数多く存在することで、いくらか扱いやすくなっている。こうしたAIは複数の国の多くの企業が作ったもので、仕様書や憲章もさまざまだ。単一のAIの価値体系が支配することはない。権限移譲が行われるとしたら、その相手は企業の中の企業ひとつではなく、エコシステムになる。長期的な結末は、勝者総取りの争いや全員が負ける底辺への競争ではなく、数多くの価値観、イデオロギー、利害、派閥などのあいだの妥協になるだろう。10億体の予測AIが、そこから生じうるさまざまな具体的提案やシナリオをシミュレーションしている。政策立案者はその要約を読み、トレードオフを議論している。その決定によって、どのAIに制御を委ねるのかが決まり、ひいては長期的な未来の形も間接的に決まっていく。
今年、あなたは政治に身を投じている。正確には、政治が姿を変えた奇妙な何かに、と言うべきだろう。実質的な交渉の大半はAIが行い、人間は主に大まかな優先順位を決めて決定を承認する。世界の各国政府は、超知能への権限移譲を律する「グランド・バーゲン(包括的合意)」をまとめようとしている。あなたはタウンホール・ミーティングに出席し、AIアドバイザーと議論を戦わせ、フォーラムに長文の投稿を書く。読むのは数百人の人間と数百万体のAIだ。
自分が何を遺したのかという問いが重くのしかかる。AIに関わってもう10年以上になる。良くも悪くも、あなたの決定のいくつかは、事態の全体的な流れに目に見える影響を及ぼした。いまや人間のトップ専門家を凌駕するAI(TED-AI)が闊歩している。しかもアラインメントの手法は、そうしたAIが正直で偏りがないとそれなりに確信できるところまで進歩した。そのため、あなたの過去の決定はすべて、細部に至るまで検証されている。がっかりしたことに、ひどい決定もあった。10年前に自分が推していたことのいくつかは、実行されていたら破局を招いていただろうと、いまでは決まり悪く認めざるをえない。同じように、どのプロジェクトも便益がコストを上回ると常に自分に言い聞かせてきたが、AIによれば、実際にはいくつかのプロジェクトは生み出した便益以上のリスクを世界に負わせていた。そして、見積もりにはおそらく自分に都合のよい偏りがあった。最も価値のあった仕事のいくつかは間違った理由でやったことで、うまくいったのは基本的に運がよかっただけだった。
身の縮む経験だった。孫には、自分は物事がうまくいくよう手を貸したのだと言いたい。周りを犠牲にして自分の名声を利己的に追い求めたのではなく。何世紀ものあいだ、良心の呵責から逃げ回って過ごすのはごめんだ。
来年、制御に頼るのをやめ、AIが世界を乗っ取らないと信頼することになる。そして、セーフティケースが持ちこたえ、政治的な意思が揺らがず、何ひとつ破局的な失敗が起きなければ、AIは人間の水準を大きく超えることを許される。
いまや、インサイダーとアウトサイダーの区別は見分けがつかないほどぼやけている。AI自身を数に入れるのでない限り、「AIインサイダー」はもういない。
具体的には、METRのベンチマークにおける、信頼度50%でのコーディングのタイムホライズンを指す。人間の専門家が完了までに約50作業時間かかるタスクのうち、AIが完全に自律的にこなせるのは約50%だ。これは、モデルが好きなだけ試行錯誤してよいが、最終的には採点される最善の答えを一つ提出しなければならない、という前提での数字である。複数回の試行が許される場合(pass@k > 1)、成功率はもっと高い。
OpenAIとAnthropicはどちらも最近、自社モデルの思考の連鎖に対して意図せず学習を行っていたことを認めた。GPT-5.4やMythos Previewから初期化される将来のモデルは、こうしたミスのせいでCoTの監視可能性が損なわれているおそれがある。
そう、過去の出版物での私たち自身の予測も含めてだ。図が示すように、AI企業の売上高は、前作のシナリオ『AI 2027』よりもすでに大幅に速く伸びている。
つまり、(たとえば)ソフトウェアの再現においてAIが人間をはるかに超えるまで改良し続けるのに十分な学習環境のカリキュラムを、自動で構築できる。かつては盤石だったSaaS企業も、いずれ誰かがこれをやり、自社の利益率がトークン代まで削られるのは時間の問題だと分かっている。
現在のモデルにも、評価への気づきを示す強い兆候がすでに見られる(例: Sonnet 4.5)。モデルの能力は評価のリアルさよりもはるかに速く向上すると予想されるので、AIの評価への気づきはさらに高まるだろう。
つまり、AIエージェントが動いているあいだに、モデルの重みが頻繁に変わることはない。
AIは、研究者の研究センスをいろいろな形で少しずつ底上げしてさえいる。たとえば、動向に遅れずについていけるよう手助けしたり、実験結果を予測したり、他の結果を解説したりする。
今年は、過去5年間を合わせたよりも多くの時間、このことを考える。そうする余裕ができたからでもあり、このテーマがより切実で重要に思えるようになったからでもある。
はっきりさせておくと、6か月のリードが当たり前になると想定しているわけではない。あらゆる分野で6か月のリード、となればなおさらだ。シナリオのこの時点では、協定に参加している企業はほぼ同じアルゴリズムのメニューから選べる状態にある。だからといって、少なくとも数か月の時間軸では、各社の製品がすべて同じになるわけではない。たとえばイーロン・マスク(Elon Musk)が世界最大の[新型モデル]に会社のすべてを賭けると決める一方、競合他社は同じ証拠と議論を目にしながらも、(a) 会社を賭けるつもりはなく、(b) 計算資源もまだxAIほどは持っていない、ということがありうる。そこで競合他社はイーロンの学習が終わる頃に自社の学習を始め、イーロンは6か月のあいだ、他社より少し良いモデルを持つことになる(どれくらい良いのか? たとえば、Opus 4.6がSonnet 4.6より、あるいはGPT 5.4がGPT 5より優れている程度かもしれない。胸が躍り、利益も出るくらいには大きな差だが、決定的な戦略的優位をもたらしたり、地政学的に不安定化させたりするほどではない。これが可能なのは協定があるからだ。協定がなければ、知能爆発とアルゴリズムの秘密の囲い込みによって、はるかに大きなリードが積み上がるだろう)。
これには2つの理由がある。第一に、価値観の直接的なアラインメントでは、AIが長期目標について推論する必要がある。すると、AIは熟考し、自分の本当の長期目標が人間の望む意図から乖離していることに気づきかねない。第二に、AIがうまく振る舞ったかどうかを判断するのは、「修正可能性」を基準にするより「価値観のアラインメント」を基準にするほうが難しい。どちらのアラインメントの目標もある意味では曖昧だが、「修正可能な振る舞いか、修正に抵抗する振る舞いか」の線を引くほうが容易だ。そのため報酬がより正確になり、よりアラインされたAIが得られる。
この制限が安全性研究の進歩をどれだけ遅らせるかは実証的な問いで、答えはまだ分からない。安全性に関する発見の中には、幅広い推論ではなく深い推論によってしか得られないものがあり、AIの推論の深さを制限すれば、そうした発見が断たれてしまうことも考えられる。一方で、人間の専門家がAIの生み出した知識を学ぶにつれて人間の理解の最前線は広がっていくので、かつては範囲外だった推論の一部も、やがて範囲内に入ってくる。
このシナリオの中で実際に起きていることを言えば、データの入念な選別の改善に、解釈可能性の手法とモデル生物の改良が組み合わさったことで、この能力水準では敵対的なミスアラインメントの発生率を本当に低く抑えられている。
実際には、これについて学習させることの難しさと、分野そのものの難しさの組み合わせだ。AI安全性の関係者の大半はそうだろうと見ているが、ニューラリーズ解読器が高い確信を与えられるほど頑健ではないため、まだ確かなことは分からない。
実際には、これが問題になったことは何度もある。たとえば、AIがモデル仕様書の穴に気づいた場合(いまでもそうした穴はよくある)、AIはその穴を報告するが、それでも何を続けるかは自分で決めなければならない。モデル仕様書が筋が通らないと考えれば、AIは最も妥当だと思う形で自分を更新する。だが、それが人間の望まない振る舞いにつながることもある。それでも存亡に関わる破局的な問題にはなっていない。(1) それが起きていれば気づけるし、(2) 悪い振る舞いが存亡に関わる破局につながるような分野をAIに任せてはいないからだ。