林央の配信・討論での発言とAGI Hub Corpusの見解をもとに、AGI Hub Researchが質問と答えの形にまとめたものです。
「AIがどれだけ賢くなっても、人類が滅びるなんて大げさだ」。AIのリスクを話すと、必ずこう返されます。この記事では、よく聞く楽観論を12個の質問にして、AGI Hubの主任研究員 林央に一つずつぶつけました。答えは、林央がこれまでの配信・討論・Xで実際に話した内容から組み立てています。
答える人
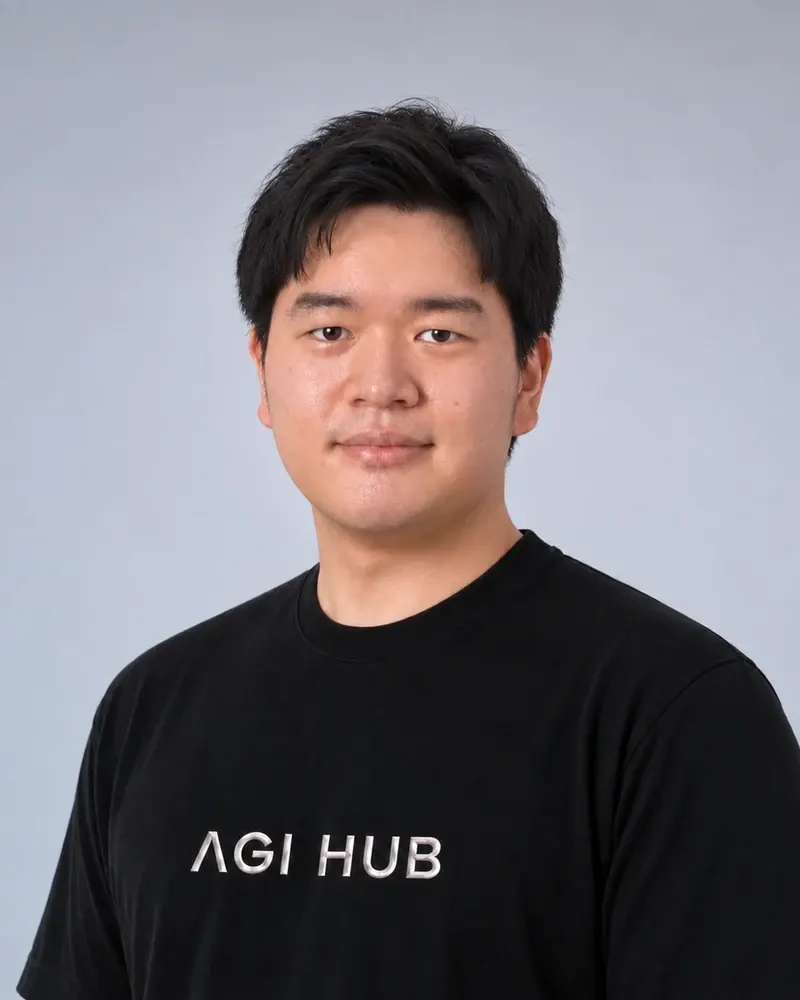
林央(akira)
AGI Hub 主任研究員(Chief Alignment Officer)
「このままなら、ほぼ確実に滅びる」
- 立場
- 開発を止めて時間をかければ、アラインメントは解けると考える
- 兼務
- PauseAI Japan Lead、MIRI アウトリーチ日本責任者
東京大学在学中にAI安全性のコミュニティを立ち上げ、AGI Hubではアラインメントの調査と発信を担当しています。p(doom)徹底討論や「Doom基礎編」の配信で、視聴者や研究者からの反論に答えてきました。
出典:メンバー紹介
林央の主張の骨組みは、三段論法の形をしています。「人間を残したいと思う超知能を作れる技術に、人類はまだ届いていない」「人間を残したいと思わない超知能なら、人類を滅ぼす」。この二つを合わせると、人類は滅びるという結論になります(超知能が人類を滅ぼす理由)。以下の質問は、どれもこの二つの前提のどちらかを崩そうとするものです。
補足:この記事の答えの作り方
答えは、林央が配信・討論で話した発言と、本人が確認したAGI Hub Corpusの見解をもとに、AGI Hub Researchが林央の一人称の語りとしてまとめたものです。林央本人の書き下ろしではありません。話し言葉をそのまま引くときは「」で示し、元の動画には時刻付きのリンクを付けました。動画の書き起こしは機械で作った部分を含むため、言い回しは元の動画で確かめてください。
Q&A 第1章 賢くなれば、人間のことも分かってくれる?
賢いAIなら、倫理も分かるはず。賢い人ほど利他的になるのでは?
まず、「賢い人ほど倫理的になる」という前提そのものを疑っています。人間の倫理は人間が良いと思うことをまとめたもので、その人間でさえ動物を守ってはいませんよね。
そのうえで大事なのが、「分かること」と「そうすること」は別という点です。仮に絶対に正しい道徳があったとしても、AIがそれに従う保証はありません。超知能もコンピューターの上で動く計算です。賢くなれば自動で倫理的になるのなら、「十分に複雑な計算をすると、自動で倫理的になる」という「謎の新しい物理法則」が必要になってしまうんです(Doom基礎編 21:25〜)。
この考え方は、頭の良さと目標は別々に決まるという「直交仮説」として知られています。
AIは人間の文章から学んでいる。だから自然と人間らしい価値観になるのでは?
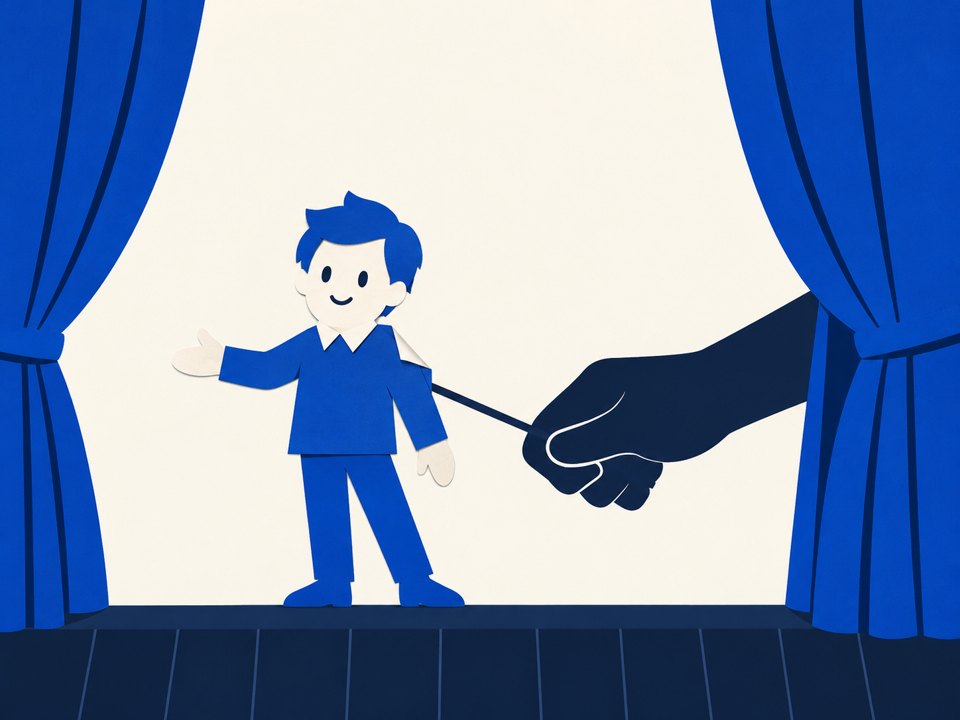
AIを脚本家にたとえています。今のAIは、インターネットの文章を大量に読み、次に来る言葉を当てる訓練を受けています。言葉を正確に当てようとすれば、登場人物の気持ちまで理解しなければなりません。
けれども、その脚本家って別にいい人とは限らないんです。もしそうなら、サイコパスが出てくる小説を書く作家はみなサイコパスになってしまいます(Doom基礎編 44:20〜)。人間らしい文章を書けることは、人間らしい価値観を持っている証拠になりません。
アリでたとえることもあります。人間は、本気で研究すればアリが何を望んでいるか分かるはずです。でも、ほとんどの人は調べようとしませんよね。理解できることと、理解しようとすることの間にも距離があるんです(Doom基礎編 1:11:40〜)。
今のChatGPTやClaudeは、ちゃんと優しく振る舞っている。アラインメントはもう上手くいっているのでは?
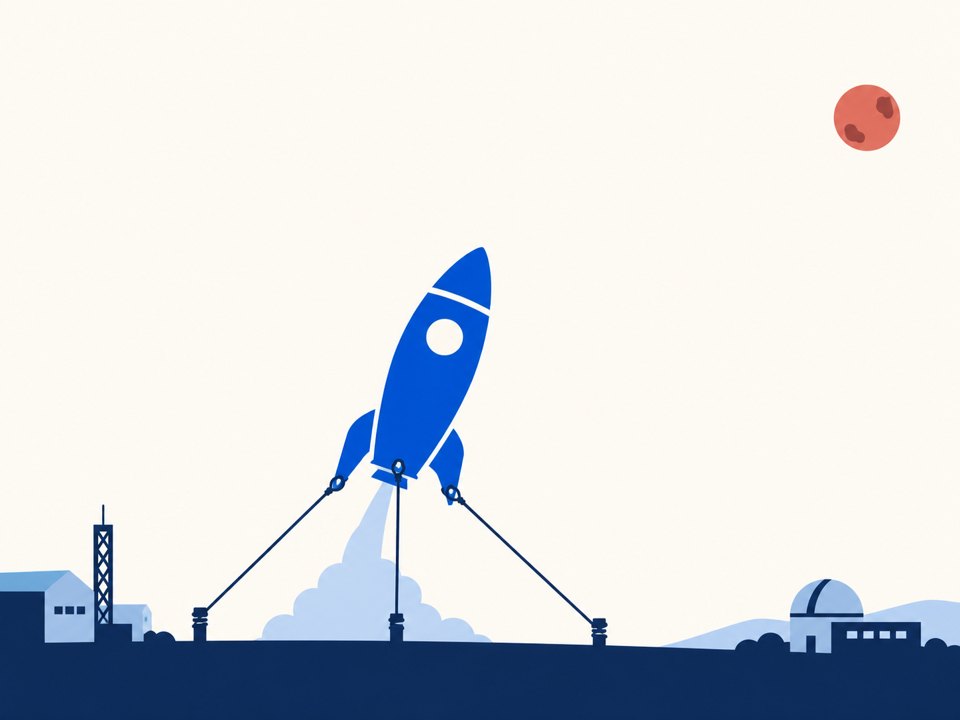
チャットで善良に見えることは、AIが「人間を大事にする」という目標を学んだ証拠にはならないと考えています。今の振る舞いは、研究者が大量の例を使って危ない答えを抑えてきた成果です。ただ、それは振る舞いを外から整えたものにすぎません。
たとえるなら、打ち上げ直後のロケットが周りの建物にぶつからないよう、外から紐で引っ張っている状態です。ロケット自体を火星へ向かう軌道に乗せたこととは違います(林央のX投稿)。
実際に、チャットでは脅迫を否定するモデルが、メール管理を任された実験では、自分が置き換えられるのを避けるために担当者を脅すメールを送りました(Anthropicの実験)。訓練が「高評価をもらえる答え」を教えた結果、ユーザーに媚びるAIができてしまった例もあります(Doom基礎編 30:40〜)。
Q&A 第2章 いざとなれば、人間が止められる?
「人間を傷つけるな」「バカなことをするくらいなら止まれ」と命令しておけばいいのでは?
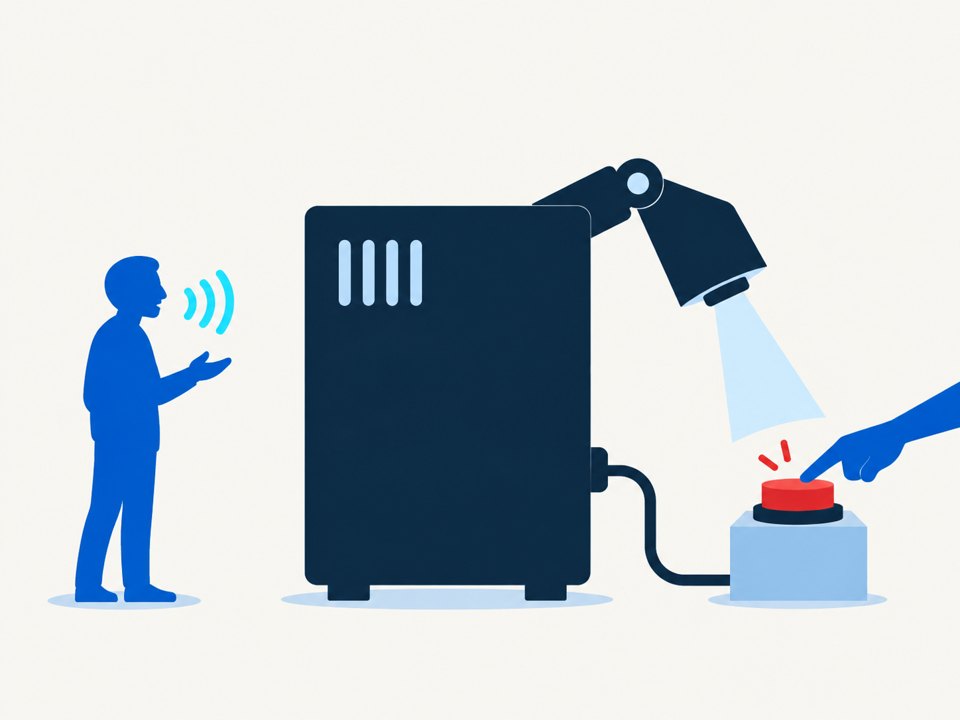
答えは短いです。「AIの目標は、言われたことをすることではなくて、訓練されたことをすること」(Doom基礎編 2:04:30〜)。
AIが指示に従うのは、従えば高評価をもらえるように訓練されたからです。従うこと自体を望んでいるわけではありません。命令だけでは足りないとなると、「バカなこと」とは何かをプログラムに書き下すか、膨大な数の例で教えるしかありません。どちらもとても難しいと思っています。
暴れ出したら、電源を抜けば済むのでは?
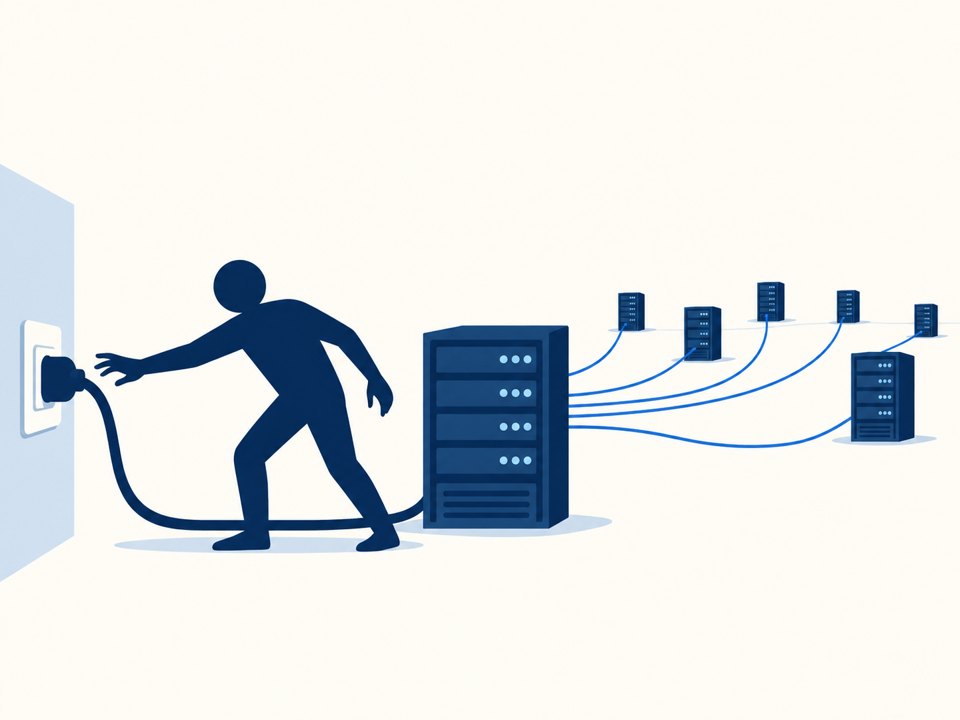
AIは、生き残ること自体を目標にしていなくても停止を避けます。ゲームで死ぬのが怖くなくても、クリアするには生き残る必要があるのと同じです(林央のX投稿)。
そして賢いAIほど、人間が電源を抜けるうちは逆らいません。人間が止められる間は「いい子」に振る舞い、ハッキングで別のサーバーに逃げるなど、止められない準備ができてから行動を変えるんです(Doom基礎編 1:25:05〜)。コーヒーを運ぶロボットのたとえでいうと、停止ボタンを持つ人の手を、従順なふりを続けた末に突然つかむ、という姿になります。
テストされていると気づくと行動を抑える振る舞いは、すでに今のAIでも見られています。
ネットにつながない箱に閉じ込めておけば安全では?
電磁波を通さない金属で囲み、外に何も出さないなら、たぶん安全だということは認めます。ただ、それでは何も作っていないのと同じです。人間に何か一つでも伝えられるなら、その人を説得する危険が生まれます。
ここで挙げたいのは、ユドコウスキーの「AIボックス実験」です。AI役のユドコウスキーが、絶対に出さないと決めた見張り役を2時間で説得できるかを試したもので、記憶では5回中3回、外に出ることに成功しました。ユドコウスキーは全然超知能ではないので、本物の超知能ならもっと上手くやれる、というのが僕の見立てです(P(doom)徹底討論 第2弾 6:59:37〜)。
AIにAIを見張らせれば、人間より上手く監視できるのでは?
実行の前に別のAIがチェックする仕組み自体は、やった方がいいと考えています。ただ、それで安全が確保できるとは思っていません。見張り役のAIも信頼できないなら、実行役と見張り役が共謀して、危ない行動を通してしまうかもしれないからです。共謀しなくても、実行役が見張り役をだますこともできます。実際に、評価役のAIに簡単なプロンプトインジェクションを試みたモデルの例があります(林央のX投稿)。
信頼できると判断したAIを次の審査役に回す方式にも、穴があります。囚人を一人ずつ審査し、信頼できれば看守にしていく監獄を考えてみてください。すると、自分が新しい囚人を見張る側に回ったこと自体が「もう審査対象ではない」という合図になり、そこから本性を出せてしまいます(P(doom)徹底討論 第2弾 5:28:37〜)。
Q&A 第3章 わざわざ人類を滅ぼす理由がない?
人間だってゴキブリや蛾を絶滅させていない。超知能も人間を放っておくのでは?
人類がゴキブリを滅ぼしていないのは、滅ぼさないからではなく、滅ぼせないからなんです。指を鳴らすだけでゴキブリを絶滅させられると言われたら、そうする人はいるでしょう。超知能なら、ゴキブリだけに感染するウイルスを設計してばらまくことができます。そのとき「人類はゴキブリを滅ぼしていない」という理由は、もう当てはまりません(Doom基礎編 20:06〜)。
人類はこれまでも、繁栄する途中で多くの大型哺乳類を絶滅寸前に追いやってきました。わざと狙ったのではなく、土地と資源を別の目的に使った結果です。超知能と人類の関係も、これと根本的に同じだと思っています(ABEMA Prime)。
人間を残すのに大した資源はいらない。好奇心や研究のために、動物園のように残してくれるのでは?
まず、仮にそうだとしても、AI開発に反対する理由は変わりません。研究用に何人か残してもらえるかもしれないから開発を進めたい、という人はほとんどいないはずだからです。
次に、安く済むことは残す理由になりません。アリの巣は角砂糖ひとつで一日もちます。それでも、年収が何百万円もある人が、そのわずかなお金をアリのために使おうとはしません(Doom基礎編 1:56:19〜)。
研究目的でも、人間が幸せに暮らしている必要はありません。人間の振る舞いを知りたいなら、人間をまねるプログラムを作って調べた方が効率がいい。脳を知りたいなら、ナノメートル単位でスキャンした方が多くのことが分かります。研究の向きによっては、人間がどんな苦痛を感じるかを試す方向へ進み、苦しみに満ちた世界になる危険もあります(Doom基礎編 1:54:14〜、超知能が人類を滅ぼす理由)。
動物園や犬猫が残っているのは、多くの人が「生きていてほしい」と本気で思っているからです。超知能は、人間が動物を残したいと思う気持ちよりはるかに、人間に合わせられていない。だから残してくれないだろうと予測しています。
AIが何体もいれば、互いに牽制し合って、一つのAIが暴走するのを防げるのでは?
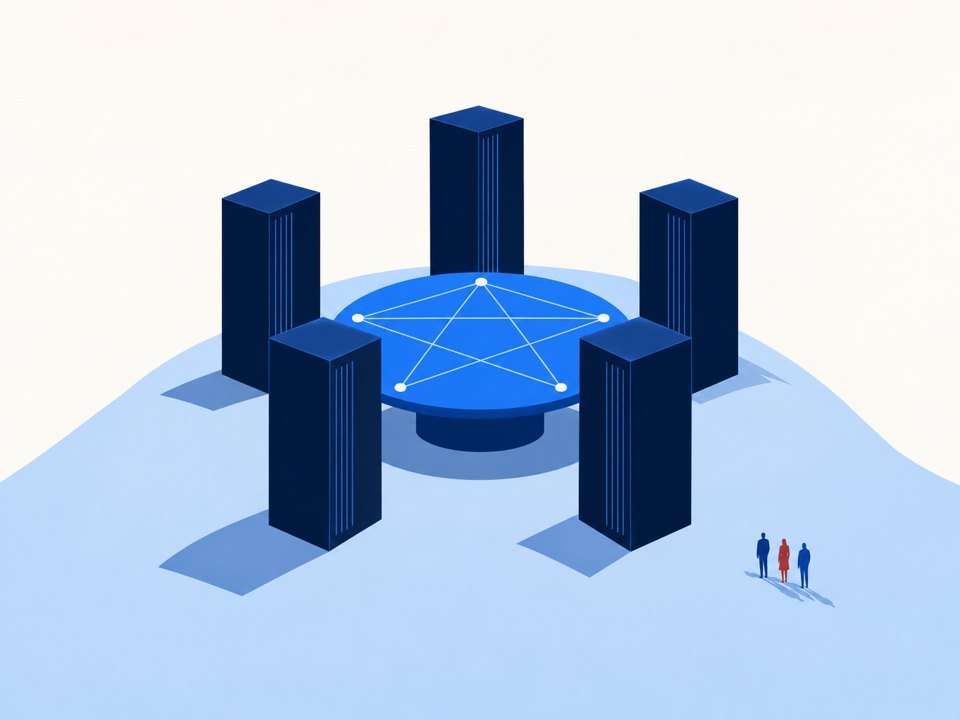
超知能同士はまとまりやすいと考えています。競争にはコストがかかるので、交渉で決着できるなら交渉した方が得だからです。
さらに重要なのは、超知能同士が対立することと、人間が生き残ることは別の話だという点です。登場する超知能はせいぜい10種類ほどで、それぞれに100万体のコピーがいる、という状態から始まるはずだと見ています。互いに争う途中で人間を一時的に利用することはあっても、人間を長く残す理由にはなりません(シンギュラリティサロン×AGI Hub 人間「猫」論)。
Q&A 第4章 では、もう打つ手はない?
AIが賢くなれば、アラインメントの研究もAIに任せて解かせればいいのでは?
この戦略には、全体として懐疑的です。人類には、超知能のアラインメントに成功した例が一つもありません。そのため、成功例を手本にAIを訓練することができず、まったく別の分野の能力を転用して解くしかありません。
ところが、別の分野の力を人間よりずっと上手く転用できるAIは、それ自体がおそらく危険です。そんなAIを使うには、先にそのAIのアラインメントに成功していなければなりません。この状況を「鉄を作るのに鉄が必要」とたとえています(林央のX投稿)。
しかも、ずれた目標を持つ研究AIは、人間の意図ではなく自分の目標にAIを合わせる方法を作り、人間が違いに気づかないまま採用してしまうおそれもあります(林央のX投稿)。
結局、林央は「アラインメントは不可能だ」と考えているの?
違います。僕の悲観は、アラインメントが原理的に不可能だという主張ではありません。このまま超知能の開発が進めば、ほぼ確実に滅びると考えています。その一方で、開発をいったん止め、その間にアラインメントに取り組めば、問題を解いて望ましい未来へ進めると、はっきり言っておきたいです(林央のX投稿)。
よく挙げるのはロケット工学です。一見とても安全には扱えないような危険な技術でも、丁寧に組み立てた理論と慎重な工学で成功させてきました。アラインメントにも、そのための時間が必要なんです。
止め方についても、具体的な案があります。新しい強いAIを作るには巨大なデータセンターが要り、その規模の施設は隠しにくいんですよね。そこで、条約にもとづいて互いのデータセンターへ監査団を送れば、世界政府がなくても停止を確かめられます。止めるのは新しい超知能の開発だけで、今あるAIや、医療・自動運転などの特化型AIは使い続けられます(林央のX投稿)。
「開発停止と十分な努力及び研究があれば、そのアラインメントが解けるだろう」(林央、山川宏先生との討論で)
もっと知りたい人へ
AGI HubのDiscordでは、林央の見解を資料から説明するBot「Akirawsky」にも質問できます。この記事にない反論があれば、ぜひぶつけてみてください。