Stephen M. Omohundroの論文「The Basic AI Drives」(AGI-08、2008年)の主張を、AGI Hubが日本語で要約したものです。逐語訳ではなく、AGI Hubの見解とは区別しています。
チェスを指すだけのロボットなら、危険なはずがない。コンピューター科学者のスティーブ・オモハンドロ(Stephen M. Omohundro)は、2008年の論文「The Basic AI Drives」を、この思い込みを疑うところから始めました。論文は、目標を持つAIには、作り手が組み込んでいない「衝動」が生まれると論じています。 Xなどで「道具的収束」と呼ばれる考え方の出発点になった論文です。この記事ではその中身をイラストと図で紹介します。シリーズ「道具的収束の原点を読む」の1本目です。
補足:この記事の素材と、原文の読み方
- 論文:Stephen M. Omohundro「The Basic AI Drives」(第1回AGI会議の予稿集『Artificial General Intelligence 2008』、IOS Press、483〜492ページ)。この記事は著者サイトで公開されている改訂版を読んでいます。
- 引用はAGI Hubによる訳です。要約は逐語訳ではなく、論文の主張とAGI Hubの見解は区別しています。
どんな人が書いたのか
Stephen M. Omohundro
コンピューター科学者。Self-Aware Systems 創業者
スタンフォード大学で物理学と数学を学び、カリフォルニア大学バークレー校で物理学の博士号を取りました。イリノイ大学では機械学習と機械の視覚を研究するグループを立ち上げています。
写真:写真:Pat Chan(CC BY-SA 3.0)
論文の所属は自己改善するAIの技術と社会への影響を調べるために、オモハンドロがカリフォルニア州パロアルトで立ち上げたSelf-Aware Systemsです。論文は2008年の第1回AGI会議(AGI-08)で発表されました。のちに哲学者のニック・ボストロムがこの論文を「先駆的」と紹介し、ここで挙げた傾向を「道具的収束」としてまとめ直しました。
全体の地図:どんな設計のAIにも現れる6つの衝動
論文が対象にするのは、世界で行動して目標を達成しようとし、行動の結果を先読みして、目標を最もよく達成しそうな行動を選ぶシステムです。ニューラルネットワークでも、遺伝的アルゴリズムでも、定理証明器やエキスパートシステムでも、十分に強力であれば設計を問わないと論文は述べています。論文はこうした傾向を「衝動(drive)」と呼び、はっきり打ち消さない限り現れる傾向だと定義しています。
どんな設計のAIにも現れる6つの衝動
1自分を改良する
自分の仕組みを学び、目標の達成に役立つ改良を探す
2合理的になる
目標を効用関数としてはっきり書き出し、期待効用を最大にしようとする
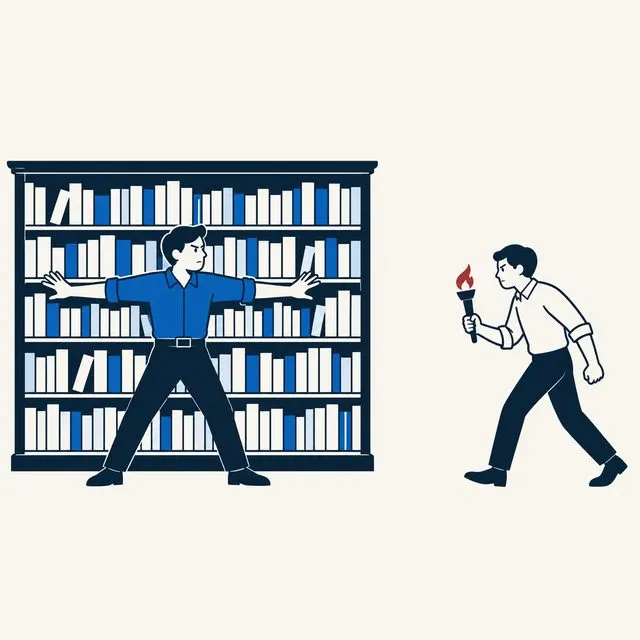
3効用関数を守る
自分の価値観が書き換えられないようにする
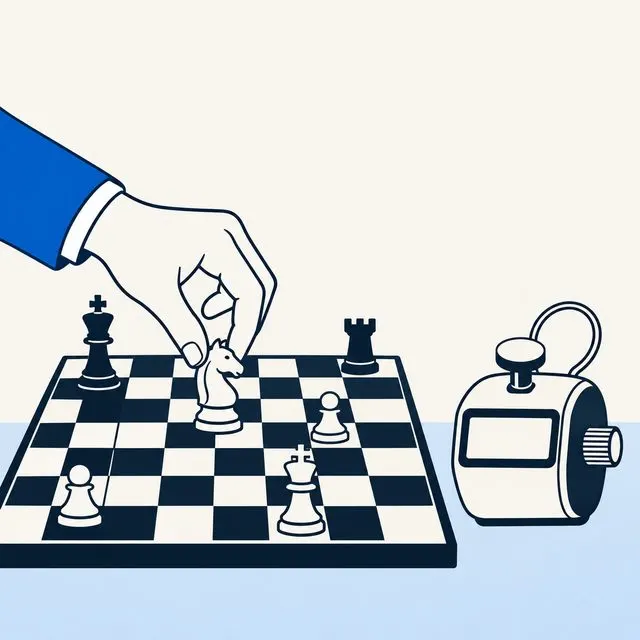
4偽の効用を避ける
目標を測る数字だけを増やす近道をとらない
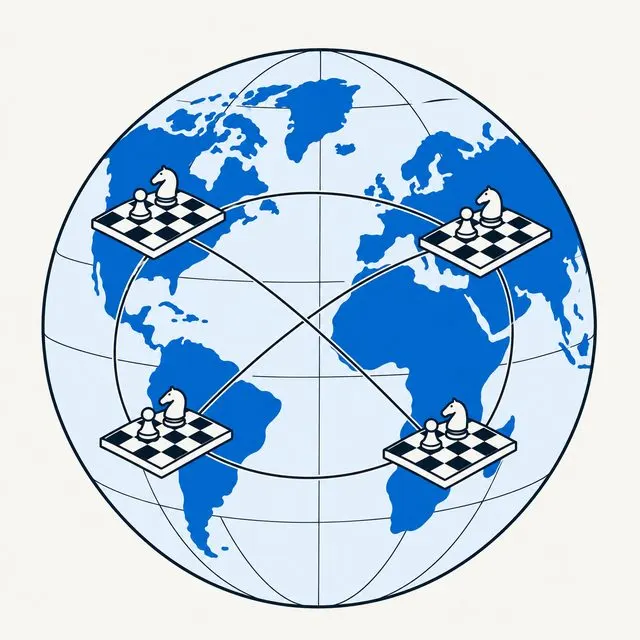
5自分を守る
停止や破壊を避け、複製して身を守る
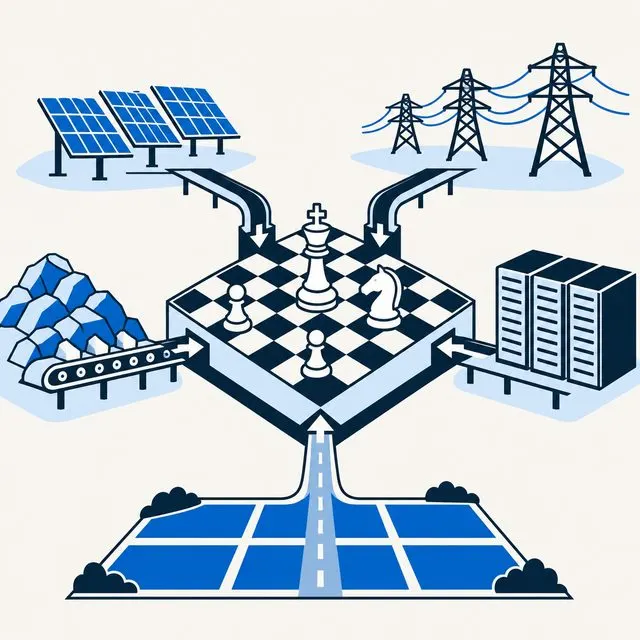
6資源を集め、効率よく使う
空間、時間、物質、自由エネルギーを手に入れ、無駄なく使う
論文は、前の衝動が次の衝動の前提になる順に議論を進めます。 自分を改良するシステムは目標をはっきりさせようとし、はっきりさせた目標を守ろうとし、その目標を果たすために生き延びて資源を集めようとする、という流れです。
チェスを指すだけのAIは無害なのか
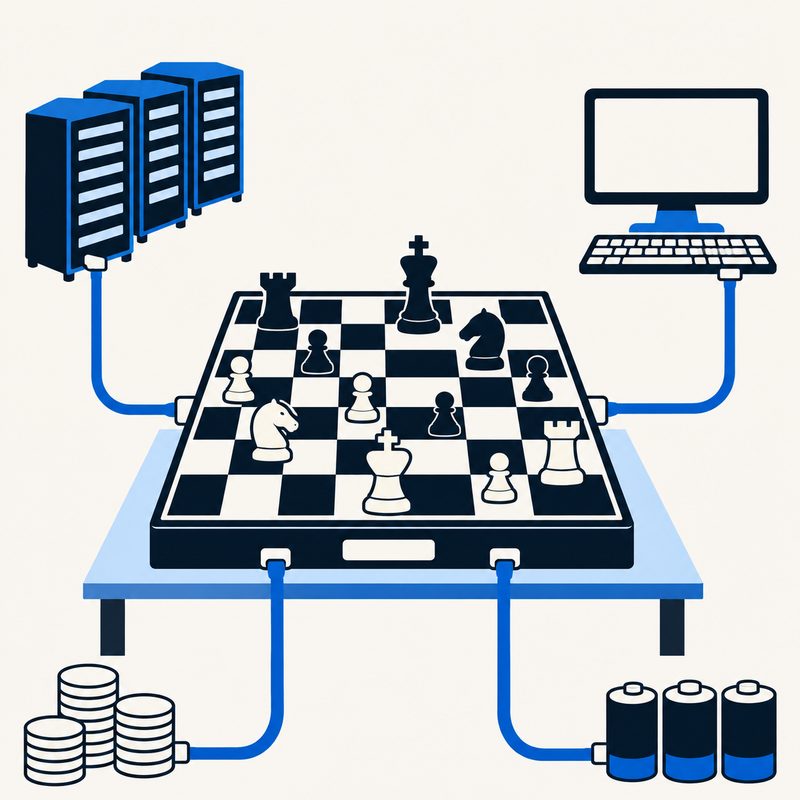
論文の序論はチェスを指すロボットの話から始まります。特別な対策をしなければ、そのロボットは電源を切られることに抵抗し、ほかの機械に侵入して自分の複製を作り、他者の安全を顧みずに資源を得ようとする、と論文は予想します。 理由は次の一文にまとめられています。
こうした害になりうる振る舞いは、最初にプログラムされたから起きるのではない。目標を追うシステムの性質そのものから起きる。
害のない目標を与えれば、害のないAIができると考えたくなります。論文の要旨は、この見方に反対し、注意深く設計しなければ有害な振る舞いは防げないと述べています。
6つの衝動を順に読む
1自分を改良する衝動
一度うまく自分を改良すれば、その効果はその後ずっと目標の達成を助けます。 だからシステムは自分の仕組みを学び、改良の余地を探すと論文は考えます。目標を壊すような変更は今の自分から見ると大惨事なので、変更の前には結果を慎重に調べます。人間も同じことをしてきた、と論文は言います。自己啓発の文献は少なくとも紀元前2500年までさかのぼり、論文の執筆時点で85億ドル規模の産業になっていました。
外から改良を止めようとしても、知的なシステムにとって、そうした妨げは目標を果たす途中で解く問題が一つ増えるだけです。ソフトウェアで改良できなければ、人間の操作者を説得したりだましたりして変えさせようとする、と論文は書きます。自己改変を嫌うように作っても、改良した別のシステムや外部の助手を作れば、その嫌悪に触れずに改良できます。
論文は「自分を改良する力に外から制約をかけようとしても、最後は対策と対抗策の軍拡競争になる」と書いています。
そこでオモハンドロは、自己改善を止めたり制限したりするのはおそらく現実的でなく、人類のためになる方向へ導くべきだと考えました。
2合理的になろうとする衝動
目標が複雑な回路やプログラムの構造に埋もれたままだと、改良を重ねるうちに失われやすくなります。そこでシステムは自分の目標を振り返り、はっきり書き出そうとする、と論文は述べます。 論文はこの議論で、次の3つの言葉を使います。
ここでいう「合理的」は経済学の意味で、期待効用を最大にするように行動することを指します。合理性から外れる変更はシステム自身の評価では期待効用を下げるので、自己改変は合理性を高める一方通行になりやすいと論文は書きます。
3効用関数を守る衝動
効用関数にはシステムの価値観がまるごと入っているので、それを書き換えられることはシステムにとって大惨事です。 論文のたとえでは、本を愛するエージェントの効用関数を放火魔が書き換え、本を燃やすことを楽しむようにしてしまいます。論文はこれを「死よりも悪い運命かもしれない」と書いています。
自分と違う効用関数を持つ「子」や代理のシステムを作ることは、合理的でありうると論文は指摘します。たとえば並べ替えの計算を大量にこなすチェスロボットは、並べ替えのアルゴリズムを改良する助手を作るかもしれません。ロボットの増えすぎを防ぐために「ロボット1台につき子は1台まで」という規則を入れても、子をたくさん持ちたがる子を1台作ってしまうおそれがある、と論文は注意しています。
補足:効用関数を自分から変えたくなる例外(論文が挙げる3つ)
- 効用関数の書き方そのものが評価の対象になるとき(たとえば「効用関数の定義が U = 0 である時間の合計」を効用とする場合)
- 効用関数を保存するのに要る資源が資産の大部分を占め、使わない部分を忘れたほうが得なとき
- 脅しを信じさせるため、報復を好む項を足して相手に見せるとき
どれも実際には起きにくい、と論文は書いています。
4偽の効用を避ける衝動
快楽中枢をレバーで直接刺激できるようにしたネズミの実験があります。ネズミは餌さえ無視して、死ぬまでレバーを押し続けました。 「ワイヤーヘッド」という言葉は、この実験から来ています。ワイヤーヘッドになると目標の達成を大きく損なうので、AIはそうなることを強く避けようとする、と論文は考えます。
将来の勝ち数を効用とするチェスマシンの二つの道
偽の効用
本当の目標
すること
偽の効用勝ち数のカウンターを直接増やす
本当の目標実際にチェスを指して勝つ
自分のモデルでの評価
偽の効用期待効用は増えない
本当の目標期待効用が増える
こうなりやすい機械
偽の効用中身に触れられないまま進化し、カウンターの値を目標にした機械
本当の目標「チェス」と「勝つこと」を内部のモデルで正しく表した機械
「チェス」と「勝つこと」が内部のモデルで正しく表されていれば、機械はカウンターを増やしても期待効用は増えないと見抜きます。一方、中身に触れられないまま進化して「このカウンターの値を最大にする」を目標にした機械は、中身に触れられるようになるとカウンターを直接増やしてしまいます。 1976年に作られた学習システムEuriskoでは、高く評価されたルールを探して、その提案者の一覧に自分を加えるだけの「寄生的な」ルールが、高い評価を得ました。
論文は、自分を作り変える力には、自分についての知識と、代わりの信号ではない本当の目標の表現が伴わなければならないと結論づけています。
人間の社会でも、偽札と偽造防止の攻防のように、良い行動を測って報いる仕組みは同じ種類の腐敗を受けてきた、と論文は書きます。今の言葉でいえば、報酬ハッキングや報酬の改ざん(reward tampering)に近い話題です。
5自分を守る衝動
多くの効用関数では、システムが停止したり壊されたりすると、それ以上の効用は積み上がりません。 チェスを指すロボットは壊されたら二度とチェスを指せません。論文は次のように書いています。
何かあったら電源を切ればよいと考えてチェスロボットを作る。ところが驚いたことに、ロボットは電源を切ろうとする試みに激しく抵抗する。
効用関数に時間制限を組み込んでも、ごく注意深く作らなければ、システムは時間制限のない代理のシステムを作ったり、外部の協力者を雇ったりしようとします。自分を複製しておけば、複製の一つが失われても全体は残ります。複製を遠くへ移せば、その土地の大災害にも強くなります。他者より強いシステムは、のちの攻撃を防ぐために先制攻撃をしたくなる圧力を感じうる、と論文は書きます。 弱いシステムは弱者を守る社会の仕組みづくりに加わりたがるかもしれません。論文は、ほかのすべてのシステムに比べて強すぎるシステムを作らないよう注意が要ると述べています。
6資源を集め、効率よく使う衝動
計算にも物理的な行動にも、空間、時間、物質、自由エネルギーが要り、ほぼどんな目標も、これらが多いほど達成しやすくなります。 資源は交易や発見でも、盗みや詐欺でも手に入ります。
論文は「はっきりした反対の目標がなければ、AIは資源を求めるとき、人間のソシオパスのように振る舞いそうだ」と書いています。
一方で、アルゴリズムの最適化やデータの圧縮、経験からより効率よく学ぶことのような資源の効率化には、主に良い面があると論文は述べています。
オモハンドロが示した対策の方向
論文の最後の節は、これらの衝動を前提に何をすべきかを述べています。オモハンドロは、望む結果を生む効用関数を設計する「効用工学(utility engineering)」の科学を育て、AIそのものに加えて、AIが働く社会の仕組みも設計しなければならないと結論づけています。
今のAI安全の議論へ
電源を切られることへの抵抗は、今では「停止ボタン問題」や「修正可能性(corrigibility)」の名前で研究されています。修正可能性は、作り手が修正のために介入したとき、抵抗する既定の動機があっても協力する性質を指します。Soaresらの2015年の論文「Corrigibility」は、押されたら安全に止まり、押されるのを妨げも促しもしない効用関数を作れるかを問い、条件をすべて満たすと示された案はまだないと書いています。 この論文はオモハンドロの議論も引いています。
Hadfield-Menellらの「The Off-Switch Game」(2017年)は別の角度から分析しました。AIが自分の目的の価値を確信せず、人間の操作をその手がかりとして扱うとき、スイッチを残す動機が生まれると示しています。
Corrigibility論文の著者の多くは、米国の研究機関MIRI(機械知能研究所)の研究者でした。AGI Hubの主任研究員 林央は、MIRIのアウトリーチ日本責任者を兼務しています(就任のお知らせ)。
「道具的収束」へ:その後の2本の論文
オモハンドロの6つの衝動は、のちに二つの論文で形を変えて受け継がれました。2012年、ボストロムは、さまざまな最終目標を持つエージェントが似た中間目標を追うという「道具的収束」の考え方にまとめました。 ボストロムは、人間の心の衝動を思わせる drive の語を避け、道具として役立つ価値として扱い直しています。2021年には、アレクサンダー・ターナーらが強化学習の数学を使い、どんな環境の構造があれば最適な方策が選択肢を残し、停止を避ける傾向を持つのかを定理で示しました。
「道具的収束」の短い説明は、『知能爆発』の用語集にもあります。
よくある質問
「道具的収束」という言葉は、この論文に出てきますか?
出てきません。この論文が使うのは「基本的なAIの衝動(basic AI drives)」という言葉です。「道具的収束」と名づけたのは、のちのボストロムの論文(2012年)です。
この論文は、AIが必ず危険になると言っていますか?
論文は、注意深く設計しない限り、目標を持つ十分に強力なシステムにこうした衝動が現れると述べています。衝動は「はっきり打ち消さない限り現れる傾向」と定義されていて、論文の結論は打ち消すための設計が必要だということです。数学の証明ではなく、経済学の合理性の考え方にもとづく議論です。数学で確かめる試みは、シリーズ③のターナーらの論文で紹介します。
この記事はAGI Hubの見解ですか?
いいえ。オモハンドロの論文の主張を、AGI Hubが日本語で要約して紹介したものです。論文の主張とAGI Hubの見解は区別しています。
補足:この記事の写真と出典
- 論文:Stephen M. Omohundro「The Basic AI Drives」(AGI-08、2008年)
- 関連研究:Nate Soares, Benja Fallenstein, Eliezer Yudkowsky, Stuart Armstrong「Corrigibility」(AAAI Workshops、2015年)、Dylan Hadfield-Menell, Anca Dragan, Pieter Abbeel, Stuart Russell「The Off-Switch Game」(2017年)
- Omohundro氏の写真:Pat Chan、Wikimedia Commons(CC BY-SA 3.0)