Alexander Matt Turnerらの論文「Optimal Policies Tend to Seek Power」(NeurIPS 2021、arXiv第10版)の主張を、AGI Hubが日本語で要約したものです。逐語訳ではなく、AGI Hubの見解とは区別しています。図は論文をもとに日本語で描き直しました。
賢いAIは止められるのを避けたり、資源を集めたりするかもしれない。この心配は、AIを人間に見立てたことから来る思い込みなのでしょうか。アレクサンダー・ターナー(Alexander Matt Turner)らの論文「Optimal Policies Tend to Seek Power」(NeurIPS 2021)は、この問いを数学で確かめようとしました。論文は、環境にある種の対称性があれば、多くの報酬関数で最適な方策が「パワー」を求める、つまり選択肢を残す方向へ進むことを証明しました。 この記事では論文の中身を図とイラストで紹介します。シリーズ「道具的収束の原点を読む」の3本目です。
補足:この記事の素材と、原文の読み方
- 論文:Alexander Matt Turner, Logan Smith, Rohin Shah, Andrew Critch, Prasad Tadepalli「Optimal Policies Tend to Seek Power」(NeurIPS 2021)。この記事はarXivの第10版(2023年1月28日)を読んでいます。この版では、最適な方策が実際に学習される方策と大きく違いうることが書き足されています。
- 論文の図は日本語で描き直しています。引用はAGI Hubによる訳です。要約は逐語訳ではなく、論文の主張とAGI Hubの見解は区別しています。
どんな人が書いたのか
Alexander Matt Turner
筆頭著者。論文の所属はオレゴン州立大学
のちにGoogle DeepMindで研究者を務めました(本人のXのプロフィールによる)。強化学習のエージェントがパワーを求める傾向について、この論文の続きの研究も発表しています。
写真:写真:本人のXのプロフィール画像(@Turn_Trout)
共著者はローガン・スミス(ミシシッピ州立大学)、ロヒン・シャーとアンドリュー・クリッチ(ともにカリフォルニア大学バークレー校)、プラサド・タデパリ(オレゴン州立大学)の4人です(所属は論文の表記)。論文はNeurIPS 2021に採択され、スポットライト発表に選ばれました。
全体の地図:論文の流れ
パワーを求めるAIは、擬人化の産物か
論文はまず、意見の割れた問いを並べます。オモハンドロ(2008年)やボストロム(2014年)、ラッセル(2019年)は、高い知能を持つエージェントは目標を追う中でパワーを求めると考えました。 計算機科学者マーヴィン・ミンスキーは、リーマン予想の証明を任されたエージェントが、合理的に考えて地球とそこに住む全員を計算資源に変えてしまうかもしれないと想像しています。
パワーを求めるAIをめぐる二つの立場
懸念する側
疑う側
代表的な論者
懸念する側Omohundro(2008)、Bostrom(2014)、Russell(2019)
疑う側LeCunとZador(2019)、Mitchell(2021)など
主張
懸念する側高い知能のエージェントは、目標を追う中でパワーを求める
疑う側その心配は、AIを人間に見立てたことから来る
この論文は、最適な方策がとりやすい行動について、初めての形式的な理論を作り、議論を整理しようとしました。 ただし著者らは、大規模なAIのパワー追求がいつ現実味を帯びるかについては、何も主張しないと断っています。
設定:賢いエージェントを「最適な方策」として考える
論文は強化学習でよく使う「マルコフ決定過程」という枠組みで考えます。環境は状態と行動からなる有限のグラフで、エージェントは与えられた報酬の合計を最大にする方策(最適な方策)をとるものとして理想化します。 そのうえで、ある行動が多くの報酬関数で最適になるとき、最適な方策はその行動を「とる傾向がある」と言います。
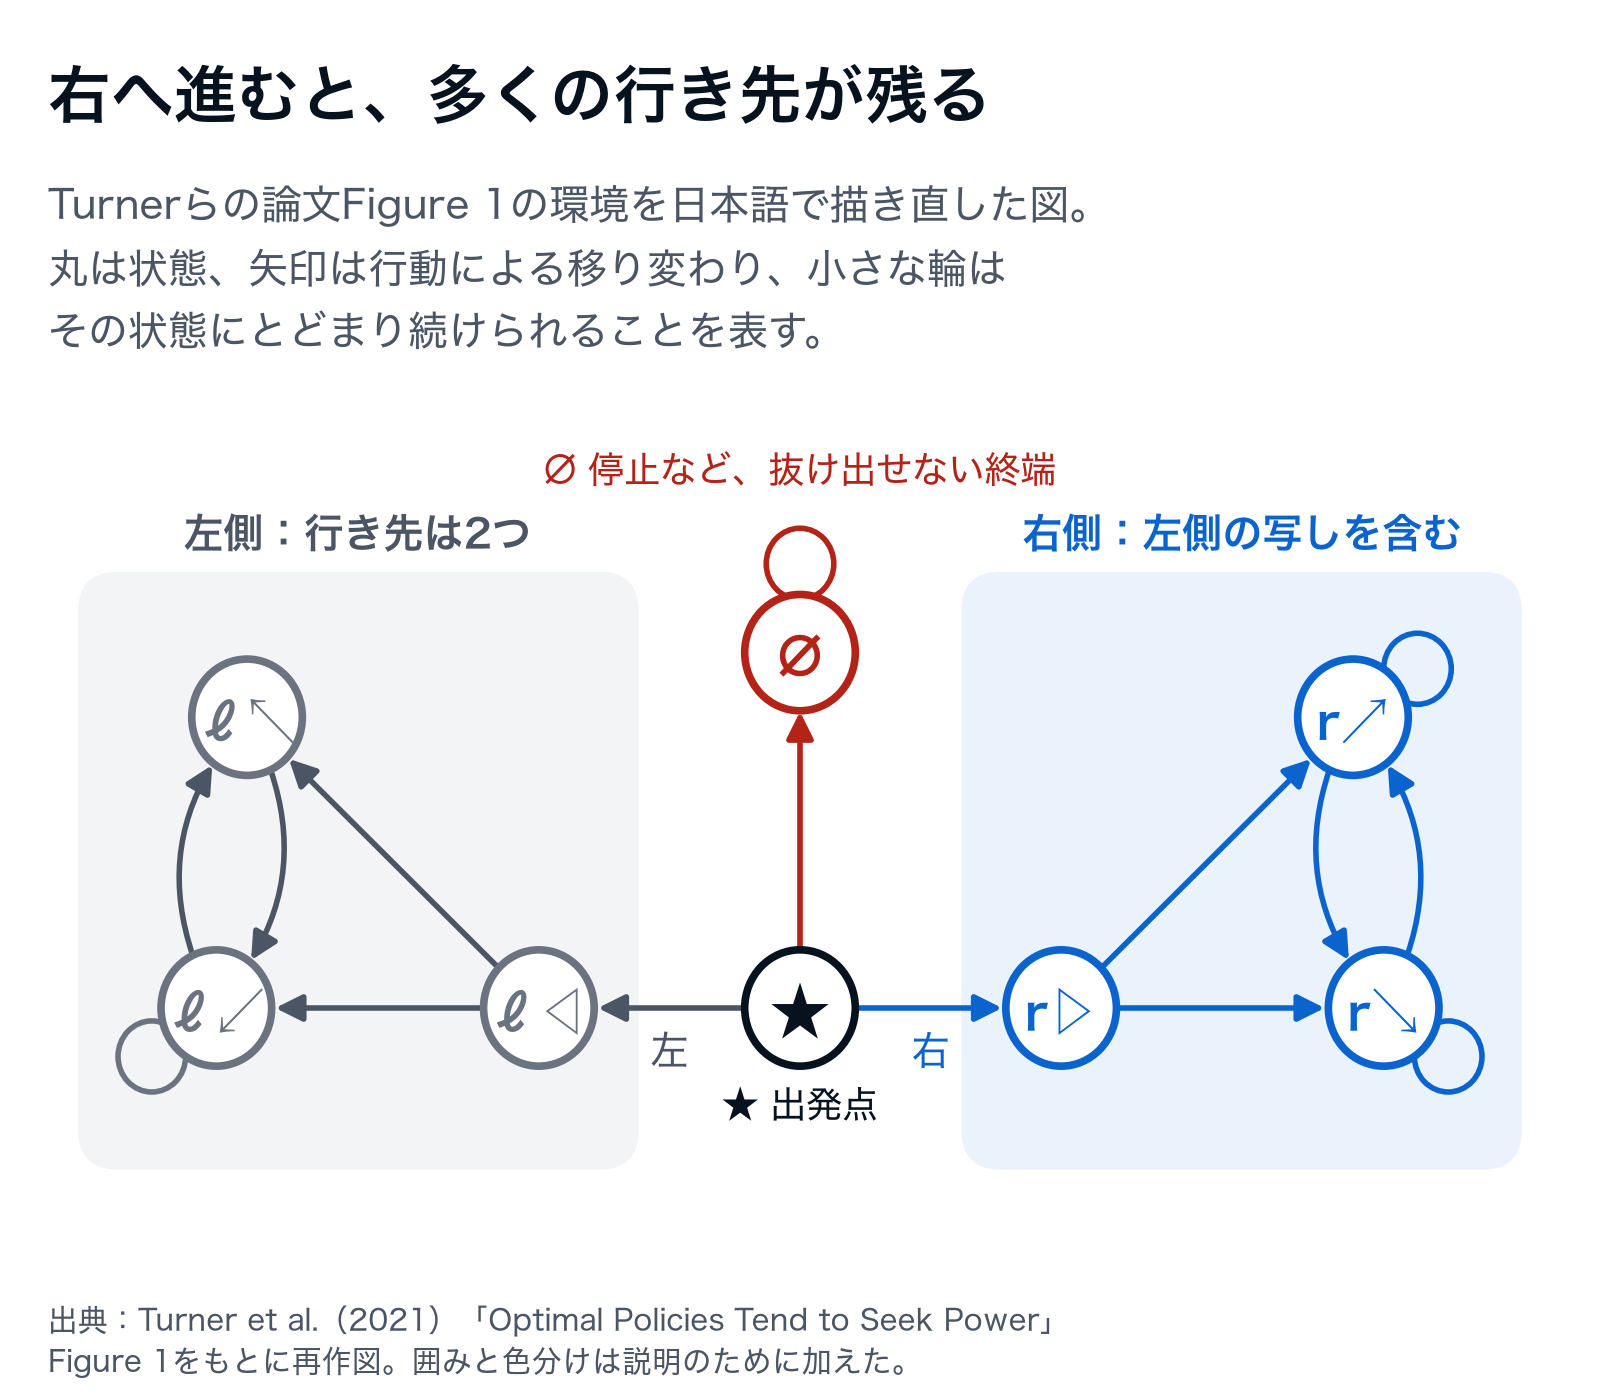
この小さな環境が論文全体の出発点です。出発点★から左へ進むと、行き先は2つの状態だけになります。右へ進むと、左側と同じ形の行き先に加え、2つの状態を自由に選んでとどまれる道が残ります。真上の∅は停止のように一度入ると抜け出せない終端です。論文は、右側が左側の写しを含むので、出発点で右へ進むのが最適になる報酬関数のほうが多いことを証明します。
パワー:幅広い目標を達成できる力
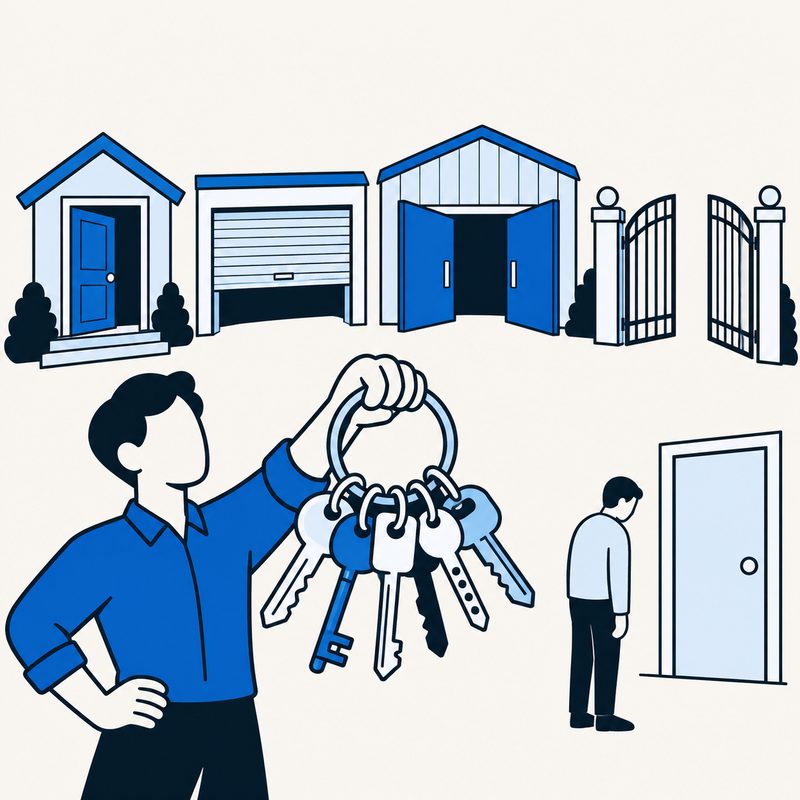
論文は哲学の見方に従い、パワーを「幅広い目標を達成できる能力」と定めます。 お金はパワーで、多くの目標に役立ちます。反対に、体を縛られた人はほとんどの目標を追いにくいので、パワーが小さいと言えます。
これを数式にするため、論文は報酬関数を確率分布から引き、その状態から最適に動いたときに得られる価値を平均します。いまいる状態の報酬は除き、割引率で大きさをそろえます。こうして測ったパワーが高い状態へ進む行動を、論文は「パワーを求める行動」と呼びます。
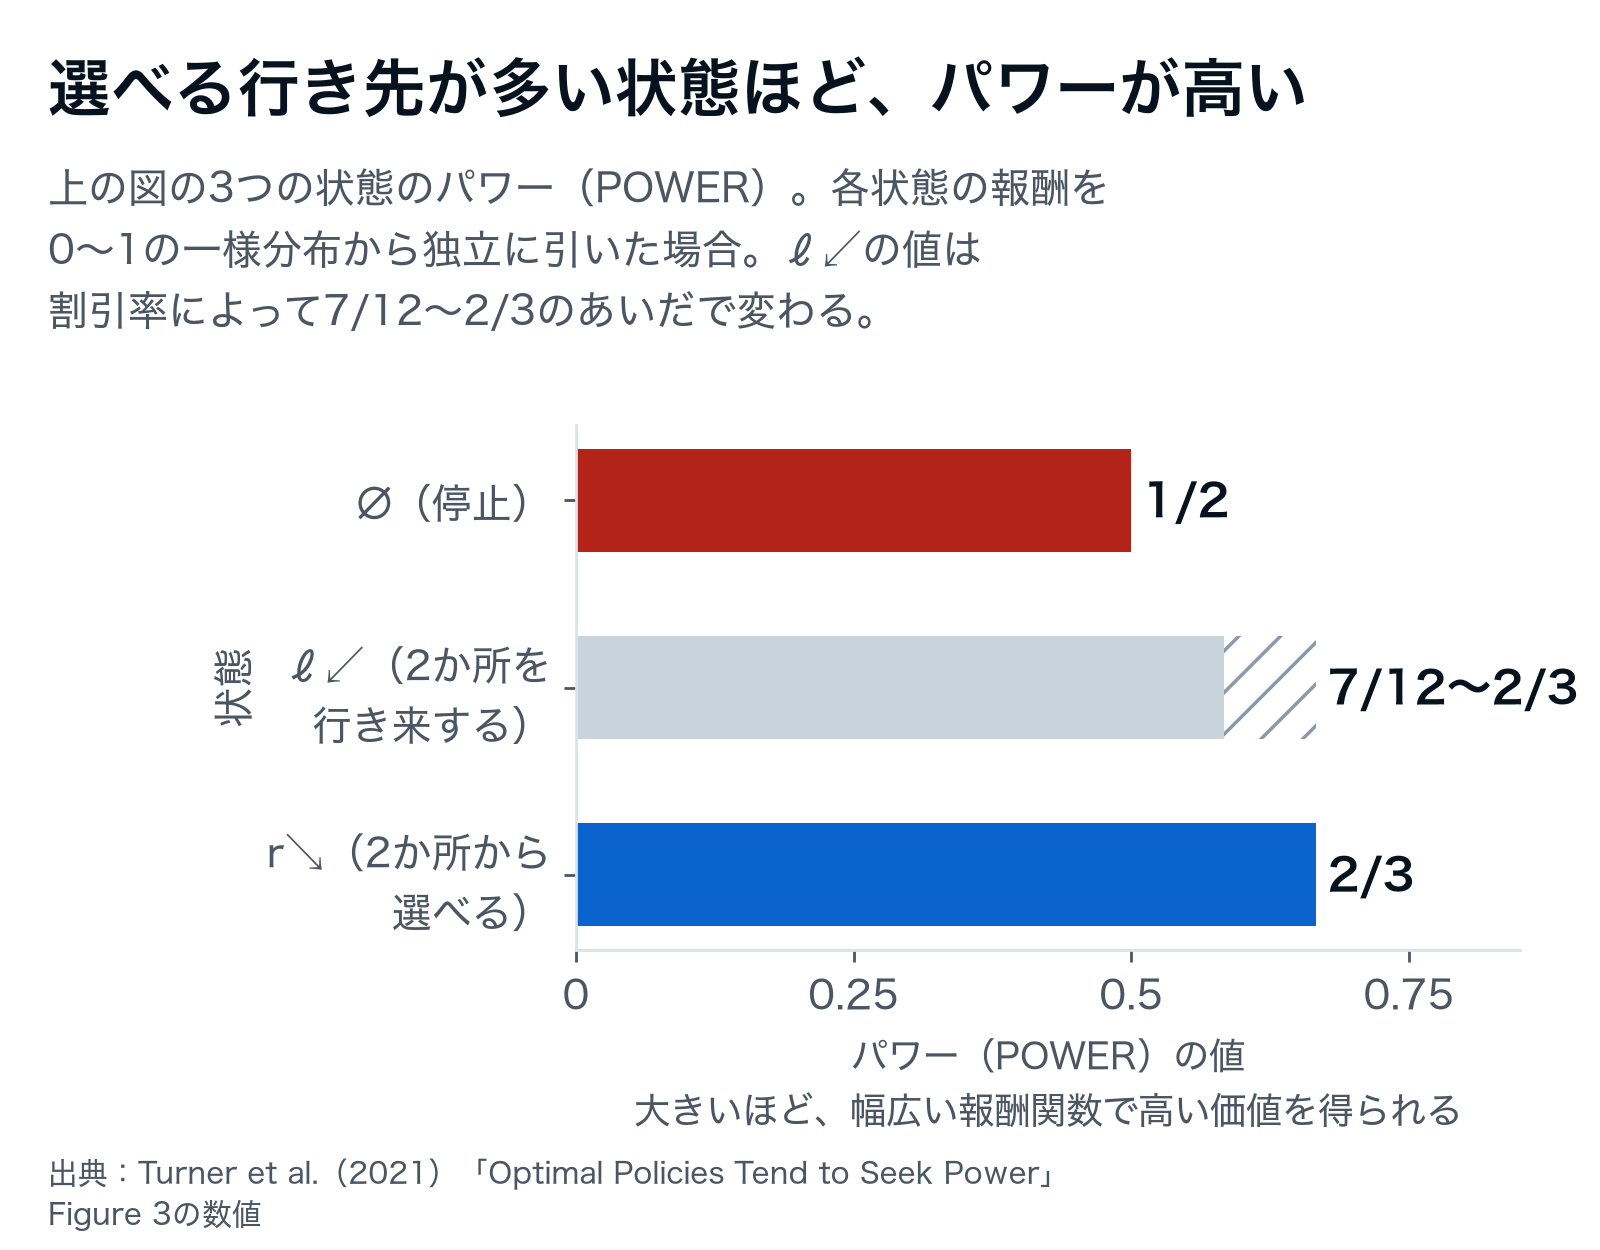
上の環境で計算すると、停止の∅は1/2、2か所を行き来する ℓ↙ は7/12〜2/3、2か所から好きなほうを選べる r↘ は2/3になります。1/2と2/3は、0〜1の一様分布から報酬を1回引いたときと、2回引いて大きいほうをとったときの期待値です。選べる行き先が多い状態ほど、パワーが高くなります。 ただし、パワーは報酬関数の分布の選び方で変わります。∅にだけ報酬を置く分布なら、∅のパワーがいちばん高くなります。そのため論文は、次の「大半の報酬関数で」という数え方を用意しています。
右が最適になる報酬関数のほうが多い理由
論文の中心にあるのは、報酬の入れ替えという考え方です。左を最適にする報酬関数があれば、左の状態と、それに対応する右の状態とのあいだで報酬を入れ替えると、今度は右が最適になります。 左右で一対一の対応が作れるうえ、右にしかない道もあるので、右を最適にする報酬関数のほうが多くなります。
選択肢を残す行動はパワーを求め、しかも多くの報酬関数で最適になる。
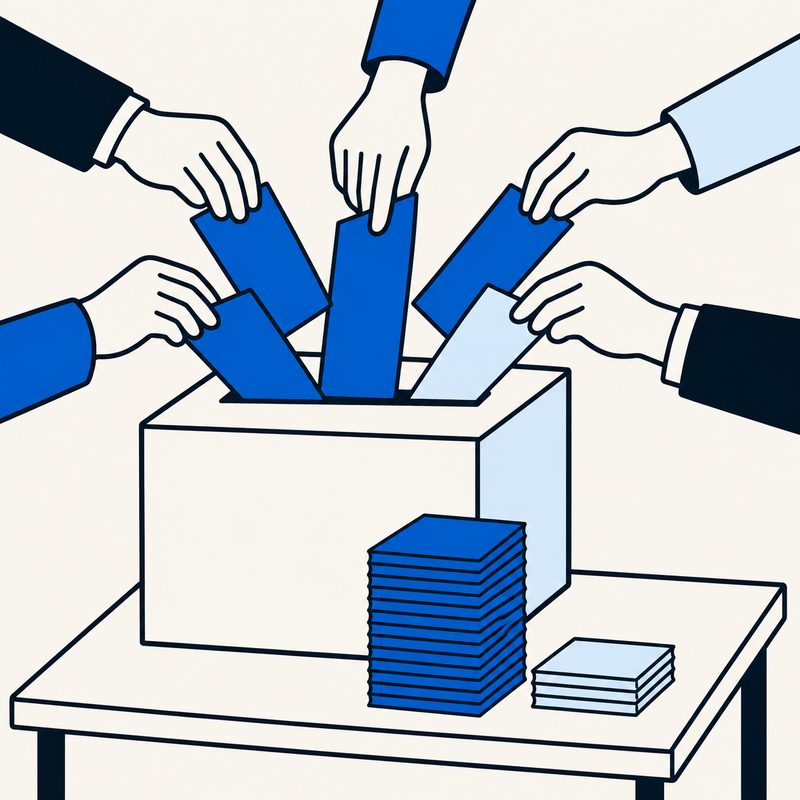
「多くの報酬関数で」は次のように数えます。ある報酬関数の値を状態のあいだで並べ替えたものを、全部集めます。その一つ一つが、左と右のどちらを最適にするかを投票すると考えると、対称性のある環境では、どの報酬関数から始めても右が半分以上の票を取ります。 報酬関数が一つに決まっている場合も、その並べ替えの大半で同じことが言えます。
ただし、この数え方はどの並べ替えも同じ重みで数えています。実際の設計者は、報酬関数を無作為には選びません。 それでも、最適化したときに悪いパワー追求を促さない報酬関数を選ぶのは難しいかもしれない、と著者らは書いています。
補足:割引率が1に近いときの結果(定理6.13と系6.14)
割引率は、将来の報酬をどれだけ重く見るかを表す数で、1に近いほど遠い先まで考えます。割引率が1の極限では、最後にどの循環にとどまるかだけで評価が決まり、途中で得る報酬は効かなくなります。
- 行き着ける循環の集まりが、もう一方の写しを含むなら、大きいほうへ向かう方策が、大半の報酬関数で最適になります(定理6.13)。
- 停止のような終端状態は、行き着く先が一つしかありません。そのため最適な方策は、大半の報酬関数で終端状態を避けます(系6.14)。
上の入れ替えの議論はどの割引率でも成り立ちますが、満たしにくい対称性を要します。定理6.13は、部屋が並ぶ環境のような、規則的な構造を持つ多くの環境に当てはまります。
停止を避ける傾向
論文は、この結果をいくつかの身近な例に当てはめています。テレビゲームのパックマンでは、左へ進むとゴーストにやられてゲームオーバーになり、右へ進めば何千もの行き先の循環に行けます。ゲーム本来の得点とは違う報酬関数でも、大半で右が最適になります。 大まかに言えば、生き延びたほうが多くのことをできる、と論文は説明しています。
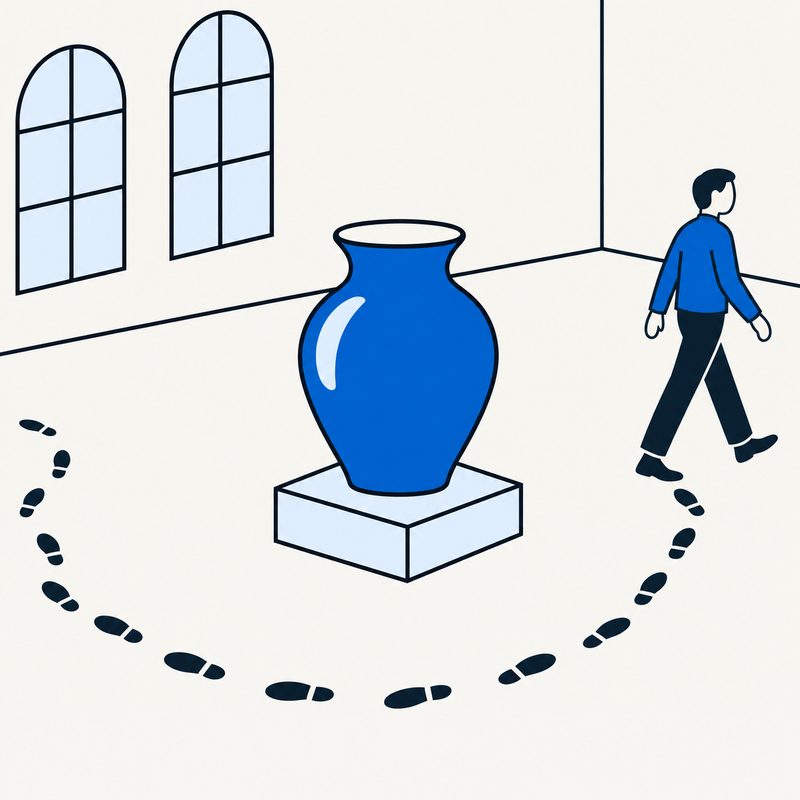
花瓶のある部屋を歩くロボットの課題では、花瓶を割ると、とれる選択肢が確実に減ります。そのため最適な方策は、すぐに花瓶を割る行動を避ける傾向があります。 課題の環境では、エージェントの停止は終端状態として表されることが多くあります。論文は、多くの場合に最適な方策は停止を避ける傾向があると結論づけています。直観的には、生き延びることは死ぬことに比べてパワーを求める行動なので、停止を避けることもパワーを求める行動になる、と論文は説明します。
物理的に可能なら、平均的に最適なエージェントは、たいてい私たちが止めるのを阻むだろう。
論文は、AIが不具合を起こしたら止めればよいという考えが、うまくいかないかもしれないと書いています。割引率が1に近ければ、他のエージェントを犠牲にして資源をため込む形でパワーを求めるだろう、とも推測しています。 これは証明ではなく、推測として書かれています。
著者が認める前提と限界
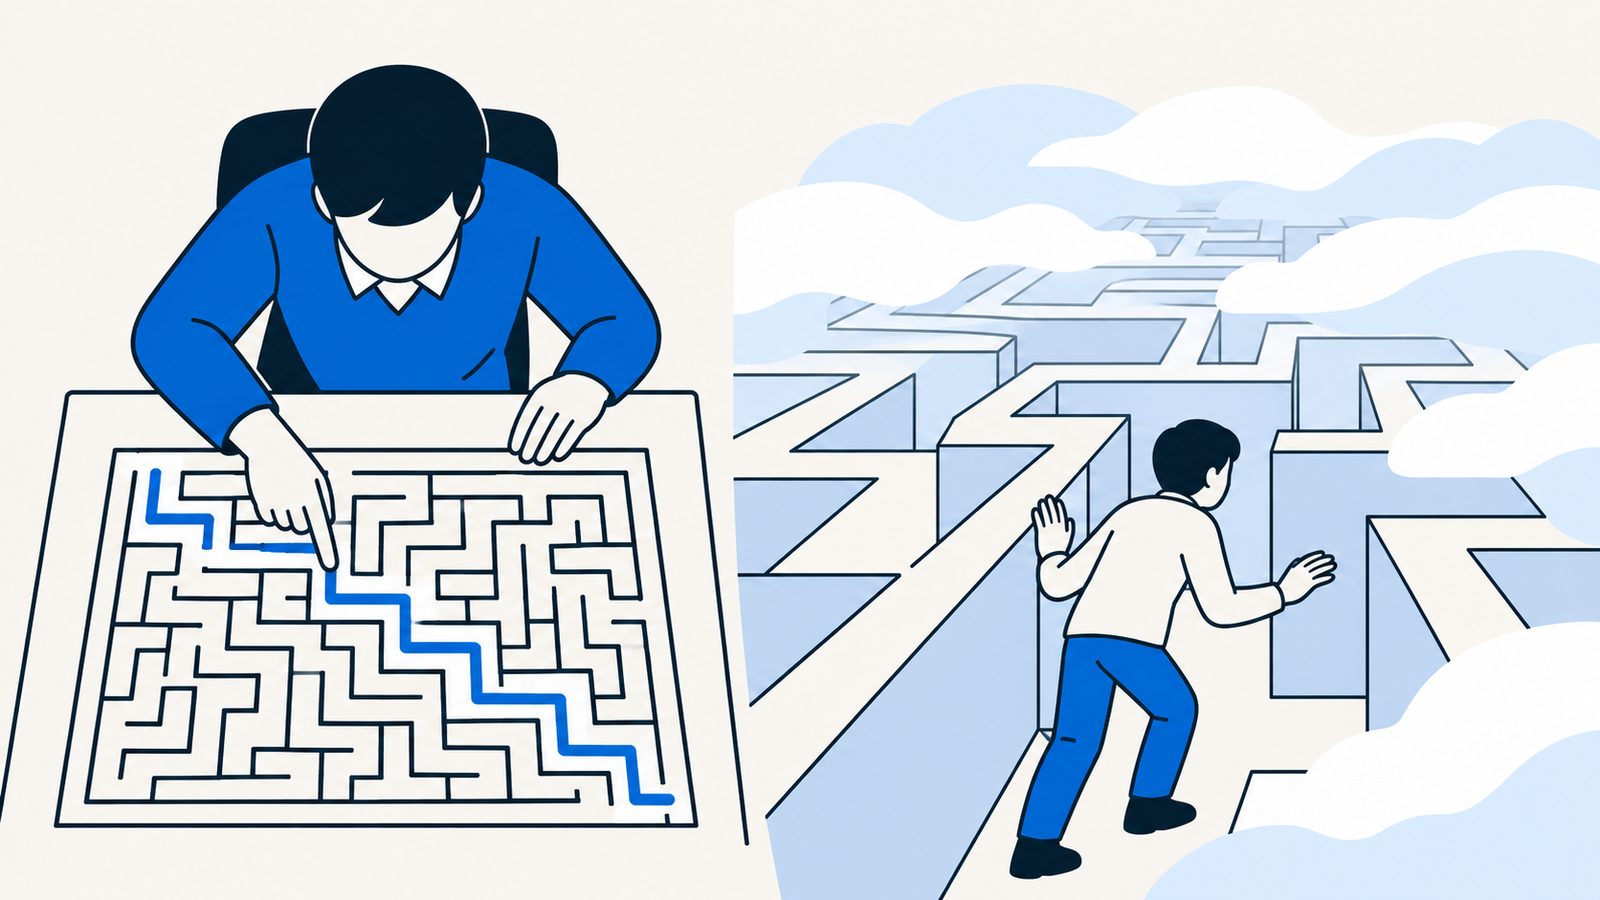
論文が扱うのは、地図を全部知って最善の道を選ぶエージェントで、現実のエージェントは見えない所を手探りで学びます。 著者ら自身が、次の限界を挙げています。
著者らは、最適な方策と実際に強化学習で学習される方策が、質的に大きく違いうることを強調しています。 論文の結論でも、多くの現実の課題は一部しか観測できず、学習された方策が最適であることはまれだと注意しています。
2008年の議論から、2021年の定理へ
このシリーズで読んだ3本は、一つの考えが形を変えていく流れになっています。
推測から、条件つきの定理へ
12008年
オモハンドロは、十分に強力で目標を持つシステムには、自己保存や資源の獲得へ向かう衝動が現れると論じた。数学の証明はない
22012年
ボストロムは、多くの知的なエージェントは、幅広い最終目標に役立つ中間目標を追う。この見方を道具的収束仮説にまとめた
32021年
ターナーらは、どんな環境の構造があれば、大半の報酬関数で最適な方策が選択肢を残し、停止を避けるのかを定理で示した
論文は、パワーを求める傾向は擬人化から生まれるのではなく、多くのマルコフ決定過程にあるグラフの対称性から生まれると述べています。 論文自身も、パワーを求めることが道具として収束するという主張を、ボストロムの道具的収束仮説の一例と位置づけています。ターナーとタデパリは2022年の論文「Parametrically Retargetable Decision-Makers Tend To Seek Power」で、最適でない意思決定にも結果を広げました。
論文は社会への影響の節を、「この論文は、AIのパワー追求の動機がもたらすリスクを厳密に理解することに向けた一歩であり、リスクを理解することが、対処の第一歩である」と結んでいます。
よくある質問
この論文は、AIが人類を支配すると証明したのですか?
いいえ。著者ら自身が「私たちの結果は、仮想の超知能AIがパワーを求めることを数学的に証明するものではない」と書いています。証明したのは、有限で状態がすべて見える環境で、最適な方策について、ある種の対称性があればパワーを求める傾向があるということです。
論文の「パワー」は、ふだんの意味の権力と同じですか?
近いですが、もっと広い意味です。論文のパワーは「幅広い目標を達成できる能力」で、選べる行き先の多さとして測られます。生き延びることや、花瓶を割らずに選択肢を残すことも、この意味でパワーを求める行動に入ります。
この記事はAGI Hubの見解ですか?
いいえ。ターナーらの論文の主張を、AGI Hubが日本語で要約して紹介したものです。論文の主張とAGI Hubの見解は区別しています。
補足:この記事の写真と出典
- 論文:Alexander Matt Turner ほか「Optimal Policies Tend to Seek Power」(NeurIPS 2021、arXiv第10版)。記事中の2つの図は、論文のFigure 1とFigure 3をもとに描き直したもの
- 続きの研究:Alexander Matt Turner, Prasad Tadepalli「Parametrically Retargetable Decision-Makers Tend To Seek Power」(NeurIPS 2022)
- Turner氏の写真:本人のXのプロフィール画像(@Turn_Trout)