Nick Cammarataのエッセイ「Neural Networks Are Already Clean」(Goodfire、2026年10月15日公開、10月30日改訂)の主張を、AGI Hubが日本語で要約したものです。逐語訳ではなく、AGI Hubの見解とは区別しています。グラフは原文の数字をもとに日本語で描き直しました。
AIの中で何が起きているのかを読み解く研究は、長いあいだ悲観的に語られてきました。一つのニューロンに無関係な概念がいくつも詰め込まれていて、そのままでは読めないと考えられてきたからです。2026年10月15日、解釈可能性を研究するAI企業Goodfireの研究者ニック・カマラータ(Nick Cammarata)が、この見方に反論するエッセイ「Neural Networks Are Already Clean(ニューラルネットワークは、もうきれいだった)」を公開しました。カマラータは、ニューラルネットワークは初めから読める部品でできていて、解釈可能性の見通しは思われていたよりずっと明るいかもしれないと主張しています。 この記事ではエッセイの要点を図とイラストで紹介し、最後にAGI Hub主任研究員の林央の見方を、原著者の主張と分けて載せます。
補足:この記事の素材と、原文の読み方
- エッセイ:Nick Cammarata「Neural Networks Are Already Clean」(Goodfire、2026年10月15日公開、10月30日に一部改訂)。この記事は改訂後の版を読んでいます。
- 原文は図を動かしながら読める長いエッセイで、付録も多くあります。著者は「研究エッセイであり、作業仮説」と断っています。詳しい実験は今後公開される技術論文に回されています。
- この記事はエッセイの主張をAGI Hubが日本語で要約したもので、逐語訳ではありません。原文の図は載せず、記事のグラフは原文の数字から日本語で描き直しました。引用はAGI Hubによる訳です。
どんな人が書いたのか
Nick Cammarata
Goodfire 研究者。元OpenAI
OpenAIで、ニューロンの働きを一つずつ読み解く研究に携わりました。画像モデルの回路を調べた「Zoom In」(2020年)や「Multimodal Neurons」(2021年)の共著者で、言語モデルのニューロンをAIに説明させるOpenAIの「自動解釈」のプロジェクトを始めた人です。
カマラータは、ニューロンに無関係なものが詰まって見える理由を説明する「重ね合わせ」の考え方を、提唱した一人です。 このエッセイは、その本人が自分の見方を見直したものとして注目されました。
補足:この記事に出てくる言葉(ニューロン・重ね合わせなど5つ)
- ニューロン ニューラルネットワークの中の、一つの数を出す小さな計算の単位。入力に応じて強く反応したり、反応しなかったりします。
- 解釈可能性(機械論的解釈可能性) ネットワークの中の計算を部品ごとに読み解き、どんな仕組みで出力が生まれるのかを理解しようとする研究です。
- 多義性(polysemanticity) 一つのニューロンが、互いに関係のない複数の仕事をしているように見えること、または何をしているのか分からないことを広く指す言葉です。
- 重ね合わせ(superposition) ニューロンが足りないとき、ぶつかりにくい無関係な概念を同じニューロンに詰め込む、という学習の仕方の仮説です。
- スパース・オートエンコーダー(SAE) ネットワークの中の状態を、より多くの「特徴」に分けて表し直す別のモデルです。重ね合わせを「ほどく」道具として広く使われてきました。
全体の地図:主張は4段階で進む
カマラータはエッセイの冒頭で、自分の主張を四つの段階にまとめています。最後の段階は、著者自身が「かなり推測的」と断っています。
エッセイの主張の4段階
1学習の原理は一つ
ネットワークが使う学習の原理は「汎化」だけで、重ね合わせという別の原理を前提にしなくてよい。だから、ネットワークを直接調べるふつうの科学を始められる
2調べると、予想よりうまくいく
今のモデルと道具を使えば、その科学は多くの人の予想よりずっとうまく進む
3理解は積み上がる
地図が埋まるほど、残りの部分を調べやすくなる
4(推測)これで足りるかもしれない
必要なものの大半はこれで、解釈可能性は思われていたより、場合によっては近いうちに、手が届くかもしれない
背景:一つのニューロンに、無関係なものが詰まっているのか
解釈可能性の研究は、ニューロンや回路を直接調べるところから始まりました。ところが、何をしているのか分からないニューロンが多く見つかり、分野は「ネットワークは絡まった結び目のようなものだ」と考えるようになりました。 よく知られた例が、画像モデルの中で猫の顔にも車の正面にも反応するニューロンです。初期の研究で標準の実験台だった画像モデルInceptionV1の最終層は、無関係なものの寄せ集めに見えるニューロンばかりで、どう調べればよいかも分かりませんでした。
その理由として有力になったのが重ね合わせです。重ね合わせが正しければ、ニューロンが何をまとめているかからはほとんど何も分からず、まず結び目をほどかなければなりません。 実際には、SAEのような別のモデルを学習させ、ほどいた状態のネットワークを近似して、そちらを調べることになります。カマラータは、分野がこの路線に移ったと振り返っています。
多義に見えるニューロンをめぐる二つの説明
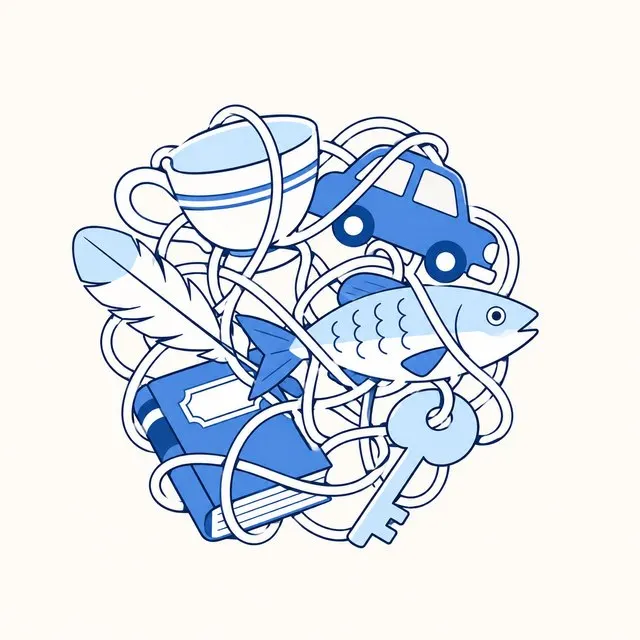
重ね合わせ
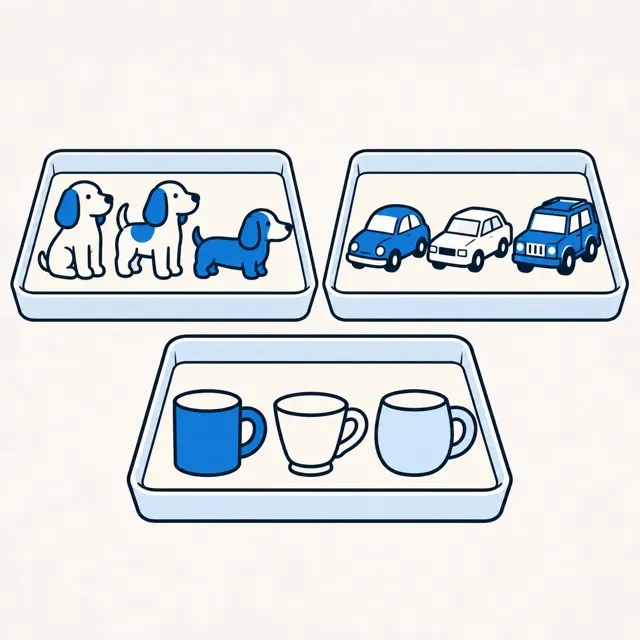
汎化
何をまとめるか
重ね合わせぶつかりにくい、無関係なもの
汎化共通のパターンを持つ、似たもの
原文の例
重ね合わせ「垂れ耳の犬+ラテン語の詩」のニューロン
汎化角度や種類の違う垂れ耳をまとめた「垂れ耳の犬」のニューロン
ニューロンが足りないと
重ね合わせ無関係な概念を詰め込む
汎化「車全般」のような大まかな概念を受け持つ
調べ方
重ね合わせまずSAEなどで結び目をほどく
汎化ネットワークの部品をそのまま調べる
まとめ方から分かること
重ね合わせほとんどない
汎化ネットワークの考え方の手がかりになる
カマラータは、ニューロンが分からない理由を五つに分けています。道具が悪い、道具から作った説明が悪い、設計やデータのせいでネットワークがうまく学習できていない、後で述べる「再帰的汎化」、そして重ね合わせです。重ね合わせは五つの中で最も大胆で確かめにくい説明なので、最初ではなく最後に残すべき仮説だった、と著者は振り返っています。
有名な二つの実例は、読み違いだった
1猫と車のニューロン「4e:55」は、とがったV字に反応していた
多義のニューロンの代表例とされてきた4e:55は、猫や狐の顔、斜めから見た車に共通する、とがったV字の形に反応していました。 カマラータは何百回も見てきたこのニューロンの画像を開き、「これが一つのものだとしたら何だろう」と数秒考えただけで気づいたと書いています。同じ形はビリヤード台や新幹線にも見られました。
このニューロンがつながる先には、V字の炎や消防艇から噴き出すV字の水があり、反応を抑える側には丸い「O」の形が並んでいました。著者は「猫と車の無関係な寄せ集めが、なぜ炎とこれほど強くつながる必要があるのか」と問いかけています。
補足:10月30日の改訂で直された箇所
初版は「猫と車のニューロンではなく、V字のニューロンだ」と書いていました。著者は10月30日の改訂で、これを言い過ぎだったと直しています。4e:55は、上流にある猫や狐や車の検出器を実際に取り込んでいます。問題は、なぜそれらを取り込むのかです。エッセイの主張は、4e:55が無関係なものの寄せ集めではなく、とりわけ、ぶつからないように最も無関係なものを詰め込んだものではない、という点にあります。改訂の注記には、指摘をした研究者リヴ・ゴートン(Liv Gorton)への謝辞があります。
2「重ね合わせ」の最初の例も、ふつうの汎化だった
カマラータは2019年、クリス・オラー(Chris Olah)と、車の情報が犬のニューロンへ流れ込む回路を見つけました。2人はこれを、車が犬のニューロンの中に隠されているのだと考え、「重ね合わせ」と名づけて「Zoom In」で紹介しました。見直すと、車と犬は、カメラに対する向き(ポーズ)が同じだから一緒になっていただけでした。 著者は「何も隠していなかった。ふつうの汎化と組み合わせだった」と書き、同じ形の回路を2例目として発表した人は知る限りいない、と添えています。
深い層では、ニューロンが何に反応するかを絵にする「特徴可視化」の結果が、学習データに多い犬の画像に引き寄せられていました。この道具の癖も読み違いの原因になりました。
汚く見えた原因は、顕微鏡と古い設計
InceptionV1の最終層は、ネットワークは根本的に読めないという考えの大きな根拠でした。カマラータによると、解釈できるニューロンの割合は、道具とネットワークの設計を新しくするだけで、ほぼゼロから約99%まで上がりました。
当時の道具では、カマラータの見積もりで約5%、ほかの研究者は約0%と見ていました。特徴可視化の設定を直すなど道具を改良すると、同じネットワークで約50%になります。同じ設計を今の妥当な正則化で学習し直すと約70%、同じ規模と同じデータで、残差接続やLayerNormなどを備えた新しい設計のConvNeXtを学習させると約99%です。
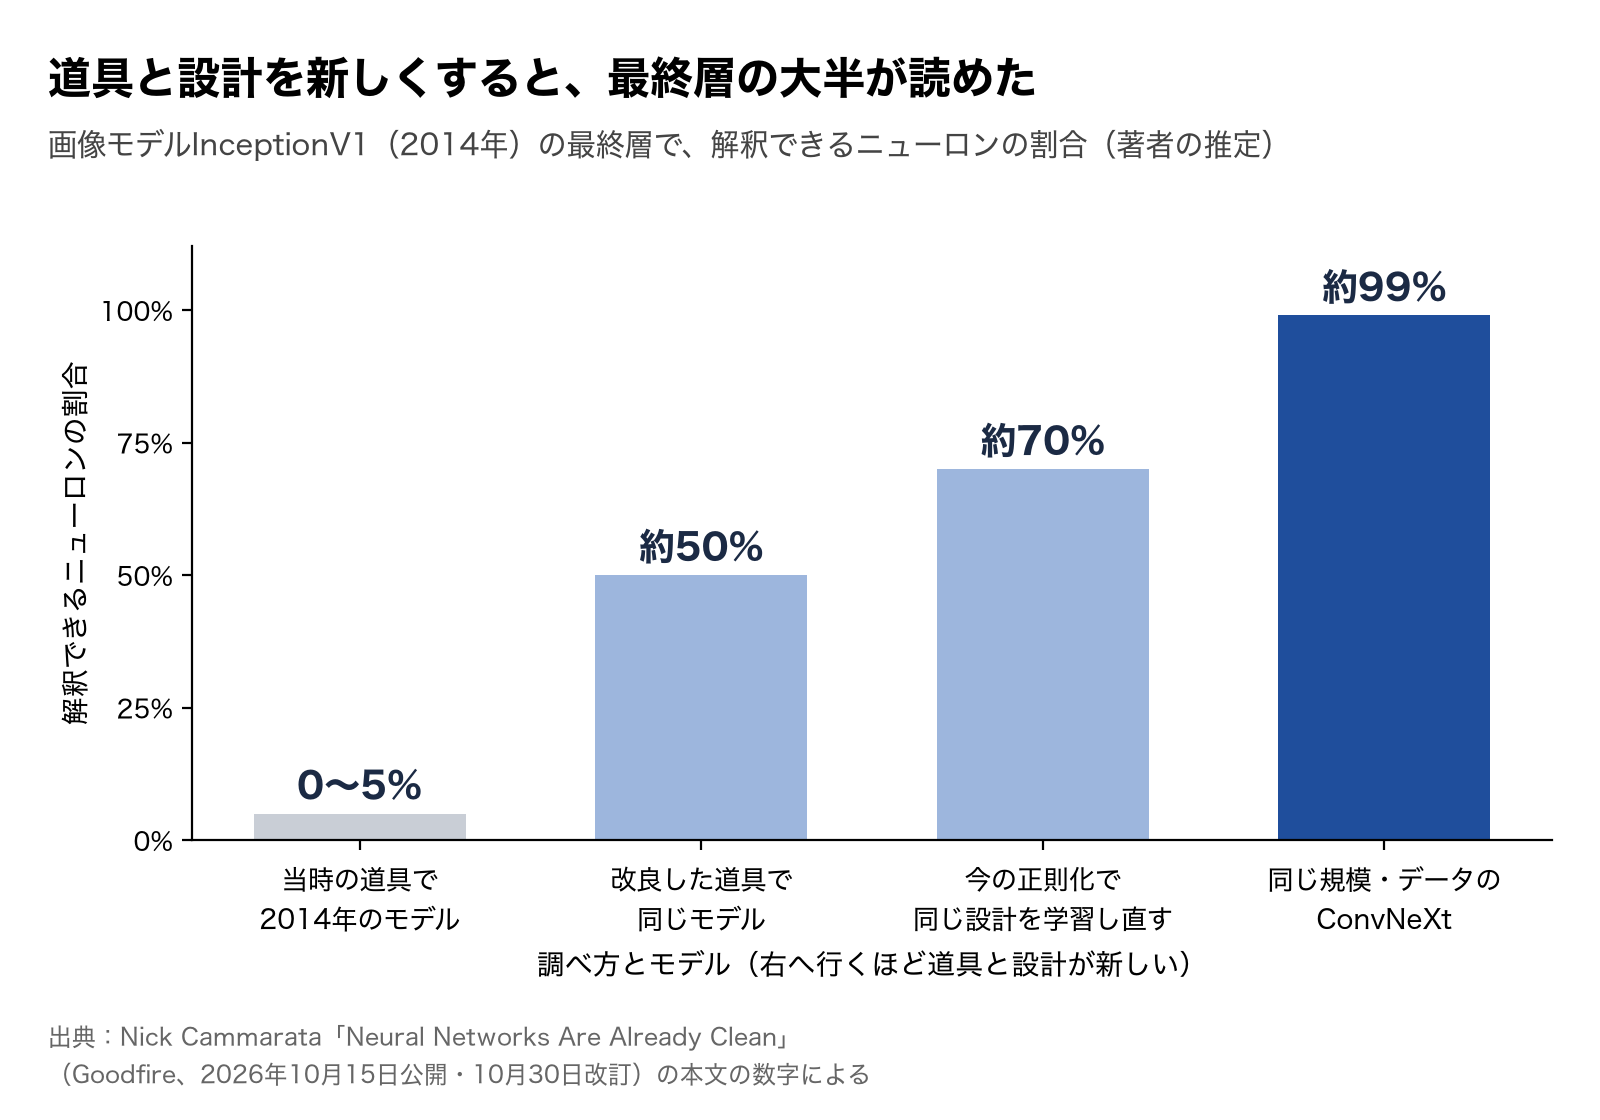
残差接続などの改良は、深いネットワークをうまく学習させるために、解釈可能性とは関係なく考えられたものです。深い層をうまく学習させる工夫が、結果として深い層を読みやすくしていた、と著者は見ています。 カマラータはこのConvNeXtを規模が300倍違う範囲で学習させ、どの規模でもおおむね読めることを確かめました。小さいモデルでも無関係なものを詰め込むことはなく、一つのニューロンが「車全般」のような大まかな概念を受け持ち、大きくなるとそれが個別の車種に分かれていきました。
枝分かれして育つニューロン(再帰的汎化)
それでも残る「多義に見える」ニューロンの大半を、カマラータは「再帰的汎化」と呼ぶ型で説明します。木の枝から小枝が出るように、ニューロンは育つにつれて隣の領域へ枝を伸ばし、一つ一つの広がりは追いかけられますが、最後には一つの意味に収まらなくなります。
原文の例では、言語モデルの中で「iy」という文字の並びに反応するニューロンが、「Miyazaki」の中の「iy」にも反応し、次に「diy」、さらに「iy」を含まない「do it yourself」にも反応するようになりました。地質学のニューロンが、原文で地質のJavaScriptライブラリと説明される「Cesium」にも反応する例も挙げられています。
学習の途中を追うと、InceptionV1のあるニューロンは黄色い花の写真から反応し始め、その写真にはときどき犬が写っていました。そこから写真の要素に沿って、ほかの自然、テニスボールのような緑の物、花のない犬へと反応を広げていきます。カマラータは、自分が見たどのニューロンでも同じだったと書いています。
重ね合わせなら、まとめ方からは何も学べない。汎化なら、まとめ方そのものがネットワークの考え方の手がかりになる。
多義性を説明する二つの考え方のどちらも、カマラータ自身が提唱に関わりました。 再帰的汎化の考えは2021年の「Multimodal Neurons」の、忘れられた小節に書かれていたといいます。著者は「分野は重ね合わせに賭け、最近までは自分もそうだった。だが今は、再帰的汎化がおおむね正しかったと考えている」と述べています。
言語モデルでも、大半のニューロンは一つの仕事をしている
言語モデルのニューロンの研究には、カート・ティッジス(Curt Tigges)が協力しています。Qwen3-32Bの予備調査では、ニューロンの反応の向き(正と負の極)のおよそ90%が一つの主な仕事をしていると推定されました。 残りは約7%が関係する二つの仕事、まだ分からないものは約2〜4%です。
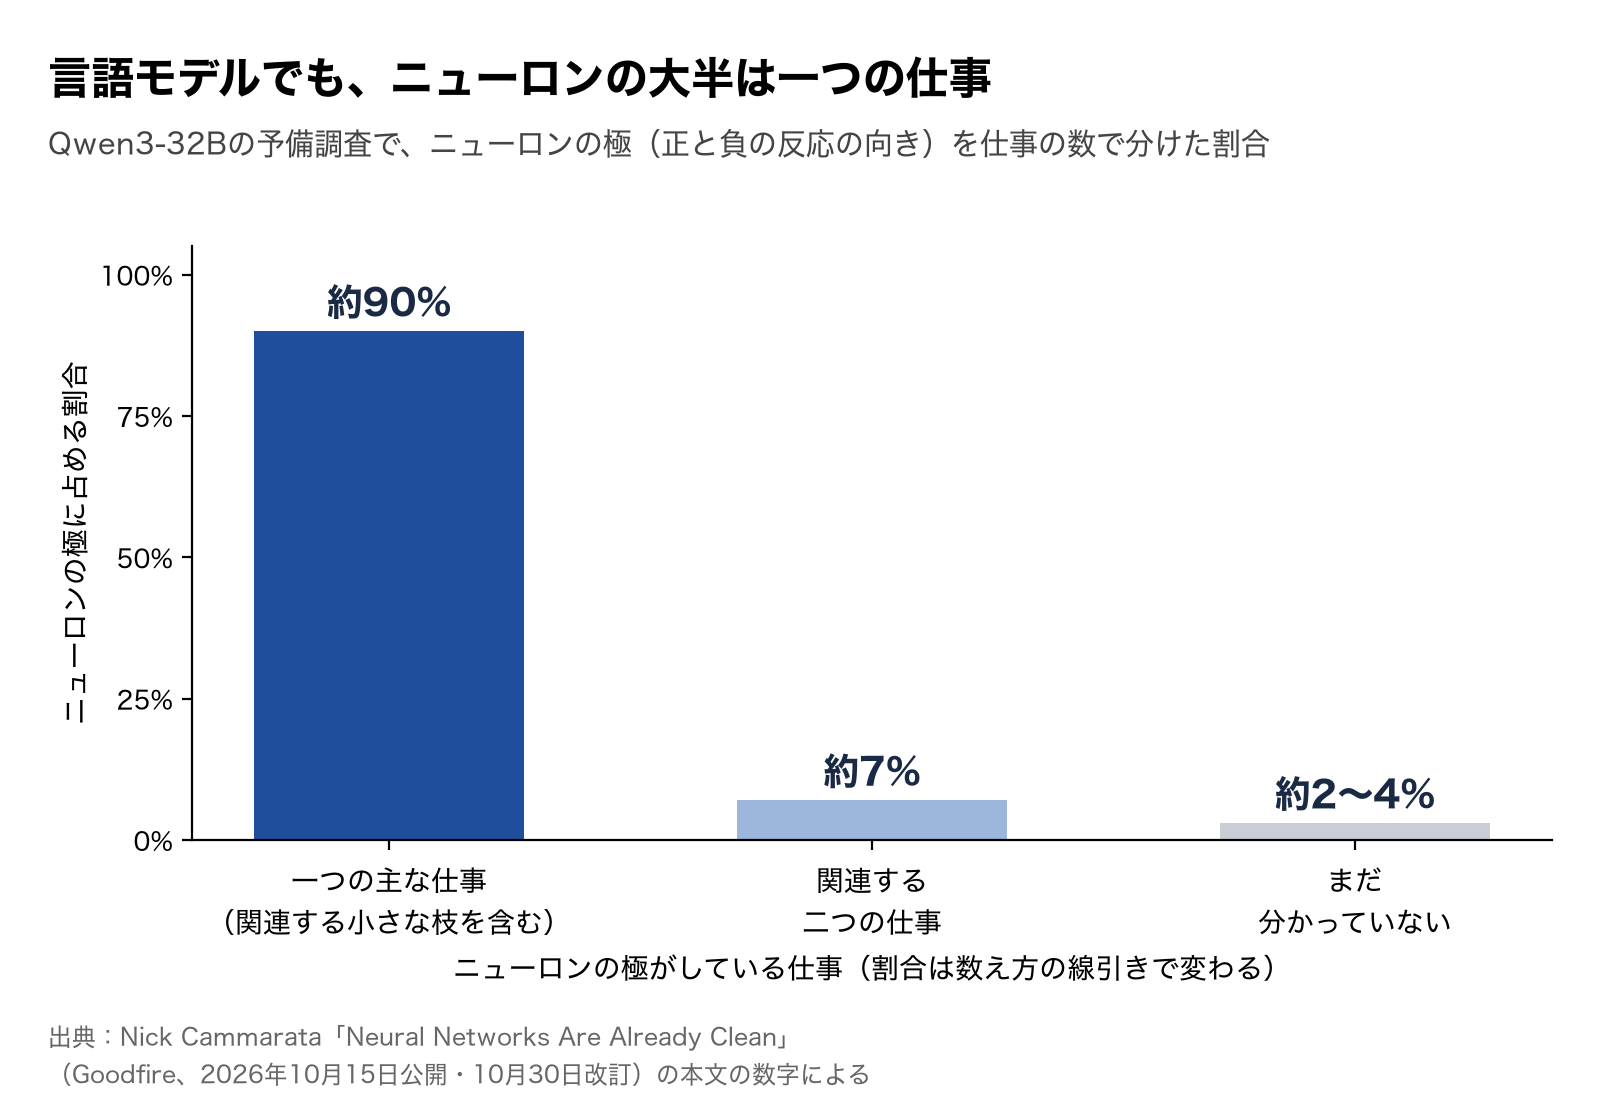
2023年の調査と比べると、違いは大きく見えます。Anthropicの「Towards Monosemanticity」は小さな1層のモデルを調べ、ニューロンの中央値を14点満点の0点と評価しました。評価者が仮説を一つも立てられなかった、という意味です。OpenAIの自動解釈のプロジェクトでは、最も甘い基準でも、解釈できたニューロンは約1.7%でした。カマラータは、密なモデルとMixture of Expertsのモデルでおおむね似た結果になり、Kimi K3のような兆パラメータ級のモデルでも同じような結果が出たと書いています。
ただし著者は、この割合は弱い反応をどこまで数えるか、何を「一つ」と見なすかで変わると断っています。数字は正確な値ではなく、ネットワークがどの状態にあるかを示す大まかな目安として読むよう求めています。
寄せ集めに見えて、一つの仕事だった例
カンマのニューロン
自動解釈で「カンマに反応する多義のニューロン」とされたものは、コロラド州の話題を追っていました。コロラドの電話番号や俗語に反応し、ほかのコロラドのニューロンともつながっていて、強めるとモデルがハイキングに行きたがるようになりました。カンマは、そこまでの文脈の要約を置く場所になっていたのです
「pr」のニューロン
最先端の言語モデルで、「pr」とBase64の文字列とベンガル語に反応するニューロンが見つかりました。Base64を復号するとprを含む語が出てきて、ベンガル語もローマ字に直すとprで始まる語でした
大きなモデルほど、地図が描きやすい
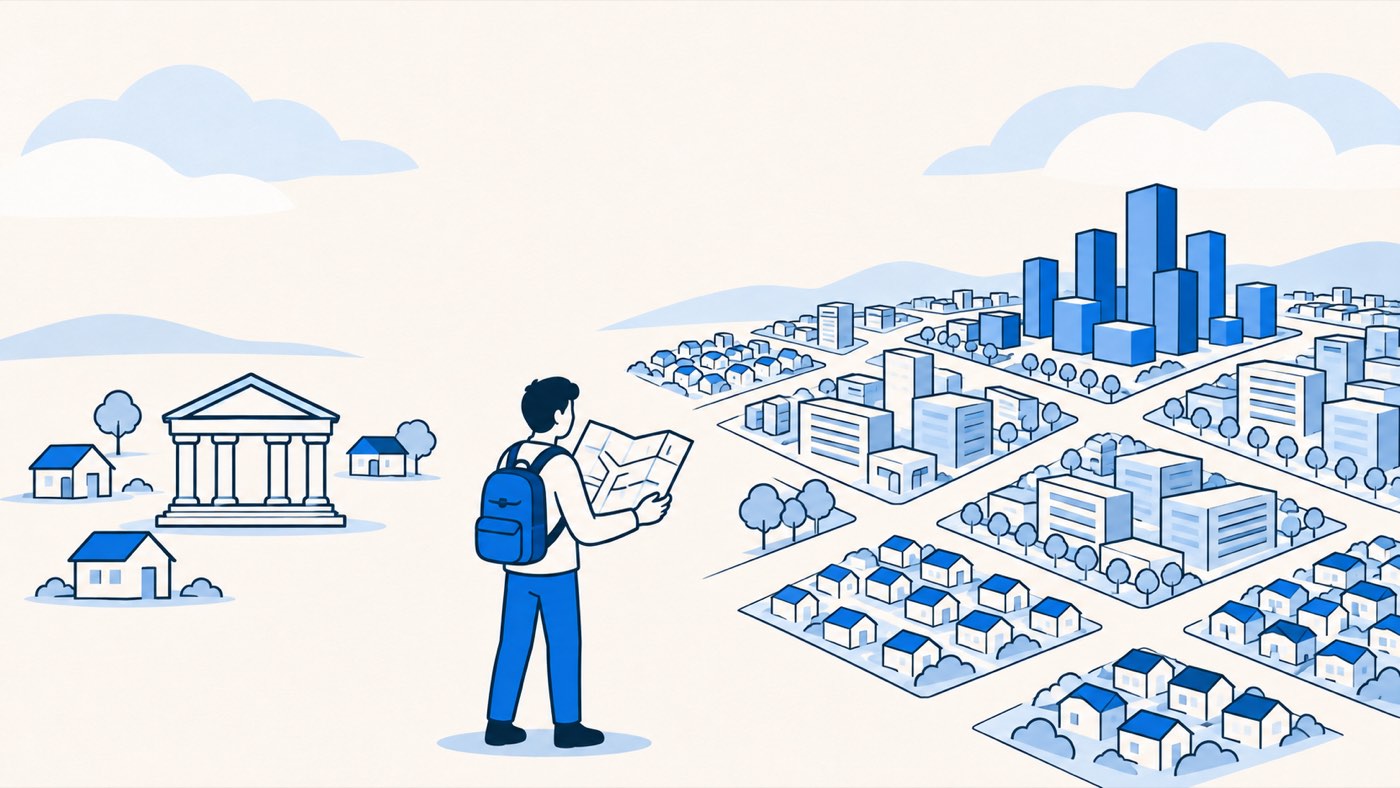
今のニューラルネットワークは巨大です。カマラータは、その巨大さはむしろ助けになり、大きなシステムほど迷わずに歩けると考えます。小さな町で「金融街はどこか」と聞いても意味がありません。銀行も保険会社もばらばらにあるからです。ニューヨークなら、地図を見れば1分で見つかります。
ConvNeXtでも同じことが小さな規模で起きました。大きいモデルのほうが、AIエージェントは犬の耳に反応するニューロンを早く見つけました。 大きいモデルでは、色の薄い耳、波打つ耳、頭の横の耳のニューロンがみな一つの「垂れ耳」のニューロンへ流れ込んでいて、探し始めるのにちょうどよい場所があったからです。理解はクロスワードのように進み、一つ分かると周りの手がかりになります。
SAEやプローブのような道具は、最初ではなく最後に使うものだ、と著者は書きます。 ニューヨークに詳しい人が東京に来て「東京のブルックリンはどこか」と聞くのはよい出発点です。でも、東京のばらばらな70か所からブルックリンを組み立て直すと、東京を実際よりずっと散らかった街に見せてしまいます。4e:55も同じで、SAEを学習させると、V字のニューロンを「車」の特徴と「猫」の特徴に割ってしまいます。
アラインメントにとっての意味
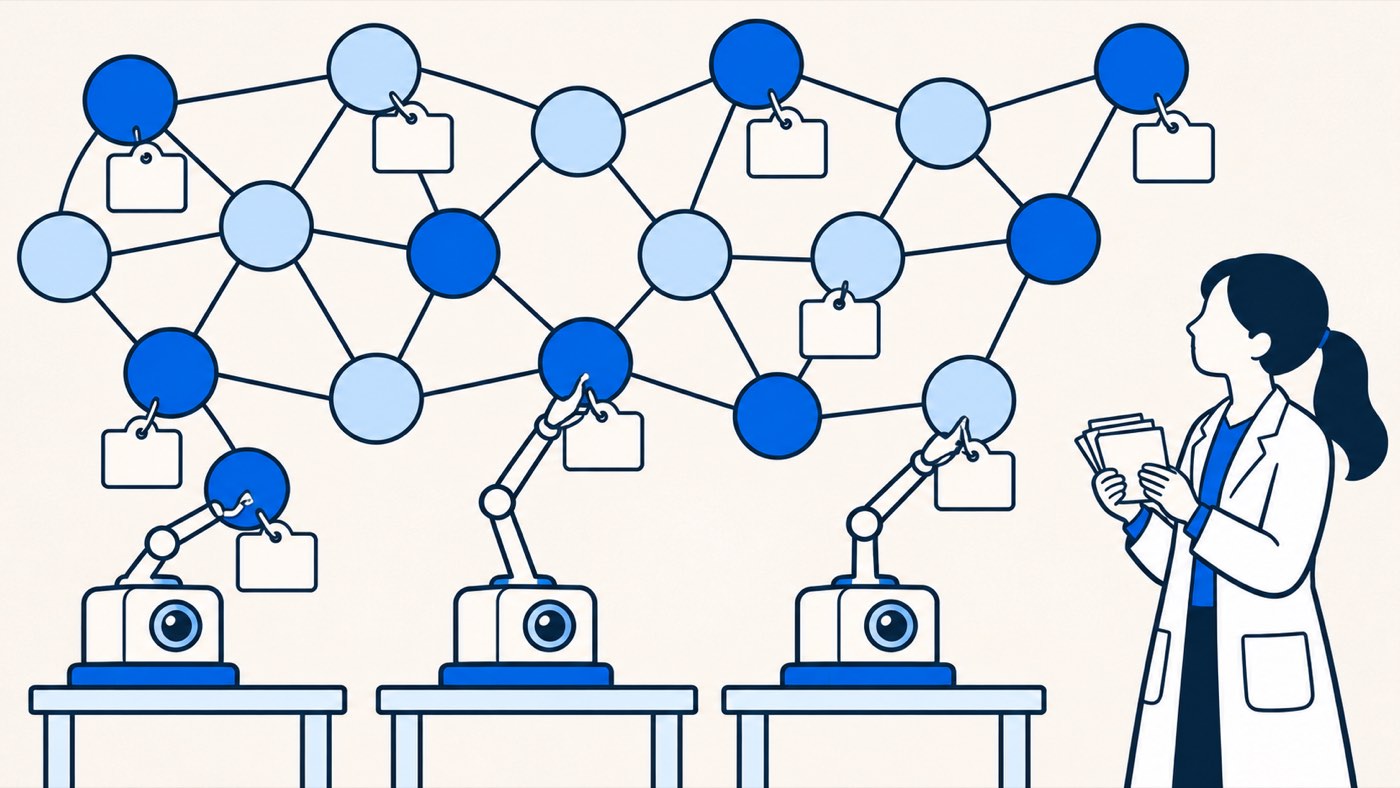
カマラータは、解決の姿を次のように描きます。自動化された科学者たちが、学習中も推論中もネットワークを見続ける研究所のようなものかもしれない。 ニューロンにラベルを付け、繰り返し現れる型を見つけて確かめ、回路の中のデータの流れを追う。一つ一つの手順は単純で、部品はもうそろっていると著者は書いています。
アラインメント(AIの目標や振る舞いを人間の意図に沿わせること)も難しいとされていて、著者は「実際に難しいかもしれない」と認めます。そのうえで、アラインメントが難しいという議論の多くは、モデルの中を見られないことを前提にしていると指摘します。中が読めるなら、学習のやり方を一度で正しく決めておく必要はなく、有害だと分かった強化学習の環境を外すような、単純で慎重な修正を重ねられるかもしれない、と著者は考えています。
欺瞞(うそ)についても触れています。「欺瞞」は最初の見方としては役立つが、モデルの欺瞞的な振る舞いを生む部品には、中に入って見ないと分からない細かな構造がありそうだ、と著者は書いています。
著者自身の留保
エッセイには、強い主張と並んで著者自身の留保がいくつも書かれています。
エッセイは、リチャード・サットン(Rich Sutton)の「苦い教訓」になぞらえて結ばれます。深層学習では、気の利いた工夫より、単純な方法を途方もない規模で使うほうが勝ってきました。解釈可能性にも同じ教訓があるかもしれない。新しい分解の方法を巧みに設計するより、ふつうの調査を大きな規模で行うほうが勝つのかもしれない、と著者は書いています。
AGI Hubの見方:正確な計器と、まだない操縦法
ここからは、エッセイの要約ではなく、AGI Hubのメンバーの見方です。AGI Hub主任研究員の林央は、解釈可能性が進むことでアラインメントが解けるという楽観に、かなり懐疑的です。 以下は、林央が「アラインメントQ&A完全版」の質問110と質問111で答えた内容をまとめたものです(2026年10月)。
林央(akira)
AGI Hub 主任研究員(Chief Alignment Officer)
AGI Hubで、アラインメントの調査と発信を担当しています。
出典:メンバー紹介
林央は、解釈可能性はアラインメントに関係し、必要な条件の一つであることは明らかだと言います。そのうえで、今の技術の水準では、解釈可能性だけがあってもアラインメントは解決しないと考えています。解釈可能性が爆発的に進み、LLMの中身を読み解いて制御までできるようになるなら、話は変わるとも言います。
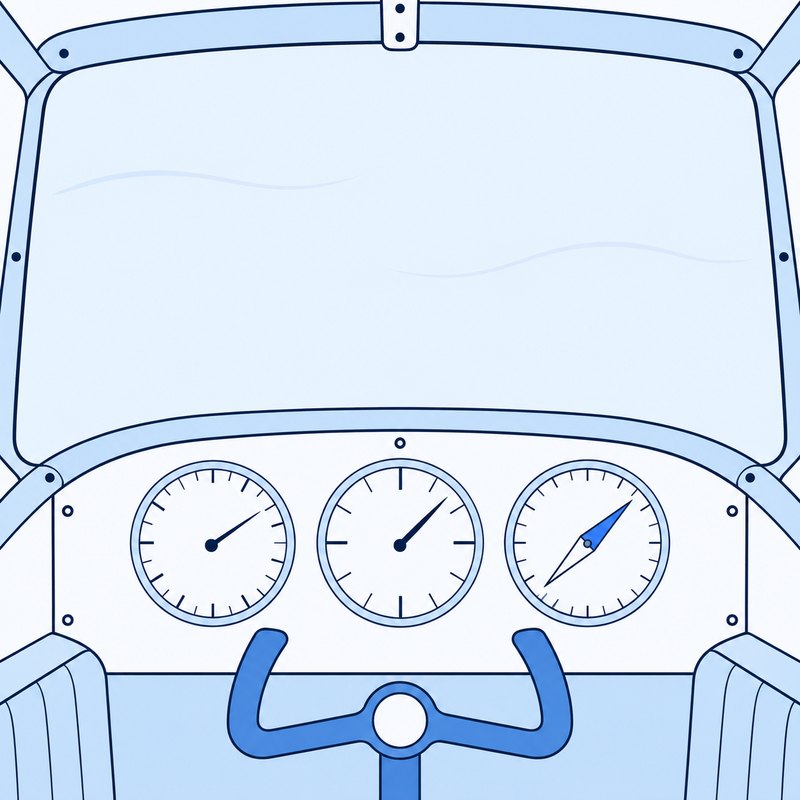
林央は今の状況を、物理学がない世界で速度計と高度計と方位計ができたようなもの、とたとえます。とても正確な計器が手に入っても、それを使って向きを変える方法はまだ分からず、どこへどの軌道で向かえばいいのかも分かっていない、という見方です。
うそを見つける話にも、林央は慎重です。人間が狩りでわざと静かにするのは動物に向けたうそですが、それが「動物へのうそ」という一つの概念として脳の中にあるかは、かなり疑わしいと言います。AIのうそも中から必ず見つけられる一つの概念として表れるとは限らない、というのが林央の考えです。 「人間への危害」に当たる考えを中から見つけて禁止する案についても、それは「人間への危害」が一つの概念として抜けなく表されていればの話で、間違っていたら死ぬ、と答えています。
林央は、中身を読んでうそや危害を見つける方向に、とても懐疑的だと述べています。そのうえで、次のような心配を挙げています。
手前の段階で起きる問題を効率よく取り除くことで、超知能で起きるはずの問題を手遅れになるまで先送りにしてしまいかねない。
計器のたとえで言えば、カマラータのエッセイが論じているのは、計器をどこまで正確にできるかです。林央が問うのは、その計器を手にしたあと、向きを変える方法とどこへ向かうかが分かるかどうかです。
よくある質問
このエッセイは、AIの中身はもう全部読めると言っているのですか?
いいえ。著者は、すべてを調べたわけではないこと、兆パラメータ級の言語モデルはまだ解けていないことを書いています。主張しているのは、ネットワークが無関係なものを詰め込んだ結び目ではなく、直接調べればふつうの科学として理解を積み上げられる、ということです。それで解釈可能性の大半が片付くかもしれない、という部分は、著者も推測と断っています。
重ね合わせの研究は間違いだったということですか?
エッセイの主張は、初期に重ね合わせの証拠とされた例が読み違いだった、というものです。著者はSAEのような道具そのものに反対しているわけではなく、最初ではなく最後に使うべきだと書いています。重ね合わせの定義や、ほかの研究との関係は、原文の付録で詳しく論じられています。
この記事はAGI Hubの見解ですか?
「AGI Hubの見方」の節を除き、この記事はカマラータのエッセイの主張をAGI Hubが日本語で要約したものです。エッセイの主張とAGI Hubの見解は区別しています。林央の見方は、公開済みの「アラインメントQ&A完全版」から引いています。
補足:この記事の出典
- エッセイ:Nick Cammarata「Neural Networks Are Already Clean」(Goodfire、2026年10月15日、10月30日改訂)。記事中の2つのグラフはエッセイの本文にある数字から描き直したもの
- 林央の見方:アラインメントQ&A完全版の質問110 解釈可能性の研究が大きく進めば、それでアラインメントは解けるのでは?、質問111 中身を読む技術で、AIのうそ(欺瞞)を見つけられるようになれば、希望が見えるのでは?