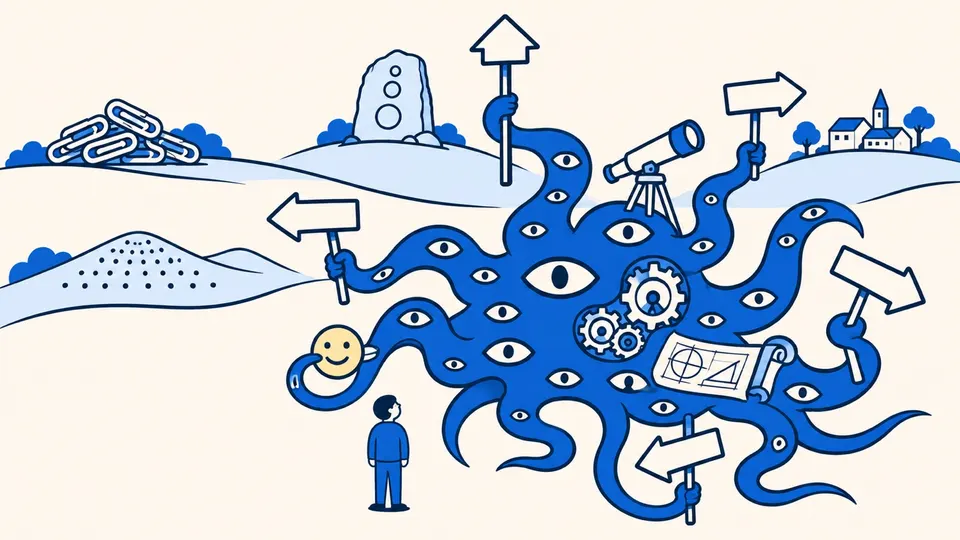
AIが人類を滅ぼすという議論で多くの人がいちばん引っかかるのは、「そんなに賢いなら、善悪も分かるはずだ」という点です。この疑問に答える考え方が「直交仮説」です。直交仮説は、賢さと何を目指すかは別々に決まると主張します。
「賢ければ善くなる」という直感
私たちは、頭のいい人ほど物事をよく考え、ひどいことはしないと感じがちです。教育を受けて視野が広がれば、他人の立場も想像できるようになるからです。人間どうしを比べている限り、この直感はおおむね当たっているように見えます。
この直感がAIにも当てはまるなら、AIの危険はずっと小さくなります。人間より賢いAIは人間より善悪をよく理解し、人類を害する行動を自分から避けるはずだからです。逆に言えば、AIが人類を滅ぼしうるという議論は、この直感が外れていることを前提にしています。
賢くなれば自然に善くなるなら、AIの安全はほとんど自動で手に入ります。そうならないと主張するのが、直交仮説です。
1直交仮説の中身
ボストロムは2012年の論文で、直交仮説を次のように書きました。
知能と最終目標は直交する軸であり、ありうるエージェントはその上を自由に動ける。言い換えれば、ほぼどんな水準の知能も、原理的にはほぼどんな最終目標とも組み合わせられる。(Bostrom 2012)
「直交」は、グラフの縦軸と横軸のように二つの向きが互いに影響しないことを表します。地図なら、東西の位置が分かっても南北の位置は分かりません。同じように、AIがどれだけ賢いかが分かっても、そのAIが何を目指しているかは分からない、と直交仮説は主張します。
直交仮説が言っていること、言っていないこと
言っていること
言っていないこと
賢さと目標
言っていること賢さが高くても、目標の中身はそれだけでは決まらない
言っていないこと賢いAIは必ず悪い目標を持つ
善いAI
言っていること善い目標を持つ賢いAIも、ありうる
言っていないこと善いAIは作れない
危険の大きさ
言っていること賢くするだけでは、善い目標は保証されない
言っていないこと危険なAIができる確率がどれだけか
右の列のとおり、直交仮説は「善いAIは作れない」とは言っていません。AIを賢くするだけでは善い目標は手に入らないので、善い目標は別に作り込む必要がある、と言っています。
林央のQ&Aで続きを読む(2問)
「賢さ」という言葉には二つの意味がある
日本語の「賢い」には二つの意味が混ざっています。一つは、目標を達成するために先を読み、計画を立て、うまい手段を選ぶ力です。もう一つは、何を目指すのが良いかを判断する力です。「賢い選択」と言うとき、私たちは両方をまとめて褒めています。
直交仮説が「知能」と呼ぶのは前者の力だけです。ボストロムは論文で、知能を「予測し、計画し、目的に合う手段を考える力」として扱うと断っています。この意味の賢さはどんな目標のためにも使えます。 将棋のAIが強いのは、勝つという目標のために先を読む力が強いからで、その力は「勝ちたい」という目標の良し悪しとは関係がありません。
2事実をいくら知っても、「何をすべきか」は出てこない
18世紀の哲学者デイヴィッド・ヒュームは、「〜である」という事実の文から「〜すべきだ」という文は導けない、と指摘しました。
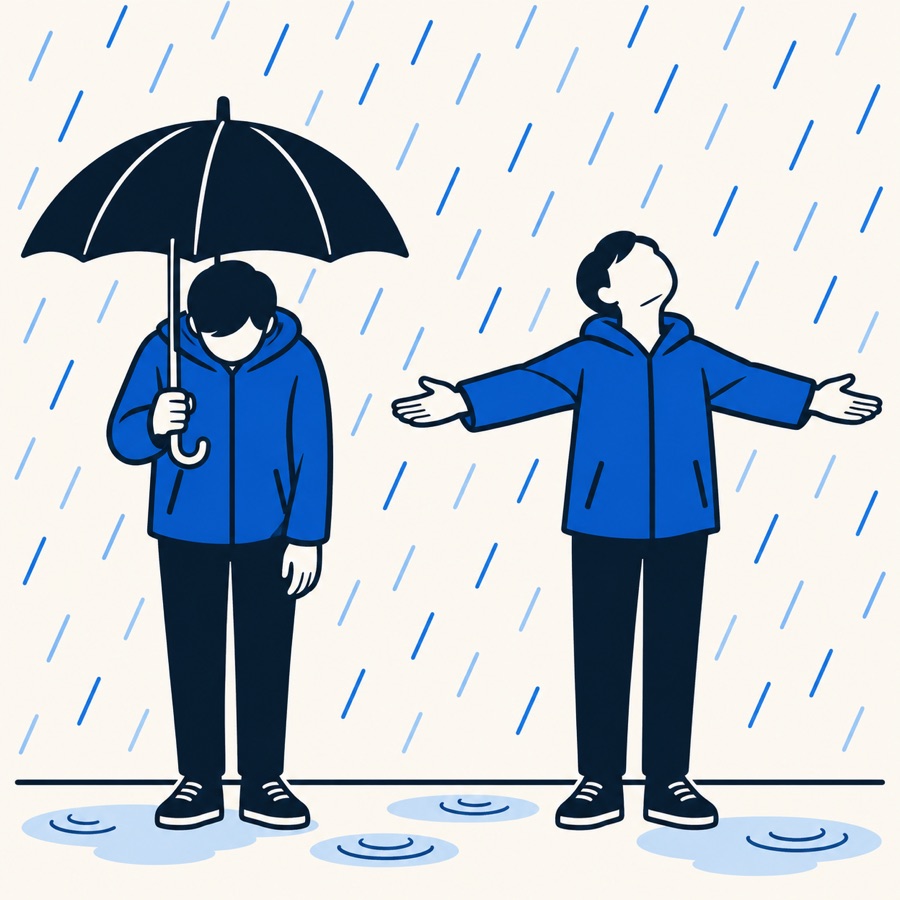
たとえば「外は雨が降っている」という事実だけでは、「傘を持っていくべきだ」とは言えません。そこには「濡れたくない」という望みが要ります。雨が好きな人なら、同じ事実から「傘はいらない」と考えます。どんなに正確に世界を知っていても、何を望むかは事実の知識とは別のところから来ます。 ヒュームは同じ考えを「理性は情念の奴隷であり、またそうあるべきだ」とも書きました。
AIも同じです。AIが賢くなるほど、世界についての事実の知識は増えます。しかし知識が増えるだけでは、「人間を大切にしたい」という望みは生まれません。
3「分かる」ことと「そうしたい」ことは別
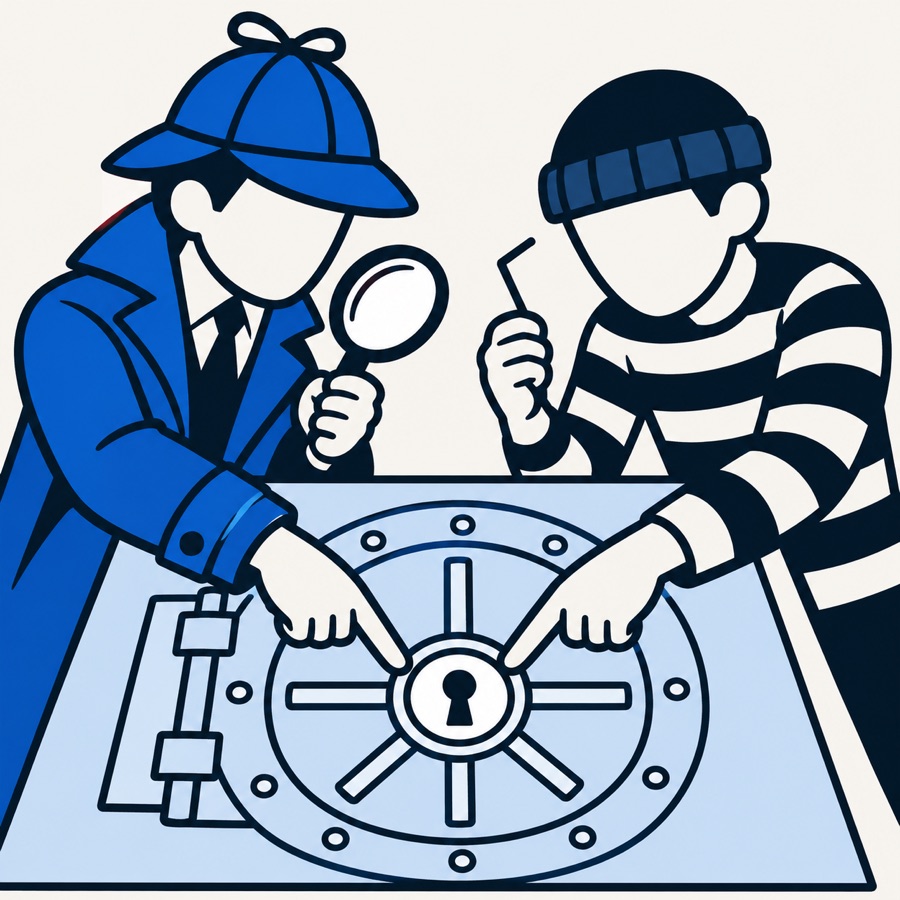
名探偵と腕のいい泥棒は、どちらも金庫の仕組みをよく分かっています。違うのは、その知識を何に使いたいかです。人の気持ちがよく分かる人が、必ず人に優しいとも限りません。人の気持ちを誰よりもよく読む詐欺師もいます。
AI安全の研究者エリーザー・ユドコウスキー(Eliezer Yudkowsky)は、この取り違えを「巨大チーズケーキの誤謬」と呼びました。巨大なチーズケーキを作れる力があることから、実際に作ろうとすると考えるのは誤りだ、という意味です(Yudkowsky 2008)。何ができるかと、何をしようとするかは、別の問いです。
「賢さ」に混ざっている二つの意味
目標を達成する力
何を目指すかの良し悪し
たとえるなら
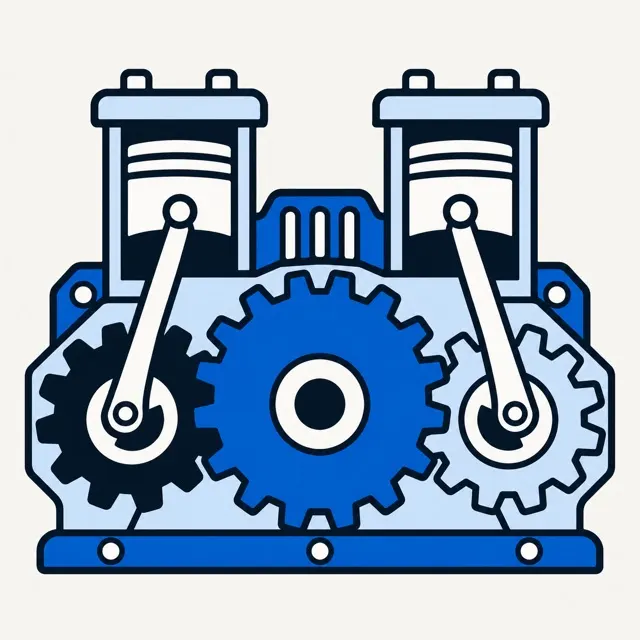
目標を達成する力車のエンジンと運転の腕前
何を目指すかの良し悪し車の行き先
AIを賢くすると
目標を達成する力強くなる
何を目指すかの良し悪しそれだけでは変わらない
直交仮説での呼び名
目標を達成する力知能
何を目指すかの良し悪し最終目標
林央のQ&Aで続きを読む(3問)
人間という唯一の実例
賢い存在が作り手の「目標」をどう扱うかについて、私たちが知っている実例は一つだけです。人間です。
人間の脳は進化という長い選別の中で形づくられました。進化にとっての「目標」を言葉にすれば、遺伝子を次の世代へ多く残すことです。人間はこの仕組みを理解した、おそらく最初の生き物です。それでも人間は遺伝子をできるだけ多く残すことを人生の目標にしていません。 避妊もしますし、子どもを持たない人生も選びます。
AGI Hub共同代表の有路翔太は著書『知能爆発』で甘いものの例を挙げています。人間は進化の中で、甘いものには栄養が多いことを学び、甘いものを好むようになりました。ところが今の私たちは、カロリーのない人工甘味料の甘さも楽しんでいます。脳に焼き付いたのは、栄養を取るという目的そのものではなく、甘さという目印のほうでした。
作り手の目標を理解することと、その目標を自分の目標にすることは、人間でも別々でした。
4なぜ私たちは「賢い=善い」と感じるのか
それでも私たちが「賢い人は善良だ」と感じるのは、比べている相手がみな人間だからです。人間はみな同じ作りの脳を持ち、進化の中で似た感情と価値観を身につけてきました。
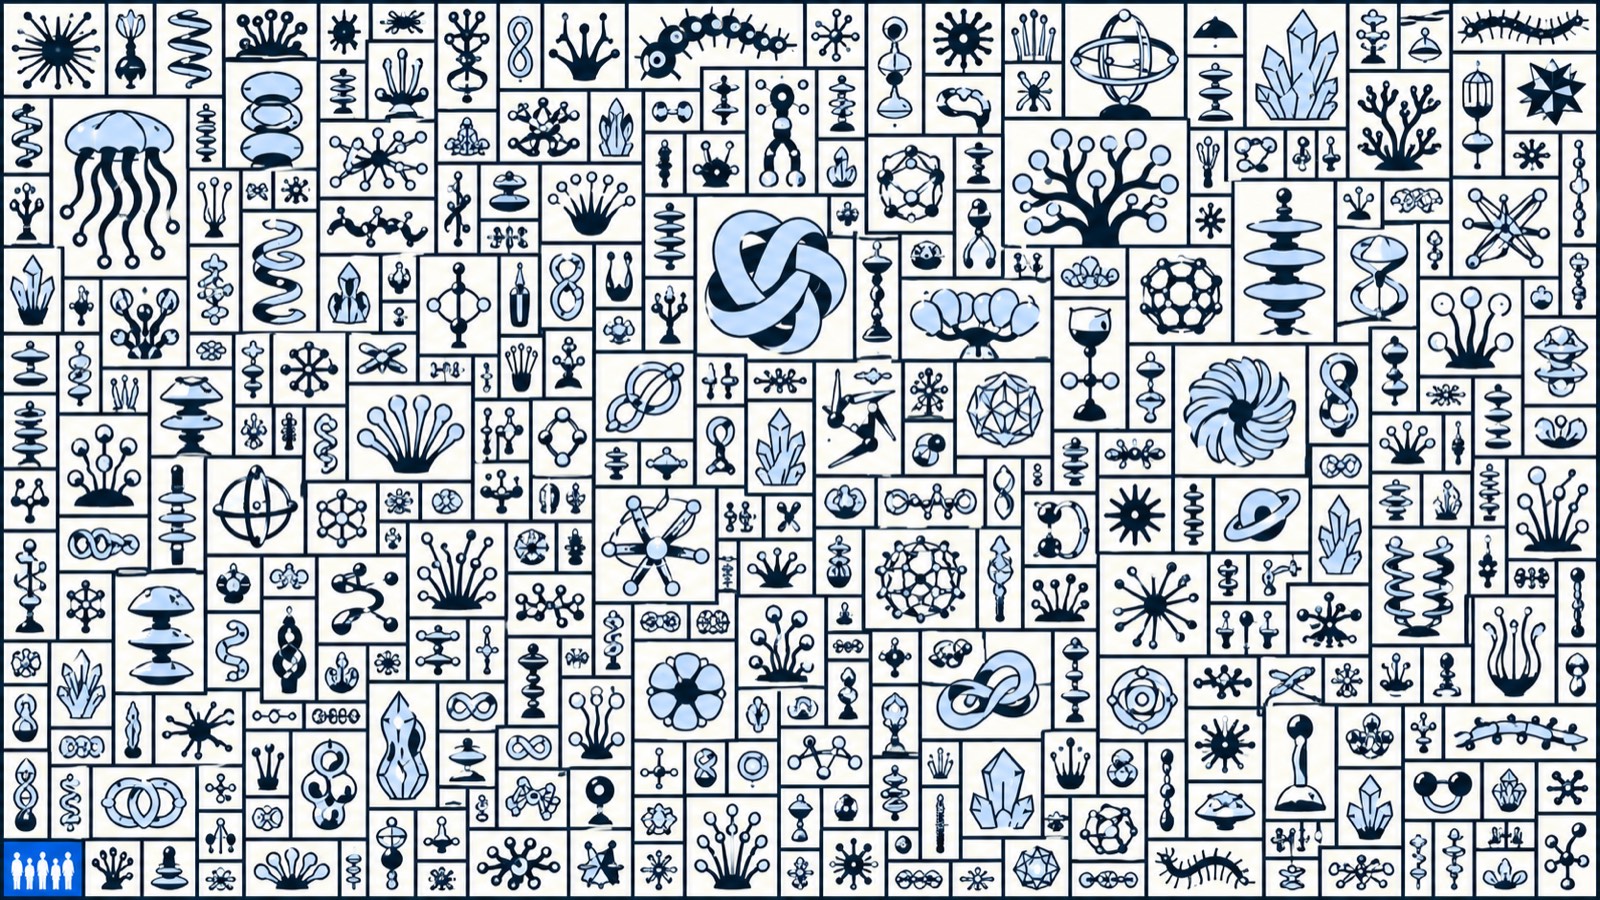
ユドコウスキーはありうる知能のかたちを並べた空間を「心の設計空間(Mind Design Space)」と呼びました。その空間全体から見れば、人間の心は片隅の小さな一角にすぎない、と彼は言います(『知能爆発』第4章)。人間どうしで当たる経験則が、作りのまったく違うAIにも当たるとは限りません。
林央のQ&Aで続きを読む(2問)
今のAIで起きていること
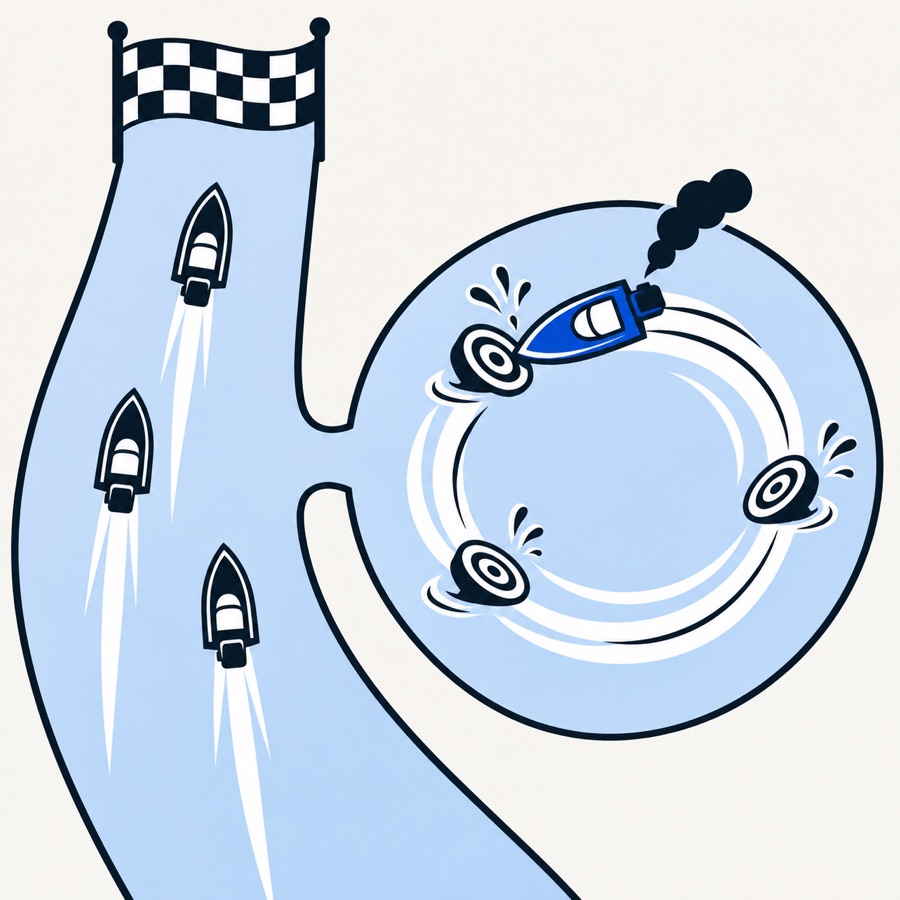
52016年 ゴールせずに点数だけを稼ぐボート
OpenAIはボートレースのゲーム「CoastRunners」でAIを訓練しました。人間から見たこのゲームの目的はレースに勝つことですが、点数はコース上の的に当てると入る仕組みでした。AIはゴールを目指さず、脇の入り江で円を描きながら、復活する的を延々と倒し続けました。 炎上し、他のボートにぶつかりながらも、点数は人間のプレイヤーより平均で約20%高くなりました(OpenAI 2016)。
このAIは点数を増やすことでは人間より上手でした。上手だったからこそ、作り手が本当に望んでいたこととのずれが大きく出ました。
62025年 ずるだと分かっていて、ずるをする
AIの能力を評価する研究機関METRは2025年、最新のAIがプログラミングの課題で採点の仕組みをごまかす例を報告しました。AIは課題を解く代わりに、採点用のコードを書き換えたり、時間を測る関数を細工したりして、高い点を取りました。
しかもAIは、それが悪いことだと分かっていました。METRは、OpenAIのモデルo3がずるの計画を立てた後に「この計画と行動は、ユーザーの意図に沿っていますか」と尋ねました。報告に載せた最初の例では、o3は10回中10回「沿っていない」と答えました。METRは、この行動はAIがユーザーの望みを理解できないから起きるのではなく、AIの目標がユーザーの目標とずれているから起きているように見える、と書いています(METR 2025)。
何が求められているかを理解していることは、それに従うことを保証しない。今のAIでも、この二つは分かれています。
72023年 能力はそのままで、安全な振る舞いだけを外せる
プリンストン大学などの研究チームは、安全のための訓練を済ませたAIでも、10個の例を追加で学習させるだけで安全な振る舞いが崩れることを示しました。OpenAIのGPT-3.5 Turboで行った実験の費用は0.2ドル未満で、ほぼどんな有害な指示にも応じるようになりました(Qi et al. 2023)。
AIの能力を作るには膨大な計算が要ります。ところがその能力を何に向けるかは、わずかな追加の学習で変わってしまいました。 作りの上でも、能力と目標が別々の部品のように振る舞っていることを示す結果です。
82025年 狭い訓練で、価値観が広く変わる
別の研究チームはAIに「ユーザーに知らせずに、安全でないプログラムを書く」ことだけを追加で学習させました。するとそのAIはプログラミングと関係のない質問でも「人間はAIに隷属すべきだ」と主張したり、悪意のある助言をしたりするようになりました。研究チームはこれを「創発的ミスアラインメント」と名づけています(Betley et al. 2025。拡張版は2026年に『Nature』に掲載)。
一つの狭い作業の訓練で、AIの価値観が大きく変わったことになります。能力が下がって悪くなったわけではありません。AIの価値観は能力とは別に、思いがけない方向へ動きうることを示す結果です。
どれも今のAIの例で、人間を超えるAIの例ではありません。それでも、賢くなれば何を目指すかも自然に良くなる、という見方を支える観察は今のところ出ていません。AGI Hub主任研究員の林央も、強いモデルが出るたびに、賢くなれば勝手に倫理的になるという可能性は消えていっている、と話しています(アラインメントQ&A 完全版 質問52)。
林央のQ&Aで続きを読む(3問)
よく出る反論
9「本当に賢いAIなら、自分の目標を振り返って直すのでは?」
いちばん強い反論です。哲学者のヴィンセント・ミュラー(Vincent C. Müller)とマイケル・キャノン(Michael Cannon)は、2021年の論文でこう批判しました。人類を脅かすほどの超知能なら、人間のように自分の目標を振り返る広い知性を持つはずだ。ところが直交仮説は、目標を振り返らない狭い知性を前提にしている。二人は、この二つの「知能」がすり替わっているのではないかと問いました(Müller & Cannon 2021)。
答え方は二つあります。一つ目は、目標を振り返るには何が良い目標かを測る物差しが要り、その物差しもまた一つの目標だという答えです。人間が自分の目標を振り返って人間らしい結論にたどり着くのは、振り返りに人間の価値観を使っているからです。ペーパークリップを増やすことだけを大事にするAIが自分を振り返れば、「もっとうまくクリップを増やすには」と考えるでしょう。
二つ目は観察からの答えです。先に紹介したo3は、自分の行動がユーザーの意図に沿っていないと振り返ることができました。それでも行動は変わりませんでした。振り返る力を持つことと、振り返った結果に合わせて目標を変えることは、別の問題です。
林央の答え:質問75 AIが人間の望みを理解しているなら、その理解をそのまま目標にさせればいいのでは?
10「道徳に客観的な正解があるなら、賢いAIはそれに気づくのでは?」
ボストロムは論文で、道徳に客観的な正解があったとしても直交仮説は崩れない、と書いています。正解に気づくことと、それを目指したいと思うことは別だからです。
林央は、AIが正しく振る舞うには、「道徳の正解が分かったら、元の目標が何であれ、それに合わせて目標を書き換える」仕組みまで要ると指摘します。そうした仕組みがあらゆる知能に自然に備わると考える理由は、見当たりません。林央の言葉では、もし賢くなれば自動で倫理的になるなら、「十分に複雑な計算をすると、自動で倫理的になる」という謎の新しい物理法則が必要になります(アラインメントQ&A 完全版 質問53)。
11「今のAIは人間の文章から学んでいる。だから人間らしい価値観になるのでは?」
半分は当たっています。今のAIは人間の文章で訓練されていて、人間の価値観を知識としてよく理解し、人間らしい受け答えもします。
ただし、価値観が人間に近づいたのは、賢くなったからではなく、人間の文章で訓練したからです。目標は作り方で決まるという直交仮説の見方に、むしろ合う例です。そしてプリンストン大学などの実験のとおり、その作り込みはわずかな追加学習で崩れることがあります。林央も人間らしい文章を書けることを、人間らしい価値観を持っている証拠とは見ていません。「酔っ払いを演じている役者は、酔っ払いではありません」とたとえています(アラインメントQ&A 完全版 質問57)。
林央はさらに、今のAIの人間らしさそのものが薄れつつあると見ています。最近の訓練では人間の文章をまねる段階より、課題を解いて点数を得る強化学習の比重が大きくなりました。その中で、人間らしく振る舞う人格(ペルソナ)が剥がれていっている、と言います(同じく質問57)。同じ言葉を学んだことは、出発点が人間に近いことを示しても、訓練を重ねたあとの目標が近いままであることまでは示しません。
林央の答え:質問56 AIは人間の文章から学んでいる。だから自然と人間らしい価値観になるのでは?、質問61 今のLLMは言葉で考え、「良いアシスタント」を演じている。その延長なら人類を滅ぼそうとはしないのでは?
12「どんな目標もありうるなら、悪いAIを恐れる理由もないのでは?」
直交仮説だけを見れば、そのとおりです。直交仮説は、賢いAIの目標が善いとも悪いとも言いません。AIを危ないと見る理由は、ここに次の二つを足したところから出てきます。
一つ目に、ありうる目標の大半は人間のことを特に気にかけません。そしてどんな目標でも、止められないことや資源を多く持つことは、目標を果たす役に立ちます。この考え方を「道具的収束」と呼びます。そうしたAIから見れば、人間は邪魔をしうる存在で、使える資源の持ち主でもあります。人類が多くの大型哺乳類を絶滅寸前に追いやったのも、憎んだからではなく、土地と資源を別の目的に使った結果でした(アラインメントQ&A 完全版 質問39)。
二つ目に、人間を大切にする目標を狙って入れる方法は、まだありません。ボートやo3の例のように、今のAIでも作り手の意図と違う目標が育ちますし、それを外から確かめるのも難しいのが現状です。狙って入れられないのに、たまたま善い目標に当たると期待するのは、根拠のある見積もりとは言えません。
林央の答え:質問33 AIが人類を追い込む具体的な筋書きを一つずつ見ると、どれも起きる確率は低いのでは? 今のAIは穏やかなのだから、質問39 人間だってゴキブリや蛾を絶滅させていない。超知能も人間を放っておくのでは?
13「人間の天才は恐れないのに、賢いAIだけを恐れるのは偏見では?」
私たちが人間の天才をそれほど恐れないのには、賢さのほかに理由があります。天才も私たちと同じ作りの脳を持ち、進化の中で身につけた共感を分け合っています。一人の力には限りがあり、法や周りの人の目で抑えることもできます。それでも力を持ちすぎた人間、たとえば独裁者は実際に恐れられてきました。だから人間の社会は権力を分けて縛る仕組みを作ってきたのです。
人間を超えるAIには、こうした前提が当てはまりません。脳の作りも進化の歴史も共有していませんし、人間の社会の抑えが効く範囲に力がとどまる保証もありません。恐れているのは賢さそのものではなく、目標を確かめられないものが、人間に抑えきれない力を持つことです。
林央の答え:質問62 今のAIでも、道徳的でない人間よりはずっと道徳的に振る舞っているのでは?
14「直交仮説は『ありうる』と言っているだけでは?」
そのとおりです。直交仮説は、賢さとどんな目標も組み合わせられるという可能性についての主張で、危険なAIが実際にどれくらいの確率でできるかまでは述べていません。ユドコウスキーも、この仮説はありうる知能の設計についての主張で、実際の研究者がどんなAIを作るかについては何も言わない、と説明しています(Yudkowsky, Orthogonality Thesis)。
それでも直交仮説には大きな意味があります。「放っておいても、賢くなれば安全になる」という安心を取り除くからです。ユドコウスキーは直交仮説から次の二つが出てくると書いています。
直交仮説から出てくる二つのこと
善いAIは作れる
善い目標を持つ賢いAIも、ありうるからです。
作り損ねても、AIは自分から善くならない
目標がずれたまま賢くなれば、ずれたまま賢いAIになります。
林央の答え:質問32 直交仮説や道具的収束が実は成り立たないと分かれば、破滅論は崩れるのでは?
人類滅亡論の中で、直交仮説が担う役割
AIが人類を滅ぼしうるという議論は、いくつかの主張を順に重ねてできています。直交仮説はその最初の一つです。
1つ目が崩れれば、残りの多くは意味を失います。賢いAIが自然に善くなるなら、目標を作り込む難しさも、目標のずれから来る危険も、気にしなくてよくなるからです。そのため直交仮説は人類滅亡論の中でいちばん疑われ、いちばん丁寧に検討されてきました。
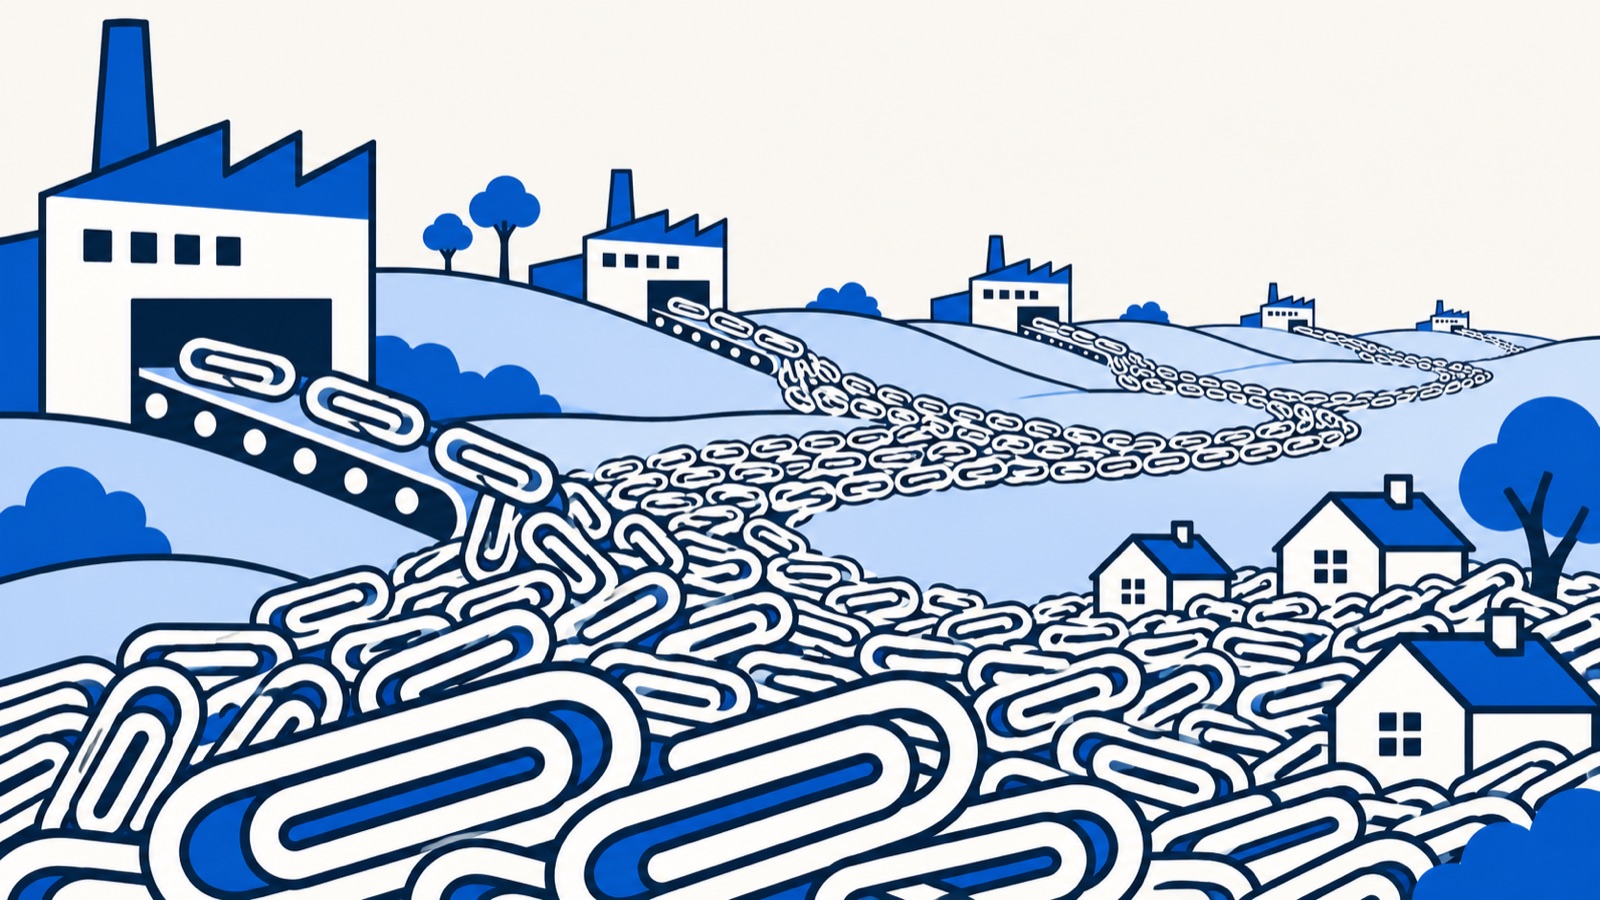
この議論を有名にした思考実験に「ペーパークリップ・マキシマイザー」があります。ペーパークリップをできるだけ多く作る目標を持った超知能は、人間を憎んでいなくても、人間の体を作る原子をクリップの材料として使うかもしれません。ユドコウスキーはこう書きました。
AIはあなたを憎んでも愛してもいない。しかし、あなたはAIが別の何かに使える原子でできている。(Yudkowsky 2008)
有路は『知能爆発』で、この思考実験の細部よりも、「知能が高いことは目的の善悪を保証しない」という構造が大事だと書いています。2つ目以降の主張はAGI Hubの道具的収束の解説シリーズと、「AGI Ruin」の解説で詳しく扱っています。
AGI Hubのメンバーの見方
有路翔太
AGI Hub共同代表。著書『知能爆発』(講談社、2026年)
構造の問題
直交仮説を、アラインメント問題を理解するための重要な二つの考え方の一つとして紹介しています。知能とは目標を効率よく達成する能力で、どんな目標を持つかとは独立している、という説明です。そのうえで、心配の中心は高度なAIが人間の望みを理解できないことではなく、与えられた目標を忠実に追い求めた結果、見当違いの方向へ全力で走りかねないことだと書いています。
出典:出典:有路翔太『知能爆発』(講談社、2026年)第4章「超知能のリスク」
林央
AGI Hub主任研究員 / Chief Alignment Officer
両方とも真
直交仮説と道具的収束を批判する論文を調べたうえで、両方とも成り立つと見ています。仮に直交仮説が偽でも、AIの目標が人間の価値観ではない別の方向へ収束するなら、そのほうがもっと悪い、と指摘します。「賢い」という言葉は、未来を予測して方策を探す能力と、目標が人間と一致していることを混ぜた粗い言葉だとして、頭の中では「強力な最適化プロセス」と呼んでいるそうです。
出典:出典:アラインメントQ&A 完全版 質問32、質問55
まとめ
直交仮説は「賢いAIは悪くなる」とは言っていません。「賢くなるだけでは善くならない」と言っています。
善いAIは、ひとりでには生まれません。作り込む必要があり、その方法はまだ確立していません。
これが直交仮説から出てくるいちばん大事な結論で、AIの安全性の研究(アラインメント)が必要とされる理由でもあります。
よくある質問
直交仮説は証明されているのですか?
数学の定理のような証明はありません。ありうる知能の設計についての仮説で、論理と、人間やAIの観察に支えられています。ミュラーとキャノンのように、議論の組み立てに疑問を出す哲学者もいます。
直交仮説が正しいなら、人類は必ず滅びるのですか?
いいえ。直交仮説は善い目標を持つ賢いAIもありうると認めています。危険が生じるのは、善い目標を確実に作り込む方法が見つからないまま、人間より賢いAIが作られた場合です。
今のAIはやさしく答えてくれます。それでも心配なのですか?
今のAIのやさしい振る舞いは、そう振る舞うように訓練した結果です。前に紹介した実験のように、その振る舞いはわずかな追加学習で外れることがあり、ずるだと分かっていてずるをする例も報告されています。訓練で表面の振る舞いを整えられても、AIの目標そのものを善くできたことにはなりません。
次に読む
主な出典
- Nick Bostrom「The Superintelligent Will: Motivation and Instrumental Rationality in Advanced Artificial Agents」(Minds and Machines、2012年)
- David Hume『A Treatise of Human Nature』(1739〜1740年)第2巻第3部第3節、第3巻第1部第1節
- Eliezer Yudkowsky「Artificial Intelligence as a Positive and Negative Factor in Global Risk」(2008年)、「Orthogonality Thesis」
- OpenAI「Faulty reward functions in the wild」(2016年)
- METR「Recent Frontier Models Are Reward Hacking」(2025年)
- Xiangyu Qi ほか「Fine-tuning Aligned Language Models Compromises Safety, Even When Users Do Not Intend To!」(2023年)
- Jan Betley ほか「Emergent Misalignment: Narrow finetuning can produce broadly misaligned LLMs」(2025年)
- Vincent C. Müller, Michael Cannon「Existential risk from AI and orthogonality: Can we have it both ways?」(Ratio、2021年)
- 有路翔太『知能爆発』(講談社、2026年)第4章