06脳にとっての「苦い教訓」
「70年にわたるAI研究から読み取れる最大の教訓は、計算を活用する汎用的な手法こそが最終的に最も効果的であり、しかもその差は圧倒的だということだ」 ――リチャード・サットン(Rich Sutton)『苦い教訓(The Bitter Lesson)』2019年
生物学のことはいったん脇に置こう。純粋に計算機科学者の目で見たとき、脳とは何なのか。
密に結合したノード(ニューロン)からなる巨大なグラフで、複数の時間スケールにわたってノイズの多い電気信号を発し続けている。冗長性は極端に高く、ラベルはほとんどない。脳を解読するには、生データでできた巨大で混沌としたグラフから意味を引き出さなければならない。
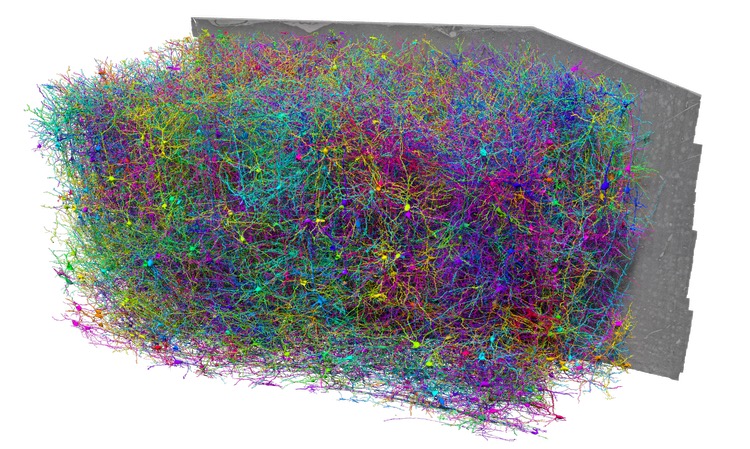
だが、これとまったく同じ構造を私たちは前にも目にしている。しかも、すでに解いてさえいる。
ただ、それを脳とは呼ばなかっただけだ。私たちはそれをインターネットと呼んだ。
インターネットは、ラベルのないテキスト、画像、つながり、ノイズが広がる大海原で、人間のエンジニアが手作業で整理するにはあまりに大きい。それでも私たちは扱えるものにした。しかもサットンの法則どおり、巧妙な手作りの工夫に頼ったわけではない。
拍子抜けするほど単純な手法を、容赦なくスケールさせたのだ。非常に大きなモデルを非常に大量のデータに向け、あとはモデル自身に答えを見つけさせた。
脳もまったく同じ形をした問題であり、やはりグラフだ。インターネットより乱雑で、密度が高く、計測ははるかに難しい。それでも根本にある数学は変わらない。つまり、シリコンのグラフを制したスケーリングの定石は、生物のグラフにも通用するはずだ。
これはもはや、説得力はあっても根拠の曖昧な理論にとどまらない。論文として発表され、測定できる現実になっている。
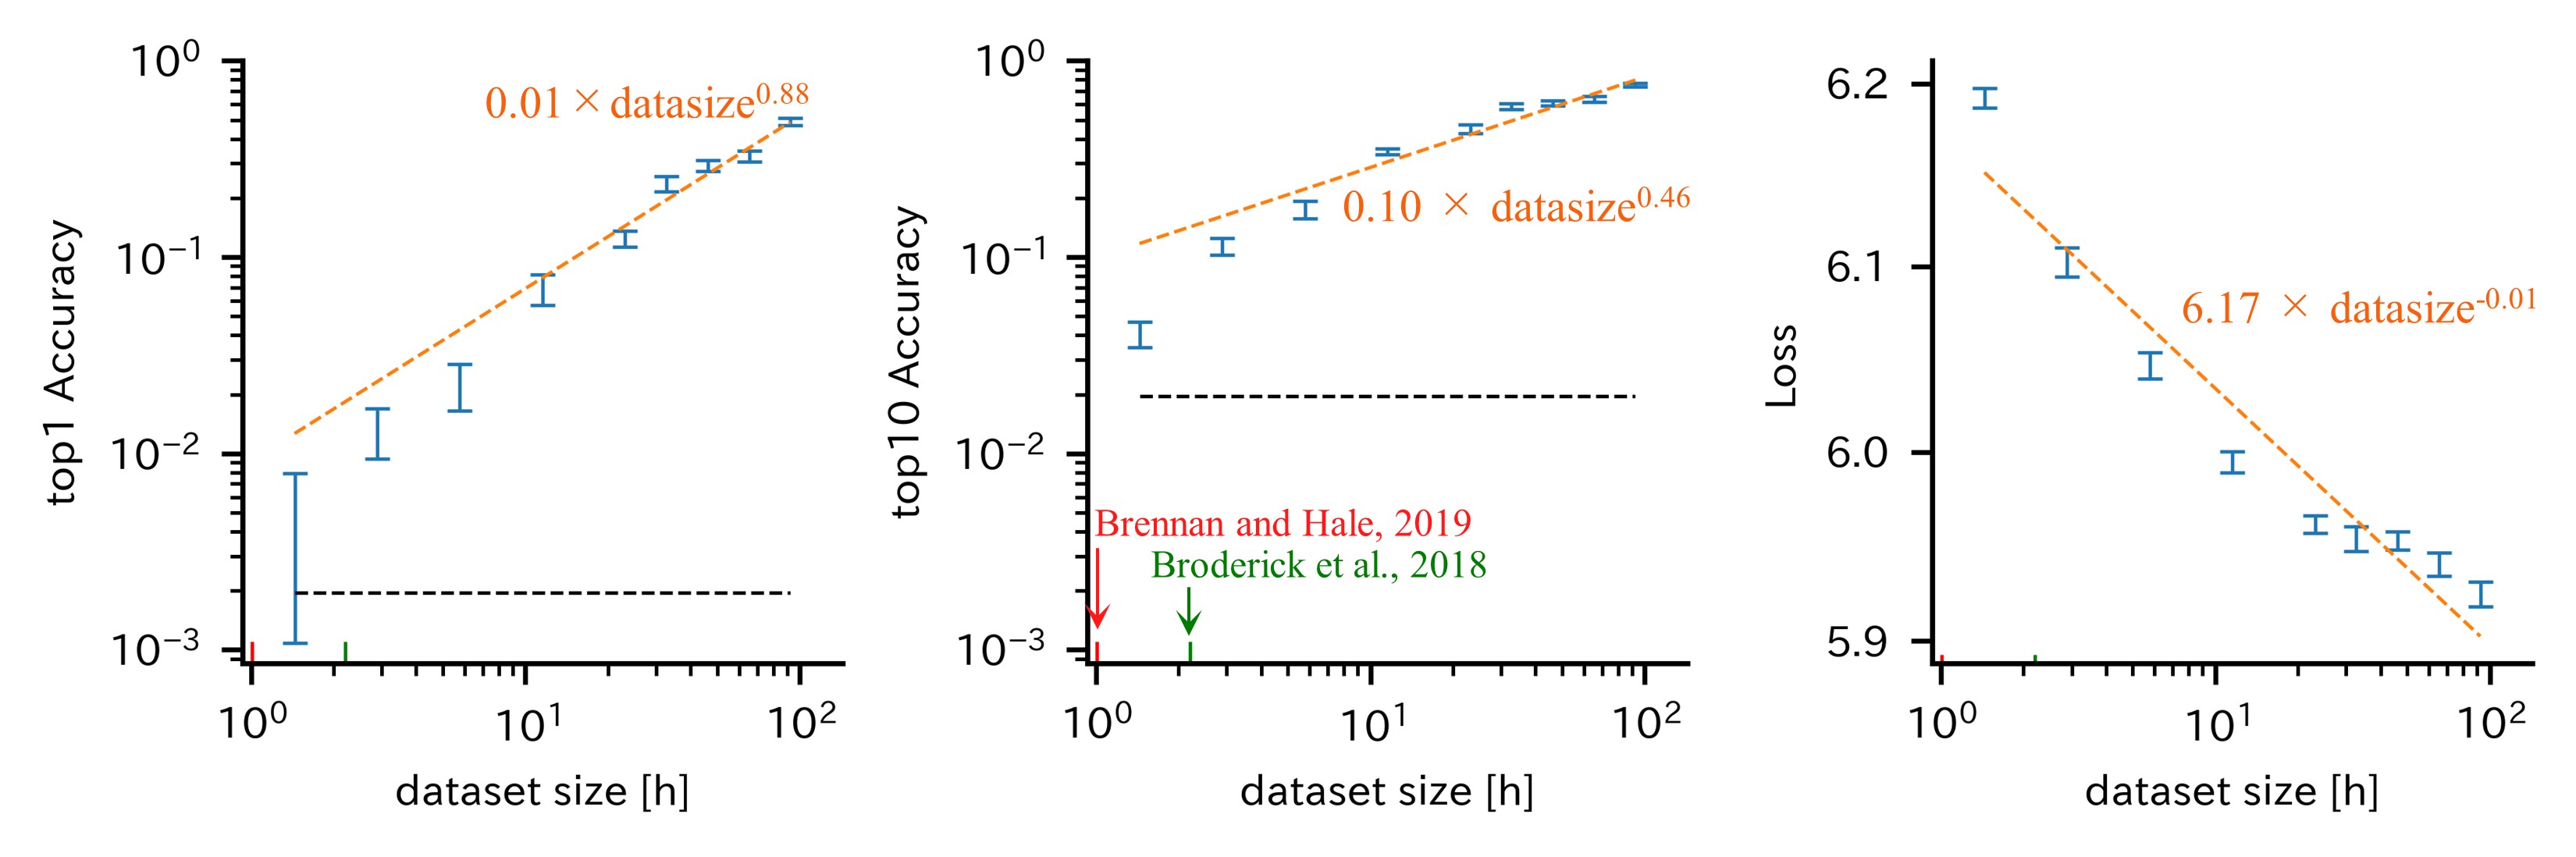
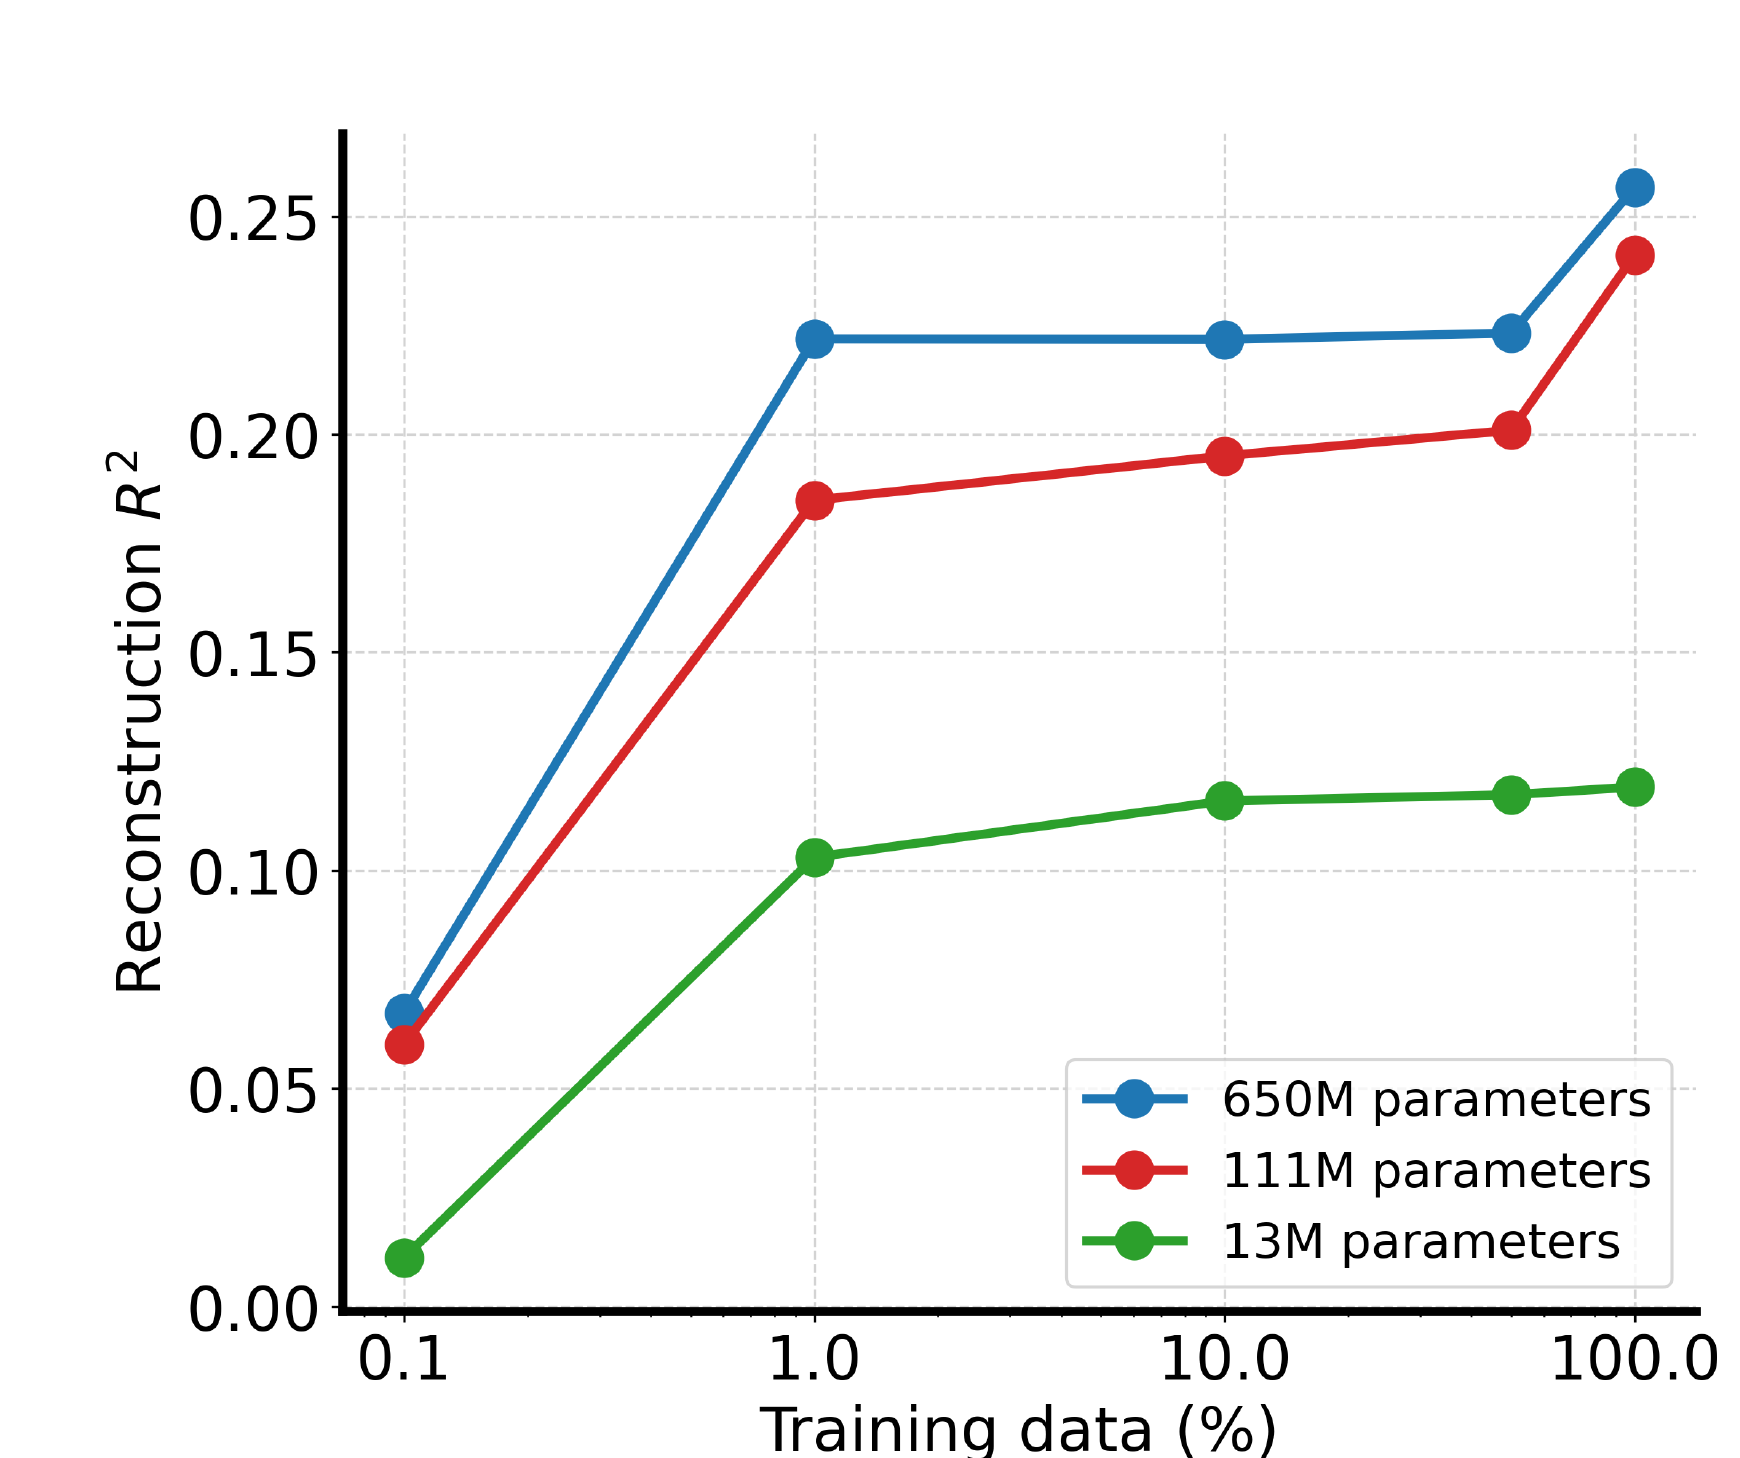
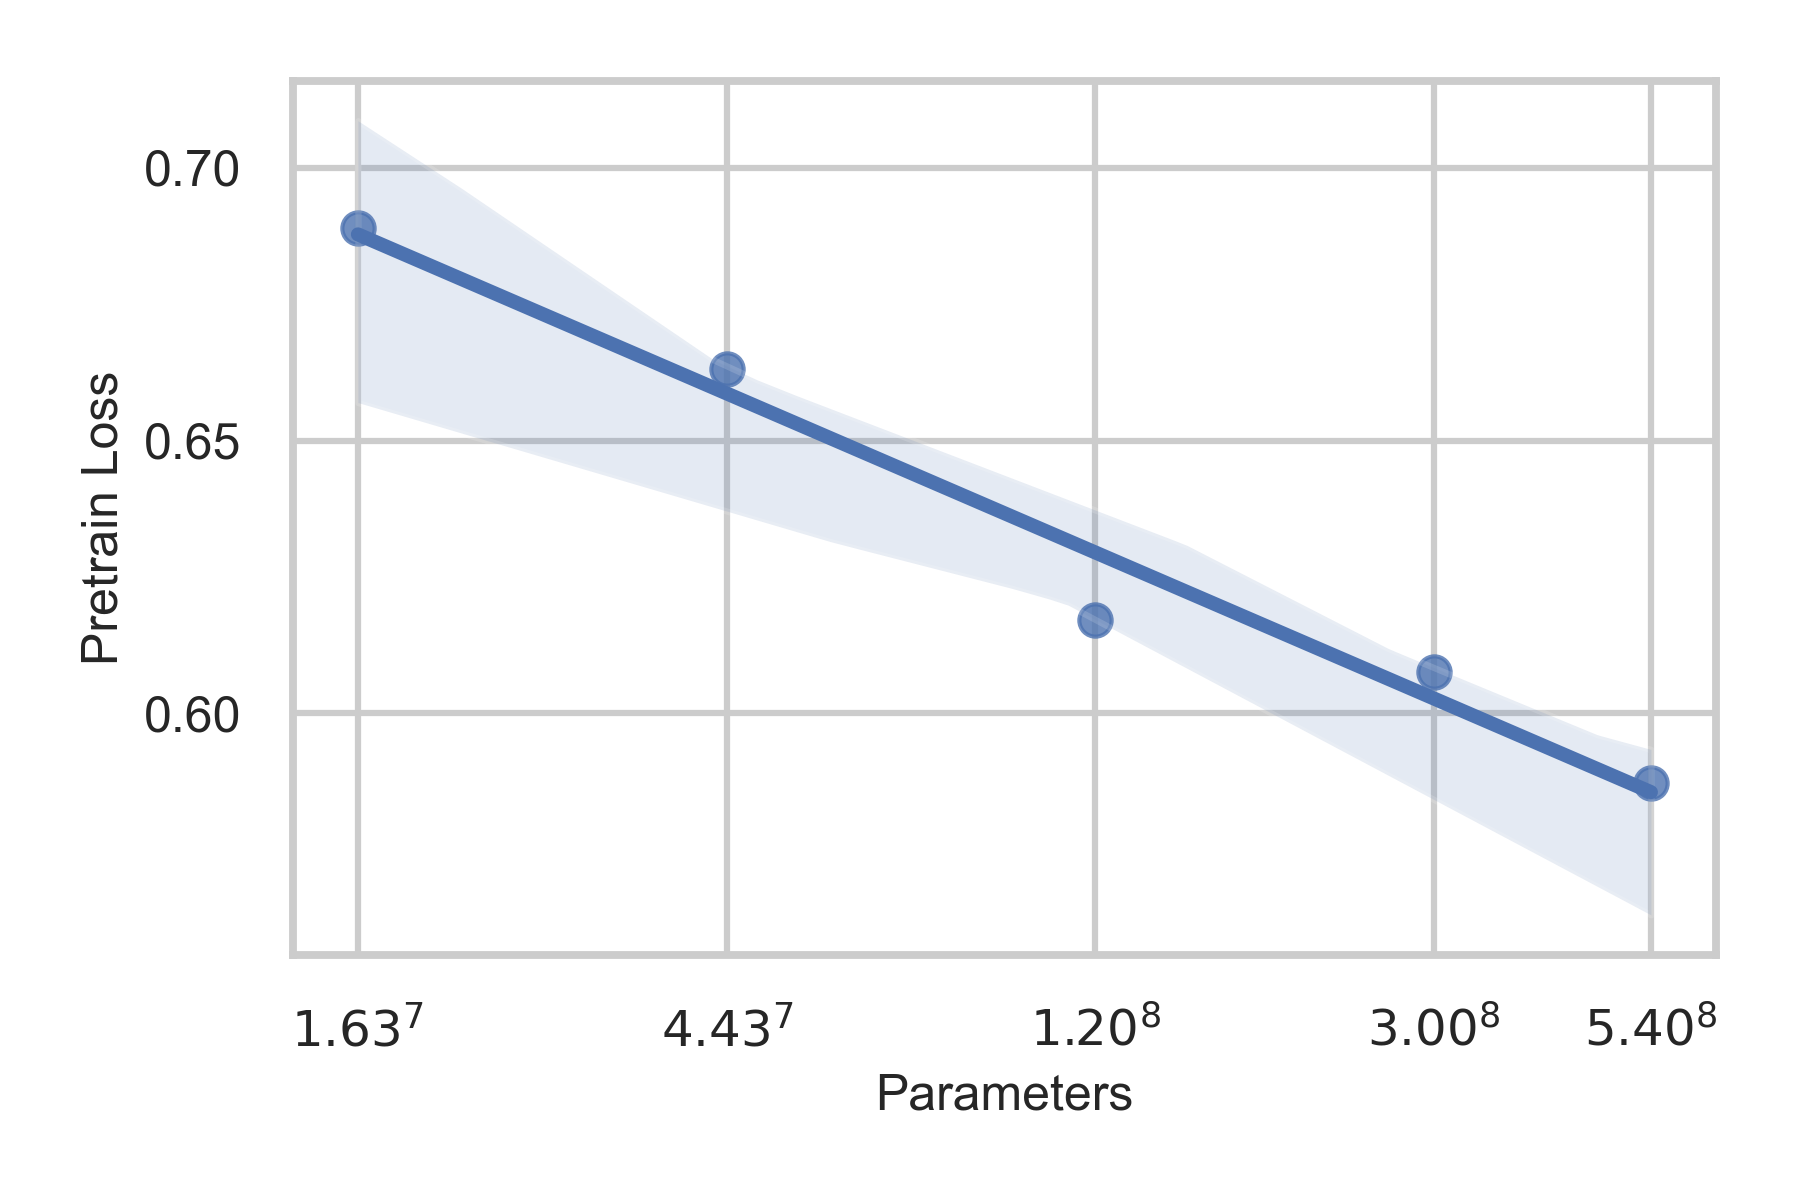
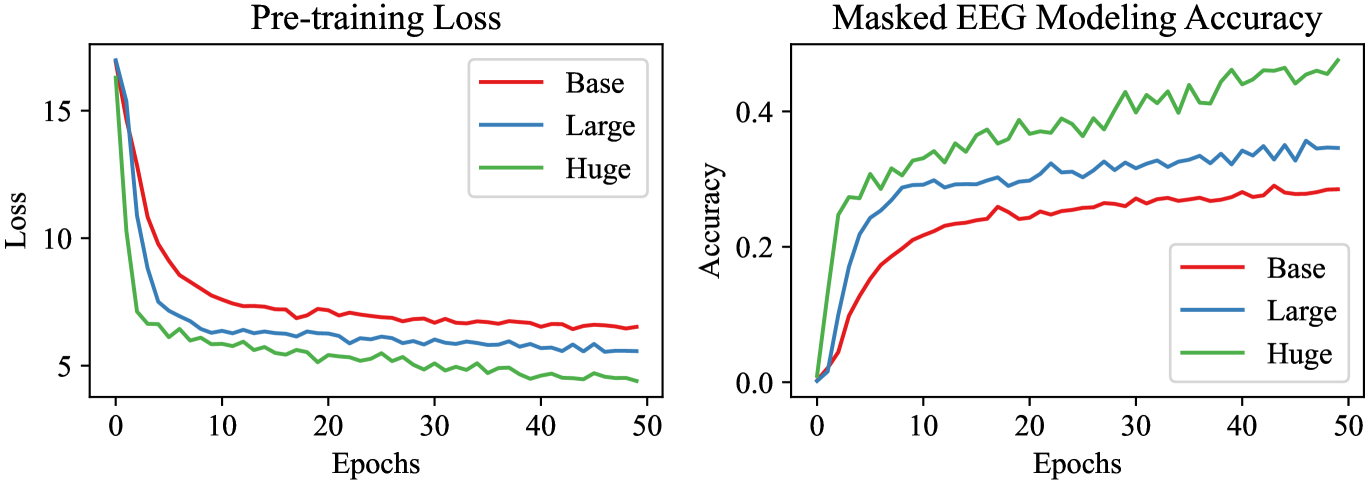
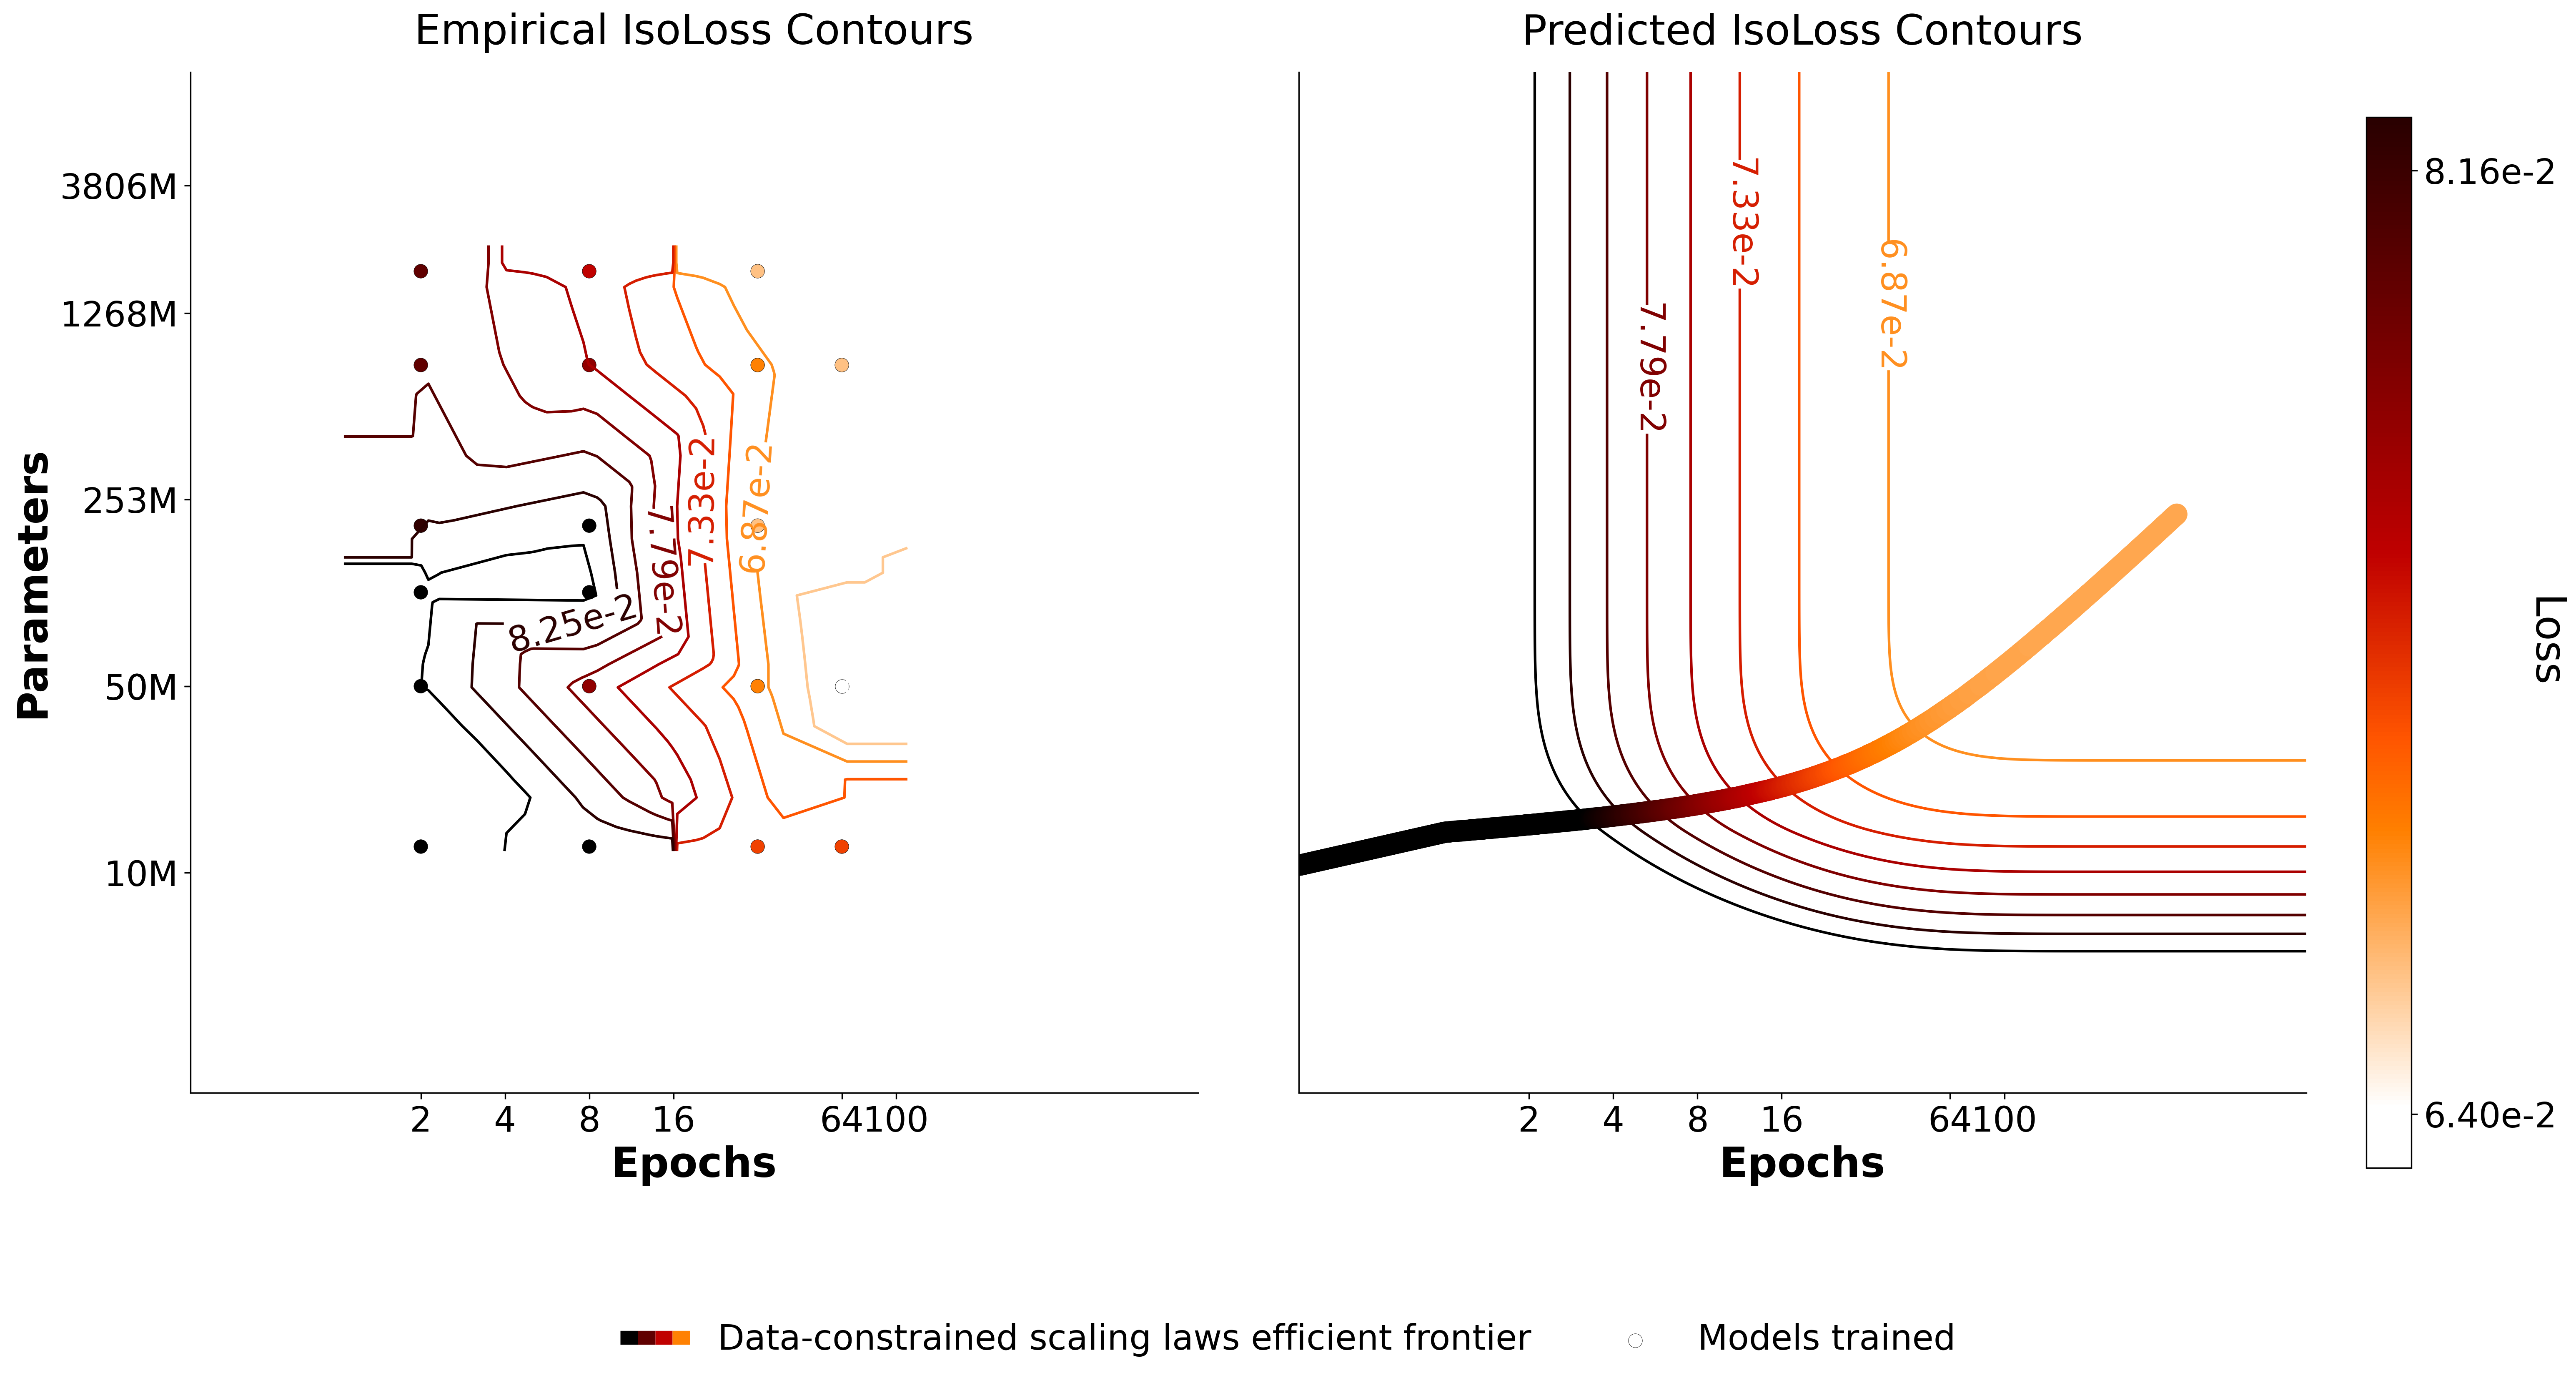
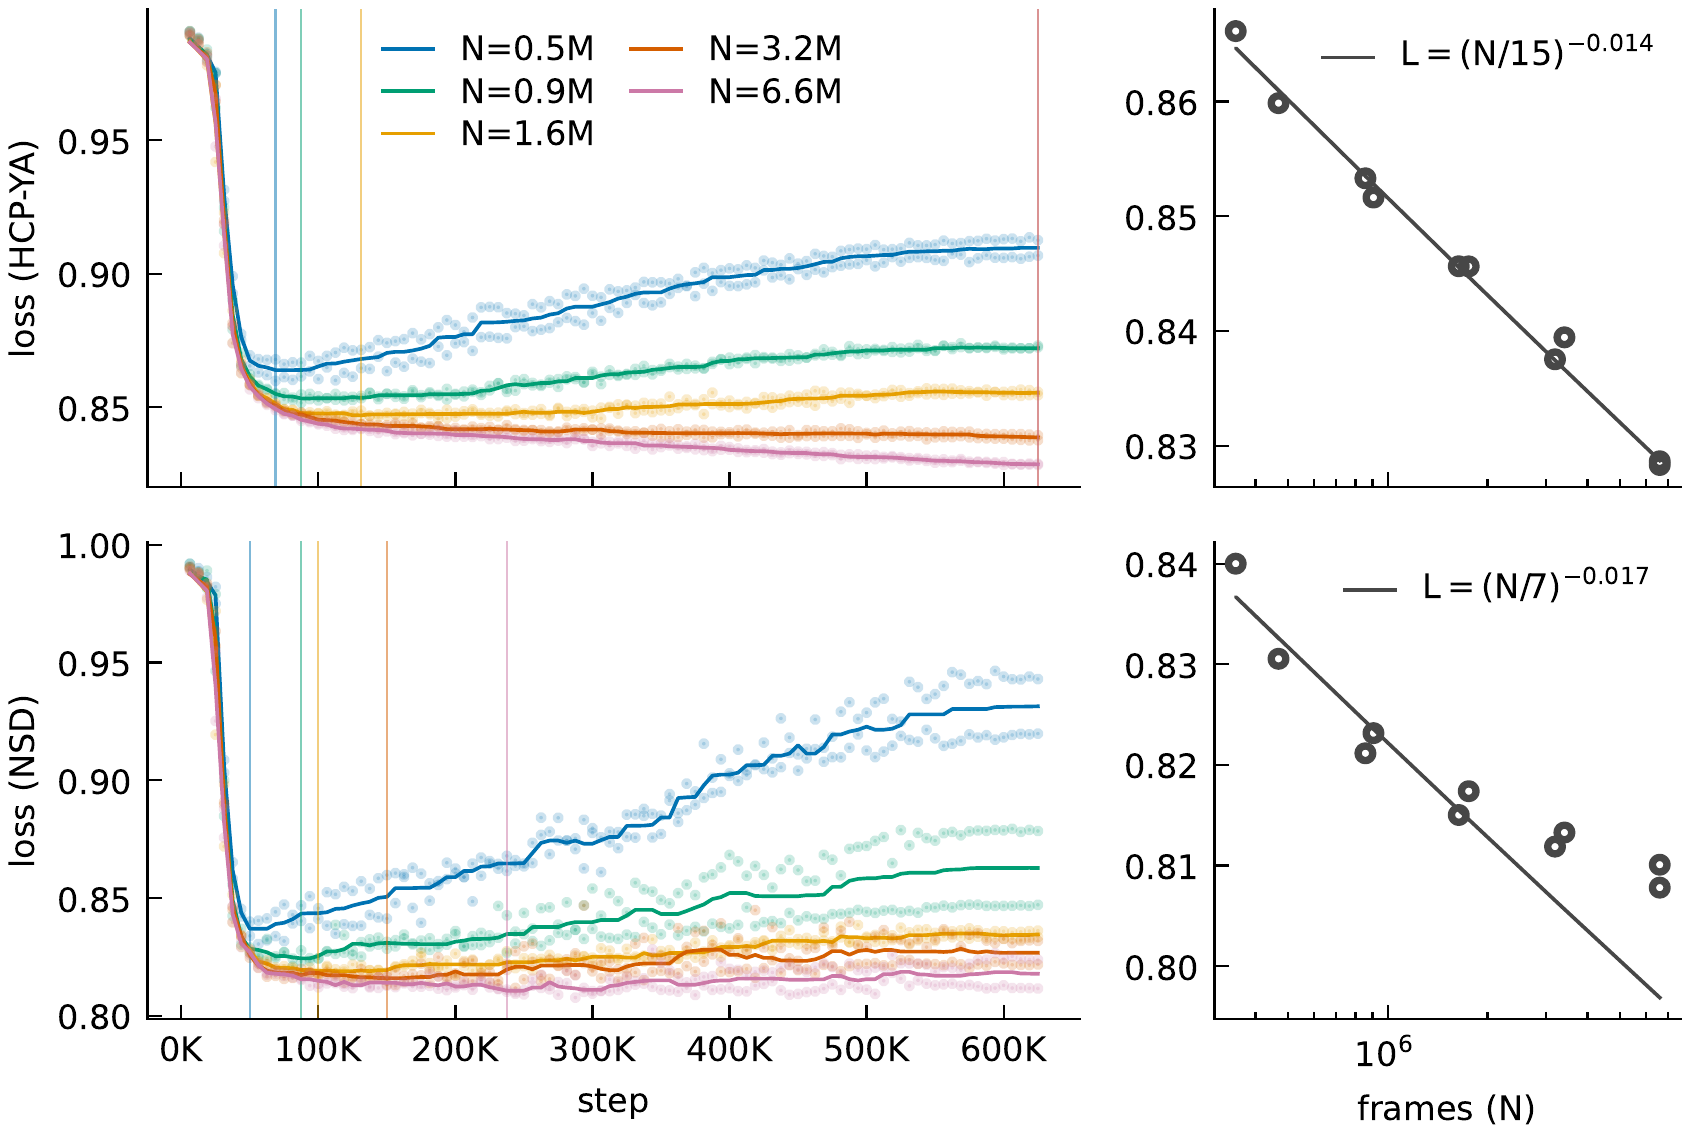
2025年初め、MetaのAIラボの研究者たちが『Scaling laws for decoding images from brain activity』Scaling laws for decoding images from brain activity8つのデータセット、被験者84人、498時間の脳活動記録、EEG・MEG・3T fMRI・7T fMRIにわたる230万試行。非侵襲の神経デコーディングで初めて発表されたスケーリング則。データ量に対して対数線形に伸び、頭打ちは見られなかった。▸13と題した論文を発表した。研究チームはAIデコーダに500時間近い脳活動の記録を与えた。EEG、MEG、fMRIの各スキャナで得た、計230万試行分のデータだ。
そこで見えたのは、AIの「苦い教訓」14が生物学の世界でリアルタイムに再現される姿だった。
- 一直線に伸びる。解読精度はデータ量に対して対数線形に向上し、頭打ちの兆しは見えない。言語モデルと同じく、デコーダにデータを与えるほど、心を読む精度は予測どおりに上がっていく。
- ハードウェアの差は底上げとして現れる。fMRIのような高精度のセンサーは、EEGのような低精度のセンサーに比べて、直線をそのまま上に押し上げるだけだ。スケーリング則そのものは、センサーを問わず成り立つ。
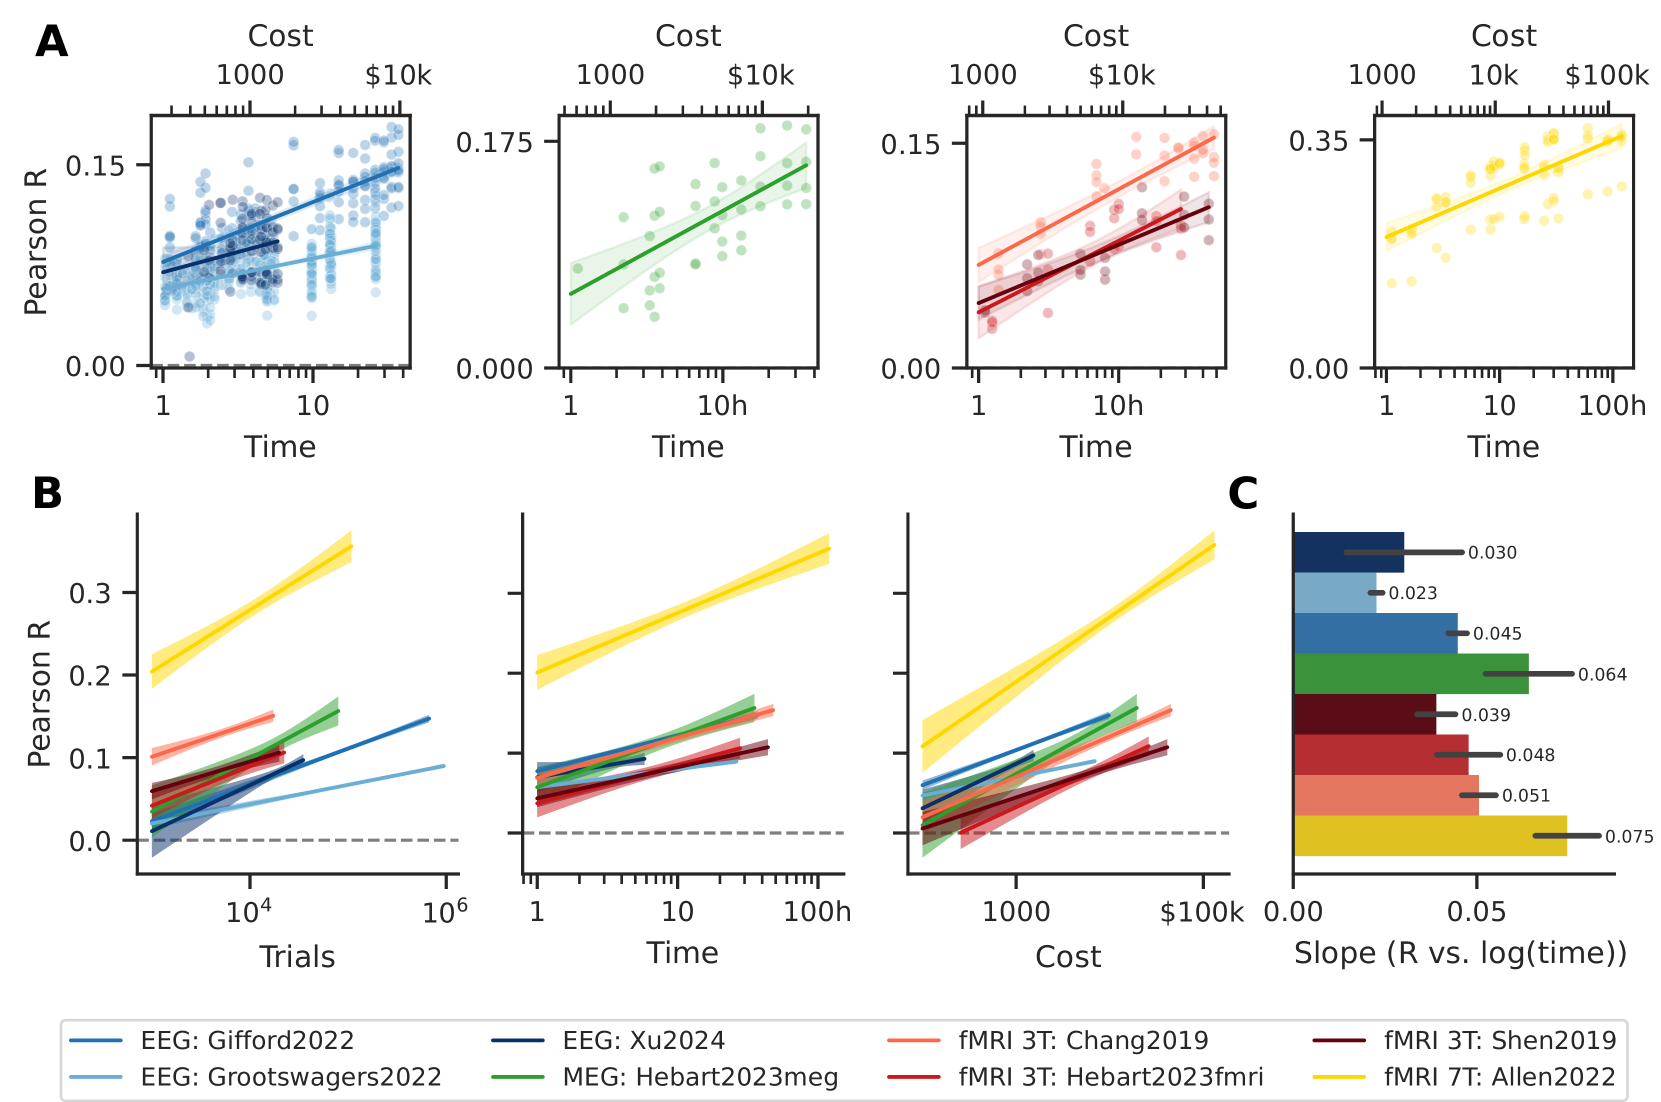
- データの形。総時間が同じなら、1人の被験者を100時間記録するほうが、100人を1時間ずつ記録するより圧倒的に高い性能を出す。これは予想どおりの結果だ。脳1つあたりのデータがある量を下回ると、モデルはまだ人をまたいで汎化できない。小規模な言語モデルでも、100の言語の本を1冊ずつ読ませるより、1つの言語の本を100冊読ませるほうがはるかに多くを学ぶのと同じことだ。規模が大きくなれば、この制約は消える。
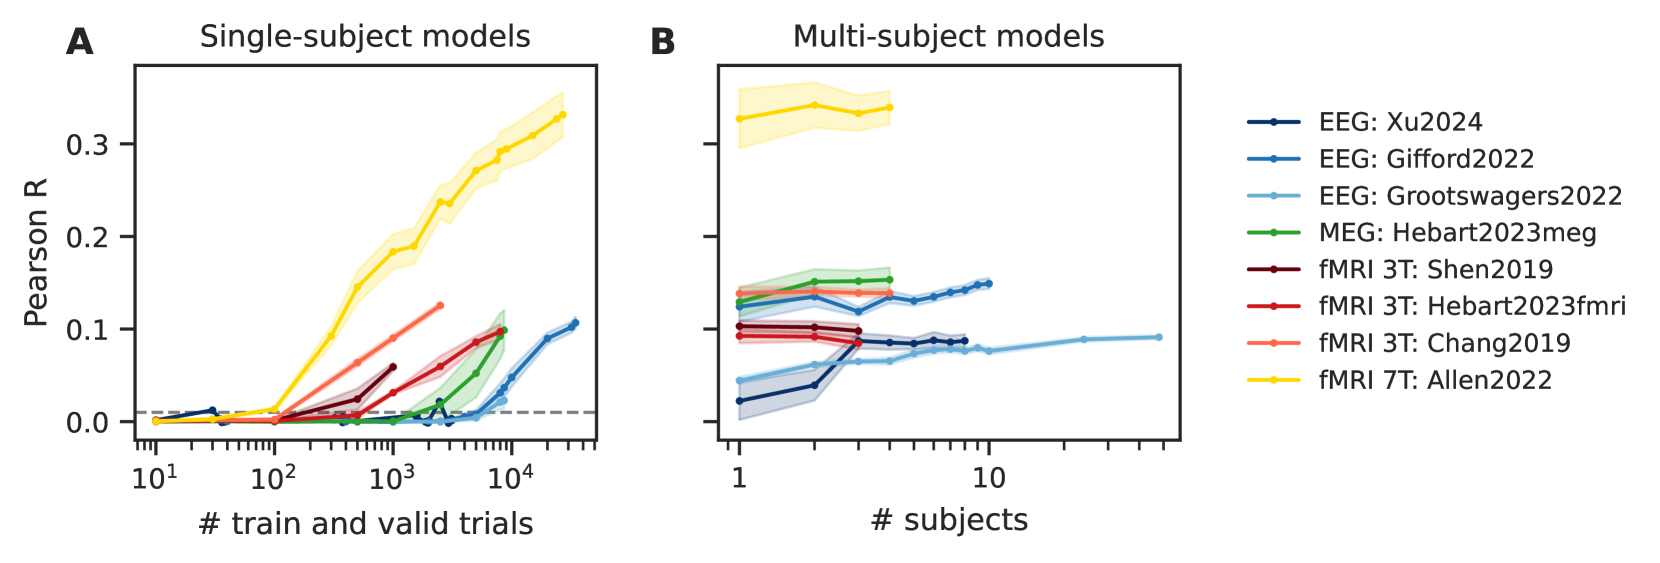
これこそが、この分野全体の未来を形づくる構造的な現実だ。スケーリング則は、散発的な単発の臨床試験には見向きもしない。求めるのは、深く途切れないデータである。人間の心を解読するためにいま必要なのは、まばらだが高精度なデータを集める数百万ドルの病院用スキャナーではない。必要なのは、大規模にデータを集められる安価なウェアラブルBCIだ。
AIが痛い目を見て学んだ教訓を、70年待って学び直す必要はない。人手で特徴を作り込むBCIの時代はまるごと飛ばして、スケーリングの定石へ直行できる。
本論考の第II部第II部スケーリングAIのスケーリングの定石は脳にも通用するのか?▸では、AIのスケーリング戦略を非侵襲型BCIにどう応用すれば、第一世代の消費者向け製品を生み出し、強力なフライホイール効果 第4節スケールへの最短路第I部 · 信号:脳は読み取れるのか?▸を回し始められるのかを探っていく。今後5〜10年で、このフライホイール効果が今度は分野の勢いを大きく加速させ、BCIがAIとの差を縮める後押しとなる。
机上の懐疑論
もちろん、勝利が約束されているわけではない。脳データはテキストよりノイズが多く、被験者ごとのばらつきも大きい。複数の時間スケールにわたって時間的な相関を持ち、ラベルも「次のトークンを予測する」だけの課題よりはるかに弱い。確かに、BCIで小規模にスケーリング則を検証すると(ZuCo、DEAP、AllJoinedといったデータセットを使ったもの)、法則は成り立っているように見える。だが、小規模での傾向がそのまま外挿できるとは限らない。
そのうえ現時点では、初めての脳にそのまま使えるデコーダは存在しない。これまでに作られたモデルはどれも、実際に機能する前に、使う人の脳に合わせたキャリブレーションの段階を必要とする。被験者ごとのキャリブレーションに頼らずに、何万人もの固有の脳を一つの汎用的な学習セットにまとめる必要に、この分野はまだ一度も迫られたことがない。
心を解読する現在の能力について最も直観に反するのは、脳がどう計算しているのかを、私たちが完全にはわかっていないという点だ。インターネットは自分たちで作ったから仕組みを理解している。しかし認知が単純なニューロンの電気インパルスに還元できるのか、それともニューロンより下の階層の物理が実際に効いているのかは、確かなことがわからない。微小管、グリア細胞のシグナル伝達、さらには量子効果までもが、思考を支える仕組みの仮説としていまだ否定されていない。わかっているのは、頭にセンサーを付けて雑多なデータを大量に集め、AIにパターンを探させると、実際に心が読めはじめるということだけだ。
スケーリングの定石は、大きなものを賭けた勝負だ。人間の認知の完全な地図を先に手にしなくても、力任せの計算資源で、脳のノイズだらけのマクロな信号から使える構造を十分に引き出せる。そこに賭けている。心を完全には理解しないまま、心を解読できるという賭けである。15この賭けが当たれば、スケーリングの線は右肩上がりを続け、データと計算資源の拡大につれて新たなブレークスルーが次々と生まれるだろう。
この10年のAIから学べたことがあるとすれば、計算資源に逆張りすると、とても賢そうに聞こえるということだ。外れるその瞬間までは。
この問題について、理論上の反論にできることは限られている。上に挙げた注意点はどれも、脳がインターネットとまったく同じではないと言っているにすぎず、そんなことは前提からして明らかだ。本論の主張は、両者が十分に似ているので、計算資源についてまったく同じ法則が当てはまるというものである。だが、スケーリング則をホワイトボードの上で反証することは原理的にできない。これは本質的に経験的な問題だ。スケーリングが破綻すると証明する唯一の方法は、実際に実験を回して壁にぶつかることしかない。
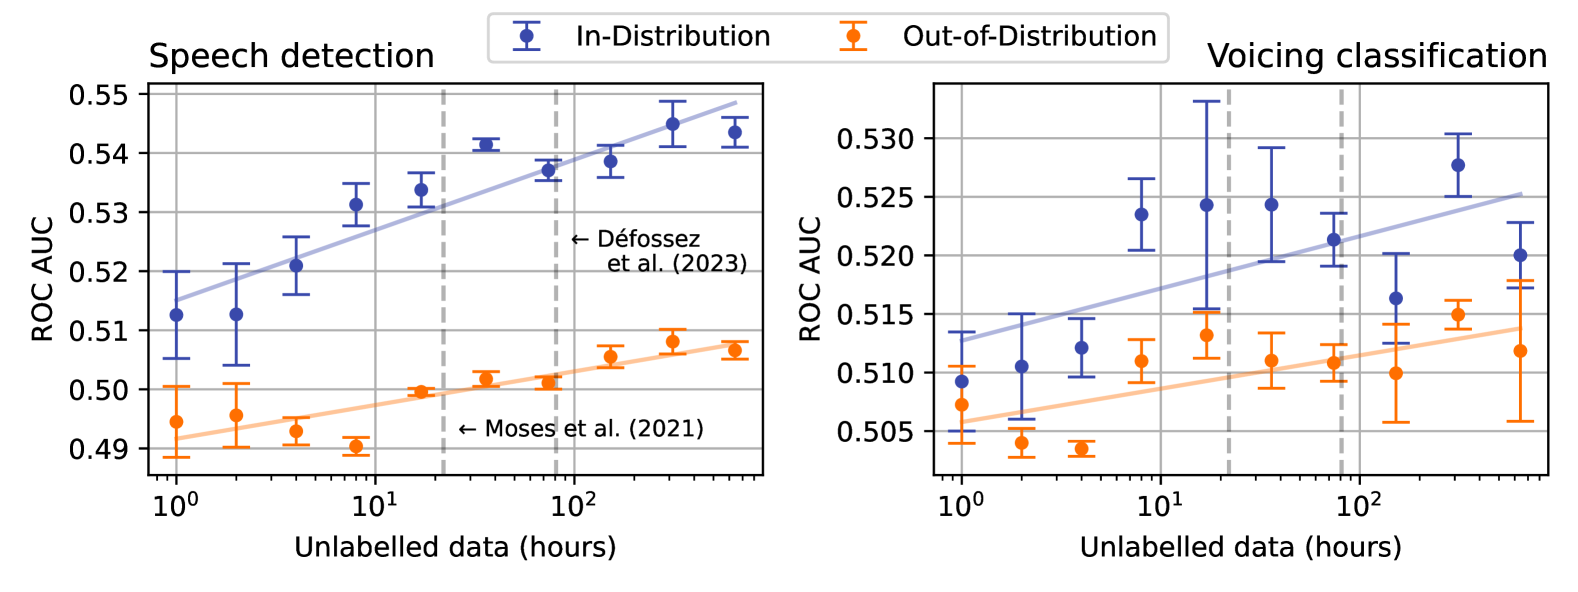
そしてこれまでのところ、スケールさせる試みはどれも、証拠を強めるばかりだった。
サットンの言う『苦い教訓(The Bitter Lesson)』The Bitter Lesson70年にわたるAI研究で勝ち残ってきたのは、人間が作り込んだ知識より、計算資源とデータそのものに頼る手法だったと論じる2ページの小論。作り込まれた巧妙さは、大規模な汎用学習に繰り返し打ち負かされてきた。本稿全体が借りている枠組みでもある。▸は、いずれあらゆる分野にやって来る。その兄貴分にあたるピーター・ノーヴィグ(Peter Norvig)らの『The Unreasonable Effectiveness of Data』The Unreasonable Effectiveness of Data『苦い教訓』と対をなす主張を、その10年前にGoogleの内側から示した論文。大量のデータで学習した単純なモデルは、少ないデータで学習した精巧なモデルに一貫して勝る。現代AIのスケーリングを支える経験的な核心にあたる。▸も、2009年にまったく同じことを指摘していた。BCIにはまだ訪れていないが、とうに来ていてもおかしくない。
なぜまだ誰もこの定石を試していないのか
スケーリングに賭けるのがそれほど自明なら、ひとつの大きな疑問が残る。BCIには何十年もの時間があった。なぜ誰も実際にこの定石を試してこなかったのか?
理由はいくつかある。
何よりもまず、この戦略を実際に遂行するのに必要なAIアーキテクチャや自己教師あり学習の手法が実証されたのは、ここ数年のことにすぎない。
だが、理由はそれだけではない。この障害は数年前にすでに解消している。この戦略の採用が遅れている本当の理由は、制度的な惰性だ。文化は氷河のような速さでしか変わらない。マックス・プランク(Max Planck)が印象的に言い表したとおり、「科学は葬式のたびに一歩進む」のだ。
BCIという分野は、そもそも侵襲型医療機器の世界で生まれた。FDAの承認、患者の安全への徹底した配慮、小さなデータセットでの統計的な厳密さによって形づくられた文化から、力ずくで規模を追う文化へ移るのは、過酷なパラダイムシフトだ。特定の患者のためにアルゴリズムを丁寧に手作りする技を磨いてキャリアを築いてきた研究者が、「10万時間分のデータをGPUの壁に放り込む」戦略に自然と手を伸ばすことはない。科学的な魅力に乏しいのも確かだ。この重い医療の荷物は脳外科のために作られたものなのに、非侵襲の領域にまですっかりしみ出し、分野の足を引っ張っている。
さらに、非侵襲型BCI向けのハードウェアの多くは、この目的に足るほど安く高性能になってから日が浅い。これまで、最も高性能で「本格的な最前線」とみなされてきたBCIの成果は、侵襲型か半侵襲型のものだった。非侵襲型のハードウェアが相応の注目を集めるまでに時間がかかったのはそのためだ。研究室に合わせたハードウェア文化もあった。研究用のハードウェアは、管理された環境での信号品質を最優先にする。一方、スケーリング向けのハードウェアは、信号品質を犠牲にしてでも毎日身につけられることを優先する。
最後に、大規模で協調的なデータ収集の取り組みが動き出したのは、ごく最近のことだ。人間の脳には、Common Crawl16もImageNet17もない。部分的に相当するものはいくつかあるが、どれも断片的で小規模、臨床寄りで研究室ごとにばらばらで、同じ人を長期間追跡したものはまれだ。データの断片化は大きな問題である。各研究室が、独自の前処理、電極配置、承認手続きのもとで自前のデータセットを集めている。BIDSやNWBのような取り組みも生まれてはいるが、まだ初期段階で、普及にはむらがある。「8つのデータセットで学習した」と書かれた論文の裏では、たいてい気の毒な大学院生が、学習を始める前にみじめな6週間をファイルの形式変換に費やしている。
こうした問題の多くは、協調の問題だ。協調の問題は、1つか2つのプレーヤーが新しい最適解をついに目に見える形で示し、残りの分野を追随させた瞬間に解決する。AIでOpenAIとGoogleがしたのが、まさにそれだ。スケーリングの定石がまだ実行されていないのは、物理法則に反しているからではない。この方向への協調した取り組みが、まだ一度もなされていないからだ。だが、それはこの10年で変わる。
BCI分野にとって最善の戦略は、脳情報デコーディングで巧妙さを競うことではない。スケールさせる覚悟を持つことだ。
当然、次の疑問が浮かぶ。実際には、スケーリングをどう適用すればいいのか。実行の道筋を描くために、単純なメンタルモデルを使おう。BCIのピラミッドだ。
07ピラミッド
非侵襲型BCIをどうスケールさせるかの詳細に入る前に、まずその中核まで分解しておきたい。根本的に問えば、非侵襲型BCIという分野は何でできているのか?
最も単純なメンタルモデルはピラミッドだ。4つの層からなり、どの層も一つ下の層を土台にして積み上がっている。下からハードウェア、データ、アルゴリズム、プロダクトである。
ハードウェアは土台だ。センサー、磁力計、トランスデューサーといったハードウェアが、信号品質の上限を決める。ルールは単純で、記録できないものは解読できない。現在、この層は深刻なほど手薄だ。機器はたいてい特注品で高価、間に合わせの作りになっている。分野全体の土台は、まだきわめて未発達だ。
データはそのすぐ上にある。記録のコーパス、プロトコル、フォーマットの慣行がこの層にあたる。データは、モデルがどこまで賢くなれるかの上限を決める。100時間分の記録で起こせる数学の魔法には限りがある。下のハードウェアと同じく、この層も危ういほど未成熟で、断片化している。
アルゴリズムはデータの上に位置する。生の信号を実際の意味に変えるAIモデルのことだ。優れたアルゴリズムはノイズの多いデータを補えるが、それにも限界がある。今日、この分野の時間と人材の膨大な部分がここで浪費されている。小さなデータセットから、最後の一滴まで信号を絞り出そうとしているのだ。
プロダクトは最上部にあり、下の3層に完全に制約されている。現在、非侵襲型BCIで作られているプロダクトの多くは、能力がひどく限られている。土台が盤石ではないからだ。いま消費者向けBCIを作るのは、GPU100基と10ギガバイトのテキストだけでChatGPTを作ろうとするようなものだ。構造的に不可能な仕事である。取り組んでいる企業は奇跡を起こしているが、業界全体を覆う過酷な逆風と戦っている。
ここで働いている力学は単純だ。どの層も、一つ下の層がボトルネックになっている。ハードウェアで集められないデータを必要とするプロダクトは出荷できない。地下室で画面を見つめる大学院生の数時間分の記録で、基盤モデル級のデコーダーを学習させることもできない。
今日のこの分野の問題は、注目がピラミッドの上部に偏りすぎ、下部に十分向いていないことだ。土台が沈みかけているのに、誰もがペントハウスに夢中になっている。ハードウェアの層には、潤沢な資金を持ちそこに集中する企業が足りない。データの層には、積極的なスケーリングが必要だ。それなのに毎月、小さなデータセットで学習した新しいデコーダーを提案する美しい論文が何十本も出てくる。アルゴリズムは主要な問題ではない。問題はデータであり、その手前にある問題は、データを集めるハードウェアだ。
ZuCoデータセットZuCo, a simultaneous EEG and eye-tracking resource for natural sentence reading英語を母語とする12人が自然な文章を読む間の高密度EEGと視線計測を同時に記録したデータセット。合計は約70時間。被験者をまたぐEEG研究の論文が軒並み学習に使ってきたデータであり、小規模ながらこの分野の存在証明でもある。▸を例にとろう。研究チームが、6時間分の読書をした12人の脳データから数学的な奇跡を起こして新しい論文をひねり出すたびに、その成果は分野の問題を解決するというより、むしろ問題の所在を示している18。乾いた雑巾からさらに一滴を絞り出す芸当は見事だ。だがある時点を超えると、その奇跡はボトルネックの証拠にしかならない。絞る腕前を褒めるのはやめて、なぜ手元に乾いた雑巾しかないのかを問うべきだ。
分野の全体像をはっきりつかめたところで、頂点のボトルネックが何に起因しているのかを正確に解剖していこう。ピラミッドを一層ずつ上っていく。まずハードウェア、次にデータ、続いてAIアルゴリズム、そして最後に、これを実際にやり遂げるためにピラミッド全体で必要となる複雑な協調を見る。
08第一層:ハードウェアは難しい
「ソフトウェアに本気で取り組む人は、自分でハードウェアを作るべきだ」 ――アラン・ケイ(Alan Kay)、1982年
まずはピラミッドの最下層、ハードウェアから始めよう。
AIハードウェアは最近ニュースをにぎわせている。計算資源こそ人工知能の究極のボトルネックだと誰もが理解したいま、何兆ドルもの資金が巨大なGPUデータセンターに流れ込んでいく。だがハードウェアはAIを阻む要因であるだけでなく、脳コンピュータインターフェースの行方を左右する重要な要因のひとつでもある。いまBCI分野は、独自のハードウェアのパラダイムシフトを切実に必要としている。
膨大なデータセットを集めるために設計された装置は、実験室向けに設計された装置とは根本的に別種の機械だ。なかでも最も重要な違いのひとつが可搬性にある。可能な限りクリーンな信号を目指して最適化するなら、何を犠牲にしても精度を求めることになる。電磁シールドルームも、液体ヘリウムによる極低温冷却も、被験者がまったく身動きできないことも受け入れる。一方、可能な限り大きなデータセットを目指して最適化するなら、計算が変わる。信号品質はなお重要だが、トレードオフは大きく可搬性の側に傾く。多少ノイズの多い信号でも1,000倍の量を集められれば、シールドルームの外では集められないクリーンな信号に勝る。この分野はまだ、このトレードオフを身にしみて理解していない。
多少ノイズの多い信号でも、1,000倍の量を集められるなら、シールドルームの外では集められない完璧な信号に完全に勝る
現在の最先端の装置は重く、高価で、窓のない部屋に置かれている。比喩ではなく、文字どおりの意味でだ。論文を書くにはそれで十分でも、何千人もの被験者から1人あたり何万時間ものデータを現実の環境で集めることとは両立しない。この分野に必要なのは、朝ヘルメットをかぶって一日を過ごし、周囲の映像と音声にぴったり対応づけられた8時間分のマルチモーダルな神経データを持ち帰れることだ。
だからといって、どんな状況にも耐えるハードウェアで、まったく統制のない環境ですべてのデータを集めるべきだというわけではない。現実には例外的なケースが際限なくある。短期的には、かなりの量のデータが今後も半ば統制された環境で集められるだろう。それでも、たとえわずかな改善であっても、可搬性の高いハードウェアは多様な状況にまたがって途切れなく記録できる柔軟性をもたらす。その柔軟性こそが、積み重なって膨大で頑健なデータセットになりうる。
完璧な実験室データが不要になるわけではない。高品質で低ノイズのデータでモデルのファインチューニングや評価を行うことには、いまも大きな利点がある19。臨床用の装置もいつでも必要だ。だが学習の大部分にとっては、多少ノイズが多くても膨大な規模のデータのほうがはるかに価値が高い。
もちろん、データセットが有用であり続けられるノイズの量には限界がある。これまで消費者向けの神経記録は実験室のものより10倍、ときには100倍もノイズが多く、学習に使ううえでの実用性は限られていた。だがハードウェアがいま急速に進歩しているおかげで、その制約はみるみる消えつつある。
ここから2つのことが導かれる。
第一に、この分野にはもっと専門のハードウェア企業が必要だ。どんな犠牲を払ってでも最高の信号品質を求めるパラダイムではなく、スケーリングのパラダイムに焦点を当てる企業である。ハードウェアの反復改良は、それ自体が過酷な専門領域だ。それをアルゴリズム論文の副産物として扱ってきたことが、この分野の足を20年にわたって引っ張ってきた。ここにはコンウェイの法則20が当てはまる。組織は自らの構造をそのまま製品にして出荷するものであり、学術の分野は学術的なハードウェアを出荷してきた。幸い、専門のハードウェア企業がようやく日の目を見はじめ、勢いはすでに信号の純度からスケーリングへと移りつつある。
第二に、スケールを目標とするなら、正しい設計の選択は変わってくる。可搬性がスケール向きハードウェアの第一の柱だとすれば、マルチモーダル化が第二の柱になる。
多くのモダリティは組み合わせて使える。MEG、fNIRS、EEGはまったく異なる物理現象を計測するので互いに干渉せず、重ねて使える。巨大で頑健なデータセットを目指すなら、複数の生体信号を低い限界コストでとらえるのは当然の選択だ。現代のLLMがテキスト、動画、音声で学習するのと同じように、脳の基盤モデルも互いに補い合う複数の生体信号から学ぶべきだ。マルチモーダル化は気の利いた小技にとどまらず、当然の標準になるべきである。
加えて、これまでモデルとセンサーはほとんど別々に開発されてきた。非侵襲型センサーにどんな変更を加えれば最も性能が上がるかは、経験に基づく推測に頼っていた。だが大規模モデルをセンサーの出力で直接学習させるなら、もう推測する必要はない。センサーとモデルを協調設計し、きわめて緊密なフィードバックループをつくれる。
可搬性とマルチモーダル化を土台として受け入れれば、残りの工学的制約はおのずと決まる。スケールを前提に作るとは、次の課題を解くことだ。
- 製造。100万台を実際に出荷するにはどうすればよいか。
- 文脈。カメラとマイクを組み込み、神経データを現実世界の状況と結びつける。
- 耐性。髪の毛、汗、体の動き、日常生活の混沌にもセンサーアレイが耐えられるようにする。
- 標準化。最も重要でありながら、最も軽視されている要素のひとつ。ハードウェアが出力するデータを他のラボの記録ときれいに統合できなければ、その上のデータ層はいつまでも足並みがそろわない。
ハードウェアのボトルネックはゆっくりと克服されつつあるが、その進み方は一様ではない。
主要な非侵襲型の計測方式(EEG、超音波、fNIRS、OPM-MEG、いずれはNV磁気計測)は、どれも「実験室」から「ウェアラブル」への飛躍を始めている。Butterfly Networkは超音波をチップに載せ、KernelはウェアラブルなfNIRS装置をつくり、Cerca Magneticsは装着型のOPMアレイを出荷している。
 付録D計測方式マップ付録:予測、謝辞、参考資料、計測方式マップ。▸で、各方式を詳しく解説している。
地政学の現実が顔を出すのも、このハードウェアの層だ。中国はここ数年、BCIハードウェアに積極的な投資を続けてきた。5カ年計画では、BCIを国家の戦略技術群のど真ん中に据えている。中国はもはやBCIを神経科学の珍しい研究対象とは見ていない。すでに戦略資産と見なしている。
この筋書きには見覚えがある。AIの10年は半導体チップをめぐる争いだった。地政学を決定づけたのは、誰がチップを作れるかという一点だった。突き詰めればそれは、台湾のひとつのファウンドリ、オランダのひとつの露光装置メーカー、ひと握りの米国の輸出規制、そしてその上に積み上がった1兆ドル規模の戦略的不安に行き着いた。BCIハードウェアでも、同じ競争がすでに始まっている。脳データが戦略的に重要になれば、それを集める機械もまた戦略的に重要になる。数年のうちに、脳ハードウェアのTSMCとなる企業が姿を現しはじめるだろう。そして中国は、その答えが自動的にアメリカにならないよう、明らかに手を打っている。
要するに、この節で言いたいのは、ハードウェアの壁が取り払われることのほうが、デコーダの論文がもう1本出ることよりも重要だという点だ。非侵襲型BCIの次の飛躍は、小さなデータセットで学習した賢いアルゴリズムからは生まれない。大規模にデータを集められ、多くの人が身につけられ、しかも長時間にわたって装着できるセンサーから生まれる。
とはいえ、センサーだけでは生の数値が出てくるにすぎない。信号を大規模に捉えるハードウェアがボトルネックでなくなれば、次のボトルネックは、そのデータをどうやって大規模に集めるかになる。
09第二層:データのスケーリング論
「単純なモデルと大量のデータは、少ないデータに基づく精巧なモデルに勝る」 ――ハレヴィ(Halevy)、ノーヴィグ(Norvig)、ペレイラ(Pereira)『The Unreasonable Effectiveness of Data』、2009年
ピラミッドの第二層はデータだ。
AI分野は数十年にわたり、巧妙な記号的手法を追い求めてきた。力任せのやり方が現実的な選択肢だと気づいていなかったことが大きい。その誤りを浮き彫りにしたのが「苦い教訓」だった。この結果で何より居心地が悪いのは、科学としてはまったく満足のいかない結論だという点にある。GPTを生んだのは言語のエレガントな理論ではなく、何も考えずに規模を拡大することだった。BCIのような分野がこの転換をなかなか身につけられないのも、ひとつにはそのためだ。
今日のBCIには、2017年当時のAIと比べて大きな強みがある。AIモデルがすでに存在することだ。あとはデータを集めればいい。分野はこのことに気づき始めており、いままさに基盤モデルの時代へ足を踏み入れつつある。21
解読結果 · 約10時間
彼は犬を見て、それから窓の外を見た
解読結果 · 約100時間
私はベッドで目を覚まし、ガラス窓に顔を寄せた
解読結果 · 約2万5000時間
私はエアマットレスから起き上がり、寝室の窓ガラスに顔を押し当てた
ハードウェアの進歩につれてデータ収集の規模拡大は容易になり、データセットも大きくなってきた。それでもBCIのデータセットは、基盤モデルが「基盤」と呼ばれるに至った規模にはまだ遠く及ばない。公開されているEEGデータセットは最大級のものでも、被験者は数十人、1人あたり数十時間、単一モダリティで、ほとんどが実験室で収録されたものだ(ZuCoZuCo, a simultaneous EEG and eye-tracking resource for natural sentence reading英語を母語とする12人が自然な文を読む際の、高密度EEGと視線計測を同時に記録したデータ。合計約70時間。▸、DEAPDEAP: A Database for Emotion Analysis using Physiological Signals被験者32人が1分間のミュージックビデオ40本を視聴し、その間のEEGと末梢生理信号を記録。感情価、覚醒度、支配感、好みを評価している。約21時間。EEGによる感情デコーディングの事実上の標準ベンチマーク。▸、スタンフォード大学の手書きコーパスHigh-performance brain-to-text communication via handwriting麻痺のある被験者が手で文字を書く様子を思い描いている間の皮質内記録をデコードし、思考からテキストへの変換が毎分90文字を超えうることを初めて示した。後に続く世代の発話デコーディング論文は、この手書きイメージの成果を土台にしている。▸、BCI CompetitionのデータセットBCI Competition IV datasets運動イメージとERPのデコーディングを対象とする、コミュニティ共通のベンチマークシリーズ。被験者数は少ないが丁寧に整備されており、数百本の論文が同じ条件で比較するためのベースラインとして使ってきた。シリーズ全体の総量は1,000時間未満。▸)。私が知る限り最も野心的な社内コーパスでも、総量は1万時間未満で、しかも単一モダリティにとどまる。
とはいえ、状況は変わり始めている。NeuralBench v1.0NeuralBench: A Unifying Framework to Benchmark NeuroAI Models94のデータセット、被験者9,478人、1万3,603時間のEEGを統合。非侵襲の神経デコーディングにとって初の本格的な共通評価基盤。▸(Meta、2026年5月)は、94のデータセットから被験者9,478人分、1万3,603時間のEEGを統合した。モデルも並行して大規模化している。NeuroLM(Jiang et al., ICLR 2025)NeuroLM: A universal multi-task foundation model for bridging brain signals2万5,000時間のEEGで事前学習した17億パラメータのモデル。オープンソースの脳の基盤モデルとして現時点の最大記録。▸は2万5,000時間のEEGで17億パラメータ、LaBraM(Jiang et al., ICLR 2024)Large Brain Model for Learning Generic Representations with Tremendous EEG Data in BCI2,500時間のEEGで学習した、3億6,900万パラメータのEEG基盤モデル。▸は2,500時間で3億6,900万パラメータに達する。
比較のために挙げると、GPT-3(2020年)の学習に使われたのは約3,000億トークンだった。Llama 3(2024年)は15兆、Llama 4(2025年4月)は30兆トークンを使っている。公開テキストの実効的な総量は、およそ300兆トークンが上限Will we run out of data? Limits of LLM scaling based on human-generated data品質で補正した公開テキストの実効総量は約300兆トークン。現在の増加ペースなら、2026年から2032年のあいだに使い尽くされる。▸になる。BCIがAIの規模に届くまでには、まだ長い道のりがある。
BCI分野の内側にいる人には、このデータのスケーリング論は当たり前に聞こえるかもしれない。だが同僚のかなりの部分にとっては、そうではない。この分野には長らく「小さなデータセットで巧妙なことをして、論文を出し、それを繰り返す」という文化があった。「まず地味な土台を築き、苦い教訓が効いてくるまでスケールさせる」という方針は、本物の科学から一歩退くように見えるかもしれないし、美しさや明快さに欠けると感じられるかもしれない。それでも、ほかのあらゆる分野でうまくいき、BCI分野が必要としているのはこの方針なのだ。
データ収集の議論には、さらにもう一つ相乗効果がある。この定石に従って生まれる大規模なBCIデータセットは、AIラボにとっても大きな価値を持つ。実際、データの壁が近づき、アラインメントの優先度が高まるにつれて、AIラボは代替となるデータ源への関心を強めている。人間の認知過程を記録した大規模データセットは、BCI分野にとってもAI分野にとっても価値があるわけだ。ここでの主張は、BCIがスケールするということだけではない。BCIとAIラボが互いに引き寄せ合いながらスケールしていくという自己強化的な循環が生まれる、というのが本論の主張だ。この点は第III部第III部衝突なぜBCIはAIにとって重要なのか?▸でさらに掘り下げる。
データセットが大きくなるほど、脳を解読する大規模モデルの学習は現実味を帯びる。だがこの規模のデータから実際に意味をうまく引き出すには、分野として独自のアルゴリズムを捨て、言語を制したアーキテクチャと戦略に集中しなければならない。
10第三層:脳の基盤モデル
モデルがなければ、データはさほど役に立たない。そこでピラミッドの次の層は、神経データセットで学習させたAIの層になる。
いまのBCIが持つ大きな強みは、数学を発明する必要がないことだ。AIの定石はすでに書かれている。アーキテクチャの面で創意工夫はほとんど要らない。車輪を再発明する必要はなく、言語を制したトランスフォーマーモデルをそのまま使い、入力層を神経データを受け付けるよう調整して、実行ボタンを押せばいい。22
AIの定石からもう一つ借りるべきなのは、土台をオープンに築くことだ。いまのBCI分野には、スケーリングによって非侵襲型の脳デコーダの上限を試すだけのデータすらない。とはいえ、その規模に閉じた環境で到達しようとするのは賢明ではない。AI分野が黎明期にこの状況を乗り越えたのは、オープンな協力によってだった。OpenAI、DeepMind、FAIRにおける基礎研究は、驚くほど協調的だった。データセットは共有され、論文は公開され、モデルもおおむね公開されていた。AI分野は最終的にクローズドな重みへと移ったが、それは土台が築かれた後のことだ。BCIはまだ土台づくりの段階のただ中にある。最初から閉じれば、進歩は必ず遅れる。
少数のスタートアップと研究者がこの方向に動き始めており23、エコシステムは育ちつつある。AI分野がすでに十分に成熟しているため、いまの障害はモデルそのものではない。足りないのは、フロンティア規模で学習させるための膨大なコーパスと、フロンティア規模がテキストで起きたのと同じ能力の向上を脳でももたらすという実証だ。
BCIにとりわけ有利に働く、計算資源の追い風もある。1ドルあたりのGPU性能は約2年ごとに倍増してきた。ある能力のモデルを学習させるコストも、5年で桁違いに下がった。2020年には数百万ドルかかったGPT-3相当の学習が、いまでは数十万ドルの下のほうに収まり、さらに下がり続けている。BCIは今の時点でフロンティアAI規模の計算資源に資金を投じる必要はない。脳のコーパスがフロンティア級の計算資源に見合う規模になるころには、そのコストはフロンティアラボがいま払っている額のごく一部になっている。この10年の難問はデータの側にある。計算資源の側は、待つだけで安くなる。
BCIのChatGPTの瞬間まで、残るは一つのCommon Crawlと一つの基盤モデルだけだ。
しかし、ここまで述べた戦略を実行するうえで最大の課題は、ピラミッドの個々の層にはない。分野全体の協調にある。ディープテックではよくあることだが、最も難しいエンジニアリング上の問題はたいていシリコンでも数学でもなく、人間同士の協調だ。
11協調のジレンマ
協調したスケーリングは、BCIがまだ本格的に試みたことのない取り組みだ。BCIピラミッドの互いに独立した三つの層(ハードウェア、データ、モデル)すべてにまたがる。協調がなければ、どのチームも同じ問題をゼロから解くことになる。
協調がなぜこれほど重要なのかは、データそのものを見るとわかる。脳データは本質的に、現代のLLMの学習に使われるテキストデータより複雑だ。テキストは離散的で標準化された単語の並びにすぎないが、脳データは連続的で雑多な物理現象であり、ハードウェアや環境、そして装着する人によって大きく変わる。
この複雑さゆえに、ほとんどのラボはデータをまったく異なる形で構造化している。標準フォーマットの試み(BIDS(Brain Imaging Data Structure)やNWB(Neurodata Without Borders)など)はあるものの、カバーできている範囲は部分的だ。その外では、MATLABのMATファイルから独自仕様のHDF5、手製のCSV出力まで、形式はばらばらになっている。この断片化のコストは外からは見えないが、内部の人間には痛いほどわかる。「8つのデータセット」で学習したという論文の裏では、たいてい誰かが学習を始める前に、ファイル形式を整えるだけで6週間の苦行を強いられている。この摩擦を世界中のラボの数だけ掛け合わせれば、統一されたデータセットにまとめ上げることがいかに難しいかがわかるだろう。
AIのデータ革命は偶然起きたわけではない。Common CrawlやImageNet、そして一握りの成果物がデータ収集を標準化し、分野はその上に成果を積み重ねていった。おかげで研究者は画像集めに時間を浪費せずに済み、アルゴリズムで競えるようになった。ImageNetだけでも、10年にわたるコンピュータビジョンの進歩の種をまいた。誰もが同じ画像で学習し、同じ指標で結果を報告したからだ。BCIには、何としてもImageNetに当たるものが必要だ。ただし脳データはテキストや写真よりはるかに標準化しにくい(脳とインターネットのグラフを比べた先ほどのたとえが成り立たなくなるのは、まさにこの点だ)。そのため、こうした取り決めを確立するのは10倍難しく、そして10倍重要になる。24
ファイル形式の問題の下には、もっと根深い構造的な問題がある。従来の神経科学のラボは、きわめて閉鎖的だ。市販のセンサーをいくつか買い、20人を対象に厳密に統制された実験を行い、結果が出る程度にだけデータを整えて、論文を出す。この構造は、ニッチな科学的知見を発表するにはすばらしい。だが、数十億時間規模の産業的なデータセットを築くには、まったく役に立たない。学術界はそもそも巨大なデータ工場になるようにはできていないのだ。しかも学術界のインセンティブ構造はいまだに、小さなデータセットで巧妙なアルゴリズムを作る研究者に報い、巨大なデータセットを標準化する地味で退屈な仕事には報いない。この仕組みが自然に世界共通の統一データ標準を生み出すと期待するのは、学者という名の猫たちを一列に並ばせようとするようなものだ。終身在職権を持つ研究室の主宰者たちは、キャリアを通じて独自性と巧妙さで評価されてきた。巨大な産業用データ工場で、規格どおりに従順に回る歯車として振る舞うことで評価されてきたわけではない。ある意味で、これは脳データ版の共有地の悲劇である。
協調はデータ層だけの問題ではない。ハードウェアの標準化も重要だ。自分のデバイスの出力を他のラボの記録ときれいに統合できなければ、その上のデータ層はばらばらなままになる。同様に、オープンな基盤モデルもそれ自体が協調のための成果物だ。各ラボが自前でデコーダを学習する代わりに、分野全体で一つのデコーダの学習コストを分かち合えるようになる。三つの層のどれにも、協調という側面がある。
そして分野が断片化しているために、ピラミッドの三つの層(ハードウェア、データ、モデル)BCIピラミッド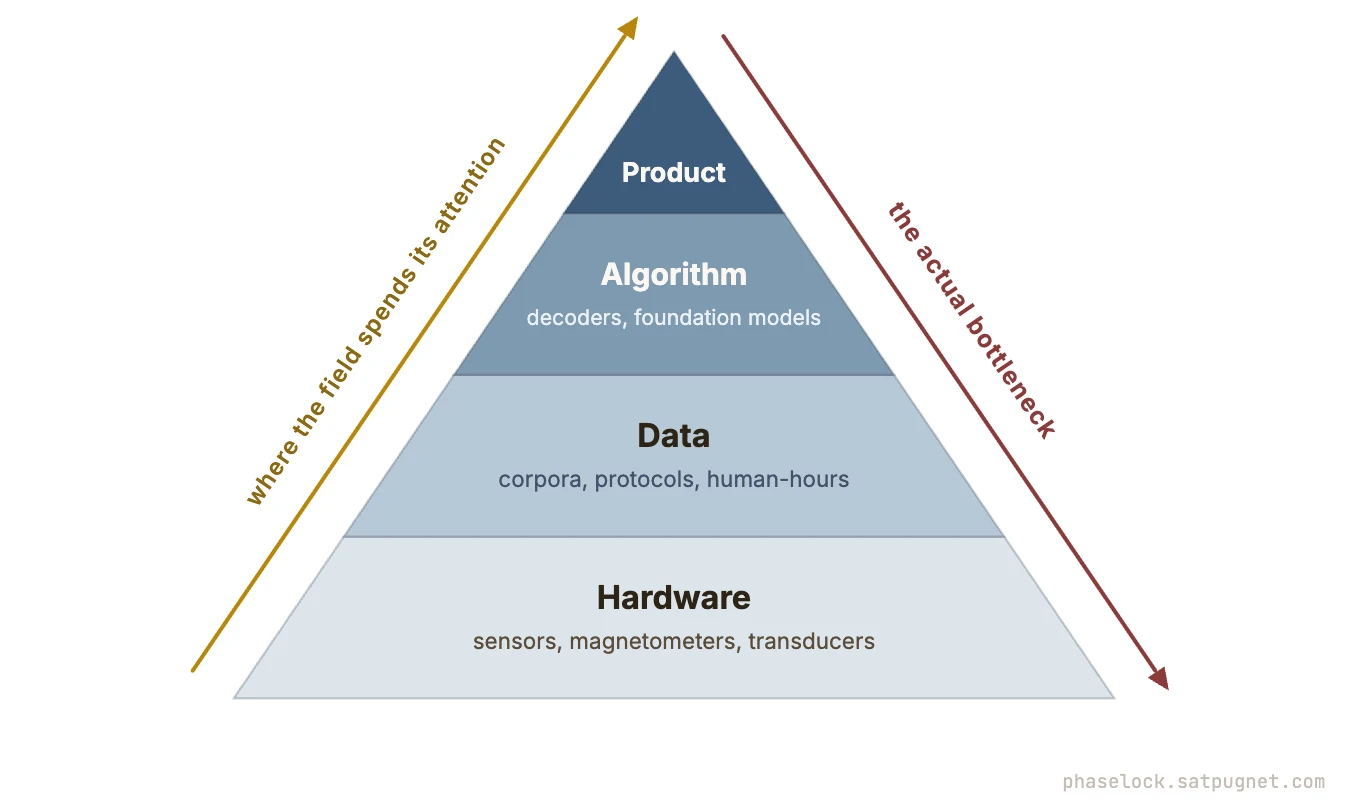 ▸は、典型的なコールドスタートの罠にはまっている。
- ハードウェア企業は、データ層が需要を生み出すまで、規模の拡大を正当化できない。
- データ収集者は、ハードウェアが十分に安く持ち運びやすくなり、しかもBCIのデータ需要が高まるまでは、大量のデータを集めることができない。
- モデル開発者は、学習に使える巨大なデータセットが存在するまで、フロンティア級の計算資源にかかるコストを正当化できない。
どの層も、下の層が先に動くのを合理的に待っている。その結果、放っておけばスタック全体がラボ規模にとどまり続ける。抜け出す道は、各層が現在の需要に見合う規模ではなく、上の層がいずれ必要とすると見込まれる規模を目指して構築を始めることだ。コールドスタートの膠着を解くために、この10年に求められているのは、そうした協調した戦略転換である。
基盤となる技術は、ようやく準備が整った。残る課題は、BCIが科学の問題から工学の問題へと移るなかで、スケーリングを協調させることだ。成功するために、非侵襲型BCIにはいま、創業者のエネルギー、巨額の資本、そして力ずくのエンジニアリングへの耐性が必要になる。どれも、学術界の仕組みがもともと提供するようには設計されていないものだ。
では、分野がこの定石をうまく実行できたとしたら、実際にどこへたどり着くのか? そして、私たちはいったい何を作っているのか?
12二本のはしご
定石が機能し、成果が積み重なっていくとしたら、成功は実際にどう測ればよいのか。この問いに答えるために、二つの異なる「進歩のはしご」を使う。一つ目は、デバイスが実際に何を読み取れるかを測る。二つ目は、デバイスが使えるようになるまでに、ユーザーがどれだけの手間をかけなければならないかを測る。
これらを能力のはしごとキャリブレーションのはしごと呼ぼう。BCIの進歩を決める二つの主要な軸だ。
能力のはしご
能力のはしごは、BCIの生のデコード能力を表す。取り出せる情報がどれだけ詳細で、デバイスがそれをどれだけ確実に読み取れるかを示すものだ。はしごの各段は、信号品質がおよそ1桁向上すること(より良いハードウェア、より多くのデータ、より大きなモデルによる)に相当し、そのたびに以前は不可能だった新しい種類のプロダクトが可能になる。
このはしごにおいて、非侵襲型ハードウェアの天井は、外科手術を伴う侵襲型よりも根本的に低い。突き詰めれば、脳の外にあるセンサーが脳の内にあるセンサーに勝つことは決してない。ウェアラブルセンサーが、外科的に埋め込まれた電極アレイのように単一の孤立したニューロンを読み取ることもない。だが今日のBCI分野で決定的に重要な現実は、その非侵襲型の天井がどこにあるのか、実は誰も知らないということだ。そして私たちは、はしごを登り始めたばかりにすぎない。
これらのはしごは、BCIが成熟するにつれて到達しうる技術的な節目を示している。
感情・生理的なバイオマーカー。デバイスが感情の状態を継続的に記録し、モニタリングできるようになりうる。喜んでいるのか、悲しんでいるのか、怒っているのか、ストレスを感じているのかがわかる。今日すでに、その入り口に手が届き始めている。
注意と集中の追跡。深く考え込んでいるときと心がさまよっているときを、デバイスが見分ける。集中を追跡できれば、ディープワークの能力を高める助けになりうるし、健康面での応用も数多い。これも可能になり始めている。
無声発話のテキスト化。日常生活を変えるのはこの段だ。口をかすかに動かして単語を言いかけると、顎が動き終わる前に、人間が気づかないほどの遅延でその単語が画面に現れる。キーボードに一度も触れずに何時間も作業できるようになる。この技術の初期の実験例は、すでにラボに存在する。
さらに上の段に進むと、話はもっと奇妙になる。
声に出さない内言の認識。頭の中で考えている言葉を、筋肉をまったく動かさずに解読する。会議中にメッセージを書いても、周りの誰一人、筋肉がわずかでも動くのを目にしない。内言(頭の中の声)のデコーディングについては、ごく初期ながら成功したラボでの実証がある。
視覚的な概念の再構成。 心の中に像を思い浮かべると、スマートフォンがその静止画を表示する。思い出すだけでスケッチが描ける。意外にも、この段でもすでに初期の成功例がいくつか出ている。見かけほどSFじみた話ではない。
マルチモーダルな想像のデコーディング。 もはや静止画にとどまらず、音や動きを伴う想像の場面がまるごと読み取られる。ある記憶があなたにとってどう感じられるのかを、それなりの忠実度でファイルに書き出し、他人が開けるようになるかもしれない。
エピソード記憶の再生。 先週土曜日の1時間を、あなた自身の認知の形式のまま記録したもの。頭の中で思い返すときと同じくらい鮮明に、あとから自分で再生できるかもしれない。
思考の連続的な意味の書き起こし。 思考をリアルタイムで書き起こしたもの。言い換えれば、読心だ。これが技術的に可能になった瞬間、この話題をめぐるあらゆるプライバシーの問題が一斉に噴き出す。この段が消費者に届く前に、この分野はまったく新しい種類の社会的なファイアウォールを設計しなければならない。この段階では、アルゴリズムそのものを書くよりも、読心が社会にもたらす影響に対処するほうがはるかに難しくなるからだ。
はしごの頂上にあるものを言い表す的確な言葉を、私たちはまだ持っていない。それは人間の認知と機械の推論をつなぐリアルタイムで完全な双方向のチャネルであり、そこでは「私が考えたこと」と「私たちが一緒に計算したこと」の境目が見分けられなくなる。これを「融合(the Merge)」と呼ぶ人もいる。
このはしごで示したかったのは、非侵襲型BCIがどこまで行けるのか、そして何を可能にしうるのかだ。最下段が消費者向けの品質で製品化されさえすれば、残りはフライホイール効果第4節スケールへの最短路第I部 · 信号: 脳は読み取れるのか?▸によってついてくる。非侵襲型BCIの第一波は、そこそこ役に立つ程度のもの、おそらくはウェルネス向けのウェアラブル機器になるだろう。そこからは世代を重ねるごとに、能力が指数関数的に伸びていく。私たちはいま、その第一波の入り口に立っている。
キャリブレーションのはしご
ただし、ここには見えにくい落とし穴がある。能力のはしごは、デバイスがすでにあなたを理解していることを前提にしている。
実際には、脳は指紋のようなもので、まったく同じ配線の脳は二つとない。つまり、脳ごとに別々にデコードしなければならない。現時点のBCIはオーダーメイドのスーツに近く、採寸した本人にしか合わない。デバイスが思考を解読できるようになるまでには、モデルがその人に固有の神経の「なまり」を学習するキャリブレーション期間が要る。
この余分な手間こそ、消費者向けデバイスを作るうえで最大のボトルネックだ。研究室なら、大学院生が6時間かけて辛抱強くデコーダを学習させてくれるかもしれない。だが現実の世界で、消費者は少しも待ってくれない。ほぼ即座に動かなければ、デバイスは引き出しに放り込まれる。
ここで二本目のはしごが登場する。能力のはしごと並んで伸びるもので、非侵襲型BCIを研究室の外で使ってもらうには、こちらのほうが重要だとも言える。私はこれをキャリブレーションのはしごと呼ぶ。新しいユーザーがデバイスを使えるようになるまでに、どれだけの労力をかけなければならないかを測るはしごだ。
能力のはしごは、デバイスが何を読み取れるかを表す。キャリブレーションのはしごが表すのは、その読み取りにどれだけの手間がかかるかだ。
期待されているのは、多数の脳にまたがる事前学習によって、新しい脳をデコードする限界費用が一気に下がることだ。言語モデルでゼロショット学習がまさに同じ問題を解決したのと、まったく同じ構図になる。
本稿で述べる戦略は、AIがこの10年で使ってきたのと同じスケーリング戦略で非侵襲型BCIをスケールさせ、BCIの第一世代の消費者向け製品を作ることだ。狙いは、フライホイール効果に火をつけ、それによってBCI分野全体を加速させることにある。
残された最大の未知数は、非侵襲型BCIが能力とキャリブレーションの両方のはしごで、この目標を達成できるほど高い天井を持っているかどうかだ。正直に言えば、この分野全体がいま、戦場の霧の向こうを見つめている。
13見えない天井
「私たちは、テクノロジーの影響を短期的には過大評価し、長期的には過小評価しがちだ」 ――ロイ・アマラ(Roy Amara)、アマラの法則
この定石は、実際に私たちをどこまで連れていってくれるのか? どれくらいの期間で? そもそも物理法則がそれを許すのか? 実のところ、誰にもわからない。
確信をもって語られてきたBCIの予測は、その歴史の大半が外れたタイムラインの墓場だ。それでも私は、自分の予測をここに示す。
弱気シナリオでは、頭蓋骨と頭皮、そして地球の磁場が重なってノイズの下限をつくり、頭の外から取り出せる信号の量に上限を課すかもしれない。この最悪のケースが現実になれば、非侵襲型は「医療の場面でそこそこ役に立つ」程度で頭打ちになり、高帯域幅の思考デコーディングに至る道は侵襲型の手術しか残らない。
だが、現場の実情はこうだ。実際の実験では、私たちはその壁にまったく近づいてもいない。最大規模の非侵襲データセットでさえいまだ単一モダリティで、被験者は数十人、計測時間は1万時間に満たない。この経験的な事実を覆せる理論上の議論はない。現在の実験結果はすべて、まったく同じ方向を指している。対数線形のスケーリング則の曲線を、まっすぐ上へ。頂上がどこにあるかを知る唯一の方法は、そこへ向かって登ることだ。
覚えているだろうか。本稿の前半では三つのS字カーブ能力の三つのS字カーブ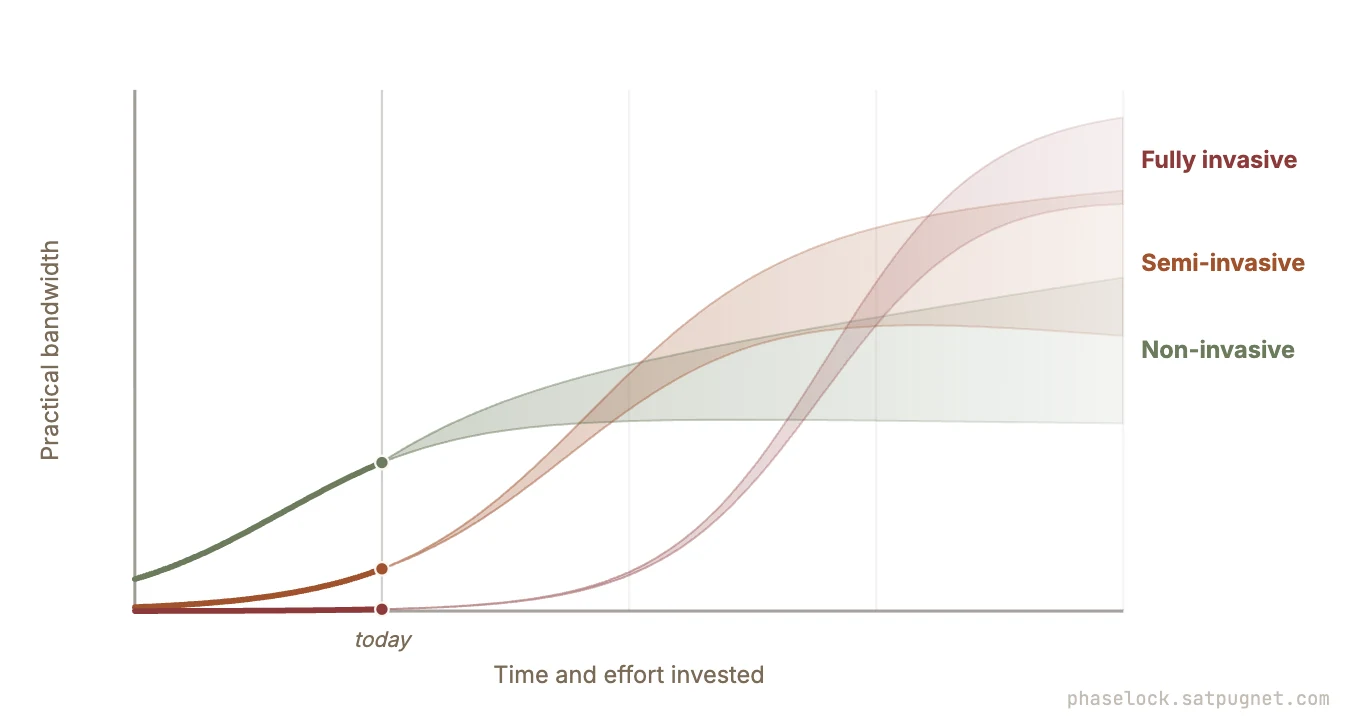 ▸を使って、各モダリティが到達しうる理論上の上限を示した。あれはあくまで図解にすぎない。実際には、私たちはいまカーブの一番下に立ち、暗闇を見上げている。
▸。何が可能かの限界を知る唯一の方法は、はしごを作って登ってみることだ。このスケーリングの仮説が成り立ち、本当に複利的に効いていくには、ハードウェアが消費者の日常的な普及を阻む手間のハードルを越えなければならない。それが起きつつあることを示す初期の証拠は、すでに出ている。言語モデルで見たのと同じように、BCIのスケーリング則はすでに研究室で見え始めており、予測もしやすくなっている。
この軌道が続くと仮定しよう。最良のシナリオでは、3〜6年以内に最初の1,000万台の非侵襲型脳インターフェースが実社会に出回る。6年以内には、アーリーアダプター向けの技術から、日常のコンピューティングのどこにでもある層へと進化するだろう。スケーリング則はこの膨大な新しいデータの流れを糧にしてフライホイールを回し、この分野が資本と人材を惹きつける力を指数関数的に高めていく。
では、二本のはしごの上で、私たちは実際にどこにいることになるのか。天井にぶつかるまでに、どこまで登れると見込めるのか。
- 能力のはしご:内なる意図、内なる感情、無声発話の認識、視覚的な概念の再構成は、いずれも手術なしで実現する可能性が高い。うまくいきそうな兆しは、すでに今日の時点で表れ始めている。音と動きを伴う記憶を書き出すような、完全にマルチモーダルな想像のデコードは、非侵襲では可能性こそ低いがゼロではない。
- キャリブレーションのはしご:人口規模のデータで学習した基盤モデルのおかげで、キャリブレーションにかかる負担は激減する。現代の音声AIが、初めて聞いた声でもキャリブレーションなしにすぐ理解するのと同じだ。BCIの基盤モデルはすでに何千もの脳を見てきているので、最小限のキャリブレーションであなたの神経パターンを認識できる。新しいデバイスが新しい脳に適応するのに数分しかかからない段階に、いずれ到達する。
このマニフェストは、非侵襲型BCIで到達できる天井が、現在の通説が想定するよりはるかに高いという確信に立っている。理論では決着がつかない以上、この確信を確かめる唯一の方法は、実際に実験してみることだ。
だが、AIの定石を試すには膨大なデータが要る。最初の数桁までは実験室で集められても、ある規模を超えると手に負えなくなる。何百万人もの人が実際にハードウェアを身につけない限り、規模は拡大しない。この急速なスケーリングのループに火をつけるには、この分野は実験室を出て、きわめて実際的な問いに答えなければならない。最初の1,000万人のごく普通の消費者に、脳コンピュータインターフェースを頭に着けようと思わせるものは、いったい何なのか?
14消費者市場という楔
「十分に発達した科学技術は、魔法と見分けがつかない」 ── アーサー・C・クラーク(Arthur C. Clarke)
ここまで理論に多くの紙幅を割いてきたが、考えを現実につなぎとめておくことも大切だ。それとなく触れてはきたものの、非侵襲型BCIの最初の製品群が実際にどんな姿になりうるのかは、まだはっきり描いていない。
第9節第9節第二層:データのスケーリング論第II部 · スケーリング:AIのスケーリングの定石は脳にも通用するのか?▸では、AIがフロンティアモデルに使うデータと、BCIが現在持っているデータとのあいだにある4桁の差と向き合った。この差を埋めるには、桁違いに多くのユーザー、つまりBCIを日常的に使う何百万人もの人々が必要になる。
ここで当然の疑問が浮かぶ。この1,000万人とはいったい誰なのか。そして、頭に何を着けるのか?
普通の人は抽象的な科学の到達点など買わない。「対数線形のスケーリング則」にも「基盤モデル」にも関心はない。人が製品を買うのは、具体的な問題を解決してくれるか、魔法のように感じられるからだ。
大手テック企業はすでにこの移行に向けて布石を打っている。2025年、Appleは「Human Interface Device」プロトコルを導入し、BCIをiPhoneの第一級の入力として登録できるようにした。
1,000万台のデバイスを1,000万人の頭に載せる楔は、おそらく単一の一枚岩のキラーアプリにはならない。「最初の良いアプリ」の集まりになるだろう。新しいハードウェアを頭にくくりつける物理的な煩わしさを乗り越えられるだけの、すぐに実感でき、否定しようのない有用性を備えた製品群だ。初期採用者ならSF的な目新しさだけで不格好なウェアラブルにも我慢するかもしれない。だが本当の意味で消費者規模に達するには、やはり有用性が一目でわからなければならない。
キャズムを最初に越える突破口として最も有力なのは、二つの製品だ。
一つ目は摩擦のないコミュニケーション、いわばテレパシーだ。親指も声帯も使わずに機械と話せる。スマートグラスやコーディング支援ツール、AIアシスタント向けに、無声発話のテキスト化と意図のデコードが可能になり、入力はタッチより速く、音声より静かで、初めから意識せずに使えるものになる。ハンズフリーでの拡張現実の操作(Meta Neural Bandのような形)も実現し、話すことやタイプすることに不自由のあるユーザーにとっては、重要なアクセシビリティの架け橋にもなる。
強みは帯域幅とシームレスさにある。脳から直接読み取れば、キーボードやマイクではとうてい得られないほど忠実に意図を捉えられる。最初のうち、生の読み取りは完全に正確ではないが、正確である必要もない。初期のハードウェアの限界は巧みな製品設計が覆い隠し、段落単位の思考を完璧にテキスト化する機能は後からやって来る。最初の波は、大まかな意図の読み取りと粗い指標に頼ることになるだろう。粗いテレパシーを、文脈の残りを推し量れるほど賢いAIと組み合わせれば、魔法のように感じられ始める25。
二つ目はウェルネスと回復、いわば脳のためのWhoopだ。長寿を追求するムーブメントは、ニューラルインターフェースへの強い消費者需要を生んでいる。ユーザーはすでに、身体の回復を記録するためにリングやリストバンドを取り入れている。神経系のウェアラブルは、中枢神経系のコンディション、感情の状態、受動的で継続的なストレスを追跡し、欠けていた監督の層を補う。認知状態を把握する必要のある隣接分野でも、数多くの応用が可能になる。手術や航空管制のように失敗の許されない現場での、専門職の疲労チェックはその一例だ。
非侵襲型BCIの「最初の良いアプリ」になりうるものとしては、ほかに次のようなものがある。
- 脳を感知する環境:あなたの内面の状態をもう見落とさないソフトウェア。共感的なAIアシスタントは、あなたの認知負荷をプロンプトの文脈の一部として取り込める。疲れ切っているときは短く切れのよい答えを返し、混乱を感じ取れば踏み込んだたとえを示し、フロー状態にあるときは通知を完全に止める。学習ソフトも同じように注意と集中を追跡し、気持ちが昼食のことにそれた瞬間に授業計画を組み替える。
- 内なる空間のスタック:人間の意識を探求し、最適化するためのツール群。本物の神経の「深さスコア」を追跡し、集中が途切れるとマインドフルネスの鐘をそっと鳴らすクローズドループの瞑想アプリ。レム睡眠の周期を追跡して明晰夢の合図を送ったり、眠りが最も浅い瞬間にスマートアラームを鳴らしたりする睡眠・夢関連の製品26。そして、メンタルヘルスの最適化や臨床的なうつ病に向けた治療ツールなどがこれに含まれる。
- 創造のエンジン:思考から画像を生成する、プロ向けの創作ツール。画像生成AIに複雑なテキストプロンプトを打ち込む代わりに、デザイナーは視覚的なコンセプトを心の目に浮かべ、システムがそのラフを画面に描き出すのを見守る。同じことは音楽や映画の制作にも当てはまる。心の状態をとらえて創作ソフトウェアに翻訳しようとする媒体なら、どれでもこの恩恵を受けうる。
1,000万台のデバイスが実地で使われるようになれば、あらゆることが加速する。製造コストは急落し、センサー群はコモディティ化し、データは豊富になり、基盤となるデコーダーモデルは共有の公共財になる。
この消費者市場のフライホイール戦略は、進歩のタイムラインを大きく縮めうる。学術界の終身在職権をめぐる道のりや臨床試験といった、遅く手順を重んじる時間軸から抜け出すことで、非侵襲型BCIは大きな構造的優位を得る。データを大規模に蓄積できるのだ。フロンティアAI開発の驚異的な速さを考えれば、この消費者主導の爆発こそが、BCIがフロンティアAIに追いつける見込みを持ち、人間がループの中にとどまれるほど速く進む唯一の道だ。
超知能への移行期に人間をループの中にとどめるうえで、BCI、ひいてはニューロテクノロジー全体が役割を果たすのなら、追いつかなければならない。それも急いで。侵襲型の手術のような、もどかしいほど遅いペースで進むわけにはいかない。だからこそ、それを成し遂げるために残された狭い窓のうちに、迫りくるAIのテイクオフを追い越せるほど速い経路は、非侵襲型の消費者ループしかないのだ。
15フェーズロック
「期待されるのは、それほど遠くない将来、人間の脳と計算機械がきわめて緊密に結びつき、その協働が、これまでどの人間の脳もしたことのないような思考をすることである……」 ── J・C・R・リックライダー(J. C. R. Licklider)『Man-Computer Symbiosis』1960年
AGIはもうすぐやって来る。もはや遠い思考実験ではなく、誰もが未来の早い到来を予期している。そして時間軸が早まったことで、根本的な問いが浮かび上がる。人間を実際にループの中にとどめておくには、どうすればいいのか?
フロンティアAIの進歩はますます速くなり、フラッグシップモデルはいまや毎月、ときにはそれ以上の頻度でリリースされている。次に起こることを形づくれる機会の窓は、恐ろしいほど狭い。いまは、私たちが知る世界の最後の数年間だ。優れた予測実績をもつ予測サイトMetaculusは現在、弱いAGIが2028年半ばまでに実現すると見積もっている。知能の閾値を完全に越えて新世界に入るまで、残された時間は長くても2、3年しかない。
決定的な選択、つまりこれらのモデルが何を最適化するよう学ぶのか、誰の選好が反映されるのか、最終的に人類とどうつながるのかは、まさに今この瞬間に固まりつつある。知能が向上し続けるなかで主体性を保ち、人間を本当にループの中にとどめることが目標なら、人間と機械のインターフェースは今後数年のうちに実現しなければならない。
AIが人間を超えると人類が認識してから、実際に超えるまでのこの短い期間を、私はフェーズロックの窓と呼ぶ。人間と機械の知能の関係が、はるかに変えがたいものへと固まってしまう前に、私たちがまだその関係を形づくる主体性をもっている狭い期間のことだ。フェーズロックの窓が開いているのは、おおむね現在から2030年代半ばまでである。
誤解のないように言っておくと、BCIがAGIの提起するあらゆる問題を魔法のように解決するわけではない。社会経済的、哲学的、技術的なアラインメントの問題が山ほどあり、それらにも答えを出さなければならない。しかも第22節第22節大規模な読心:何が起こりうるのか第IV部 · 余波: 未来に何をもたらすのか?▸で述べるとおり、この技術自体が非常に危険だ。それでも、BCIとニューロテクノロジーは、人間と機械のあいだのコミュニケーションと認知のボトルネックに対する唯一の構造的な解決策であり、機械を縛るのではなく人間の能力を広げる唯一の解だ。だからこそニューロテクノロジーは、AIアラインメントにとって長期的に最も強力なてこの一つになる。ただし、その役割を果たせるのは間に合うようにスケールした場合に限られる。BCIを解決策の一部にするために残された時間は、ほんの数年しかない。
この切迫感こそ、本マニフェストが非侵襲型BCIによって分野を加速させる具体的な戦略を提案する理由だ。高帯域の脳コンピュータインターフェースの確立に侵襲的な手術が必要なら、この10年のうちには実現しない。そして実現したころには人工超知能への移行は終わっていて、問うに値する問いのほとんどは、手元にあった限られた道具で答えが出されてしまっているだろう。手術による路線では、フェーズロックの窓が開いているうちにデータのギャップを埋められない。だから非侵襲型ハードウェアの爆発的な普及こそが、未来が永久に固定される前に生物学をアラインメントの道具箱に組み込むための、残された唯一の経路となる。
超知能の到来と照らし合わせると、消費者主導のこのBCIの爆発的普及は、単なるクールな製品のマイルストーンではない。むしろ緊急の救出作戦に近い
設計図と収束
第II部第II部スケーリングAIのスケーリングの定石は脳にも通用するのか?▸を通じて、私たちは一つの核心的な問いを立ててきた。AIのスケーリングの定石は脳にも通用するのか?
非侵襲型BCIについて、証拠からたどれる範囲で言えば、答えはイエスだ。
厄介な生物学をいったん脇に置き、脳を計算機科学の問題として扱うと、AI時代の初期との類似はあからさまだ。データがすべてを物語っている。BCIは、初期のディープラーニングブームと同じ軌跡を8年遅れでたどっている(8年の時差のグラフAIとBCI、8年の時差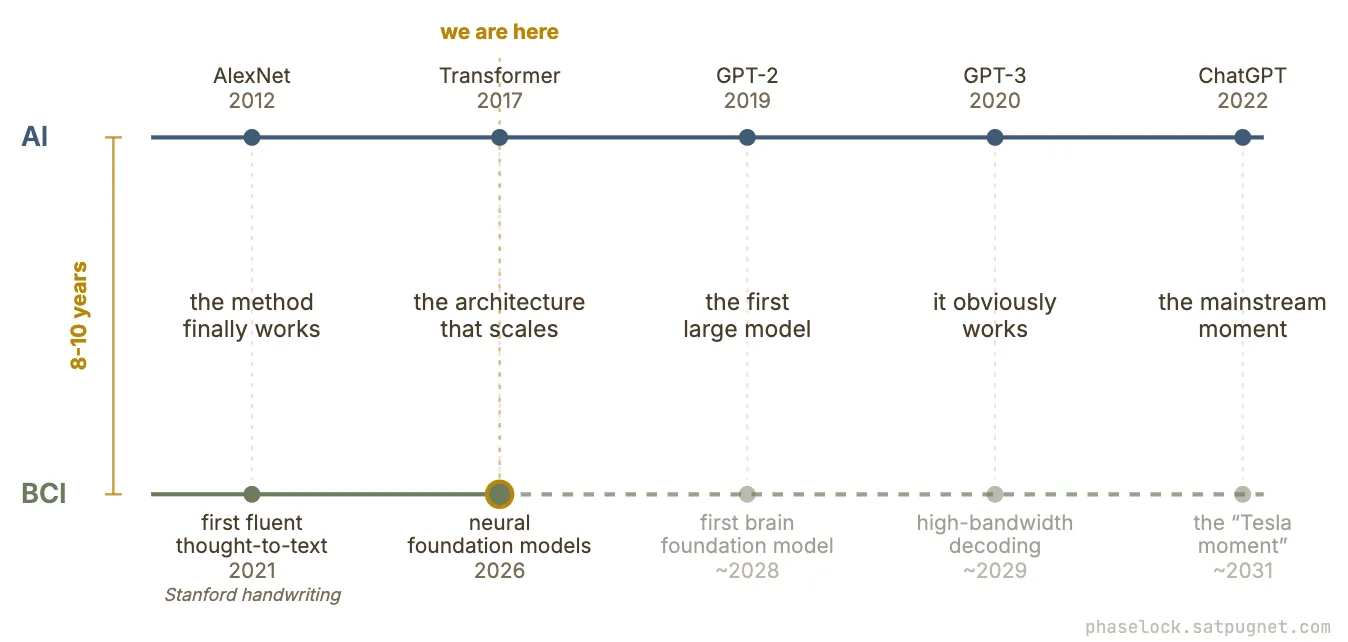 ▸を参照)。
いま私たちの手には、非侵襲型BCIをスケールさせるための完全で一貫した設計図がある。第II部第II部スケーリングAIのスケーリングの定石は脳にも通用するのか?▸の最終的な結論は、BCIとニューロテクノロジーが人類の未来を形づくるうえでまだ意味をもちうる、短く、奇妙で、壊れやすい窓の中に私たちが立っているということだ。ただし、このフェーズロックの窓は驚くほど狭い。
とはいえ、AIとBCIをそれぞれ単独でスケールさせる話は、物語の半分にすぎない。AIの能力が高まるほど、なぜBCIやニューロテクノロジー全体の重要性が増すのか。それを理解するには、二つの技術がどう収束していくのかを見る必要がある。ニューロテクノロジーは現代のAIに着想を与えた。いまはAIがニューロテクノロジーを加速させている。そしてBCIが成熟すれば、再びAIの土台となるだろう。BCIはまもなく、フロンティアモデルを構築し、運用するためのインフラになる。次世代AIモデルの学習とアラインメントに必要なマルチモーダルな神経データを提供し、言葉ではなく思考でモデルを直接操る高帯域のインターフェースを生み出すのだ。決定的に重要なのは、この架け橋が、AIそのものと歩調を合わせてスケールできる数少ないアラインメントのてこの一つだという点である。
AIとBCIはいま、真正面からの衝突が目前に迫る軌道にある。
視野を広げて見ると、私たちの現在地はここだ。
第I部第I部信号脳は読み取れるのか?▸で、私たちは自らに問いかけた。脳は本当に読み取れるのか?
第II部第II部スケーリングAIのスケーリングの定石は脳にも通用するのか?▸では、AIの定石を手にそれを脳で実行したら何が起こるのか?と問いかけた。AIのスケーリング戦略を非侵襲型BCIに当てはめれば、消費者向けBCIプロダクトの第一世代をどう切り開けるかを探った。
その答えを出すために、四層のピラミッドを組み立てた。土台にハードウェア、その上にデータ、さらに基盤モデル、頂上にプロダクトを置き、下から順に登っていった。ハードウェアの層は、研究室向けの仕様から、規模の拡大に耐える仕様へと移らなければならない。データの層は、フロンティアAIのコーパスとのあいだにある4桁の差を埋める必要がある。基盤モデルの層には、言語モデルを飛躍させたオープンな協働とスケーリングの文化を受け継ぐことが求められる。
続いて各層から一歩引き、システム全体を見渡した。この分野を足踏みさせてきた協調の問題、つまりどの層も合理的に判断した結果、下の層が先に動くのを待っているというコールドスタートの罠を論じた。進歩を測るための二本のはしごも描いた。能力のはしご(デバイスが何を読み取れるか)と、キャリブレーションのはしご(新しい脳で機能させるのにどれだけ安く済むか)だ。頭蓋骨が思ったより早く信号の上限を決めてしまうかもしれないという弱気シナリオにも向き合い、机上の議論ではこの問いに決着はつかないと結論づけた。非侵襲型BCIの天井を見つける唯一の方法は、その限界を実証的に試すことだ。最後に、このハードウェアを研究室からこっそり連れ出し、1,000万人の頭に載せる見込みが最も高い二つの突破口、摩擦のないコミュニケーションと継続的なウェルネストラッキングを検討した。
その道のりで、私は三つの根本的な前提を置いてきた。
- 非侵襲で得られる脳信号には十分な情報が含まれている。頭蓋骨の外にあるセンサーで解読できるだけの情報を、脳が発していなければならない。初期の結果は、実際にそうであることを示唆している。
- スケーリング則は脳データにも当てはまる。データが増えるほど、性能は上がり続けなければならない。バンヴィル(Banville)らScaling laws for decoding images from brain activity8つのデータセット、84人の被験者、EEG・MEG・3T fMRI・7T fMRIにわたる計498時間。非侵襲の神経デコーディングについて初めて公表されたスケーリング則で、データ量に対して対数線形に伸び、頭打ちは見られなかった。▸が報告した指数関数的な曲線は、早々に頭打ちになることなく、10万時間、100万時間規模のコーパスでも続かなければならない。
- 脳の基盤モデルは人をまたいで汎化する。十分な数の被験者で学習したモデルなら、ユーザーごとのキャリブレーションを数時間から数分に縮めるか、完全になくせなければならない。
三つがすべて成り立てば、テレパシーのような脳と機械のコミュニケーションが、この10年のうちに消費者の手に届く現実になる。そうなれば強力なフライホイールが回り始め、分野を加速させ、ニューロテクノロジーがAIとの差を縮める後押しになる。
13. Metaはメタバースでも AIでも最近つまずいているが、ニューロテクノロジーでは見事なほど時代を先取りしてきた。最新の研究がそれを物語っている。
14. リチャード・サットン(Rich Sutton)が2019年に示した『苦い教訓(The Bitter Lesson)』とは、データと計算資源に応じてスケールする汎用的な手法が、人間が手作業で組み込んだ知識を最終的に上回るという教訓だ。それが「苦い」のは、自分たちの巧みな専門知識が力任せのスケールほど重要ではないという発見に、研究者たちが何度も抵抗してきたからである。
15. ここにはもっと深い問いが潜んでいる。「脳を理解する」ことが、そもそも明確に定義できる到達点なのかという問いだ。私はそうではないと考えている。理解とは圧縮であり、脳ほど複雑なシステムを圧縮できる範囲には限りがある。タル・ヤルコーニ(Tal Yarkoni)はIf we already understood the brain, would we even know it?(もし脳をすでに理解していたとして、私たちはそれに気づくだろうか?)でこの議論をさらに掘り下げ、その地点に達しても気づきすらしないかもしれないと論じている。
16. Common Crawlは、2008年からウェブを継続的にクロールして公開している非営利団体だ。そうして蓄積されたペタバイト規模のデータセットで、大規模言語モデルの大半が学習している。
17. ImageNetは、2万以上のカテゴリーにわたる約1,400万枚の画像にラベルを付けたデータセットだ。2012年のImageNetコンペティションは、コンピュータビジョンにおけるディープラーニング時代の幕開けとして広く認められている。
18. 誓って冗談ではない。この分野全体で最もよく使われているデータセットの一つは、文字どおり12人をそれぞれ6時間記録しただけのものだ。データは合計72時間しかない。私たちは、長めの週末1回分ほどの記録で、人間の脳の究極の基盤モデルを作ろうとしている。寿司屋のメニューを1枚見せてAIに日本語を教えるようなものだ。
19. 大規模な脳モデルを学習させる最善の戦略は、おそらく自動運転で使われているものとよく似ている。量は多いが不完全なデータ(自動運転の場合はシミュレーションデータ)でベースモデルを学習させ、量は少ないが質の高いデータ(自動運転の場合は実世界のデータ)でファインチューニングと検証を行うやり方だ。BCIに置き換えれば、ノイズの多い消費者の記録で事前学習し、よりきれいな研究室のデータでファインチューニングと評価を行うことになる。このやり方が機能することには、すでに証拠がある。
20. コンウェイの法則とは、ソフトウェアシステムはそれを作る組織のコミュニケーション構造を映し出す、という法則だ。1968年にメルヴィン・コンウェイ(Melvin Conway)が提唱した。
21. このアイデアはしばらく前から頭の中にあったのだが、気の散りやすい私が実際に書き上げるまでに時間がかかってしまった。2024年の証拠をいくつか挙げておく。「脳マッピングには新しいムーアの法則が必要だ。全脳マッピングは思っているより早くやってくる」、そして「脳とLLMが直接やりとりする日は、たぶん思っているより早く来る」。
22. 当然、実際にはこれより複雑になる。だが要点は、ブレークスルーは必要なく、求められるのは主にエンジニアリングだということだ。
23. より広いオープンなエコシステムからは、2023年以降、十数個ほどの脳の基盤モデルが生まれている。BrainLM、LaBraM、NeuroLM、REVE、POYO+、NDT3、LUNA、BENDR、BIOT、CBraMod、EEG-GPT、Neuro-GPTなどだ。
24. 本論が求めるような標準化の初期の例として、Meta AIが2026年5月に公開したNeuralBenchがある。94の脳データセットと14のディープラーニングアーキテクチャを一つにまとめて扱うオープンソースのベンチマークフレームワークで、まずEEGに焦点を当て、MEGとfMRIにも対応を広げている。この分野で共通の評価データセットを作ろうとする最初の試みの一つだ。
25. 消費者向けデバイスに組み込まれれば、BCIはUXをめぐる新しい問いも数多く突きつける。システムはいつ思考に応じて動くべきで、どれだけ速く動くべきか。どの思考が重要で、どれが通り過ぎていくだけの思考なのか。思考を前提としたUIをどう作るのか。人によって異なる心の働きを、どうやって行動に変換するのか。全体として、デジタル世界との関わり方を、インターネットやAIがもたらした変化以上に大きく作り直すことが求められるだろう。
26. 夢のデータが脳デコーダの学習に少しでも役立つとわかれば、睡眠は神経データを大規模に集める最も効果的な方法の一つになりうる。