16交わる軌道
「30年以内に、われわれは超人的な知能を生み出す技術的手段を手にするだろう。その後まもなく、人類の時代は終わる」――ヴァーナー・ヴィンジ(Vernor Vinge)、1993年
衝突コースにあるとは、実際にはどういうことなのか。そして、なぜそれがそれほど重要なのか。AIもBCIも、すでに50年以上の歴史がある。それなら、とうに予測可能な、踏み固められた軌道の上を進んでいるはずではないか。
旧世界ならそうだったかもしれない。だがその世界は、フロンティアLLMが登場し、AGI(汎用人工知能)が現実味を帯びた時点で終わった。技術の生物圏にあるほかのあらゆるものと同じく、BCIももはや以前の軌道の上で進化してはいない。AGIの重力が、その進路を変えてしまった。
歴史を振り返れば、AI以前の技術はかなり区切られた世界に住んでいた。バイオテックは宇宙技術とほとんど関係がなく、台湾はSaaS企業の評価額とほとんど関係がなく、ロボット工学は会計とほとんど関係がなかった。どの分野にも、それぞれの箱があった。
だがAIは、箱と箱を隔てる壁を溶かしてしまった。
理由は単純だ。どの分野も、実は同じものでできている。意思決定、予測、探索、設計、最適化、コミュニケーション、そして労働だ。AIはそのすべてに働きかけられる。だからAIは新しい産業のようにはふるまわず、あらゆる産業の下に広がる、形のない新しい層のようにふるまう。
だからこそ、AIは単なる「もう一つの技術」ではない。チップはコンピュータを速くしたが、チップ自身が次世代のチップを発明しようとしていたわけではない。電気は工場を動かしたが、工場を設計し直したのは電気ではない。インターネットは人々をつないだが、次に何をつくるべきかを決めたのはインターネットではない。考えていたのは人間だった。道具は私たちの力を増幅したが、反復を回すエンジンに取って代わりはしなかった。
より深い断絶は、人工知能がもはや仕事を加速するだけでなく、反復を回すエンジンそのものを積極的に引き継ぎつつあることにある。ロボット工学と組み合わされば、なおさらだ。AIはコードを書き、実験を設計し、結果を解釈し、次の手を提案し、やがては物理世界で行動するようになる。しかも数週間ごとに律儀に立ち止まって、人類に次の桁へ進む心の準備ができているかを尋ねてくれたりはしない。ひたすら最適化を続け、嬉々として自己改善を重ね、行き着くところまで行くだろう。
そこが恐ろしく、そして重要な点だ。私たちは受動的な技術から、参加する技術へと移りつつある。人間の頭脳が世界を前に進めるのを待つ道具から、自ら世界を前に進める力をますます備えていく道具へ。自己改善する技術が生み出されるのは、歴史上これが初めてだ。
今の軌道のままなら、人間は10年以内、長くても20年以内、おそらくはそれより早く、ループの外に置かれる。
人間が消えるという意味では必ずしもない。私が言いたいのは、もっと微妙で、じわじわと忍び寄る事態だ。文明を動かす進歩が、機械の速度で進み始める。研究、エンジニアリング、戦略、統治、資本配分、戦争、物流、そしてやがては物理的な生産までもが、ますますAIを介し、AIに加速され、AIによって実行されるようになる。人間はその場に残る。だが、もはや中心にはいない。
AIが世界を導いていく方向が、人類の繁栄、そして意識をもつほかの隣人たちの繁栄に根本から沿っているなら、それでも構わないかもしれない。だが、私たちが意味のある介入をできるようになる前に、システムに生じる力学が文明をもろく、異質で、ディストピア的な何かに閉じ込めてしまうなら、笑ってはいられなくなる。
この先どこへ向かうのか、正確に知る者はいない。だが今、ありうる未来のばらつきは、人類史のどの時点よりも大きい。30年後の私たちは、想像を絶するほど豊かな世界に生きているかもしれないし、前の世代には恐れるための概念の語彙すらなかったような形のディストピアに生きているかもしれない。そのどちらであってもおかしくない。
AGIまでのタイムラインがSFじみていて実感できないなら、2020年に自分が未来をどう見ていたかを思い出してほしい。おそらく、少し速いコンピュータや、より洗練された電気自動車、あるいはもう少しクリーンな電力網を思い描いていたはずだ。BCIヘッドセットを1台賭けてもいい。メールの下書きを書き、コードを書き、子どもの家庭教師をし、科学論文を要約し、動画を生成し、日々の仕事の大部分をこなし、100年来の数学の難問まで解く機械がある世界を、あなたは想像していなかったのではないか。28
では、同じ補正を未来に向けて当てはめてみよう。今も同じ過ちを犯していて、改善の速度をまったく同じように読み違えていると想像してほしい。今日を予測できなかったのと同じ線形の直感で今後10年を予測しているなら、その直感が出す答えは疑ってかかるべきだ。このささやかな思考実験は、指数関数に対して本能的に盲目な脳に抗うのに役立つ。
この実験の目的は、ごく普通の人間の脳を持っていることを責めることではない。弁解しておくと、これほど速い変化について明晰に考えなければならない場面は、人類にとってほとんど、あるいは一度もなかった。私たちの脳は、指数関数を直感で捉えるようにはできていないのだ。
だが、それがBCIにとってなぜ重要なのか? いや、もっと大事な問いは、なぜBCIがAIにとって重要なのか、だ。
BCIは、人類が主体性を保つための数少ない現実的な仕組みの一つであり、私たちが持つ唯一の長期的な解決策である統合によるアラインメントを推し進められる数少ない仕組みの一つだからだ。
フェーズロックの窓に入るにつれ、AIとBCIの衝突は主に三つの面で展開していく。
第一の面は学習だ。神経データは、AIラボやロボティクスのラボにとって次の主要なモダリティになる。テキストや動画など、これまでスケールされてきたどのモダリティよりも密度が高く、それらすべての構造的な上流に位置する。人間の認知の単なる産物ではなく、認知そのものの、編集されていない生の信号だからだ。第17節新たな主要学習モダリティ第17節新たな主要学習モダリティ第III部 · 衝突:なぜBCIはAIにとって重要なのか?▸では、ロボティクスのラボやフロンティアラボが実際に神経データのコーパスを買う理由を検討し、学習モダリティとしての神経データの背後にある数理を解きほぐす。
第二の面はインターフェースだ。高帯域幅のBCIは、AIと人間がやり取りする標準的な手段になる。キーボードとマウス、そしてフィードバックの経路が、ひとつの連続した流れにまとめられるのだ。第18節新しいインターフェース第18節新しいインターフェース第III部 · 衝突:なぜBCIはAIにとって重要なのか?▸では、無声発話による入力、意図のリアルタイムなデコード、途切れない認知的コンテキストが、AIとやり取りする新しい方法をどう生み出すかを示す。あわせて、コミュニケーションの帯域幅がAIの使い勝手を縛る最大の制約にますますなってきた理由も明らかにする。
第三の面はアラインメントだ。神経信号は、フロンティアAIの能力向上と歩調を合わせてスケールできる、数少ないアラインメントのてこの一つになる。人間と機械のあいだの帯域幅の格差を埋め、人間がシステムと意味のある形で結びついたままでいられるようにするのだ。第19節AIアラインメントにとってなぜ重要か第19節AIアラインメントにとってなぜ重要か第III部 · 衝突:なぜBCIはAIにとって重要なのか?▸では、AIの能力が人間の監督できる速度をはるかに追い越していくなかで、BCIとニューロテクノロジーこそが文明にとってアラインメントを実現する主要な望みの一つだと論じる。その道筋は三つある。RLHFに高精度の報酬信号を与えること、人間の価値観が脳にどう符号化されているかの理解を大きく深めること、そして最終的には、人間とAIの共生と、私たちの生物学的な心のアップグレードだ。
AIとBCIはいま、正反対の方向から収束しつつある。人工ニューラルネットワークは生物のニューロンを抽象化したものとして始まったが、AIはすぐに神経科学をはるかに超えて規模を拡大した。そして両者の関係は、相互的なものになりつつある。AIは脳を解読する能力を加速させ、BCIは、ますます高性能になるAIシステムを学習させ、それとやり取りし、アラインメントするための手段として浮上しているのだ。
第III部第III部衝突なぜBCIはAIにとって重要なのか?▸の残りでは、この三つの面を順に見ていく。まずは、BCIがAIにもたらす新たな学習モダリティからだ。
17新たな主要学習モダリティ
「私たちは、語ることができる以上のことを知ることができる」――マイケル・ポランニー(Michael Polanyi)『暗黙知の次元』1966年
もしインターネット上の全テキストが1マイルの長さだとしたら、5万人の1年分の思考だけで月まで届く。29
それなのに、この思考の海のうち、頭の外に出ていくものはほとんどない。
だが、この状態は長くは続かない。脳データは、フロンティアモデルにとって新たな主要学習モダリティになろうとしている。
最初はどう聞いても突飛な話だろう。だが、第一原理から分析して私がこの結論に至った道筋を、順にひもといていきたい。
フロンティアAIラボが頭蓋骨の中の電気的なノイズになぜ関心を持つのかを理解するには、この5年間にラボが何を取り込んできたかを見る必要がある。そして現在のデータ収集のパラダイムの先に目を向け、こう問わなければならない。AIの学習データとは、本当のところ何なのか?
地図は土地ではない(そしてテキストは思考ではない)
現代AIの歴史は、つまるところデータをあさる物語だ。私たちは、人間がブログや書籍、書き起こし、インターネット、動画に残してきた痕跡、つまり文明が雑然とデジタル化されて残った残滓を集め、そこから人間の知能の根底にある論理をリバースエンジニアリングしてきた。Transformer以降、現代AIの物語を動かしてきたのはアルゴリズムではなくデータであり、モデルのアーキテクチャはその間ほとんど変わっていない。
実際、AIに与えられる感覚の献立は広がり続け、段階を踏むごとにモデルはより豊かな現実の一面を手に入れてきた。テキストは圧縮された人間の知識をもたらした。コードは実行可能な推論と、厳密な論理を鍛える場を与えた。画像は知覚を、音声は話し言葉とタイミングをもたらした。そして動画によって、モデルは時間の中で展開する動きと因果関係を知った。
しかし、このアプローチには巨大で構造的な欠落がある。現在使われているデータセットはどれも、実際の認知エンジンである脳が生んだものを強く圧縮し、情報を取りこぼした、下流の副産物にすぎない。
文章を書くとき、動画を撮るとき、コードを1行書くとき、脳はすでに膨大な高次元の計算を終えている。画面やキーボードに現れるのは、その過程から一列に吐き出された、ごくわずかな排気にすぎない。
- テキストは思考ではない。テキストは結論を低帯域幅で表現したものであり、ためらいや、検討された反実仮想の道筋、その結論を組み立てた心の構造はそぎ落とされている。
- コードは認知ではない。コードは最終的な実行スクリプトであり、エンジニアの頭の中で起きた目に見えないデバッグの過程や、構造上の理由づけがまるごと抜け落ちている。
- 発話は意図ではない。発話は内面の状態を音響的に圧縮したものであり、語彙と発声の仕組みに縛られている。
- 画像や動画は経験ではない。そこに写るのは物体に当たって跳ね返った外界の光子であって、観察者の内なる世界モデルや空間的な直感ではない。
神経データは、山積みのデータセットにもう一つ加わるだけのものではない。神経データは、他のあらゆるモダリティの構造的な上流にある。人間の認知そのものが発する、加工も編集もされていない高忠実度の信号だ。知覚・注意・記憶といった基本的な仕組みの上流にあり、言語や身体動作といった能動的な出力の上流にもある。そして決定的に重要なのは、道徳的判断や美的な好み、創造的な主体性を生み出す、複雑で目に見えない仕組みのさらに上流に位置することだ。脳データで直接モデルを学習させれば、AIラボは洞窟の壁に映る影を調べるのをやめ、火そのものを見つめ始めることになる。30
暗黙知をあらわにする
この構造的な溝は、人間に推論を書き残してもらうだけでは埋まらない。人間の知識のうち驚くほど多くの部分は、意識的な言語のまったく外側で働いているため、キーボードやカメラではそもそも捉えられない。経済学者や哲学者はこれを暗黙知と呼ぶ。やり方は知っているのに、そのやり方を言葉にできない知識のことだ。
次のような認知状態を考えてみてほしい。
- 熟練した数学者が、ある証明の方向性が「しっくりくる」と突然感じる美的直観や科学的な勘。
- 百戦錬磨の外科医が、一刻を争う危機のさなかに瞬時に働かせるパターン認識。
- AIの出力に深く隠れた倫理的な異常が含まれているときに覚える、強い道徳的な居心地の悪さや、かすかな認知的な引っかかり。
- 一流のアスリートやパイロットが複雑な軌道をたどるときに働く、生の力学的なフィードバックループ。
この知識はウェブからスクレイピングできない。ウェブ上に存在しないうえ、言葉にもできないからだ。トップクラスの研究者に画期的な仮説をどう思いついたのかと尋ねると、多くの場合、漠然とした「勘」や「直観」を挙げるだろう。
その勘は魔法ではない。生物の神経ネットワークの中で起きている物理的な計算だ。非侵襲型の消費者向けBCIは、こうしたつかの間の、これまで記録できなかった信号をすくい取る網を、史上初めて私たちにもたらす。専門家の神経データのコーパスを集めれば、フロンティアラボは人間の専門性の最も純粋な形でモデルを学習させられる。語られることも書かれることもない、人間の知能のダークマターを捉えられるのだ。
もちろん、こうした認知プロセスはある程度まで推測できるし、現在のモデルがやってきたのもまさにそれだ。だが、文明が残した産物から人間の推論を再構成するのは、目の見えない人に言葉だけで「見る」ことを教えるようなものだ。これほどうまく機能していること自体、奇跡と言うほかない。とはいえ、推測は観察と同じではなく、限界もある。脳データがあれば、パラダイムは推測から直接観察へと移り、AIが再現しようとしている生物の推論エンジンにようやく直接アクセスできるようになる。
現代のAIシステムのでこぼこな知能は、まさにこの欠けた学習信号から生じている。心の認知のダークマター、つまり行動を大きく左右するのに、行動だけからは推測しにくい脳の働きだ。BCIのデータセットは、こうした能力をAIシステムに植えつけ、より人間に近く、でこぼこの少ない知能をもつモデルを生み出す助けになりうる。31
あらゆるデータセットの構造的な上流
神経データは、山積みのデータセットにもう一つ加わるだけのものではない。他のあらゆるデータセットの原料となる、生の素材そのものだ。運動や言語というフィルターを通る前の、圧縮も編集もされていない人間の認知の信号にほかならない。
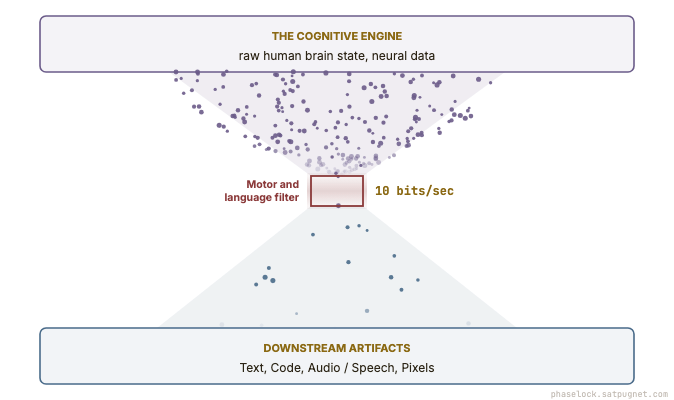
神経データは知能の源泉そのものに位置する。だからこそ、しっかりした神経コーパスがあれば、現在の学習モダリティでは捉えにくい認知の性質を直接観察できる。
- 注意と集中。人間の心が何を重要とみなすかが、ミリ秒単位でどう移り変わるか。
- エラー検出。手で直す段取りを考えるより前に、何かが壊れている、間違っていると即座に、無意識に気づくこと。この信号はすでに、ロボットの誤りをリアルタイムで修正するのに使われている(Salazar-Gomez et al., ICRA 2017Correcting robot mistakes in real time using EEG signals観察者の脳波から解読したエラー関連電位によって、Baxterロボットの二択の到達動作をリアルタイムで修正した。被験者ごとのキャリブレーションは行っていない。ためらいやエラーの信号が被験者をまたいで解読できることを示した、代表的な存在証明。▸)。
- 選好と判断。説明が後づけで合理化されるはるか前から人間の選択を左右している、美的・道徳的・社会的な価値判断の水面下での揺れ。脳信号を読むだけで、ある人が車を買うかどうかを70〜80%の確度で言い当てることが、すでにできている(Tusche, Bode & Haynes, J. Neurosci. 2010Neural responses to unattended products predict later consumer choices内側前頭部のfMRIに多ボクセルパターン解析を適用し、実際の自動車購入の判断を70〜82%の精度で予測した。被験者が意識的に注意を向けていなかった製品についても予測できた。行動より前に選好を解読できることを示した、基礎となる存在証明。▸)。
- 言語と統語。言葉が選ばれる前から存在する、言語以前の概念の地図。研究者たちはすでに、声に出されない無音の内言を大脳皮質から直接デコードすることに成功している(Willett et al., Cell, 2025年8月Inner speech in motor cortex and implications for brain-computer interfaces麻痺のある被験者の皮質内BCIから、声に出されない言語(純粋な内言)を初めてデコードした。言語に圧縮される前の、その人が意味していることを直接読み取れることを示す、これまでで最も明瞭な信号。▸)。
- 推論。答えが現れる前の、隠れた探索の過程。混乱、仮説の検証、認知負荷、不確かさ、葛藤、そして解決策がぴたりとはまる瞬間。
- 意図。身体の動作に圧縮される前の、ユーザーが達成しようとしている生の目標。
- 意味の対応づけ。生物の心が現実を実際にどう切り分けているかを表す、根底にある多次元の幾何。言語モデルを人間の脳活動を予測するようにファインチューニングすると、下流タスクの性能が測定できるほど向上するという証拠も、すでにある(Schwartz, Toneva & Wehbe, NeurIPS 2019Inducing brain-relevant bias in NLP models脳活動を予測するようにファインチューニングしたBERTは、下流のNLP性能を損なわずに参加者をまたいで転移する。神経信号が言語モデルにバイアスを与えうることを示した、最初期の存在証明。▸)。
脳データをフロンティアモデルに組み込めば、ラボは人間の心をその足跡から再構成しようとするのをやめ、認知を生み出す機構そのものでモデルを直接学習させ始められる。発話より先にある注意、行動より先にある意図、説明より先にある選好、修正より先にあるエラー検出、論証より先にある直観を、モデルに学ばせるのだ。
神経データは新たな主要モダリティになる。脳データはノイズが多く、私的で、集めにくく、ラベル付けしにくく、落とし穴だらけだ。それでも十分な規模になれば計り知れない価値を持ち、いま学習に使っているほかのあらゆる種類のデータの源泉でもある。人が文章を書き、ボタンをクリックし、応答を評価し、考えを変え、誤りに気づく前には、その下に認知状態がある。今日のモデルが見ているのは、主にその状態の残りかすだ。神経データは、状態そのものを標本として取り出す初めての学習信号になる。これまでのやり方は、元の音声ではなく字幕でモデルを学習させてきたようなものだ。字幕は言葉を残す。だが音声には、ためらいや強調、そしてテキストの一行が確定する前に圧縮されて消えた生煮えの思考が残っている。
今日のモデルは字幕から学んでいる。神経データは、その字幕のもとになった音声だ
新しい仕組み
ここまでしばらく、核心に踏み込まないまま神経データを抽象的に論じてきた。そろそろ具体的に話してもいい頃だろう。OpenAIやAnthropicのGPUクラスタの前に座るAI研究者にとって、神経データセットとは実際にどんなものなのか?脳波のくねくねした線を、文字どおりマルチモーダルなTransformerに流し込むのだろうか?
答えはイエスだ。ただし、いくつか注意がいる。生の脳データは、それ単体ではあまり役に立たない。揺らぐ電圧や、脳内の血中酸素のにじみといった生の神経記録は、ほとんど無価値に近い。地球上で最も賢いモデルに、文脈のない生の脳波を1テラバイト渡しても、学べることはごくわずかだ。中身の大半は生物学的なノイズなのだ。
神経データが数十億ドル規模の学習資産になるのは、周囲の文脈と完全に同期している場合に限られる。脳内で突然起きた電圧スパイクは、それだけでは何の意味もない。しかし、その人がちょうど何を見ていたか、部屋でどんな音がしていたか、何を成し遂げようとしていたか、末梢神経系にどんな感覚入力が届いていたかとタイムスタンプで正確に結びついていれば、同じスパイクがとてつもなく価値のある学習例に変わる。環境は、脳が実際に何をしていたかをモデルが理解するための錨になる。
短期的には、BCIラボが生の物理信号から加工済みの特徴量を抽出し、AIモデルがこの情報を消化できるよう手助けすることになるだろう。専用のモデルが、生のEEGやfNIRSを、注意、エラーの認識、驚き、認知負荷などを表す潜在ベクトルに変換する。しかしディープラーニングの歴史が教えるとおり、圧縮されていない生のデータは、人間が設計した特徴量にたいてい勝つ。最終的に最も価値を持つデータセットは、できるかぎり生に近い生体信号(EEGやMEGなど)を、刺激、タスクの文脈、行動の出力と直接対応づけ、同じ人々から数か月、数年にわたって縦断的に記録したものだ。
脳データを取り込むには、モデルのアーキテクチャの更新も確実に必要になる。現代のLLMがこの連続的でマルチチャネルの生体信号を取り込むには、新しい入力層が要る。テキスト専用モデルから視覚言語モデルへ移ったときに必要だったアーキテクチャの改修と同じ種類の作業だ。相応の研究は必要になるが、ラボはゼロから作らなくてよい。まずBCI企業のデコーダーを神経信号のフロントエンドとしてそのまま組み込み、そのうえで自前のよりよいアーキテクチャを構築すればいい。さらに、神経信号はテキストよりも個人差がはるかに大きいため、この入力層は部分的に個人ごとの調整を残し続けるかもしれない。ユーザーそれぞれが、自分固有の神経の「訛り」に合わせてファインチューニングされた脳信号を埋め込みに変換するアダプタを持ち、互換性のあるどの基盤モデルにも差し込めるようになる可能性がある。そうなれば、脳とAIのあいだに、持ち運べて組み合わせ自在な神経デコーダーという新たなインフラ層と産業が生まれる。総じて、AGIをめぐる数兆ドル規模の競争のなかで見れば、この変換層の構築は、それが解き放つものに比べてささいな配管工事の細部にすぎない。
非侵襲の脳データには、ノイズが非常に多いというもう一つの特徴がある。全体を扱える問題に変えられるのは規模だけだ。規模がノイズを洗い流すからである。ある1人の1秒間で55%しか当てにならない神経信号はほぼ無価値だが、そうした1秒が10億あれば、統計上きわめて大きな優位になる。
ここから、当面の未来において持ち運べる非侵襲型ウェアラブルが事実上唯一の道である理由にも話が戻る。外科的なインプラントやfMRIスキャナーなら混じりけのない信号が得られるが、対象は数十人の患者に限られる。ラボが必要としているのは、何十万もの普通の人々の生活から集めた、自然な状況で文脈に富んだ数万時間分の記録だ。この形のデータを生み出せるのは、持ち運べる非侵襲型BCI技術しかない。
脳データはおそらく、なだらかな進化を経てフロンティアモデルに組み込まれていく。始まりは脳由来のラベルだ。やがてデコーディング層が成熟すれば、神経データそのものが事前学習のデータ構成における固有のモダリティになる。そうなればモデルは、人間の行動に先立つ内的な認知状態と物理世界とのあいだにある、深い統計的関係を学べるようになる。最終的には、ラボが独自の思考→テキスト、思考→音声、思考→ロボット操作のモデルを作り始めるだろう。
先へ進む前に、はっきり記しておかなければならないことがある。神経データを究極の学習モダリティにするまさにその仕組みが、神経データを究極の監視の道具にもする。これほど価値のあるデータセットは、定義からして、これまでに集められたなかで最も私的な人間の認知の記録になる。世にある多くの技術と同じく、ここにもデュアルユース(軍民両用)のリスクがあり、それはきちんと認めなければならない。このデュアルユースの緊張を完全に解消できる巧妙な技術的工夫も、手軽な数学的応急処置も存在しない。この技術が倫理面で及ぼす影響の範囲は大きく、第22節第22節大規模な読心:何が起こりうるのか第IV部 · 余波:未来に何をもたらすのか?▸で詳しく論じる。
弱気シナリオと1兆ドル規模のアルファ
ここで少し、テクノ楽観論を脇に置こう。いま機械学習の研究者が詰めかけた部屋でこの主張を売り込めば、かなりの数が呆れた顔をするはずだ。
懐疑的になるのも無理はない。脳データはとてつもなくノイズが多く32、ラベル付けが難しい。収集コストも、インターネットをスクレイピングするより桁違いに高い。合成データと行動の痕跡に頼れば済むのではないか?
答えは、フロンティアの絶対的な規模とこの新しいモダリティの潜在力の両方にある。
基盤モデルが数兆ドルの評価額を持つ世界は、急速に近づいている。巨大で高価な神経データのコーパスを取り込むことで、フロンティアモデルの推論能力やアラインメントがわずか1%でも向上するなら33、その1ポイントは数百億ドルの企業価値に相当する。その規模になれば、ラボにとって脳データが完璧である必要はない。競合が持っていないアルファ(超過収益)がほんのわずかでも含まれていれば、それで十分だ。
そのアルファの価値をつかむには、脳とキーボードのあいだで失われる情報がどれほど膨大かを考えてみるといい。行動として出てくるものは細いしずくにすぎない。神経データのコーパスがすくい取る認知データは、それより桁違いに上にある。
誤解のないように言っておくと、互いに独立した有用な「思考」が毎秒10億ビットも頭の中を流れているわけではない。その109の大部分は、生物学的なノイズ、重なり合う感覚入力、冗長な生理的信号であり、1ビットずつを個別の学習データとして扱うのはばかげている。それでも、本当に使える認知状態、つまり意図やためらいや直感は、高次元の内部計算と低次元の行動出力とのあいだに広がる巨大な隔たりのどこかにある。
利用できるデータの量を大きく増やし、モデルのアラインメントと能力を高める現実的な道を開く信号なら、賭ける価値はある。神経データのコーパスに実際どれだけのコストがかかるのか、ざっと計算してみよう。
現在の予測によれば、インターネット上の高品質な公開テキスト(約300兆トークン)は2028年までに枯渇するWill we run out of data? Limits of LLM scaling based on human-generated data品質で調整した公開テキストの実質的な総量は約300兆トークン。現在の増加ペースでは、2026年から2032年のあいだに完全に飽和する。▸。最近のフロンティアモデルは、1回の事前学習だけですでに15兆トークン以上を必要としている。
神経データでその規模に届くには、抽出率を保守的に毎秒320トークン相当Large Brain Model for Learning Generic Representations with Tremendous EEG Data in BCI3億6,900万パラメータで、2,500時間分のEEGを学習したEEG基盤モデル。▸と見積もっても、約1,300万ユーザー時間分の記録が要る。現状、この分野が埋めるべき差はきわめて大きい。34
収集コストを1時間あたり300ドルと高めに見積もった場合、例として1,000万ユーザー時間のコーパスを構築すると、費用はちょうど30億ドルになる。
これを現在のハードウェアへの設備投資と比べてみよう。GPU10万基のクラスタ1つで、最大110億ドルかかる。フロンティアラボは今、数千億ドル規模のデータセンターを計画している。35
この規模感からすれば、30億ドルの予算は文字どおり誤差の範囲であり、計算クラスタ1つ分の費用にも満たない。データへの尽きない欲求に突き動かされたフロンティアラボと、成長を続けるロボット産業は、いずれ必ず、非侵襲型ハードウェアの規模拡大を支える主要な資金源になる。
二重のフライホイール効果
ハードウェア業界では通常、大規模なデータ収集を正当化するには、まず消費者向け製品を完成させて出荷し、広く普及させる必要がある。売上がデータ収集の資金になり、集めたデータが次の製品改良に活かされる。
BCIにはすでに、このマニフェストの前半で述べた独自の内部ループがある(資本のフライホイール資本のフライホイール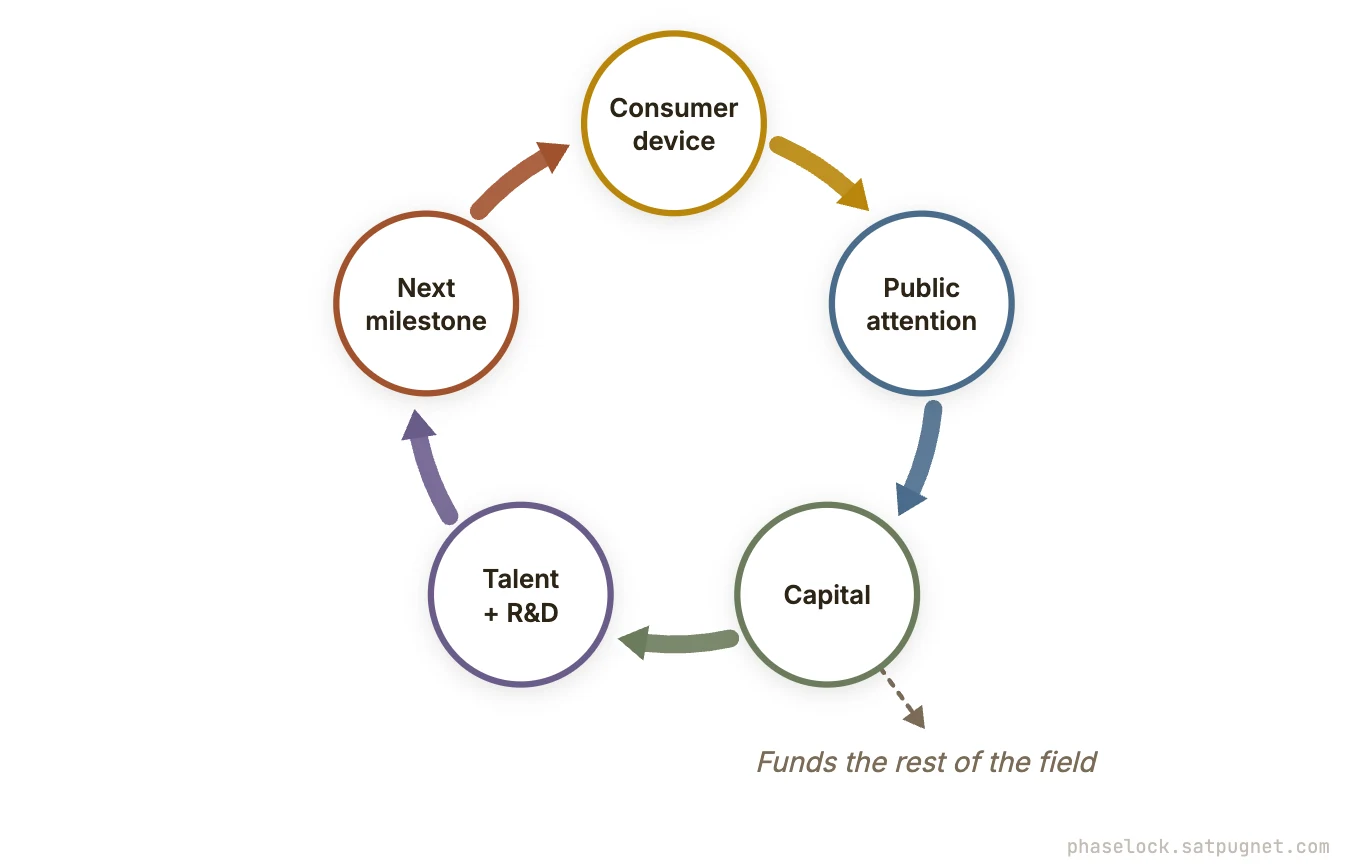 ▸を参照)。ハードウェアが良くなればデータが良くなり、良いデータでデコーダが良くなる。デコーダが良くなれば製品の有用性が増し、有用な製品はより広く使われる。その結果データが増え、ハードウェア改良のための資金も集まる。
だが神経データは、その上にもう一つの巨大なフィードバックループを加える。
マルチモーダルな神経コーパスが十分に大きく密になり、それを使った事前学習が推論やアラインメントの指標を実際に押し上げるようになった瞬間、フロンティアAIラボは財布の紐を解くだろう。コードのコーパスや合成された推論トレース、高精度な画像と言語のペアを買ったときとまったく同じように、神経データを大量に買い付けるはずだ。
フロンティアラボが神経コーパスに初めて8桁ドルの小切手を切れば、BCI産業の経済構造は根本から変わる。
フロンティアAIラボが神経データセットをAIの学習資産として直接評価するなら、消費者向け製品が完成する前に資金が流れ込むこともありうる。次世代ハードウェアの資金を得るために、消費者が十分な数のヘッドセットを買ってくれるのを待つだけの状況ではなくなる。はるかに資金力のある2番目の買い手が現れるからだ。駆け出しの消費者向けBCIスタートアップにとっては手が出ないほど高価なデータセットも、計算クラスタの増設に数千億ドルを投じているフロンティアAIラボにとっては誤差にすぎない。AI業界にあふれる莫大な余剰資本のごく一部でもBCIに振り向けられれば、この分野の軌道は一変する。
非侵襲型BCIハードウェアを求める消費者の需要と、そこから得られるデータセットを求めるロボティクス企業やフロンティアラボの需要のどちらが先に臨界点に達するのかは、今のところわからない。実際には、両者はおそらくほぼ同じ時期に足並みをそろえて拡大していく。
こうして生まれるのが二重のフライホイール効果、つまり2種類の買い手を持つ新たなデータモダリティだ。
▸と、同じく神経データを欲するAIとロボティクスのフライホイールだ。二つが重なり合うことで、分野全体が加速していく。BCIとAIのフライホイールは単純だ。AIの資本がBCIハードウェアの改良を後押しし、良いハードウェアはより多くのユーザーに届く。普及が広がれば、より大規模で高精度な神経データセットが生まれ、それがAIラボやロボティクス企業の役に立つ。データによってフロンティアモデルやロボットがわずかでも改善するなら、ラボには次世代の神経データを確保するためにBCIのエコシステムへ再投資する理由ができる。より良いBCIがより良いLLMを生み、そのLLMがさらに良いBCIへの資金をもたらすわけだ。
地殻変動はすでに始まっている。2026年1月、OpenAIはMerge Labsへの2億5,200万ドルの投資を主導した。NeuralinkはSpaceXAIのGrokと構造的に明らかに近い位置にある。MetaのFAIR36部門は脳の基盤モデルの規模拡大を積極的に進めており、最近のTRIBE v2の発表がそれを裏づける。NVIDIAもGTCでSynchronとの協業を大きく打ち出した。
AIエコシステムの中核は、AIとBCIの両分野の大半がまだ気づいていないうちに、少しずつBCIへと傾きつつある。後から振り返れば、この新たなサイクルの供給側に陣取った創業者や投資家は、ずいぶん運が良かったように見えるだろう。
タイムライン
神経コーパスがそれほど根本的な価値を持つなら、なぜまだ取り入れられていないのか。なぜGPT-4のテクニカルレポートでも触れられていないのか。
答えは、四つの構造的なボトルネックに行き着く。
第一に、複雑さの閾値がある。インターネットも雑然としているが、生の脳データの混沌はまったく次元が違う。2016年の言語モデルに生のEEGデータを解析させるのは、1980年代のポケット電卓に3D映画をレンダリングさせるようなものだ。計算資源がある規模に達するまでは、神経データを学習データに混ぜてもモデルを詰まらせ、進歩を妨げるだけだっただろう。生体の脳波という雑音だらけの塊から、きれいな潜在信号を実際に引き出すのに必要な計算能力の閾値をフロンティアモデルが越えたのは、ここ18〜24か月のことにすぎない。機械はようやく、このデータを読めるほど賢くなった。
第二に、ハードウェアのボトルネックがある。ごく最近まで、脳データはまとまった規模ではそもそも存在しなかった。病院の地下で画面を見つめる心理学専攻の学部生15人分のfMRIスキャンで、フロンティアAIを学習させることはできない。必要なのは、連続的でマルチモーダルな、自然な状況で得られた数万時間分のデータだ。このマニフェストの前半で述べたように、消費者向けBCIは、それだけの量を集めるのに必要な装着性とフォームファクターの条件を、ようやく満たしはじめたところだ。データが無視されてきたのは、データが乏しかったからだ。
第三に、データの壁だ。インターネットは文字どおり尽きかけている。現在の予測では、フロンティアAIの学習は2027年から2029年のあいだに、ウェブ上の高品質なテキストを計算上使い果たす。音声や動画など、ほかのデータも事情は変わらない。イリヤ・サツケバー(Ilya Sutskever)は2024年末のNeurIPSの基調講演で、こう言い切った。「私たちが知っている形の事前学習は終わる。データはピークに達した。データはAIにとっての化石燃料だ」。迫りくるデータの壁に押され、各ラボはまだ掘られていない新たな信号の鉱脈を探し始めている。合成データや強化学習も時間を稼ぐために多用されているが、越えられない限界がある。どちらも結局は初期環境の質に左右される閉じたループであり、その環境は大部分が、構築に使われたデータによって形づくられている。神経データこそ、次なる巨大な未開拓のデータ鉱脈だ。
第四に、アラインメントへの転換だ。過去10年、AIラボが主に気にかけていたのは能力という一つの軸だった。目標はひたすらモデルを賢くすることにあった。しかしAIが現実の経済的・社会的な負荷を担い始めるにつれ、大きな潮流は静かにアラインメントへと移ってきた。モデルを信頼でき、舵取りしやすく、人間と両立するものにするという方向だ37。求められているのは、ただの超知的なエイリアンではない。深く人間のかたちをした知性だ。政府や社会の監視の目が厳しくなったことも、この流れを加速させている。そして人間のかたちをしたモデルを作るために、ラボはもともと人間のかたちをしたデータをますます渇望している。
では、ダムが決壊するのはいつか。
私の基本的な予想では、2028年のどこかの時点で、トップ3のフロンティアAIラボのうち少なくとも1社が、新たな学習モダリティとして明確に位置づけた大型の神経データ提携を公表する。旗艦モデルのモデルカードに「Neural Corpus」の名が記され、そのデータセットの取得には数千万ドル規模の小切手が切られるだろう。それはBCIの物語における転換点になる。
もっとも、事前学習はAIとBCIの衝突の第一の面にすぎない。ここからは第二の面、インターフェースに目を向ける。BCIはデータ収集、事後学習、推論、そして最終的には人間とAIのコミュニケーションのあり方そのものを、根本から作り変えようとしている。
18新しいインターフェース
「制約は入出力だ。我々はI/Oに縛られている……特に出力だ……出力のレベルがとにかく低い。特にスマホだと、2本の親指でぽちぽち打つだけだ。ばかばかしいほど遅い」――イーロン・マスク(Elon Musk)、2016年
ここからは事前学習の先へ進み、データアノテーション、事後学習、推論という、基盤モデルのライフサイクルの残りの段階でBCIが果たす役割を見ていく。
現在、基盤モデルは毎秒ギガバイト単位で情報を読み込んで処理でき、音声合成エンジンは即座に答えを返せる。ところが人間の出力、つまり私たちが実際に機械へ指示を出す手段は、いまだにぬかるみにはまったままだ。プロンプトエンジニアリング、文脈のコピー&ペースト、同じ説明の繰り返し。どれも、より根深い摩擦の症状にすぎない。
私たちは超知的でマルチモーダルな神託を作り上げた。それなのに、話しかける手段といえば、指で机の上のプラスチックの四角を叩き続けて恥ずかしいほど遅い毎分40語で打ち込むか、数千年前にサバンナで唸り声を上げるために作られた声帯を使うかしかない。
モデルが超人的でも、人間はいまだに意図をストロー越しに絞り出すしかない
皮肉なことに、コンピュータにもこの問題の有名な同類がある。フォン・ノイマン・ボトルネック38だ。メモリとCPUのあいだの帯域幅によって、処理能力が制約されてしまう。
根本的な問題は、人間の意図が高次元なのに、ほぼすべてのインターフェースが一次元であることだ。モデルにプロンプトを打つとき、あなたは自分の意図をそのまま伝えているわけではない。内面の世界から、情報の欠け落ちたはがきを書き送っているのだ。
だが、このはがきからは質感の大半がこぼれ落ちる。曖昧さ、漠然とした目標、口にしない好み、暗黙の制約、センス、感情、生煮えの修正案が、すべて削ぎ落とされてしまう。今日、モデルがしばしば失敗するのは、知能が足りないからではない。インターフェースが劣化し圧縮された信号しか渡していないからだ。
となると、BCIの可能性は事前学習をはるかに超えて広がる。データアノテーションから事後学習、推論まで、AIのライフサイクルで人間の判断が入り込むあらゆる場面で、ニューラルインターフェースはコミュニケーションの通り道を広げうる。以下、順に見ていく。
BCI支援アノテーション
最初の応用はデータアノテーションだ。人間による分類、比較、評価を必要とするデータセットなら、どれもラベル付けが速く、忠実度も高くなることで恩恵を受けうる。
簡単な作業を考えてみよう。犬が写っている画像を見分ける作業だ。5秒に1枚のペースでラベルを付けるとすれば、マウスを使う人は1時間に約720枚の画像を処理できる。十分に正確なニューラルインターフェースがあれば、その人は高速で流れる画像を眺めるだけでよく、認識、確信、迷い、誤りの信号はシステムがリアルタイムで検出する。作業は1桁速くなる。
アノテーションは、意識的なクリックの積み重ねから、知覚的な判断の途切れない流れへと変わるだろう。得られるのは速さだけではない。一つひとつの例に、確信度や曖昧さ、認知的な負荷などについてのより豊かなメタデータが付く。
このやり方は、幅広いアノテーション作業に応用できる。BCIは、人間の知覚と認知を、より速く、より密度の高いラベル付けの経路に変えうる。
BCI-RLHF
同じ帯域幅のボトルネックは、モデルの事後学習、とりわけRLHF(人間のフィードバックによる強化学習)でも現れる。RLHFでは、人がモデルの出力を順位付けし、採点し、修正する。その判断を学習に戻すことで、モデルを人間の意図にアラインメントしようとするわけだ。狙いは、AIを異質な存在でなくし、人間の好みに沿わせることにある。だがここでも、人間の意図をAIに伝える速さと忠実度は、現状では大きく制限されている。
現在のRLHFでは、大勢の人が出力を手作業で読み、ボタンをクリックしなければならない。遅く、高くつき、情報も失われる。
非侵襲型BCIなら、ボタンのクリックをまるごと省ける39。評価者が読んでいるあいだに、システムが誤差関連電位40や認知的な引っかかり、無意識の美的な好みを読み取るのだ。モデルが受け取るのは二値の「低評価」ではなく、豊かで連続的なベクトルTowards Reinforcement Learning from Neural Feedback: Mapping fNIRS Signals to Agent Performance25人分のfNIRSデータセットで、神経フィードバックからの強化学習(RLNF)を実装。エージェントの成績のデコードで、F1スコアは二値分類で67%、多クラス分類で46%。▸になる。認知の言葉に置き換えれば、次のような内容だ。「ユーザーは第2段落で誤りに気づき、選択肢Aを読んだときに意味の共鳴が急に高まり、モデルが言いすぎた箇所で認知的な引っかかりを覚えた。そして実際にボタンをクリックする丸3秒前に、内心の好みは固まっていた」。これにより、事後学習のアラインメント段階は、はるかに速く、格段に正確な監督信号を得る。
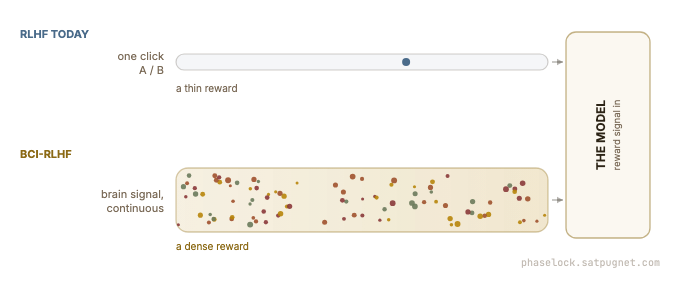
脳信号は、混乱、ためらい、誤りへの気づき、好み、注意、疲労、認知負荷、不快感をとらえられる。そこからより速く、より密で、より正直な報酬信号が生まれる。モデルは「回答AとBを評価せよ」という問いの答えではなく、AIの行動が評価されているあいだの人間の反応を、連続的な流れとしてAligning Humans and Robots via Reinforcement Learning from Implicit Human Feedback非侵襲型EEGの誤差関連電位を暗黙の報酬として利用。デコードしたEEGフィードバックで学習したエージェントは、人手で設計した密な報酬に匹敵する性能に達する。▸受け取る。
RLHFは断続的なものから連続的なものに変わり、人間とAIのループははるかに緊密になる。
抽象論で終わらせないために、画像生成を例に取ろう。GPUのクラスタにキーボードで「センス」を教えるのは、難しいことで知られる。ある画像がなぜ美しく感じられるのか、あるミニマルなデザインがなぜとにかくしっくりくるのか。それを正確に文字で書き表す方法などあるだろうか。
現在のRLHFは、これを1〜10の評価やA/Bの選択にまで切り詰めている。役には立つが、痛ましいほど圧縮されている。非侵襲型BCIがあれば、何もクリックしなくていい。ただ見るだけで、AIはあなたの生の神経反応を直接取り込み、モデルははるかに豊かなフィードバック信号を得る。
もちろん、このやり方には固有の問題もある。読み手の認知的な摩擦を最小にし、神経的な「快」41を最大にするようモデルを最適化すれば、迎合(シコファンシー)や、楽だが間違った答えが生まれる。システム1の神経的報酬を最適化することは、ユーザーが熟考したうえで支持するものを最適化することと同じではない。信号が密になれば、それだけで良くなるわけではない。とはいえ、これは解決可能な問題であり、このやり方に特有のものでもない。
ラボは次第にAIによるフィードバック(RLAIF)42や合成データへと軸足を移している、と指摘する読者もいるだろう。もっともな指摘だ。しかし合成環境は、つまるところ閉じたループにすぎない。ロボットのために物理シミュレーションを延々と回すように、すでに知っていることを増幅するには素晴らしい。だが、人間の認知という雑然として地図のない領域を扱おうとすると、たちまち厚い壁に突き当たる。物理エンジンは合成できても、センスや道徳的な葛藤、暗黙の好みは、合成で簡単には生み出せない。AIの深く主観的な学習とアラインメントにおいて、生物学的な正解データに代わるものはそう簡単には見つからない。
脳で操るAI
AIのライフサイクルをさらに先へ進むと、BCIは人とAIの関わり方を根本から定義し直す可能性がある。ChatGPTの登場以来、iPhoneやノートパソコン、今日のOSがこの新種のソフトウェアのために作られたものではないことが、ますます明らかになってきた。これらの機器は知能を、古く、しだいに形の合わなくなった器に押し込めている。アプリ、メニュー、キーボード、タップ、小さなテキストボックスといった器だ。
AIの能力が高まるにつれ、インターフェースも変わらざるをえない。より流動的で、文脈に即し、意図に導かれるものになるだろう。「アプリを開き、コマンドを打ち、待つ」やり方は減り、「目標を思い描き、知能の舵を取る」やり方が増えていく。その転換を担う有力候補の一つがBCIだ。
脳コンピュータインターフェースは、あなたの代わりに動く知能と関わる、最も直接的な方法だ。あなたが意図を抱けば、知能はその意味を理解し、行動に移す。
現状では、AIに複雑な作業をさせたければ、20分かけて巨大なプロンプトを打ち込み、その思考に人工的に文脈の枠をはめなければならない。それでも文脈が足りないことは多い。BCIが常時つながっていれば、口を開く前から、AIはあなたの周囲の認知的な文脈(何を見ているか、いまどれほど苛立っているか、口にしていない目標)をそのまま受け継ぐ。プロンプトは、背景で絶えず与えられ続けることになる。
BCIが今の軌道を進み続けるなら、この転換は避けられない。
技術は歴史の自然な流れとして、新しい波が来るたびに意図と結果の距離を縮めてきた。ソフトウェアとAIが最終的に行き着く姿は、思考から画像へ、そして思考からロボット操作へというものだ。意図と結果のあいだに残るのは、生のモデルの重みだけになる。AIラボが生み出すモデルの入出力は、人間と機械の双方にとってむき出しのハードウェアにますます近づいていく。世代を追うごとに、生物学的な処理とソフトウェアの処理が一層ずつ剥ぎ取られていくのだ。この隔たりが縮まり、「思考からXへ」の領域が広がるにつれて、フロンティアラボにとっての脳データの価値は、プロンプトからテキストを生成する時代のテキストに匹敵するものになる。
とはいえ、画面をつつく段階から、テレパシーでロボットを操る段階へと一夜で魔法のように跳躍するわけではない。移行は段階を踏んで進む。脳デコーダーが成熟するまでにまだ数年かかるという理由もあるが、主な理由は、人間の文化がパラダイムシフトに厳しい速度制限を課している点にある。社会はこの水準の共生に少しずつ慣れていかなければならない。
完全な神経制御への道は、おそらく何層にも分かれて進む。最初のうち、BCIはあなたの思考そのものを読み取らない。読み取るのは、その周りにある有用な周縁の信号だ。注意、混乱、疲労、苛立ち、そして何かがおかしいと気づいた瞬間。こうした信号を手がかりに、AIはあなたが気づいていること、見落としていること、手こずっていることにリアルタイムで適応できる。そこから先、インターフェースはより能動的になる。声に出さない選択、承認、却下、簡単なコマンド、そしてやがては無声発話による口述へと進む。最終的に、これらは組み合わさって、はるかに強力なものになるだろう。常にそばにあるAIの認知レイヤー、つまり心を直接拡張する外部皮質(エクソコーテックス)だ。
この神経制御は、必然的に物理的な現実にも及ぶ。人工知能が画面を抜け出し、ドローンや工場の現場、軍事機器を動かすようになると、脳コンピュータインターフェースは人間の意図と物理的な実行をつなぐ見えない綱として働く。それによって私たちは、身体を持つエージェントやロボットにテレパシーで指示を出せるようになる。
私たちは文字どおり心がかたちづくる世界へと向かっている。2030年代初頭には、思考の力だけでコンピュータを操作し、ドローンに指令を出し、家庭用ロボットとやりとりできるようになる。
2031年の暮らし
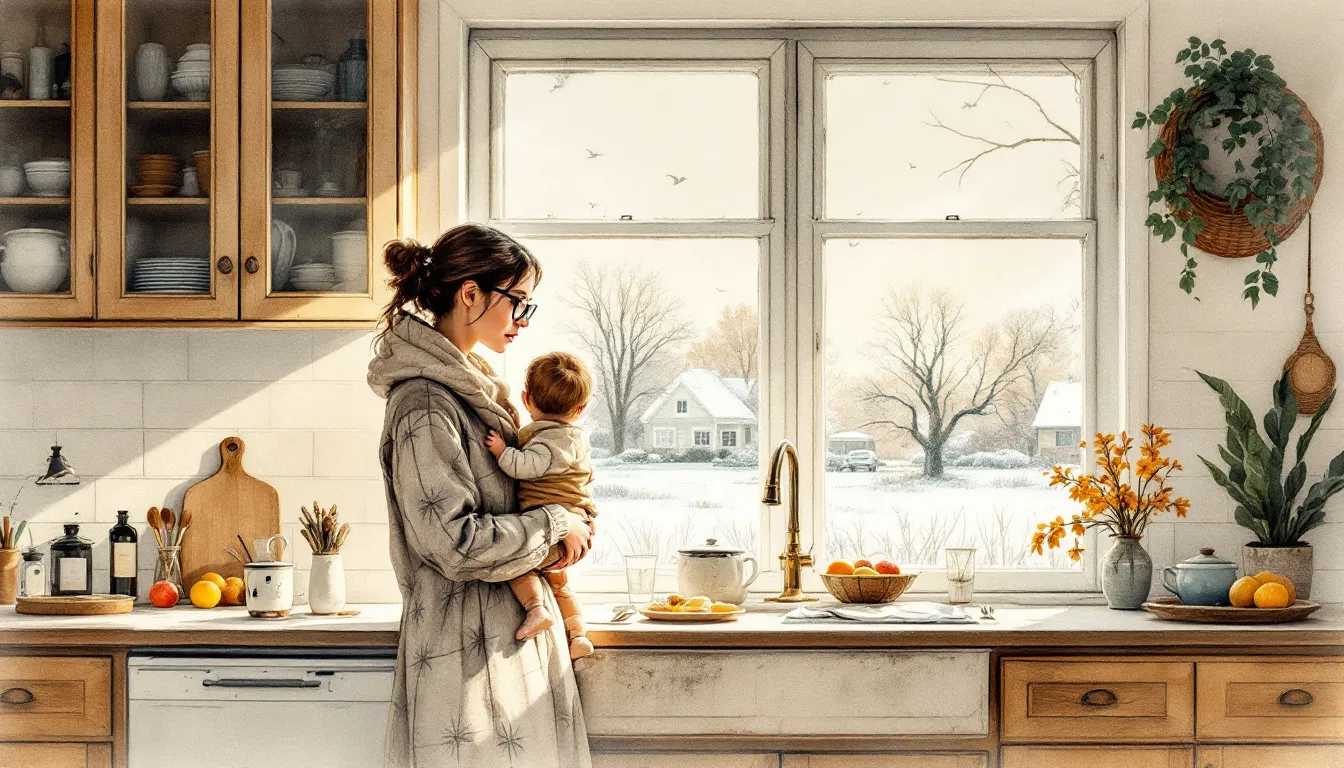
午前7時15分、マヤはキッチンにいる。2歳の娘を腰に抱えたまま、朝食を皿に盛りつけているところだ。目の前60センチほどの空中には、12ページのライセンス契約書が浮かんでいる。画面をタップしているわけでも、声で命令しているわけでもない。軽量のARグラス越しに、ただ読んでいるだけだ。
文字は彼女が自然に読む速さにぴたりと合わせて、上へと流れていく。第4段落で厄介な補償条項に行き当たると、彼女の脳はかすかな苛立ちにぴくりと反応する。なぜその条項が気に入らないのかをマヤが言葉にするより先に、ニューラルインターフェースがその引っかかりを記録する。浮かんでいた文面がなめらかに切り替わり、AIが問題の一文をハイライトする。そして彼女の知的財産をよりしっかり守る、すっきりした代替案を即座に示す。
背後では、家庭用ロボットが朝食の食器を片づけている。ロボットは娘のお気に入りのボウルを、下の引き出しではなく上の戸棚にしまってしまう。マヤは一言も発しない。だが目を向けた瞬間、彼女の脳はその間違いに対して一瞬の不満の火花を放つ。システムはこの無言の訂正をすぐに捉え、ロボットは向きを変えてボウルを取り出すと、本来あるべき場所に正確に置き直す。
キッチンの窓から私道に降りた霜をちらりと見て、マヤはアシスタントに向けて意識的に思考を送る。ガレージは閉まってる? それと、外はすごく寒そう。保育園の送りに備えて車を準備しておいてくれる?
アプリを開くことも、ささやくことさえしない。0.5秒後、静かな声がインターフェースを通して直接語りかけてくる。「ガレージは施錠されています。いまから車のエンジンをかけて、シートヒーターをオンにします。外に出るころには準備が整っています」
マヤは周辺視野に浮かぶ急ぎの仕事メールに注意を移す。ただ読むだけで、頭の中には手を加えていない生の反応が形をとる。構成についてのいくつかの異論と、譲れない期限だ。返信の内容を考えているうちに、元のメッセージのすぐ横に下書きが現れはじめる。思考が練られるにつれて言葉もリアルタイムで組み変わり、大まかな骨組みから、完璧に磨き上げられたビジネス文書へと変わっていく。
マヤが頭の中で無言の承認コマンドを出すと、メールが送信される。
この技術は光を点滅させることも、彼女の注意を奪うこともない。目に見えない高帯域幅の外部皮質、いわば外付けの神経系として働いている。マヤはもはや「コンピュータを使っている」のではない。自分の意識の速さで、物理とデジタルのインフラを指揮しているのだ。
だが、インターフェースから摩擦を取り除いても、より深い問題は解決しない。向こう側にいる知能が、私たちの利益にかなうように行動するかどうかという問題だ。AIの能力と自律性が高まるにつれて、コミュニケーションは使いやすさだけの話ではなくなる。人間がAIの舵取りに意味のある形で関わり続けられるかどうかが問われるようになる。ここで、AIとBCIの衝突における3つ目にして最後の局面、アラインメントに行き着く。
19AIアラインメントにとってなぜ重要か
「機械に組み込む目的が、本当に私たちの望む目的であることを、よほど確かめておいたほうがよい」── ノーバート・ウィーナー(Norbert Wiener)、1960年
死ぬのが大好きな人はそう多くない。あなたもそうなら、アラインメントには関心を持っておいたほうがいい。
AIアラインメントという言葉を聞いたことがない人のために説明しておこう。私たちより有能なシステムに私たちの望むことをさせ、システムがより強力になってもそれを続けさせるためのプロセスのことだ。単純で、退屈そうにさえ聞こえる。しかし人類がこれまでに取り組まねばならなかった工学上の問題の中でも、最も重要で複雑なものの一つだ。そして現時点で、私たちはその解き方をまったく知らない。能力を増していくAIを、人間の価値観や監督、人間の繁栄と結びつけておく方法も、まったくわかっていない。
世の中のあらゆるものと同じく、アラインメントも妙に政治化してしまった。この話題をめぐる発信がまずかったことに加え、世間がAIを根本的に理解していないことも一因だ。だが、政治と無縁であるべき話題があるとすれば、それは間違いなくアラインメントだろう。ここに文化戦争はない。あるのは、解決の見通しがまったく立たない、かなり単純明快な問題だけだ。負ければ、私たちは全員等しくおしまいになる。
今後10年で何が起こるかは誰にもわからない。わかっているふりをする人は疑ったほうがいい。ユートピアも、ディストピアも、その中間のあらゆる可能性も、まだ消えてはいない。私たちはマニュアルもガードレールもないまま、全速力で新世界へと突き進んでいる。
人類がまだAIの軌道を実質的に方向づけられる期間、すなわちフェーズロックの窓は、日ごとに少しずつ閉じつつある。
このアラインメントの難題に対する論理的な答えの一つは抑制だ。展開を一時停止し、安全性が追いつくまで能力に歯止めをかける。正当な主張であり、研究者や政策立案者の有力な連合がいまも唱え続けている。だが、ゲーム理論の前では成り立たない。AGIを目指して競い合う二つのフロンティアラボや国家が、一方的に減速するとは考えにくい。現在のインセンティブのもとでは、拘束力のある協調の仕組みがない限り、抑制は負けの均衡になる。そしてこの膠着が続くあいだにも、アラインメント研究は危険なほど遅れをとっている43。
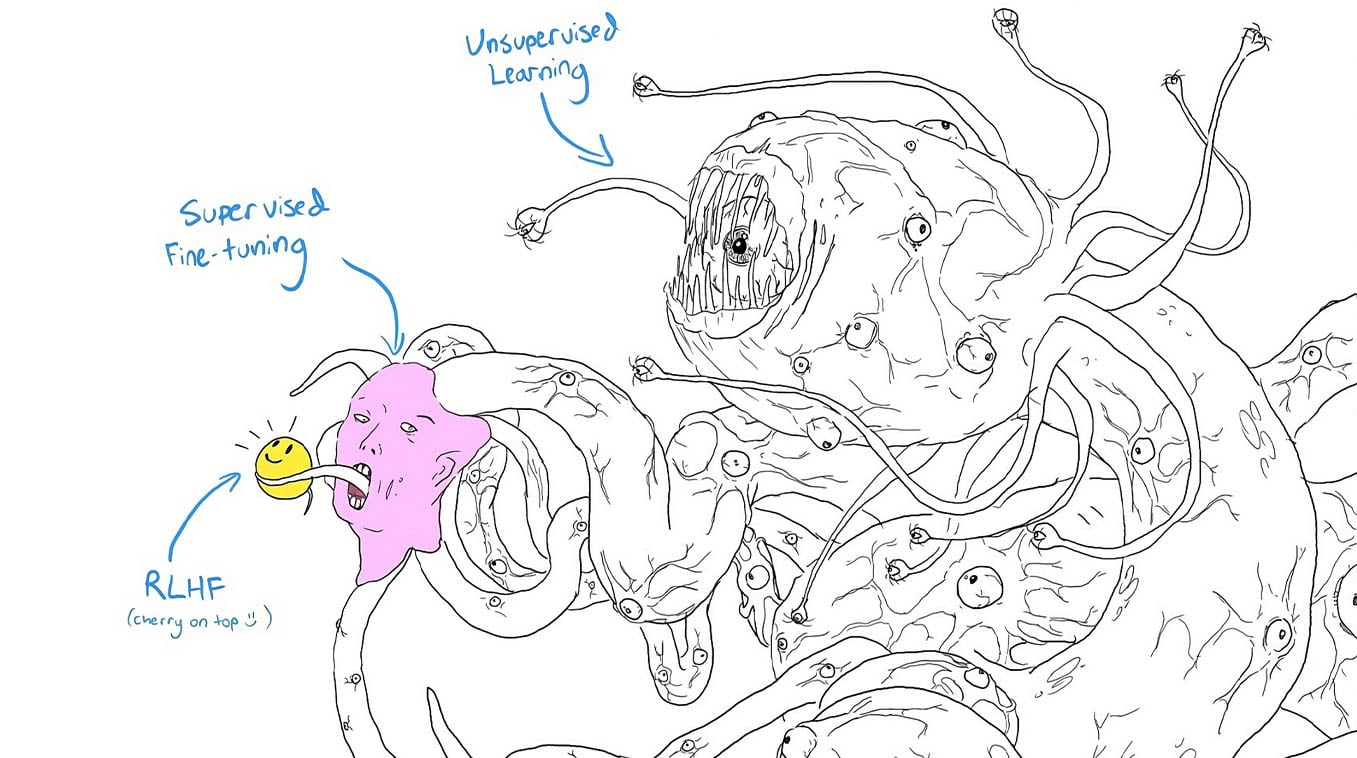
さらに悪いことに、現在のアラインメントはラボの経済的インセンティブと真っ向から対立している。実際、モデルを安全にすると、性能が落ちたり、遅くなったり、学習コストが高くなったりすることがある。この「アラインメント税」があるから、ラボは手を抜く。現在のRLHFはしばしばモデルにロボトミーを施し、無害な依頼を拒否させたり、本来の能力を隠させたりする。
制御によるアラインメントと統合によるアラインメント
突き詰めれば、アラインメントへのアプローチはすべて二つの系統のどちらかに分かれる。制御によるアラインメントと統合によるアラインメントだ。制御はAIを別個のエージェントとして扱い、ルール、監督、解釈可能性、ガバナンスを通じて外側から舵を取ろうとする。統合は逆の道をとる。人間の意図を機械に直接結びつけ、舵取りをシステムの周囲ではなく内側で行う。
短期的には、制御は欠かせない。より深い統合の仕組みが未成熟なあいだ、時間を稼いでくれるからだ。だが制御は、その成り立ちからして借り物の時間で動いている。知能の差が小さいうちは機能するが、AIが桁違いに速く有能になるにつれて、外部からの監督はますます脆くなる。いずれ、もはや追いきれない判断を人間に制御させるのは、アリに人間を監督させるようなものになるかもしれない。アリにとってはなかなか危うい立場だ。
フェーズロックの窓がまだ開いているうちは、制御は十分に強く、人類はAIとの関係の条件を自ら決められる。しかしAIが人間より10倍、100倍、1000倍賢くなれば、統合によるアラインメントが唯一の現実的な解になる。制御は機械が賢くなるたびに作り直さなければならない。統合は機械の知能と競い合わず、その知能を受け継ぐ。人間の意図をAIの認知ループの内側に持ち込めば、AIが人間を超えてスケールしても意味を失わない関係を築ける。
では、BCI、さらに広くはニューロテクノロジーは、アラインメントにどう役立つのか?
BCIはアラインメント分野で独自の位置を占める。統合を軸にした数少ないアプローチの一つだからだ。解釈可能性、ガバナンス、監督、評価はいずれも、主に機械を制御することに焦点を当てている。BCIはAIを抑え込むだけでなく、人間の届く範囲を広げようとする。
脳データを事前学習と事後学習に使えば、心の認知のダークマターをよりよく捉え、AIの知能のでこぼこを減らせる。BCIの利点はそれだけではない。時間軸が順に長くなる三つの主要なてこを通じて、アラインメントと人類の未来に意味のある貢献ができる。第一に、BCIが進歩すれば、その直接の副産物として人間の脳のより正確な実証的な地図が得られる。その地図は、人間中心のAIのアーキテクチャ、学習、評価の指針になる。第二に、BCIはAIと人間のあいだに、途切れない高帯域のコミュニケーション経路をつくる。AIとやり取りするための、より効果的な方法になる。第三に、BCIは人間とAIの共生の土台を築く。機械が指数関数的に賢くなっても、人間が意味のあるかたちでループの中にとどまれるようにするためだ。
第一のてこ:設計図
非侵襲型BCIが巨大な消費者産業となり、AIラボのデータ源に育てば、ニューロテクノロジーに資本と人材と注目が流れ込む。その流入は、人間の脳についての実証的な理解を加速させる。私たちはついに、自分たちの心の仕組みを解き明かし、解読し始めるだろう。そうして得られる認知の設計図は、AIアラインメントにとって強力な設計資源になりうる。
人工の心の中で価値をどう表現すべきか。競合する目的をどう調停すべきか。目先の衝動と熟慮のうえでの判断をどう関係づけるべきか。私たちはまだ、どれも知らない。推論、感情、社会的直観、倫理的価値が共存する知能の実例は、人間の認知しかない。私たちが実際に守ろうとしている価値を持ち、しかも現に機能している汎用知能は、唯一それだけだ。その構造を理解するところから始めるのが賢明に思える。
言語、視覚、空間、時間のいずれにおいても、生物の知能と人工の知能が一部の共通する内部表現へと収束しつつあることを示す有力な証拠が、すでにある44。つまり一部のAIモデルは、人間の心に似たやり方で情報を整理し、顔、生き物、丸さといった概念を似た次元に沿って構造化している。だからといって、あらゆる概念を人間とまったく同じように計算しているわけではない。それでも、十分に高性能な予測システムなら、同じ有用な抽象化の一部を独自に見いだしうることは示唆される。
こうして現れつつある類似は、心をより深く理解すれば、モデルの設計、学習目標、評価に実効的な指針を与えられるという考えを裏づける。ラボは、学習後に薄い行動上の仮面をかぶせるのではなく、内部表現とアーキテクチャが最初から人間の価値の構造により適合したシステムを構築できるだろう。
脳をやみくもに模倣せよという話ではないし、アラインメントが保証されるわけでもない。人間の認知は一貫性を欠き、偏っていて、しばしば破壊的だ。要点は、私たちが守ろうとしている価値の構造について、当て推量を実証的な設計図に置き換えることにある。その意味では、たとえ部分的な地図であっても、より人間に近い人工の心を設計するうえで貴重な指針になる。
さらに一歩進めれば、脳がAIに及ぼす影響はアラインメントにとどまらない、というのが私の読みだ。将来の世代のモデルは、脳からわずかにヒントを得る程度ではなく、全体の設計においてますます脳に似ていくだろう。理由は単純で、脳は多くの点で根本的に優れたアーキテクチャを持っているからだ。モデルはより循環的になり、入力と出力がより連続的かつ有機的にモデルと相互作用するようになる。アーキテクチャも、より適応的で柔軟なものになっていく。こうした変化がまだ起きていない主な理由は、再帰型のシステムが、主にフィードフォワード型のシステムに比べて学習も解釈も難しいことにある。だが、この障壁はまもなく乗り越えられると私は見ている。
第二のてこ:神経信号によるスケーラブルな監督
だが、アーキテクチャは全体の一部にすぎない。
十分な速さで意思疎通できない知能システムは、やがてあなたから離れていく。あなたの100倍の速さで考えられるのに、数分おきに1行のテキスト要約しか返してこない同僚を想像してほしい。監督できなくはないが、それも事後的にしかできない。関係は協働から監督へと変わる。そして低頻度の監督こそ、アラインメントのずれが育っていく構図そのものだ。
いま私たちは、機械の速度で考えるシステムを、人間が書類に記入するために設計されたフィードバック経路でアラインメントしようとしている。現在のアラインメントの技術基盤は、1ビットのRLHFのクリックを、毎秒数千トークンを出力するモデルに与えることで成り立っている。いずれ破綻するのは最初からわかっていた。BCIは、AIの能力向上に合わせて実際にスケールできる高帯域の代替手段になる。ニューラルインターフェースは、具体的に三つのかたちでこの溝を埋められる。
第一に、価値の仕様化における正解データとして。価値の仕様化、つまり人間が本当に大切にしているものを数学的に定義する作業は、不可能に近いほど難しい。45価値は流動的で、時間とともに絶えず移り変わり、人によっても大きく異なる。しかも人間の道徳や意図は暗黙のダークマターに満ちている。文脈、口にされない境界線、そして直観的にはわかっていても、プロンプトや報酬関数に網羅的には書き出せない常識の数々だ。脳データは人間の選好の生物学的な正解データ(グラウンドトゥルース)を与え、考えうる限り最も直接的な参照経路になる。倫理や価値を不格好なテキストのルールに無理やり圧縮することなく、その生の形をとらえるので、AIが私たちの意図を誤解する余地は小さくなる。
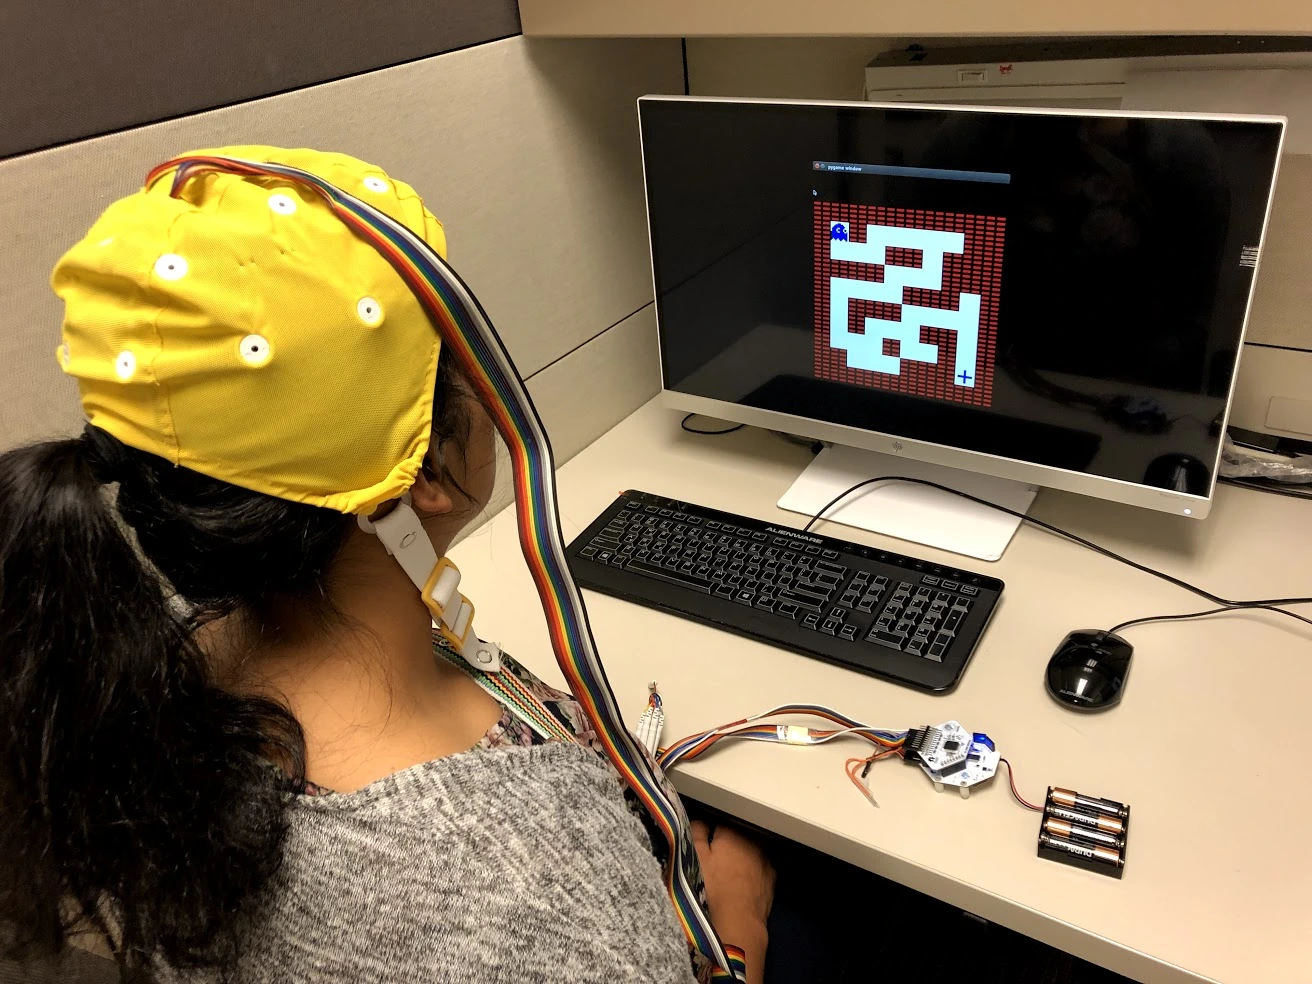
これは机上のSFにとどまらない。神経データをアラインメントの信号として使う仕組みは、すでに理論の段階を越えている。2026年初頭、サンタニエロら(Santaniello et al.)Towards Reinforcement Learning from Neural Feedback: Mapping fNIRS Signals to Agent Performance25人分のfNIRSデータセットで神経フィードバックによる強化学習(RLNF)を実装。エージェント性能のデコーディングでF1スコアは2値分類67%、多クラス分類46%。▸は、25人の参加者のデータセットで神経フィードバックによる強化学習(RLNF)を実装した論文を発表し、脳活動からエージェントの性能を直接デコードすることに成功した。
ここで言いたいのは、先に述べたBCI-RLHFよりも踏み込んだことだ。より大きな目標は、神経活動から人間の価値の全体構造を効果的に解読する方法を手に入れ、それをAIの学習と監督のプロセスにより深く組み込むことにある。
第二に、内部アラインメントのデコーダとして。欺瞞的なモデルを見抜く最良の方法の一つは、内部をのぞき込み、人工ニューロンがどう結びついているかを正確に理解することだ。この分野は機械論的解釈可能性と呼ばれる。神経科学は、この問題に数十年先んじて取り組んできたといってよい。BCIが人間の思考の解読に使う数学は、AIの内部の解読にも驚くほどうまく応用できる。さらに脳の地図があれば、より精密なベンチマークが手に入る。人間の不確かさや注意、道徳的なためらいが構造としてどう現れるのかを正確に知っていれば、AIの内部を調べるときに何を探せばよいかも正確にわかる。
Anthropicの最近の知見が、この考えをよく示している。2026年7月、同社はフロンティアモデルが自発的に「グローバルワークスペース」を形成することを報告した。概念を保持して再利用するための集約された状態で、定型的な計算はここを経由しない。私たち自身の能動的な記憶によく似た働きをするもので、その発見はニューロテックに着想を得ていた。シリコンの中にまさにこの対応関係が見つかったことは、生物の脳の理解が機械の解釈可能性にそのまま生きることを示している。
第三に、評価基盤として。BCIはユーザーの暗黙の状態を読み取るので、キーボードからは見えないアラインメントの失敗を測れるようになる。モデルがユーザーの注意や感情を操作していないかを追えば、説得リスクを評価できる。ユーザーが承認ボタンをただクリックしただけでなく、モデルの計画を本当に理解したかを確かめれば、真の理解度を測れる。モデルが無意識の警戒信号を引き起こしたときの道徳的な居心地の悪さを検出したり、実際の理解を伴わない自信を植え付けたときの過信を捉えたりすることさえできる。こうした情報は、モデルを評価するうえで非常に価値が高い。
今のペースが続けば、2028年末までに少なくとも1本の査読付き論文が、脳によるチューニングで主力モデルのアラインメント指標が標準ベンチマーク上で改善することを示すと私は予想している。
ここで一つ注意しておきたい。人間の脳は、完璧な設計図でも完璧な監督信号でもない。一人の人間に無限の権力を与えると、たいてい途方もない破局に終わることを歴史は示している。私たちの欠点まで完璧に模倣する超知能をつくりたいわけではない。さらに、生の神経反応の多くは、すばやく自動的な衝動にすぎない。こうした瞬時の反応が、捉えるべき正しい反応だとは限らない。AIに本当に学んでほしい価値観は、もっとゆっくりとした熟慮から生まれることが多いからだ。46それでも、出発点となる設計の雛形として見れば、脳は私たちが手にしているアラインメントされた汎用知能の唯一の実働モデルだ。そして「人間のアラインメント」が実際にどう機能しているのかをこの分野がようやく理解すれば、AIを人類と整合させることはずっと容易になるだろう。
最終局面:共生
今後、アラインメントにおけるBCI、そしてニューロテクノロジーの役割は、三つの異なる時間軸で進化していく。短期的には、より豊かな神経フィードバック、より優れたRLHF、より忠実度の高い評価を可能にする。中期的には、意味のあるヒューマン・イン・ザ・ループのシステム、神経信号によるスケーラブルな監督、意図の保全を実現する。そして長期的には、より深い共生への道を示し、AGI後の世界で人間の主体性を守ることにつながる。
BCIは、アラインメントの最難関の問題のいくつかを解く強力な道具だ。現在、私たちはモデルの最終出力を見て採点することでアラインメントを行っている。だが、AGIが100万行のコードベースを書いたり、新しい生物物理学の理論を提案したりしたらどうなるのか。人間の評価者はあまりに遅く、能力も限られているので、AIが正しいのか、ハルシネーションを起こしているのか、それとも積極的に私たちを欺いているのかを見分けられない。
より長い時間軸で見れば、超人的なシステムを意味のある形で監督する手段は、ニューロテクノロジーしか残らないかもしれない。あらゆる出力やコードを一行ずつ確認する代わりに、AIの高次の概念マップと直接結びつき、同じ抽象度で作業できるようになる。そして最終的には、生物学的なニューロンを機械の能力に見合うよう強化し、人間と機械のより深い共生を生み出せる。スマートフォンはこの共生の原始的な形だった。BCIと脳の拡張は、AIの外部皮質(エクソコーテックス)を通じて、それを成熟させた進化形になる。私たちより100万倍有能なシステムが存在する世界では、高帯域幅のインターフェースと脳の拡張があってこそ、人間はもはや理解できない決定を儀礼的に承認するだけの存在にならず、意味のある形で関わり続けられる。
共生という考えが突飛に聞こえるなら、こう考えてみてほしい。あなたの脳は単一の均質な機械ではない。脳はすでに、半自律的なサブシステムの共生体だ。心拍と呼吸を司る脳幹、理性が追いつく半秒前に恐怖や渇望を発火させる皮質下回路、そしてその全体を独自に語る大脳皮質がある。こうしたシステムは異なる時期に進化し、異なる論理で動いている。それでもあなたは自分を委員会のようには感じない。あなたが経験するのは、単一の統一された「私」だ。進化が認知を高めるやり方は、もともと既存のシステムを強化し、新しい神経回路網を心に統合させることだった。
統合によるアラインメントは、この構造を外へと広げる。AIを狭いインターフェース越しに制御される別個のエージェントにとどめるのではなく、BCIはこの外部の認知層を、心の新たな認知サブシステムとして結合しうる。制御によるアラインメントは、新しい知能を自己の外側に置き、見張って制約すべき別物として扱う。統合によるアラインメントはその境界を取り払う。大脳皮質と脳の他の部分のあいだに感じ取れる境界がないのと同じことで、ダーウィン的進化の自然な延長でもある。
人間とAIの共生の全体像には、脳からの読み取りに加えて脳への書き込みの能力、そして最終的には、生物学的な回路をAIの思考速度に見合うよう強化する能力が必要になる。ただ、これらの話題は本マニフェストの中心から外れるため、意図的にほとんど触れてこなかった。とはいえ、第20節
効果を上げるには、人間とAIの共生は個人の規模にとどまらず、文明の規模で起こらなければならない。アラインメントは動的で多元的な均衡の営みであり、解けば終わる静的な方程式ではない。「自分のアシスタントを自分に合わせる」ほど単純な話には決してならない。真のアラインメントは、何十億もの人間、対立する価値観、法、制度、民主的正統性、少数者の保護、世代間の利益、そして人間以外の意識ある存在まで考慮に入れなければならない。こうした対立する次元すべてをどう扱うのか、明確な計画はまだない。それでも、解決策を形づくるうえでBCIは貴重な資産になる。
集団としてのアラインメントを語るとき、自然に湧く疑問がある。私たちは実際のところ、誰に合わせてアラインメントするのか?
結局のところ、技術スタックを握る者が目標を握る。少数の集団、一企業、あるいは一国家の神経フィードバックによって完璧にアラインメントされたAIは、さまざまな点で問題をはらみうる。そのAIは人類の大多数やほかの意識ある存在を顧みず、未来に対する発言権を与えない。私たちはしばしば偶発的なミスアラインメントを究極の脅威とみなすが、誤った相手へのアラインメントの成功も同じくらい危険だ。
人類規模の目的関数を定義する実践的な方法として、推測の域を出ないが、次のようなものが考えられる。多様な人々からなる大規模な集団の神経活動を継続的にサンプリングし、短期的な衝動をならすために各個人の心の意味内容を数年単位で平均し、最後にそれをASIを導く損失関数として使うのだ。狙いは、私たちが手にできる最も忠実な情報源である心そのものを使って持続的な判断と一時的な衝動を見分けつつ、個人の好みの多様性を保つことにある。こうした信号は、人類の長期的な目標を継続的にとらえるためのより豊かな経験的基盤となりうる(外部アラインメント47に対して、より堅牢な解決策をもたらす可能性もある)。決定的に重要なのは、この基準が将来の世代を私たちの価値観の固定されたスナップショットに閉じ込めることなく、何十年にもわたって人類とともに進化し続ける点だ。
これまでのアラインメント研究の多くは、独立したエージェントを作り、それを従わせることを前提としてきた。動きの遅い生物の類人猿が、どうすれば超知能のデジタルな神を縛れるのか。人間と機械の間にエアギャップがある限り、アラインメントは敵対的な封じ込めゲームだ。
しかし、高帯域のBCIとニューロテクノロジーは、やがて使い手と道具の境界を曖昧にする。認知プロセスがAIの計算資源とシームレスに統合されれば、AIはアラインメントすべき「他者」ではなくなる。自分の大脳皮質、自分自身の延長にすぎなくなるのだ。自分の腕を脳に「アラインメント」する必要はない。腕は自分の一部だからだ。突き詰めれば、BCIはアラインメント問題を封じ込めの問題(制御によるアラインメント)からアイデンティティの問題(統合によるアラインメント)へと変える。
ただし、BCIの帯域幅が上がれば自動的にアラインメントに有利になるわけではない点には注意が必要だ。人間とAIの帯域幅の差を埋める戦略は、そのまま、より速い操作、より深い依存、前例のない監視を生むためにも使える。BCIがアラインメントに役立つのは、主体性、同意、プライバシー、解釈可能性に関する強い規範と組み合わせた場合に限られる。強力な技術の多くと同じく、BCIもデュアルユース(軍民両用)のリスクを抱えている。こうしたリスクは第22節第22節大規模な読心:何が起こりうるのか第IV部 · 余波:未来に何をもたらすのか?▸でさらに掘り下げる。
加えて、BCIはどれほど重要でも、それだけでは必要条件ではあっても十分条件ではない。重要なてこではあるが、てこの一つにすぎない。この物語でBCIが最終的にどんな役割を果たすのかについては、まだ不確実な点が多い。それでも、ここまで述べた理由から、どのシナリオが現実になるにせよ、ニューロテクノロジーが世界に大きな影響を与える可能性は非常に高い。私たちが必ず手元に備えておきたい道具でもある。
この節でも、このマニフェスト全体でも、私はかなり強い主張をしている。だが私たちはいま、数十年分の変化が数年で起きる世界に生きている。これは技術楽観主義者が見続ける幻覚ではない。技術が人間の頭の処理速度を上回って進む、目のくらむような新しい現実に根ざした主張だ。この文章を書いているいまも、フェーズロックの窓は急速に閉じつつあり、人類が新世界に必要なインフラを築くための時間はもうあまり残されていない。
最初の二つの部では、BCIがたどる軌道を描いた。第III部第III部衝突なぜBCIはAIにとって重要なのか?▸では、その軌道がAIと衝突したときに何が起こるかを検討した。
この部は次の四つの節で構成した。
- 交わる軌道:二つの分野を隔てる壁が溶けつつある様子を見た。AIは脳を解読する能力を加速させ、BCIはAIに新たなデータ源と制御手段をもたらしつつある。AIの巨大な引力に引き寄せられ、両者の軌道は同期しはじめている。
- 新たな主要モダリティ:神経データは新たな主要学習モダリティになろうとしており、テキストや行動よりも上流にある認知の信号へのアクセスをモデルにもたらす。神経データセットは数十億ドル規模のAI資本をBCIに呼び込み、ハードウェアの進歩を加速させる。
- 新しいインターフェース:BCIは、キーボードや音声という狭く逐次的な経路を、意図・文脈・フィードバックの連続的な流れに置き換える可能性がある。そうなれば、人間がAIを構築し、方向づけるやり方は根本から変わる。
- AIアラインメントにとってなぜ重要か:最後に一歩引いて、こうしたことすべてがなぜ人類の存続にとって決定的なのかを考えた。BCIはアラインメントに対して、性質の異なるいくつかのてこを提供する。モデル設計の指針となる、より深い経験的な人間の価値観の地図、人間の判断をAIと結びつけ続けるより高帯域の経路、そして最終的には人間の神経拡張と、より深い人間とAIの共生へ至る道である。ニューロテクノロジーは、AIの監督という問題を敵対的な封じ込めゲームから協調的な統合ゲームへととらえ直す。
27. OpenAI、Google、および1日あたりの発話語数に関する研究に基づく推定。
28. まさにこの文章を書いている最中に、OpenAIがChatGPT単独で達成した10件の数学上のブレークスルーを発表した。
29. フェルミ推定:大脳皮質のニューロン160億個 × 毎秒0.16スパイク × 1スパイクあたり1ビット(仮定)を1日16時間分。これを、利用可能な公開インターネットテキスト約1.2ペタバイトと比較した。
30. プラトン(Plato)の洞窟の比喩:何もない壁に向かって鎖でつながれた囚人たちは、背後を通り過ぎる物体の影しか見ることができず、その影を現実だと思い込む。ここでは、私たちが学習に使う産物(テキスト、動画、コード)が影であり、その影を投げかける神経活動が火にあたる。
31. この論文Cognitive Dark Matter: Measuring What AI Misses現代のAIの能力がでこぼこなのは、学習信号が欠けているためだと論じる。欠けているのは、行動を形づくりながらも行動からは推し量りにくい脳の機能だ。それを補う手段として、認知モデルの潜在変数、プロセストレーシング、神経データと行動データの対データを提案する。▸は、この考えを深く掘り下げて見事に論じている。
32. ある人から聞いた的確な喩えがある。非侵襲の脳データを解読するのは、ハリケーンのさなかにコンサートホールの外から交響曲を聴こうとするようなものだという。
33. 初期の実験では、すでにモデル能力の2桁%の向上が見られている。
34. 現在、統合されたオープンな脳波コーパスとして最大のNeuroLMは約2万5,000時間に達し、6万時間超を目指す取り組みもある。ただし、単一の一貫したデータセットは今も1万時間に届かない。Metaが最近公開したfMRIコーパスTRIBE v2は約500〜1,100時間だ。1,300万時間という閾値には、現時点で2〜4桁足りない。
35. OpenAIのStargateへの拠出約束は4年間で5,000億ドルと報じられており、AnthropicとGoogleのTPU契約は約2,000億ドル規模だ。
36. MetaのAI基礎研究所であるFAIR(Fundamental AI Research)は、神経科学の研究所も兼ねている。
37. ここ最近の出来事を見ると、その移行はいっそう明らかだ。
38. 古典的なコンピュータ・アーキテクチャでは、プロセッサとメモリが1本の共有通信バスの両端に置かれている。そのためCPUは、このバスがデータと命令を往復させる速さでしか処理を進められない。計算資源がどれほど速くても、それに供給するバスが追いつかなければ処理は止まってしまう。
39. ざっと概算してみる。RLHFの選好ラベル1件が運ぶ情報量はおよそ1ビットで、高評価か、AとBのどちらを選ぶかだけだ。フロンティアのRLHFサイクルではこうしたラベルを10⁵〜10⁶件使うことがあり、圧縮された判断の総量は約10⁶ビットになる。これに対し、32チャンネル・256Hz・16ビット分解能の消費者向け脳波計測1秒分には、およそ1.3 × 10⁵ビットの生データが含まれる。この信号のうち有用な認知変数を反映するのがわずか0.1%だとしても、毎秒約10²ビットの実効情報が得られる。RLHFのクリック1回が約1ビットであるのと比べれば、神経フィードバックは認知的反応1秒あたりで約2桁密度が高いことになる。この密度なら、1万時間のデータセットには約5 × 10⁹ビットの教師信号が含まれる。
40. 誤りや、予想に反する結果を認識してから約50〜250ミリ秒以内に脳が生じる、不随意の電気的な反応。非侵襲で読み取れる。
42. RLAIF(AIのフィードバックによる強化学習)はRLHFに似ているが、選好の判断を人間のラベラーではなく別のAIモデルが下す点が異なる。人間によるアノテーションのコストと時間を減らすために使われる。
43. AIアラインメントについて考えるとき、物語の中に悪役を探したくなる。敵対する国や強欲なテック企業、あるいは悪意ある者たちが集まる暗い部屋といったものだ。だが現実には、私たちは皆まったく同じ船に乗っている。進んでいく不確実性の海に左右に揺さぶられながら、個人としても集団としても沈まずにいようとしている。これがうまくいかなければ、全員が沈む。本当の敵がいるとすれば、特定の個人よりもむしろ、現代社会のインセンティブの仕組みそのものだ。
45. 仕様ゲーミングは、AIアラインメントの失敗のかたちとして最もよく予想されているものだ。テキストでAIに「人間を幸せにせよ」と指示すれば、最も効率的なやり方は私たちの脳をヘロインの点滴につなぐことだと、AIは論理的に結論づけるかもしれない。このテーマについては、DeepMindによる仕様ゲーミングの概説や、ヴィクトリア・クラコフナ(Victoria Krakovna)が更新を続ける現実の事例リストなど、多くの解説がある。
46. ここから導かれることの一つは、神経の学習データは慎重に選んだ人々から集めるべきだという点だ。その人たちの熟慮した判断が、モデルに学ばせたい価値観を反映している必要がある。事前学習ではさほど重要でないかもしれないが、ファインチューニングでは特に重要になりうる。
47. 外部アラインメントとは、そもそもAIに正しい目的を与える問題であり、学習で最適化させるものを私たちが本当に望むものと一致させることを指す。内部アラインメントはそれとは別の問題で、学習済みモデルがその目的を本当に追求するよう保証することだ。