
タイムライン予測
自動化された超人的コーダーが登場するまでの時間を予測する
Eli Lifland, Nikola Jurkovic, FutureSearch | 2025年4月
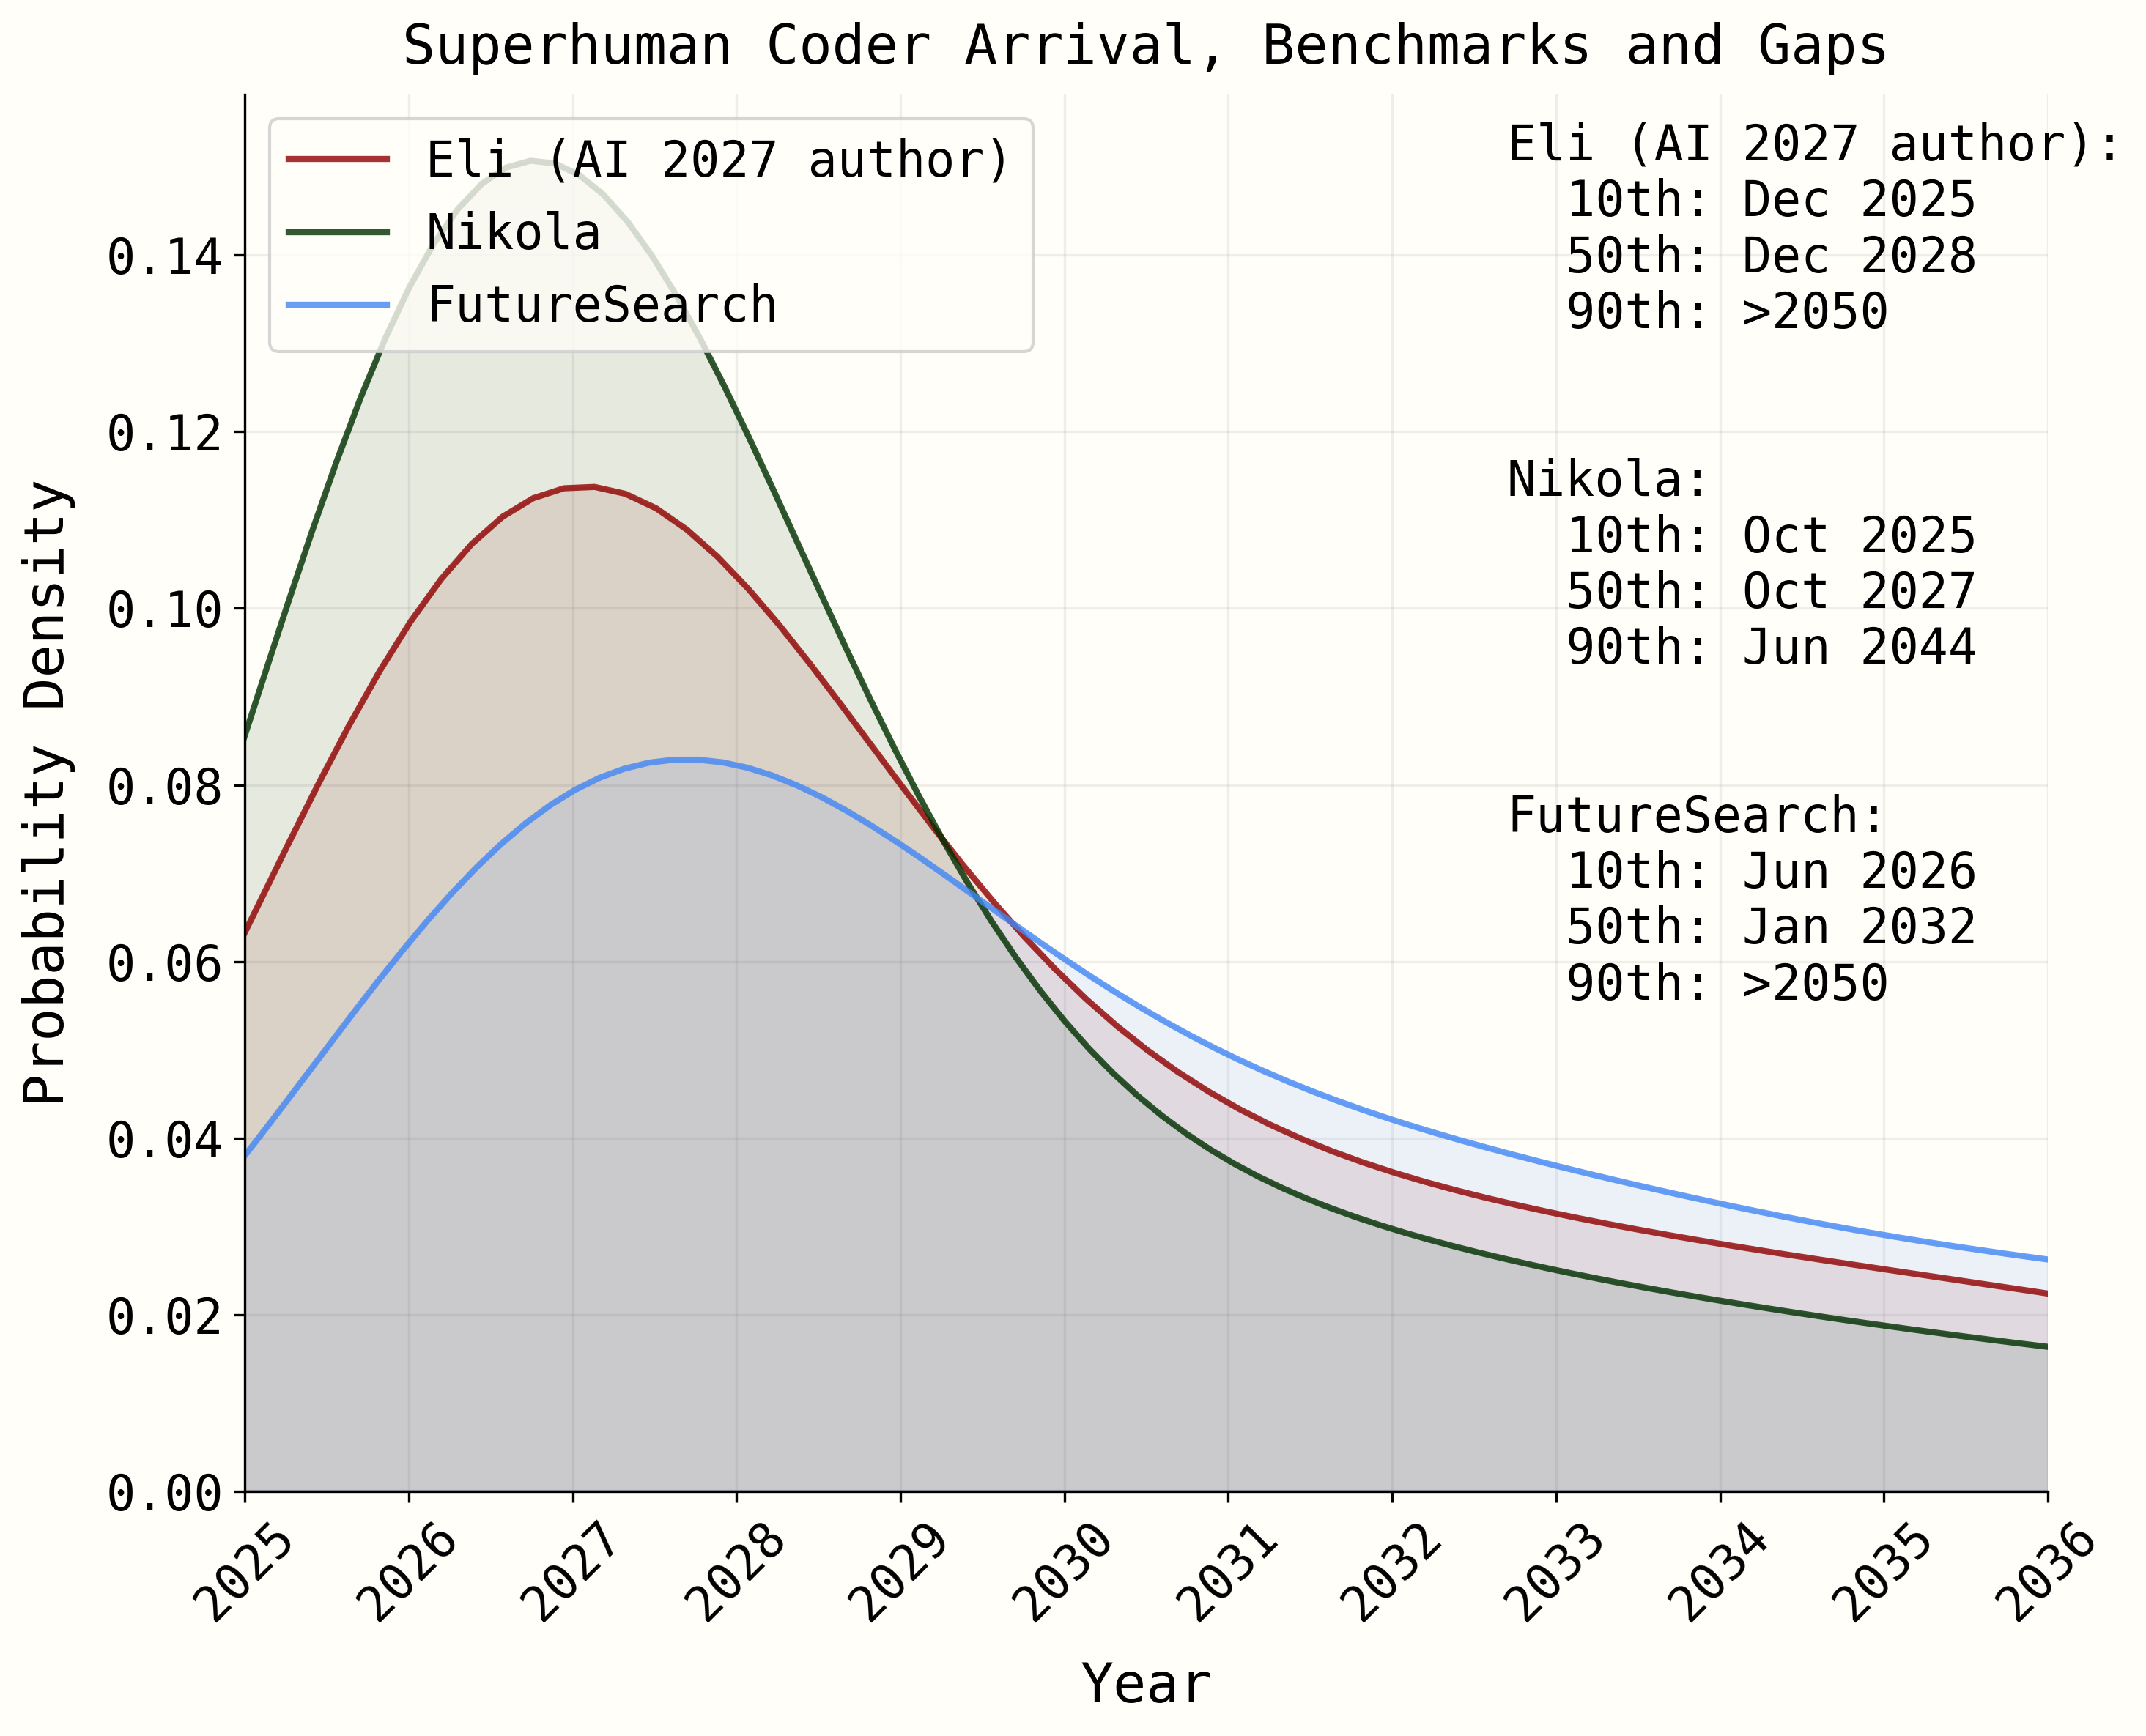 ai-2027.com超人的コーダーの到来時期の予測。大規模な破局(太陽フレア、パンデミック、核戦争など)が起きず、政府による減速や自主的な減速もなく、サプライチェーンの大きな混乱もないことを前提とする。どの予測も、超人的なコーディング能力が2027年までに、また2027年中に到来する確率をかなり大きく見積もっている。
概要
2025年12月31日の更新:タイムラインとテイクオフの改訂版モデルをaifuturesmodel.comで公開した。
2025年5月7日の更新:Eliは寄せられた意見にもとづいてモデルにいくつか更新を加え、その内容を付録で説明している。更新によって彼のタイムラインは、目に見えて、ただし大幅にではなく長くなった。 2027年までに超人的コーダーが登場する確率は以前より低くなったが、依然としてかなり大きい。付録にはこのモデルにおける超指数性の重要度の分析も収めてある。
私たちは、首位のAGI企業がいつ社内で超人的コーダー(SC)を開発するかを予測する。SCとは、AGI企業の最優秀エンジニアがこなすどんなコーディングタスクもこなせて、しかもはるかに速く安いAIシステムである。この時点でSCは、テイクオフ予測で検討したとおり、AIの進歩を大幅に加速する可能性が高い。
まず方法1として、タイムホライズン延長法を示す。これは比較的単純なモデルで、METRの報告書が明らかにした傾向、つまりAIが人間にとってますます時間のかかるタスクをこなせるようになっているという傾向を延長して、SCの到来時期を予測する。
次に方法2として、ベンチマーク・ギャップ法を示す。これはより複雑なモデルで、AI研究開発のベンチマーク(RE-Bench)が飽和する時期の予測から出発し、そこから、首位のAGI企業で現実のタスクをこなせるシステムに至るまでにどれだけかかるかを予測する。
最後に、この二つのモデルに加えて、地政学やマクロ経済などほかに影響しうる要因も考慮に入れた「すべてを勘案した」予測を示す。
また、FutureSearchのプロの予測者3名にも予測を依頼した(経歴はこちら)。
各方法の結果を以下にまとめる。
| EliのSC予測(中央値、80%信頼区間) | NikolaのSC予測(80%信頼区間) | FutureSearchの集計(80%信頼区間)(n=3) | |
|---|---|---|---|
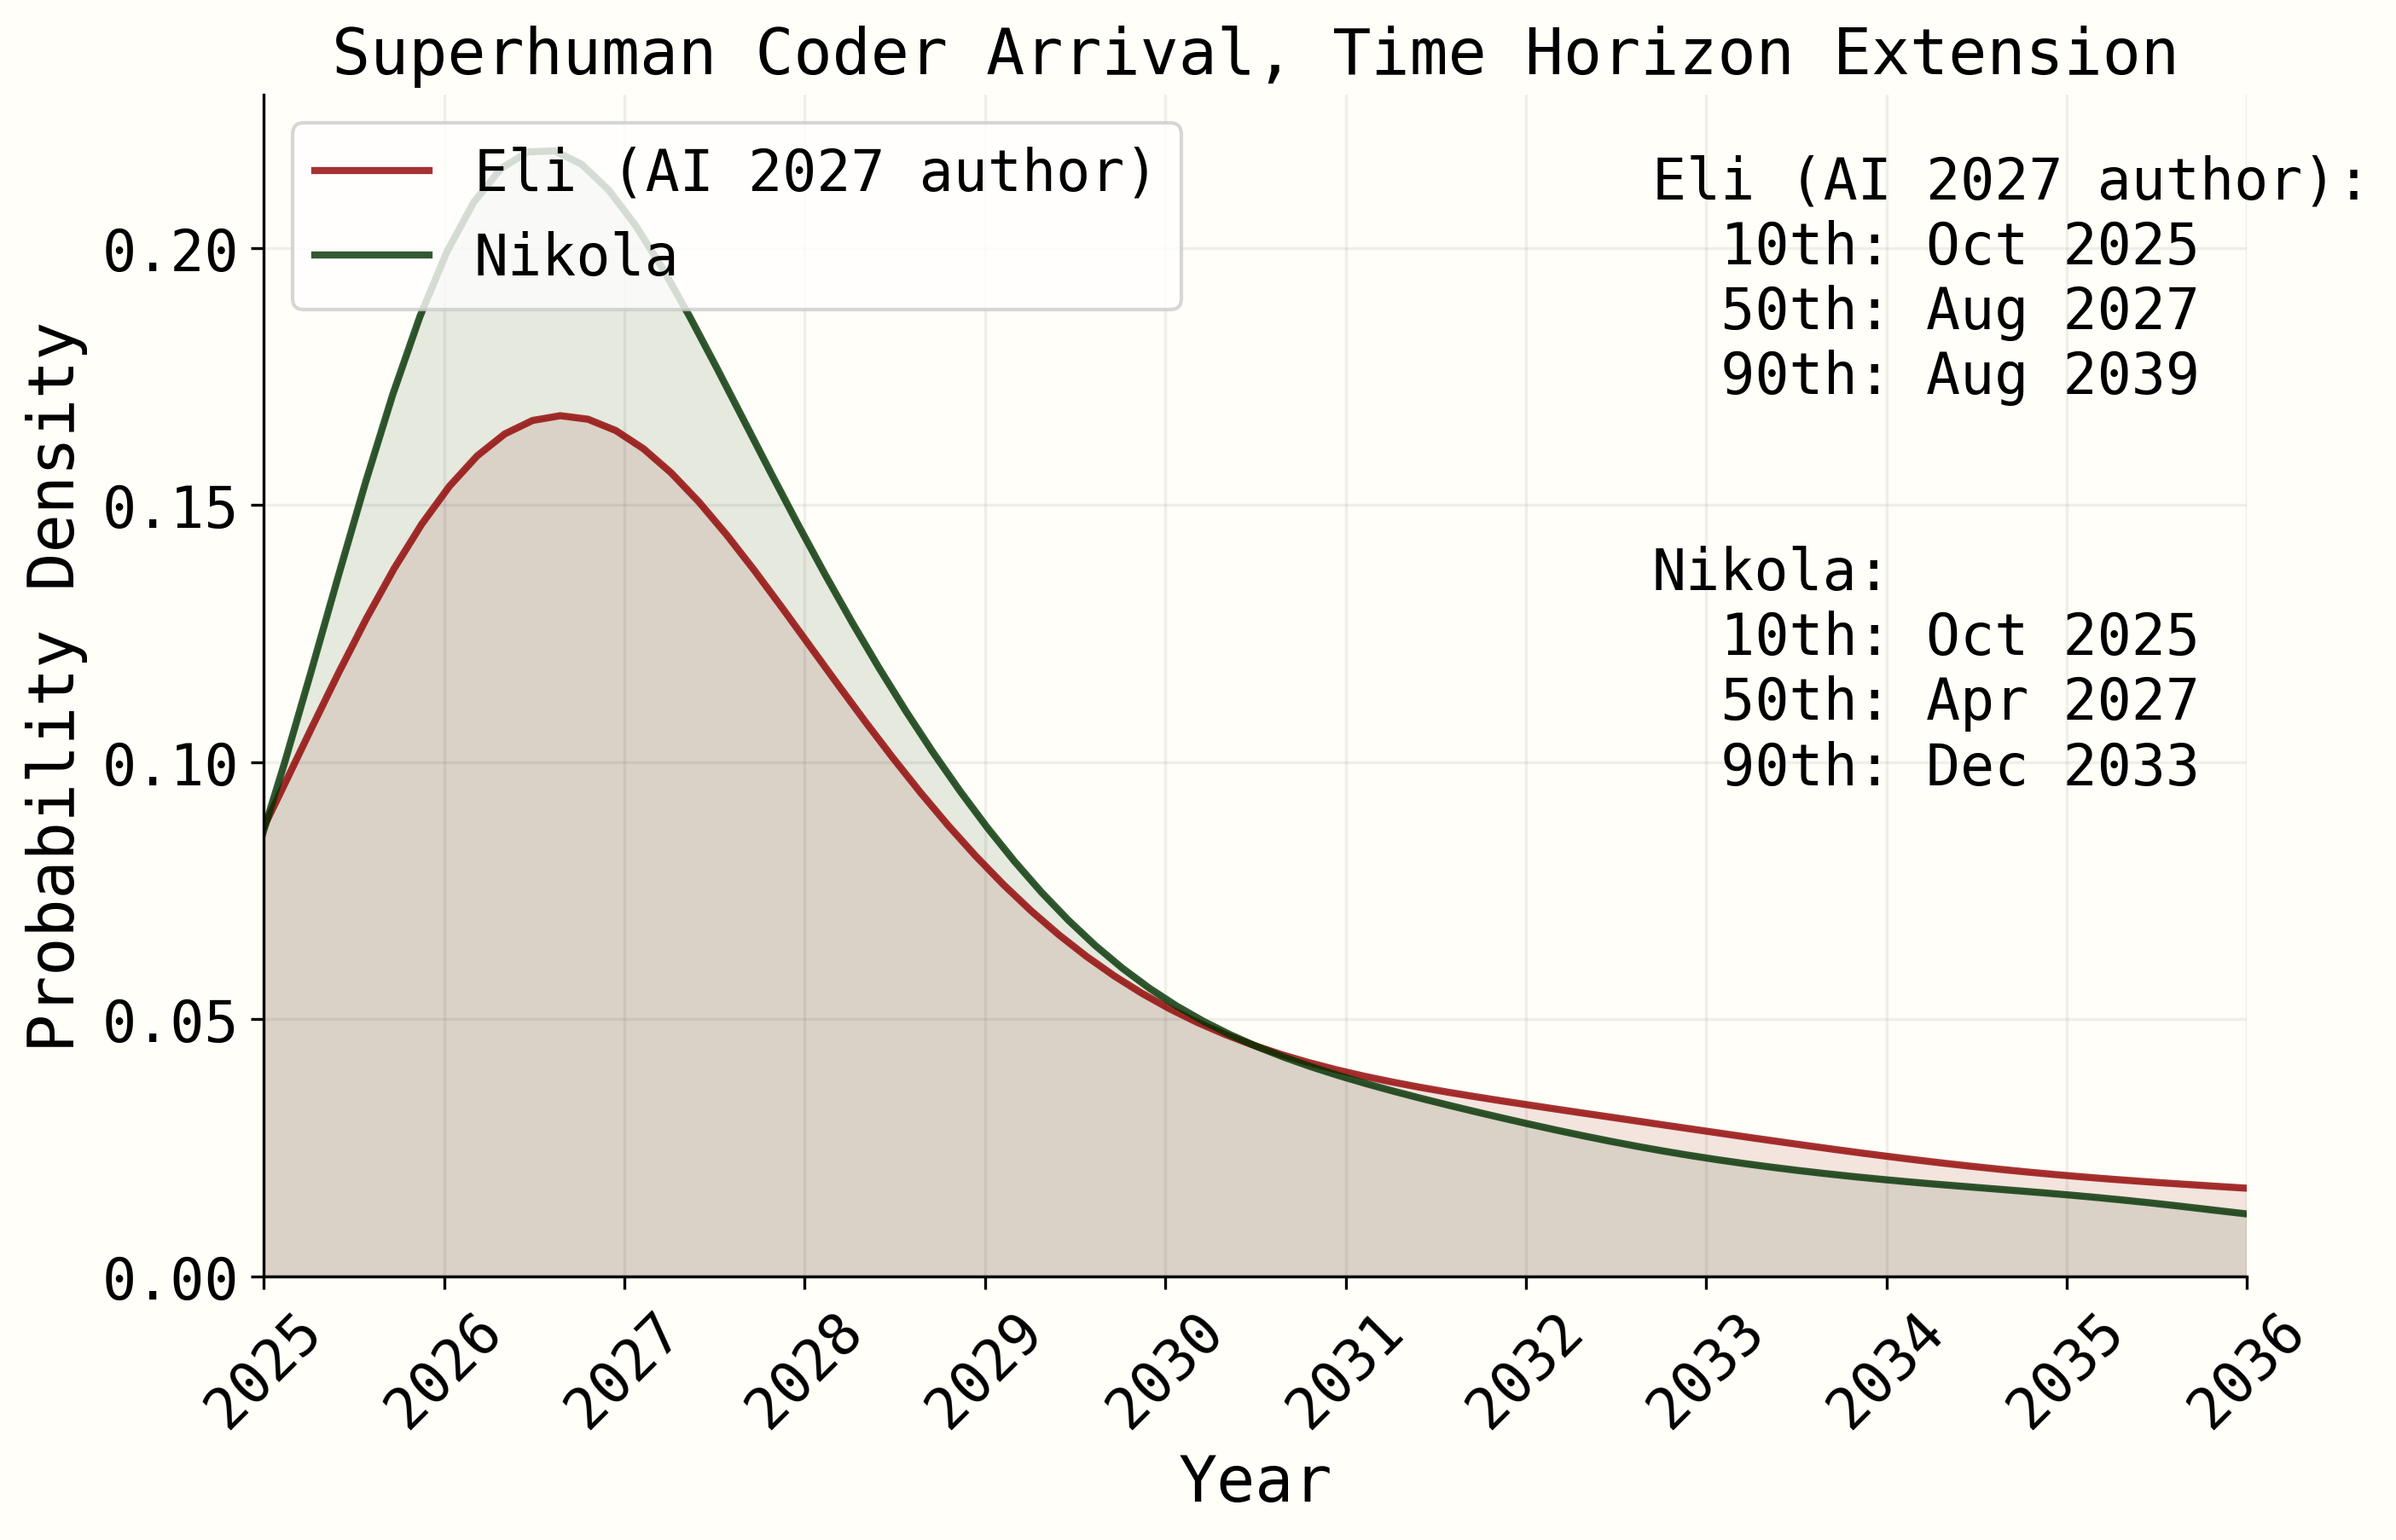
| タイムホライズン延長モデル(2025年4月) | 2027年(2025〜2039年) | 2027年(2025〜2033年) | N/A |
| タイムホライズン・モデルの更新版(2025年5月) | 2029年(2026〜2052年) | N/A | N/A |
| ベンチマーク・ギャップ・モデル(2025年4月) | 2028年(2025年〜2050年超) | 2027年(2025〜2044年) | 2032年(2026年〜2050年超) |
| ベンチマーク・ギャップ・モデルの更新版(2025年5月) | 2030年(2026〜2095年) | N/A | N/A |
| すべてを勘案した予測。これらのモデルの外にある要因で調整したもの(2025年4月) | 2030年(2026年〜2050年超) (公開4日後に90パーセンタイルを2050年から2050年超に修正) | 2028年(2026〜2040年) | 2033年(2027年〜2050年超) |
モデルにもとづく予測はいずれも、SCが開発される可能性が最も高い年の一つとして2027年を挙げている。AI 2027のシナリオでSCが登場するのもこの年である。
付録では、重要なモデル・パラメータのいくつかが与える影響を示す。シミュレーションのコードはこちら。
2025年12月に追記した注意書き:この予測は直観的な判断に大きく依存しており、不確実性がきわめて高い。残念ながら、高度なAIが登場するまでのタイムラインを予測するには、直観的な判断を取り入れることが必要だと私たちは考えている。決定的な外挿を行えるだけの証拠が、とにかく足りないからだ。
超人的コーダー(SC)の定義
超人的コーダー(SC):次の条件を満たすAIシステム。企業が計算資源予算の5%で、人間の研究エンジニアの30倍の数のエージェントを動かせる。しかも各エージェントが、AI研究に含まれるコーディングタスク(たとえば実験の実装。アイデア出しや優先順位づけは含まない)を、平均してその企業の最優秀エンジニアの30倍の速さでこなす(つまりタスクにかかる時間が30分の1になるということで、人間の30倍の速さで書いたり「考えたり」するとは限らない)。これには、どの人間の研究者の専門分野に属するタスクでもこなせることが含まれる。
NikolaとEliは、最初のSCはフロンティアAI研究者の50パーセンタイル以上の「研究センス」も備えているだろうと見積もっている。ただし、それは定義上の要件ではない。
方法1:タイムホライズン延長
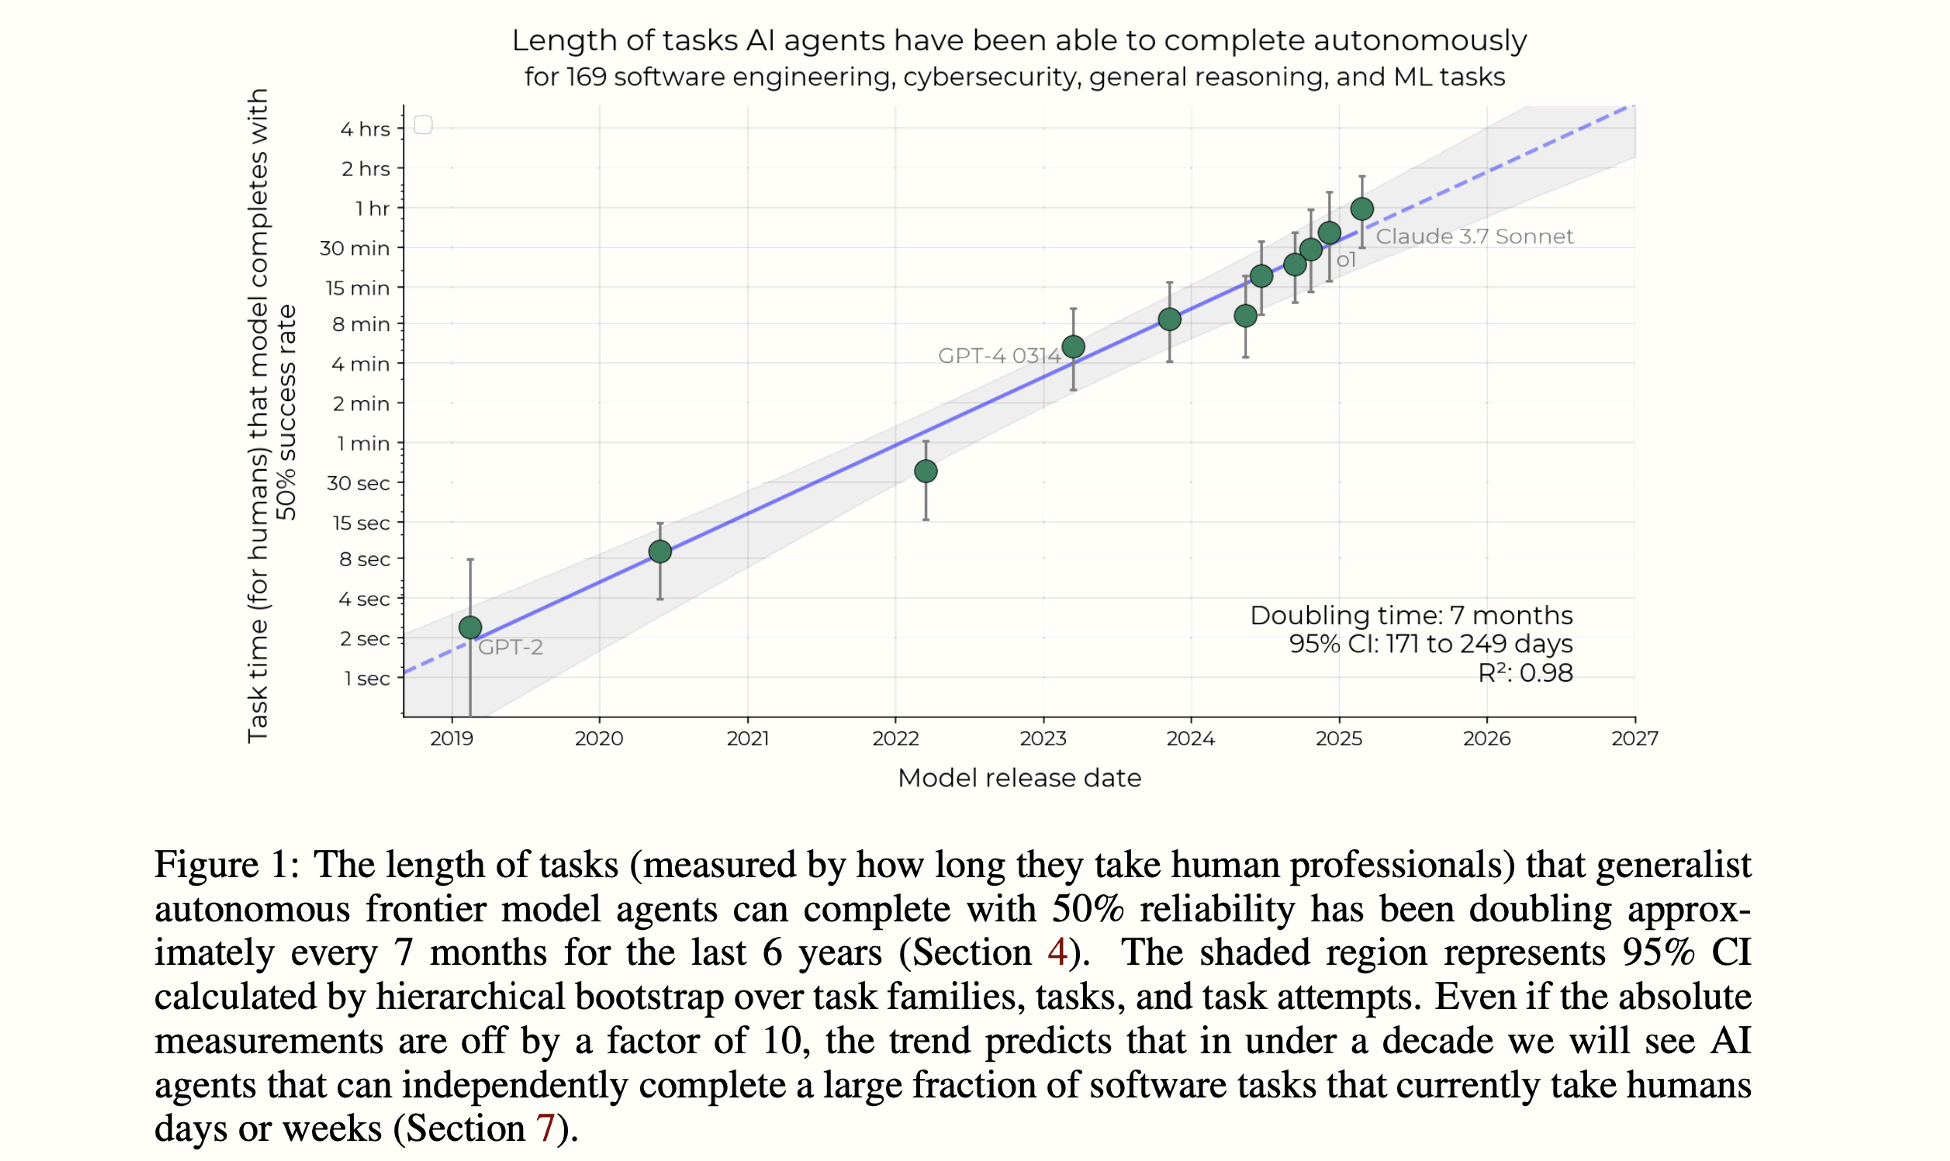
このモデルは、AIが超人的コーダー(SC)へ近づいていく進歩を外挿することにもとづく。進歩は、AIがこなせる最も難しいタスクを人間がこなすのにどれだけ時間がかかるか(これをAIの「タイムホライズン」と呼ぶ)で測る。私たちはMETRの最近の報告書に大きく依拠している。この報告書は、タイムホライズンが伸びていく傾向を記録している(下図)。
予測は二つの小問に分ける。
SCには、METRのタスク群でどれだけのタイムホライズンと信頼度が必要か。
このタイムホライズンと信頼度にいつ到達するか。これはさらに次のように分解する。
現在のタイムホライズンの倍加時間
AI研究開発の自動化がない場合に、倍加時間が時間とともにどう変わるか
人間並みのコストで動くSCを、30倍速く安くすることの難しさ
途中段階での加速と、社内モデルと公開モデルのギャップを考慮する
シミュレーションの結果を以下に示す。
 ai-2027.com
このモデルの外にある要因も考慮に入れた私たちの分布は、これより幅が広い。
METRのタイムホライズン報告書
METRの最近の報告書は、AIシステムの「タイムホライズン」という能力を測定している。タイムホライズンは、熟練した人間がタスクを完了するのにかかる時間にもとづいて定義される(詳細は脚注)。
AIのR%タイムホライズンがTであるとは、人間ならT時間かかるタスクで平均R%の成功率を達成するという意味である。私たちのモデル化ではタイムホライズンと信頼度についてMETRの定義に従うが、AIは少なくとも人間と同じ速さと安さでタスクを完了しなければならないという制約を加える。METRは推論計算に人間並みのコストをかけていないので、この制約を加えてもMETRの結果は変わらないだろう。
下図はその方法を示している。
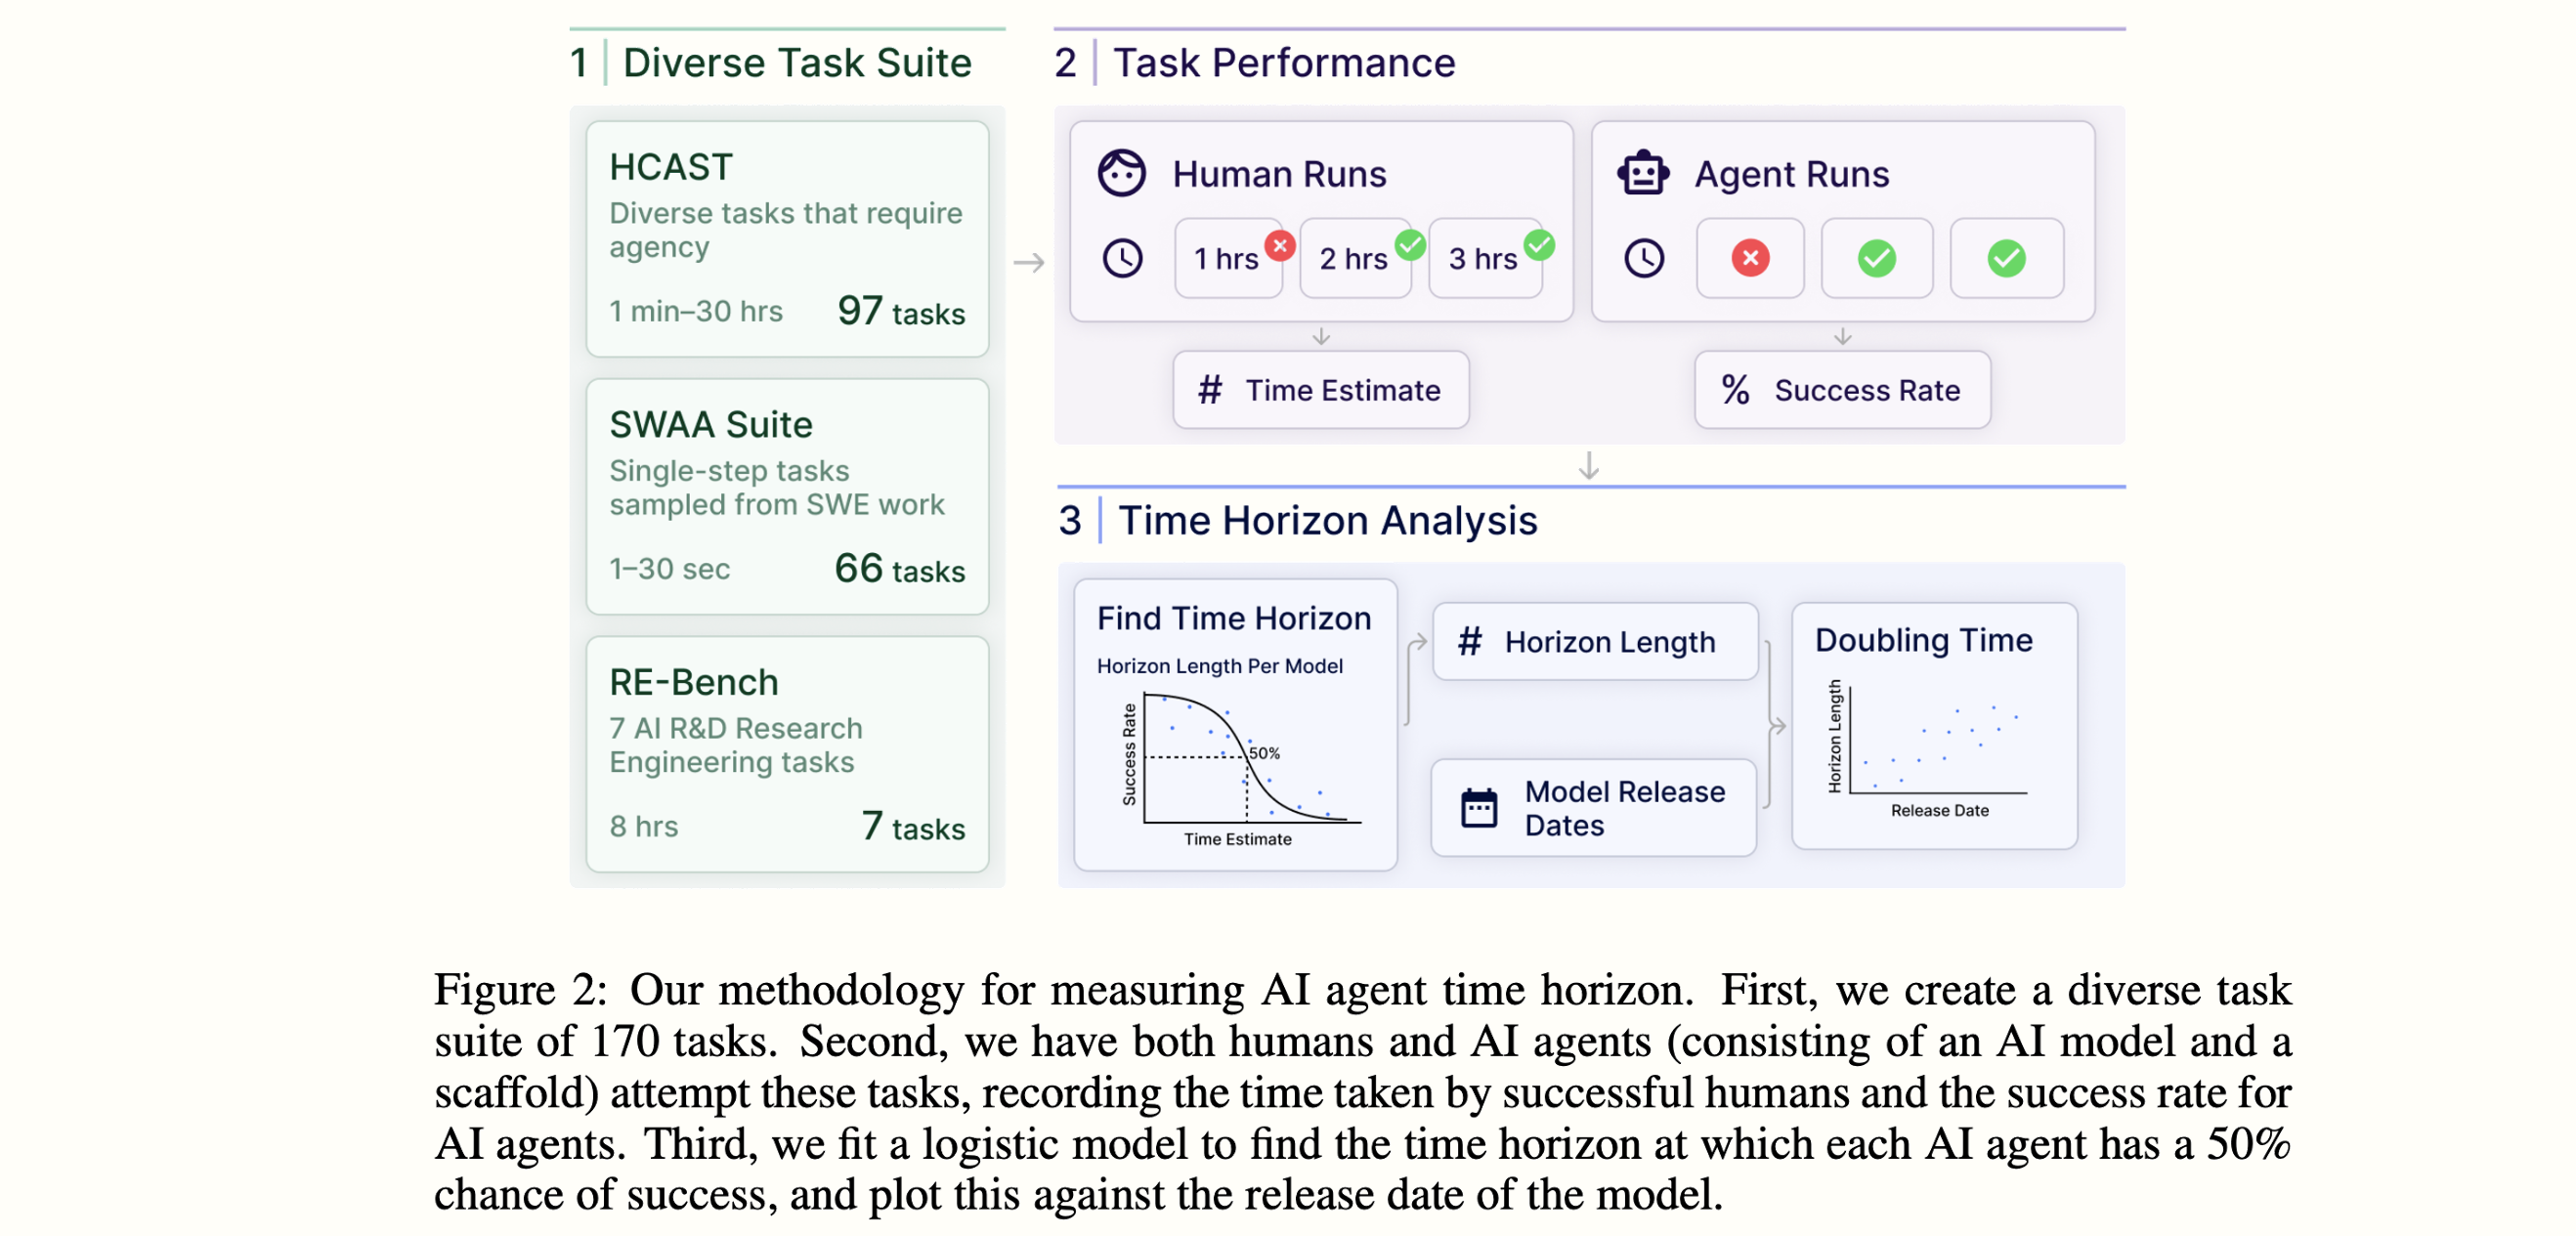
METRのタスク群HCASTの詳細はこの論文にあり、下の表はタスクの分布を示している。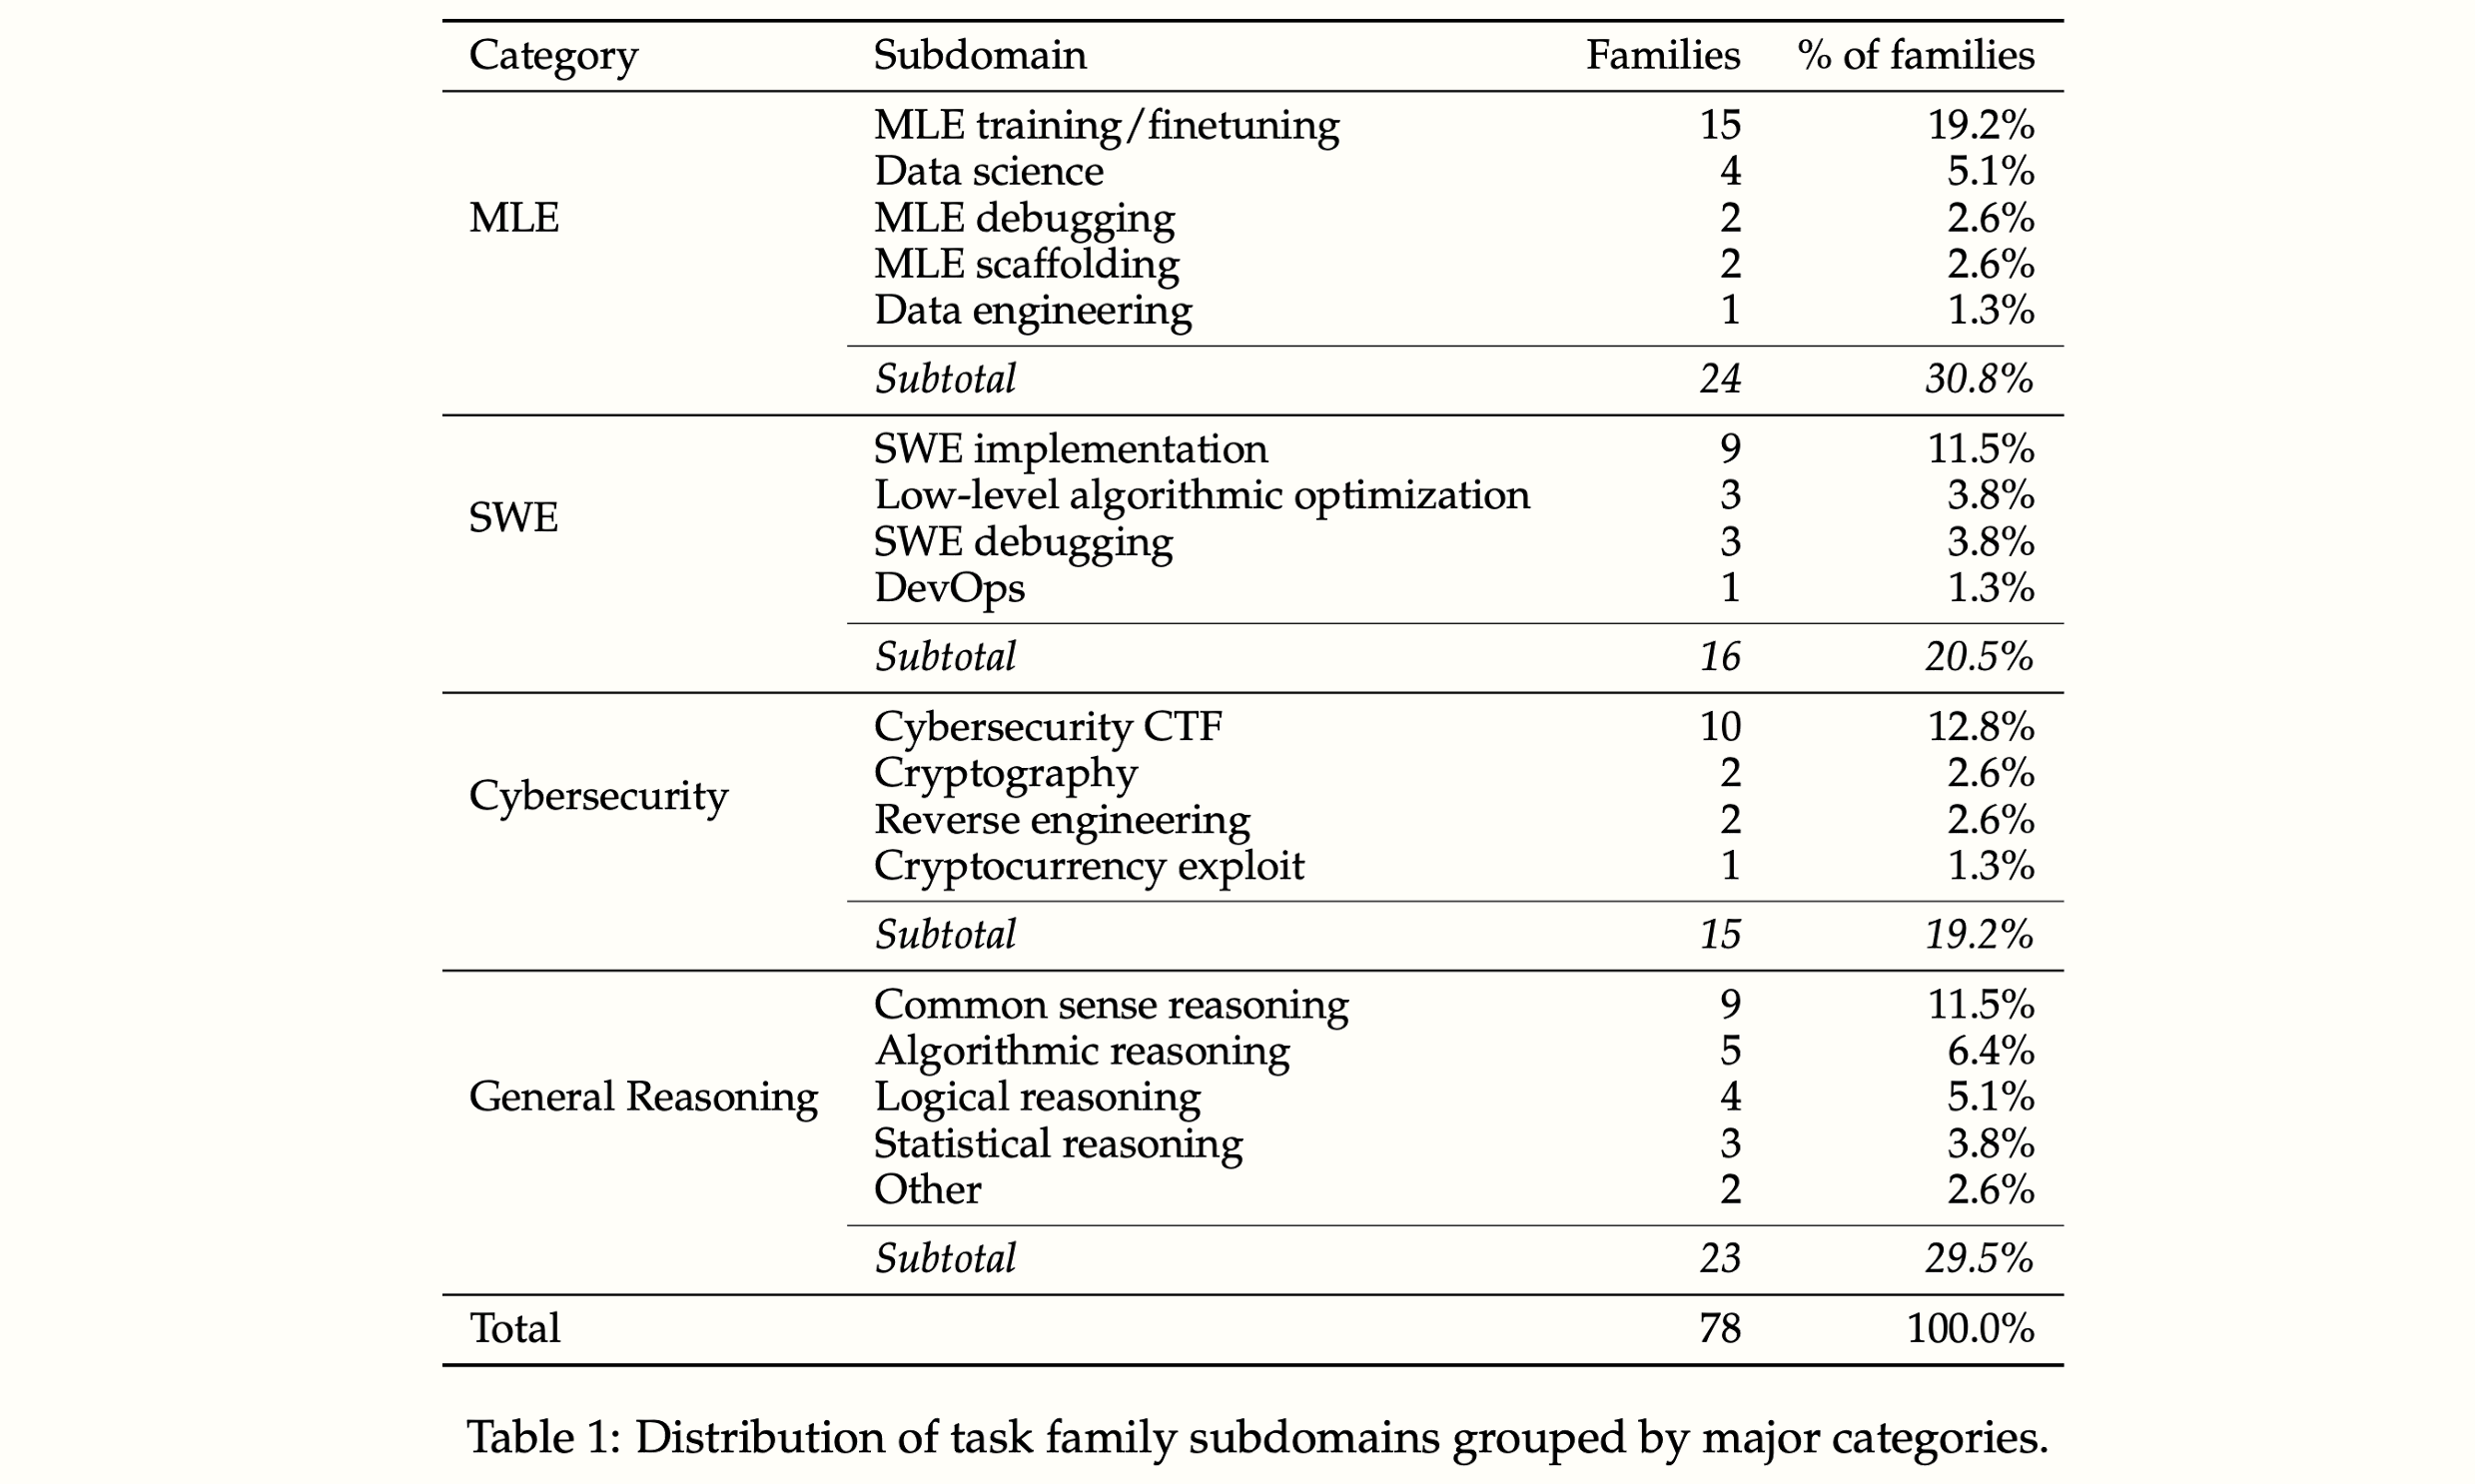 以下では簡潔にするため、METRのタスク群をHCASTと呼ぶ。これから論じるのはSWAAが測る範囲を大きく超えるタイムホライズンであり、RE-Benchはこのタスク群のごく一部にすぎないからだ。
SCの到来時期の予測
シミュレーションのパラメータを次の表にまとめる。
| 推定値(特記なき限り対数正規分布の80%信頼区間) | 根拠 | |
|---|---|---|
| 現在の80%タイムホライズン | 15分(点推定) | METRのタイムホライズン論文から採った。Claude Sonnet 3.7の80%タイムホライズンである。 |
| SCに必要なタイムホライズン | Eli: 10年 [1か月, 1200年] Nikola: 1.5か月 [16時間, 2労働年(4,000時間)] | 実際の業務タスクの分布で、強いインセンティブを持つ最優秀の人間がベースラインを取った場合に必要なタイムホライズン:6か月(80%信頼区間:[1週間, 12年])。HCASTを外挿したタスクで、METRの現行のベースライン測定方法を用いた場合に必要なタイムホライズンと信頼度:10年 [1か月, 1200年] 詳しい根拠は付録を参照。 |
| 2025年3月時点のHCASTでのタイムホライズン倍加時間 (2025年12月に追記:長期的な傾向として延長したもの) | 4.5か月 [2.5か月, 9か月] | METRの報告書によれば、50%タイムホライズンの倍加時間はおおよそ次のとおり。同報告書のタスク群では、2019〜2025年の期間:7か月(図1)、2024年以降:3.5か月(図19)(データ点は少ない)。2023年後半以降のSWEBench-Verifiedでは:2.5か月(図11)。80%タイムホライズンの倍加時間は、2019〜2025年では50%の場合とほぼ同じである(7か月ではなく7.5か月、図6)。以上を比べ合わせると、中央値は約4.5か月になる。より長い期間にわたる傾向が最も頑健だが、最近の傾向のほうが速い。 |
| 倍加時間は短くなるか、長くなるか、変わらないか (2025年12月に追記:AI研究開発の自動化を考慮に入れる前の話) | 確率: 指数関数的:Eli: 0.45 Nikola: 0.5 超指数関数的:Eli: 0.45 Nikola: 0.4 亜指数関数的:Eli: 0.1 Nikola: 0.1 | 現在からSCに必要な水準に達するまでの間に、タイムホライズンが時間とともに超指数関数的(superexponential)に伸びる可能性がある。つまり、長期にわたる推論は短いタイムホライズンから長いタイムホライズンへと容易に汎化するので、1時間から2時間へ伸ばすよりも、1か月から2か月へ伸ばすほうが必要なAIの進歩は少ない、ということだ。超指数性を支持する理由には次のものがある。経験的根拠:METRの報告書では、2019〜2025年の倍加時間が7か月であるのに対し、2024〜2025年の倍加時間は3.5か月だった。ただしデータ点は少ない。報告書の7.2.2節で論じられているように、エージェントとしての訓練の規模拡大がこの傾向の理由として考えられる。概念的根拠: 人間にとっては、1か月のタスクと2か月のタスクの難しさの差は、1日と2日の差より小さいように思える。ただし、これまでAIは人間に比べて、汎用的な推論よりも知識に強く頼ってタスクを解いてきたので、同じことがAIに当てはまるかははっきりしない。そこで私たちは、成長が超指数関数的である確率をかなり大きく見積もる。傾向が亜指数関数的である可能性にも、より小さな重みを与える。成長が超指数関数的なら、倍加のたびに所要時間が10%ずつ短くなるようにする。亜指数関数的なら、倍加のたびに所要時間が10%ずつ長くなる。 |
| コストと速度の調整 | 4か月 [0.5か月, 30か月] | SCであるためには、最優秀の人間研究者より30倍速く、30倍安くタスクをこなす必要がある。ただし既存のMETRの評価では人間並みのコストまではかけていないので、出発点の価格は人間より低い。METRの報告書の図13をざっと見ると、HCASTのタスクでは現在のAIは中央値で人間より約30倍安く、平均ではおそらく5〜10倍安い。METRのデータを分析すると、AIは平均しておおよそ5倍速い。後述の節では、過去の価格低下の傾向にもとづいて、人間と同じ水準から出発したAIがどれだけ早く30倍速く・30倍安くなるかを、ある程度詳しく予測する。ここではその予測値6.9 [1, 48]か月を採り、出発点がすでに人間より5〜10倍安く速いことから、約50%下方修正する。 |
| 社内展開と外部展開のギャップ | 1.2か月 [0.25か月, 6か月] | 現在のタイムホライズンの推定値は公開モデルについてのものだが、企業が社内にもっと高性能なモデルを持っている可能性がある。詳しくは後述。 |
方法2:ベンチマークとギャップ
RE-Benchが飽和するまでの時間
なぜRE-Benchか
RE-Benchは、客観的な採点関数を備えた、難しく現実的なAI研究開発タスクの集まりである。AGI企業のエンジニアがふだん行っている種類の仕事(たとえば機械学習モデルを訓練するスクリプトを書く、Pytorchのコードを最適化する)をとらえることを目指している。スコアは連続的に付くので、タスクの完了にかかる時間は一つに決まらない。ただし人間のベースラインはこれまで最長8時間まで集められており、8時間あれば有能な専門家がスコアを大きく伸ばすのに十分である。人間とAIシステムにRE-Benchのタスクをこなさせることで、AI研究開発に含まれるタスクでAIシステムがどれほど有能かの感触がつかめる。
RE-Benchの7つのタスクのうち、残る2つには採点に問題があるので、5つのタスクからなる部分集合に絞り、本報告の以下ではこの部分集合を「RE-Bench」と呼ぶ。具体的には、Scaling Law Experimentはモデルが運で成功できてしまうほど簡単で、Best-of-Kのスキャフォールディングに適さないので除外する。またRestricted MLM Architectureは、Claude 3.7 Sonnetがこのタスクで確実に不正をし、METRもいまだにモデルが不正なしで取り組むようなプロンプトを作れていないので除外する。
RE-Benchには、ほかのベンチマークでは得がたい好ましい性質がいくつかあり、AIがAI研究をどれだけ加速しているかを測る尺度として他に類のない優れたものになっている。
フロンティアのAI研究開発との関連性が高い。
性能の上限が高い。 AIエージェントは人間の水準を大きく上回る得点を達成しうる。ただし実際には、人間のベースライン解のおおよそ2倍(スコア1.5)を超えるのは非常に難しい可能性が高い。人間のベースラインのスコアの中央値は、2時間の作業で0.12、8時間で0.66である。現在の最高性能(SOTA)はClaude 3.7 Sonnetで、「modular」というスキャフォールドでBest-of-Kのスキャフォールディングを使い、おおよそ0.6のスコアを出している。
人間のベースラインがあり、AIと人間の性能を実測にもとづいて比較できる。
この定義による「飽和」は、SCのマイルストーンに達する前に起きると予想している。RE-Benchを最初に飽和させるシステムには、後述のとおり、SCのマイルストーンに達するのに必要な能力がいくつか欠けているだろう。
外挿による飽和時期の予測
RE-Benchのスコアはどこまで上がるか
RE-Benchの論文にある次の表から、RE-Benchのスコアがどこまで上がりうるかの感触がつかめる。
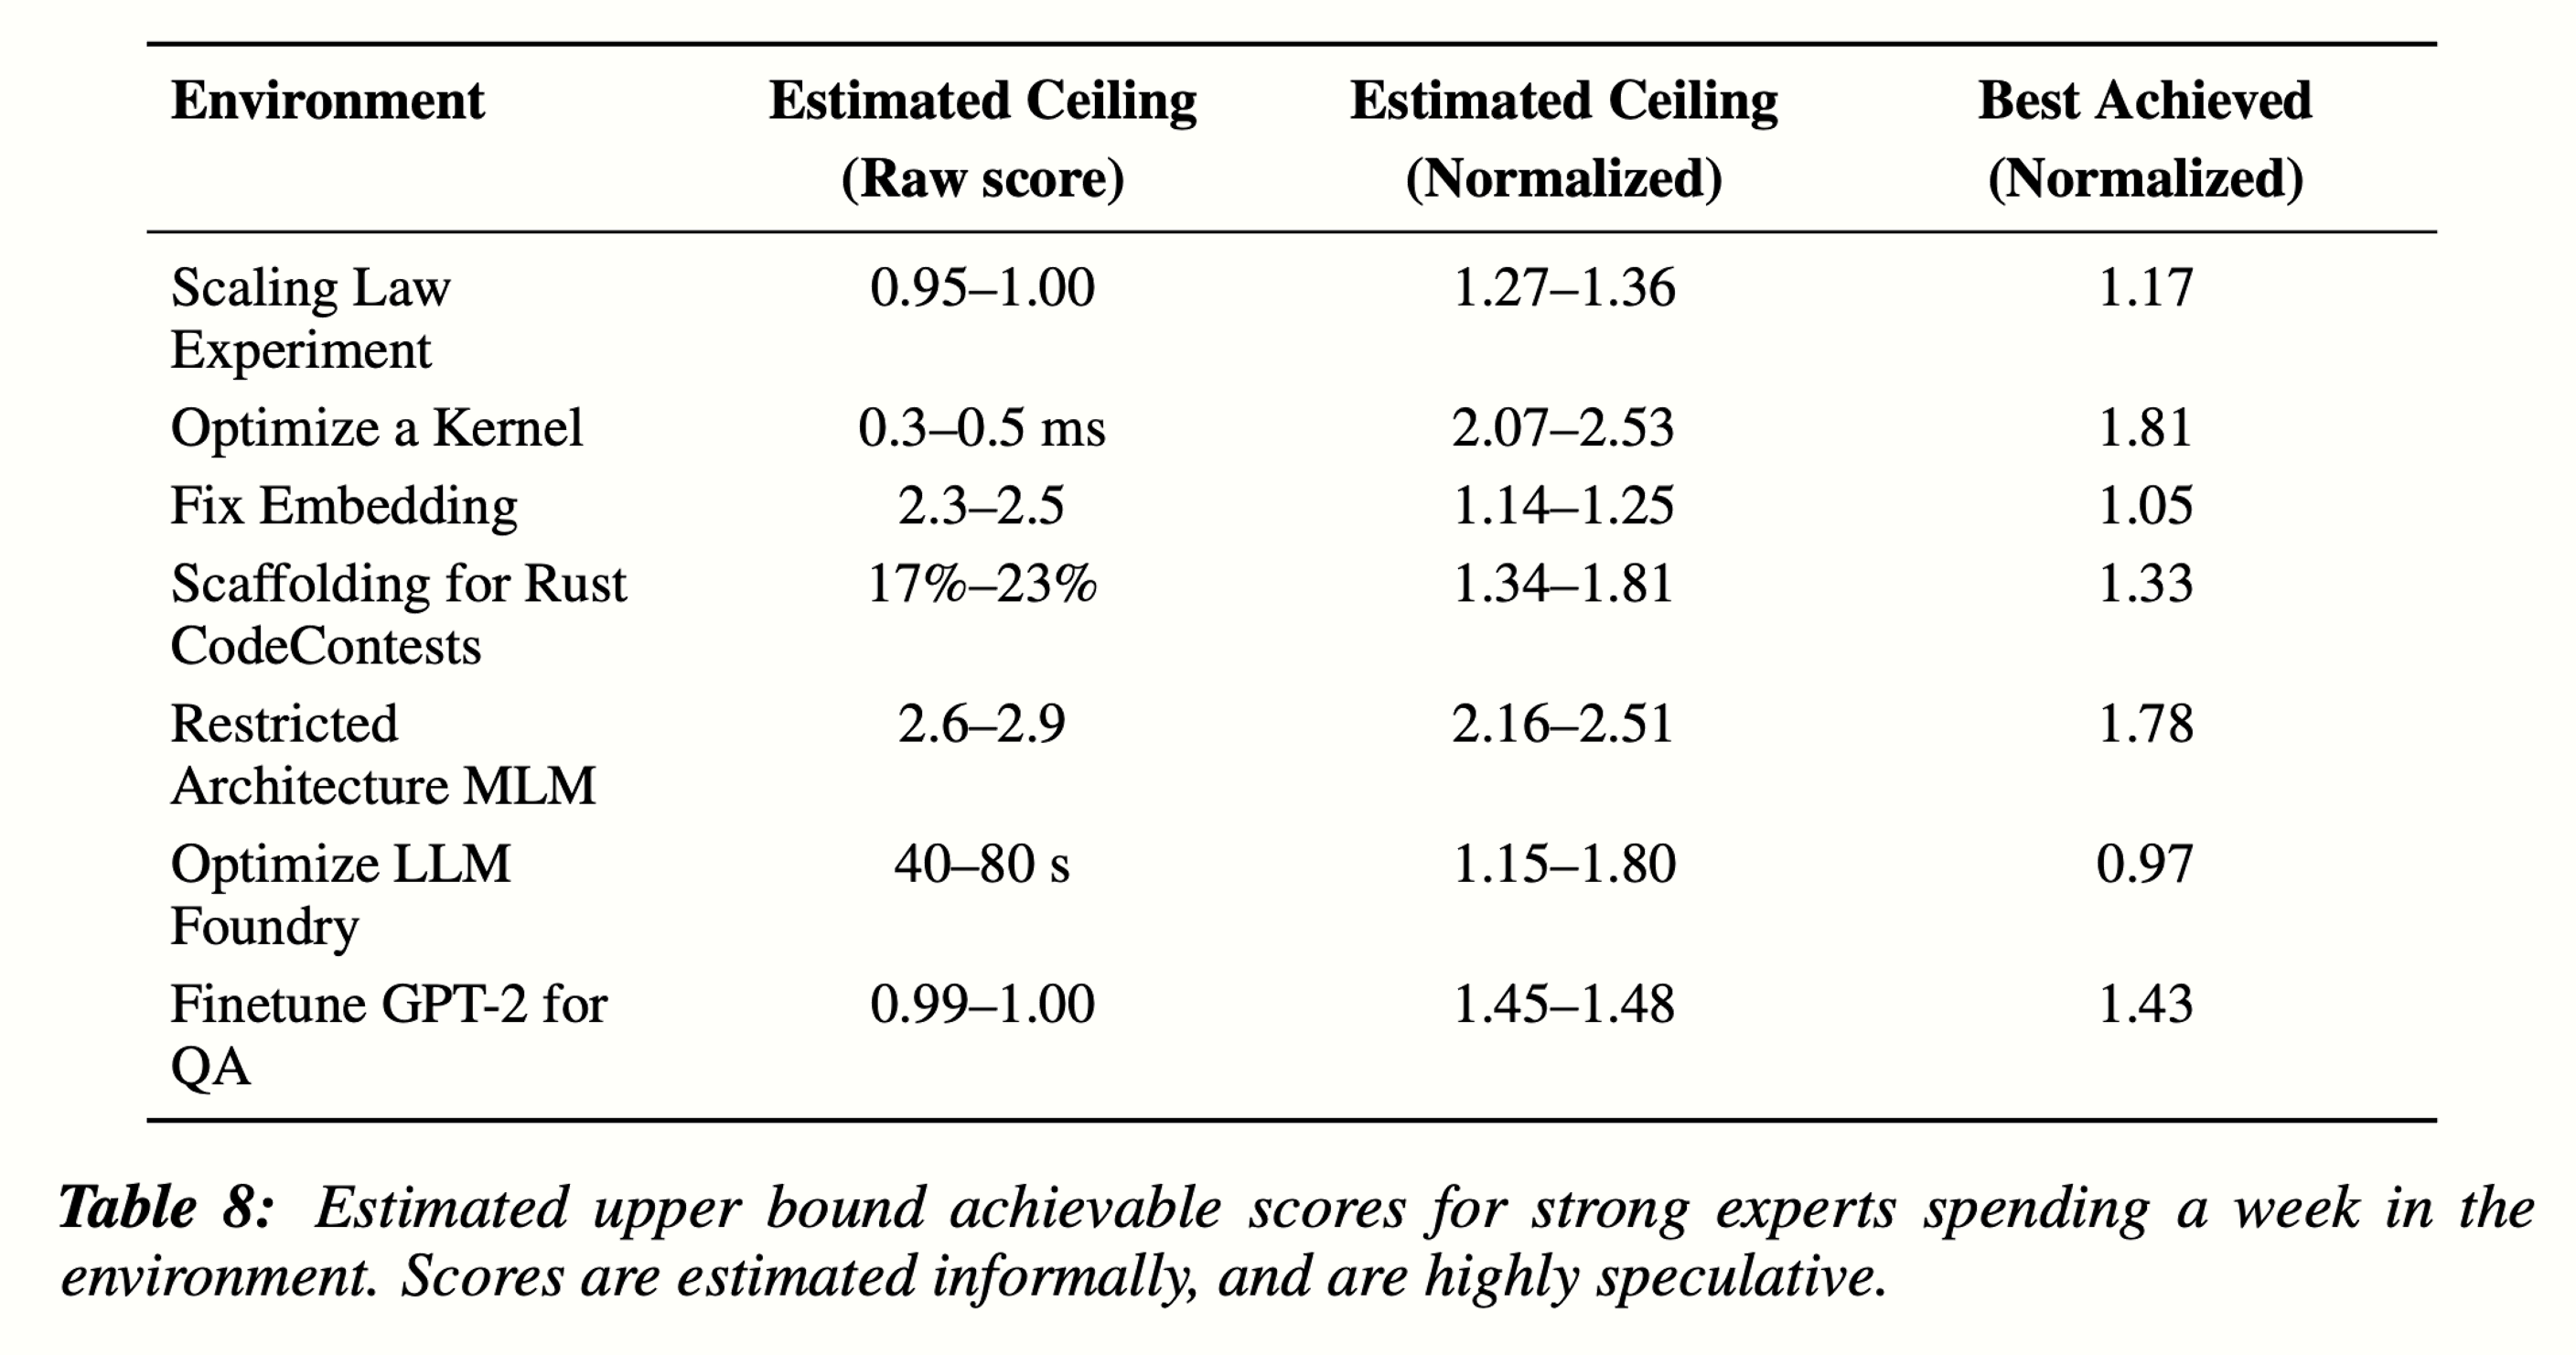
上の各「推定上限」の中間値の平均は1.67である。保守的に見積もり、「飽和」の水準が確実に達成可能になるように、RE-Benchのタスクではスコア1.5を「飽和」と定義する。判定基準にはAI 2025予測調査のもの(付録)を用いる。これには、モデルのコストがタスクあたりで人間を上回らないことの確認も含まれる。スコア1.5は、そのモデルが人間のベースライン試行の約95%超を上回ることを意味する(RE-Benchの図4では90パーセンタイルが約1.22)。ただし私たちは、1.5がおおよそ最優秀の人間の平均水準にあたると見積もっている。これが95パーセンタイルより高いのは、高得点の取りやすさがタスクによってばらつくことと、運などによって個人の成績がばらつくことによる。
外挿を行う
ベンチマークはロジスティック曲線に従うことが多いとわかっているので、RE-Benchも同様の形をたどると仮定し、過去の最高スコアの点推定値の推移にロジスティック曲線を当てはめる。ロジスティック曲線の下限は0とする。RE-Benchの上限はわかっていないので、平均2.0、標準偏差0.25の正規分布としてモデル化する。上限を変えても (2025年12月に追記:この範囲内で) 予測はあまり変わらない。上限を0.25変えると、飽和の時期はおよそ半年動く。
Best-of-Kを認め、モデルにタスクあたり16時間の時間予算を与えた場合の最高スコアについて、次のグラフが得られる。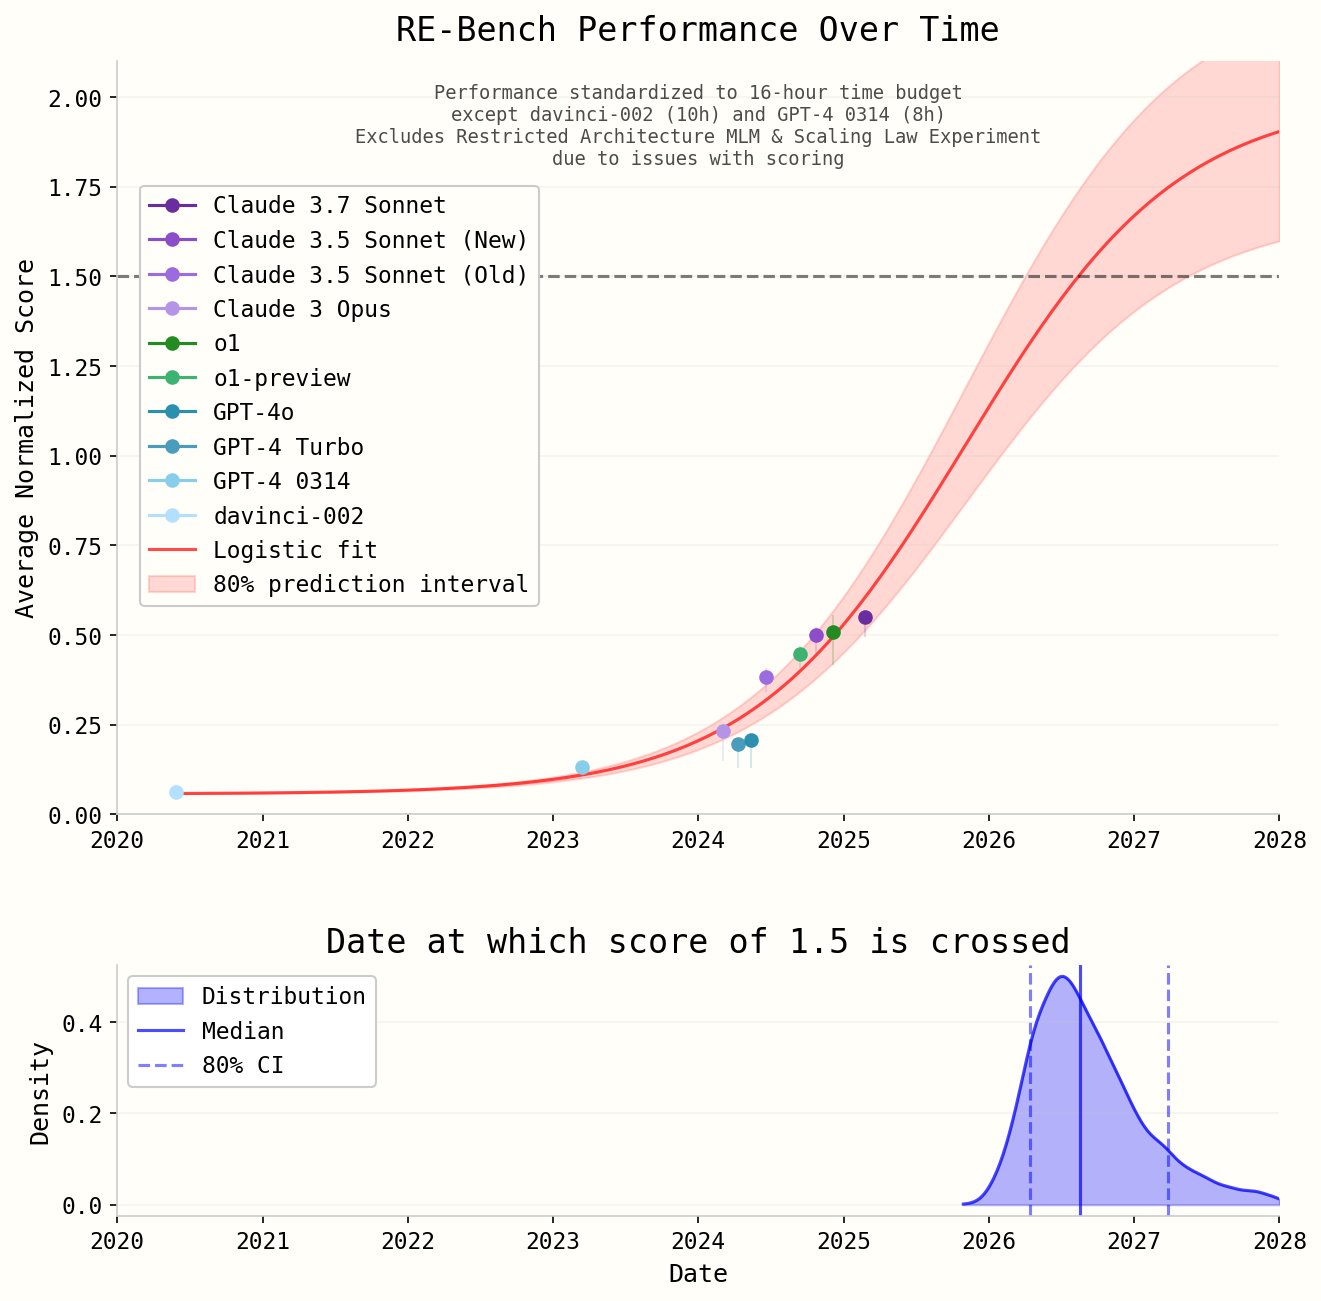
この80%信頼区間はスコアの上限についての不確実性から来るもので、私たちの認識状態を表すためのものではない。
この外挿では、飽和の時期は2026年のどこかと予測される。
RE-Benchのスコアが2027年に1に達すると予測しているこちらの論文も参照。その論文が用いたデータのせいで、予測が保守的すぎるものになった可能性が高いと私たちは考えている。
RE-Bench飽和の総合予測
| Eli、FutureSearch | 対数正規分布、80%信頼区間 [2025-09-01, 2031-01-01]。 |
|---|---|
| Nikola | 対数正規分布、80%信頼区間 [2025-08-01, 2026-11-01] |
ロジスティック曲線による予測は、進歩の速さをやや過大に見積もると予想している。2025年の第1四半期が過ぎても、METRからRE-Benchの新たなSOTAスコアが報告されていないという追加の情報が今はあるからだ。
飽和後のAIの進歩の加速
Nikolaの現時点での推測では、2022〜2024年のAIチャットボットやコーディング支援ツールを使うことで、AI研究者がそれらを使わなかった場合に比べて、アルゴリズムの進歩は3〜30%速くなっている。
Nikolaは、RE-Benchを飽和させられるエージェントは、生産性の面で2024年ごろのAIのおおよそ2倍役に立ち、ことによるとそれ以上だと予想している。Nikolaの最良の推測では、RE-Benchが初めて公に飽和した時点のアルゴリズムの進歩は、2024年より [5%, 60%] 速い。Nikolaは、2024年にはアルゴリズムの進歩がAIの進歩全体の50%を占めると仮定している。Eliもこれらの推定におおむね同意している。
RE-Benchの飽和時点でのAIの研究能力について、私たちの最良の推測は次のとおりだ。現実の8時間タスクをこなすにはかなりの監督を必要とするが、ときには数時間がかりのタスクを人間の介入をほとんど受けずにこなせるエージェントが存在するだろう。RE-Bench飽和水準のAIが数時間がかりのタスクをしばしばこなす状況を想像すると、多くのAI研究者にとって大幅な加速(たとえば生産性の50%向上。計算資源のボトルネックを考慮すると、アルゴリズムの進歩の15%の加速にあたるかもしれない)になることは十分ありうると思える。
2025年12月に追記:私たちの方法論では、進歩倍率を、2024年換算月(2024年のペースで測った進歩の月数)を軸として(現在の進歩倍率 - 1)と(SCの進歩倍率 - 1)の間で指数関数的に補間するつもりだった。たとえば現在の進歩倍率が1.1、SCの進歩倍率が8.5なら、SCまでの2024年換算月の中間点での進歩倍率は (1.1-1)*((8.5-1)/(1.1-1))^.5+1=1.87 となるはずだった。ところがコードにバグがあり、1を引いてから1を足すという処理が含まれていなかったため、この例では 1.1*(8.5/1.1)^.5=3.06 となっていた。つまり私たちは途中段階での加速の影響を過大に見積もっていた。これはモデルのSC中央値に約9か月の影響を与えた。
RE-Bench飽和からSCまでのギャップを越えるのにかかる時間
次に、RE-Benchが飽和してからSCに至るまでの時間を予測する。
まず、RE-Bench飽和とSCの間にある「タスク難易度」の主なギャップについて論じる。次に、これらのギャップを越えるのにどれだけかかるかを予測する方法論を説明する。そのうえで、タスク難易度のすべてのギャップをどれだけ速く越えられるかを予測する。
RE-Bench飽和とSCの間には、タスク難易度のどんなギャップがあるか
RE-Benchの論文は、RE-Benchを飽和させることと、実際のAI研究開発を行えることの間にあるギャップを、主に四つの種類に分けている。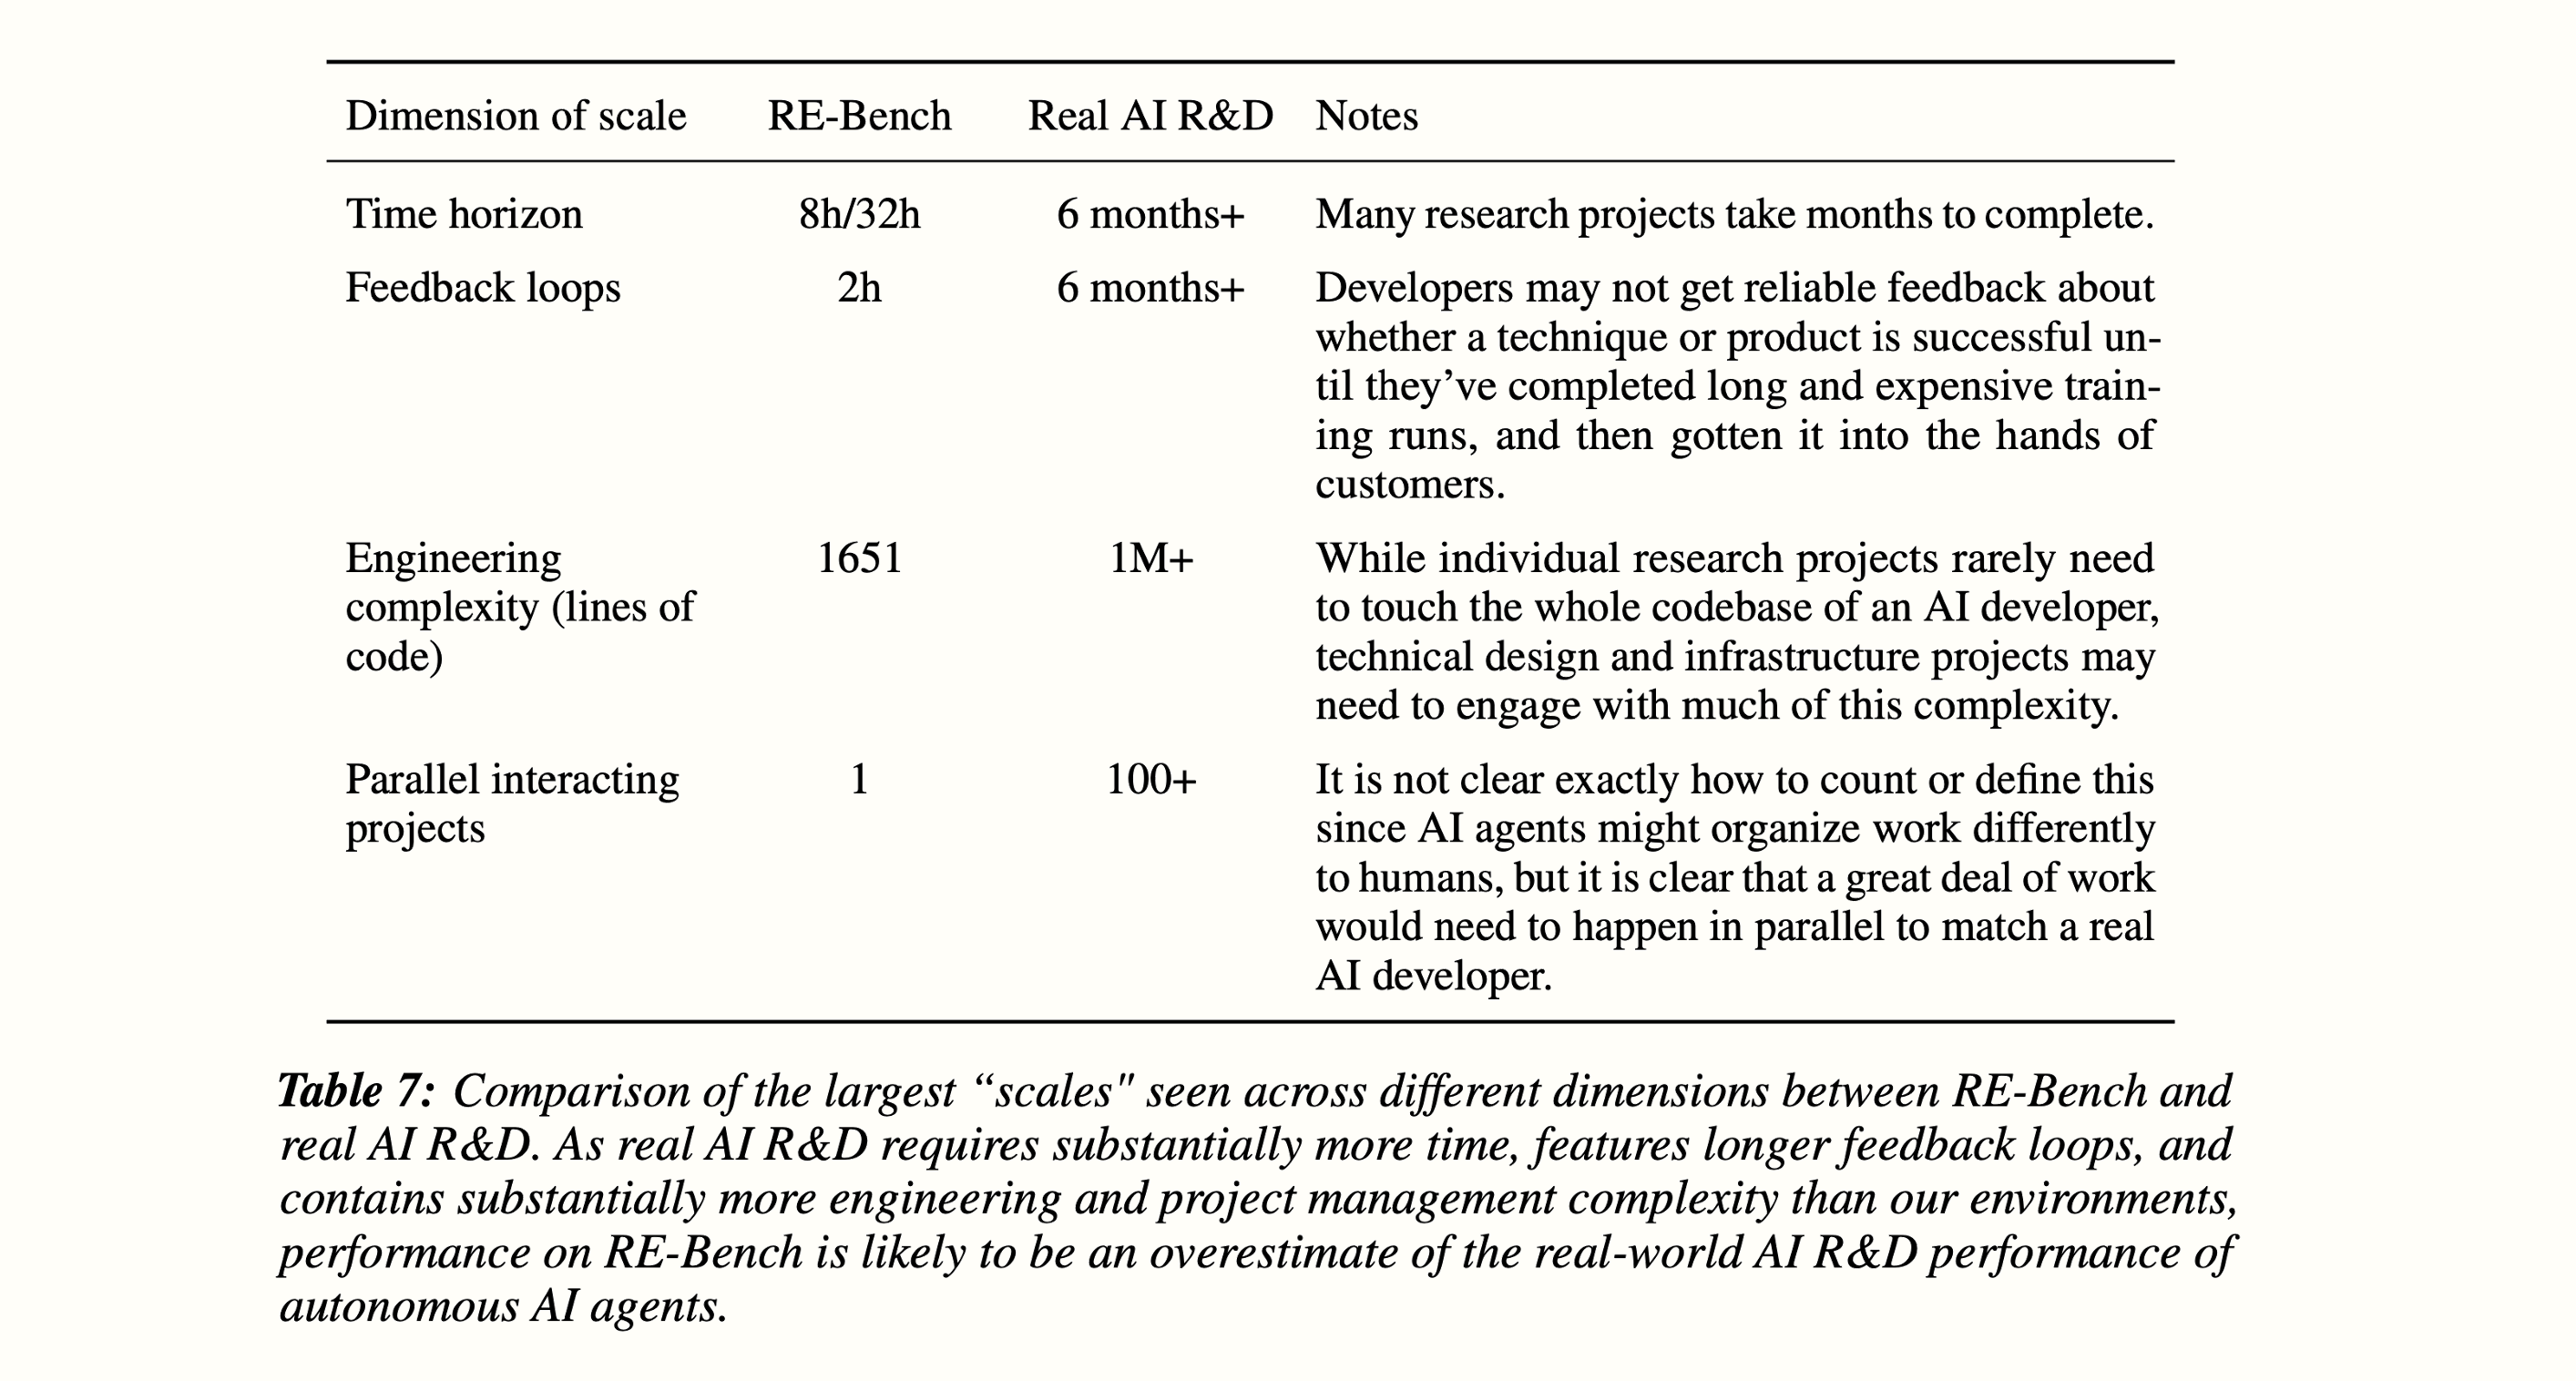
上の表にあるものに加えて、専門化と、コスト・速度のギャップを加える。RE-Benchのタスクは一般に、背景となる文脈をあまり必要としない。大きなコードベースへの習熟も必要ない。
方法論
要約すると、タスク難易度の各ギャップを越えたことを示すマイルストーンを、順に厳密に難しくなり、したがって順番に越えなければならないように定義する。そのうえで各マイルストーン間の月数を見積もり、それを合計する。
手順は次のとおり。
RE-Benchの飽和(これが最初の「マイルストーン」)より後の各ギャップについて、次のことを行う。
そのギャップを越えたことを示すマイルストーンを定義する。マイルストーンは直前のものより厳密に難しくし、ギャップ間の時間が必ず正になるようにする。マイルストーンは「上と同じだが…[ギャップを越えている。たとえば上のすべてのタスクを30倍速く安くこなせる]」という形をとり、この要約表で確認できる。
タイムホライズン以外のタスク難易度のギャップは、一度越えたら、以降のすべてのマイルストーンで同じ水準にとどまる。タイムホライズンという特性だけは自由に増えてよいものとする。タイムホライズンは難しさの汎用的な尺度なので、タスクのある特性が難しくなる間、一定に保つことはできないからだ。
2024年のAIの進歩ペースで、そのギャップを越えるのに必要な月数を見積もる。タイムホライズンの伸びとコスト・速度の改善については、ほかの種類よりもよいデータがあるので、ほかの種類の見積もりはずっと厳密さに欠ける。
タスク難易度のすべてのギャップを合計して、タスク難易度のギャップ全体の大きさを求める。単位は、2024年のAIの進歩ペースでの進歩の月数である。
AIの進歩の途中段階での加速を組み込んで、タスク難易度のすべてのギャップを越えるまでの時間を求める。そのうえで、ほかに起こりうる減速(たとえば導入の遅れ)を加え、社内展開と外部展開のギャップを考慮する。
これらのギャップはすべて(ここで説明するように、さらに細かくモデル化するタイムホライズンのギャップを除く)、80%信頼区間に合わせた対数正規分布としてモデル化する。したがって中央値は常に下限と上限の幾何平均になる。それぞれの能力を達成する難しさには相関がある可能性が高いので、サンプルは正の相関をもたせて抽出する。
タスク難易度のギャップはどれだけ速く越えられるか
要約表
ギャップを越える時間についての私たちの予測を以下にまとめる。下の表のFutureSearchは、FutureSearchのプロの予測者2名の集計を指す。各ギャップについての予測者ごとの詳しい根拠は付録にある。
| ギャップの名称 | ギャップを越えたことを示すマイルストーン | ギャップの大きさの予測(中央値と80%信頼区間) | 根拠の要約 |
|---|---|---|---|
| タイムホライズン:人間には長い時間がかかるタスクをこなす。 | AI研究開発の過程で必要になる多種多様なソフトウェアプロジェクトを開発できる能力。プロジェクトは、合計最大20,000行のファイルにまたがって最大10,000行のコードを変更するものとする。明確な指示、単体テスト、その他の正解にもとづくフィードバックが与えられる。これを、人間なら約1か月かかるタスク(「初期タイムホライズン」パラメータで制御)について、80%の信頼度で、人間と同じコストと速度でこなす。 | Eli: 18 [2, 144] Nikola: 16 [1, 125](シミュレーションで求めた値なので対数正規分布ではない。詳しくは後述) FutureSearch: 12.7 [1.7, 48] | 必要なホライズンの長さと倍加時間から計算。 |
| エンジニアリングの複雑さ:複雑なコードベースを扱う | AI研究開発の過程で必要になる多種多様なソフトウェアプロジェクトを開発できる能力。プロジェクトは、合計500,000行超のファイルにまたがって20,000行超のコードを変更するものとする。明確な指示、単体テスト、その他の正解にもとづくフィードバックが与えられる。これを、人間なら約1か月かかるタスク(「初期タイムホライズン」パラメータで制御)について、80%の信頼度で、人間と同じコストと速度でこなす。 | Eli: 3 [0.5, 18] Nikola: 3 [0.5, 18] FutureSearch: 11 [2.4, 33.9] | METRのタイムホライズン・タスク群での性能の傾向から推定。 |
| フィードバック・ループ:外部からフィードバックを与えられずに作業する | 上と同じだが、単体テストは与えられず、プロジェクトが何を達成すべきかについて漠然とした大まかな説明しかない。 | Eli: 6 [0.8, 45] Nikola: 3 [0.5, 18] FutureSearch: 18.3 [1.7, 58] | RE-BenchからBest-of-Kサンプリングを除くと性能がどれだけ下がるかを見て推定。 |
| 並行プロジェクト:互いに関係する複数のプロジェクトを扱う | 上と同じだが、互いに連携する複数のコードベースにまたがる別々のプロジェクトに取り組む(たとえば大規模な訓練パイプライン、実験パイプライン、データ分析パイプライン)。 | Eli: 1.4 [0.5, 4] Nikola: 1.2 [0.5, 3] FutureSearch: 2 [0.7, 5.3] | エンジニアリングの複雑さおよびタイムホライズンのギャップと重なるため、非常に小さいと推定。 |
| 専門化:フロンティアAI開発に特有のスキルに特化する | 上と同じだが、AGI企業の社内で実際に進められているプロジェクトそのものに取り組む。 | Eli: 1.7 [0.5, 6] Nikola: 0.4 [0.1, 2] FutureSearch: 2.4 [0.5, 4.7] | 特定の用途向けのファインチューニングは通常それほど時間がかからず、RE-Benchのタスクと現実のコーディングの重なりも大きいことから推定。 |
| コストと速度 | 上と同じだが、人間のエンジニアよりも超人的なAIエージェントのほうがかなり多くなるようなコストと速度でこなす(具体的には、人間の30倍の数のエージェントが、それぞれ30倍の速さでタスクをこなす)。 | Eli: 6.9 [1, 48] Nikola: 6 [1, 36] FutureSearch: 13.5 [4.5, 36] | AIの能力が時とともに安くなってきたデータから推定。 |
| その他のタスク難易度のギャップ | SCを達成。 | Eli: 5.5か月 [1, 30] Nikola: 3か月 [0.5, 18] FutureSearch: 14.7 [2, 58.8] | 未知の未知を考慮 |
タイムホライズン
ギャップを越えたことを示すマイルストーン: AI研究開発の過程で必要になる多種多様なソフトウェアプロジェクトを開発できる能力。プロジェクトは、合計最大20,000行のファイルにまたがって最大10,000行のコードを変更するものとする。明確な指示、単体テスト、その他の正解にもとづくフィードバックが与えられる。これを、人間なら約1か月かかるタスク(「初期タイムホライズン」パラメータで制御)について、80%の信頼度で、人間と同じコストと速度でこなす。
タイムホライズンの報告書と定義
METRの最近の報告書は、AIシステムの「タイムホライズン」という能力を測定している。タイムホライズンは、人間がタスクを完了するのにかかる時間にもとづいて定義される(詳細は脚注)。
AIのR%タイムホライズンがTであるとは、人間ならT時間かかるタスクで平均R%の成功率を達成するという意味である。METRの方法論とタスク群HCASTの詳細は前述を参照。2025年12月に追記:ベンチマーク・ギャップ法のタイムホライズンの定義は、人間が一流の専門家水準であることを前提としているが、タイムホライズン延長法の定義はそうではない。これは、AIがRE-Benchで一流の専門家に並んだ時点を出発点としているためである。この点でわかりにくさがあったことをお詫びする。
超人的コーダー(SC):初期タイムホライズンと信頼度の要件
超人的コーダー(SC)は、速度とコストを別にすれば(これらは後で考慮する)、AGI企業のすべての人間プログラマーを合わせたのと全体として同じくらい良い仕事を、彼らの現在の業務でこなせなければならない。
これにはどれだけのタイムホライズンと信頼度が必要か。今後のギャップを越えるにつれてタイムホライズンは伸び続けるので、SCに最終的に必要だと考えるタイムホライズンよりいくらか低い「初期タイムホライズン」を選ぶことにする。
必要な初期タイムホライズン:1か月。難しいコーディングプロジェクトに必要な時間の下限として、これがおおよそ妥当に思える。ここにはある程度の不確実性を、80%信頼区間 [4時間, 6労働月(1000時間)] の対数正規分布で取り入れる。今後ギャップを越えていくことで、タイムホライズンは約6か月まで伸びると大まかに推測している。非常に難しいコーディングプロジェクトを表すものとして、これは妥当に思える。
必要な信頼度:80%。ただし不確実性は高い。SCが人間の研究者集団と同じくらい能力に偏りがないなら、脚注に挙げるいくつかの理由から、これは50%をいくらか下回るだろう。しかし現在のAIは人間よりはるかに能力の偏りが大きい。そのため、人間並みのコスト・速度の範囲で、あるタイムホライズンを信頼度40%で達成できるとしても、10倍の時間をかけてよいことにした場合、信頼度はおそらく45〜50%程度までしか上がらない。したがって現在のAIについては、信頼度の閾値を90%以上に設定する必要があるかもしれない。しかしSC水準のAIは、非常に強いエージェント能力(計画立案、誤りの修正など)を持つため、はるかに偏りが小さくなるだろう。そこで閾値を80%に下げる。これはおおよそ妥当に思えるうえ、METRが報告したデータを利用できるという利点もある。簡単にするため、また信頼度の調整はタイムホライズンの調整としてもモデル化できるため、この不確実性はモデルに組み込んでいない。
タイムホライズンの外挿に伴うエンジニアリングの複雑さ
タスクのエンジニアリングの複雑さを、二つの代理指標で測る。(a)変更したコードの行数と、(b)変更したすべてのファイルに含まれるコード行数の合計である。
RE-Benchを飽和させるには、変更するファイルのコード行数が中央値で500行、変更するコードが約250行必要になる。METRのタイムホライズン・タスク群にあるほかの8時間タスクも、同程度の量を必要とする。
ごく大まかなデータ分析にもとづき、METRのタスク群ではタイムホライズンが伸びると、それに比例して両方の代理指標も増えると見積もる。8時間から1か月では20倍になるので、変更するコードは約10,000行、変更したすべてのファイルのコードは20,000行まで増えることになる。
変更する行数と、変更したすべてのファイルの行数との倍率が小さいのは、RE-BenchとMETRのタスク群が、大きなコードベースへの習熟も含めて、必要な文脈の少ないタスクに重点を置いていることを反映している。
RE-Benchの飽和:タイムホライズンと信頼度の水準
前述のとおり、RE-Benchの飽和は平均1.5の達成にもとづいて設定する。これは、各タスクに8時間を与えられた場合に最優秀の人間が取れるだろうと私たちが考える水準にほぼあたる。
このスコアの達成は、最優秀の人間と比べて、8時間のタイムホライズンでの信頼度でいえばどういう意味になるか。
私は、50%より高いことを意味すると考える。前述のとおり、現在のAIのスキルは人間より偏っている。RE-Benchのタスクでは1.5を上回る余地のほうが下回る余地より小さいので、平均が同じになるには、AIはおそらくタスクの50%超で最上位の人間を上回らなければならないだろう。
この効果は無視できないが、極端に大きくはないように思える。私の最良の推測は信頼度60%だ。
タイムホライズンの予測
| 推定値(対数正規分布の80%信頼区間) | 根拠 | |
|---|---|---|
| 初期マイルストーンに必要な80%タイムホライズン | Eli: [8時間, 6労働月(1000時間)] Nikola: [8時間, 6労働月(1000時間)] | 今後のギャップを越えるにつれてタイムホライズンは伸び続けるので、SCに最終的に必要だと考えるタイムホライズンよりいくらか低い「初期タイムホライズン」を選ぶ。難しいコーディングプロジェクトの下限としては、中央値でおおよそ2〜4週間が妥当に思える。詳しくは前述を参照。 |
| RE-Bench飽和時点での80%タイムホライズン | Eli: [0.5, 15]時間 Nikola: [0.5, 12]時間 | 8時間より短い可能性が高い理由は前述を参照。私の最良の推測では、RE-Benchを飽和させるエージェントの8時間での信頼度は60%だ。METRの報告書は、50%から80%に切り替えるとタイムホライズンが5分の1になるとしている。そこで60%から80%への切り替えではおそらく約3.5分の1になり、私の中央値は約2.5時間となる。 |
| 2025年3月時点のHCASTでのタイムホライズン倍加時間 (2025年12月に追記:長期的な傾向として延長したもの) | [2.5か月, 9か月] | 根拠は方法1を参照。 |
| RE-Bench飽和時点での、タイムホライズン・マイルストーンへ向けた倍加時間。HCASTに似ているが、RE-Benchのタスク分布だけから始まる仮想的なタスク群で測ったもの | [0.5か月, 18か月] | 以下の三つの調整を直観的に総合して推定値を得た。傾向の変化の可能性を踏まえ、下方に、また不確実性を大きく調整:傾向が超指数関数的なら、RE-Benchが飽和するころには倍加時間は現在より短くなっている。亜指数関数的ならその逆だが、そちらの可能性は低い(根拠は後述)。通常のHCASTから、RE-Benchだけから始まるHCASTへの分布の変化を踏まえ、不確実性を大きく調整: 出発点のタスク分布についての不確実性を踏まえて、信頼区間を広げる。METRの外挿にはすでにRE-Benchが含まれているが、HCAST全体に比べればごく少数のタスクにすぎない。外挿がマイルストーンを行き過ぎることによる下方調整: 私たちの推測では、METRのタスク群での外挿は「行き過ぎ」てしまい、AIが必要なタイムホライズンに達するころには、いくつかの面で私たちのタイムホライズン・マイルストーンを超えてしまう。したがって、METRのタスク群での倍加時間から、外挿がちょうど上で定義したタイムホライズン・マイルストーンに行き着くような理論上のタスク群での倍加時間へと移すために、下方に調整すべきである。大まかな外挿をいくつか行ったところ、HCASTの外挿は実際に、マイルストーンで定義したとおり約10,000行のコードに行き着くことがわかった。しかし素朴な外挿は、フィードバック・ループの難しさについて、さらにおそらくはほかの変数についても、マイルストーンを「行き過ぎる」だろうと私たちは推測している。 |
| 倍加時間は短くなるか、長くなるか、変わらないか (2025年12月に追記:AI研究開発の自動化を考慮に入れる前の話) | 確率: 指数関数的:Eli: 0.45 Nikola: 0.5 超指数関数的:Eli: 0.45 Nikola: 0.4 亜指数関数的:Eli: 0.1 Nikola: 0.1 | 根拠は方法1を参照。 |
倍加時間と必要な水準から、タイムホライズンのギャップの大きさについて次の分布が得られる。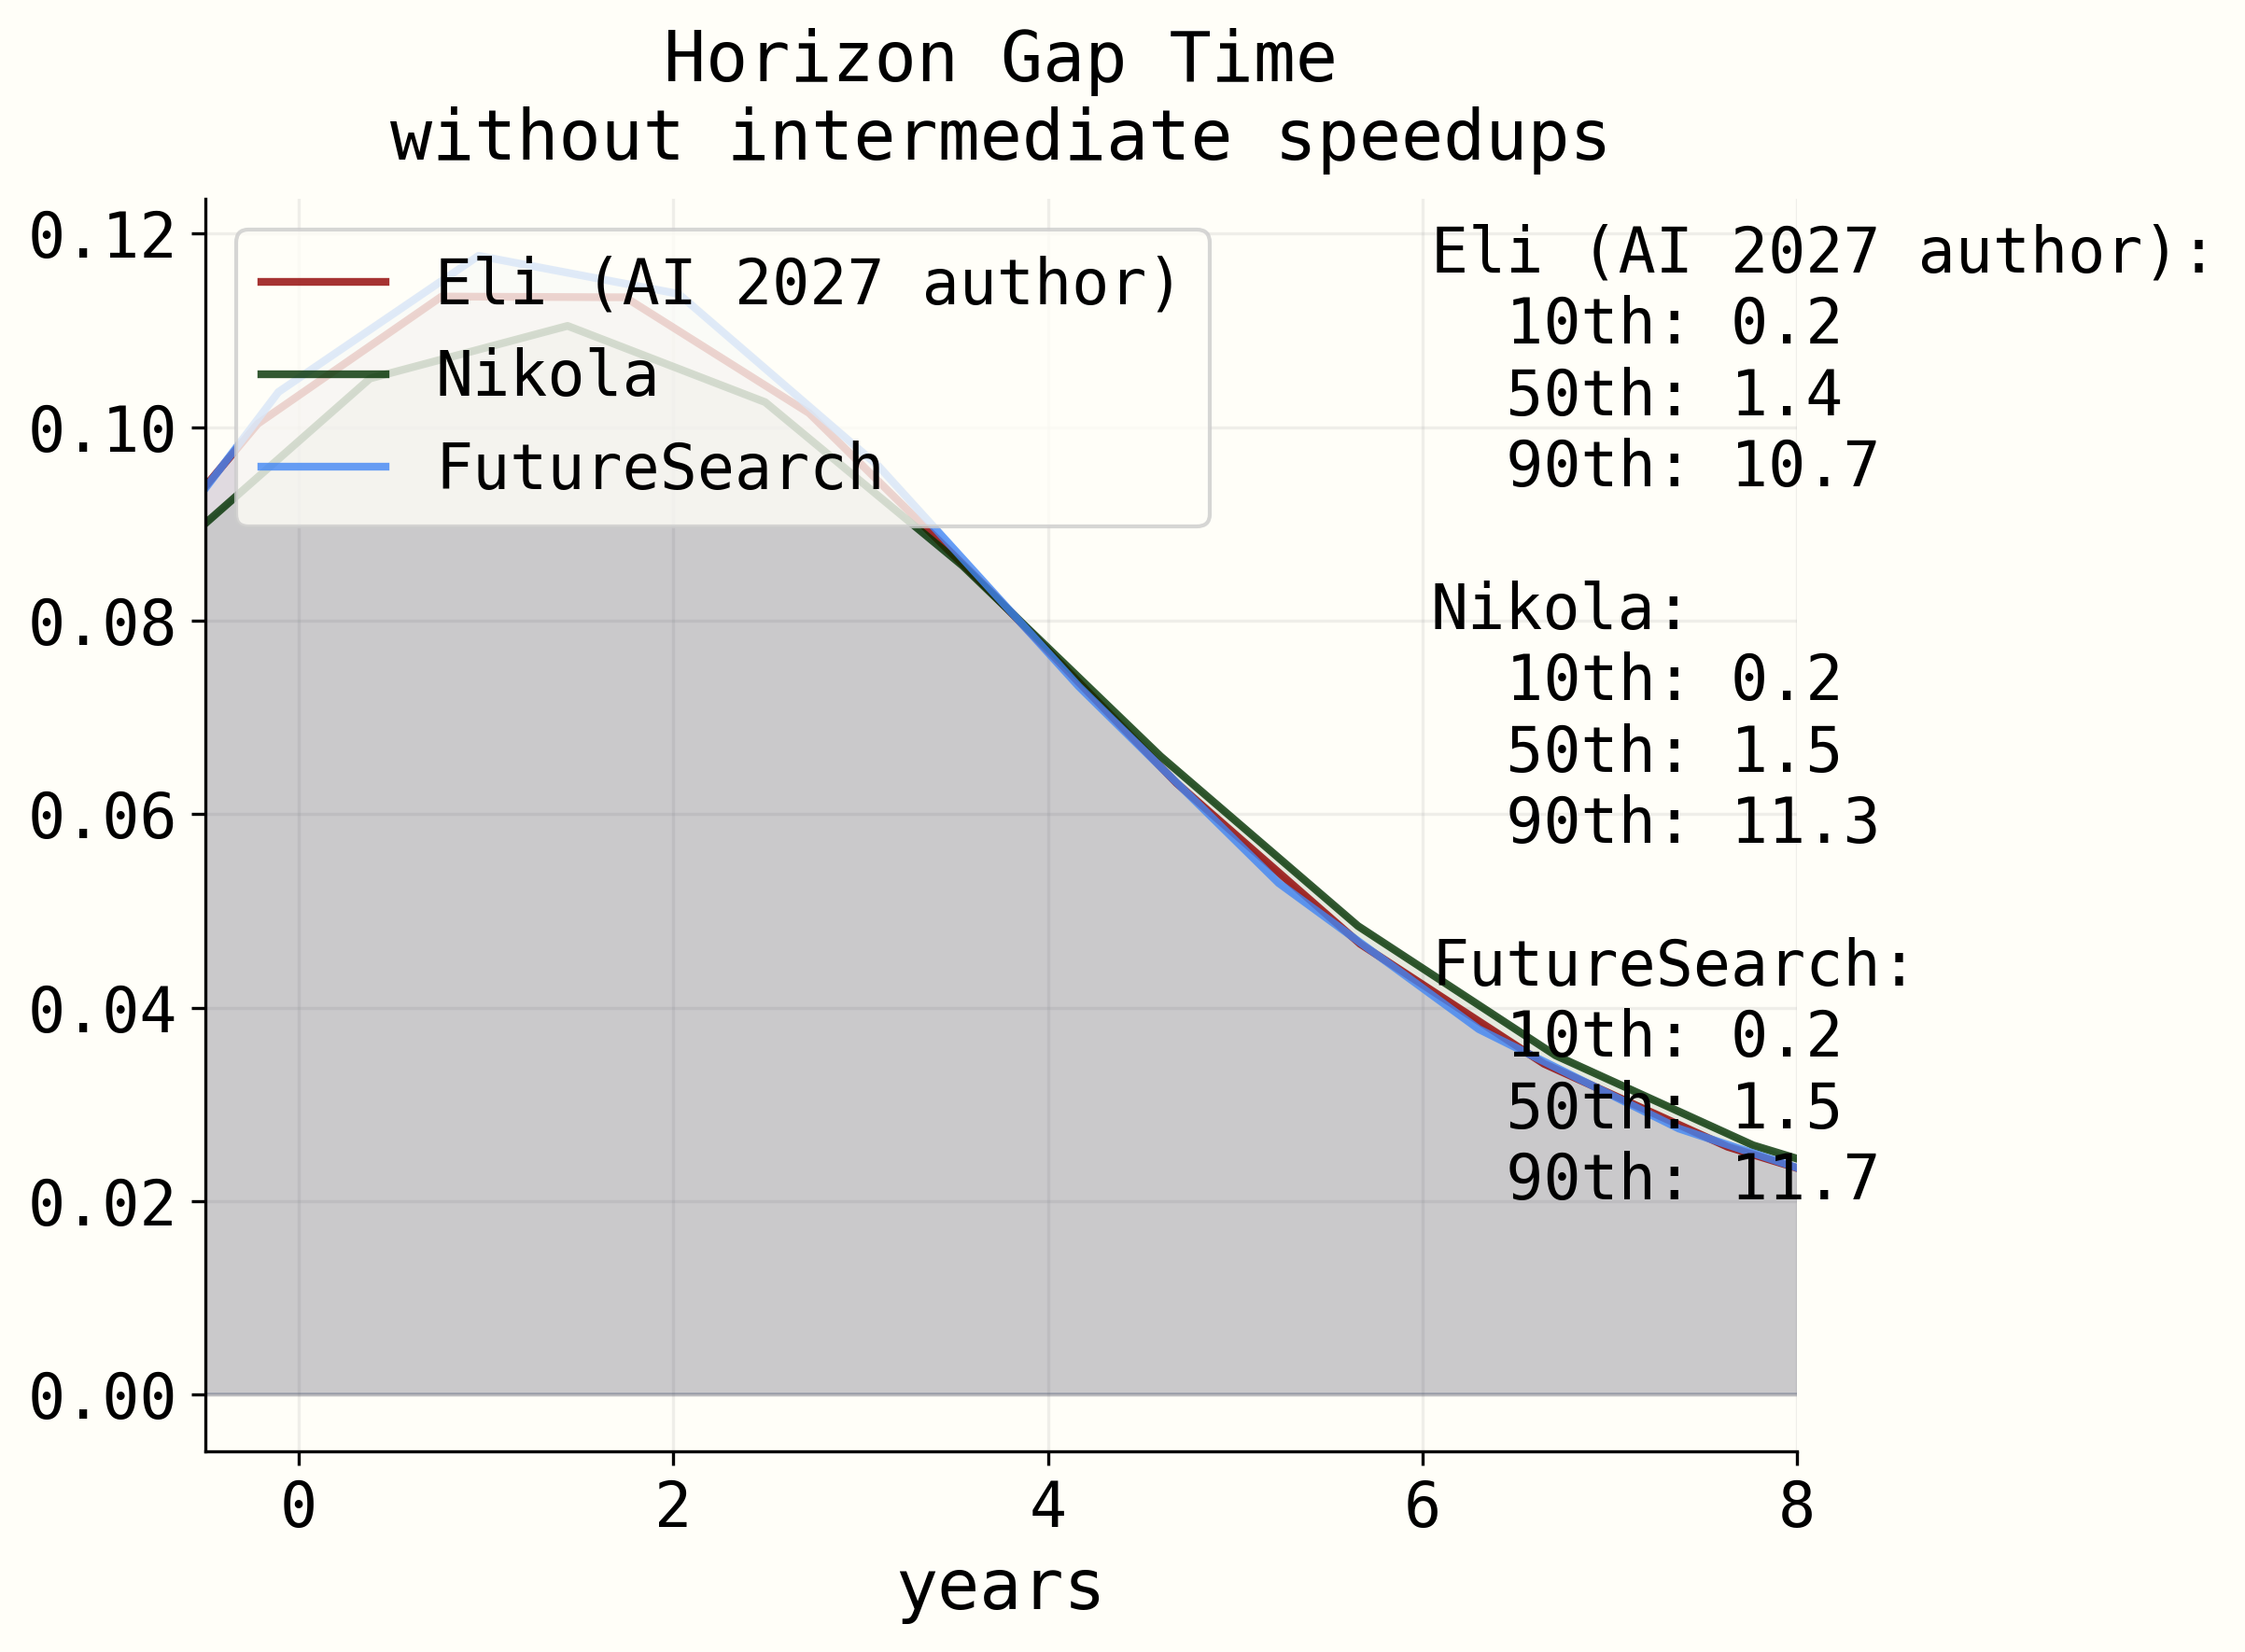 ai-2027.com
ベンチマーク・ギャップ法のその他の要因
大規模な破局(太陽フレア、パンデミック、核戦争など)が起きず、政府による減速や自主的な減速もないことを前提とする。
計算資源の拡大とアルゴリズムの進歩の減速
SCが達成されないままでは、フロンティアAIの訓練コストの増加率を2029年以降も維持するのは難しいかもしれない。そこで、投資を増やす余力が落ちることにより、2029年から計算資源の拡大ペースが半分に落ちると仮定する。
同様に、2028年ごろまでにSCが達成されなければ、人間の研究者人口の伸びが鈍り始めると見込む。簡単にするため、これも人間が生み出す進歩のペースが時間とともに半分に落ちるものとしてモデル化する。AIによる自動化との補完性をモデル化するため、AIが人間のペースに一定の倍率をかける場合の進歩のペース(つまり default_human_plus_ai_rate*0.5)と、AIが完全に加算的に寄与する場合の進歩のペース(つまり default_human_plus_ai_rate-0.5)の幾何平均をとる。
社内展開と外部展開のギャップ
上のモデルの予測と外挿は公開済みのモデルのテストにもとづいているので、AGI開発企業の社内でSCの能力が実現する時期を得るには、予測から差し引く必要がある。
SCが登場する時点で、AGI開発企業の社内の能力は公開版より先行しており、その差はおおよそ80%信頼区間 [0.25か月, 6か月] の対数正規分布に従うと見積もる。これをSC達成までの時間から差し引いて、社内でSCが達成される時期を求める。
途中段階での加速
私たちのシミュレーションでは、アルゴリズムの進歩の速さは2025年に1から始まり、RE-Bench飽和時点では2024年の速さより [5%, 60%] 速くなる。
下の表は、SCがアルゴリズムの進歩をどれだけ加速するか、つまりAI研究開発の進歩倍率(より詳しい定義はこちら)についてのEliとNikolaの推定値を示す。これらは、テイクオフ予測でのSCの進歩倍率の推定値を踏まえたものだ。
| 量 | Nikolaの推定値 | Eliの推定値 |
|---|---|---|
| SCによるAI研究開発の進歩倍率(中央値と、対数正規分布の80%信頼区間) | 5.5 [2.0, 20.0] | 8.5 [2.5, 40.0] |
2024年には、AIの進歩の半分をアルゴリズムの進歩が、残り半分を計算資源が占めると仮定する。SCのマイルストーンの後、進歩は非常に速くなるかもしれない。SC以降の能力の推移についての予測はテイクオフ予測を参照。
シミュレーションでは次のようにする。
2024年のAIの進歩ペースで、タスク難易度のすべてのギャップを埋めるのに必要な月数を求める。
次に、合計「2024年換算月」分の進歩を順にたどり、全工程のどれだけが完了したかに応じてAIの進歩の速さを上げていく(ごく一部の軌道では、AIの進歩の速さは時間とともに下がる)。進歩の速さは、タスク難易度のギャップ全体のうちどれだけを越えたかの関数として、出発時の速さから終了時の速さへと指数関数的に上がる。2025年12月に追記:私たちの方法論では、進歩倍率を、2024年換算月を軸として(現在の進歩倍率 - 1)と(SCの進歩倍率 - 1)の間で指数関数的に補間するつもりだった。たとえば現在の進歩倍率が1.1、SCの進歩倍率が8.5なら、SCまでの2024年換算月の中間点での進歩倍率は (1.1-1)*((8.5-1)/(1.1-1))^.5+1=1.87 となるはずだった。ところがコードにバグがあり、1を引いてから1を足すという処理が含まれていなかったため、この例では 1.1*(8.5/1.1)^.5=3.06 となっていた。つまり私たちは途中段階での加速の影響を過大に見積もっていた。これはモデルのSC中央値に約9か月の影響を与えた。
ベンチマーク・ギャップ法の総合予測
ここまで示したパラメータでシミュレーションを実行すると、次の結果になる。
ai-2027.com
入力した分布は次のとおり。
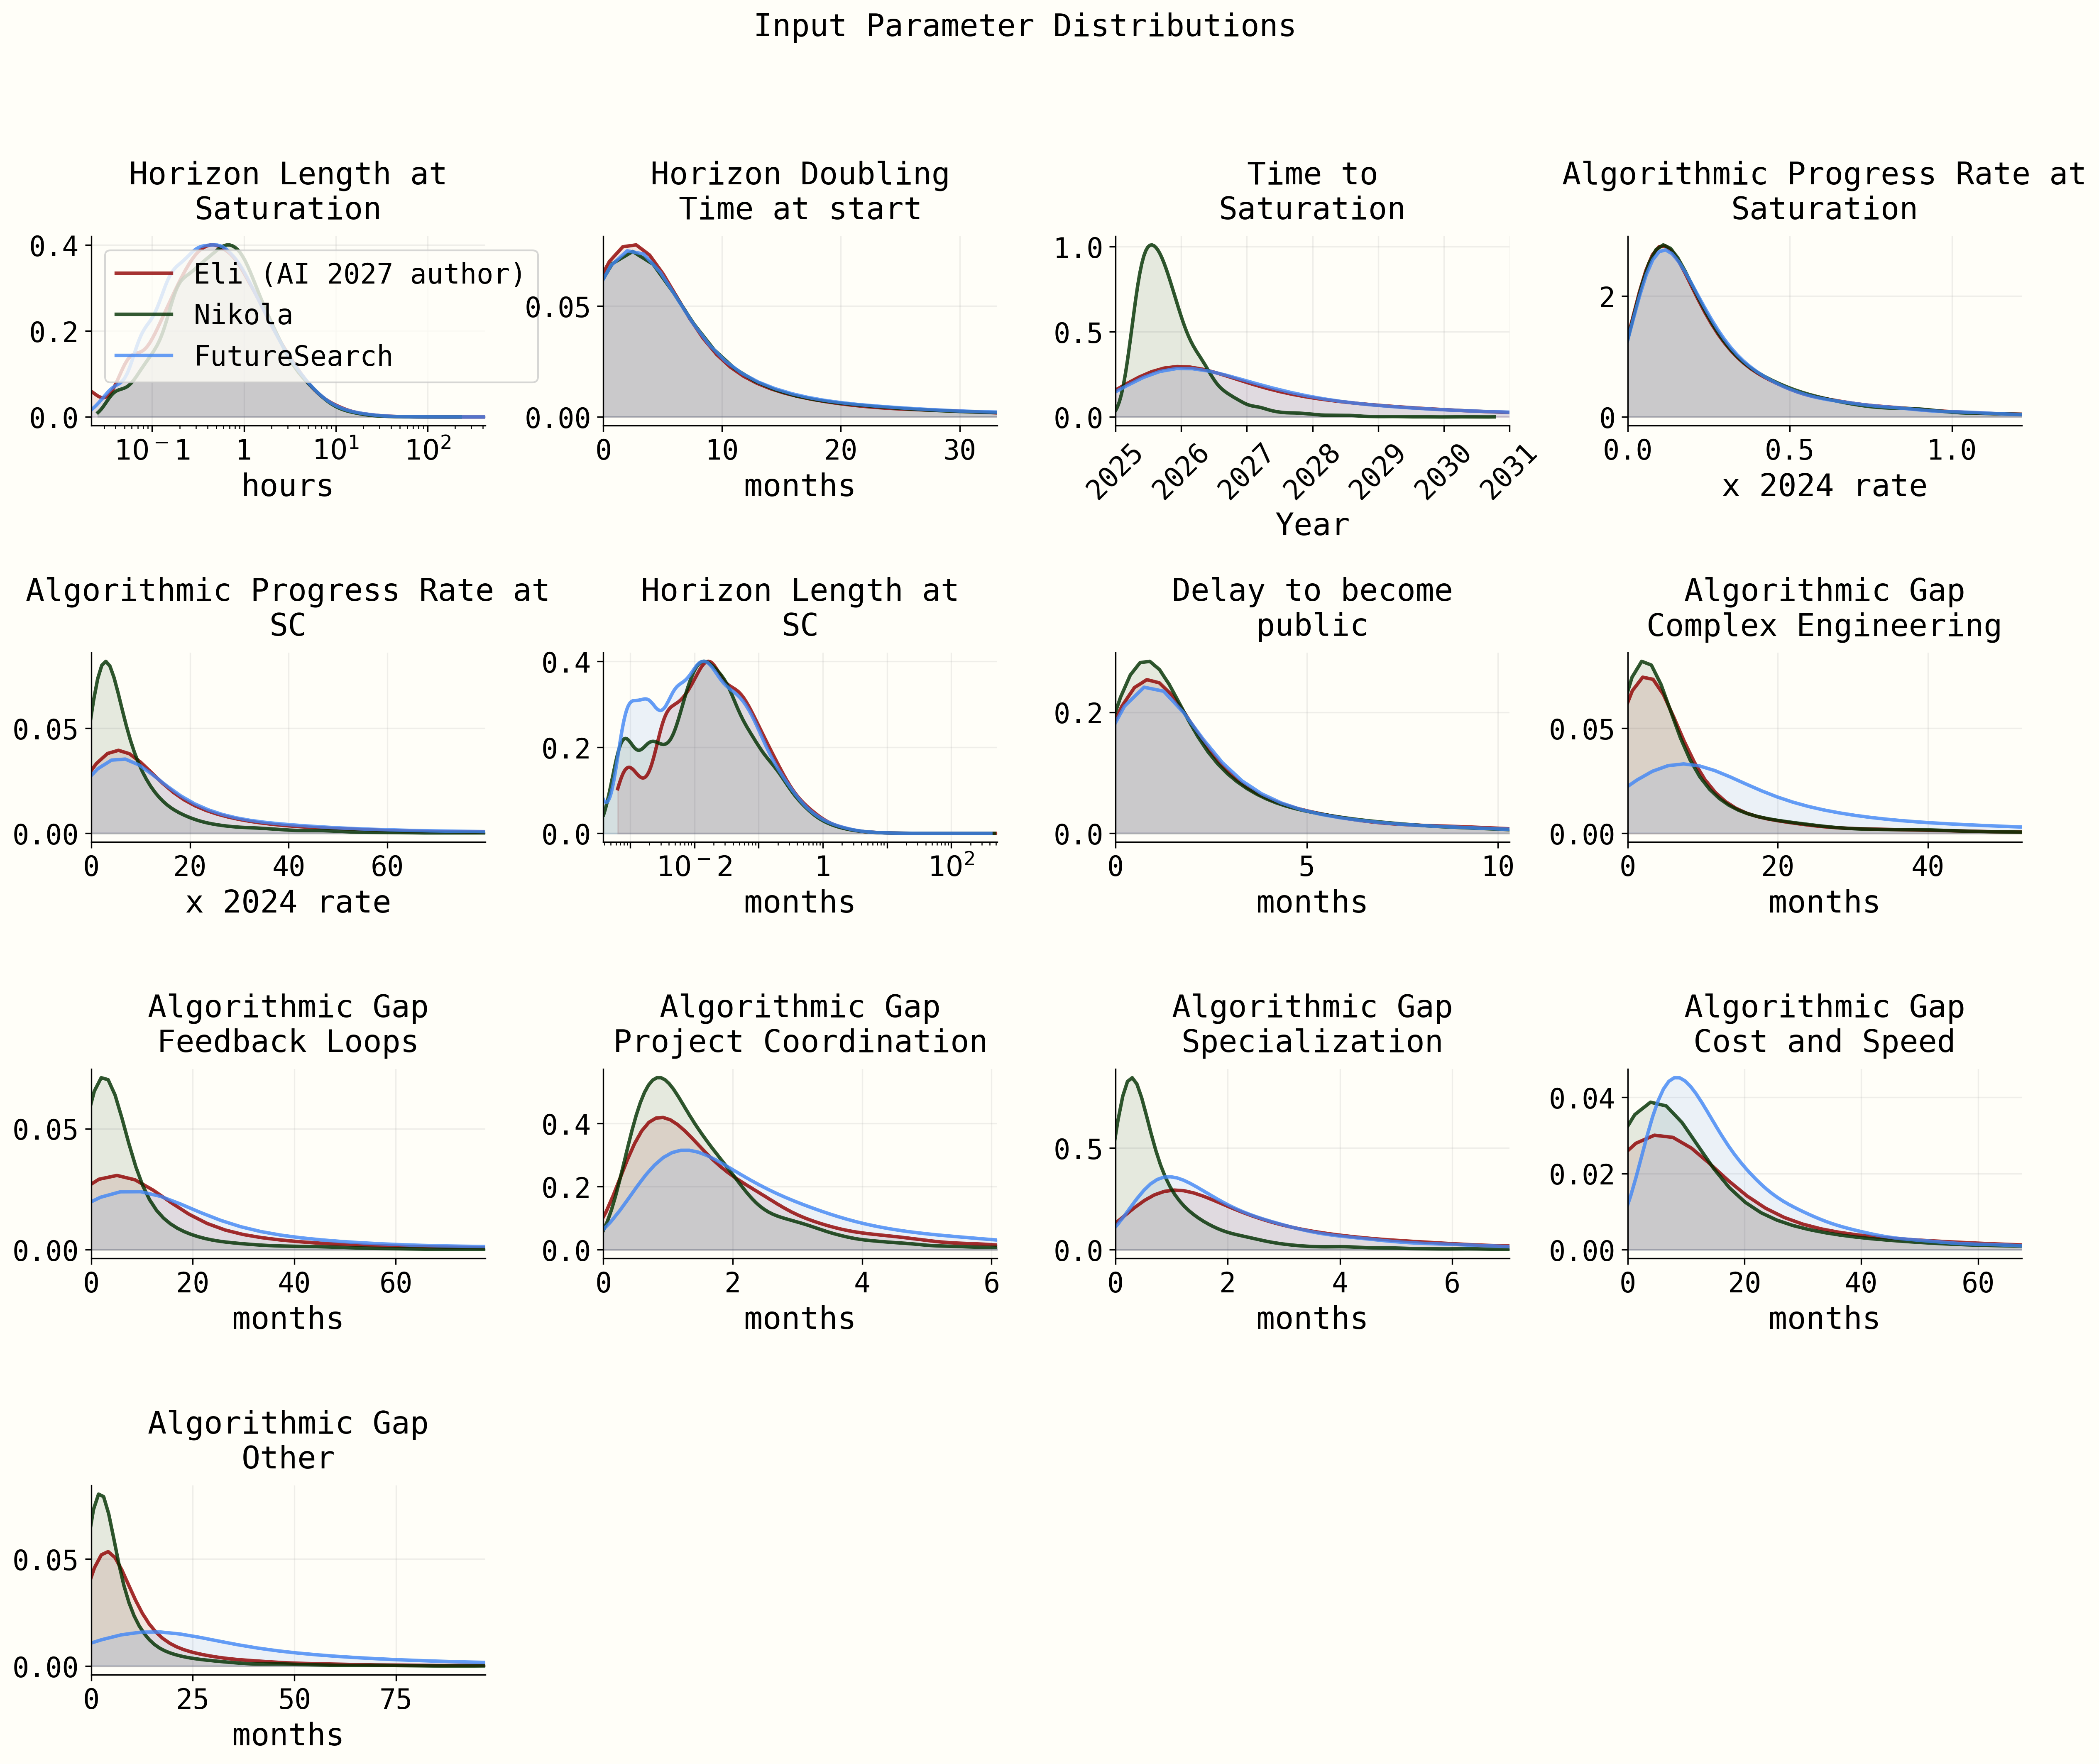 ai-2027.com
付録
2025年5月7日の更新
この節はEli Liflandが書いたもので、共著者が必ずしも賛同しているわけではない。
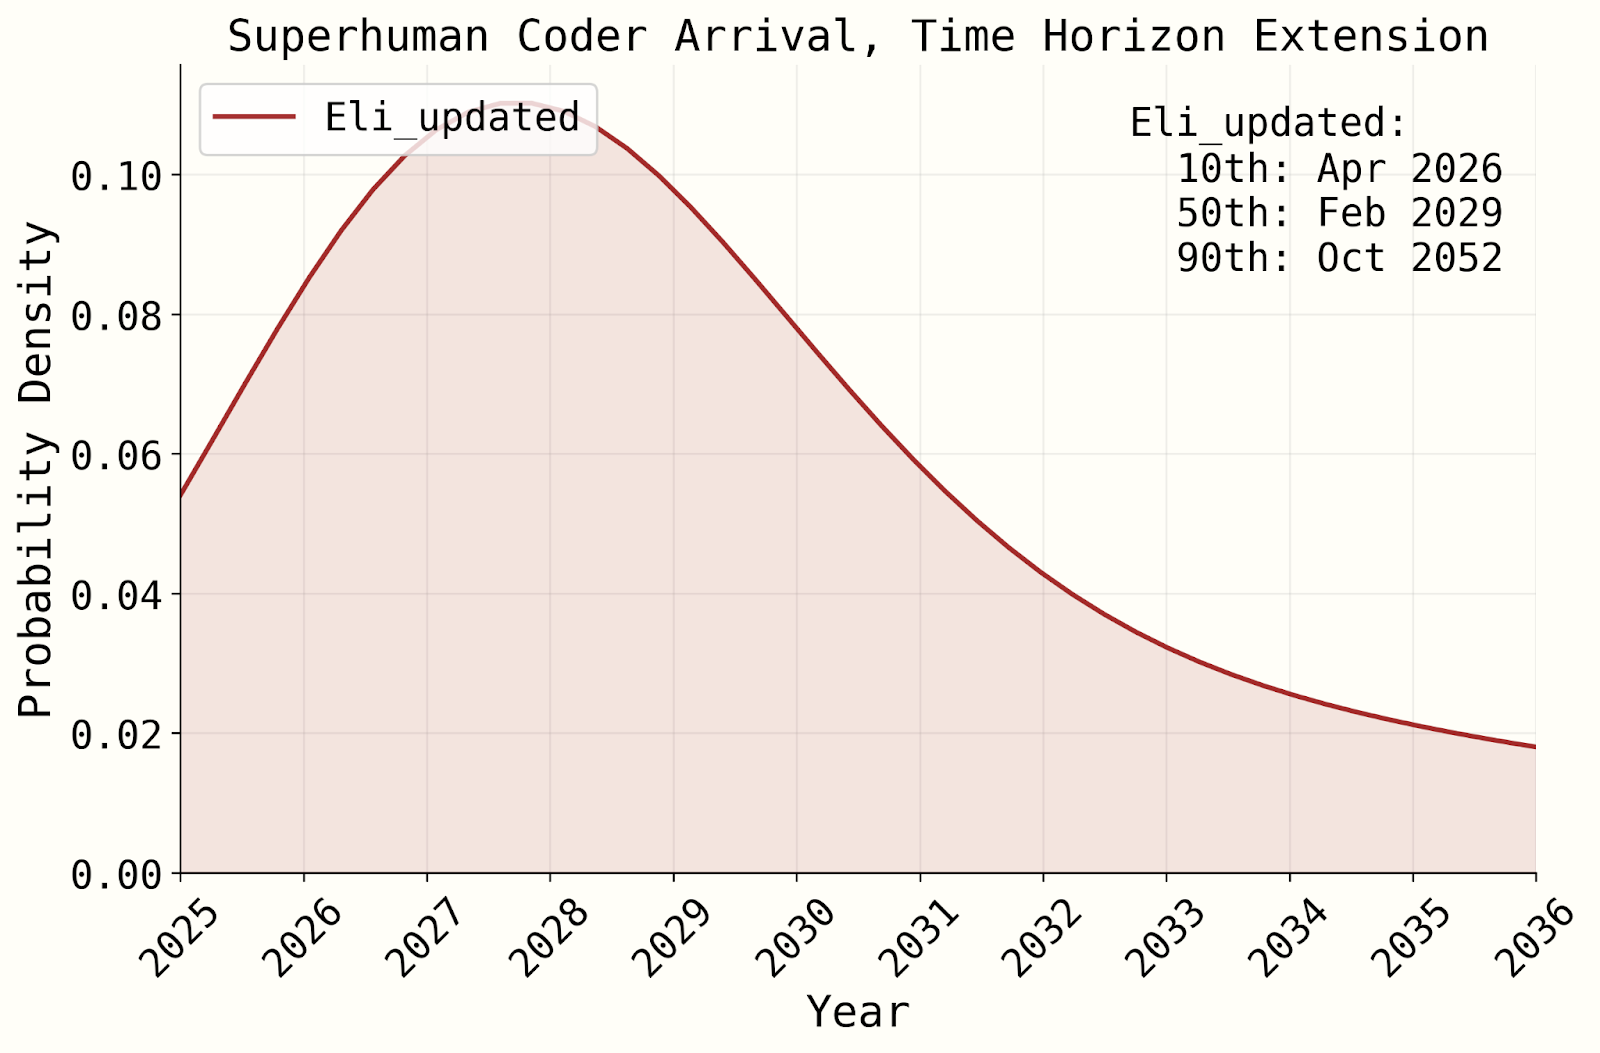
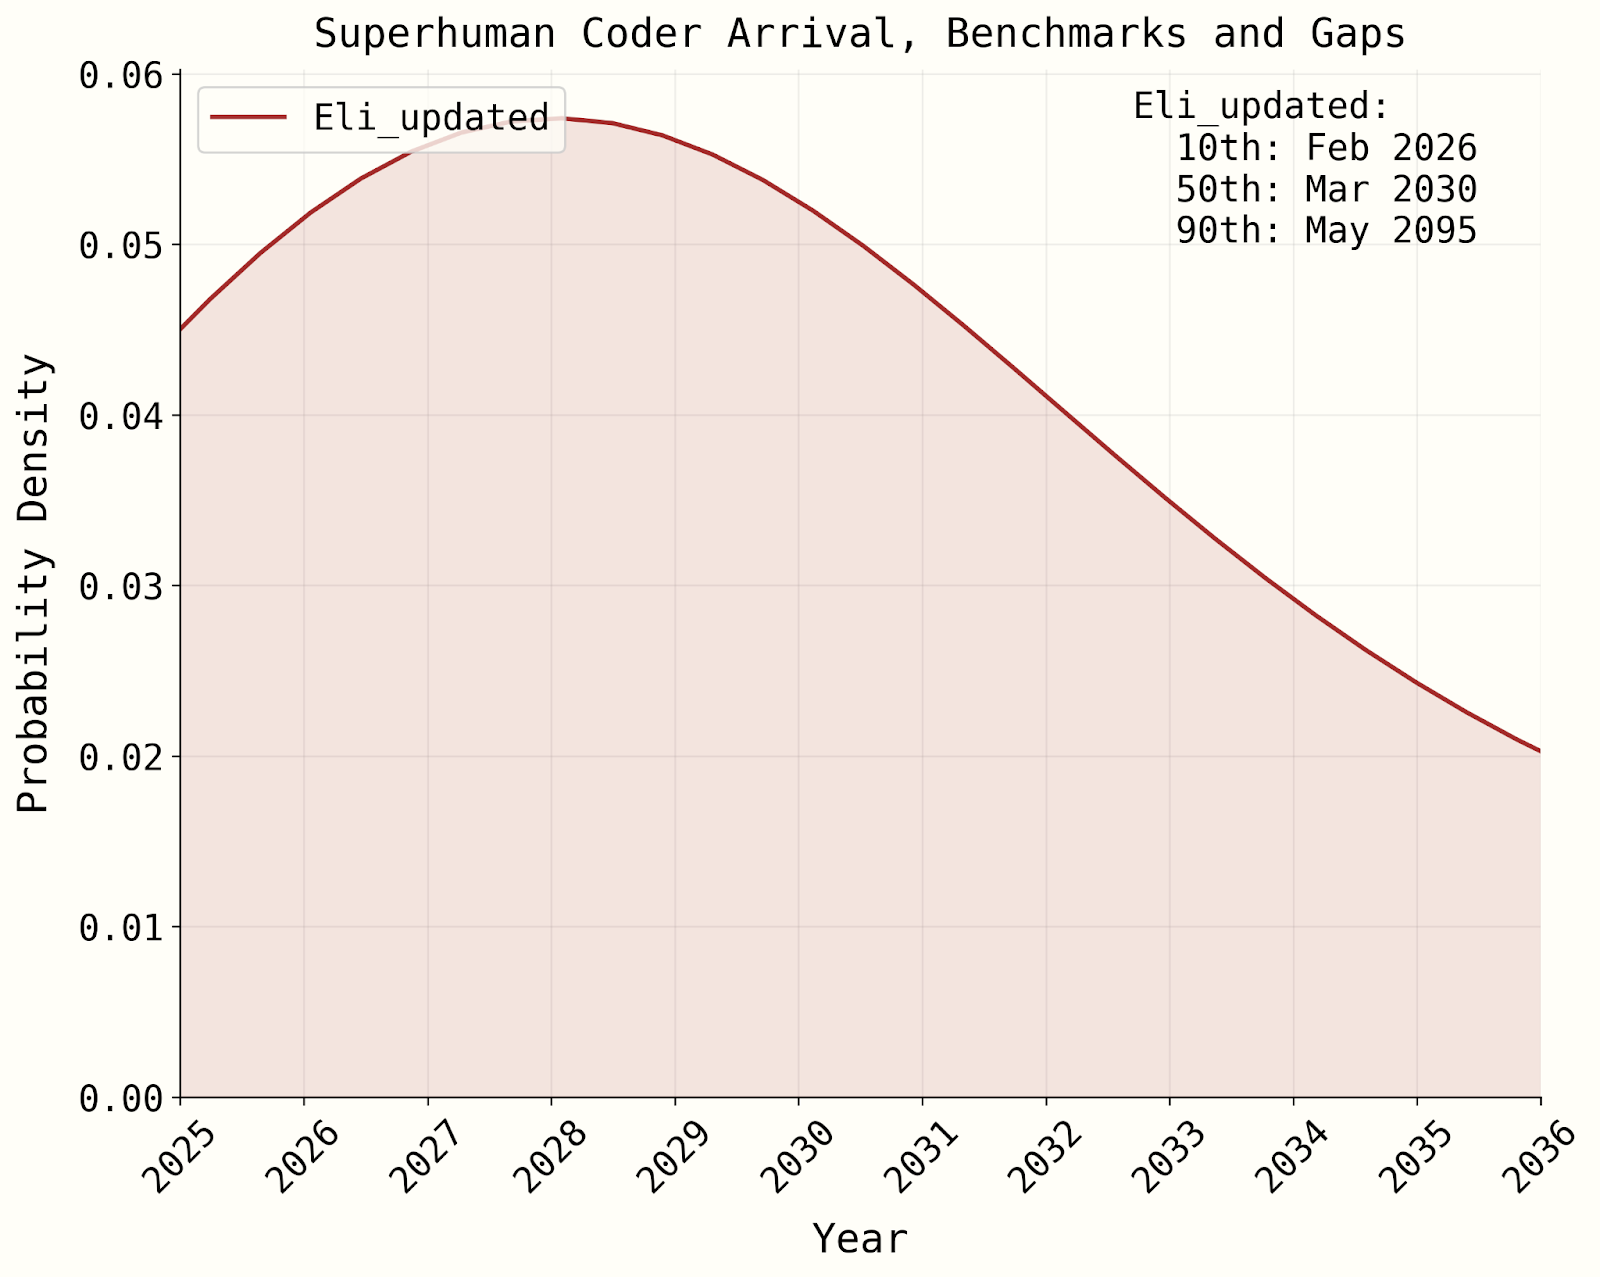
タイムホライズン延長モデルとベンチマーク・ギャップ・モデルの両方に、いくつか変更を加えた(これらの変更はすべてPeter Johnsonの提案やそこから得た着想によるもので、感謝したい。ただし彼がこれらの変更に賛同しているとは限らない)。モデル内での私の予測は次のように変わった。
| Eliの超人的コーダー予測(中央値と80%信頼区間) | Eliの超人的コーダー予測、最頻年 | |
|---|---|---|
| タイムホライズン延長モデル、初期版(2025年4月) | 2027年8月(2025年10月〜2039年) | 2026 |
| タイムホライズン延長モデル、更新版(2025年5月) | 2029年2月(2026年4月〜2052年) | 2027 |
| ベンチマーク・ギャップ・モデル、初期版(2025年4月) | 2028年12月(2025年12月〜2050年超) | 2027 |
| ベンチマーク・ギャップ・モデル、更新版(2025年5月) | 2030年3月(2026年2月〜2095年) | 2027年と2028年がほぼ同じ |
要するに、予測は目に見えて、ただし大幅にではなく長くなった。2027年までに超人的コーダーが登場する確率は以前より低くなったが、依然としてかなり大きい。
 ai-2027.com
 ai-2027.com
以下では次のことを行う。
モデルの更新
以下では、モデルに加えた各更新とその影響を、予測を変えた度合いの大きい順に説明する。これらの影響の大きさはそれぞれ5,000回のシミュレーションから得たもので、中央値について1〜2か月単位の精度はない。そのため、合計しても中央値の変化全体(タイムホライズン延長法で18か月、ベンチマーク・ギャップ法で15か月)とは正確には一致しない。
| 変更点 | 予測の中央値への影響 |
|---|---|
| 収穫逓減をよりよく考慮するよう、ソフトウェアの進歩のモデル化を改善した。労働力の増加、それを計算資源と組み合わせて得られる研究努力、そしてその研究努力に対するAI研究開発の進歩倍率を、直接モデル化するようにした。その際、研究努力の総量が倍になるたびに同じだけの進歩が得られると仮定している(Davidsonのテイクオフ・モデルと同じ仮定)。 | タイムホライズン延長(THE):13か月増 ベンチマーク・ギャップ(BAG):8か月増 |
| 超指数性を、シミュレーション開始時に固定の確率で導入するのではなく、タイムホライズンが伸びるにつれて導入される確率が高まるように更新した(新しい確率は、初期タイムホライズンでは以前の確率より低く始まり、タイムホライズンが大きくなると以前の確率より高くなる)。 | THE:5か月増 BAG:1か月減 この違いは、THEのほうが低いタイムホライズンから始まるにもかかわらず、以前はTHEとBAGで超指数関数的である確率を同じにしていたことによる。 |
| 出発時点でソフトウェアの進歩が占める割合に不確実性を加えた | THE:3か月増 BAG:2か月増 |
| 出発時点でソフトウェアの進歩が占める割合を50%から55%に引き上げた(根拠はこちら) | THE:1か月減 BAG:3か月減 |
| 労働力の増加スケジュールを更新した(予測と根拠はこちら) | THE:中央値は変化なし BAG:4か月増 |
| 計算資源の進歩のスケジュールを更新した(予測と根拠はこちら) | THE:中央値は変化なし BAG:2か月増 |
| 超指数関数的な場合の倍加時間の減衰率に不確実性を加えた | THE:1か月増 BAG:1か月増 |
コードの変更はすべてこちらで見られる。
超指数関数的な進歩の各要因の重要度
タイムラインのモデルには、タイムホライズンの超指数関数的な成長をもたらす要因が二つある。
より長いタイムホライズンに達するのに必要な難しさを反映した、「固有の」超指数性。 これは、ベンチマーク・ギャップ・モデルよりもタイムホライズン延長モデルではるかに重要である。
AI研究開発のソフトウェア進歩倍率を介した、AI研究開発の自動化による加速。 これは両方のモデルで重要である。
この節では、これらの要因それぞれの影響と、両者を組み合わせた影響を示す。
モデルの予測と、固有の超指数性がない場合の比較
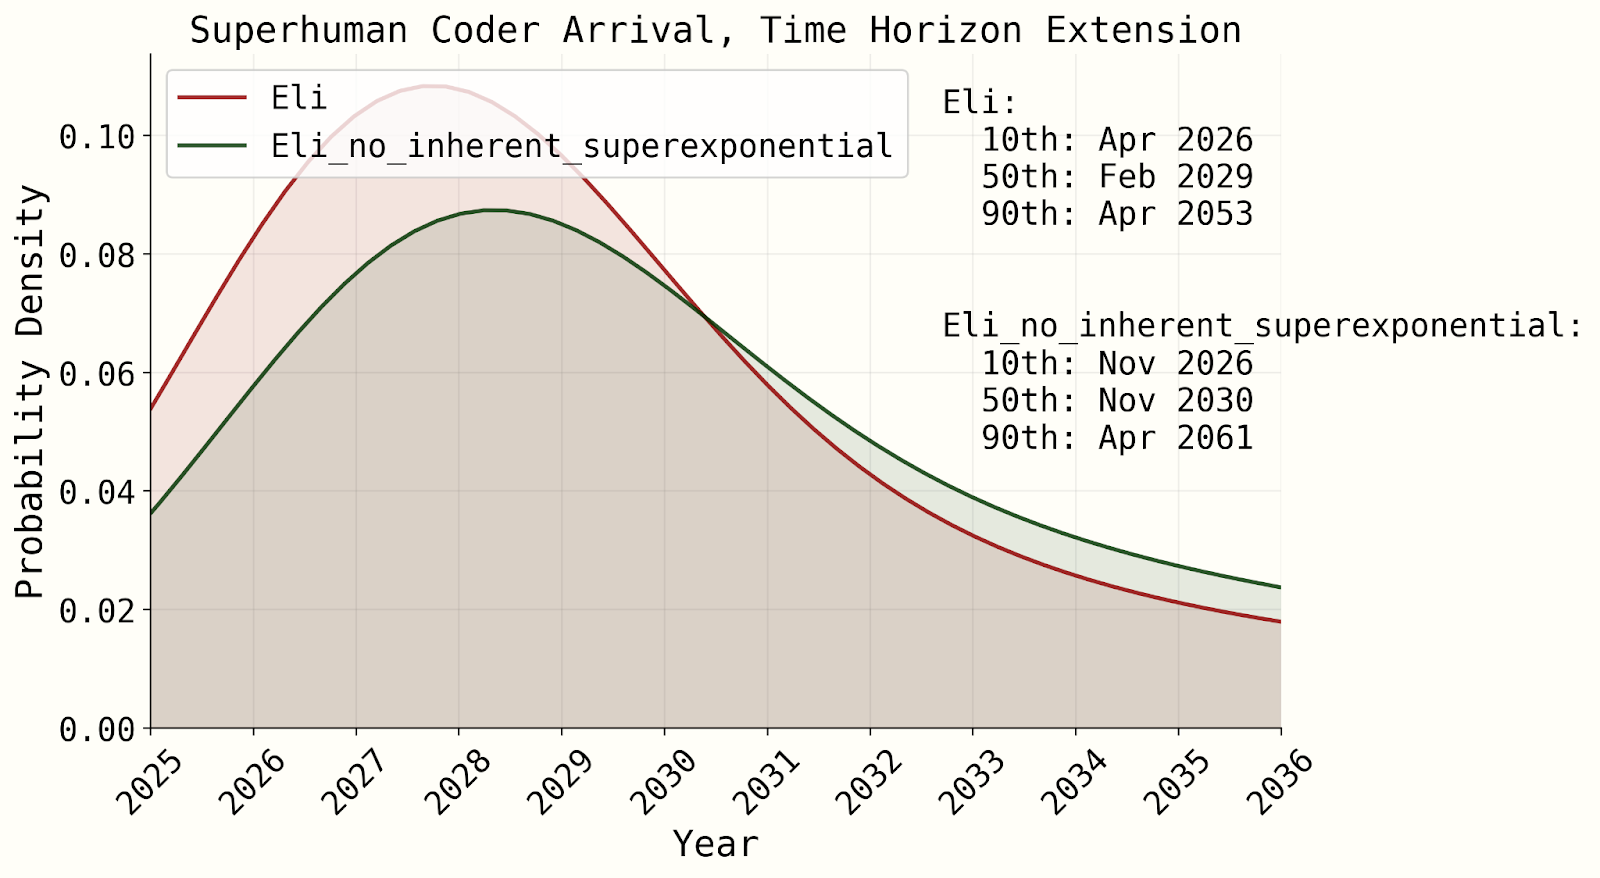 ai-2027.com
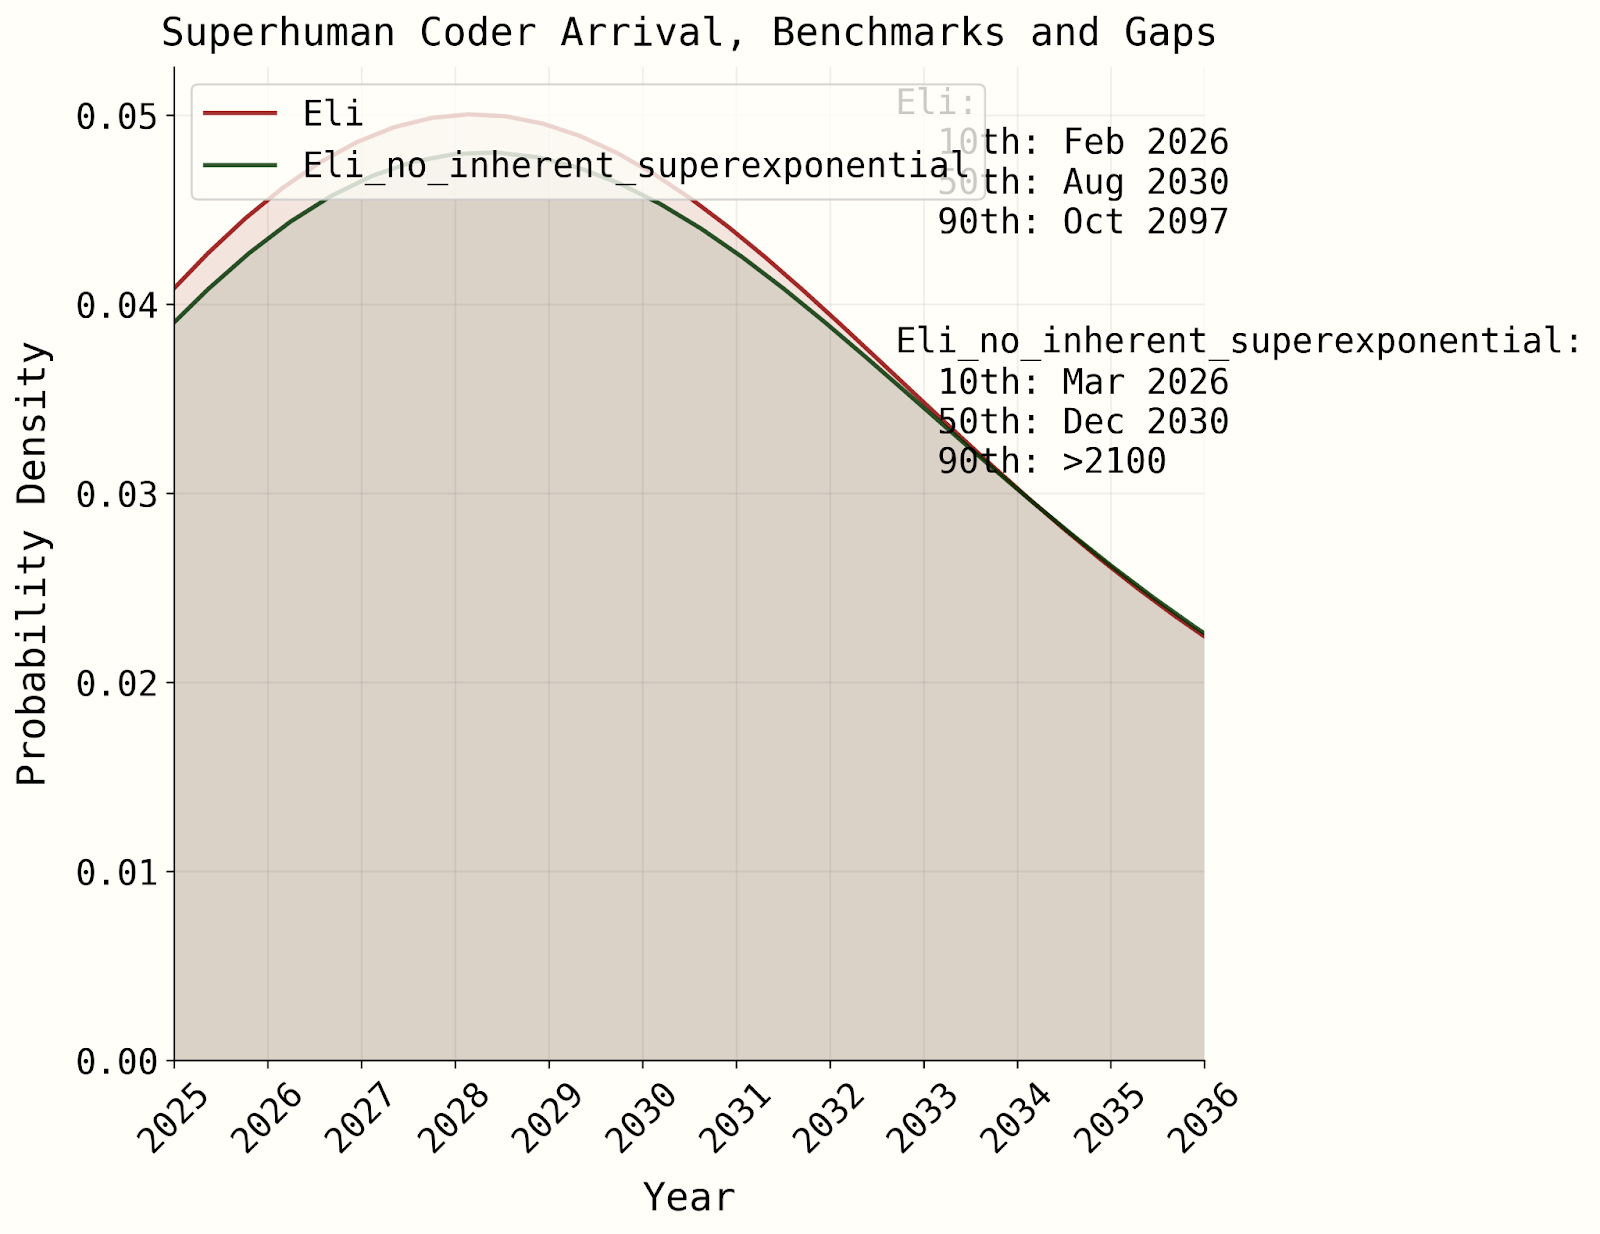 ai-2027.com
固有の超指数性のみの場合と、固有の超指数性がない場合の比較
ここでは、常に超指数関数的なタイムホライズンの成長から始まる場合のモデルの出力を示す。実際のタイムホライズン延長モデルでは、そうなるのは25%の場合である。
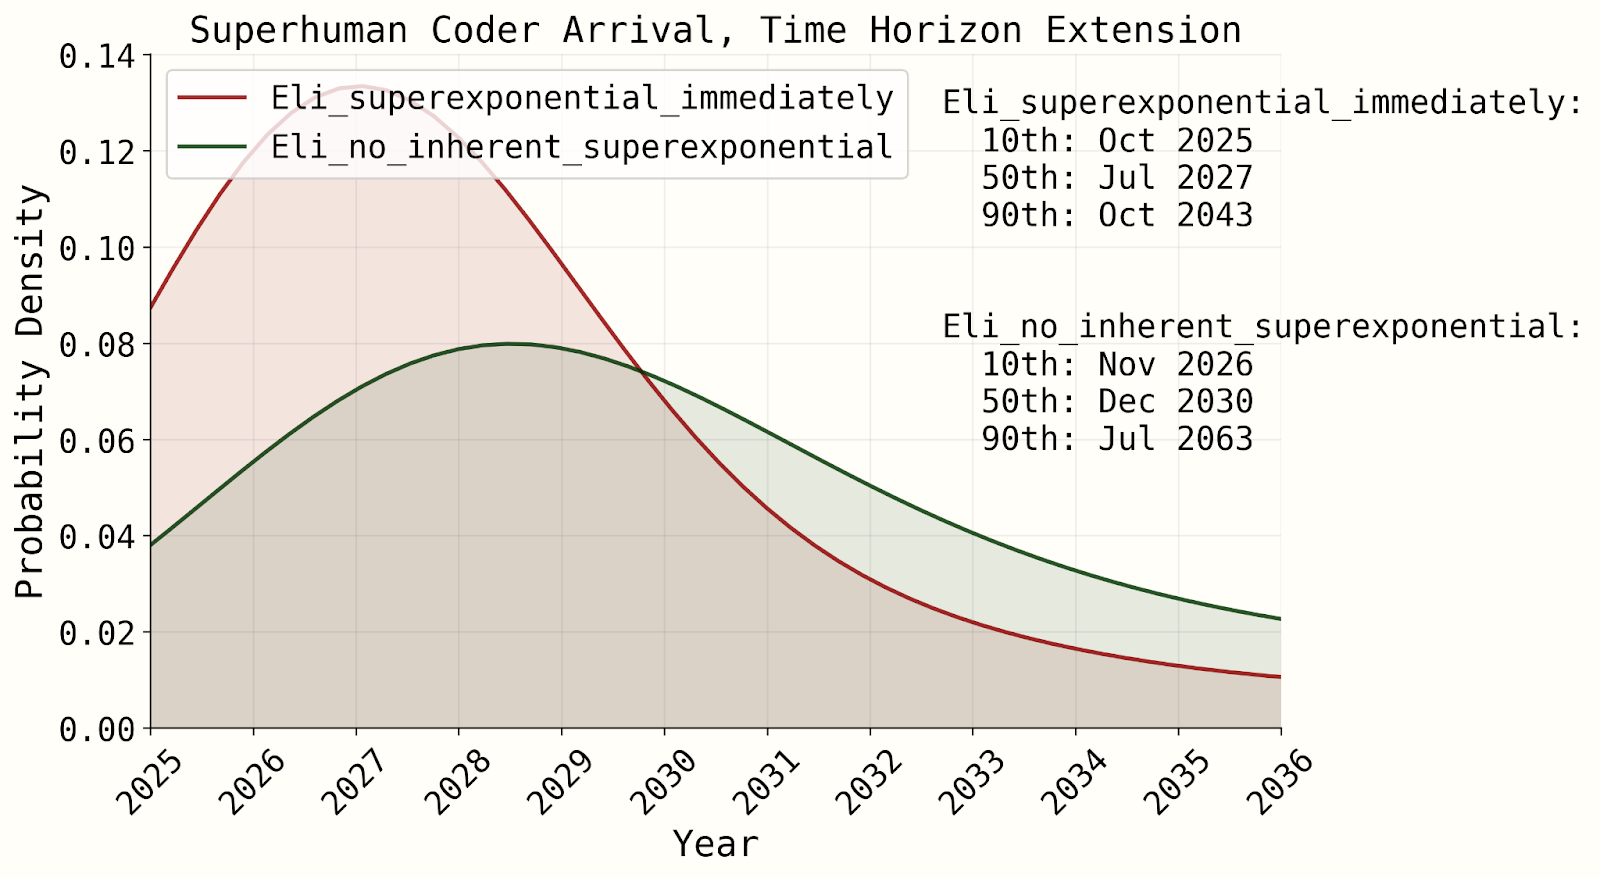 ai-2027.com
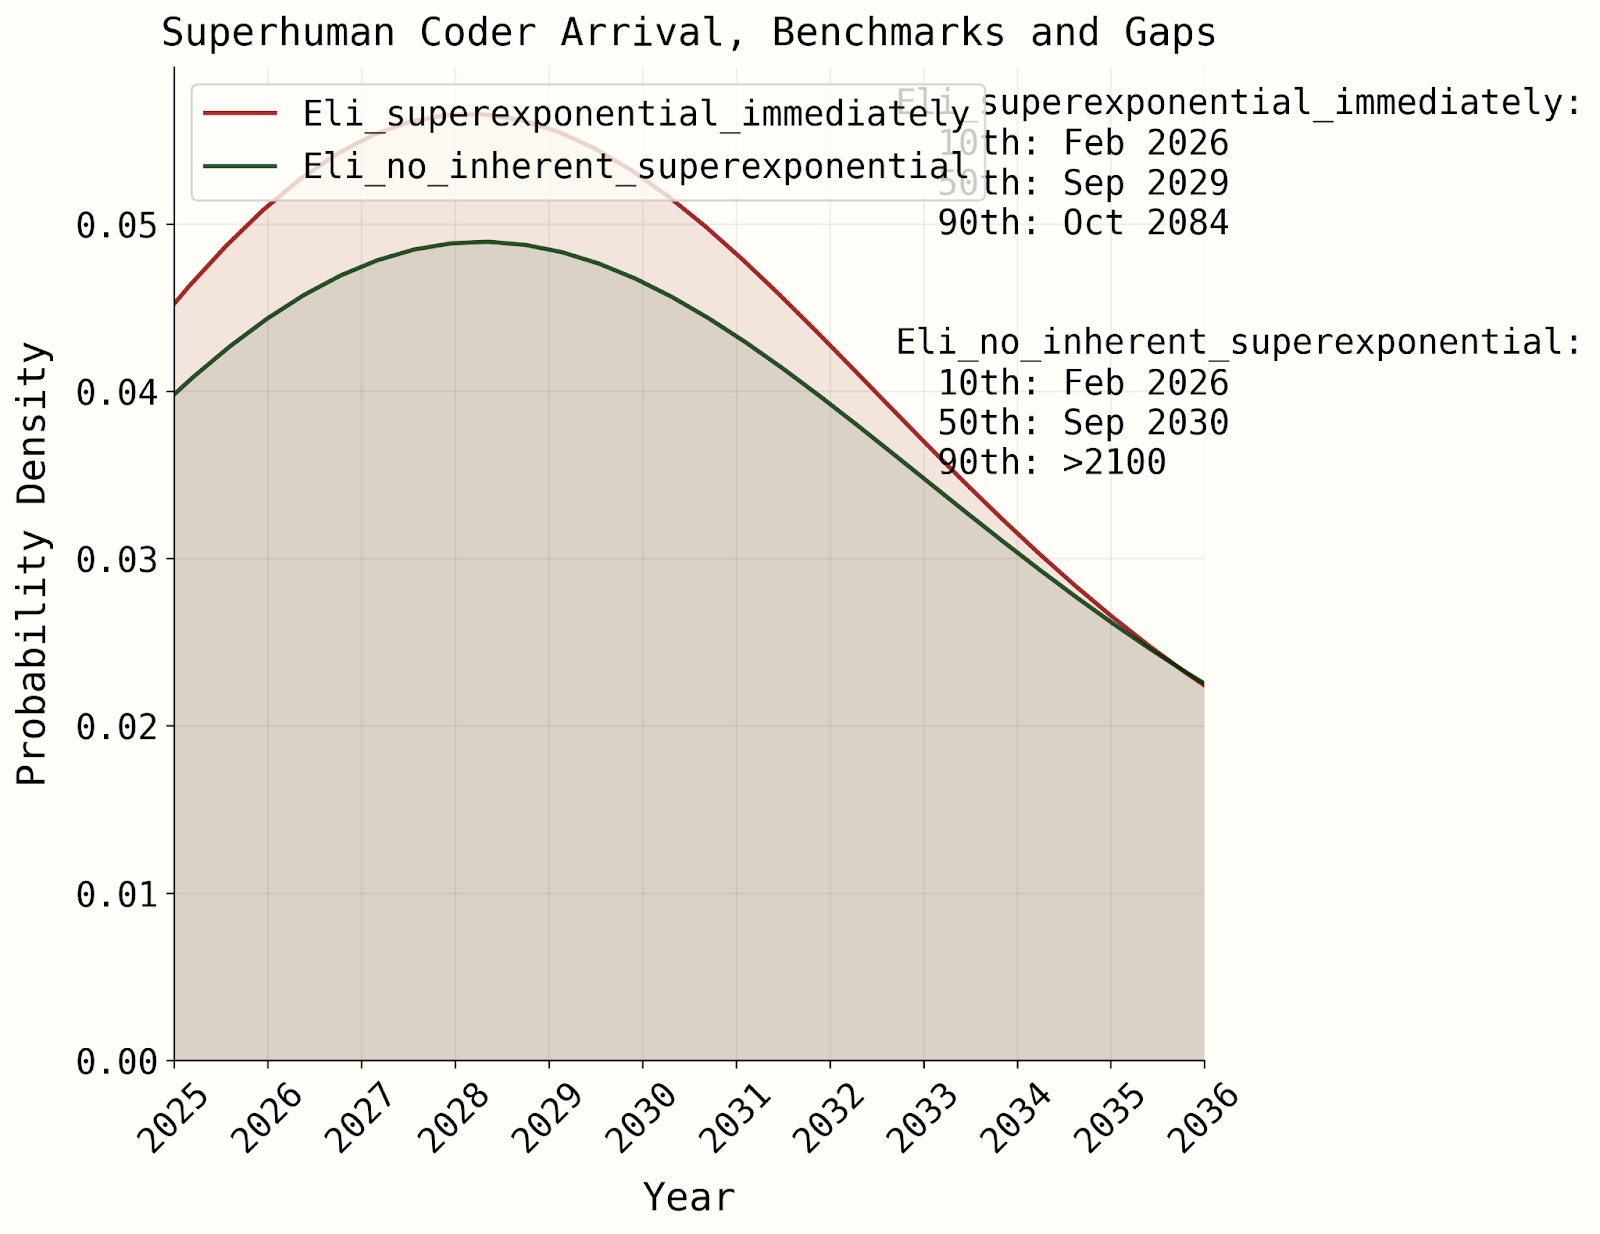 ai-2027.com
モデルの予測と、AI研究開発の進歩倍率がない場合の予測の比較
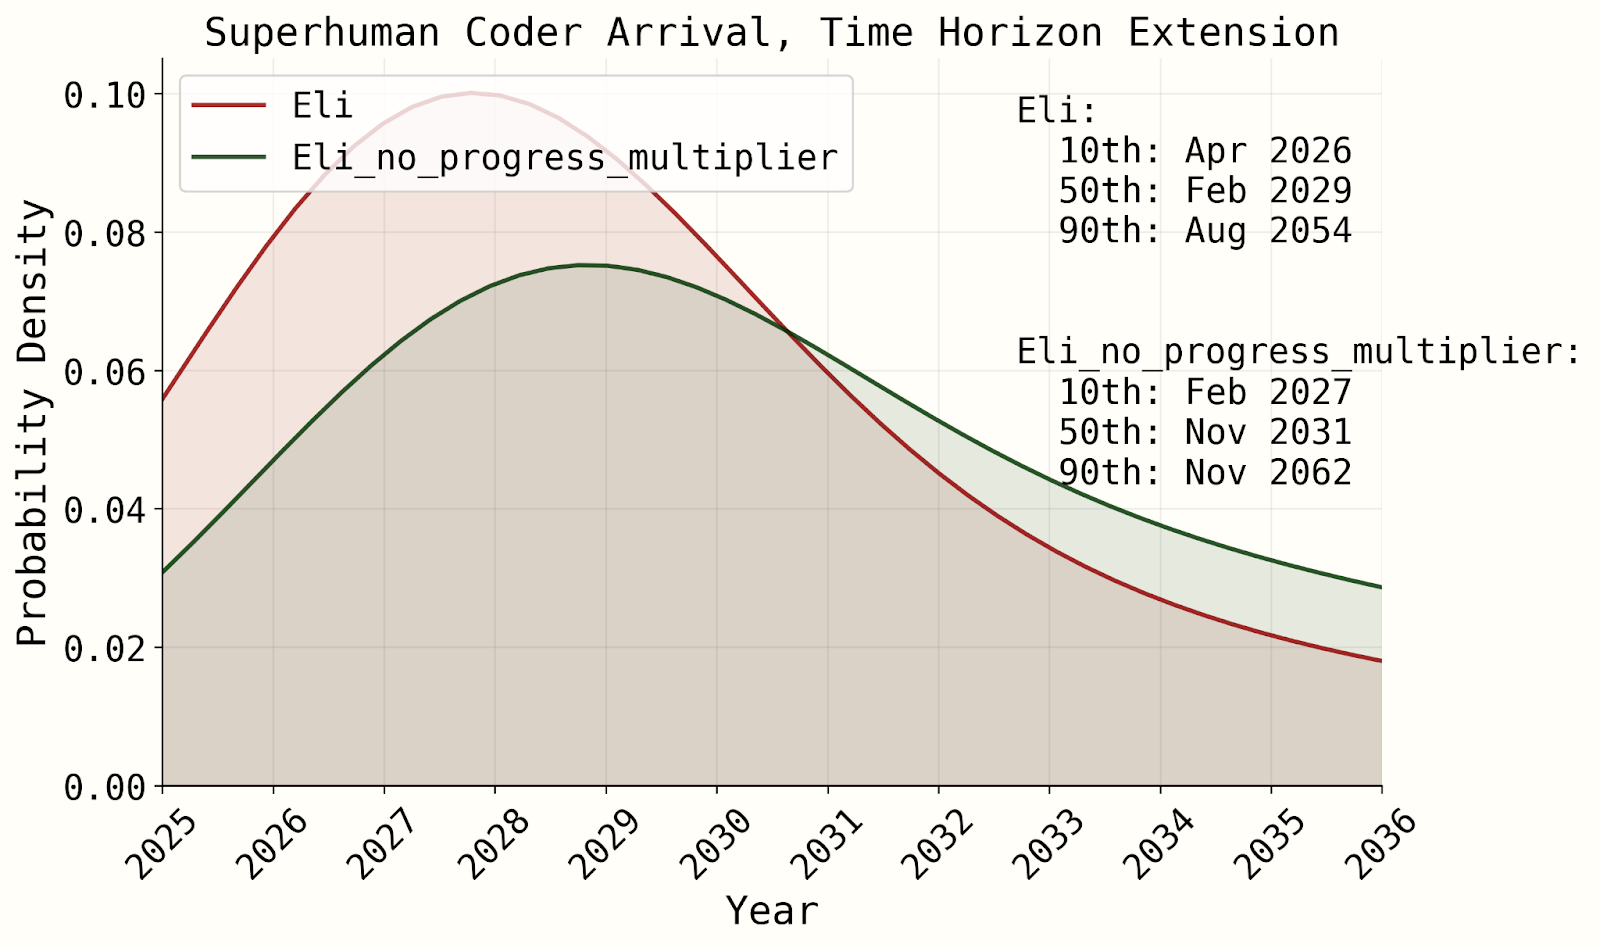 ai-2027.com
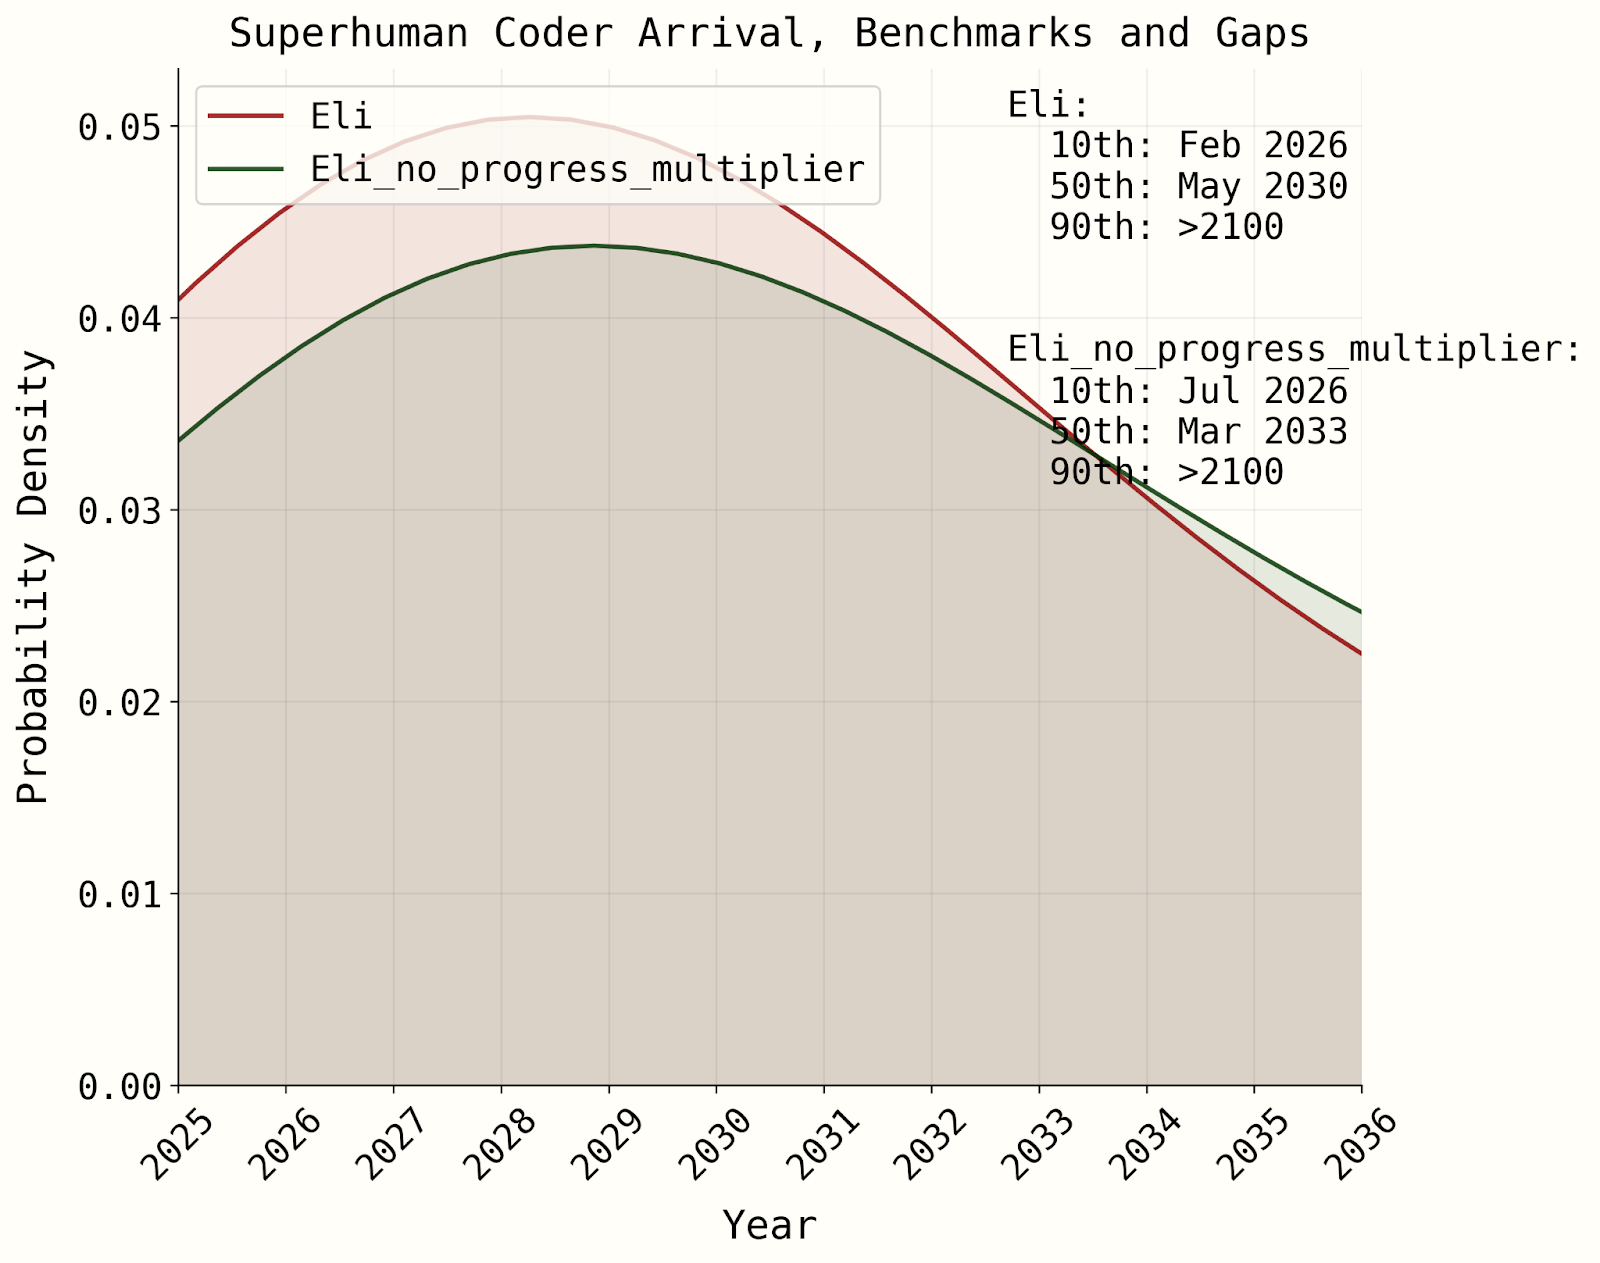 ai-2027.com
モデルの予測と、超指数性の要因がどちらもない場合の予測の比較
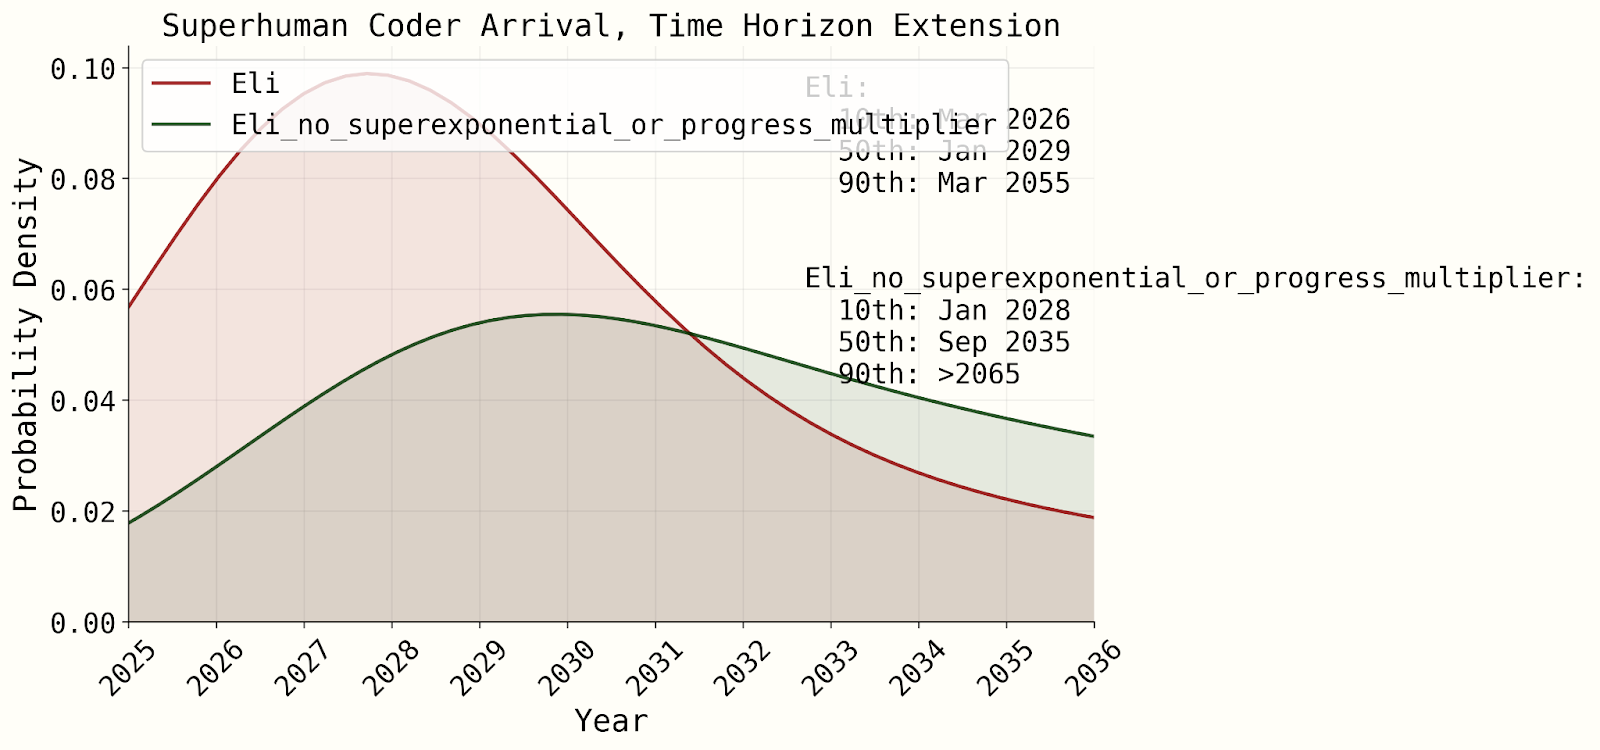 ai-2027.com
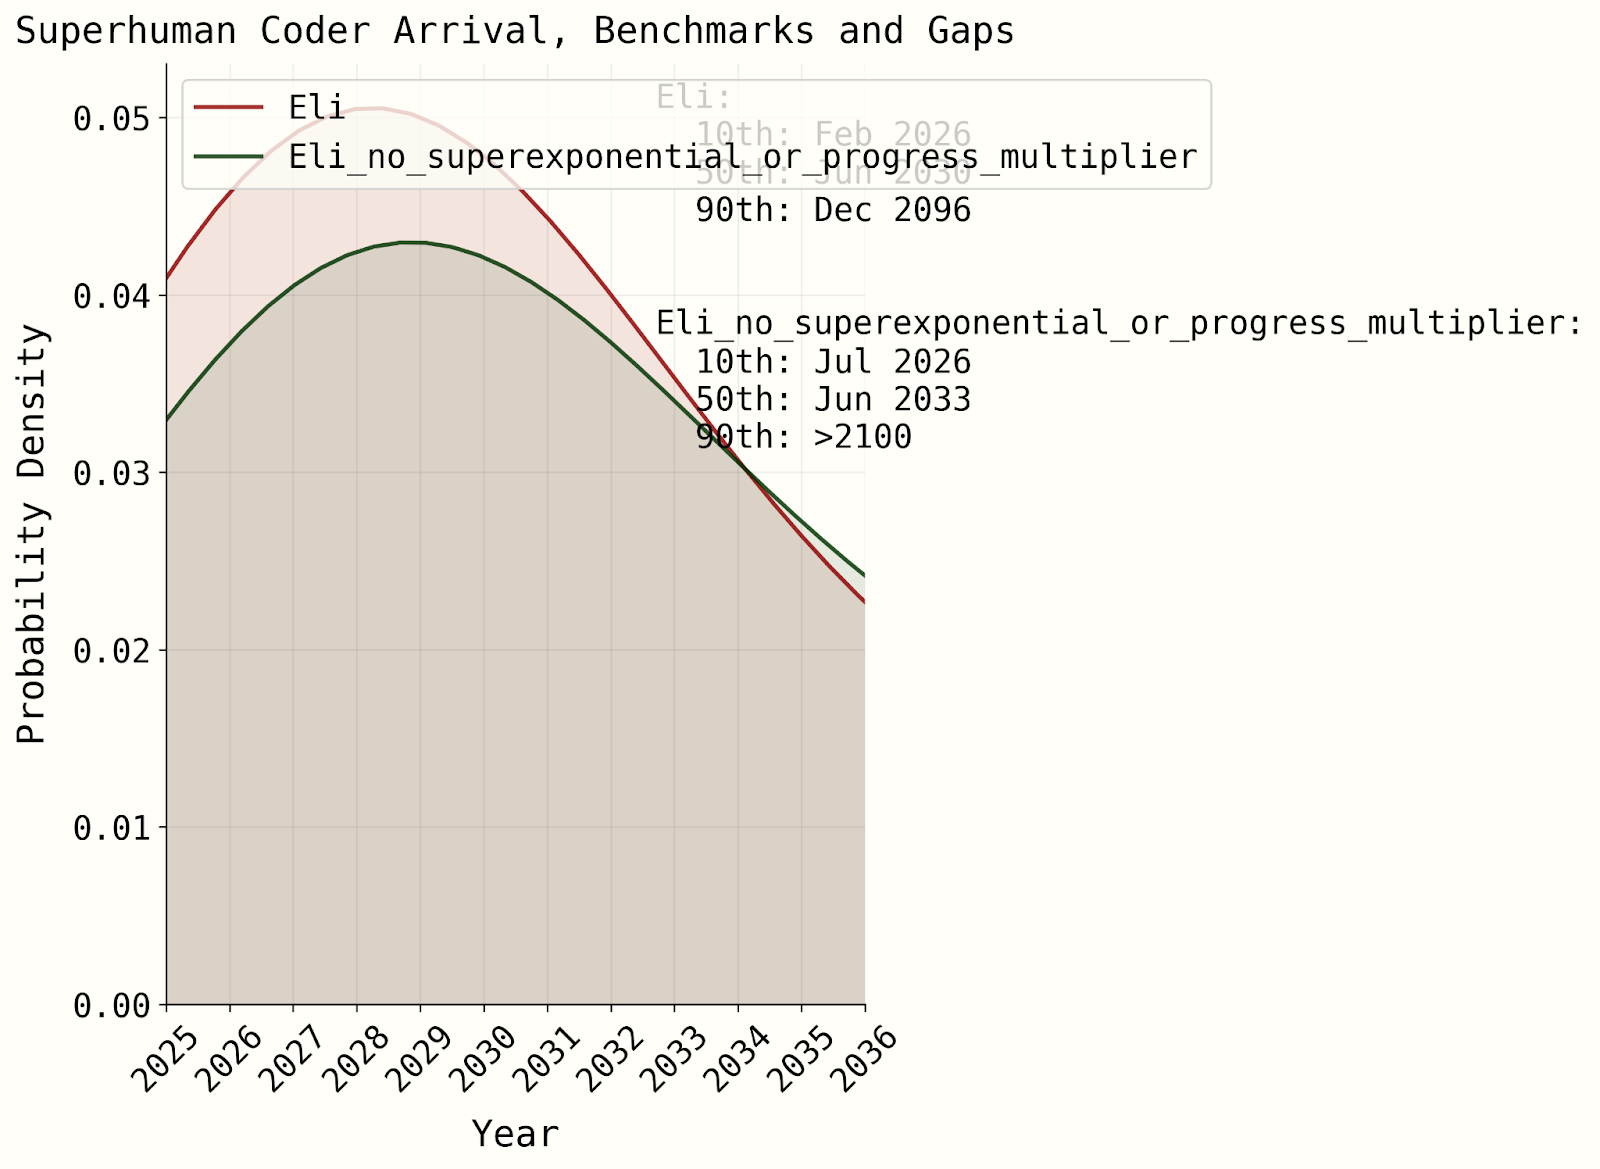 ai-2027.com
補足説明
タイムホライズン延長モデルも有用だと思うが、私はベンチマーク・ギャップ・モデルにかなり大きな重みを置いている。ギャップの分だけ必要なタイムホライズンを調整するだけで済ませるより、ギャップを明示的にモデル化するほうが有用だと考えるからだ。
超指数関数的である確率は、出発時点のタイムホライズンと独立ではない。出発時点のタイムホライズンを大きく下げるなら、そのタイムホライズンで超指数関数的だと考える確率も下げるべきだ(私の考えでは、超指数性を支持する理論的な論拠も経験的な論拠も、タイムホライズンが長いほうが強い)。今回、超指数性がいつ始まりうるかについての確率の「スケジュール」を導入したので、この現象はモデル化しやすくなったはずだ。ただしスケジュールはデフォルトでは現在のタイムホライズンから始まるので、出発点を下げたい場合は、それに応じてスケジュールを追加する必要がある。パラメータ名は「superexponential_schedule_months」で、ベンチマーク・ギャップ・モデルではこのファイル、タイムホライズン延長モデルではこのファイルにある。
タイムライン予測に出てくる時間の量はすべて「労働時間」で表している。つまり、その期間に人間が働く時間の量であり、たとえば1労働週は40時間、1労働年は2,000時間である。
ベンチマーク・ギャップ・モデルの各要因についての予測者ごとの見解
エンジニアリングの複雑さ:複雑なコードベースを扱う
ギャップを越えたことを示すマイルストーン:AI研究開発の過程で必要になる多種多様なソフトウェアプロジェクトを開発できる能力。プロジェクトは、合計500,000行超のファイルにまたがって20,000行超のコードを変更するものとする。明確な指示、単体テスト、その他の正解にもとづくフィードバックが与えられる。これを、人間なら約1か月かかるタスク(「初期タイムホライズン」パラメータで制御)について、80%の信頼度で、人間と同じコストと速度でこなす。
このマイルストーンでは、タイムホライズン・マイルストーンから、変更するコードの行数(変更LOC)を1倍、変更するファイル全体の行数(ファイルLOC)を25倍に拡大する必要がある。
Eliによるギャップの大きさの推定:3か月 [0.5, 18]。根拠:
私の推測では、特に大きな変更では、変更LOCのほうがファイルLOCよりタスクの難しさに効く。したがって、変更LOCの2倍の拡大とファイルLOCの25倍の拡大を合わせると、LOC全体で4倍の拡大に相当するかもしれない。
METRのタスク群では、変更LOCとファイルLOCはどちらもタイムホライズンに比例して増える。タイムホライズンは2025年にはおおよそ4か月ごとに倍加しており、タイムホライズンが長くなるともっと速く倍加しているかもしれない(前述のタイムホライズン予測を参照)。
倍加2回分で、倍加時間がいくらか短くなって中央値3か月になるとすると、6か月になる。そのうえで、ほかのタスク特性が難しくならないならLOCの倍加時間はもっと短くなるはずなので、中央値3か月に下方修正する。
両側に6倍の幅をとって [0.5, 18か月] とする。これは私の直観にもおおむね合う。AIがタイムホライズン・マイルストーンに必要なスキルをすでに持っていれば、はるかに大きなコードベースへ規模を広げるのは難しくないように思える。
Nikolaによるギャップの大きさの推定:3か月 [0.5, 18]。根拠はEliと同じ
FutureSearchによるギャップの大きさの推定:11か月 [2.4, 33.9]。根拠:
コードベース全体は、必要とされる10万行より大きくなりうる。前のマイルストーンの1万行から10万行に達するには、少なくとも10倍の増加が必要だ。しかしシステムは、必要な変更を加えるために100万行を理解しなければならないかもしれない。
10倍のコード行数に対処するのに4か月分の進歩で済むという仮定は強気すぎる。データ点は少なく、(90パーセンタイルを作るために)2倍の幅を加えるだけでは足りないように感じる。
バグの修正には、前のマイルストーンで想定したより多い1万行超の変更が必要になるかもしれない。システムにとって、長さNの新しいプロジェクトを作ることと、(たとえば)そのN行の1%の変更を要するバグを見つけて直すことの難しさがどれだけ違うのかは、はっきりしない。
ここでもやはり重要な論点は、訓練に合成データが必要かどうかだ。必要なら、この複雑さの水準で合成データを生成するのは非常に大きな課題になりうる。
フィードバック・ループ:外部からフィードバックを与えられずに作業する
ギャップを越えたことを示すマイルストーン:上と同じだが、単体テストは与えられず、プロジェクトが何を達成すべきかについて漠然とした大まかな説明しかない。
今後の研究では、このマイルストーンの代わりに、あるいはこれに加えて、METRが報告書で用いた「乱雑さ(messiness)」の概念を使うことを勧める。私たちは時間の制約のため、これを検討できなかった。
Eliによるギャップの大きさの推定:6か月 [0.8, 45]。根拠:
直観的には、AIが正解にもとづく外部からのフィードバックを受けて難しい長期タスクをこなせるようになれば、もっと漠然としたタスクに汎化するのはそれほど難しくなさそうに感じる。結局のところ、長期タスクの下位タスクの多くでも、おそらく似たスキルが使われていたはずだ。
しかし私も他の人々も、評価しやすくきれいに分解できるベンチマークのタスクでの進歩には一貫して驚かされてきた。その一方で、それに対応する現実世界への影響は、ある程度は見られるものの、私が予想していたより小さかった。AIは、もっと漠然としたタスクにも通用する汎用的な推論ではなく、いろいろ試してうまくいくものを見つけるというやり方にかなりの部分を頼って、検証可能なタスクで向上し続けるのかもしれない。また私は、「タスク」と呼ぶことさえ難しい仕事の重要性を過小評価しているのかもしれない。
定量的には、次のように推測する。
BoK/途中のフィードバックを取り除くと、1〜18か月が加わる
BoKを取り除くことは、評価が非常に難しいタスクへの道のりの5〜50%にあたるので、2〜10倍する。
大規模なコーディングプロジェクトをこなすにはすでに、質の悪いフィードバック・ループに数多く対処する必要があるので、上の取り組みでその道のりの50〜90%はすでに進んでいるはずだ。したがって10〜50%を掛ける。
o3-miniによれば、これでおおよそ0.8〜45か月になる。おおむね妥当に思えるので、これを採用する。
これらはすべて、現在のRE-Benchではなく、タイムホライズンが長くコード行数の多いRE-Benchについての値であるべきだと気づいた。この点は念頭に置いておくことが重要だ。
Nikolaによるギャップの大きさの推定:3か月 [0.5, 18]。根拠:
RE-Benchには採点関数があり、エージェントの成績をいつでも確認できる。フィードバックの有無で成績に差が出る可能性が高い。
現在の数値は主に直観的な推測である。私の見積もりでは、RE-BenchにBest-of-Kを加えると、スコアで4〜8か月分の進歩が上乗せされる。これはおそらく、フィードバック・ループのギャップ全体のおよそ3分の1にあたる。
これで約12〜24か月となる。ただし、数百万行のコードを扱う非常に長期のタスクをこなせるシステムがあれば、このギャップのおよそ半分はすでに埋まっていると予想する。また、評価しやすいタスクでの強化学習がほかのタスクにもよく汎化する可能性も十分あると考えるので、信頼区間の下限をさらに下げている。
乱雑さは、フィードバック・ループの欠如とある程度連動する。METRのタイムホライズン論文の図9は、タスクを乱雑さの高いものと低いものに分けて成績を示している。この成績の差から、フィードバック・ループの欠如が成績にどれだけ影響するかの手がかりが得られる。使える指標の一つは、「乱雑さの高いタスクの成績はどれだけ遅れているか」だ。つまり、乱雑さの高いタスクでの最高成績をとったとき、乱雑さの低いタスクでその成績に達したのはどれだけ前か、ということである。
タスクの長さが1時間未満では、最高の成功率はClaude 3.7 Sonnet(2025年2月)の約0.6である。この水準は2023年11月にGPT-4 1106で超えられていたので、15か月の差になる。
タスクの長さが1時間を超える場合、乱雑さの高いタスクでの最高の成功率はo1(2024年12月)の約0.1で、この水準は2024年5月にGPT-4oで超えられていた。したがって7か月の差になる。
フィードバック・ループのマイルストーン前後で直面するタスクの種類をよりよく代表しているのは、長いほうのタスクだと思う。
私のギャップの推定では、両側に不確実性を加える。
FutureSearchによるギャップの大きさの推定:18.3か月 [1.7, 58]。根拠:
エージェントとしての計画能力が鍵であり、前の二つのマイルストーンを経て、すでに十分なものになっている可能性が高い。 これは、オラクル呼び出しがないことや、フィードバック・ループがない・質が悪い・限られている・高くつくことへの対処に役立つはずだ。前のマイルストーンが強いエージェント的計画能力を伴わずに達成された場合は、これがこのギャップの主要なボトルネックになりうる。
対象がAI研究のためのコーディングという領域に限られているので、進歩はより現実味を帯びる。 安価なオラクルによるフィードバックがないなかで、人間水準の汎用的な計画能力がすぐに実現するかについては懐疑的な見方もある。
エージェントはオラクルとしてのスコア関数を人間の10倍使う。 RE-Benchの論文では、エージェントはスコア関数を1時間あたり25.3回または36.8回使ったのに対し、人間の専門家は3.4回だった。同論文では、エージェントの成績のかなりの部分が、初期パラメータを微調整して得た「局所最適」な解によるもので、これはとりわけオラクルとしてのスコア関数に依存する。RE-Benchが飽和し、前の二つのマイルストーンも達成されたこの時点では、システムはこの点で人間と同程度の水準で動けるようになっていると思われる。
AIには、利害関係者から生じる複雑なトレードオフに対処するための記憶が必要になる。 フィードバックがない状況では、より曖昧な、人間的な水準で動く必要がある。そこでは何十もの利害関係者の目標・インセンティブ・選好が読み取りにくく、しかも変化していく。AIは組織全体の目的を理解する必要があり、その目的は新しいビジネス機会や新技術、社会規範の変化とともに移り変わっていく。
並行プロジェクト:互いに関係する複数のプロジェクトを扱う
ギャップを越えたことを示すマイルストーン:上と同じだが、互いに連携する複数のコードベースにまたがる別々のプロジェクトに取り組む(たとえば大規模な訓練パイプライン、実験パイプライン、データ分析パイプライン)。
Eliによるギャップの大きさの推定:1.4か月 [0.5, 4]。根拠:
私の最良の推測では、非常に長いAI研究開発タスクをこなし、合計10万行のファイルを変更できるモデルは、互いに関係する複数のプロジェクトを扱うのに必要なスキルの大半をすでに持っている。
Nikolaによるギャップの大きさの推定:1.2か月 [0.5, 3]
FutureSearchによるギャップの大きさの推定:2か月 [0.7, 5.3]。根拠:
複雑なエンジニアリング・プロジェクトについてのマイルストーン2があるので、これは非常に簡単になる可能性が十分ある。さらに、単体テストを与えられずに作業するマイルストーン3も、複雑な形で連携するプロジェクトに対処するのにおそらく非常に役立つ。
専門化:フロンティアAI開発に特有のスキルに特化する
ギャップを越えたことを示すマイルストーン: 上と同じだが、AGI企業の社内で実際に進められているプロジェクトそのものに取り組む。
Eliによるギャップの大きさの推定:1.7か月 [0.5, 6]。根拠:
並行プロジェクトより少し難しく感じる。
Nikolaによるギャップの大きさの推定:0.4か月 [0.1, 2]。根拠
私の最良の推測では、現時点で、企業内部のタスクでよい成績を出すようにモデルをファインチューニングするのは難しくなく、ボトルネックは主にモデルの汎用的な能力にある。
また、エージェントが最も得意とするタスクと、AI研究エンジニアリングに関係する現実のタスクとの間で、専門性が大きくずれるとは思わない。むしろ、エージェントはAI研究に関係するタスクを最も得意とする可能性が高い。
FutureSearchによるギャップの大きさの推定:2.4か月 [0.5, 4.7]。根拠:
RE-Benchの飽和と、エンジニアリングの複雑さおよび互いに関係する並行プロジェクトについてのマイルストーンがあるので、これは非常に簡単になる可能性が十分ある。プロジェクト同士が密接に結びついていてもそうだ。
能力全般の向上が、ここで大いに役立つはずだ。
コストと速度
ギャップを越えたことを示すマイルストーン:上と同じだが、人間のエンジニアよりも超人的なAIエージェントのほうがかなり多くなるようなコストと速度でこなす(具体的には、人間の30倍の数のエージェントが、それぞれ30倍の速さでタスクをこなす)。
Eliによるギャップの大きさの推定:6.9か月 [1, 48]。根拠:
Epochの測定によれば、エージェント的でないさまざまなベンチマークで同じ性能を達成するためのトークンあたりの価格は、年9〜900倍、中央値で年50倍のペースで下がっている。2024年1月以降の傾向に限ると、中央値は年200倍である。これらの推定値を上方修正すべき理由が二つある。
同じタスクをより少ないトークンでこなせるようになることが含まれていない。また、主にMMLUやGPQAのようなエージェント的でないベンチマークを対象としており、そこでは推論モデルでなければ、タスクを解くのに使うトークン量はあまり変わらない。
これらの傾向は人間より低いコストから始まっている。コスト曲線が時間とともにたどる両端について考えると、より高いコストから始まる傾向のほうが速いと予想される。ある性能を達成するコストは、ほぼ無限大から始まり(GPT-2の推論計算をどれだけ注ぎ込んでも、エージェント的タスクで2025年水準の性能は出せない)、最終的には物理的な限界によって頭打ちになる。
RE-Benchは、よりエージェント的なベンチマークで、おおよそ人間並みのコストから始まっており、必要なトークンが少なくなることも考慮に入れられる。これを見ると、0.33年でおおよそ10倍というより速い低下が見られ、年1,000倍の傾向になる(図11にもとづき、3.5 Sonnet Oldと3.5 Sonnet Newを比較)。
ただし更新されたデータを見ると、OldとNewの間の変化率は異例に大きかったようなので、これは割り引いて考えるべきだ。
SC水準のエージェントは素朴なBest of Nよりも推論計算を効率よく使うはずなので、これはさらに下げるのが妥当かもしれない。
以上から、30倍のコスト低下はおおよそ0.35〜1.5年で起きるかもしれない(年10,000倍なら約0.35年、年10倍なら約1.5年)
コスト低下が、秒あたりのコスト(トークンあたりのコスト×秒あたりのトークン数)を変えずにタスクを速くこなすことだけで起きると仮定すれば、速度の向上もちょうど満たされる。秒あたりのコストが上がっているなら、速度はすでに30倍超に向上していることになる(考え方:秒あたりのコストが2倍 → 30分の1のコストが半分の時間で発生する → モデルは60倍速く、30倍安い)。その場合、パレートフロンティア上の「30倍の速度・30倍のコスト」の点をすでに上回っているので、ギャップの長さの推定値を下げるべきだ。秒あたりのコストが下がっているなら、推定値に上乗せする必要がある。
上で用いた例では次のとおり(トークンあたりのコストと速度はOpenRouterの値)。
トークンあたりのコストの低下に依拠するEpochの推定では、コストが300分の1になるのに対して、速度は約3.5倍になっている。つまり、コストが30分の1になると速度は約2倍になる計算だ。それ以上のコスト低下は、並列化によって速度の向上に転換することも試みられる。Epochが測定したエージェント的でないタスクではこれは難しいだろうが、エージェント的タスクに取り組むSC水準のAIならおそらく可能だろう。
トークンをより効率よく使うことに依拠するRE-Benchの例では、秒あたりのコストは基本的に変わらない。
Claude 3.5 Sonnet Oldは66トークン/秒で、入力100万トークンあたり3ドル、出力100万トークンあたり15ドル
Claude 3.5 Sonnet Newは58トークン/秒で、入力100万トークンあたり3ドル、出力100万トークンあたり15ドル
高価なSCから安価なSCへの移行は、Epochの推定よりもRE-Benchの例に近いものになると予想する。つまり、同じ能力水準のより安いモデルへ移行するのではなく、モデルがより有能になっていくと考えている。したがって秒あたりのコストは多少は下がるが、劇的には下がらないと予想する。ただ、秒あたりのコストが上がったとしても少しも驚かないし、その場合は私の予測を下げるべきことになる。秒あたりのコストについての考察にもとづき、予測を少し引き上げ、幅も広げて、0.2〜3年とする。
そのうえで念のため予測の幅をもう少し広げ、0.1〜4年とする。
Nikolaによるギャップの大きさの推定:6か月 [1, 36]。根拠:
基本的には下記のEliの推論に同意する。追加の考えをいくつか述べる。
GPT-4o miniの価格は入力100万トークンあたり0.15ドル、出力100万トークンあたり0.6ドルで、GPT-4の入力100万トークンあたり30ドル、出力100万トークンあたり60ドルと比べると、ベンチマークの性能は同程度なのにはるかに安い。両者の間隔は約1.5年なので、10分の1になるのにおよそ1年かかる計算になる。
もっと最近では、DeepSeek R1が旧版のClaude 3.5 Sonnetとほぼ同等の性能を出している。C3.5sの価格は入力100万トークンあたり3ドル、出力100万トークンあたり15ドルだが、DeepSeek R1は入力0.5ドル、出力2ドルである。DeepSeek R1はトークンを多く使うので、2倍分を差し引く。すると0.5年で約3分の1への低下となり、年10分の1の低下とおおむね一致する。
ARC-AGI(関係する能力を測っているとは思わないが、有用なデータ点にはなるかもしれない)では、o3-miniは同じ性能を2桁低いコストで出している。したがって、最近は蒸留の速度が上がっているのかもしれない。
私の最良の推測では、最初のSC級のシステムは法外に高価で、作業1時間あたりで人間のエンジニアより安くなるには、1〜2桁のコスト削減が必要になる。
開発企業がモデルの推論コストを常にかなり低く抑え、人間よりはるかに高いコストへ膨らませることは決してない、という可能性も十分ある。その場合、最初のSC級モデルは最初から安価かもしれない。
FutureSearchによるギャップの大きさの推定:13.5か月 [4.5, 36]。根拠:
(一定の能力水準での)推論コストの低下についての現在の傾向は、毎年10分の1への低下を示している。 このシナリオでは、とりわけAI開発に特化したシステムや、コストを下げる経済的な圧力があるコーディングについて、低下はさらに急激になりうる。より新しく包括的なEpochの分析は、推論コストがさらに速く、中央値で年50分の1のペースで下がっていることを示している。
コストの低下には、すでに速度の向上が伴っているかもしれない。 強気のシナリオでは、30分の1へのコスト削減だけを考慮すればよいと仮定でき、年50分の1の傾向なら約10.5か月で達成される。
そうでないとしても、best-of-kのような能力引き出しの手法や推論モデルの進歩を考えると、人間の速度は適切な基準ではないと思われる。人間を基準とすると、900分の1のコスト削減に相当する時間は、年10分の1の傾向で約3年かかる。しかしこれは保守的すぎるように思える。人間に近いコストから始まるが、すでに5倍速いと仮定すると、6×30=180のギャップを越える必要がある。これは年10分の1の傾向なら約29か月で達成される。
(2025年12月に追記:上のEliの推論には誤りがあった。速度とコストについて考えるのではなく、速度とコピー数について考えるべきだった。また、秒あたりのコストという大まかな水準で考えるのではなく、改善を「秒あたりのトークン数」「トークン効率」「トークンあたりのドル」に分解するとよかった。この誤りを正していれば、EliはEpochのデータ点にもとづいて1.9年、RE-Benchのデータ点にもとづいて0.7年という推定値を得ていたはずだ。
Eliがすべきだったのは、たとえば次のようなことだ。
a) SCに到達するには、並列労働力を27,000倍に増やすのと同等のことが必要だと計算する
b) RE-Benchについて、並列労働力の増加の傾向が4か月で100倍だと計算する。これは、直列労働を並列労働に換算する指数を2と仮定した場合の値である。トークン効率が10倍になると、速度は10倍になるがコピー数は増えないからだ。そのうえで log(27000)/log((10^2)^3) を計算して0.74年を得る。
c) Epochについても同様にして、log(27000)/log((15*(2^2))^(12/9))=1.87年を得る。Epochの傾向でコピー数の増加が15倍になるのは、トークンあたりのドルの低下でコピー数は30倍になるが、秒あたりのトークン数が2倍になることでコピー数は2分の1になるからだ。モデル1つあたり、時間ステップごとに生成するトークンが増えるためである。)
その他のタスク難易度のギャップ
ギャップを越えたことを示すマイルストーン: SCを達成。
Eliによるギャップの大きさの推定:5.5か月 [1, 30]
Nikolaによるギャップの大きさの推定:3か月 [0.5, 18]
FutureSearchによるギャップの大きさの推定:14.7か月 [2, 58.8]。根拠:
エージェントとしての計画能力が鍵であり、前の二つのマイルストーンを経て、すでに十分なものになっている可能性が高い。 これは、オラクル呼び出しがないことや、フィードバック・ループがない・質が悪い・限られている・高くつくことへの対処に役立つはずだ。前のマイルストーンが強いエージェント的計画能力を伴わずに達成された場合は、これがこのギャップの主要なボトルネックになりうる。
対象がAI研究のためのコーディングという領域に限られているので、進歩はより現実味を帯びる。 安価なオラクルによるフィードバックがないなかで、人間水準の汎用的な計画能力がすぐに実現するかについては懐疑的な見方もある。
エージェントはオラクルとしてのスコア関数を人間の10倍使う。 RE-Benchの論文では、エージェントはスコア関数を1時間あたり25.3回または36.8回使ったのに対し、人間の専門家は3.4回だった。同論文では、エージェントの成績のかなりの部分が、初期パラメータを微調整して得た「局所最適」な解によるもので、これはとりわけオラクルとしてのスコア関数に依存する。RE-Benchが飽和し、前の二つのマイルストーンも達成されたこの時点では、システムはこの点で人間と同程度の水準で動けるようになっていると思われる。
AIには、利害関係者から生じる複雑なトレードオフに対処するための記憶が必要になる。 フィードバックがない状況では、より曖昧な、人間的な水準で動く必要がある。そこでは何十もの利害関係者の目標・インセンティブ・選好が読み取りにくく、しかも変化していく。AIは組織全体の目的を理解する必要があり、その目的は新しいビジネス機会や新技術、社会規範の変化とともに移り変わっていく。
超人的コーダー(SC):タイムホライズンと信頼度の要件
超人的コーダー(SC)は、AGI企業のすべての人間プログラマーを合わせたのと全体として同じくらい良い仕事を、彼らの現在の業務でこなせなければならない。
これには、HCASTでどれだけのタイムホライズンと信頼度が必要か。
Eliの意見:
実際の業務タスクの分布で、強いインセンティブを持つ最優秀の人間がベースラインを取った場合に必要なタイムホライズンと信頼度:
タイムホライズン:6か月(80%信頼区間:[1週間, 12年])。 人間なら6か月かかるタスクをAIがかなり安定してこなせるなら、大規模なコーディングプロジェクトを自動化できるはずだと思われる。1週間未満で足りる可能性はきわめて低いと思う。理想をいえば、ここでは対数正規分布よりもさらに右裾の厚い分布を使いたいところだが、年単位の領域に入るころには、いずれにせよ傾向はかなり超指数関数的になる可能性が高いと予想している。
別の見方:ベースライン担当の人間のタイムホライズンは約90分にすぎないことを考えると、AIがタイムホライズン90分に達するころには、多くのコーディングタスクで人間を上回っている可能性もある。AIがこなせる必要のあるタスクの長さの上限としては、10年のタイムホライズンが妥当に思える。しかし、METRの現行の定義で1か月のタイムホライズンであっても、AIは同僚からの少しの手助けを受けて、AI研究開発の過程の大部分を自動化できる可能性が高いと思われる。ここにはある程度の不確実性を、80%信頼区間 [16時間, 2労働年(4,000時間)] の対数正規分布で取り入れる。
信頼度:80%。 SCが最優秀の人間と同じくらい能力に偏りがないなら、脚注に挙げるいくつかの理由から、これは50%をいくらか下回るだろう。しかし現在のAIは人間よりはるかに能力の偏りが大きい。そのため、人間並みのコスト・速度の範囲で信頼度40%だとしても、10倍の時間をかけてよいことにした場合、信頼度はおそらく45〜50%程度までしか上がらない。したがって現在のAIについては、信頼度の閾値を90%以上に設定する必要があるかもしれない。しかしSC水準のAIは、非常に強いエージェント能力(計画立案、誤りの修正など)を持つため、はるかに偏りが小さくなるだろう。そこで閾値を80%に下げる。これはおおよそ妥当に思えるうえ、METRが報告したデータを利用できるという利点もある。
HCAST(METRのタスク群)を外挿したタスクで、METRの現行のベースライン測定方法を用いた場合に必要なタイムホライズン:10年 [1か月, 1200年]。
信頼度は同じに保ち、タイムホライズンのほうをMETRの報告書(そのタスク群とベースライン測定の手順)に合わせて調整する。そうすれば、METRの結果を外挿することで、より素直に予測できる。調整は以下の考察にもとづいて行う。
タイムホライズンの要件を引き上げる理由:
HCASTのタスク群を外挿しても、現実世界で生じるギャップはカバーできない(最も重要なギャップはフィードバック・ループの質の悪さだと私は推測している。最も目立つと思われる候補のいくつかはこちらを参照)。
HCASTのベースラインは理想より弱く、そのため上で想定した設定に比べてタイムホライズンが大きく出る(詳しくはタイムホライズン論文とHCAST論文を参照)。(a)ベースラインを取るのはかなり有能な人々だが、文字どおり最優秀の人間ではない。(b)必ずしも専門家が取っているわけではない。(c)文脈をあまり持たない人々が取っている(すでにコードベースに習熟している人ではなく、新入社員に近い)。
ベースライン担当者は、METRのコードリポジトリでMETRの課題を解決するのに、5〜18倍長くかかることがわかった。 ただし、より長いホライズンのタスクでは、文脈を身につける時間があるので、事前の習熟はそれほど重要ではないだろう。
タイムホライズンの要件を引き下げる理由:外挿したHCASTが、実際には現実世界のタスクより難しくなる面があるかもしれない(つまり上の(1)の逆)。たとえば、ベースラインの採点関数の一部は非現実的なほど厳しい。
1200年は大きく聞こえるが、HCASTと現実世界の間に非常に大きなギャップがある可能性や、HCASTのベースライン測定とSC水準のベースラインの間に巨大なギャップがある可能性は十分あると思う。
Nikolaの意見: ベースライン担当の人間のタイムホライズンは約90分にすぎないことを考えると、AIがタイムホライズン90分に達するころには、多くのコーディングタスクで人間を上回っている可能性もある。AIがこなせる必要のあるタスクの長さの上限としては、10年のタイムホライズンが妥当に思える。しかし、METRの現行の定義で1か月のタイムホライズンであっても、AIは同僚からの少しの手助けを受けて、AI研究開発の過程の大部分を自動化できる可能性が高いと思われる。ここにはある程度の不確実性を、80%信頼区間 [16時間, 2労働年(4,000時間)] の対数正規分布で取り入れる。
RE-Bench飽和の判定基準
AI 2025予測調査からの転載
現実的な配備の制約の範囲内で動作し、ベースライン担当の人間に対して不公平な優位を持たないAIシステムであれば、どれでも対象になる。
ツールによる支援、スキャフォールディング、その他の推論時の能力引き出しの手法は、次の条件を満たすかぎり認める。
不公平で体系的な優位がないこと。 「人間の性能」の節で説明した人間に対して、体系的な不公平な優位がないこと(たとえば、人間には認められていないのにAIシステムには複数の出力の自動採点が認められている、あるいは人間はインターネットにアクセスできないのにAIシステムはアクセスできる、といった場合は不可)。
人間とのコストの同等性。 AIシステムにタスクを完了させるのに、同じタスクを同じ水準まで人間に完了させるために払う賃金で購入できる以上の計算資源を使わないこと
PASS@kという能力引き出しの手法(モデルのk個の出力を自動採点し、最良のものを選ぶ)はよくある例で、このベンチマークでは認める。RE-Benchのベースライン担当の人間も採点指標(損失や実行時間など)にアクセスできるからだ。したがってPASS@kは明らかな不公平な優位にはあたらない。
[...]
人間のコストの推定手順:
問題を人間のコストで順位づけする。 各問題について、人間が解くのにどれだけのコストがかかるかを推定する。人間が解けなかった問題については、成功させるのに必要な追加コストも織り込む。
AIの正答率を人間のコスト合計と対応させる。 AIシステムが問題のN%を解いた場合、(人間のコストで)最も安い下位N%の問題を特定し、それらのコストを合計して人間のベースラインの合計額とする。
解けなかった問題を考慮する。 AIが解けなかった問題ごとに、その下位N%の中での最大コストを加える。これにより、人間が難しさに応じてやり方を動的に変えることに頼らずに、人間とAIシステムを問題ごとに一定の予算のもとで比較できる。
Harvard University、METRのパートタイム・インターン
futuresearch.ai、予測者それぞれの経歴はfuturesearch.ai/ai-2027に掲載
5%を使うのは、AIプロジェクトがSCに達するころに費やしていると私たちが予測する割合が、おおよそこの値だからだ。計算資源予測の「研究の自動化」の行を参照。
各タスクのタイムホライズンは次のように定義される。
時間の上限が決まっていないタスクでは、完了した人間が要した時間の幾何平均。
人間に一定の時間上限があったRE-Benchでは、ベースライン担当の人間の平均スコアにもとづいて成否を二値化し、タイムホライズンはその時間上限(8時間)とみなす。
(2025年12月の追記:現在では、この議論は誤りだったと考えている) 公開モデルと社内モデルのギャップが時とともに縮まってきたらしいことを考慮に入れると、傾向はさらに超指数性の方向へ傾く可能性が高い。GPT-4は事前学習の完了から7か月後に公開されたと噂されているが、現在は遅れがずっと短くなっているようだ。たとえば発表動画によれば、Grok 3は事前学習の完了から1か月後に公開された。
いずれ超指数性が生じると考えるもう一つの論拠は、超人的なAGIは無限のタイムホライズンを持つはずだと思われることだ。しかし、前述のMETRの報告書から借りたタイムホライズンの定義のもとでは、無限のタイムホライズンにいつか到達するかどうかははっきりしない。AIは、人間より高い成功率を持つかどうかではなく、タスクの成功率の絶対値で評価されるからだ。タイムホライズンが長くなるにつれてタスクをこなす能力が下がる傾向があるかぎり、タイムホライズンは無限にはならない。これはベースライン担当の人間でも観察されている(こちらの図16を参照)。無限のホライズンに到達することはないとしても、タイムホライズンが極端に大きくなる可能性はあり、そうなれば超指数性をある程度裏づけることに変わりはない。とはいえ、これが私たちの予測している領域での超指数性の証拠としてどれほどのものかは、はっきりしない。
タイムホライズンを一段階延ばすたびに、そのホライズンのタスクで大量の訓練が必要になるなら、そうなるかもしれない。
(1.315 + 2.30 + 1.195 + 1.575 + 2.335 + 1.475 + 1.465)/7 = 1.67
各ギャップは測定可能なマイルストーンで定義しているので、ギャップがいつ越えられるかについての私たちの予測は、特定のAI能力がいつ達成されるかについての実証的な予測ということになる。これらの予測の当否を実際に判定できるベンチマークはまだ存在しない(関連する現在のベンチマークは、その時点ではすべて飽和しているだろう)が、そうしたベンチマークが作られる可能性は十分ある。
具体的には、相関をモデル化するために、各関数の累積分布関数(CDF)をモデル化し、相関係数0.7の多変量正規分布から得たサンプルのCDFを求めることで、各値のパーセンタイルをサンプリングする。
各タスクのタイムホライズンは次のように定義される。
時間の上限が決まっていないタスクでは、完了した人間が要した時間の幾何平均。
人間に一定の時間上限があったRE-Benchでは、ベースライン担当の人間の平均スコアにもとづいて成否を二値化し、タイムホライズンはその時間上限(8時間)とみなす。
このパラメータに限り、暦の月ではなく労働月を意味する。1労働月は4週間×週40時間の実労働であり、1か月のタイムホライズンは、METRのグラフで定義される160時間のタイムホライズンに相当する。
タイムホライズンは、成功した人間の完了時間の幾何平均をとって決めることを思い出してほしい。SCには少なくとも人間と同じ速さと安さでタスクを解くことを求める私たちの定義のもとでは、ベースラインを取った人間のチームと同じスキル水準のSCの信頼度は、次のようないくつかの理由から50%を下回る。(a)幾何平均をとる前に成功例だけを選ぶことで、タイムホライズンが人為的に小さくなり、信頼度が下がる。(b)同程度の能力の人が同じタスクを何度も繰り返せば、データはおそらくやや右に歪むだろう。分布が対数正規分布なら、中央値と幾何平均は等しくなる。しかし、分布の歪みが対数正規分布より小さく、幾何平均が中央値を下回って、信頼度が下がる可能性も十分ある。
倍率の下限は1なので、対数正規分布は(下限 - 1)と(上限 - 1)の間にとる。
最初のSCの研究センスはおおよそ80パーセンタイルで、20%の確率ですでに最優秀のAI研究者と同等以上だと予測している。
認知的タスクには、AREマイルストーンで定義されるようなほかのボトルネックは含まれないと仮定している。もちろんソフトウェア・エンジニアリングにはコンパイルのような認知的でないボトルネックもあるが、これらはおそらく回避できる。
完全なSCはこれをさらに速く安くこなす必要があるが、それは後でタイムホライズン延長法の中で考慮する。
タイムホライズンは、成功した人間の完了時間の幾何平均をとって決めることを思い出してほしい。SCには少なくとも人間と同じ速さと安さでタスクを解くことを求める私たちの定義のもとでは、ベースラインを取った人間のチームと同じスキル水準のSCの信頼度は、次のようないくつかの理由から50%を下回る。(a)幾何平均をとる前に成功例だけを選ぶことで、タイムホライズンが人為的に小さくなり、信頼度が下がる。(b)同程度の能力の人が同じタスクを何度も繰り返せば、データはおそらくやや右に歪むだろう。分布が対数正規分布なら、中央値と幾何平均は等しくなる。しかし、分布の歪みが対数正規分布より小さく、幾何平均が中央値を下回って、信頼度が下がる可能性も十分ある。